Validación de datos de la API REST: Una guía práctica de implementación
|
8
minuto de lectura

Por lo general, no estás frente a una capa de validación limpia cuando las cosas salen mal. Estás mirando un panel lleno de filas extrañas, un bucle de reintento de webhook roto o un informe que está "casi bien" hasta que alguien nota que los números no concilian. Ese es el costo real de la REST API data validation; las solicitudes incorrectas no solo fallan en el límite, sino que pueden deslizarse en los pipelines, distorsionar la analítica descendente y convertir un simple desajuste de contrato en una limpieza costosa.
La medida práctica es tratar la validación como parte del API contract, no como una cortés verificación previa. Ese cambio modifica la forma en que diseñas los esquemas, dónde rechazas las solicitudes, qué registras en los logs y cuánto detalle expones cuando algo falla. También cambia la forma en que los equipos piensan sobre la confiabilidad, porque una solicitud mal formada rara vez es solo una entrada incorrecta; a menudo es la primera señal de que un contrato legible por máquina se está desincronizando con los sistemas que dependen de él.
Tabla de Contenidos
Por qué la validación de REST API es un problema de contrato
Conectar la validación con la calidad de los datos y la Observability
Por qué la validación de REST API es un problema de contrato
Una solicitud rota no siempre falla en el límite. En los sistemas empresariales, puede pasar a través de un controlador, aterrizar en una cola y aparecer más tarde como una tendencia engañosa en un panel o un informe operativo en el que nadie confía. Es por eso que la REST API data validation se trata realmente de hacer cumplir el contrato del que dependen los sistemas descendentes, no solo de filtrar entradas desordenadas.
El validador REST de AWS API Gateway concreta esa mentalidad de contrato. Comprueba si los parámetros requeridos de URI, cadena de consulta y cabecera están presentes y no están en blanco, y puede validar una carga útil contra un JSON Schema configurado. Si no hay un tipo de contenido que coincida, se omite la validación, lo que es un recordatorio útil de que la validación solo funciona cuando el contrato es lo suficientemente explícito como para que la plataforma lo haga cumplir. Detalles de validación de solicitudes de AWS API Gateway
Eso importa porque los fallos de validación en entornos empresariales no se quedan a nivel local. Una sola solicitud inválida puede contaminar los flujos de trabajo de analítica, monitoreo y generación de informes si el sistema la acepta demasiado tarde o no la acepta en absoluto. Las directrices de la REST API de Eurostat describen las solicitudes como un patrón de URL estructurado compuesto por host, servicio, versión, tipo de respuesta, código de conjunto de datos, formato, idioma y filtros. Directrices de la REST API de Eurostat
Regla práctica: si los sistemas descendentes no pueden asumir de forma segura la forma y el significado de una solicitud, aún no tienes un contrato, tienes una sugerencia.
La validación comenzó como una simple verificación de entrada, luego creció hacia la aplicación de contratos, la higiene de seguridad y el control de rendimiento para APIs a gran escala. Ese cambio se muestra en las directrices que enfatizan el comportamiento de fallo rápido, errores claros y la prevención de fugas técnicas. Guía de validación de REST API
Para los equipos que gestionan pipelines de datos, el modelo es aún más estricto. La validación es una capa de la historia de la confiabilidad, y los data contracts son la disciplina más amplia que hace explícito el contrato entre productores y consumidores.
El patrón de validación de dos capas
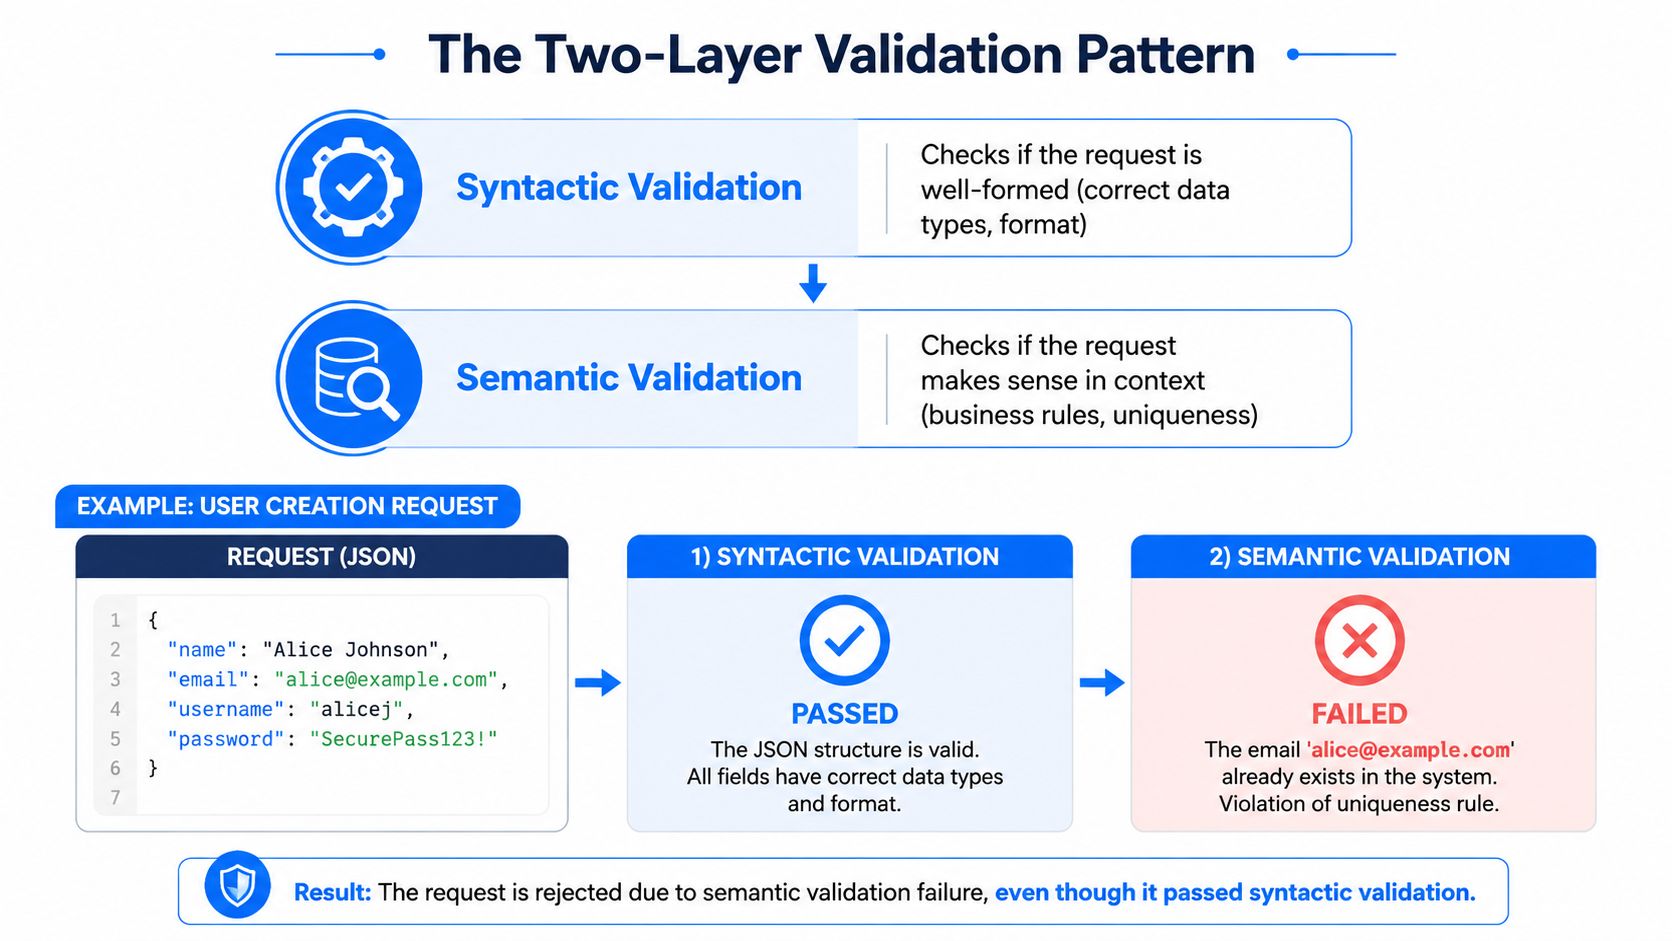
La forma más limpia de diseñar la validación de una REST API es separar la validación sintáctica de la validación semántica. Las comprobaciones sintácticas responden a una pregunta: ¿esta solicitud está bien formada? Las comprobaciones semánticas responden a la más difícil: ¿esta solicitud tiene sentido para este recurso y dominio de negocio?
Qué pertenece a la validación sintáctica
La validación sintáctica detecta JSON mal formado, campos requeridos faltantes, tipos de datos incorrectos, fallos de análisis, cadenas vacías y valores que violan los límites declarados. El objetivo es rechazar solicitudes obviamente rotas antes de que lleguen a la costosa lógica de negocio. Esa es la capa donde los esquemas de OpenAPI, los validadores de JSON Schema y las protecciones a nivel de controlador demuestran su valor.
El flujo de trabajo es sencillo. Valida en la pasarela o controlador, aplica un esquema estricto, rechaza desajustes de tipo y valores fuera de rango, y ejecuta pruebas negativas para JSON mal formado, nulos, cadenas vacías y cargas útiles de tamaño excesivo antes de que comience el procesamiento descendente. Las directrices al estilo OWASP también recomiendan un tipado fuerte, restricciones de expresiones regulares, rechazo de contenido ilegal y límites de tamaño de solicitud que devuelven un HTTP 413 cuando se superan. Prácticas de validación y manejo de entradas
Qué pertenece a la validación semántica
La validación semántica comprueba el significado del negocio. Un ID de usuario puede ser sintácticamente válido y, aun así, no existir. Un valor de enumeración puede ser estructuralmente válido y, aun así, ser incorrecto para el estado actual del recurso. Ahí es donde verificas la integridad referencial, la unicidad, el estado del flujo de trabajo, la propiedad o cualquier regla que dependa de los datos del dominio en vivo.
Un árbol de decisiones útil es simple:
¿Puede el analizador leerlo? Pon eso en sintaxis.
¿El tipo, el campo requerido o el rango son incorrectos? Pon eso en sintaxis.
¿El valor se refiere a una entidad real o a un estado válido? Pon eso en semántica.
¿La regla depende del contexto de negocio, los permisos o el estado actual de la base de datos? Pon eso en semántica.
Comienza con las comprobaciones económicas. Si una solicitud falla en la validación de forma básica, no gastes lecturas de base de datos probando una regla de negocio para una carga útil que debería haber sido rechazada dos milisegundos antes.
Esa secuenciación es lo que la gente entiende por validación progresiva. Comprueba primero los campos críticos, rechaza temprano y reserva las comprobaciones costosas para las solicitudes que ya han superado la puerta estructural. La guía para profesionales divide las dos capas exactamente por esta razón: la sintaxis te da velocidad y seguridad, la semántica te da corrección. Validación sintáctica versus semántica
Diseño de esquemas que funcionan en producción
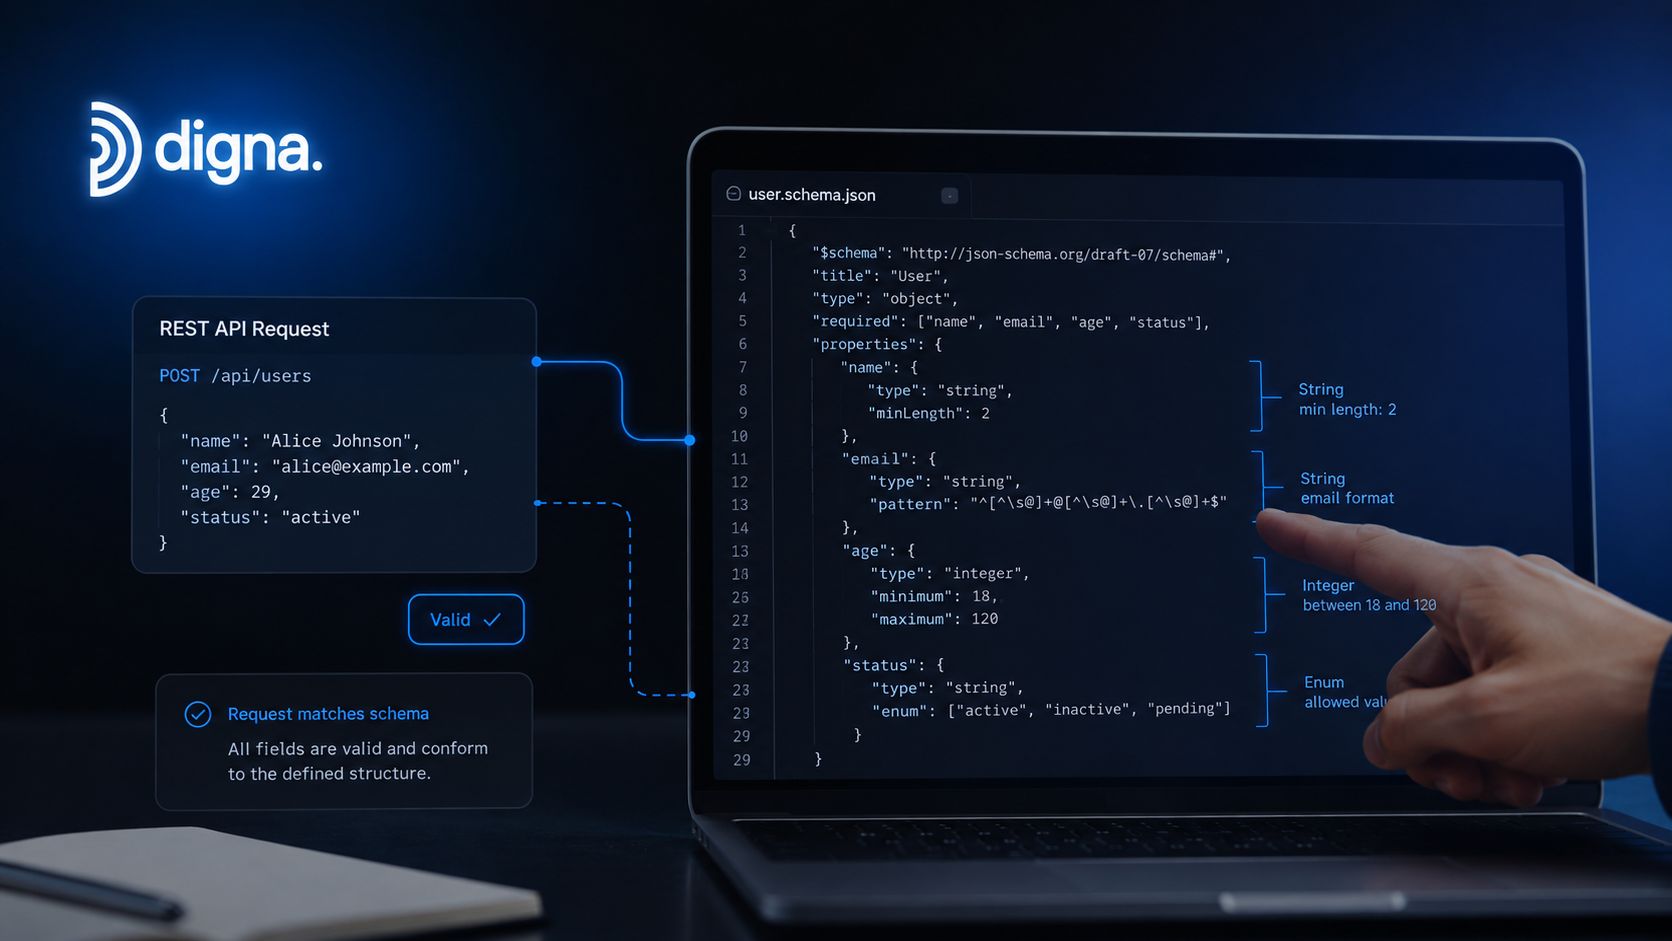
Un esquema que acepta todo no es flexible, es inútil. Un buen diseño de esquema comienza con los campos que los clientes deben enviar, luego ajusta el contrato con tipos, patrones, rangos y enumeraciones que coincidan con el objeto de negocio que se supone que la API debe aceptar. En la práctica, JSON Schema y OpenAPI funcionan bien juntos porque el esquema describe la forma de la solicitud mientras que la especificación de la API describe dónde y cómo se utiliza esa forma.
Reglas de esquema que se sostienen en producción
Define los campos requeridos de forma explícita, luego restringe cada propiedad con el tipo práctico más estrecho. Para las cadenas de texto, utiliza patrones de expresiones regulares cuando el formato importe más que el texto libre. Para los números, declara rangos en lugar de confiar en el código descendente para detectar casos límite. Para conjuntos cerrados, utiliza enumeraciones para que los clientes no inventen nuevos valores por accidente.
Esa disciplina evita los modos de fallo que aparecen en producción. Los equipos a menudo omiten las comprobaciones de formato para correos electrónicos y fechas, o escriben esquemas que no reflejan las reglas de negocio reales del endpoint. El resultado es un contrato que admite datos incorrectos en etapas posteriores y obliga a la capa de aplicación a compensar la falta de estructura. El uso de descripciones de esquemas que se mantienen alineadas con las estructuras de datos almacenadas ayuda a mantener la validación de solicitudes cerca del modelo de datos que se supone que debe proteger.
Un patrón de diseño de esquema práctico se ve así:
Objetos base compartidos para campos reutilizados en todos los endpoints.
Superposiciones específicas de endpoint para requisitos específicos de la acción.
Enumeraciones explícitas y expresiones regulares para valores restringidos.
Archivos de esquema con versión cuando un cambio en el contrato rompería de otro modo a los consumidores.
Rendimiento y control de desviaciones
Compilar esquemas importa cuando el volumen de solicitudes es alto. El análisis repetido añade un ruido que no deseas en las rutas críticas, y los validadores compilados reducen ese costo. El control de versiones del esquema importa por la misma razón, porque los requisitos de negocio cambian y los clientes antiguos no desaparecen según tu horario.
El modo de fallo que se debe evitar es la desviación silenciosa del esquema, donde el código, el documento de OpenAPI y la forma real de la carga útil dejan de coincidir entre sí.
El monitoreo estructural se vuelve útil en ese punto. El Schema Tracker de digna está diseñado para vigilar los cambios estructurales en producción de modo que los equipos puedan detectar la desviación antes de que rompa la validación, lo cual es el problema correcto a resolver cuando el contrato de tu API es solo una parte de un pipeline de datos más grande. Mantén el esquema cerca del servicio, mantén el control de versiones explícito y no permitas que "lo actualizaremos más tarde" se convierta en la estrategia de Release predeterminada.
Elegir bibliotecas de validación y middleware
La elección de la biblioteca es principalmente un equilibrio entre velocidad, expresividad y carga de mantenimiento. Los validadores de JSON Schema como Ajv son fuertes cuando deseas esquemas compilados y una aplicación predecible. Las herramientas basadas en OpenAPI son mejores cuando tus necesidades de validación deben permanecer estrechamente acopladas a un contrato de API que ya existe para la documentación y la generación de clientes. Los sistemas de tipos como TypeScript ayudan en el momento de la compilación, pero no reemplazan la validación en tiempo de ejecución porque a las solicitudes externas no les importa lo que crea tu compilador.
El middleware del framework es donde los equipos a menudo realizan la optimización incorrecta. El middleware de Express es fácil de conectar, FastAPI te ofrece un potente análisis de solicitudes de forma nativa, y la validación en la capa de la pasarela puede detener el tráfico mal formado antes de que llegue al código de la aplicación. La división correcta depende de dónde deseas que ocurra el fallo y quién debe ser el propietario de la superficie de error.
Enfoque | Rendimiento | Calidad del error | Curva de aprendizaje | Ideal para |
|---|---|---|---|---|
Validador de JSON Schema | Fuerte cuando se compila | Bueno si está bien mapeado | Moderada | Contratos de solicitud estrictos |
Herramientas basadas en OpenAPI | Sólido | Bueno, alineado con el contrato | Moderada | Equipos que priorizan las APIs |
TypeScript más comprobaciones en tiempo de ejecución | Mixto, depende de la capa de ejecución | Varía | Más baja para equipos de TS | Bases de código compartidas |
Middleware del framework | Bueno para casos sencillos | A menudo específico del framework | Baja | Integración rápida |
Validación en la capa de la pasarela | Fuerte en el límite | Por lo general estandarizado | De moderada a alta | APIs de alto tráfico |
Los esquemas compilados y la validación progresiva deberían ser obligatorios en sistemas con mucha actividad. Comprueba primero los campos más económicos, falla rápido y solo invoca validadores más profundos cuando una solicitud ya se ha ganado ese tiempo de CPU. Ese patrón importa más que la marca de la biblioteca.
También hay una cuestión de mantenimiento que los equipos subestiman. Los validadores personalizados parecen fáciles cuando se envía el primer endpoint, pero luego se vuelven frágiles cuando diez endpoints más necesitan las mismas reglas con excepciones ligeramente diferentes. Las bibliotecas consolidadas reducen esa desviación, especialmente cuando te ofrecen esquemas reutilizables, mensajes a nivel de campo y una vía de escape para comprobaciones específicas de dominio que no pertenecen a la biblioteca en sí.
Manejo de errores que los desarrolladores utilizan
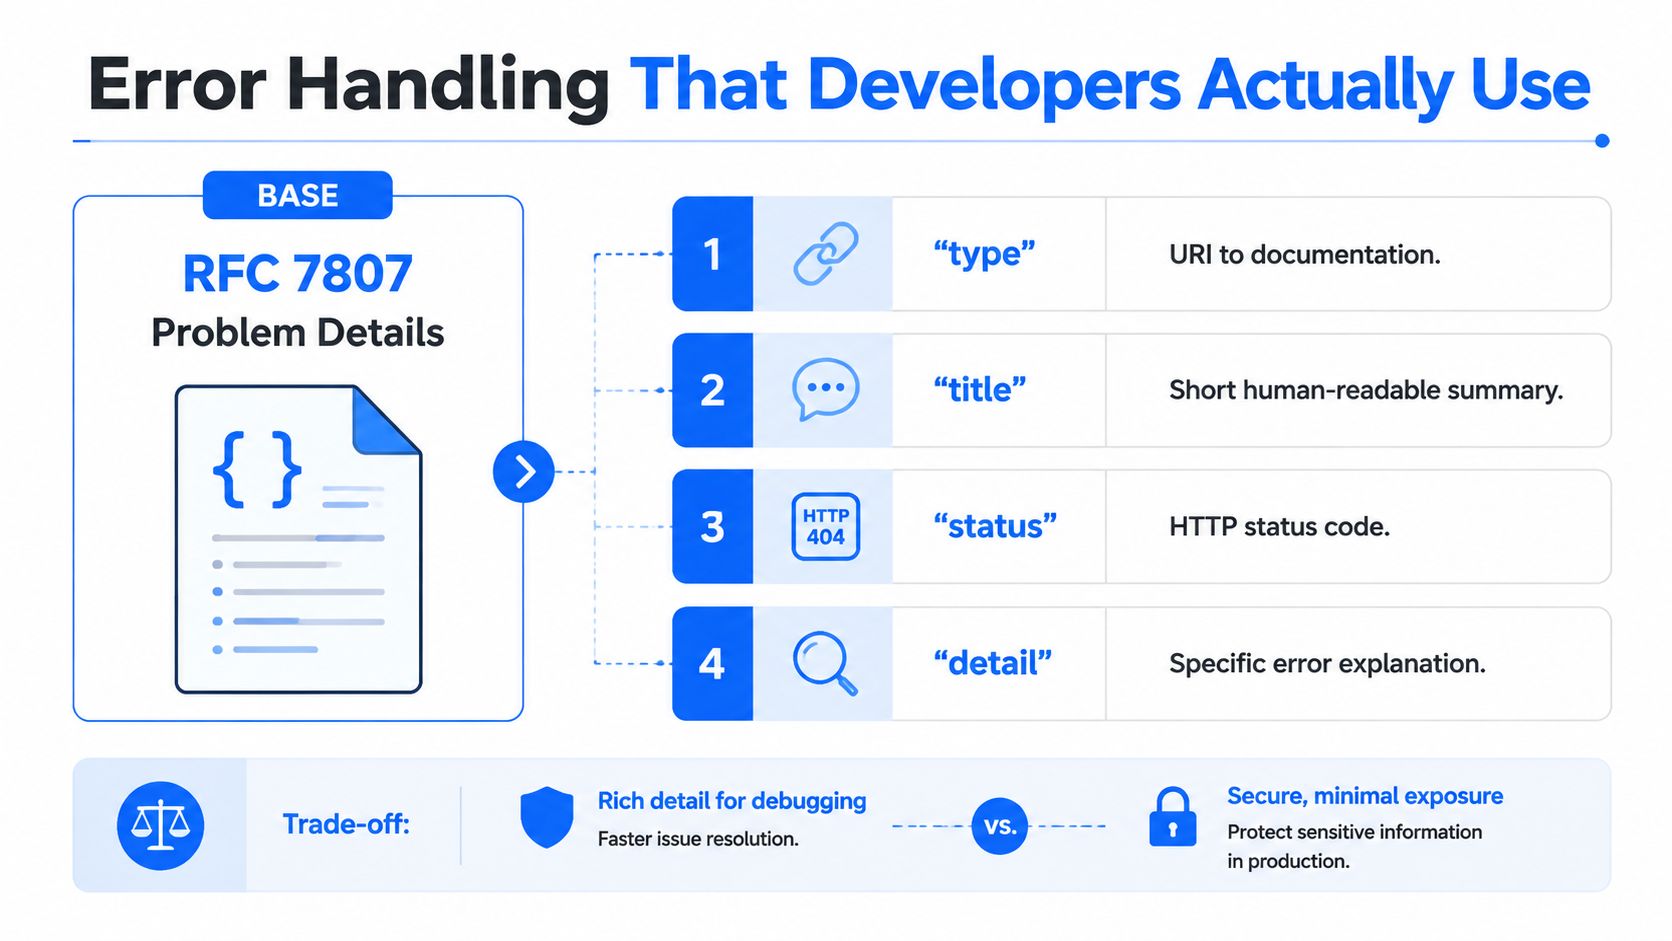
La validación solo ayuda cuando la respuesta ofrece a los clientes algo sobre lo que puedan actuar. El RFC 7807 funciona bien como base porque ofrece a los consumidores de la API una estructura legible por máquina para analizar los fallos sin obligarles a realizar ingeniería inversa en un formato personalizado. Los campos que importan son type, title, status y detail, además de la información a nivel de campo cuando una carga útil falla en la validación. Respuestas de validación al estilo RFC 7807
Qué devolver y qué ocultar
Utiliza HTTP 400 Bad Request cuando la carga útil falle en la validación del esquema o del campo. Mantén el cuerpo seguro, específico y consistente. Incluye el nombre del campo, el motivo y el formato esperado para que los desarrolladores front-end y los clientes automatizados puedan corregir la solicitud sin tener que adivinar.
Una buena respuesta es descriptiva sin ser excesivamente detallada. Los errores específicos del campo funcionan mejor que un mensaje genérico de "entrada no válida" porque se asocian directamente con la propiedad ofensiva. Los errores agregados son aún mejores cuando fallan varios campos a la vez, ya que permiten a los clientes corregirlo todo en un solo viaje de ida y vuelta. La guía pública también recomienda evitar los detalles de implementación interna, lo que te protege de filtrar trazas de pila, aspectos internos del campo o la estructura del backend. Guía de manejo de errores de validación de API
Dónde encajan los códigos de estado
Existe un verdadero equilibrio entre la semántica de 400 y 422, y el material público todavía no define completamente el límite. La regla práctica es ser consistente dentro de tu propia API y documentarlo claramente para los consumidores. Si tu equipo utiliza 400 para todos los fallos en la forma de la solicitud, mantenlo así y haz que el cuerpo sea lo suficientemente preciso como para compensarlo.
El registro de logs en el lado del servidor debería ser mucho más rico que las respuestas enviadas al cliente. Registra el contexto de validación, el ID de la solicitud y la regla interna que falló, pero nunca registres contraseñas, tokens u otros campos de carga útil sensibles. Esa división permite a los equipos de soporte depurar rápidamente mientras mantiene las respuestas de producción seguras frente a clientes hostiles. En una API real, ese equilibrio importa más que la perfecta pureza teórica.
La mejor respuesta de error es aquella que el cliente puede solucionar y que un atacante no puede explotar para obtener información adicional.
Conectar la validación con la calidad de los datos y la Observability
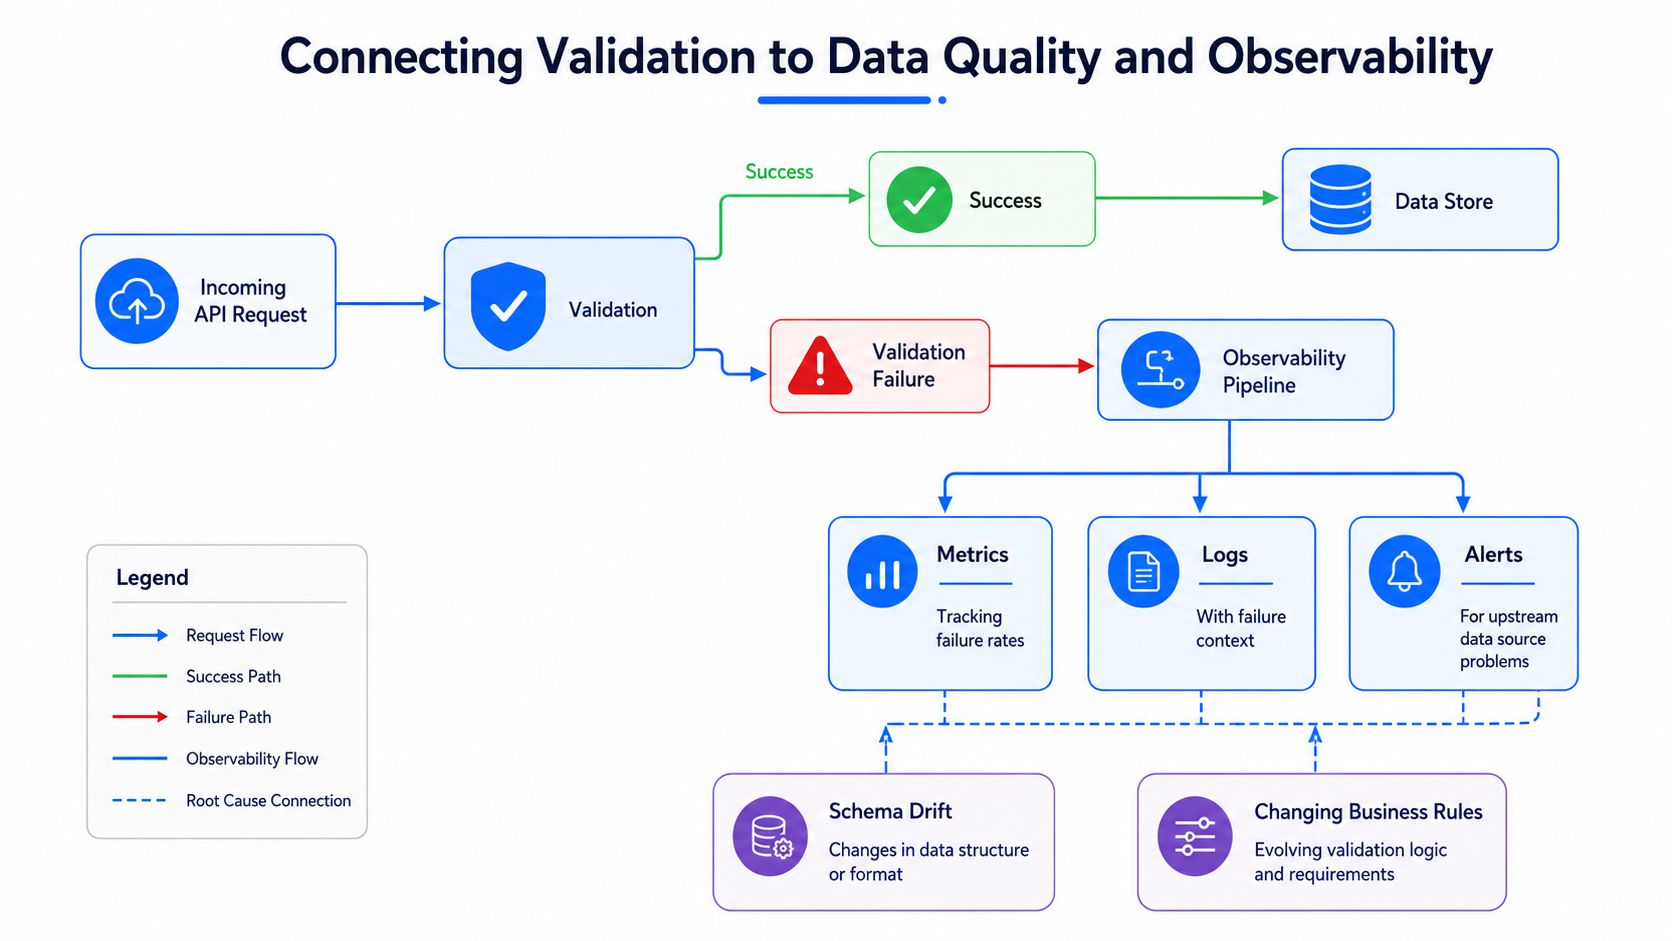
Los fallos de validación no son solo problemas de la API, son señales sobre la salud del sistema de datos que rodea a la API. Un pico en las solicitudes rechazadas puede apuntar a cambios en la fuente ascendente, desviación del esquema o una regla de negocio que cambió más rápido que los clientes. Si solo tratas la validación como un filtro de entrada, te pierdes una de las advertencias más tempranas de que el pipeline está comenzando a desalinearse.
Qué vigilar después de que se rechaza la solicitud
Los fallos de validación deberían alimentar la Observability de la misma manera que las escrituras exitosas alimentan el almacenamiento. Realiza un seguimiento de los patrones de fallo, conserva logs contextuales y alerta cuando un endpoint específico comience a rechazar una nueva clase de cargas útiles. Así es como los equipos distinguen un mal despliegue de cliente de un problema de compatibilidad más profundo.
El punto también se extiende de manera descendente. Si la API es la puerta de entrada a un almacén, lago o almacén operativo, la validación de solicitudes y las comprobaciones de calidad de datos posteriores a la carga deben reforzarse mutuamente en lugar de duplicarse a ciegas. La validación a nivel de API detecta solicitudes mal formadas antes de la ingesta, mientras que las comprobaciones descendentes detectan anomalías que solo aparecen después de que los datos se combinan, transforman o comparan con otros sistemas.
Cómo encajan las plataformas en el bucle
Los módulos de Data Validation y Schema Tracker de digna encajan de forma natural en esta capa porque permiten a los equipos monitorear las reglas de negocio y los cambios estructurales a lo largo de todo el pipeline, no solo en el punto de ingreso. Eso es útil cuando el contrato de la API es estable pero el comportamiento de la fuente no lo es, o cuando múltiples productores alimentan las mismas tablas descendentes. digna data observability
Un bucle de Observability práctico se ve así:
Métricas de validación para señalar nuevos patrones de error.
Logs para capturar el campo rechazado y el motivo.
Alertas para notificar a los propietarios sobre problemas en la fuente ascendente.
Monitoreo de cambios de esquema para detectar la desviación antes de que se propague.
Comprobaciones de reglas de negocio para confirmar que los datos siguen teniendo sentido después de la ingesta.
Trata los fallos de validación como telemetría operativa, no solo como ruido de la aplicación.
Esa mentalidad es lo que mantiene la capa de la API conectada con la confiabilidad de los datos. Cuando la validación, la Observability y las comprobaciones de calidad descendentes están alineadas, los equipos dejan de debatir si un fallo pertenece al equipo de la API o al equipo de datos. Pueden ver la misma señal, interpretarla en contexto y solucionar la capa correcta más rápido.
Si estás ajustando los contratos de solicitud, reduciendo las cargas útiles incorrectas o intentando evitar que la desviación del esquema rompa tu pipeline, digna ofrece a los equipos de datos una forma de monitorear la validación, los cambios de esquema y el comportamiento de los datos dentro de su propio entorno. Visita digna para ver cómo sus módulos de Data Observability y validación encajan en la misma capa de confiabilidad de la que ya dependen tus APIs.


