Observabilidad de la calidad de datos: guía práctica para equipos de datos
|
8
minuto de lectura

Seguro que conoce la sensación. A las 6:45 un dashboard parece estar perfecto, a las 8:00 las cifras ya no cuadran, el VP pregunta por qué los ingresos cambiaron de la noche a la mañana y el equipo de datos revisa logs de pipelines mientras todos los demás esperan una respuesta. Eso es data downtime, y es una de las formas más rápidas de convertir una capa de reporting fiable en un riesgo.
La observabilidad de la calidad de datos cambia esa postura. En lugar de esperar a que fallen los dashboards, vigila el comportamiento de los datos mientras se mueven, para que los equipos detecten retrasos en la frescura, schema drift, cambios de volumen y fallos de validación antes de que lleguen a las decisiones. No se trata de tener más alertas. Se trata de tener señales más tempranas, un triaje más limpio y menos tiempo dedicado a explicar por qué no se puede confiar en las cifras.
Índice de contenidos
El coste oculto de los datos defectuosos
Un incidente de lunes por la mañana rara vez empieza de forma dramática. Empieza con una tabla desactualizada, una carga que falta o un cambio de esquema silencioso que nadie detectó a tiempo. Cuando el problema sale a la luz, el daño ya ha pasado del data warehouse al negocio.
Es fácil subestimar la magnitud de este problema. Una encuesta de Wakefield Research de 2023 encargada por Monte Carlo reveló que los incidentes de datos mensuales aumentaron de 59 en 2022 a 67 en 2023, un aumento de 1,89 veces en el data downtime, y que el 68% de los encuestados necesitó cuatro horas o más para detectar incidentes. La misma encuesta indicó un tiempo medio de resolución de 15 horas por incidente, y más de la mitad de los encuestados afirmó que al menos el 25% de los ingresos estaba expuesto a problemas de calidad de datos, con una cuota media de ingresos afectados que subió al 31% desde el 26% del año anterior, según recoge una visión general del mercado de esta categoría en el informe de mercado de data observability.
Cómo se ve en la práctica
Una analista financiera actualiza una presentación para el consejo y detecta una cifra que no coincide con la exportación de ayer. Un data engineer revisa los logs de orquestación y ve que el pipeline terminó correctamente, lo cual es peor, no mejor, porque ahora el problema se esconde en el contenido y no en el estado del job. El equipo empieza a comparar recuentos de filas, a buscar cambios de esquema y a escribir a responsables que quizá ni siquiera saben que causaron el fallo.
Regla práctica: si la primera señal de un problema es la pregunta de un usuario de negocio, la capa de monitorización ya está demasiado aguas abajo.
Por eso importa la observabilidad. No sustituye el análisis de causa raíz ni hace que los datos sean correctos por arte de magia. Le avisa antes, para que el equipo deje de tratar cada incidente como una sorpresa y empiece a tratarlo como un riesgo operativo controlable.

Los mejores equipos con los que he trabajado dejaron de preguntarse «¿Por qué se rompió este dashboard?» y empezaron a preguntarse «¿Qué cambió antes de que se rompiera el dashboard?». Ese cambio lo es todo. La observabilidad de la calidad de datos le da una forma de responder a esa pregunta antes de que el negocio pague el precio.
Entender la observabilidad de la calidad de datos
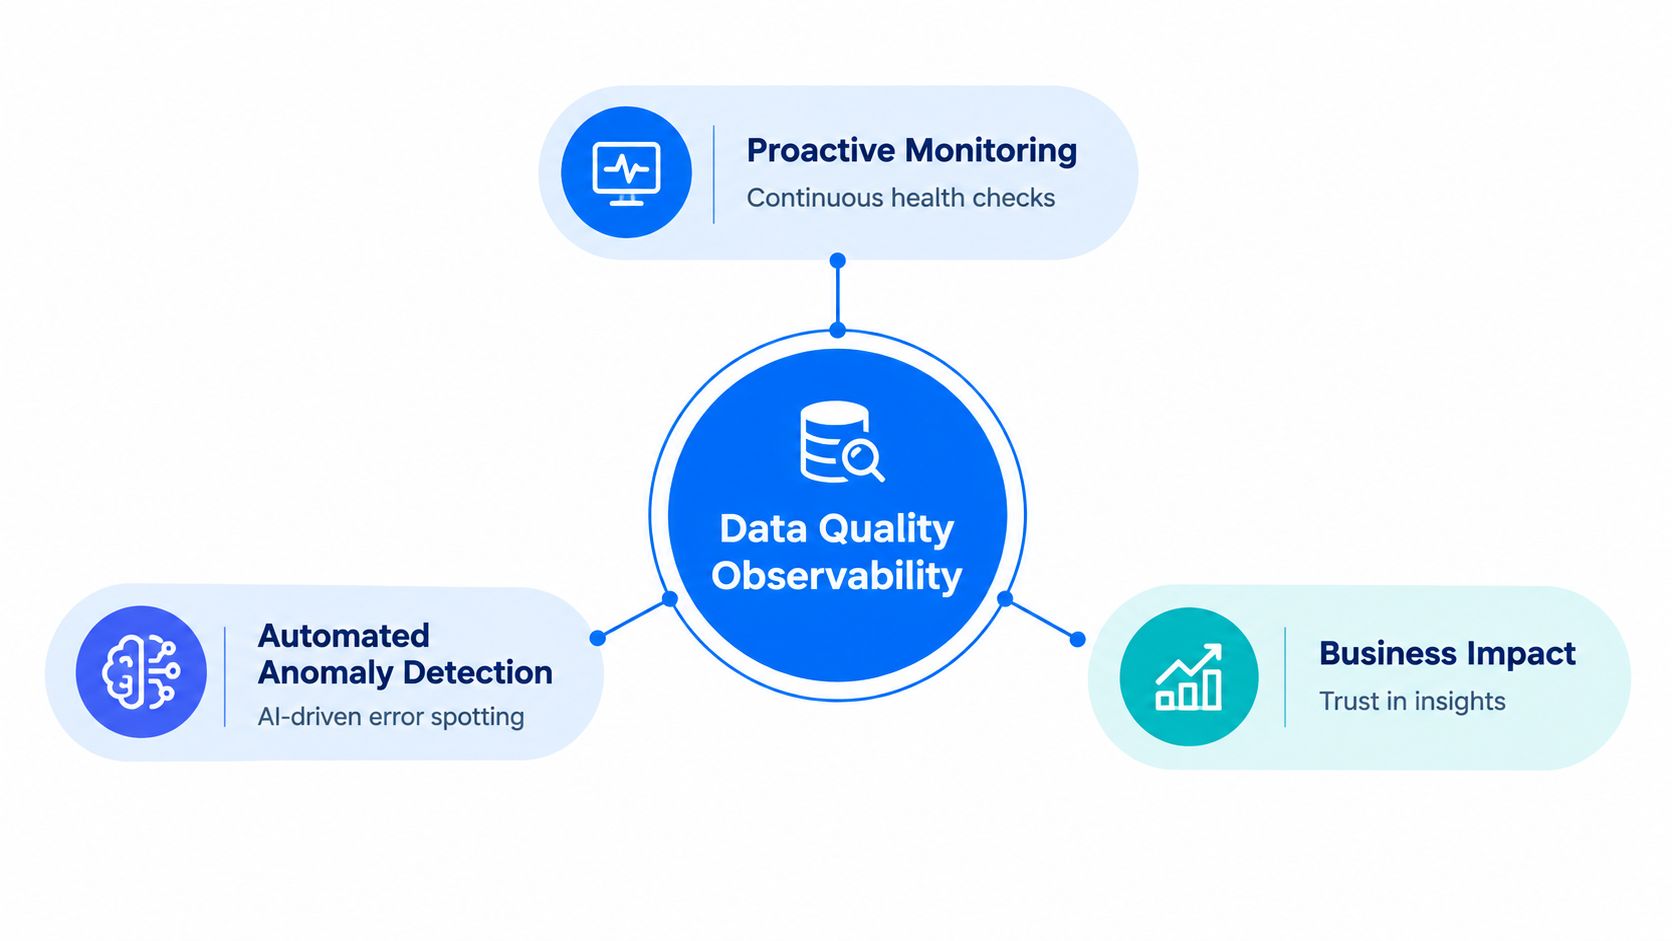
Un dashboard puede parecer sano mientras el pipeline que lo alimenta se desvía. Una tabla de origen puede seguir cargándose a tiempo, pero el esquema cambia por debajo, una transformación empieza a alterar los valores y los informes posteriores siguen siendo erróneos hasta que alguien detecta la discrepancia. La observabilidad de la calidad de datos se centra en esas señales del sistema, no solo en el resultado final a nivel de fila.
De las reglas a las señales
Los controles basados en reglas siguen siendo importantes. Son precisos, auditables y útiles cuando hay que aplicar lógica de negocio a nivel de registro. Pero también se les escapan muchas cosas, porque solo detectan lo que ya esperaba que fallara. La observabilidad analiza señales externas como la frescura, el volumen, el esquema, la distribución y el linaje, y usa esos patrones para mostrar si el pipeline se comporta con normalidad, tal como lo definen las guías prácticas de observabilidad.
Este cambio es especialmente relevante cuando entra en juego el schema drift. Si una fuente añade, elimina, renombra o cambia el tipo de una columna, una transformación frágil puede fallar sin previo aviso o enviar valores mal formados a la analítica posterior antes de que nadie lo note, el schema drift es una señal central de observabilidad. La observabilidad detecta el propio cambio estructural en lugar de esperar a que aparezca el resultado erróneo.
La fatiga de alertas es la contrapartida. Las reglas estáticas pueden generar un flujo interminable de alertas de poco valor, sobre todo cuando los cambios en los datos son normales para el negocio. La monitorización basada en el comportamiento reduce ese ruido al preguntarse si el patrón ha cambiado de forma significativa, algo que encaja mejor con los pipelines modernos y con la manera en que los equipos investigan los incidentes.
La observabilidad es más potente cuando vigila cómo se comportan los datos, no solo si una fila cumple una regla.
Qué monitorizar primero
Empiece por las señales que le indican si el pipeline está vivo y es coherente.
Frescura: los datos que llegan tarde suelen ser la primera señal de un pipeline detenido o degradado.
Volumen: los picos o caídas repentinos pueden indicar problemas de ingesta, duplicados o cargas parciales.
Esquema: los cambios inesperados en los campos suelen ser el camino más rápido hacia transformaciones rotas.
Distribución: los cambios en los patrones de valores pueden revelar una corrupción silenciosa que sigue pareciendo válida a nivel de tabla.
Linaje: saber de dónde vienen los datos y hacia dónde fluyen le ayuda a rastrear el impacto en lugar de adivinarlo.
El objetivo práctico es sencillo. Si los controles de calidad de datos le dicen si un registro es aceptable, la observabilidad le dice si todo el flujo se comporta de una manera en la que puede confiar. Para un tratamiento más completo de cómo las señales de comportamiento sustituyen a las reglas estáticas, consulte la visión general de data observability.
Señales clave para monitorizar la salud de los datos
La monitorización funciona mejor cuando cada señal se asocia a un modo de fallo y a una consecuencia de negocio. Los controles tradicionales basados en reglas siguen siendo útiles, pero a menudo tratan cada desviación como igual de urgente. La observabilidad impulsada por IA añade líneas base de comportamiento y ayuda a los equipos a distinguir la variación esperada de un patrón que amenaza la disponibilidad de los datos, el reporting posterior o las decisiones operativas. El objetivo es tener menos alertas de poco valor y atender antes el data downtime.
Frescura, volumen, esquema y validación trabajan juntos
Timeliness suele ser la primera advertencia de que un pipeline se ha detenido o degradado. Las implementaciones modernas aprenden la cadencia de entrega de un conjunto de datos, calculan cuándo debería llegar la siguiente carga y lanzan una alerta cuando se retrasa o no llega, tal como se describe en las guías de monitorización operativa. La lógica de Timeliness también puede identificar entregas que llegan antes de lo esperado, algo importante cuando una fuente se aparta de su ritmo habitual, ese patrón basado en la cadencia también se trata en guías de plataformas.
La detección de anomalías aporta contexto a un simple umbral. Un pico en una tabla de actividad de clientes puede reflejar una campaña legítima o un feed duplicado que vuelve a cargar registros. Un modelo de comportamiento no puede determinar por sí solo la explicación de negocio, pero sí puede señalar un cambio significativo antes de que los analistas confíen en los datos afectados.
El seguimiento del esquema limita los fallos estructurales aguas abajo. Un feed financiero puede añadir un campo que admite nulos, o un extracto sanitario puede cambiar una definición de tipo sin mostrar un problema evidente en el origen. El fallo puede aparecer más tarde en una transformación, un modelo o un dashboard, donde el diagnóstico cuesta más tiempo.
La validación conecta la observabilidad con las reglas de negocio. Los controles a nivel de fila comparan los valores con formatos, longitudes y métricas de calidad esperados. Respaldan el trabajo de cumplimiento normativo, las evidencias de auditoría y la revisión dirigida de registros de alto riesgo. La validación a nivel de fila está descrita en la literatura sobre verificación.
Una guía de métricas de data observability puede ayudarle a asociar cada métrica con el modo de fallo que pretende revelar.
Señal | Qué detecta | Qué no detecta |
|---|---|---|
Frescura | Cargas tardías o ausentes | Significado de negocio incorrecto |
Volumen | Datos ausentes, duplicados, feeds recargados | Errores detallados a nivel de fila |
Esquema | Campos añadidos, eliminados, renombrados o con cambio de tipo | Errores semánticos en columnas válidas |
Validación | Infracciones de reglas a nivel de registro | Comportamientos inesperados fuera del conjunto de reglas |
El alcance importa más que la cobertura
El coste principal no está en elegir las señales. Está en aplicarlas de forma indiscriminada en grandes entornos de datos, múltiples stacks y muchas tablas. Una cobertura más amplia aumenta la carga de cómputo, metadatos y alertas, una advertencia práctica que destaca Databricks. El exceso de alertas también genera fatiga operativa. En cuanto los ingenieros dejan de confiar en las notificaciones, una caída real de datos puede quedar oculta detrás de la variación rutinaria.
Priorice los pipelines cuyo fallo afectaría a los ingresos, el reporting, el cumplimiento normativo o las operaciones con clientes. La detección impulsada por IA puede reducir las alertas repetitivas por umbral, mientras que la validación explícita sigue siendo adecuada para las reglas conocidas. Usados juntos, estos enfoques producen un flujo de alertas más tranquilo, con responsabilidades más claras y una respuesta más rápida a los incidentes.
Patrones de arquitectura para la observabilidad
La mayoría de los fracasos de observabilidad se deben a decisiones de arquitectura, no a la señal de monitorización en sí. Los equipos o bien trasladan demasiados datos a una herramienta independiente, o bien añaden controles a posteriori y esperan que la latencia y las concesiones de seguridad no importen. En la práctica, la arquitectura tiene que respetar dónde residen ya los datos.
Mantener los controles cerca de los datos
El patrón más sólido es la ejecución dentro de la base de datos. La lógica de monitorización se ejecuta dentro del data warehouse o del data lake, de modo que los datos permanecen donde están y el equipo evita movimientos innecesarios entre sistemas. Eso importa tanto para la seguridad como para el rendimiento, especialmente cuando la plataforma ya gestiona conjuntos de datos sensibles o cargas de trabajo pesadas.
Aquí es también donde la modularidad demuestra su valor. Un stack de observabilidad monolítico puede ser difícil de adoptar porque obliga a los equipos a un despliegue amplio antes de haber demostrado su valor. Una configuración modular le permite empezar por un problema, como el schema drift o la puntualidad, y ampliar después a la validación o la monitorización de negocio una vez que la primera señal funcione.
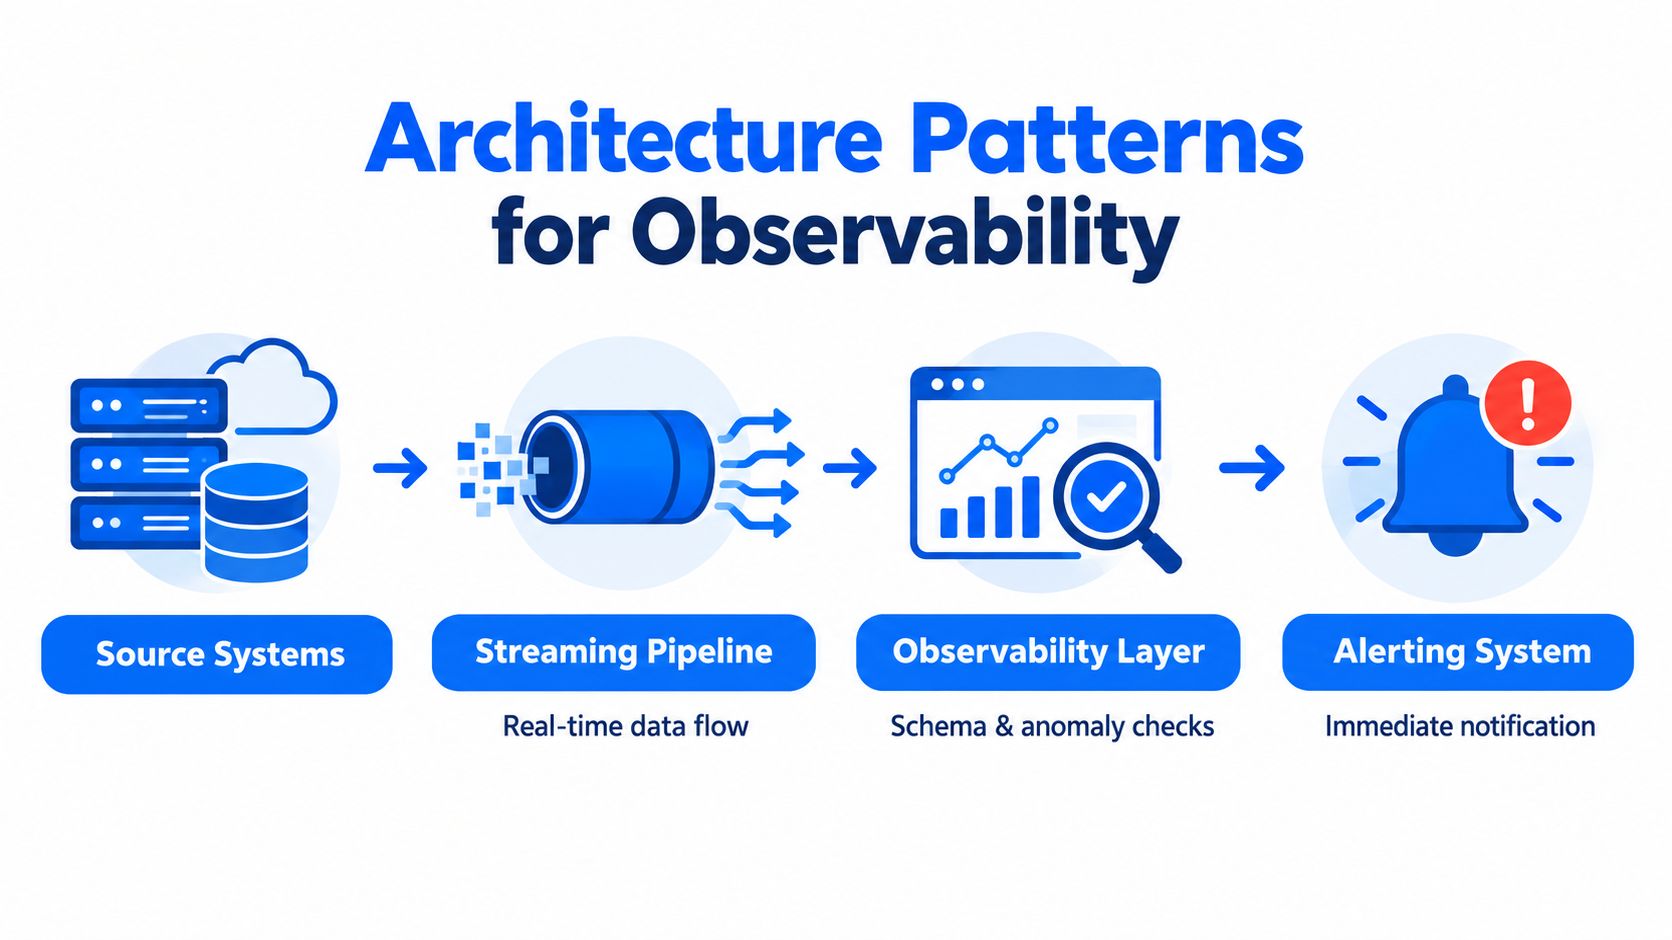
Una arquitectura limpia suele seguir esta secuencia:
Los sistemas de origen emiten datos operativos o analíticos.
Los pipelines de streaming o batch trasladan los datos al entorno gobernado.
Una capa de observabilidad evalúa las señales de frescura, esquema y anomalías allí donde ya residen los datos.
Un sistema de alertas envía solo los incidentes relevantes al responsable adecuado.
Por qué las plataformas modulares son más fáciles de poner en operación
Una plataforma modular mantiene acotado el radio de impacto cuando introduce la observabilidad en un stack maduro. Puede dirigirla primero a las tablas más importantes y ampliarla a medida que el equipo confíe en la calidad de las señales. Eso también facilita el despliegue para los equipos de data engineering, porque la lógica de monitorización evoluciona junto con los pipelines en lugar de imponer un modelo operativo aparte.
La guía de arquitectura de observabilidad de digna encaja bien con ese patrón modular, sobre todo para equipos que quieren mantener la monitorización cerca del data warehouse o del data lake en lugar de construir una capa desacoplada que resulta cara de mantener.
No se trata de arquitectura por la arquitectura. Se trata de reducir la fricción, reducir el movimiento de datos y asegurarse de que la capa de monitorización no se convierta en otra fuente de ruido operativo.
El papel de la observabilidad en analítica e IA
Tanto la analítica como la IA fallan rápido cuando los datos de entrada se desvían. Un dashboard puede ser erróneo porque un feed llega tarde. Un modelo puede volverse poco fiable porque cambian los valores de las features. En ambos casos, el problema suele ser invisible hasta que el negocio ve el efecto.
Por qué la IA eleva el listón
Una fuente de 2025 sobre la brecha entre mercado y adopción señaló que el 48% de los encuestados considera la baja calidad de datos la principal barrera para estar preparados para la IA, mientras que otra encuesta reveló que el 74% de las organizaciones considera importante monitorizar los procesos de negocio críticos y el 54% afirma que la calidad de la detección de alertas es lo que más influye en el ROI de la observabilidad, según resume el análisis de los actores del mercado. No son cifras abstractas. Muestran que los equipos ya no tratan la observabilidad como un asunto de ingeniería de nicho, sino como un requisito previo para la IA y el reporting a la dirección.
Esto importa porque los pipelines de IA no dependen solo de registros limpios. Dependen de entradas estables, de un comportamiento predecible de las features y de señales posteriores fiables. Si los datos que alimentan el modelo cambian de forma, el modelo puede seguir devolviendo un resultado, pero ese resultado puede perder utilidad sin ninguna señal de fallo evidente.
Las métricas de negocio merecen la misma disciplina
La observabilidad también ha ido más allá de la monitorización clásica de pipelines y se ha extendido a la monitorización de procesos de negocio. Ese cambio es importante, porque a la dirección no le importa si un diff de esquema fue interesante. Le importa si la pérdida de clientes, el volumen de pedidos, la tramitación de siniestros u otros KPI de negocio se salieron del rango esperado. Monitorizar esas métricas sobre los datos subyacentes ofrece a los equipos una forma más temprana de ver las desviaciones operativas, sin esperar a que la capa de reporting las ponga de manifiesto.
La guía de preparación para la IA de digna se alinea con esa visión más amplia, porque la observabilidad ya no trata solo de la salud técnica. Se trata de demostrar que la base de datos puede sostener la analítica, la automatización y la IA sin crear puntos ciegos.
Cuando los equipos lo hacen bien, dejan de preguntarse si el dashboard funciona. Empiezan a preguntarse si las señales que hay detrás del dashboard siguen mereciendo confianza.
Plataformas modulares y ejemplos reales
La ventaja de la observabilidad modular es que permite a los equipos resolver un problema concreto de fiabilidad sin tener que adquirir todo un nuevo modelo operativo. Eso es importante en entornos empresariales, donde los equipos de finanzas, sanidad, telecomunicaciones y sector público se enfrentan a patrones de fallo distintos y a distintos niveles de tolerancia al ruido.
Dónde encaja la observabilidad modular
Un equipo de servicios financieros suele preocuparse por los tiempos, la integridad de las transacciones y el reporting posterior. Si un feed regulatorio llega tarde, el problema no es solo operativo. Afecta a la confianza en el reporting y puede acabar provocando el incumplimiento de plazos. Una plataforma modular puede centrarse primero en la puntualidad y la detección de anomalías para los feeds críticos, y añadir después el seguimiento del esquema y la validación donde más importan las reglas de negocio.
Un equipo sanitario tiene otras restricciones. Los conjuntos de datos clínicos y operativos suelen necesitar validación, estabilidad estructural y trazabilidad entre sistemas de origen. Los cambios de esquema en un pipeline de historia clínica electrónica pueden ser tan disruptivos como una entrega tardía, porque pueden romper la analítica o los flujos de reporting posteriores aunque el sistema de origen parezca estar bien.
Por qué una sola plataforma puede seguir siendo específica
digna es una opción en esta categoría, y su configuración modular combina detección de anomalías impulsada por IA, monitorización de Timeliness, seguimiento del esquema y validación a nivel de registro dentro del propio entorno del cliente. Ese modelo resulta útil cuando los equipos quieren mantener los datos donde están y añadir observabilidad sin trasladar datos de producción a un servicio externo independiente.
La página de casos de uso de digna es adecuada para equipos que comparan cómo encajan estos módulos con distintas necesidades operativas. Lo importante, sin embargo, no es la marca. Es el principio de diseño: empiece por las señales que corresponden a sus pipelines de mayor riesgo y amplíe solo donde la monitorización aumente la confianza más de lo que añade carga.
Si una plataforma no puede explicar por qué una alerta importa al negocio, todavía no está terminada.
Ese principio se cumple en todos los sectores. El mejor despliegue de observabilidad suele ser el que empieza con un alcance reducido, demuestra su valor y luego crece solo donde el equipo puede mantener la señal limpia.
Desmontando ideas erróneas comunes
La idea errónea más extendida es que la observabilidad es solo una forma más elegante de encontrar registros incorrectos. No lo es. La calidad de los registros sigue importando, pero el problema más difícil es decidir qué merece atención, porque cada nueva tabla monitorizada añade coste, metadatos y carga de alertas.
Más monitorización no siempre significa más confianza
Un flujo de alertas ruidoso puede minar la confianza más rápido que no tener monitorización alguna. Cuando cada desviación menor activa un aviso, los ingenieros empiezan a ignorar las advertencias y el sistema pierde credibilidad. Por eso el control del alcance es tan importante, sobre todo en grandes entornos donde monitorizarlo todo por igual es caro y distrae.
Otro error habitual es suponer que la observabilidad es solo para grandes empresas. Los equipos más pequeños también se benefician, pero solo si se centran en los pipelines más importantes. Si un equipo de datos de tres personas monitoriza cada tabla de poco valor del data warehouse, se ahogará en trabajo que no necesita.
Aplique la observabilidad donde el negocio siente el dolor
La regla práctica es sencilla. Vigile primero los activos en los que un retraso, una desviación o un fallo afectaría al reporting, a la experiencia del cliente, al cumplimiento normativo o a la calidad de los modelos. Una vez estabilizados, amplíe a los conjuntos de datos adyacentes con la misma disciplina.
Una buena observabilidad reduce la incertidumbre. Una mala observabilidad solo crea una versión más pulida de la fatiga de alertas.
Esa es la contrapartida fundamental. Detectar más solo es útil si el equipo puede actuar, y hacerlo lo bastante rápido como para que importe. Si no, la capa de monitorización se convierte en otra fuente de fricción.
Cómo construir su estrategia de observabilidad de datos
Una estrategia viable empieza por los pipelines que más daño harían si fallaran. Parece obvio, pero muchos equipos siguen empezando por instrumentar el conjunto de datos más fácil en lugar del más importante. El resultado es un dashboard impecable sobre una tabla de bajo riesgo y ninguna protección real allí donde el negocio está realmente expuesto.
Empezar por las rutas críticas, no por una cobertura amplia
Identifique las tablas, los feeds y los informes posteriores que impulsan las finanzas, las operaciones, la experiencia del cliente o las cargas de trabajo de IA. Después, defina qué señales importan más en cada caso. En un pipeline, una carga tardía puede ser el problema clave, mientras que en otro importan más los cambios de esquema o de distribución.
A partir de ahí, use la observabilidad para reducir la creación manual de reglas. Eso no significa abandonar la validación. Significa reservar los controles exhaustivos a nivel de registro para los activos en los que la corrección de negocio es más importante, y dejar que la monitorización basada en el comportamiento cubra el resto del entorno. Ese equilibrio mantiene el sistema práctico.
Diseñar para actuar, no solo para detectar
Las alertas deben conducir a la asignación de responsables, al triaje y a la resolución. Si la plataforma no puede enviar un incidente al equipo propietario de los datos, la señal no se convertirá en una solución. Si la alerta no muestra el probable impacto aguas abajo, los ingenieros dedicarán demasiado tiempo a reconstruir a mano el radio de impacto.
Obtendrá mejores resultados si toma estas tres decisiones desde el principio:
Elija primero los pipelines de alto impacto: monitorice los datos cuyo fallo cambiaría las decisiones de negocio.
Separe la señal del ruido: ajuste las alertas para que el equipo vea desviaciones significativas, no cada pequeña fluctuación.
Mantenga simple el modelo operativo: use capacidades modulares para que la observabilidad crezca con el stack en lugar de desbordarlo.
El objetivo a largo plazo es la confianza, no las herramientas. Cuando la monitorización forma parte de cómo el equipo entrega datos fiables, los equipos de analítica avanzan más rápido, los usuarios de negocio hacen menos preguntas a la defensiva y el data engineering deja de pasarse la semana arreglando incidentes evitables.
Si está afinando su estrategia de observabilidad de la calidad de datos, digna ofrece a los equipos detección de anomalías modular, controles de Timeliness, seguimiento del esquema y validación dentro de su propio entorno. Visite digna para ver cómo este enfoque puede respaldar una analítica y una IA fiables sin añadir movimientos de datos innecesarios ni ruido operativo.
Si quiere ver cómo es este enfoque modular y dentro de la base de datos en toda una plataforma, desde la frescura y los cambios de esquema hasta las anomalías y la validación, nuestra página de observabilidad de plataformas de datos muestra cómo digna monitoriza estas señales sin sacar los datos de su entorno.
Preguntas frecuentes
¿Qué es la observabilidad de la calidad de datos?
La observabilidad de la calidad de datos vigila cómo se comportan los datos mientras se mueven por los pipelines, usando señales como la frescura, el volumen, el esquema, la distribución y el linaje. En lugar de esperar a que falle un dashboard, señala con antelación las cargas tardías, el schema drift o los cambios de volumen, para que los equipos se pregunten qué cambió antes de que fallara el dashboard y no por qué falló.
¿En qué se diferencia la data observability de los controles de calidad de datos basados en reglas?
Los controles basados en reglas solo detectan los problemas que ya se esperaban, mientras que la observabilidad aprende el comportamiento normal y señala los cambios significativos. Las reglas siguen siendo valiosas para una lógica precisa y auditable a nivel de registro, pero no detectan fallos inesperados y pueden inundar a los equipos con alertas de poco valor. El artículo recomienda mantener la validación para las reglas conocidas y dejar que la monitorización basada en el comportamiento cubra el resto.
¿Qué señales de data observability debería monitorizar primero?
Empiece por la frescura, el volumen, el esquema, la distribución y el linaje, porque muestran si un pipeline está vivo y es coherente. Cada una se corresponde con un modo de fallo: la frescura detecta cargas tardías o ausentes, el volumen detecta duplicados y feeds recargados, y el esquema detecta campos añadidos, eliminados, renombrados o con cambio de tipo, aunque ninguna de ellas detecta por sí sola los errores semánticos.
¿Cuánto se tarda en detectar un incidente de datos?
A menudo más de lo que los equipos esperan: en una encuesta de Wakefield Research de 2023, el 68% de los encuestados necesitó cuatro horas o más para detectar incidentes de datos. La resolución llevó de media 15 horas por incidente y los incidentes mensuales pasaron de 59 a 67 de un año a otro, por lo que una señal más temprana importa más que apagar fuegos más rápido.
¿Deberían ejecutarse los controles de observabilidad dentro del data warehouse?
Sí, la ejecución dentro de la base de datos es el patrón de arquitectura más sólido, porque la lógica de monitorización se ejecuta donde ya residen los datos en lugar de copiarlos a una herramienta independiente. Eso mejora la seguridad y el rendimiento en cargas de trabajo sensibles o pesadas, y una configuración modular permite a los equipos empezar por un solo problema, como el schema drift, antes de ampliar.



