Libro de jugadas para la mejora de la calidad de los datos para equipos empresariales
|
6
minuto de lectura

Un cuadro de mando de ingresos trimestrales puede parecer perfectamente saludable mientras sobreestima las reservas de EMEA durante semanas. Una actualización del proveedor cambia una columna de moneda del sistema de origen, los valores nulos comienzan a fluir hacia el almacén de datos y una transformación posterior interpreta incorrectamente los valores faltantes. Finanzas descubre el problema durante la preparación de la junta, después de que los analistas ya hayan distribuido informes y los líderes hayan tomado decisiones a partir de ellos.
Ese incidente no es principalmente un problema del cuadro de mando. Es un fallo en la mejora de la calidad de los datos que involucra el control de esquemas, la puntualidad, la propiedad y la respuesta a incidentes. La solución no es otra compra de monitoreo aislada. Es un modelo operativo que define qué significan los datos confiables, asigna la responsabilidad a los equipos que los crean, detecta defectos cerca de su origen y mide la rapidez con la que la organización restaura la confianza.
Tabla de Contenidos
Por qué la mayoría de los programas de calidad de datos se estancan antes de comenzar
Validación, detección de anomalías, Timeliness y controles de esquema
Ejecución en base de datos, integración de flujos de trabajo y guías de ejecución
Por qué la mayoría de los programas de calidad de datos se estancan antes de comenzar
La primera respuesta a un incidente como el ejemplo de EMEA suele ser predecible. Alguien propone una plataforma de calidad de datos, otro equipo construye un cuadro de mando de tasas de nulos y un centro de excelencia publica estándares que los productores nunca ven. La organización crea una actividad visible sin cambiar las condiciones que permitieron que el defecto pasara.
La herramienta rara vez es el modelo operativo
Una herramienta de calidad puede calcular métricas, ejecutar reglas y enrutar alertas. No puede decidir si el equipo de finanzas o el equipo de sistemas comerciales es el propietario del campo de la moneda. Tampoco puede determinar si un valor faltante debe bloquear una carga, poner en cuarentena los registros afectados o generar una advertencia mientras continúa el procesamiento.
Esa decisión requiere un contrato documentado entre productores y consumidores. Sin él, los equipos debaten las alertas después del incidente en lugar de ponerse de acuerdo de antemano sobre el comportamiento aceptable. Un análisis útil de las causas estructurales aparece en este análisis de por qué fallan los proyectos de calidad de datos, particularmente la distinción entre síntomas técnicos y causas organizativas.
La cobertura debe extenderse más allá de la completitud
Las tasas de nulos son útiles, pero una tabla puede estar completa y aun así estar incorrecta. Un flujo de datos puede llegar tarde, contener un esquema modificado, usar un código de moneda no válido o introducir claves de negocio duplicadas. Los equipos que miden solo la completitud crean una falsa sensación de control porque están verificando una sola dimensión mientras ignoran la ventana de decisión y el significado de los datos.
Un programa de trabajo asigna controles a los riesgos que importan:
Estándares: Definiciones, valores aceptados, propiedad y procedimientos de cambio.
Responsabilidad: Productores y administradores designados con autoridad para resolver defectos.
Retroalimentación: Alertas, tickets, retrospectivas y cambios en las canalizaciones para evitar la recurrencia.
La calidad también necesita una perspectiva económica. El resumen del IBM Institute for Business Value informó que el 43% de los directores de operaciones identificaron los problemas de calidad de datos como su prioridad de datos más importante. Más de una cuarta parte de las organizaciones informaron pérdidas anuales superiores a 5 millones de USD, mientras que el 7% informó pérdidas de 25 millones de USD o más. Esas cifras explican por qué la calidad pertenece a las revisiones operativas y no solo a los backlogs de ingeniería.
La unidad práctica de progreso es el ciclo de incidente a resolución. Un programa está funcionando cuando detecta fallos antes, los enruta al propietario correcto, limita la exposición posterior y convierte cada hallazgo posterior al incidente en un control de canalización más sólido.
Evaluación de su estado actual de calidad de datos
Comience con evidencia, no con la frustración de las partes interesadas. La gente a menudo dice que no confía en un conjunto de datos, pero esa percepción puede reflejar un puñado de incidentes visibles, definiciones poco claras o defectos medibles. Su línea de base debe capturar los tres.
Construir la línea de base a partir de cuatro flujos de evidencia
Primero, realice una arqueología de incidentes. Exporte los últimos seis meses de tickets relacionados con datos de Jira o ServiceNow. Agrupe cada ticket por dominio, conjunto de datos afectado, tipo de defecto, causa raíz, tiempo de detección, tiempo de resolución y si el mismo problema había aparecido antes. No descarte los tickets "pequeños". Las correcciones manuales repetidas a menudo revelan una debilidad del proceso que una interrupción mayor expondrá más adelante.
Segundo, profile las tablas críticas automáticamente. Examine las tasas de nulos, la cardinalidad distinta, los valores mínimos y máximos, las claves duplicadas, la integridad referencial y los cambios en la distribución. Compare los recuentos de origen y destino donde sea apropiado, pero no trate los recuentos de filas coincidentes como prueba de corrección. Una transformación puede preservar el volumen mientras corrompe los valores.
Tercero, encueste a productores y consumidores por separado. Pregunte a los productores qué campos creen que poseen y a los consumidores si los datos son adecuados para sus decisiones. Capture puntuaciones cualitativas de confianza junto con patrones de uso, informes críticos, modelos y flujos de trabajo operativos. Un conjunto de datos de alto uso con baja confianza merece prioridad incluso si su historial de incidentes es tranquilo.
Cuarto, clasifique los defectos según las seis dimensiones. Utilice la precisión, la completitud, la consistencia, la puntualidad, la validez y la unicidad como un vocabulario compartido. El modelo de madurez de calidad de datos puede ayudar a los equipos a convertir observaciones dispersas en una línea de base repetible en lugar de un taller único.
Crear una instantánea de madurez medible
Califique cada dimensión en una escala del 1 al 5, utilizando evidencia explícita. Una puntuación baja podría significar que la organización no tiene una definición compartida o una medición repetible. Una puntuación media podría indicar comprobaciones automatizadas pero una propiedad inconsistente. Una puntuación alta debería requerir umbrales documentados, controles monitoreados, propietarios responsables, historial de incidentes y mejoras regulares.
Dimensión | Métrica Primaria | Enfoque de Muestreo | Fuente de Detección Típica |
|---|---|---|---|
Precisión | Concordancia con una fuente autorizada o resultado verificado | Comparar campos críticos con registros de origen o datos de referencia aprobados | Conciliación, revisión del consumidor |
Completitud | Tasas de nulos, registros faltantes y campos obligatorios | Comprobaciones de tabla completa para campos críticos, comprobaciones muestreadas para atributos de menor riesgo | Perfilado, pruebas de validación |
Consistencia | Concordancia entre sistemas, tablas y definiciones | Comparar claves compartidas, unidades, etiquetas y valores calculados | Conciliación entre sistemas |
Timeliness | Llegada y disponibilidad frente a la ventana de decisión | Monitorear cada partición esperada o evento de entrega | Monitor de programación, registros de canalización |
Validez | Conformidad con tipos, rangos, formatos y reglas de negocio | Comprobaciones completas para campos restringidos, muestreo específico para registros complejos | Comprobaciones de esquema, motor de reglas |
Unicidad | Tasa de duplicados para claves de negocio definidas | Escaneos de clave completa o detección incremental de duplicados | Restricciones de base de datos, perfilado |
Mantenga la línea de base versionada. Una puntuación sin las pruebas, muestras y definiciones subyacentes no puede respaldar la comparación trimestre a trimestre.
Definición de SLAs y KPIs que realmente se mantengan
Un SLA de calidad de datos necesita cuatro cosas: un propietario, un umbral, una ventana de medición y una ruta de escalación. Elimine cualquiera de ellas y el SLA se convertirá en una aspiración. "Mantener los datos actualizados" no es aplicable. "El flujo de datos de riesgo debe llegar dentro de su ventana de decisión acordada, alertando al propietario de los datos de riesgo cuando se supere el umbral" es operativo.
Clasificar los conjuntos de datos por nivel de consecuencia
No aplique la misma intensidad de control a todas las tablas. Clasifique los conjuntos de datos como críticos, operativos o exploratorios de acuerdo con el impacto comercial, la exposición regulatoria, la dependencia posterior y las expectativas de recuperación.
Los conjuntos de datos críticos respaldan los informes financieros, las decisiones de riesgo, las presentaciones regulatorias o las operaciones esenciales con los clientes. Los conjuntos de datos operativos impulsan los flujos de trabajo recurrentes y los informes de gestión. Los conjuntos de datos exploratorios respaldan el análisis donde los datos retrasados o imperfectos son inconvenientes pero no dañinos de inmediato.
Los umbrales deben reflejar el uso, no una tarjeta de puntuación universal. Una tabla de hechos de ingresos puede requerir un 95% de completitud, mientras que un flujo de datos de riesgo intradiario puede requerir un 98% de frescura, pero esas cifras solo importan cuando cada una está vinculada a un propietario, una ventana de medición definida y una respuesta explícita. El objetivo es hacer visible el compromiso comercial.
Separar las señales tempranas de las medidas de resultado
Los recuentos de filas y las tasas de nulos describen el estado de los datos después del procesamiento. Son indicadores rezagados útiles, pero no le dirán si el modelo operativo está mejorando. Agregue indicadores adelantados como la tasa de incumplimiento de SLA, el tiempo de reconocimiento, la tasa de defectos reportados por el consumidor, la tasa de incidentes recurrentes y el porcentaje de conjuntos de datos críticos con guías de ejecución vigentes.
Nivel | SLA de Frescura | KPI de Completitud | KPI de Validez | Responsabilidad del Propietario |
|---|---|---|---|---|
Crítico | Definido por la ventana de decisión y monitoreado por entrega | Campos requeridos medidos en cada carga | Las reglas de negocio bloquean o ponen en cuarentena fallas materiales | Administrador designado, propietario productor y escalación de guardia |
Operativo | Ventana de entrega acordada con estados de advertencia e infracción | Tendencia monitoreada frente a un umbral aprobado | Registros no válidos enrutados para corrección antes del consumo | El productor resuelve, el administrador confirma la idoneidad |
Exploratorio | Disponibilidad de mejor esfuerzo con estado visible | Perfilado periódicamente en lugar de bloquear el trabajo | Advertencias documentadas para limitaciones conocidas | El consumidor acepta o escala el riesgo |
Publique el SLA donde trabajan los productores. Colóquelo en el repositorio del almacén, la configuración de la canalización, la plantilla de solicitud de extracción y la guía de ejecución de incidentes. Un portal de gobernanza puede contener la definición canónica, pero no debería ser el único lugar donde los ingenieros puedan encontrar el contrato.
Validación, detección de anomalías, Timeliness y controles de esquema
Ningún control único detecta todos los defectos. La validación basada en reglas proporciona precisión donde se conoce el contrato. La detección impulsada por IA proporciona una cobertura más amplia donde el comportamiento normal es difícil de codificar. Los controles de Timeliness y de esquema abordan modos de falla que las comprobaciones a nivel de valor suelen pasar por alto.
Hacer coincidir el control con el defecto
La validación determinista es la opción correcta para los campos obligatorios, la unicidad, la integridad referencial, los conjuntos de valores aceptados, los tipos de datos y las reglas de negocio conocidas a nivel de fila. Es interpretable y fácil de conectar a una pista de auditoría. Su debilidad es el mantenimiento. Cada nueva regla requiere creación, prueba y propiedad, y una regla no puede detectar una falla que nadie anticipó.
La detección de anomalías aprende distribuciones normales, volúmenes, cardinalidad y comportamiento a lo largo del tiempo. Puede sacar a la luz desviaciones silenciosas, cambios inesperados y modificaciones en las cargas útiles de los proveedores sin necesidad de una regla para cada posibilidad. El compromiso es la interpretabilidad. Una alerta estadística necesita contexto, y los equipos deben ajustarla para que los eventos inusuales pero legítimos no generen fatiga por alertas.
El monitoreo de Timeliness verifica si los datos llegan y se vuelven utilizables dentro de su ventana de decisión. Una tabla que existe pero refleja el estado de ayer no es saludable para un proceso intradiario. Las pautas sobre monitoreo de validación y Timeliness de datos recomiendan umbrales de envejecimiento automatizados para que los registros obsoletos se marquen antes de que los flujos de trabajo posteriores dependan de ellos.
El seguimiento de esquemas controla las versiones de los tipos de columnas, la admisibilidad de nulos, las estructuras anidadas y la presencia de campos. Debe distinguir los cambios aditivos de los cambios disruptivos y la desviación semántica. Agregar una columna que admita nulos puede ser seguro para un consumidor y disruptivo para otro, por lo que el análisis de linaje y de impacto es importante.
Control | Qué detecta | Qué pasa por alto | Perfil de costo | Capa más adecuada |
|---|---|---|---|---|
Validación determinista | Violaciones de reglas conocidas y fallas de contrato | Nuevos patrones fuera de las reglas definidas | Esfuerzo predecible de creación y mantenimiento | Ingesta, normalización, servicio |
Detección de anomalías por IA | Cambios de distribución, volúmenes inusuales, desviación de comportamiento silenciosa | Contexto que requiere explicación comercial | Menor creación manual de reglas, mayor necesidad de ajuste | Monitoreo amplio en todas las canalizaciones |
Comprobaciones de Timeliness | Cargas omitidas, particiones retrasadas, datos obsoletos pero presentes | Valores que llegan a tiempo pero son incorrectos | Bajo una vez que se definen los horarios y las ventanas | Límites de ingesta y entrega |
Seguimiento de esquemas | Campos y estructuras agregados, eliminados o con tipo cambiado | Cambios de significado sin cambio estructural | Esfuerzo moderado de metadatos y propiedad | Contratos de origen y límites de canalización |
Los equipos que evalúan patrones de automatización también pueden revisar las perspectivas de automatización de Truespeak para obtener un contexto de flujo de trabajo más amplio. El programa de calidad aún debe decidir qué fallas bloquean el procesamiento, cuáles ponen registros en cuarentena y cuáles solo notifican a los consumidores. Más automatización no es automáticamente mejor si traslada la incertidumbre a una cola opaca.
Un enfoque en capas es más sólido que elegir entre reglas e IA. Utilice reglas de Data Validation y controles de calidad continuos para las obligaciones conocidas, y luego agregue la detección de anomalías para los casos atípicos.
In-Database Execution, Workflow Integration, and Runbooks
Ejecute comprobaciones en el límite donde se producen o transforman los datos. Las aserciones nativas, las pruebas dbt y el SQL programado mantienen la validación cerca de la tabla y facilitan la asociación de fallas con una carga, partición o transformación específica. Una capa de monitoreo separada puede agregar valor, pero no debería introducir un gran retraso entre la creación y la detección del defecto.
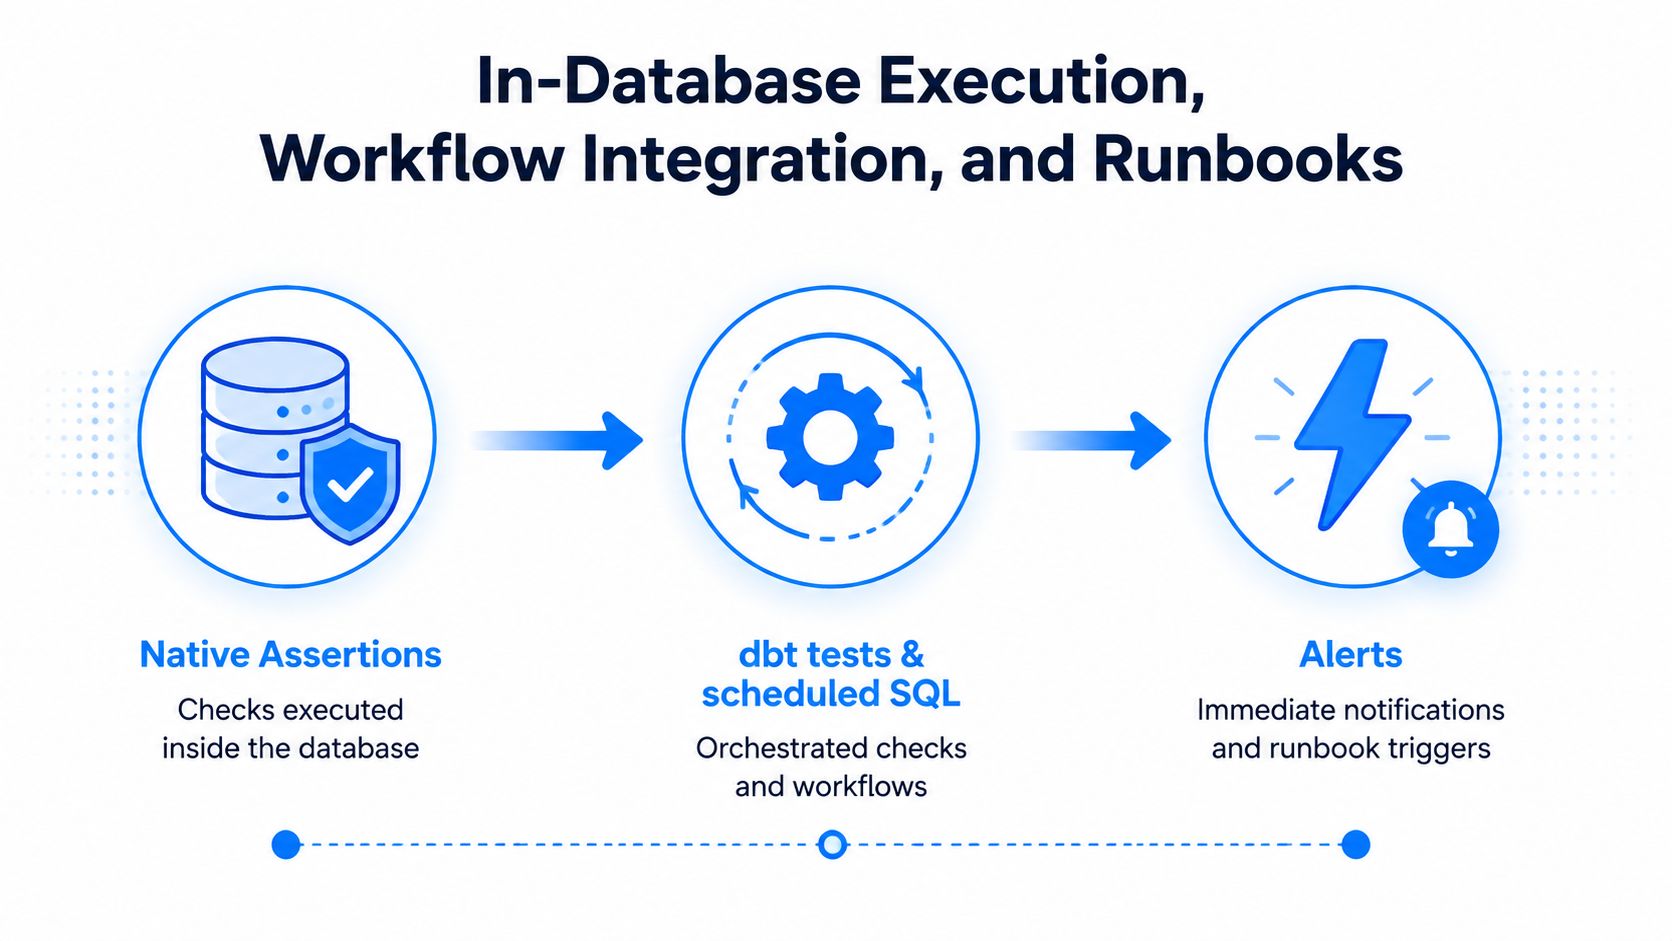
Enrutar las señales hacia el trabajo existente
Utilice un enrutamiento basado en la gravedad en lugar de enviar cada resultado a todos los canales.
Gravedad uno: Alerte al ingeniero de guardia a través de PagerDuty cuando un conjunto de datos crítico no esté disponible, sea materialmente inválido o esté fuera de su ventana de decisión.
Gravedad dos: Abra un hilo de Slack con el productor y el administrador cuando los consumidores se vean afectados pero exista una solución alternativa controlada.
Seguimiento: Cree un ticket de Jira para defectos recurrentes, mantenimiento de reglas, documentación o remediación de la canalización.
La guía de automatización de flujos de trabajo de datos es útil al diseñar estas transferencias, pero el principio es simple: las alertas deben llegar a la persona que puede cambiar el proceso de producción.
Hacer que la guía de ejecución sea ejecutable
Una guía de ejecución debería permitir a un ingeniero comenzar el diagnóstico sin necesidad de encontrar al autor original. Incluya:
Firma de la falla: La métrica, regla o programación que se incumplió.
Radio de impacto: Tablas, cuadros de mando, modelos, informes y procesos de negocio afectados.
Propietario probable: Productor, administrador, equipo de plataforma o proveedor externo.
Primeras tres consultas: Comprobaciones de valores de origen, salida de transformación e impacto posterior.
Paso de contención: Reversión, cuarentena, pausa de carga o notificación al consumidor.
Plantilla de comunicación: Qué sucedió, qué está afectado, qué deben hacer los usuarios y cuándo llegará la próxima actualización.
Desduplique las alertas dentro de una ventana definida, suprima las alertas secundarias cuando la falla de una canalización principal las explique, y agrupe los hallazgos de baja gravedad en un resumen. Antes de declarar el proceso como listo, realice un simulacro de incidentes. Confirme que la alerta se active, que el propietario esté localizable, que las consultas funcionen, que la reversión sea segura y que el ticket capture suficiente evidencia para una retrospectiva posterior.
Organización de equipos, propiedad y cadencia operativa
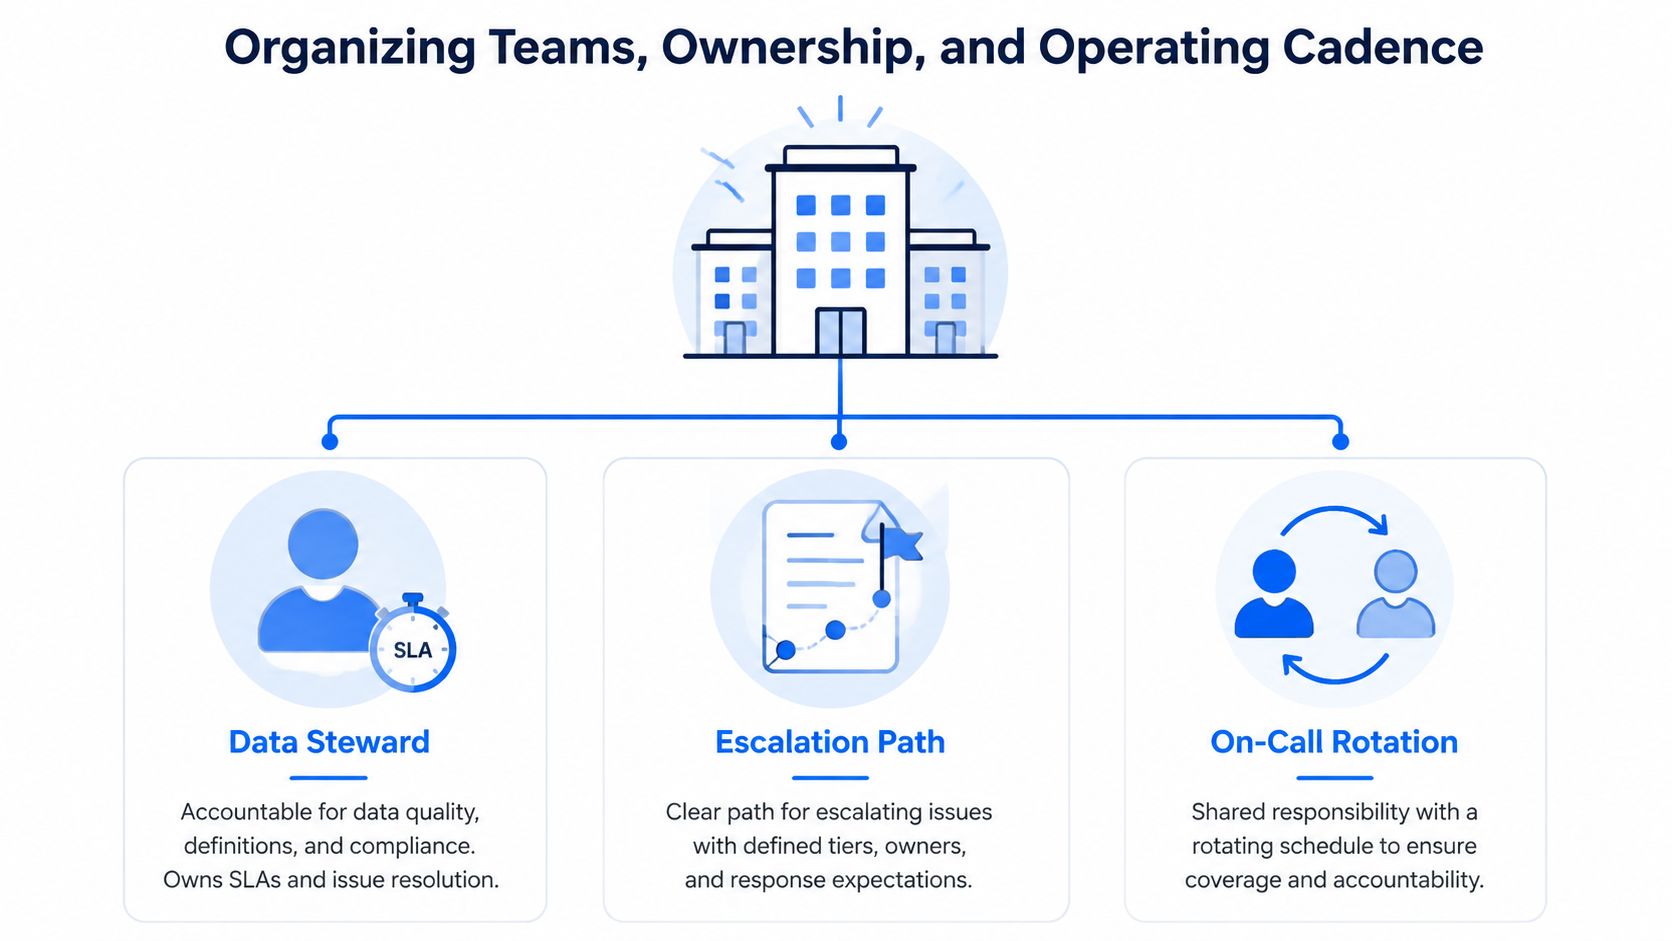
La propiedad se vuelve clara cuando cada conjunto de datos tiene un administrador designado, un productor, un consumidor y una ruta de escalación. Un centro de excelencia puede proporcionar patrones y asesoramiento, pero no debe ser responsable de un defecto que no puede corregir.
Separar los roles
El productor de datos es el propietario de la ingesta, los contratos de origen, los cambios de esquema y el comportamiento de la canalización. El administrador de datos es el propietario de las definiciones, las expectativas de calidad, la interpretación comercial y la coordinación de la resolución. El consumidor de datos valida si el conjunto de datos es adecuado para un informe, modelo o decisión operativa y registra defectos accionables.
Los incidentes interdominio necesitan un líder de incidentes designado. Si un proveedor es el propietario del origen, un equipo de sistemas comerciales es el propietario de la aplicación y un equipo de plataforma es el propietario del almacén, el líder coordina la contención mientras cada grupo se hace cargo de su parte de la investigación.
Turn meetings into artifacts
Una cadencia útil produce decisiones, no discusiones:
Clasificación semanal: Revisa nuevas anomalías, asigna propietarios y cierra o escala incidentes.
Revisión mensual de KPIs: Compara el rendimiento de los SLA, los defectos recurrentes, los informes de los consumidores y las remediaciones atrasadas.
Actualización trimestral de contratos: Revisa definiciones, umbrales, linaje, cambios regulatorios y nuevos consumidores.
Utilice una matriz RACI ligera para cada conjunto de datos crítico. El productor es el responsable de la ejecución, el administrador es el responsable de la idoneidad y las definiciones, se consulta a los consumidores sobre el impacto y se informa al grupo de plataforma o gobernanza sobre los cambios sistémicos. Adapte las letras si su organización utiliza un modelo diferente, pero no deje la responsabilidad compartida en manos de un comité sin nombres.
El modelo operativo también necesita una rotación de guardia para las canalizaciones más importantes. Sin ella, las alertas llegan fuera del horario comercial y la organización mide la detección mientras acepta una recuperación lenta. La propiedad debe aparecer en el catálogo, el repositorio, la carga útil de la alerta y la guía de ejecución, no solo en un documento de reunión.
Medición del ROI y sus primeros 90 días
La dirección no necesita otra puntuación de calidad sin una interpretación financiera. Comience con el tiempo de inactividad de los datos, el período en el que un conjunto de datos no está disponible, está obsoleto o no es confiable para el uso previsto. Una fórmula práctica es DDT = N × (TDD + TTR), donde los incidentes se multiplican por el tiempo promedio de detección más el tiempo promedio de resolución, como se describe en esta guía de medición del tiempo de inactividad de los datos.
Convertir la pérdida operativa en un caso de negocio
Recopile las horas que los analistas, ingenieros, personal de finanzas y equipos de operaciones pasaron persiguiendo datos incorrectos durante el trimestre anterior. Multiplique esas horas por el costo horario cargado correspondiente, luego agregue las consecuencias documentadas, como pronósticos revisados, decisiones retrasadas, acciones fallidas de clientes o remediación de cumplimiento.
Realice un seguimiento de las mismas categorías después de la implementación. La comparación debería mostrar menos incidentes, un tiempo de detección más corto, un tiempo de resolución más corto, menos reprocesamiento y una menor exposición a decisiones tomadas a partir de datos no confiables. No afirme que cada incidente evitado es un ingreso garantizado. Separe los ahorros reales del riesgo evitado y haga visibles los supuestos.
El caso es material para muchas empresas. IBM informa que más de una cuarta parte de las organizaciones estiman pérdidas anuales superiores a 5 millones de USD debido a la mala calidad de los datos, mientras que el 7% estima pérdidas superiores a 25 millones de USD. Utilice esas cifras como contexto, no como un sustituto de su propia línea de base.
Usar una secuencia enfocada de 90 días
Fase | Días | Entregables Clave | Criterios de Éxito |
|---|---|---|---|
Línea de base | 1 al 15 | Perfilar las cinco tablas críticas principales, definir los SLA, asignar propietarios, registrar el tiempo de inactividad actual | Cada conjunto de datos prioritario tiene un contrato, un propietario y una medición inicial |
Instrumentar | 16 al 45 | Implementar comprobaciones de esquema y frescura en la base de datos, enrutar alertas a canales de guardia, publicar guías de ejecución | Los incumplimientos llegan al equipo responsable con un contexto de diagnóstico accionable |
Ajustar | 46 al 75 | Agregar detección de anomalías, revisar falsos positivos, ajustar umbrales y documentar excepciones | El volumen de alertas es manejable y los cambios significativos reciben investigación |
Revisar | 76 al 90 | Ejecutar la revisión trimestral, informar sobre el tiempo de inactividad y los cambios de respuesta, y seleccionar la siguiente área de cobertura | La dirección ve el impacto operativo y aprueba la siguiente expansión |
El marco del caso de negocio de calidad de datos puede ayudar a estructurar la narrativa financiera en torno al costo, el riesgo y los resultados medibles.
Evite cuatro trampas. Las métricas de vanidad premian el número de comprobaciones en lugar de una detección útil. La fatiga por alertas oculta fallas graves bajo el ruido. Las herramientas sin responsabilidad crean cuadros de mando en lugar de remediación. Omitir la primera retrospectiva de incidentes garantiza que la misma clase de defecto volverá a aparecer.
Comience con cinco tablas críticas, un propietario designado para cada una y una definición escrita de lo que significa "disponible y confiable". Luego, mida el primer incidente desde la detección hasta la resolución, porque ese ciclo le dirá más sobre la madurez del programa que una puntuación de calidad perfeccionada.
digna proporciona validación en la base de datos, detección de anomalías, monitoreo de Timeliness y seguimiento de esquemas dentro de su propio entorno, para que los equipos puedan conectar los controles de calidad a las canalizaciones y conjuntos de datos que ya operan. Visite digna para evaluar un enfoque modular para la mejora de la calidad de los datos en almacenes, lagos de datos y canalizaciones empresariales.
Preguntas frecuentes
¿Por qué se estancan los programas de calidad antes de empezar?
Porque la primera reacción ante un incidente suele ser comprar o configurar una herramienta. Una herramienta de calidad puede calcular métricas, ejecutar reglas y enrutar alertas, pero no puede decidir qué significa correcto, y eso exige un contrato documentado entre productores y consumidores.
¿Basta con medir tasas de nulos?
No. Las tasas de nulos son útiles, pero una tabla puede estar completa y aun así estar equivocada. La cobertura debe ir más allá de la completitud hasta las definiciones, los valores aceptados y las relaciones que determinan si un registro completo es además correcto.
¿Qué asigna un programa que funciona?
Controles a los riesgos que importan, en tres áreas: estándares con definiciones, valores aceptados, propiedad y procedimientos de cambio; responsabilidad mediante productores y stewards nombrados con autoridad para resolver defectos; y retroalimentación mediante alertas, tickets, retrospectivas y cambios de canalización que evitan la recurrencia.
¿Por qué necesita la calidad una lente económica?
Porque sin ella todo conjunto de datos parece merecer la misma atención. Ligar los controles al coste de un fallo es lo que permite justificar dónde invertir esfuerzo y qué dejar monitorizado pero sin remediar por ahora.
¿Cómo es el fallo clásico?
Un panel de ingresos que parece perfectamente sano mientras sobrestima durante semanas las reservas de una región. El incidente no es en esencia un problema de panel, y por eso sustituir el panel o añadir una comprobación más rara vez evita el siguiente.


