Limpieza de datos en SQL: patrones prácticos
|
9
minuto de lectura
Un panel de control experimenta un pico de actividad de la noche a la mañana, y la primera explicación suele ser la actividad comercial. Luego, alguien revisa el almacén de datos y encuentra pedidos duplicados, claves foráneas faltantes o fechas interpretadas en dos formatos diferentes. El informe no estaba "casi bien". Sus entradas eran inconsistentes y cada cálculo posterior heredó el problema.
Esa es la realidad operativa de la limpieza de datos en SQL. El trabajo se trata menos de una sintaxis ingeniosa y más de medir defectos, aislar registros riesgosos, aplicar reparaciones deterministas y evitar que vuelvan a ocurrir los mismos defectos. A escala de almacén de datos, un UPDATE descuidado puede dañar más datos de los que corrige, mientras que un flujo de trabajo de SQL bien estructurado puede hacer que la lógica de calidad sea repetible, revisable y eficiente.
Tabla de Contenido
Por qué SQL sigue siendo la columna vertebral de la limpieza de datos
Estandarización de formatos de texto y corrección de tipos de datos
Asegurar la calidad con restricciones y reglas de validación
Ir más allá de los scripts únicos hacia el monitoreo continuo
Por qué SQL sigue siendo la columna vertebral de la limpieza de datos
Una gran carga de trabajo de analítica puede dedicar más tiempo a preparar datos que a analizarlos. Un punto de referencia ampliamente citado indica que los analistas y científicos de datos pueden pasar hasta el 80% de su tiempo limpiando y preparando datos, un hallazgo que se analiza en este resumen de limpieza de datos en SQL de Domo. Esa asignación explica por qué operaciones como filtrar nulos, eliminar duplicados, estandarizar formatos y validar rangos se convirtieron en habilidades fundamentales para ingenieros de datos e ingenieros de analítica.
SQL se sitúa cerca de los datos, lo que importa en las arquitecturas modernas de ELT. Los registros sin procesar se pueden cargar en un almacén de datos y transformarse allí mismo donde ya residen, en lugar de ser extraídos, movidos y procesados repetidamente en otro sistema. La base de datos se convierte en la capa de ejecución de la lógica de calidad, mientras que las sentencias SQL proporcionan un registro determinista de lo que cambió y por qué.
Un incidente típico comienza con un pequeño defecto que se convierte en un gran problema de informes:
Eventos comerciales duplicados: Un reintento en un trabajo de ingesta crea dos filas para una transacción, lo que infla los ingresos o el volumen.
Claves de relación faltantes: Un cliente nulo o una clave de producto faltante evita que un join coincida, por lo que el panel de control subestima la actividad.
Desviación de formato: Una fuente envía una fecha como texto en una convención diferente, desplazando los registros al período de informe incorrecto.
Valores centinela: Cadenas vacías, fechas de marcador de posición o ceros reemplazan la información faltante y superan las comprobaciones superficiales de nulos.
Regla de producción: Trate la limpieza como una operación de datos controlada, no como una serie improvisada de correcciones dentro de una consulta de panel de control.
La distinción importa porque SQL puede tanto reparar como ocultar defectos. Un COALESCE puede hacer que un informe se visualice mientras enmascara un valor faltante que debería activar un incidente ascendente. Un DELETE amplio puede eliminar duplicados mientras elimina también el registro válido que debería haberse conservado. Una buena lógica de limpieza clasifica primero los errores, aísla las filas afectadas y preserva suficiente evidencia para auditar la decisión.
Para los lectores que deseen ejemplos de SQL más amplios y perspectivas prácticas, los recursos de SQL de Wonderment Apps ofrecen un contexto útil sobre el lenguaje y sus aplicaciones. Para los equipos que evalúan la ejecución de calidad nativa en el almacén de datos, la guía de calidad de datos en base de datos de digna es relevante porque mantener las comprobaciones cerca de los datos reduce el movimiento innecesario y separa la lógica de validación de los frágiles scripts externos.
Perfilar sus datos antes de escribir una sola corrección
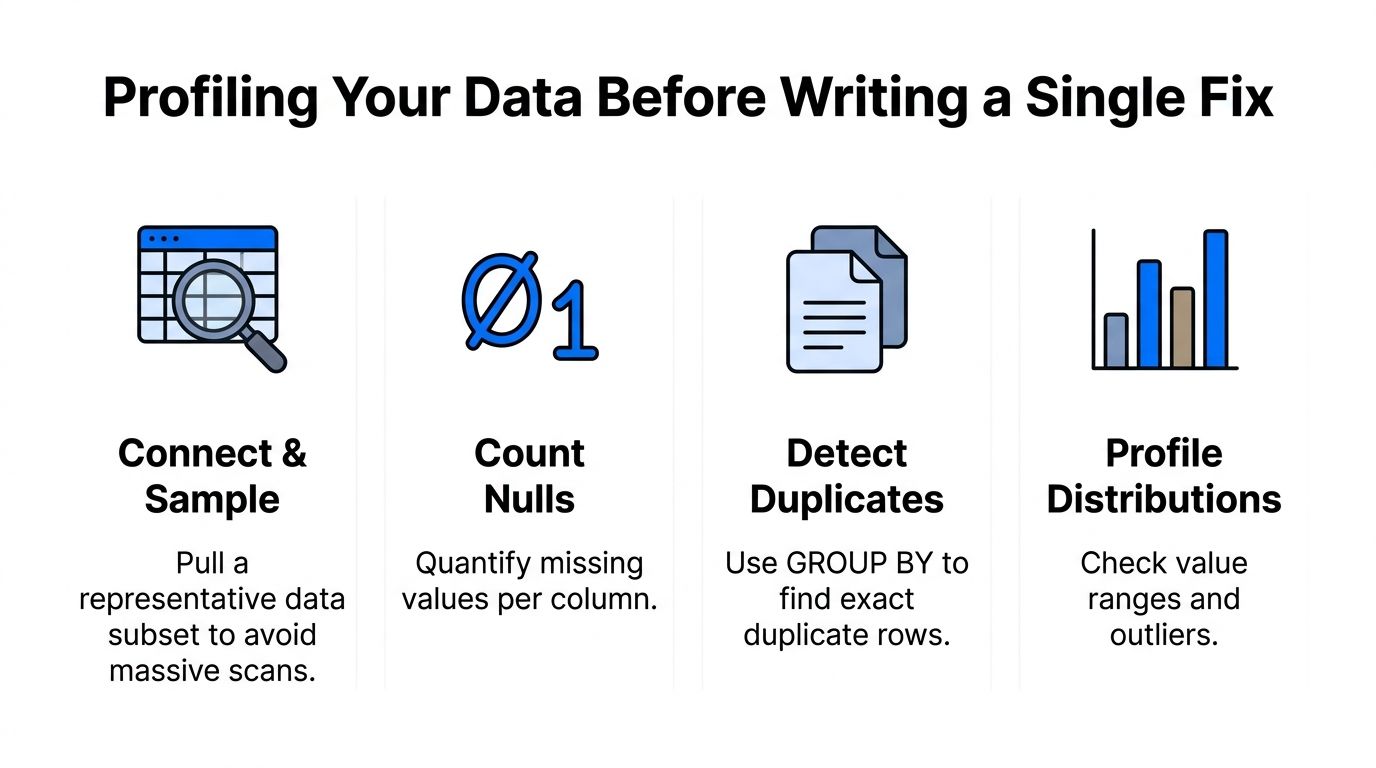
El error de limpieza más costoso suele ser el primero: escribir un UPDATE antes de medir el problema. Un perfil le brinda una línea base, revela si el problema está aislado o es sistémico, y le permite comparar el conjunto de datos antes y después de la remediación.
Comience con una muestra representativa cuando la tabla sea grande. Una muestra no reemplazará una ronda de validación completa, pero le ayuda a inspeccionar formatos y valores comerciales sin forzar inmediatamente un escaneo masivo. Ejecute agregaciones específicas contra la tabla completa cuando el motor del almacén y la partición hagan que esas comprobaciones sean viables.
Establecer una línea base de defectos
Para columnas que admiten nulos, cuente los valores faltantes directamente en lugar de confiar en una muestra visual:
Una tasa de nulos es útil porque hace que el defecto sea medible y comparable entre ejecuciones de pipelines. También puede agrupar la falta de datos por sistema de origen, partición o fecha de ingesta para distinguir una característica de datos de larga data de una interrupción reciente.
Las comprobaciones de valores distintos exponen categorías inesperadas:
Busque variantes de ortografía, inconsistencias en mayúsculas y minúsculas, cadenas vacías y valores que violen el vocabulario comercial. Una columna que parece contener un pequeño conjunto de estados puede contener varias representaciones del mismo estado.
Buscar duplicados sin tocar producción
La detección exacta de duplicados comienza agrupando las columnas que definen el registro:
Esta consulta le indica dónde existen duplicados, pero no cuál fila debe sobrevivir. Capture los registros sospechosos en una tabla intermedia separada e incluya metadatos de ingesta, prioridad de origen, marca de tiempo de actualización y una clave subrogada estable cuando esté disponible.
La sintaxis exacta varía según el almacén, pero el principio operativo es constante: nunca experimente directamente en la relación de producción cuando puede aislar a los candidatos primero. La guía práctica de limpieza con SQL también recomienda validar las transformaciones en subconjuntos pequeños antes de aplicarlas de manera generalizada, lo que reduce el radio de impacto de un predicado incorrecto. Las técnicas de perfilado de datos utilizadas en la limpieza de almacenes de datos complementan este enfoque al hacer explícita la fase de inspección en lugar de tratarla como una preparación opcional.
Mida primero, repare después. Si no puede indicar cuántas filas se ven afectadas, no puede revisar el cambio de manera segura.
Manejo de nulos y eliminación de duplicados a escala
El manejo de nulos es una decisión comercial disfrazada de expresión SQL. Reemplazar cada valor faltante con un valor predeterminado puede simplificar las consultas posteriores, pero también puede convertir "desconocido" en una afirmación falsa. Mantenga disponible el valor original cuando la distinción sea importante.
COALESCE es apropiado cuando una opción de respaldo tiene un significado claro:
Ese patrón es más seguro para la presentación que para el almacenamiento irreversible. Si la ausencia de una moneda significa que el origen no proporcionó la información requerida, una bandera de validación es más honesta:
NULLIF ayuda a convertir marcadores de posición conocidos en verdaderos nulos antes del perfilado:
También puede utilizar lógica condicional cuando el reemplazo correcto dependa de una regla documentada. No infiera un atributo de cliente a partir de un campo no relacionado únicamente porque la consulta necesita un valor no nulo.
Eliminar duplicados con una regla de supervivencia explícita
ROW_NUMBER() es el patrón duradero para identificar un sobreviviente dentro de cada grupo duplicado:
La cláusula ORDER BY es la parte importante. "Conservar el último" solo funciona si la marca de tiempo es confiable y los empates tienen un respaldo determinista. Si los registros difieren en su nivel de completitud, ordene por una regla de completitud documentada en lugar de asumir que la última fila en llegar es la mejor.
Para tablas a escala de almacén de datos, materialice el resultado clasificado en una nueva relación o partición de reemplazo siempre que sea posible. Reconstruir una partición limpia puede ser más seguro que realizar una eliminación masiva fila por fila, especialmente cuando la tabla está agrupada o particionada. Preserve las filas rechazadas en una tabla de auditoría si los duplicados requieren corrección en el sistema de origen.
Saber cómo trata la unicidad a los nulos
SQL Server tiene un comportamiento particularmente importante: una restricción UNIQUE permite NULL, pero solo se permite un valor NULL por columna restringida, como se documenta en la referencia de restricciones check y unique de Microsoft. Ese comportamiento puede sorprender a los equipos que limpian campos opcionales, porque el manejo de nulos afecta si los registros posteriores son aceptados o rechazados.
Utilice comprobaciones de completitud de datos para separar "faltante pero permitido" de "faltante e inválido". Elimine duplicados solo cuando la regla de identidad sea inequívoca. De lo contrario, marque el grupo para su revisión y conserve la evidencia necesaria para explicar por qué se seleccionó un registro específico.
Estandarización de formatos de texto y corrección de tipos de datos
Las inconsistencias de texto a menudo sobreviven a las pruebas básicas porque parecen correctas a simple vista. Un espacio final en una clave de join, diferencias de mayúsculas y minúsculas en un estado o un carácter Unicode que se asemeja a un carácter ASCII pueden producir joins que no coinciden y agregaciones fragmentadas.
Normalice los valores primero en una proyección controlada:
TRIM elimina el espacio en blanco circundante, mientras que UPPER y LOWER establecen una forma de comparación consistente. REPLACE puede eliminar caracteres de formato conocidos, pero los reemplazos amplios son riesgosos cuando la puntuación tiene un significado. Las expresiones regulares son útiles para la validación de patrones y la corrección dirigida donde el almacén las admita, pero deben probarse contra variantes de origen reales en lugar de aplicarse como un limpiador universal.
Hacer que las conversiones sean explícitas
Las conversiones implícitas son convenientes durante la exploración y peligrosas en producción. Un valor de texto puede convertirse de manera diferente según el motor, la configuración de la sesión, la configuración regional o el tipo de destino. Las sentencias explícitas CAST o CONVERT hacen visible la representación deseada:
Antes de realizar la conversión, perfile los valores que no cumplen con el formato esperado. Una conversión fallida debe capturarse como una excepción de calidad, no descartarse. Verifique también la precisión y la escala, ya que un tipo numérico de destino puede perder detalles significativos si es más estrecho que el de origen.
Los datos temporales necesitan aún más cuidado. Una marca de tiempo sin contexto de zona horaria puede cambiar cuando los sistemas la interpretan bajo diferentes configuraciones de sesión. Estandarice la convención de origen, convierta con una política de zona horaria explícita y conserve el valor sin procesar original hasta que el resultado pase la validación.
Estandarizar antes de la eliminación de duplicados
El orden importa. Una secuencia práctica de limpieza consiste en inspeccionar nulos, duplicados y formatos inusuales, luego estandarizar el texto, corregir tipos y eliminar duplicados una vez que los valores equivalentes se hayan llevado a una forma común. Este orden se describe en la guía de limpieza de datos con SQL sobre inspección y estandarización.
Si elimina los duplicados antes de recortar espacios y normalizar, los registros como ACME y ACME seguirán separados a pesar de que el negocio los trate como una sola clave. Si agrega restricciones antes de la conversión de tipos, la base de datos puede rechazar registros entrantes válidos o preservar una representación inadecuada. Mantenga las columnas sin procesar, normalizadas y validadas de forma independiente durante el desarrollo para que los revisores puedan comparar cada transformación.
Asegurar la calidad con restricciones y reglas de validación
Un script de limpieza corrige el lote actual. Una restricción protege el siguiente lote. Utilice barreras de seguridad de base de datos cuando la regla sea estable, local al registro y lo suficientemente importante como para rechazar datos no válidos en la ingesta.
Restricción | Alcance | Mejor caso de uso |
|---|---|---|
| Presencia de columna | Identificadores, fechas y claves requeridos |
| Columna única o combinación | Control de identidad y prevención de duplicados |
| Regla booleana a nivel de fila | Rangos permitidos, estados y orden de fechas |
NOT NULL es sencillo, pero debe reflejar un requisito real. Aplicarlo a un atributo opcional crea fricción operativa sin mejorar la precisión. UNIQUE funciona bien para identificadores naturales o claves comerciales compuestas, siempre que haya definido cómo deben comportarse los nulos y las actualizaciones tardías.
Las restricciones CHECK expresan reglas como:
Las expresiones CHECK de ANSI SQL pueden evaluarse como TRUE, FALSE o UNKNOWN, y están limitadas a la integridad del dominio. Pueden validar los valores de una fila, pero no pueden inspeccionar otras filas para verificar la consistencia entre filas, como se explica en esta referencia de migración de restricciones SQL. Un CHECK puede rechazar un monto negativo o un orden de fechas inválido. No puede confirmar que el total de una cuenta cuadre con una tabla separada.
Elegir rechazo estricto o cuarentena blanda
Las restricciones estrictas son apropiadas cuando aceptar una fila incorrecta corrompería una tabla crítica y la fuente puede corregir las fallas rápidamente. Son menos adecuadas cuando los sistemas ascendentes envían regularmente registros parciales que necesitan investigación antes de su finalización.
Un patrón blando almacena el registro mientras agrega columnas de validación como is_valid, failure_reason o rule_name. Los modelos posteriores pueden excluir las filas fallidas, mientras que los equipos de operaciones mantienen la visibilidad sobre el defecto de origen. Este enfoque requiere más esfuerzo de diseño, pero evita convertir un problema transitorio de origen en una carga fallida sin contexto de diagnóstico.
La guía de reglas de validación de datos SQL y calidad continua proporciona un marco útil para separar los valores requeridos, los formatos, la completitud, la unicidad y la integridad referencial. En la práctica, combine las restricciones con la validación intermedia. Las restricciones son el filtro final, no un sustituto del perfilado, la clasificación de errores o una pista de auditoría.
Ir más allá de los scripts únicos hacia el monitoreo continuo
La limpieza con SQL es reactiva. Repara los registros después de que un defecto ha ingresado al pipeline, mientras que el monitoreo continuo busca las condiciones que indican una regresión.
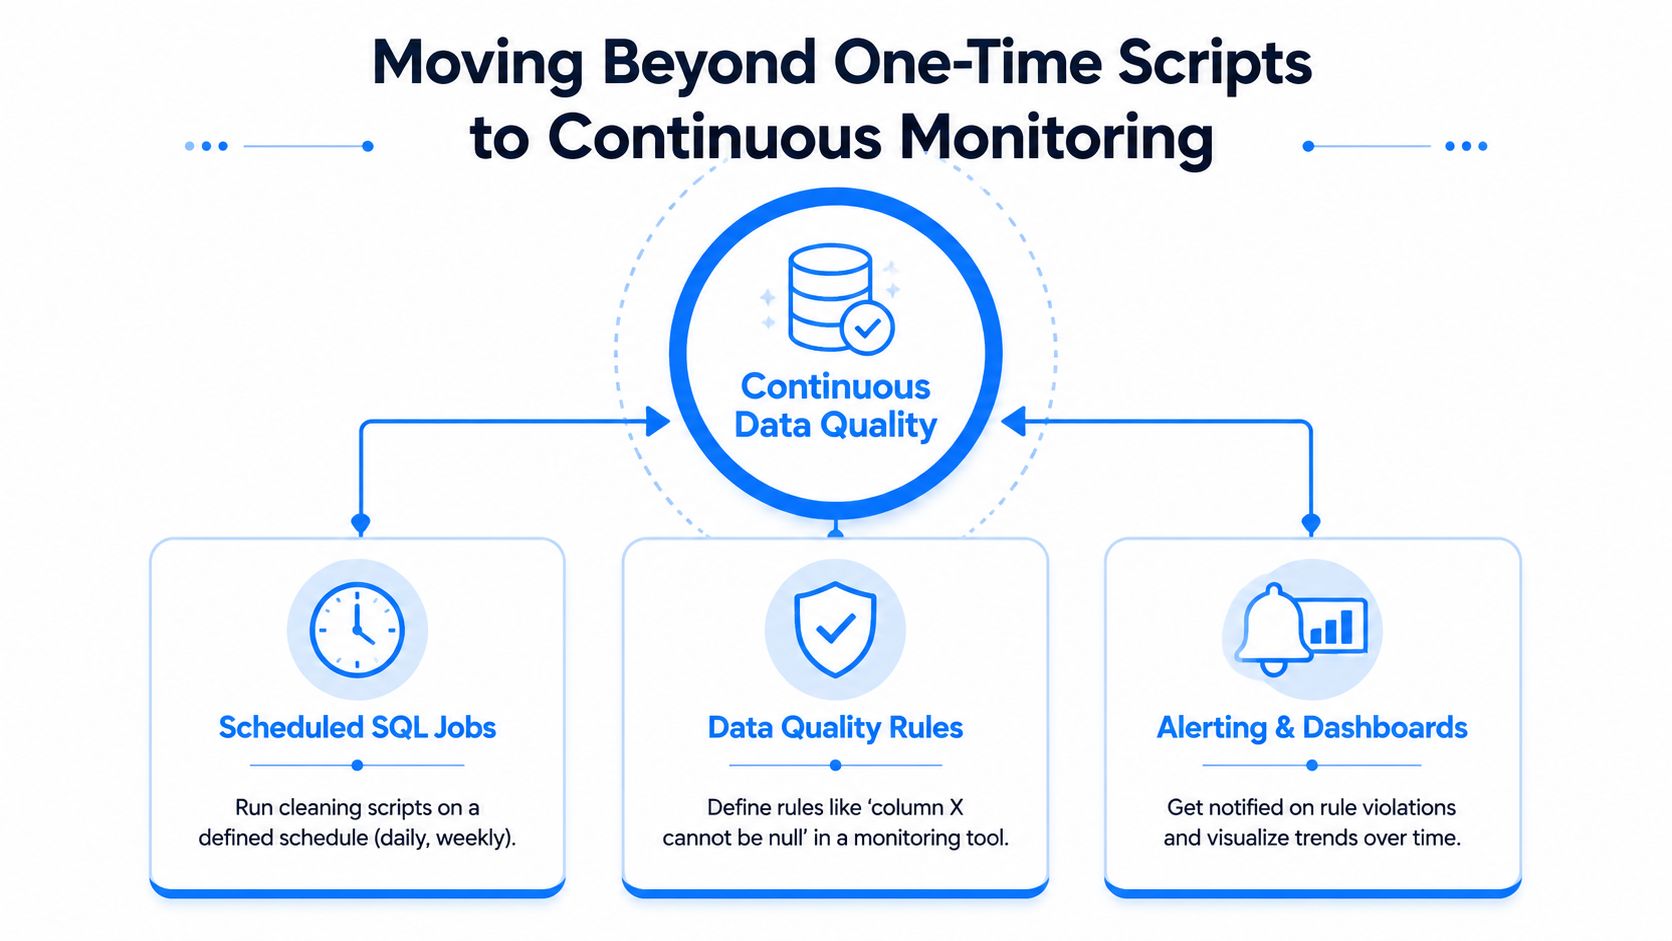
Un flujo de trabajo maduro superpone varias señales sobre el conjunto de datos limpio:
Trabajos SQL programados: Ejecutan transformaciones deterministas en un horario definido y registran el conteo de filas afectadas.
Reglas de calidad: Verifican los valores requeridos, formatos válidos, unicidad, integridad referencial y condiciones comerciales.
Detección de anomalías: Compara las distribuciones y volúmenes actuales con el comportamiento establecido para identificar cambios inusuales.
Comprobaciones de puntualidad (Timeliness): Detectan entregas faltantes, retrasadas o inesperadamente tempranas.
Seguimiento de esquemas: Identifica columnas agregadas o eliminadas y cambios en los tipos de datos antes de que fallen las consultas posteriores.
La inversión adecuada depende del modo de falla. Escriba un script SQL cuando la regla sea determinista, la transformación sea repetible y el conjunto de datos afectado esté claramente delimitado. Agregue Observability automatizada cuando los defectos se repitan, el comportamiento del origen cambie, el tiempo de entrega sea importante o si una revisión manual descubriría una falla en el panel de control demasiado tarde.
Plataformas como digna ejecutan comprobaciones de calidad y anomalías dentro del entorno de la base de datos del cliente, lo que permite a los equipos monitorear el comportamiento de los datos sin mover los registros de producción a una capa de procesamiento externa. Sus capacidades de monitoreo de calidad de datos cubren la brecha entre la limpieza programada y la detección continua al combinar validación, anomalías, puntualidad (Timeliness) y monitoreo estructural.
Utilice digna para ejecutar validaciones en la base de datos, detección de anomalías, comprobaciones de puntualidad (Timeliness) y seguimiento de esquemas en los conjuntos de datos de los que dependen sus pipelines SQL. Visite digna para ver cómo el monitoreo continuo puede convertir la lógica de limpieza única en un sistema operativo de calidad de datos.
Preguntas frecuentes
¿Por qué sigue siendo SQL la columna vertebral de la limpieza de datos?
Porque está cerca del dato, lo que importa en arquitecturas ELT modernas donde la transformación ocurre tras la carga. Un benchmark muy citado indica que analistas y científicos de datos pueden dedicar hasta el 80 % de su tiempo a limpiar y preparar datos, así que dónde se ejecuta ese trabajo no es una decisión menor.
¿Qué defectos causan más daño en el reporte?
Se repiten cuatro: eventos de negocio duplicados, cuando un reintento de ingesta crea dos filas e infla los ingresos; claves de relación ausentes, cuando un nulo impide que case un join y el panel subcuenta; deriva de formato, cuando una fecha llega con otra convención y desplaza registros al periodo equivocado; y valores centinela que superan comprobaciones superficiales de nulos.
¿Por qué son tan peligrosos los valores centinela?
Porque parecen datos. Cadenas vacías, fechas de relleno y ceros sustituyen a la información ausente y pasan limpiamente una comprobación de nulos, de modo que el registro cuenta como completo mientras no lleva nada utilizable en el campo que importa.
¿Puede SQL ocultar defectos además de arreglarlos?
Sí, y por eso conviene tratar la limpieza como una operación de datos controlada y no como una serie improvisada de arreglos dentro de una consulta de panel. Un COALESCE en la capa de reporte elimina a la vez el síntoma y la evidencia.
¿Qué hacer antes de escribir el primer arreglo?
Perfilar los datos. Conocer el volumen actual, la distribución, las tasas de nulos y los patrones de valores indica qué defectos existen realmente, en lugar de aquellos en los que el último incidente hizo pensar a todos.


