Manual de implementación de calidad de datos para equipos de datos modernos
|
7
minuto de lectura

Tus dashboards vuelven a estar desactualizados, una pipeline falló durante la noche y la primera pregunta de la mañana sigue siendo la misma: "¿Podemos confiar en este número?" Ese es un desafío común para muchos equipos que realizan la data quality implementation después de que el warehouse, el lake y la capa de BI ya están activos. La solución no es otro sprint de limpieza, sino construir controles que eviten que los datos de mala calidad se conviertan en el problema de otra persona.
Un programa viable comienza con una idea simple: solo una pequeña parte de los datos conlleva realmente el riesgo comercial. Los equipos que ganan dejan de tratar la calidad como un proyecto de una sola vez y comienzan a tratarla como operaciones, con propiedad, umbrales y alertas que encajan en la pipeline que la gente ya ejecuta.
Tabla de contenidos
Por qué la implementación de la calidad de datos falla sin un sistema de control
Identificación de elementos de datos críticos y establecimiento de umbrales por niveles
Arquitectura y opciones de implementación para entornos empresariales
Diseño de reglas de validación y líneas de base para la detección de anomalías
Integración de comprobaciones de calidad en pipelines y flujos de trabajo de MLOps
Tu lista de verificación para el lanzamiento de la implementación de calidad de datos
Por qué la implementación de la calidad de datos falla sin un sistema de control
De tareas de limpieza a controles gestionados
Muchos equipos de datos todavía gestionan el trabajo de calidad como una respuesta de emergencia. Un dashboard falla, alguien abre un ticket, un analista parchea un modelo y el mismo problema vuelve a aparecer la semana siguiente porque nadie cambió el comportamiento de origen. Ese patrón es exactamente la razón por la cual las guías modernas tratan la calidad de los datos como un sistema gestionado de exactitud, integridad, consistencia, puntualidad, unicidad y validez, no como un esfuerzo de limpieza puntual (TechTarget).
La interrupción suele ser mundana. Una carga tardía hace que un informe de ingresos parezca plano, una clave faltante provoca que los joins descarten registros o un cambio de esquema altera una métrica. Una vez que un equipo tiene cientos de cargas diarias, el trabajo de rescate manual deja de ser escalable y el warehouse comienza a acumular pequeños fallos de confianza que la gente nota mucho antes de poder explicarlos.
Regla práctica: si una comprobación no tiene un propietario, un umbral y una ruta de solución, no es un control, es una nota.
Por qué se desmorona la auditoría periódica
Las auditorías periódicas ayudan, pero son demasiado lentas para las pipelines en vivo. Las guías prácticas contemporáneas ahora colocan la puntualidad, el seguimiento de la latencia, las reglas de vencimiento y la sincronización en tiempo real en el centro de la gestión de calidad habitual, porque la primera señal de problemas suele ser datos retrasados o inconsistentes, no una corrupción obvia (Lumenalta). Es por eso que el modelo de control se ha desplazado hacia comprobaciones integradas en las pipelines, validadas contra reglas y monitoreadas a lo largo del tiempo.
El otro modo de fallo es cultural. Los equipos llaman al trabajo "limpieza de datos", lo que suena a algo finito, y luego lo dotan de personal como si fuera un proyecto con una fecha de finalización. En la práctica, el mejor modelo se acerca más a la gestión de versiones. Identificas los elementos de datos críticos, asocias las reglas de negocio a las comprobaciones, defines los umbrales de aceptación y sigues observando después del lanzamiento inicial. Este enfoque se alinea con las directrices que enfatizan los diccionarios de datos, la procedencia, el linaje y la idoneidad antes de que las capas de governance más profundas puedan funcionar de manera eficaz (TechTarget).
Cuando ocurre ese cambio, la conversación se transforma. La gente deja de preguntar si los datos "se ven bien" y comienza a preguntar si están dentro de la tolerancia, quién es el propietario de la excepción y cuál es el radio de impacto si no se soluciona.
Identificación de elementos de datos críticos y establecimiento de umbrales por niveles
Comienza con los campos que conllevan riesgo
La mayoría de los programas fallan porque intentan medir demasiadas cosas a la vez. Comienza con los elementos de datos críticos vinculados a los ingresos, el cumplimiento (Compliance) o las operaciones principales, y luego deja el resto en paz hasta que el primer dominio sea estable. La guía de Gartner sobre calidad de datos indica que los casos de uso y los recursos de datos deben mapearse por valor y riesgo antes de elegir dimensiones y métricas (Gartner).
Esto es importante en entornos regulados, donde el riesgo suele concentrarse en un pequeño conjunto de campos más que en todo el warehouse. Los identificadores, los balances, los registros de pacientes y registros similares merecen mucha más atención que las tablas de referencia de bajo impacto. Si intentas instrumentar todo por igual, el equipo terminará con un dashboard ruidoso, una priorización débil y una falsa sensación de cobertura.
Una forma práctica de decidir qué entra en el alcance es hacer tres preguntas:
¿Qué se rompe si este campo está mal? El reconocimiento de ingresos, las comunicaciones con los clientes, las declaraciones de cumplimiento (Compliance) o las características del modelo suelen revelar la respuesta rápidamente.
¿Quién siente primero el error? Los equipos de finanzas, operaciones, soporte y ML a menudo detectan diferentes modos de fallo.
¿Podemos asignar la propiedad de forma clara? Si la solución requiere de cinco equipos, la regla probablemente necesite un límite más estricto.
Utiliza ese filtro para definir el primer conjunto de monitoreo. El objetivo no es construir el programa más grande, sino detectar los errores que duelen. Una ayuda útil para definir el alcance es el enfoque de los elementos de datos críticos, porque obliga al equipo a nombrar los campos que importan antes de dedicar tiempo a una cobertura amplia.
Utiliza líneas de base antes de establecer reglas
Antes de escribir la lógica de validación, perfila la fuente. Las guías de implementación gubernamentales recomiendan observar primero los recuentos, las tasas de nulos, los valores mínimos/máximos, los tipos de datos y los patrones recurrentes, y luego usar esos resultados para establecer umbrales de aceptación como porcentajes y comprobaciones medibles (Oracle). Esa secuencia ahorra mucho trabajo repetido porque no estás adivinando cómo se ve lo normal.
Los umbrales funcionan mejor cuando se estructuran por niveles en lugar de ser binarios. Un marco práctico utiliza el nivel Oro para una exactitud ≥ 99%, Plata para el 95–98% y Bronce por debajo del 95% con remediación requerida (Acceldata). Esa estructura ofrece a los propietarios de productos y administradores un lenguaje común, y evita la falsa precisión de aprobar o reprobar en cada regla individual.
La primera pasada debe mantenerse acotada. En un warehouse empresarial maduro, un conjunto monitoreado más pequeño con umbrales claros suele superar a una cobertura amplia y débil en la que nadie confía.
Arquitectura y opciones de implementación para entornos empresariales
Elige dónde se ejecutan realmente las comprobaciones
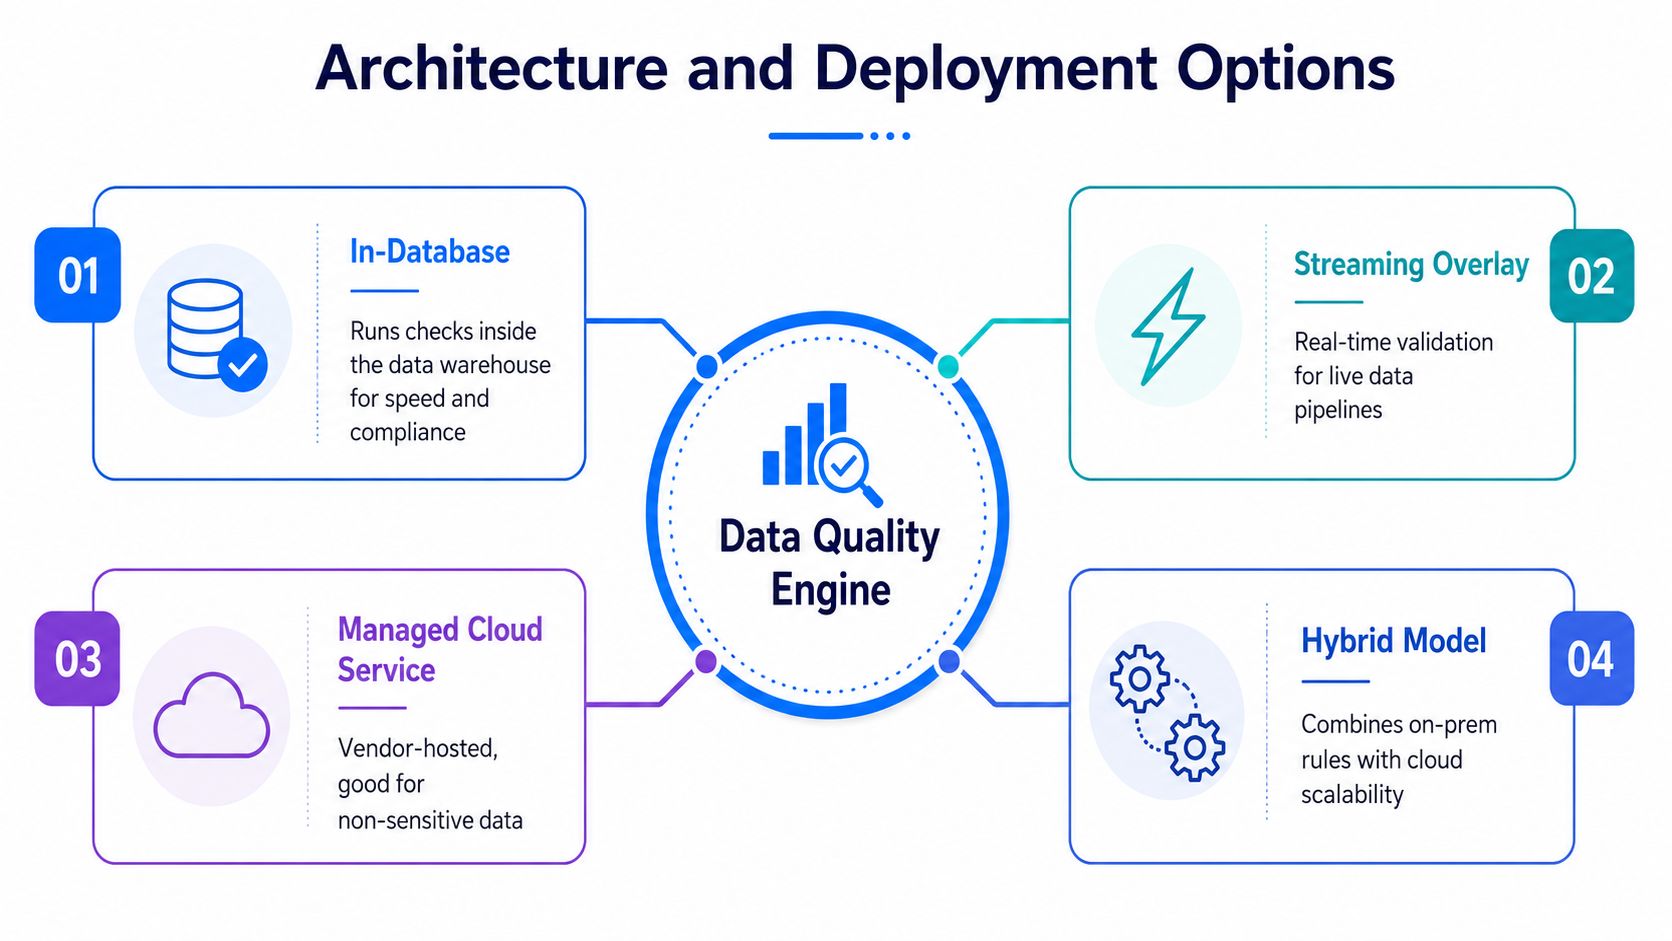
La decisión de la arquitectura no se trata de elegancia, sino de dónde viven los datos y quién tiene permitido tocarlos. En entornos de finanzas, atención médica, telecomunicaciones y sector público, trasladar los datos de producción a un sistema externo suele ser inviable, por lo que la ejecución dentro de la base de datos se convierte en la opción práctica. Esto mantiene los datos residiendo en el entorno controlado por el cliente y reduce el movimiento innecesario de información.
Muchas implementaciones fallan en el primer intento. Los equipos compran una capa de dashboard que se ve bien en las demostraciones, y luego descubren que todavía necesitan código personalizado en cada punto donde el warehouse, el lake y las pipelines divergen. El patrón más saludable es mantener el motor de calidad cerca de los datos y luego exponer los resultados a través de una UI, API o SDK según quién deba actuar sobre ellos.
Existen ventajas y desventajas en ambos casos:
Los dashboards centralizados ayudan con la visibilidad entre equipos, pero pueden convertirse en un mero escenario de solo lectura si no están vinculados a la propiedad y al cumplimiento de las reglas.
Los SDK basados en código brindan a los ingenieros el control que desean, pero necesitan un modelo operativo claro o cada equipo desarrollará su propia interpretación de la misma regla.
Las implementaciones en nube privada o local preservan el control, lo cual es fundamental cuando la residencia de los datos y el acceso de los proveedores son temas delicados.
Las configuraciones híbridas pueden funcionar cuando no todos los conjuntos de datos necesitan el mismo tratamiento, pero la división debe ser intencionada.
La mejor arquitectura es la que se adapta a la infraestructura existente sin obligar a reescribir el warehouse o la pila de orquestación.
Mantén la plataforma cerca de los datos
Las plataformas modernas suelen necesitar tres capacidades para seguir siendo útiles en entornos empresariales. Primero, el aprendizaje de líneas de base para que el sistema comprenda los patrones recurrentes. Segundo, el análisis de tendencias para poder detectar desviaciones en lugar de solo contar los fallos. Tercero, el seguimiento de esquemas para que las adiciones, eliminaciones o cambios de tipo de columna no afecten a los informes posteriores sin previo aviso.
Una plataforma como digna se adapta a este patrón al ejecutar análisis dentro de las bases de datos de los clientes, monitorear la puntualidad y realizar un seguimiento de los cambios de esquema sin necesidad de que los datos salgan del entorno controlado. Ese es el tipo de modelo de implementación que los equipos empresariales suelen necesitar cuando la Observability debe coexistir con la privacidad y las inversiones existentes en el warehouse.
El principal desafío es el mantenimiento. Una plataforma que se encuentra demasiado lejos de los datos necesita más código de integración y más gestión de excepciones. Una plataforma que se ejecuta cerca de los datos puede ser operativamente más silenciosa, porque observa directamente el comportamiento de origen y no depende de extractos copiados para comprender qué cambió.
Diseño de reglas de validación y líneas de base para la detección de anomalías
Asocia los controles al modo de fallo correcto
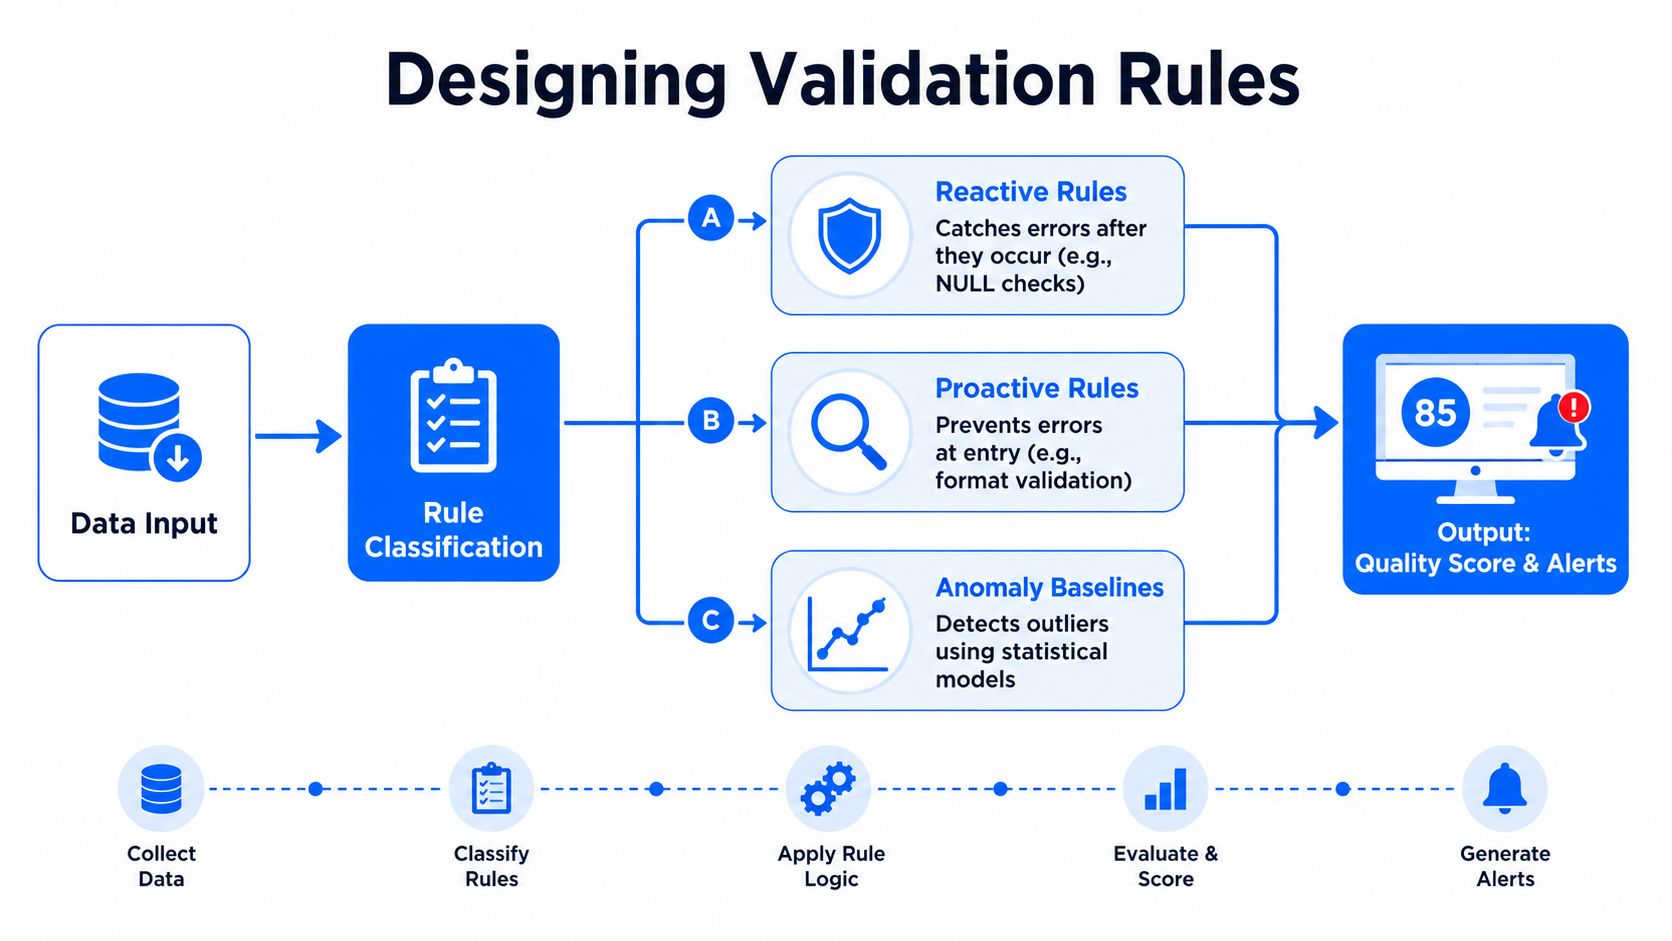
Un modelo de control práctico combina cuatro enfoques: reactivo, proactivo, apto para el consumo y detección de anomalías (OvalEdge). Esa combinación es importante porque los diferentes fallos necesitan respuestas distintas. Un valor faltante es un problema. Un formato roto es otro. Una desviación lenta en un sistema de origen necesita un control completamente diferente.
Las reglas reactivas detectan problemas después de que ocurren. Las reglas proactivas detienen los datos de mala calidad en el momento de la entrada. Las comprobaciones de aptitud para el consumo confirman que los datos son utilizables para un propósito comercial específico. La detección de anomalías vigila los cambios que no se ajustan al patrón aprendido. Esa separación proporciona al sistema una estructura clara y evita que los equipos conviertan cada regla en una parada estricta y frágil.
Las dimensiones principales siguen siendo las mismas: exactitud, integridad, consistencia, puntualidad, validez y unicidad. La parte útil consiste en asociar cada dimensión al punto de control correcto en lugar de pretender que una sola regla pueda cubrirlo todo.
Una buena regla te dice qué falló, dónde falló y a quién debería importarle. Cualquier cosa menor se convierte en un simple adorno de dashboard.
Deja que las líneas de base gestionen la desviación y los tiempos
La detección de anomalías resulta muy útil cuando la fuente cambia lentamente. Si el volumen, la distribución o el patrón de tiempo de una tabla cambian lo suficiente como para ser relevantes, una línea de base aprendida puede marcarlo antes de que un usuario de negocio vea el problema en un informe. Esto reduce la necesidad de realizar cientos de comprobaciones manuales, especialmente en pipelines volátiles donde el esquema y el comportamiento de origen varían a menudo.
La puntualidad requiere su propio tratamiento. La práctica actual incluye el monitoreo de los tiempos de entrega esperados, la detección de retrasos y las comprobaciones de llegada basadas en el cronograma como controles de calidad estándar (Lumenalta). El retraso a menudo provoca una mala decisión antes de que se active cualquier otra comprobación. Un conjunto de datos "correcto" que llega después de la reunión sigue fallando el control.

El seguimiento de esquemas cierra otra brecha común. Las columnas añadidas, eliminadas y los cambios de tipo de datos pueden romper el análisis posterior incluso cuando la pipeline parece saludable. Trata estos elementos como señales prioritarias y no como notas secundarias, porque a menudo representan la advertencia más temprana de que un acuerdo de origen se ha desviado.
Integración de comprobaciones de calidad en pipelines y flujos de trabajo de MLOps
Haz que las puertas de calidad formen parte de la entrega
La calidad solo importa cuando la pipeline la aplica automáticamente. Eso significa que las comprobaciones de validación, la detección de anomalías y el monitoreo de la puntualidad deben ejecutarse como parte de la misma ruta de entrega que mueve los datos hacia los dashboards de producción o los trabajos de entrenamiento de modelos. Si el equipo tiene CI/CD para el código, la puerta de calidad de datos también pertenece a ese proceso.
La secuencia debe ser rutinaria. Validar en la ingesta, validar después de las transformaciones y validar nuevamente antes de publicar. Si se programa una carga, ejecuta las comprobaciones según el cronograma. Si es por streaming, mantén las comprobaciones en línea. Si alimenta ML, bloquea el conjunto de características antes de que las entradas incorrectas lleguen al entrenamiento o al servicio.
Utiliza las alertas con moderación y con un propósito claro. Una regla ruidosa puede causar más daño que el propio problema de datos, porque la gente deja de confiar en la página. Las alertas deben dirigirse según la gravedad y el impacto empresarial, no solo en función de quién esté de guardia.
Dirige las excepciones a los propietarios, no a las bandejas de entrada
La razón por la que la propiedad importa es simple: los defectos recurrentes no desaparecen porque alguien los haya copiado en un ticket. Desaparecen cuando el administrador o custodio adecuado puede ver el fallo, comprender la causa raíz y corregir el comportamiento de origen. Es por eso que los marcos maduros emparejan las comprobaciones con una propiedad explícita y rutas de escalación en lugar de dejar que los analistas clasifiquen todo manualmente (Monte Carlo).
Los bucles de retroalimentación mantienen las reglas actualizadas. Las fuentes cambian, los objetivos comerciales cambian y el equipo debe esperar que el modelo de umbrales cambie con ellos. La automatización ayuda en este aspecto, ya que reduce el error humano y facilita el mantenimiento del programa a lo largo del tiempo. Si el flujo de trabajo funciona, los ingenieros dedican menos tiempo a supervisar la pipeline y más tiempo a mejorarla.
Los equipos que desean un flujo de trabajo gestionado a menudo recurren a herramientas como digna, pruebas de dbt o comprobaciones nativas del warehouse, pero la selección solo importa si el modelo de enrutamiento está claro. La herramienta debe informar del problema, el administrador debe asumir la solución y el historial debe mostrar si el mismo defecto sigue apareciendo.
Monitoreo continuo y medición del ROI
Mide la calidad como un sistema en funcionamiento
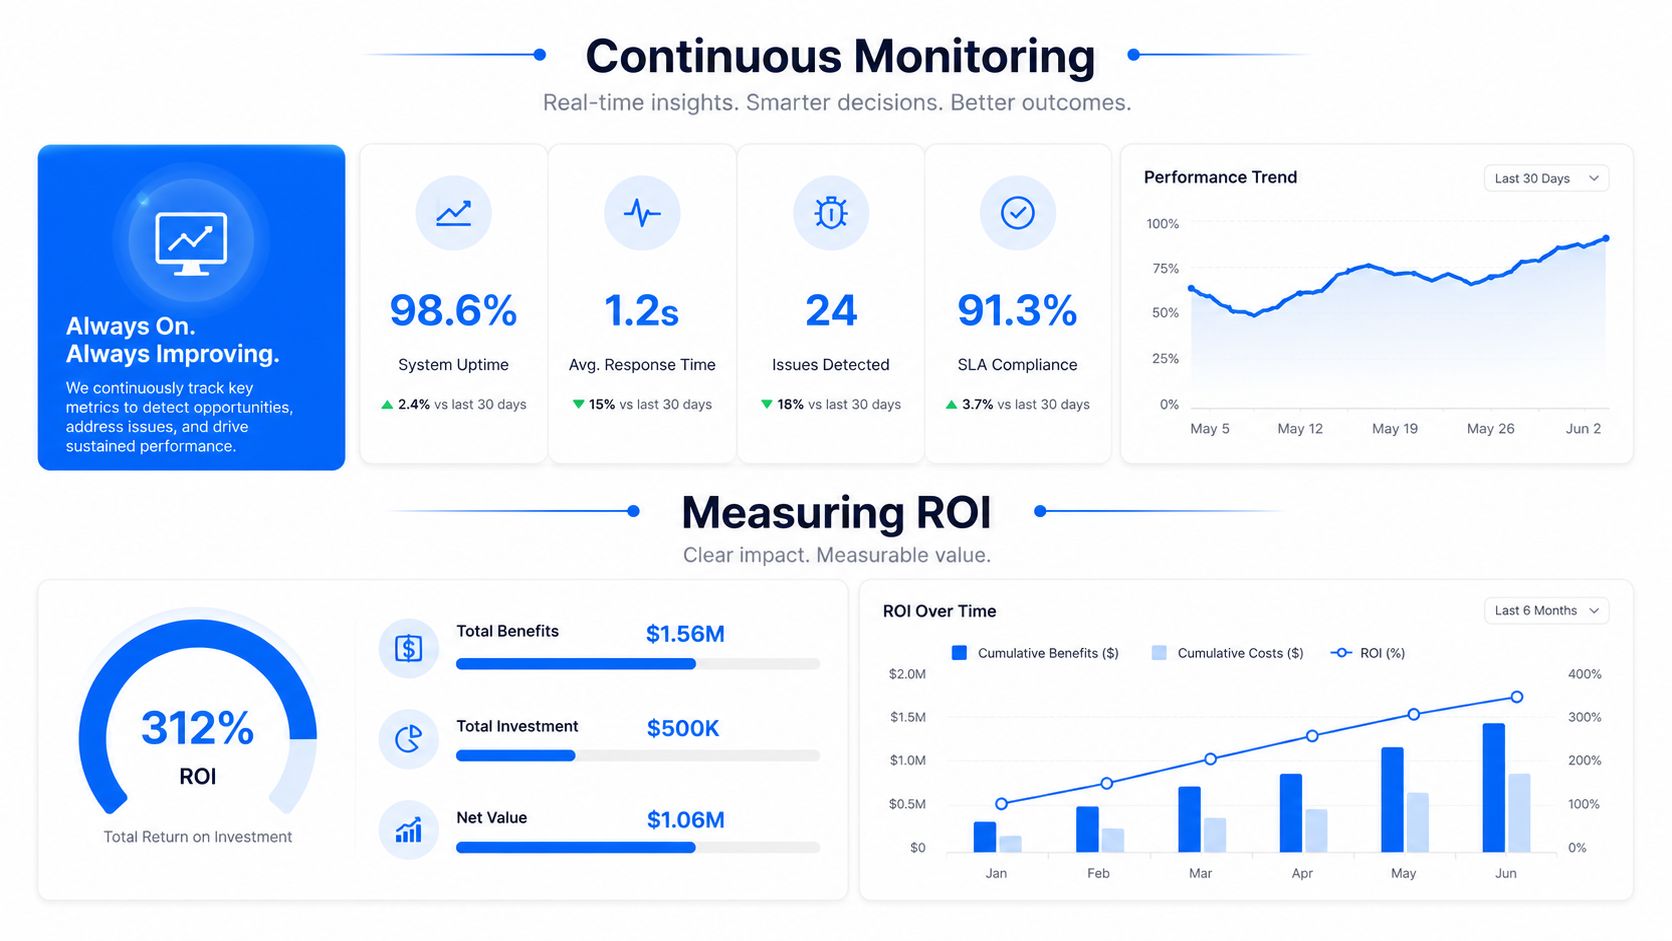
Una pipeline puede parecer saludable por la mañana y aun así entregar datos erróneos a la hora del almuerzo. Las comprobaciones manuales ocasionales no siguen ese ritmo, por lo que el monitoreo continuo debe integrarse dentro del sistema de control, vigilando los retrasos, la desviación y los cambios de esquema antes de que esos problemas afecten las decisiones. El cambio práctico consiste en pasar de una limpieza ocasional a una medición gobernada, donde el conjunto de datos está siempre bajo vigilancia en lugar de ser inspeccionado en un calendario.
Establece criterios de éxito en términos operativos, no en niveles vagos de confianza. Los equipos suelen realizar un seguimiento de los rangos de exactitud, los períodos de retraso monitoreados y las tasas de excepción para decidir si el programa se sostiene. Esas señales funcionan mejor que simplemente valorar si un conjunto de datos se ve limpio, porque se pueden analizar como tendencias, comparar entre fuentes y vincular directamente con propietarios específicos.
El análisis histórico también es importante. Al revisar incidentes pasados, el patrón suele manifestarse en los tiempos de llegada, la desviación y las causas raíces repetidas que una auditoría única pasa por alto. Eso es lo que convierte al monitoreo en un sistema de gestión en lugar de una acumulación de alertas, y es por eso que el data quality monitoring debe conectar la comprobación misma con el origen, el propietario y la ruta de remediación.
Prueba útil: si una métrica no te ayuda a decidir si solucionar, escalar o ignorar, pertenece a un informe, no a un monitor.
Track outcomes without vanity metrics
El ROI de la calidad de datos suele traducirse en menos tareas de emergencia de última hora, una detección más rápida y menos reparaciones manuales. Un dashboard de monitoreo puede hacer que esto sea visible cuando conecta la cobertura de calidad con el impacto operativo, no solo con la actividad técnica. La pregunta correcta no es cuántas comprobaciones existen, sino si estas evitan malas decisiones y reducen el trabajo repetido.
Las evaluaciones periódicas importan porque las fuentes y los objetivos siguen cambiando. La automatización ayuda a mantener la cadencia, pero el valor proviene del ciclo: detectar, asignar, solucionar, confirmar y luego ajustar la regla cuando el negocio cambia. Si el mismo problema sigue apareciendo, es necesario revisar el umbral, el modelo de propiedad o el proceso de origen.
Tu lista de verificación para el lanzamiento de la implementación de calidad de datos
Lanza algo pequeño y expándelo con pruebas
Comienza con uno o dos dominios que conlleven el mayor riesgo comercial. Perfila la fuente, define las reglas de negocio, establece los umbrales y selecciona a los propietarios antes de ampliar la cobertura. Si los primeros lanzamientos no se estabilizan, expandir el alcance solo multiplicará el ruido.
Una secuencia de lanzamiento práctica se ve así:
Selecciona los elementos de datos críticos. Enfócate en los campos vinculados a ingresos, cumplimiento (Compliance) o de operaciones clave.
Perfila la fuente. Captura las líneas de base para recuentos, tasas de nulos, rangos, tipos de datos y patrones comunes.
Establece rangos de aceptación. Utiliza umbrales medibles y resultados estructurados para que el equipo sepa qué activa una remediación.
Integra la automatización. Ejecuta comprobaciones dentro de la pipeline, no mediante inspecciones manuales a posteriori.
Asigna la propiedad. Asegúrate de que cada defecto recurrente llegue a un administrador o custodio que pueda solucionar la fuente.
Revisa y expande. Añade más cobertura solo después de que el primer área sea estable.
Mantén una vigilancia estricta sobre la expansión descontrolada del alcance. Los equipos a menudo intentan definir demasiadas métricas antes de haber estabilizado las que son críticas para el negocio, o bien olvidan las fuentes heredadas y externas donde suele residir la mayor parte de las anomalías. Así es como el programa se vuelve impresionante en papel y frágil en producción.
Mantén el lanzamiento enfocado en la propiedad
La mejor lista de verificación para un lanzamiento es lo suficientemente corta como para que la gente la use. Debe cubrir la alineación de las partes interesadas, las fases de prueba, las rutas de escalación y los umbrales que deciden si los datos son aptos para publicarse. También debe dar espacio a las excepciones, porque no todas las reglas fallidas significan que los datos estén incorrectos.
La prueba final es si el programa reduce la clasificación manual de problemas. Si los analistas todavía pasan las mañanas conciliando las mismas entradas rotas, los controles aún no son operativos. Si los propietarios pueden ver el problema, el umbral y la ruta de solución sin necesidad de una reunión, la implementación está empezando a funcionar.
Si estás construyendo o reemplazando un programa de calidad de datos, digna puede ayudarte a monitorear elementos de datos críticos, validar registros dentro de la base de datos y realizar un seguimiento de la puntualidad y el cambio de esquema sin mover los datos de producción fuera de tu entorno. Visita digna para ver cómo se adapta esto a un warehouse real o a una pila de pipelines.