Gestión de la calidad de los datos: una hoja de ruta práctica
|
8
minuto de lectura
El paquete de la junta directiva ya está en circulación cuando alguien detecta el problema. Los ingresos parecen menores de lo esperado, un pronóstico no cuadra y el analista de FP&A vuelve a ejecutar la consulta, y luego la ejecuta una vez más. Nada en el cuadro de mando indica que esté "roto". El almacén de datos aceptó la carga, el pipeline informó de que se había realizado correctamente y el informe se actualizó según lo previsto.
Esa es la realidad operativa de la gestión de la calidad de los datos. Los datos erróneos rara vez llegan con un mensaje de error claro. Aparecen como una tendencia cuestionable, una conciliación fallida, una excepción regulatoria o un resultado de IA que parece plausible hasta que alguien comprueba los registros subyacentes. Un programa de DQM viable detecta esos fallos donde comienzan, dentro de los sistemas y tablas que producen los datos, en lugar de esperar a que un consumidor los descubra.
Tabla de Contenidos
Lo que realmente significa la gestión de la calidad de los datos
Gobernanza y el flujo de trabajo operativo en torno a la calidad
Modos de fallo comunes y los patrones de remediación que funcionan
Casos de uso de la industria en datos regulados y de alto volumen
De la limpieza periódica a las operaciones continuas y confiables
Cuando la confianza en los datos se quiebra silenciosamente
El equipo de FP&A ha enviado su presentación para la junta directiva. La cifra de ingresos está subestimada en un 8% porque una tabla de facturación perdió filas tras un cambio de nombre de esquema la noche anterior a la carga. El ejecutivo que revisa la presentación nota que la línea de tendencia se desvía en la dirección incorrecta, pero la primera reacción no es "incidente de calidad de datos". Es "el negocio no cumplió con el plan".
El analista comprueba la consulta de origen. Luego la consulta del informe. Luego una versión con un join diferente. El resultado sigue pareciendo incorrecto. Un ingeniero finalmente encuentra una columna huérfana que quedó tras el cambio de nombre, con la lógica posterior esperando aún el campo anterior. El vicepresidente hace la pregunta que todo líder de datos acaba escuchando: ¿cómo superó esto el control de calidad?
Esa pregunta expone la debilidad de las pruebas basadas únicamente en los resultados. Un informe puede superar una comprobación de actualización conteniendo datos incompletos. Un pipeline puede finalizar correctamente entregando una partición obsoleta. Un modelo puede producir predicciones técnicamente válidas a partir de una tabla de características cuyo significado cambió de origen. El fallo se hace visible solo después de que los datos han cruzado varios límites.
Regla práctica: Trate cada tabla crítica como un servicio de producción con un propietario, un comportamiento esperado y una ruta de incidentes.
Las consecuencias comerciales de los continuos problemas de calidad de los datos van más allá de un cuadro de mando inexacto. Los ejecutivos heredan números poco confiables, los analistas pierden tiempo demostrando hechos básicos, los reguladores pueden recibir pruebas defectuosas y los clientes pueden encontrarse con flujos de trabajo rotos basados en esos mismos registros. Gartner estima que las organizaciones pierden un promedio de 12,9 millones de dólares al año debido a fallas en la calidad de los datos, mientras que los resúmenes de la industria suelen citar que los datos erróneos afectan aproximadamente al 31% de los ingresos de las empresas. Estas cifras se resumen en la investigación de mercado sobre la gestión de la calidad de los datos.
La respuesta práctica es instrumentar el propio pipeline. Compruebe los cambios estructurales, los patrones de llegada, el comportamiento de los registros, las reglas de negocio y el impacto posterior antes de que los consumidores actúen sobre el resultado. Cada informe, característica de ML, presentación regulatoria y proceso de cara al cliente hereda la confianza ascendente que sus controles ganan o no logran proteger.
Lo que realmente significa la gestión de la calidad de los datos
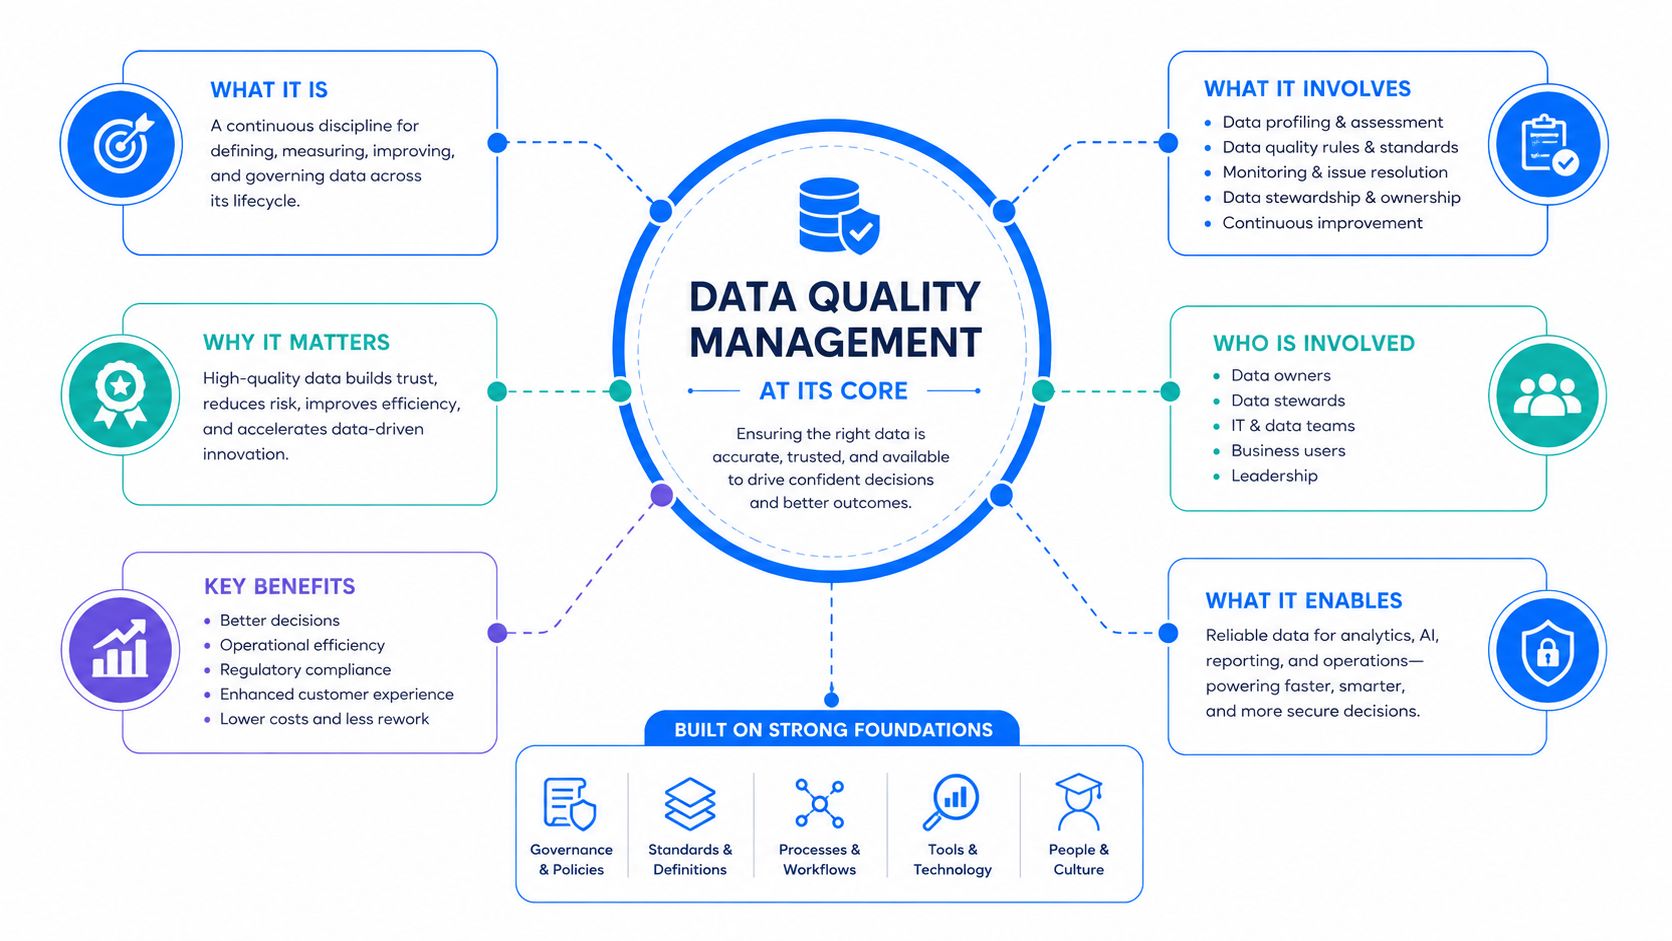
La gestión de la calidad de los datos es la práctica continua de medir, controlar y remediar los datos frente a estándares definidos a lo largo de su ciclo de vida. Ese ciclo de vida comienza en la ingesta, continúa a través de la transformación y el almacenamiento, y finaliza cuando un informe, modelo, aplicación o proceso operativo utiliza los datos.
El límite entre la DQM y las disciplinas adyacentes es importante:
La Data Governance define las políticas, la propiedad, el uso permitido y los derechos de decisión.
La Observability hace visibles las señales sobre la frescura, el volumen, el esquema y el comportamiento.
La DQM convierte esas expectativas en controles ejecutables que detectan defectos y apoyan la remediación.
La relación es operativa. La gobernanza puede requerir que un identificador de cliente sea único y esté disponible antes de que se ejecute la facturación. La Observability puede mostrar que el volumen de la tabla cambió inesperadamente. La DQM aplica las reglas de unicidad y completitud, registra la excepción y la dirige a un propietario responsable. Esta comparación de la calidad de los datos y la gobernanza de datos aclara el límite.
Medir el flujo, no solo el punto final
El control de calidad en la fabricación ofrece una comparación útil. El control estadístico de procesos en la línea de producción detecta los defectos antes de que el producto salga de la fábrica. Inspeccionar los productos terminados en el muelle de carga sigue identificando problemas, pero no puede evitar el desperdicio de materiales, los procesos de reelaboración o un envío defectuoso que ya está en tránsito.
Los controles de calidad de los datos deben realizarse en los límites de la ingesta, la transformación y el consumo, no solo en el cuadro de mando final. Un registro puede cumplir con el esquema pero llegar tarde, omitir valores obligatorios, aparecer más de una vez o no coincidir con un sistema relacionado. El punto de control debe ajustarse al modo de fallo y al coste de descubrirlo más tarde.
Reemplazar los proyectos de limpieza por controles operativos
Un ejercicio de limpieza produce una instantánea. Puede estandarizar valores, eliminar duplicados y reparar defectos conocidos, pero esos defectos vuelven a aparecer cuando cambia el proceso de origen. La DQM proporciona controles permanentemente activos que comprueban si los datos siguen siendo adecuados para el uso previsto.
En entornos regulados, los controles deben ejecutarse dentro de la base de datos del cliente siempre que la arquitectura lo permita. Las reglas y las comprobaciones de anomalías evalúan las tablas en tiempo real, preservan el contexto local y reducen el movimiento innecesario de datos. La contrapartida es que los equipos deben gestionar el coste de las consultas, los permisos y la propiedad de las reglas en el mismo entorno operativo. Esa disciplina hace que las excepciones sean más fáciles de rastrear porque el equipo responsable puede revisar el comportamiento, el historial y los fallos de la tabla allí donde residen los datos protegidos.
Core Dimensions and the KPIs That Prove Quality
Un programa de DQM necesita dimensiones que la gente pueda medir y sobre las que pueda actuar. Seis proporcionan una base práctica, pero el umbral debe reflejar el uso del conjunto de datos. Un objetivo de completitud para un atributo de marketing opcional no debe tratarse como un objetivo de completitud para un campo regulatorio.
Dimensión | KPI | Umbral Típico | Rol Responsable |
|---|---|---|---|
Precisión | Tasa de coincidencia con una fuente de confianza o distribución esperada | 99.5% en campos críticos | Custodio de datos |
Completitud | Tasa de valores nulos y por defecto por columna, segmentada por nivel de datos | Cercano a cero para campos críticos obligatorios | Propietario del sistema de origen |
Consistencia | Tasa de conciliación entre sistemas, como la coincidencia de IDs de clientes entre el CRM y la facturación | Todas las conciliaciones críticas resueltas antes de la generación de informes | Equipo de integración |
Timeliness | Retraso entre la hora del evento y la hora de disponibilidad | Minutos para operaciones, hasta 24 horas para informes | Equipo de plataforma |
Validez | Conformidad con el esquema, patrones regex y listas de valores enumerados | Se superan todas las reglas obligatorias | Ingeniería |
Unicidad | Tasa de duplicados en claves naturales y subrogadas | Sin duplicados no explicados en claves críticas | Equipo de MDM |
La medida de precisión necesita un punto de referencia. Compare los valores críticos con una fuente de confianza, un registro maestro aprobado o una distribución esperada. El custodio de datos debe ser el propietario de la definición de "confianza", porque los ingenieros pueden calcular una tasa de coincidencia sin saber si la referencia en sí misma es adecuada para su propósito.
La completitud debe segmentarse por columna y nivel. Una tasa de nulos puede ocultarse tras un promedio de tabla aceptable, mientras que falta un único campo crítico en una parte significativa de los registros. Los propietarios de las fuentes deben solucionar la recopilación y los valores predeterminados de origen, no pedir a los analistas que pongan parches en la capa de informes.
La consistencia expone los conflictos entre sistemas. La coincidencia de la identidad del cliente entre un CRM y la plataforma de facturación es un ejemplo sencillo, pero la misma lógica se aplica a los datos de productos, cuentas, proveedores y ubicaciones. Los equipos de integración son propietarios del contrato de mapeo y conciliación.
La Timeliness mide si la información llega a tiempo para la decisión que depende de ella. Un documento técnico de la referencia global de gestión de datos del EDM Council describe la Timeliness como un valor normalizado en el rango (0,1], donde los valores más cercanos a 1 representan una mejor frescura. Ese marco es útil porque un registro puede ser correcto en su contenido pero inutilizable si se ha cerrado la ventana de decisión.
La validez y la unicidad completan el conjunto de controles. Ingeniería es propietaria del formato y de las reglas de valores permitidos, mientras que los equipos de MDM son propietarios de la resolución de duplicados. No optimice la validez de forma aislada. Los datos perfectamente formateados que llegan tarde, o los datos frescos que contienen claves de negocio duplicadas, siguen creando riesgos operativos.
Para obtener un conjunto más amplio de medidas orientadas a la implementación, utilice esta guía de métricas de calidad de datos.
Gobernanza y el flujo de trabajo operativo en torno a la calidad
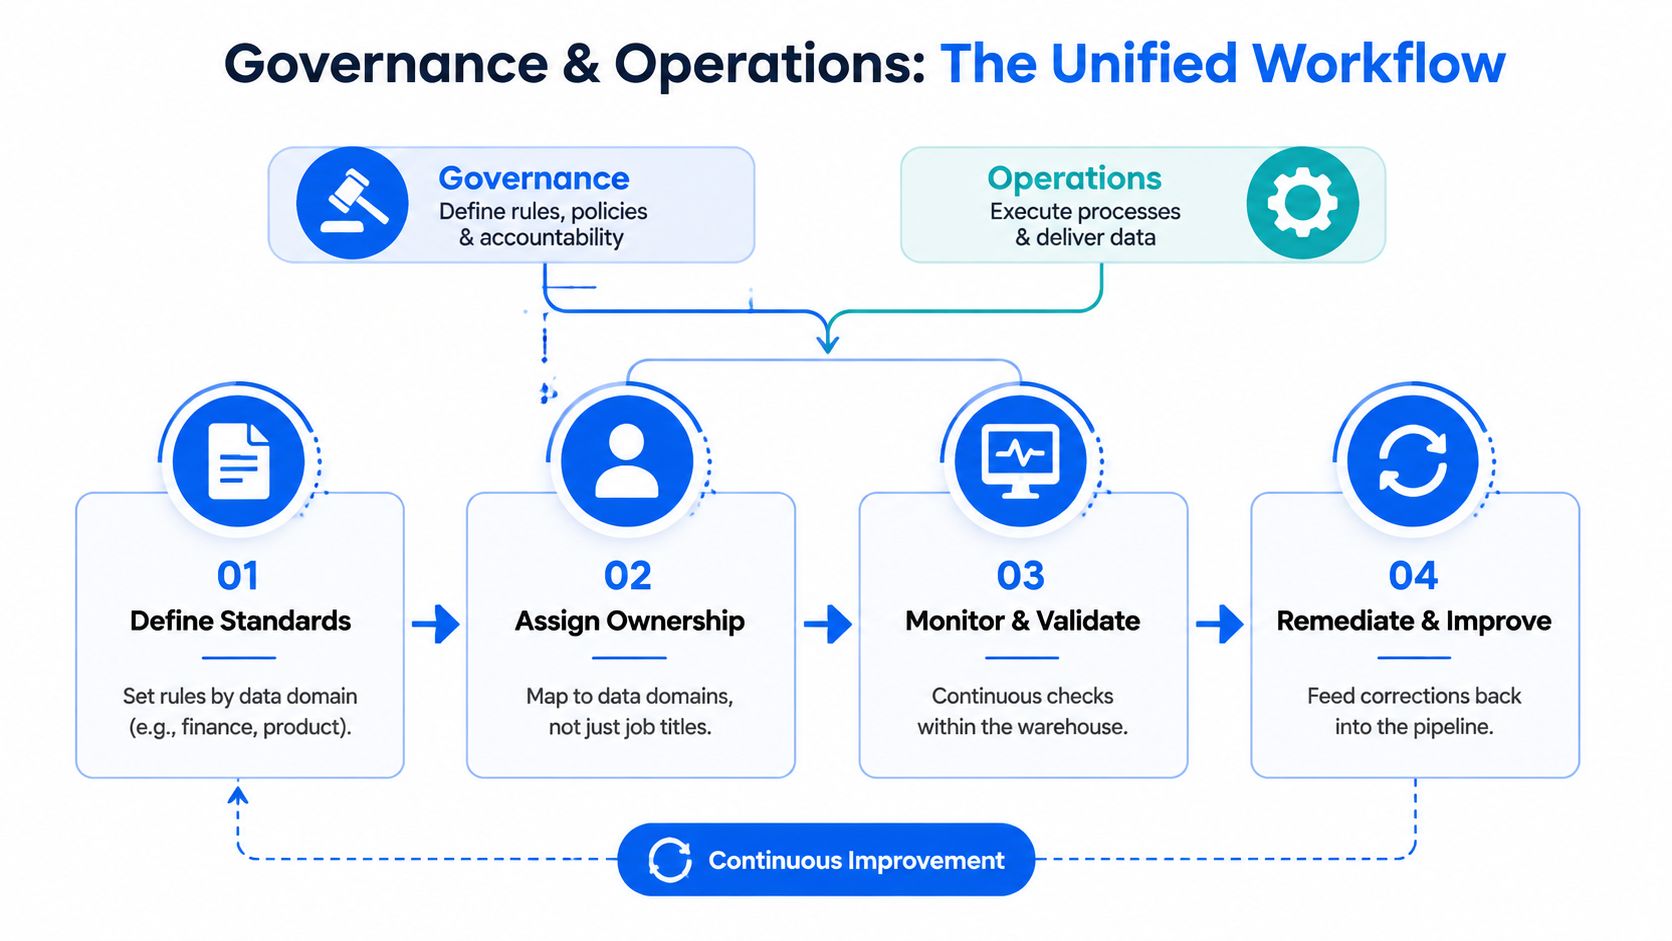
La gobernanza y las operaciones fallan cuando se limitan a reuniones separadas. Una política que no produce una comprobación es simple documentación. Una alerta sin propietario es solo ruido.
Asigne la responsabilidad por dominio de datos, no solo por cargo. Un analista financiero puede ser propietario de las tablas de ingresos, un informático clínico puede ser propietario de los registros de pacientes y un gerente de producto puede ser propietario de los eventos de comportamiento. Sus responsabilidades difieren, pero cada uno necesita autoridad para definir valores aceptables, aprobar umbrales y solicitar cambios en el sistema de origen.
Crear un catálogo de políticas
Cada propietario de dominio debe mantener un catálogo con control de versiones que contenga:
Reglas de negocio: Qué valores, relaciones y estados están permitidos.
Umbrales: Cuánta desviación es aceptable antes de intervenir.
SLAs de frescura: Cuándo deben llegar los datos para cada proceso de consumo.
Requisitos de evidencia: Qué registros, resultados y aprobaciones necesita una auditoría o revisión de incidentes.
La canalización de incidentes debe reflejar el impacto comercial. Un P1 puede interrumpir los informes ejecutivos o un proceso regulado. Un P2 puede corromper un único dominio. Un P3 puede reducir la confianza sin crear un daño operativo inmediato. Estas categorías son importantes porque evitan que cada excepción despierte a todo el equipo de datos.
Ejecutar un bucle de respuesta compartido
Los custodios supervisan los cuadros de mando, revisan las excepciones y ajustan las políticas. Los ingenieros colocan comprobaciones de validación y anomalías en los puntos de ingesta y transformación. Los comités de gobernanza revisan los patrones recurrentes, la propiedad no resuelta y las métricas de tendencia en lugar de investigar cada alerta individual.
La guía de estrategia de Data Governance es más útil cuando se traduce en este bucle operativo. En la práctica, la detección de anomalías y los monitores de Timeliness de digna se ejecutan en la base de datos contra las tablas de origen, mientras que el seguimiento de esquemas señala la deriva estructural cuando ocurre. El papel de la plataforma es proporcionar señales y pruebas. La organización sigue necesitando propietarios que puedan decidir si rechazar, poner en cuarentena, reparar o aceptar una excepción.
Una hoja de ruta de implementación que se ejecuta
Los programas de DQM se estancan cuando los equipos monitorean todo antes de demostrar que alguien responderá a una alerta. Una hoja de ruta viable comienza con las tablas donde los datos erróneos pueden interrumpir un proceso regulado, distorsionar los informes ejecutivos o afectar a un modelo de ML.
Haga primero un inventario de las tablas críticas. Evalúe la precisión, completitud, consistencia, Timeliness, validez y unicidad, y luego clasifique cada activo según su impacto comercial. Ejecute controles continuos dentro de la base de datos del cliente siempre que sea posible. Esto mantiene las comprobaciones cerca de la fuente, evita una ruta de movimiento de datos independiente y preserva las pruebas para la investigación.
Fase | Duración | Entregables Clave | Módulos de digna Utilizados |
|---|---|---|---|
Evaluación y priorización | Definido por el equipo de entrega | Inventario de tablas críticas, evaluación de dimensiones, clasificación de impacto empresarial | Data Analytics, Catálogo de Datos |
Ganancias rápidas | Definido por el equipo de entrega | Comprobaciones de nulos, detección de duplicados, monitoreo de frescura para tablas prioritarias | Data Validation, Timeliness |
Expansión del control | Definido por el equipo de entrega | Seguimiento de esquemas, monitoreo de distribución, contratos entre sistemas, enrutamiento de incidentes | Schema Tracker, Data Anomalies, Data Validation |
Escalado | Definido por el equipo de entrega | Plantillas reutilizables, incorporación de dominios, revisiones operativas | Combinación modular seleccionada |
Comenzar con controles en los que la gente pueda confiar
El primer Release debe apuntar a modos de fallo que los equipos puedan explicar y resolver. Habilite las comprobaciones de campos obligatorios, la detección de duplicados y el monitoreo de frescura en las tablas de mayor riesgo. La priorización importa más que una cobertura amplia. Un control que recibe respuesta es más valioso que un conjunto de reglas más grande que produce excepciones desatendidas.
Una vez que esas comprobaciones funcionen de manera confiable, formalice la propiedad. Publique SLAs, nombre custodios, defina rutas de escalado y pruebe el proceso con excepciones reales. Un incumplimiento de Timeliness en una tabla regulada debe llegar a su propietario responsable, en lugar de a un canal general donde nadie rinde cuentas.
Agregue controles avanzados una vez que el bucle de respuesta esté funcionando. El Schema Tracker puede señalar columnas añadidas o eliminadas y cambios en los tipos de datos. La detección de anomalías puede identificar cambios en el número de filas o en las distribuciones. Las reglas de validación pueden hacer cumplir los contratos entre sistemas, especialmente cuando la transformación de un dominio depende de los datos de otro dominio.
Comience con un enfoque lo suficientemente estrecho como para que cada alerta reciba una respuesta. Expándase solo después de que el bucle de respuesta funcione.
Escale a través de plantillas después de que los controles hayan demostrado su utilidad. Un patrón financiero para la frescura y la unicidad de las claves puede guiar a otro dominio, pero copiarlo sin revisión crea umbrales que no coinciden con el proceso local. Cada propietario debe confirmar el significado comercial de la regla y establecer su umbral en torno a la ventana de decisión del activo.
Los equipos que evalúan las opciones de despliegue pueden usar esta hoja de ruta para la implementación de la calidad de los datos como punto de partida, y luego adaptar la secuencia a su arquitectura de almacén, lago o pipeline. La prueba práctica es simple: priorizar los datos con la mayor consecuencia operativa, mantener el monitoreo cerca de la fuente y expandirse solo cuando la propiedad y la respuesta sean visibles.
Modos de fallo comunes y los patrones de remediación que funcionan
Los fallos más dañinos suelen ser los que superan una comprobación básica del pipeline. Una tarea puede informar que se ha completado con éxito mientras su resultado tiene la forma incorrecta, el tiempo de llegada equivocado o una distribución inesperada.
Modo de Fallo | Síntoma | Patrón de Remediación | Módulo de digna |
|---|---|---|---|
Deriva silenciosa del esquema | Campos agregados, eliminados o con tipos modificados rompen a los consumidores inesperadamente | Comparar la estructura actual con una línea base de referencia conocida y alertar sobre los cambios | Schema Tracker |
Flujo obsoleto | El pipeline se ejecuta con éxito, pero falta el último evento de negocio | Monitorear las marcas de tiempo comerciales y los patrones de entrega esperados | Timeliness |
Fatiga de reglas | Grandes colecciones de comprobaciones estáticas producen excepciones que nadie ajusta | Combinar reglas deterministas con líneas base de comportamiento aprendidas | Data Anomalies, Data Validation |
Ruido de alertas | Los equipos descartan o ignoran notificaciones repetidas de bajo valor | Aplicar niveles de gravedad, propiedad, ventanas de supresión y agrupación de incidentes | Cuadro de mando centrado en el usuario |
La deriva del esquema merece una atención temprana porque las comprobaciones del recuento de filas no detectarán todas las roturas estructurales. Un equipo de origen puede agregar una columna que admita nulos, eliminar un campo o cambiar un tipo de datos mientras conserva el número de filas. El SQL posterior, la lógica de BI o las características de ML pueden fallar de formas que no parezcan relacionadas con el cambio de origen.
El monitoreo de la frescura debe utilizar marcas de tiempo que tengan un significado comercial. Una tarea de orquestación exitosa demuestra que el código se ejecutó, no que llegaron datos útiles. Compare la hora del evento con la hora de disponibilidad y el comportamiento de entrega esperado para que un pipeline técnicamente en verde pueda seguir generando un incidente útil.
La validación estática sigue siendo importante para las violaciones explícitas de las políticas. Se vuelve ineficaz cuando los equipos codifican cada posible fluctuación como un umbral estricto. La detección de anomalías puede sacar a la luz desviaciones de las distribuciones y volúmenes normales, pero necesita el contexto de la propiedad y una ruta de respuesta. Ninguno de los dos enfoques sustituye al otro.
El diseño más robusto superpone los controles. Las comprobaciones de esquema detectan cambios estructurales, las comprobaciones de Timeliness detectan flujos tardíos o ausentes, las comprobaciones de volumen y distribución detectan cambios de comportamiento, y la validación determinista hace cumplir las reglas de negocio. Un cuadro de mando compartido ayuda a los encargados de responder a ver si estas señales describen un único incidente o varios problemas no relacionados.
Casos de uso de la industria en datos regulados y de alto volumen
Las prioridades de la DQM cambian con el propósito de los datos. Un equipo de finanzas puede preocuparse más por la conciliación y las pruebas de auditoría, mientras que un operador de telecomunicaciones puede necesitar identificar un problema de ingesta regional antes de que un cuadro de mando operativo resulte engañoso.
Industria | Principales Prioridades de Calidad | Ejemplos de KPIs Principales | Módulo Líder de digna |
|---|---|---|---|
Finanzas | Timeliness, unicidad, conciliación, estabilidad del esquema | Unicidad de claves de registro, conciliación de operaciones frente a riesgo, retraso en la entrega | Timeliness y Schema Tracker |
Atención médica | Integridad de la identidad, validez de las reclamaciones, frescura de los flujos | Identificadores de pacientes duplicados, conformidad de campos obligatorios, retraso en la llegada | Data Validation y Data Anomalies |
Telecomunicaciones | Frescura de alto volumen, estabilidad de volumen, consistencia regional | Comportamiento de llegada de eventos, cambios de volumen, cambios en la distribución regional | Timeliness y Data Analytics |
Sector público | Auditabilidad, completitud, consistencia, trazabilidad de excepciones | Cumplimiento de campos obligatorios, conciliación, estado de excepciones documentado | Data Validation |
Las finanzas necesitan controles a través de los límites del sistema
Los registros de operaciones y riesgos a menudo se mueven a través de sistemas de front, middle y back-office. Un conjunto de controles práctico comprueba la unicidad de las claves de registro, concilia los identificadores críticos entre sistemas y vigila los cambios en la estructura maestra de productos antes de que se rompa la atribución de pérdidas y ganancias. La Timeliness importa porque un registro de riesgo correcto que llega después de una ventana de informe o de decisión tiene un valor limitado.
La atención médica necesita disciplina de identidad y llegada
Los registros de identidad de los pacientes y los datos de las reclamaciones requieren una validación sólida porque los duplicados y los identificadores con formato incorrecto pueden distorsionar las métricas posteriores. Los MRN duplicados, por ejemplo, deberían crear un flujo de trabajo para la investigación en lugar de una tarea de limpieza invisible. Los flujos de HL7 que llegan tarde también necesitan alertas de Timeliness, especialmente cuando las métricas operativas dependen de una secuencia completa de eventos.
Las telecomunicaciones necesitan proximidad a la ingesta
Los registros de detalles de llamadas y la telemetría de red llegan en grandes volúmenes y pueden variar según la región. Las comprobaciones en la base de datos cerca de la ingesta pueden monitorear la frescura y el volumen sin crear un proceso adicional de movimiento de datos. Las vistas de Analytics pueden ayudar a los equipos a aislar si un patrón inusual es generalizado o se concentra en un área operativa específica.
El sector público necesita pruebas defendibles
Los datos de beneficios y censos pueden revisarse mucho tiempo después de la carga original. Las reglas de validación deben producir resultados trazables, asignación de propiedad de excepciones e historial de remediación. Esa evidencia es parte de la calidad de los datos, no una idea de diseño administrativo tardía. Un control que detecta un problema pero no puede mostrar quién lo revisó o qué cambió deja a la organización expuesta durante una auditoría o supervisión.
De la limpieza periódica a las operaciones continuas y confiables
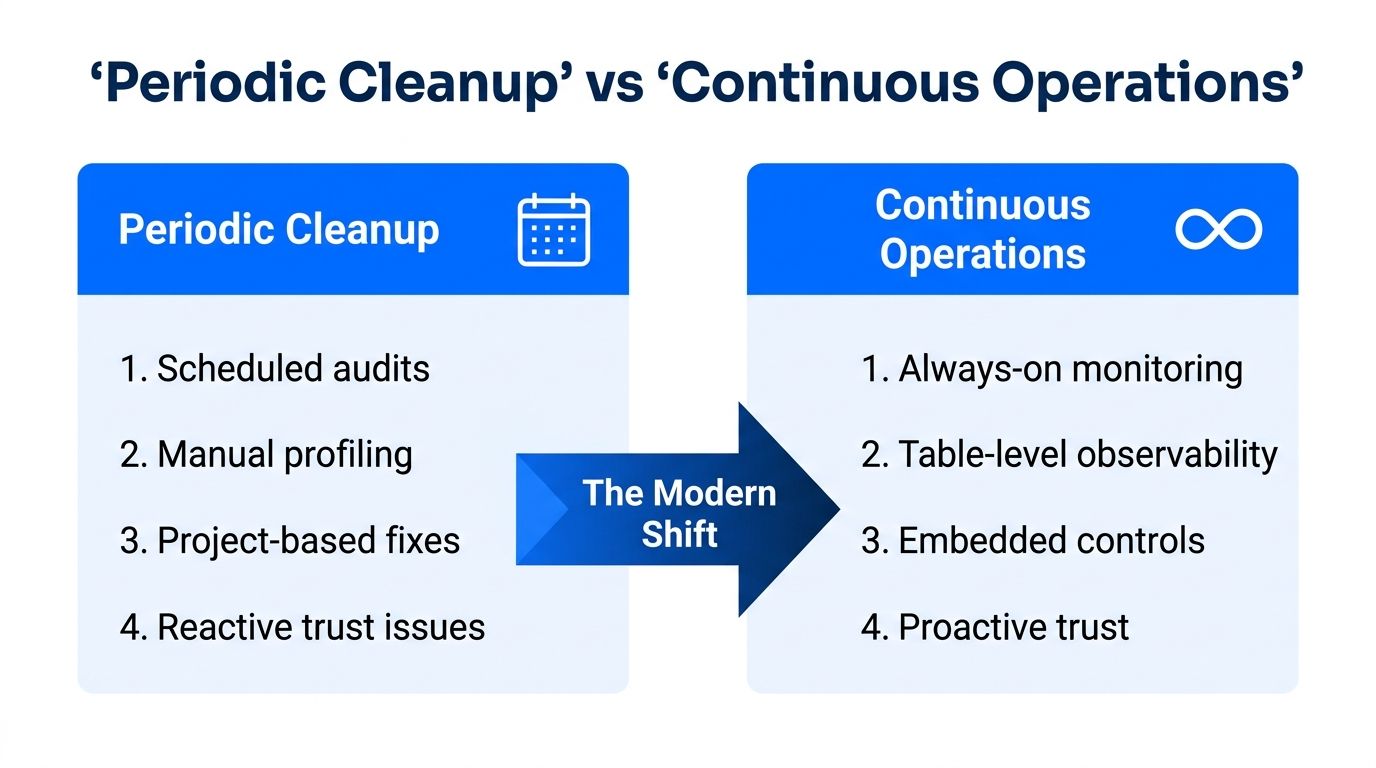
La limpieza periódica sigue siendo útil para la remediación, la migración y la creación de líneas base. Pero no es un modelo operativo. Los datos pueden corromperse entre los barridos programados, y la falta de asignación de propiedad hace que las excepciones se acumulen hasta que alguien necesita los datos con urgencia.
La evidencia de las encuestas de Monte Carlo ilustra la presión operativa. Los incidentes mensuales de datos aumentaron de 59 en 2022 a 67 en 2023, y un análisis comparativo posterior informó de aproximadamente un problema de calidad de datos por cada 10 tablas al año, en comparación con aproximadamente uno por cada 15 tablas en mediciones anteriores, como se documenta en las estadísticas de calidad de datos de Monte Carlo. La implicación es directa: el monitoreo a nivel de tabla debe ejecutarse continuamente en entornos donde los esquemas, la frescura y el comportamiento de las métricas cambian regularmente.
Una lista de verificación operativa compacta
Instrumentar primero las tablas prioritarias: Comience con los activos regulados, los informes ejecutivos y las entradas de ML.
Asignar la propiedad del conjunto de datos: Nombre a la persona o equipo responsable de cada dominio crítico.
Acordar los umbrales antes de alertar: Las partes interesadas deben definir el comportamiento aceptable antes de que los ingenieros ajusten las notificaciones.
Dirigir las excepciones a una única cola: Brinde a los encargados de responder un lugar compartido para clasificar, asignar y documentar incidentes.
Hacer un seguimiento de la detección y resolución: Monitoree el tiempo medio de detección y el tiempo medio de resolución como señales operativas.
Revisar la cobertura periódicamente: Vuelva a evaluar las reglas, las líneas base y la propiedad durante las revisiones trimestrales de control.
Para el año 2026, tres prioridades merecen atención. Primero, codificar los SLAs de calidad como contratos explícitos entre productores y consumidores. Segundo, agregar el razonamiento de anomalías asistido por IA a las guías de remediación, manteniendo a los propietarios humanos como responsables de las decisiones. Tercero, tratar el esquema y el linaje como activos de nivel de seguridad, con una disciplina de revisión comparable a la del código de producción.
El cambio no consiste solo en pasar del trabajo manual a la automatización. Consiste en pasar de una propiedad de datos incierta a una responsabilidad operativa visible. Cuando los controles se ejecutan allí donde viven los datos, los equipos pueden detectar los problemas antes, preservar las pruebas y decidir si un conjunto de datos es adecuado para el proceso que depende de él.
digna proporciona gestión de la calidad de los datos en la propia base de datos a través de la detección de anomalías, la validación, el monitoreo de la Timeliness y el seguimiento de esquemas, con un despliegue dentro de su propia nube, VPC o centro de datos. Visite digna para evaluar un plan de monitoreo enfocado para sus tablas de mayor relevancia y construir a partir de ahí.
Preguntas frecuentes
¿En qué se diferencia la gestión de la calidad de datos de la gobernanza y la observabilidad?
En lo que produce. La gobernanza define políticas, propiedad, uso permitido y derechos de decisión; la observabilidad expone señales sobre frescura, volumen, esquema y comportamiento; la gestión de la calidad convierte esas expectativas en controles ejecutables que detectan defectos y sostienen la remediación.
¿Qué se le escapa a probar solo la salida?
La causa. En un ejemplo, una cifra de ingresos estaba un 8 % subestimada porque una tabla de facturación perdió filas tras un renombrado de esquema la noche anterior a la carga. Comprobar solo la salida dice que el número parece raro, no qué cambio lo produjo.
¿Cómo debe tratarse una tabla crítica?
Como un servicio en producción con un responsable, un comportamiento esperado y una vía de incidente. Ese encuadre saca al conjunto de datos del mantenimiento de buena voluntad y le da una respuesta definida cuando se comporta mal.
¿Cuánto cuesta el fallo?
Gartner estima que las organizaciones pierden una media de 12,9 millones de USD al año por fallos de calidad, mientras que los resúmenes sectoriales citan a menudo que los datos deficientes afectan a cerca del 31 % de los ingresos. Esas cifras respaldan instrumentar la canalización en lugar de inspeccionar la salida.
¿Por dónde debe empezar una hoja de ruta?
Por los conjuntos de datos cuyo fallo tiene consecuencias, y solo para ellos recorrer estándares, controles ejecutables, medición y remediación. Una hoja de ruta que arranca con cobertura de todo el estado suele producir un backlog en lugar de un control.


