Qué es la gestión de la calidad de datos en el sector sanitario
|
8
minuto de lectura

Un médico abre un panel antes del pase de planta de la mañana y ve una tendencia tranquilizadora. El último resultado de laboratorio parece normal, pero el flujo llegó después de la ventana de reporte. En otro lugar, un código de diagnóstico contradice el historial del paciente porque un sistema de origen mapeó el valor de forma distinta durante el intercambio. El registro existe, pero no es apto para la decisión que se está tomando.
Ese es el significado operativo de la gestión de la calidad de datos en el sector sanitario. Es la disciplina continua de comprobar si los datos clínicos, operativos, de salud pública, de investigación y regulatorios son completos, precisos, coherentes, significativos y están disponibles cuando las personas los necesitan. El trabajo abarca desde los controles en el punto de captura hasta la validación del intercambio, la detección de anomalías, la remediación, el linaje y la gobernanza.
Tabla de contenidos
Lo que está en juego con la integridad de los datos clínicos
Dónde se hace visible el fallo
Las dimensiones clave de la calidad de datos sanitarios
Cuatro preguntas para el mismo conjunto de datos
Convertir las dimensiones en controles
Errores habituales en la validación de datos sanitarios
Tres modos de fallo que conviene separar
Por qué las puntuaciones agregadas ocultan el riesgo
De las auditorías estáticas a la observabilidad continua
Controles de auditoría frente a observabilidad
Qué debe revelar la monitorización continua
Garantizar la interoperabilidad y el cumplimiento normativo
La conformidad estructural no es acuerdo semántico
Datos limpios también pueden producir una IA insegura
Implementar un marco de calidad de datos escalable
Construir el plano de control por capas
Reducir el movimiento de datos y el ruido de alertas
Estrategias de datos sanitarios preparadas para el futuro
Lo que está en juego con la integridad de los datos clínicos
Un resultado tardío puede ser tan disruptivo como un resultado erróneo. Si un almacén de datos clínicos recibe un valor de laboratorio después de que el equipo asistencial ya haya revisado el estado de un paciente, el dato puede ser técnicamente correcto pero operativamente inseguro. Lo mismo ocurre con una alergia ausente, una identidad de paciente duplicada, una lista de medicación desactualizada o un diagnóstico cuyo significado cambió entre sistemas.
Los equipos sanitarios toman decisiones a través de sistemas conectados. Las historias clínicas electrónicas, las plataformas de laboratorio, los sistemas de imagen, los registros, los entornos de facturación y los almacenes de reporting aportan cada uno una parte de la historia del paciente. Cuando un componente falla, el personal puede repetir pruebas, conciliar registros manualmente, retrasar informes o actuar sobre una imagen incompleta.
La escala del intercambio convierte la disponibilidad en un requisito de calidad, no en una comodidad. En 2021, el 88 % de los hospitales de EE. UU. enviaron u obtuvieron electrónicamente información sanitaria de pacientes mediante consultas o la recepción electrónica de informes de resumen asistencial, según el informe de datos sobre interoperabilidad de la Office of the National Coordinator for Health IT. Los datos que no se pueden encontrar, interpretar ni utilizar en el punto de atención no cumplen su propósito, aunque sigan almacenados en algún lugar.
Dónde se hace visible el fallo
La mala calidad de los datos genera varios tipos de exposición operativa:
Riesgo clínico: la información ausente o contradictoria puede distorsionar el diagnóstico, la conciliación de la medicación y las decisiones de tratamiento.
Riesgo de reporting: los eventos incompletos o los denominadores inestables pueden hacer que los indicadores de calidad parezcan mejores o peores que la realidad.
Riesgo para la investigación: la codificación y la procedencia incoherentes debilitan la reproducibilidad y hacen más difícil defender la definición de las cohortes.
Riesgo de cumplimiento: los equipos pueden ser incapaces de demostrar qué registros se comprobaron, qué regla falló y cómo se llevó a cabo la remediación.
Riesgo de confianza: los clínicos y los analistas dejan de confiar en los paneles cuando encuentran discrepancias de forma reiterada.
Un proyecto de limpieza periódico no resuelve estas situaciones. Para cuando una auditoría identifica una interfaz con retraso, un mapeo roto o una carga ausente de un centro, los informes y modelos posteriores ya pueden haber consumido los datos. La pregunta práctica no es si una organización tiene errores. Todo entorno sanitario complejo los tiene. La pregunta es si puede identificar pronto los fallos relevantes, determinar su causa y conservar evidencias de la respuesta.
Para ver con ejemplos reales cómo estos fallos afectan a la atención, consulte cinco incidentes graves causados por la mala calidad de los datos sanitarios. La lección central es sencilla: la integridad de los datos forma parte de la seguridad clínica y del control operativo, no es una preocupación aislada del backlog de ingeniería de datos.
Las dimensiones clave de la calidad de datos sanitarios
El marco Data Quality Review de la Organización Mundial de la Salud ofrece a los equipos sanitarios una base útil. Define la calidad a través de la completitud, la consistencia interna, la comparación externa y la consistencia externa de los datos de población, tal como se describe en la guía de marco y métricas de la OMS.
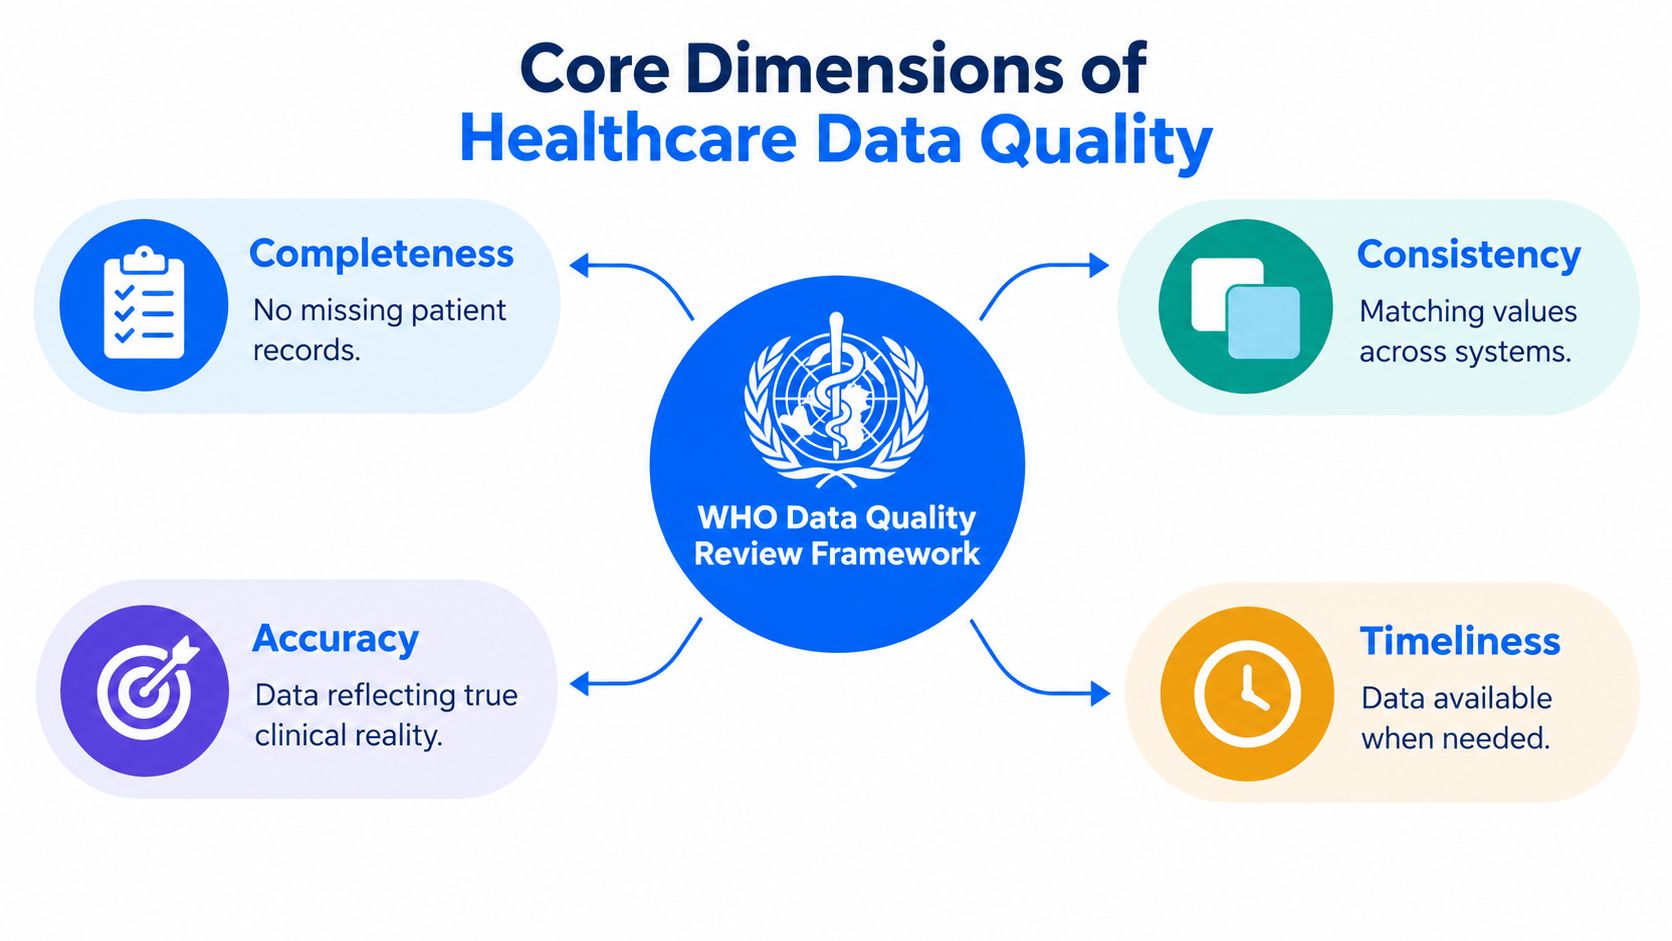
Estas dimensiones aportan un vocabulario para evaluar si los datos son aptos para un uso definido. No deberían convertirse en una lista de verificación desligada del contexto del flujo de trabajo.
Cuatro preguntas para el mismo conjunto de datos
La completitud pregunta si están presentes los registros, campos, eventos y unidades de reporte necesarios. Un centro puede enviar episodios pero omitir los eventos de alta, o rellenar los datos demográficos dejando en blanco campos clínicamente importantes. La completitud también incluye el comportamiento de entrega. Un fichero completo que llega después del plazo de reporte puede seguir siendo inservible para ese fin.
La consistencia interna pregunta si los valores relacionados concuerdan. Las fechas deben seguir secuencias válidas, los registros vinculados deben hacer referencia a entidades existentes y los valores deben cumplir las reglas clínicas o de negocio. La edad de un paciente, la fecha del episodio, el diagnóstico y el historial de procedimientos pueden parecer válidos por separado y, sin embargo, formar juntos una combinación imposible.
La comparación externa contrasta los totales con una fuente independiente. La actividad de un centro puede compararse con un registro, la aplicación de origen, el sistema de laboratorio o un libro de reporte. Esto ayuda a identificar infranotificaciones sistemáticas que los controles a nivel de registro pueden pasar por alto.
La consistencia externa de los datos de población examina si los denominadores y las estimaciones de población dan sentido a las tasas notificadas. Una tasa de vacunación, una tasa de ingresos o un indicador de enfermedad pueden calcularse correctamente y aun así inducir a error a quienes deciden si la estimación de población subyacente está desactualizada o no corresponde.
El marco también respalda expectativas prácticas en torno a la precisión, la fiabilidad y la puntualidad. La precisión se refiere a lo fielmente que un valor refleja la prestación real del servicio o la realidad clínica. La fiabilidad se refiere a si las mediciones repetidas se mantienen estables y dignas de confianza. La puntualidad se refiere a si la información está disponible dentro de la ventana que exige el uso previsto.
Convertir las dimensiones en controles
Un programa de calidad debe definir umbrales por conjunto de datos y flujo de trabajo, no publicar una única puntuación para toda la organización. Entre los controles útiles se incluyen:
Comprobaciones de campos obligatorios y de cobertura de eventos.
Validación de rangos, conjuntos de códigos y reglas condicionales.
Conciliación entre sistemas de totales e identificadores.
Monitorización de cargas retrasadas, ausentes o inusualmente pequeñas.
Documentación de excepciones, responsables, remediación y evidencias.
Las dimensiones de la calidad de datos importan porque un conjunto de datos puede ser completo pero inexacto, coherente pero obsoleto, o estructuralmente válido pero semánticamente engañoso. La gestión de la calidad empieza cuando los equipos vinculan cada dimensión con la decisión que los datos deben respaldar.
Errores habituales en la validación de datos sanitarios
El error de validación más común es tratar los campos rellenados como prueba de calidad. Un valor puede estar presente, tener el tipo correcto y aun así ser erróneo para el paciente, para el episodio o en su significado tras el intercambio. Los equipos sanitarios necesitan controles separados para la completitud, la precisión, la validez, la consistencia, la unicidad y la puntualidad.
La distinción es operativa. La metodología de calidad sobre infecciones asociadas a la asistencia sanitaria del Gobierno del Reino Unido define la precisión como la cercanía a la realidad, la completitud como la presencia de los registros esperados y de los valores esenciales, y la puntualidad como la vigencia y disponibilidad para el periodo representado. También subraya un punto crítico: la completitud no equivale a la precisión.
Tres modos de fallo que conviene separar
Datos ausentes: el episodio, la observación, el denominador o el campo obligatorio esperado nunca llega. La respuesta consiste en investigar la captura, la entrega por interfaz y la ingesta.
Datos incorrectos: el registro llega, pero su valor entra en conflicto con una fuente de referencia, un rango o una regla clínica. La respuesta requiere comparación, validación y corrección.
Datos tardíos u obsoletos: el valor es correcto pero no está disponible cuando el flujo de trabajo lo necesita. La respuesta requiere líneas base de entrega y monitorización de la puntualidad.
Una cuarta categoría merece la misma atención: el fallo semántico. Dos sistemas pueden intercambiar un código sintácticamente válido atribuyéndole significados distintos. Una transformación puede conservar el formato pero perder el contexto, las unidades, la procedencia o la relación con otro recurso.
Por qué las puntuaciones agregadas ocultan el riesgo
Un estudio multicéntrico de 2025 en 19 hospitales concluyó que el 17,7 % de los problemas de calidad de datos identificados tenía un impacto elevado, afectando al menos a la mitad de los registros relevantes, y que la investigación incompleta de las causas de error pasaba por alto fallos sistémicos críticos, según el estudio del Journal of the American Medical Informatics Association. El estudio identificó errores de abstracción de historias clínicas, diferencias entre sistemas de origen y errores de extracción, lo que muestra por qué los equipos deben investigar las causas en lugar de quedarse en un porcentaje de precisión.
Una secuencia de validación útil es:
Validar la estructura: comprobar tipos de datos, elementos obligatorios, valores permitidos e integridad referencial.
Validar el significado: aplicar reglas clínicas, operativas y entre campos.
Validar la entrega: comparar la hora de llegada, el volumen, las tasas de nulos y las distribuciones con el comportamiento esperado.
Validar el impacto: identificar los informes, indicadores, modelos, centros y grupos de pacientes afectados.
Registrar la remediación: conservar la regla, la fuente, la marca de tiempo, el número de registros afectados, el responsable y el estado.
Este enfoque trata la validación como un sistema de control y no como un ejercicio puntual de limpieza. La validación de datos sanitarios a escala debe ayudar a los equipos a localizar la capa que falla y a priorizar los defectos que pueden cambiar un resultado clínico o regulatorio.
De las auditorías estáticas a la observabilidad continua
Las auditorías periódicas siguen teniendo su papel. Aportan un aseguramiento independiente, ponen a prueba la gobernanza y examinan si los controles funcionan según lo previsto. Pero son insuficientes como mecanismo principal de detección para datos clínicos que cambian con rapidez.
Una revisión de documentos clínicos electrónicos concluyó que el 86,3 % de los documentos muestreados contenía errores, con una media de 4,9 errores por documento, según la revisión revisada por pares de documentos clínicos electrónicos. La misma revisión separó las alertas de completitud de las alertas de sintaxis, lo que ilustra por qué un fichero que llega correctamente puede seguir conteniendo defectos que comprometen su uso posterior.
Controles de auditoría frente a observabilidad
Modelo operativo | Qué hace bien | Dónde falla |
|---|---|---|
Auditoría manual periódica | Aporta profundidad de revisión y evidencias de gobernanza | Detecta los fallos cuando los datos ya se han propagado |
Biblioteca de reglas fija | Hace cumplir requisitos clínicos y de negocio explícitos | Requiere mantenimiento y puede generar ruido de alertas |
Observabilidad continua | Detecta cambios de comportamiento, cargas ausentes y desviaciones en la entrega | Necesita diseño de líneas base, responsables y una escalada sensata |
Investigación humana | Interpreta el contexto y confirma la causa raíz | No escala como primer filtro para cada registro |
Un conjunto amplio de reglas creado a mano puede parecer riguroso y, al mismo tiempo, volverse difícil de mantener. Los equipos pueden ignorar las alertas cuando los umbrales son frágiles, los duplicados son frecuentes o cualquier pequeño cambio de distribución recibe la misma prioridad. Por el contrario, un sistema sin reglas deterministas puede detectar comportamientos inusuales sin entender si el cambio infringe un requisito clínico.
El modelo práctico combina ambos enfoques. La validación determinista se ocupa de las restricciones conocidas, como campos obligatorios, códigos válidos, relaciones de referencia y lógica clínica condicional. La monitorización del comportamiento aprende los patrones esperados de volúmenes de registros, tasas de nulos, horas de entrega, distribuciones de valores y actividad asistencial, y señala las desviaciones que merecen investigarse.
Qué debe revelar la monitorización continua
Una capa de observabilidad útil puede identificar:
Una carga ausente de un centro o una reducción inesperada de registros.
Un cambio de esquema que añade, elimina o modifica una columna.
Un cambio brusco en las distribuciones de códigos o en las tasas de nulos.
Un flujo que llega más tarde de lo que indica su patrón de entrega aprendido.
Una métrica de negocio que se sale de su rango normal.
Un fallo de validación repetido y concentrado en una fuente o interfaz.
El valor no está en la alerta en sí. El valor está en el contexto: qué conjunto de datos cambió, cuándo cambió, qué fuente lo produjo, cuántos registros están afectados y qué productos posteriores dependen de él. La observabilidad de la calidad de datos expresa este paso de la limpieza reactiva a la monitorización continua de la fiabilidad.
Garantizar la interoperabilidad y el cumplimiento normativo
La interoperabilidad suele reducirse a si los sistemas pueden intercambiar mensajes. Esa definición se queda corta para el trabajo clínico. Un sistema receptor debe ser capaz de analizar, interpretar, relacionar y utilizar la información dentro de la ventana temporal requerida.
La United States Core Data for Interoperability, o USCDI, define las clases y elementos de datos básicos que deben admitir los sistemas de TI sanitaria certificados. Entre las especificaciones aplicables figuran HL7 FHIR US Core y Consolidated Clinical Document Architecture. Los requisitos de HL7 Patient Information Quality Improvement describen además mecanismos para evaluar datos estructurados, como campos obligatorios, vinculaciones terminológicas, estructura de documentos y relaciones entre los recursos intercambiados.
La conformidad estructural no es acuerdo semántico
La validación FHIR puede comprobar tipos de datos, cardinalidad, expresiones, terminología y referencias. Esas comprobaciones son necesarias, pero no garantizan que dos organizaciones utilicen un concepto en el mismo contexto operativo. La desalineación semántica entre estándares como HL7 FHIR y SNOMED CT puede dejar datos técnicamente interoperables con un significado incoherente.
Los estándares también evolucionan. USCDI y las especificaciones de intercambio asociadas se actualizan cada año, por lo que las organizaciones necesitan un seguimiento de cambios en lugar de un proyecto de conformidad puntual. Un cambio en un elemento, una vinculación terminológica, un perfil o la estructura de un documento puede afectar a la ingesta, el reporting, la analítica y los modelos posteriores.
Regla práctica: trate cada frontera de intercambio como una frontera de calidad. Valide qué llegó, qué significa, cuándo llegó y cómo se relaciona con los datos de la fuente de referencia.
Datos limpios también pueden producir una IA insegura
Un conjunto de datos puede superar los controles de esquema y completitud y seguir sin ser representativo. Los datos ausentes pueden concentrarse en una población, las prácticas de codificación pueden variar según el centro y las enfermedades raras pueden estar infrarregistradas. Estos patrones afectan no solo a la analítica descriptiva, sino también al desarrollo y la monitorización de modelos.
Una revisión de las National Academies de 2025 destacó que la disponibilidad, la calidad y el sesgo de los datos están estrechamente vinculados en la IA sanitaria, y advirtió de que los sistemas automatizados pueden amplificar las debilidades semánticas y de calidad de datos en lugar de corregirlas, según resume la revisión de las National Academies. Esto cambia la pregunta sobre la calidad de «¿Está limpia la tabla?» a «¿Quién está representado, de quién faltan datos y cómo cambia el rendimiento entre entornos y grupos?»
Un programa defendible conecta los controles técnicos con la gobernanza:
Conservar el linaje desde la captura hasta la transformación.
Registrar la procedencia y los mapeos semánticos.
Monitorizar la completitud por subgrupos y los cambios de distribución.
Hacer seguimiento de los cambios de codificación y del comportamiento específico de cada fuente.
Revisar los resultados posteriores, no solo las tasas de validaciones superadas.
Escalar las degradaciones sin explicación a través de los responsables clínicos y de gobernanza.
Por tanto, el cumplimiento normativo de los datos sanitarios requiere algo más que comprobaciones de formato. Exige evidencias de que los datos siguen siendo comprensibles, trazables, puntuales y adecuados para la decisión o el uso regulado.
Implementar un marco de calidad de datos escalable
Un marco escalable parte del uso, no de las herramientas. Identifique las decisiones clínicas, operativas y regulatorias que dependen de cada conjunto de datos y defina después qué significa un fallo para ese uso. Un flujo de laboratorio puede necesitar una monitorización estricta de la entrega, mientras que un conjunto de datos histórico de investigación puede tolerar retrasos pero exigir una documentación más sólida de la procedencia y la completitud.
Construir el plano de control por capas
Empiece con un inventario de datos que conecte fuentes, tablas, pipelines, responsables, productos posteriores y usos previstos. Priorice los conjuntos de datos de mayor impacto en lugar de intentar monitorizarlo todo a la vez.
A continuación, establezca cuatro capas de control complementarias:
Validación de registros: aplicar comprobaciones de campos obligatorios, validación de conjuntos de códigos, controles de rango, integridad referencial y reglas de negocio condicionales.
Monitorización de conjuntos de datos: seguir volúmenes, tasas de nulos, duplicados, distribuciones y volatilidad inesperada por fuente y centro.
Monitorización de la entrega: aprender el comportamiento de llegada esperado y señalar cargas ausentes, retrasos y horarios de entrega inusuales.
Monitorización estructural: detectar columnas añadidas o eliminadas, tipos de datos modificados y otras derivas de esquema antes de que los consumidores dejen de funcionar de forma inesperada.
Mantenga las evidencias cerca del control. Cada incidente debe conservar el conjunto de datos, la regla o señal, la marca de tiempo, la fuente, el número de registros afectados, la gravedad, el responsable, el estado de la remediación y las notas de resolución. Ese registro respalda la gobernanza y ayuda a los ingenieros a distinguir un problema local de documentación de un fallo en una interfaz anterior.
Reducir el movimiento de datos y el ruido de alertas
Los entornos sanitarios imponen límites estrictos al movimiento de datos sensibles. La ejecución dentro de la base de datos permite a los equipos calcular métricas y realizar análisis en el propio almacén de datos o plataforma del cliente, reduciendo copias innecesarias y preservando los controles de acceso existentes. El despliegue en nube privada y on-premises permite dar soporte a entornos donde los datos de producción deben permanecer dentro de la nube, la red privada virtual o el centro de datos de la organización.
El diseño de las alertas importa tanto como la detección. Enrute solo las desviaciones accionables, agrupe los fallos relacionados, muestre el impacto probable y permita a los equipos silenciar eventos de mantenimiento conocidos sin ocultar comportamientos nuevos. Una plataforma modular como digna puede combinar detección de anomalías, validación a nivel de registro, monitorización de la puntualidad, seguimiento de esquemas y revisión compartida de incidentes, manteniendo el cálculo en el entorno del cliente.
El objetivo de la implementación no es una puntuación perfecta. Es un ciclo operativo repetible: detectar, clasificar, investigar, remediar, verificar y aprender.
Estrategias de datos sanitarios preparadas para el futuro
Los datos sanitarios seguirán llegando desde más entornos, dispositivos, aplicaciones y vías de intercambio. La telemedicina, los dispositivos wearables, la investigación genómica y la información generada por los pacientes aportan señales útiles, pero también introducen comportamientos de captura, unidades, patrones de ausencia de datos y requisitos de procedencia diferentes. Una estrategia resiliente asume que la calidad cambiará a medida que cambie el entorno.
El enfoque más duradero integra los controles en el ciclo de vida:
En la captura: hacer explícito el contexto necesario y evitar entradas ambiguas siempre que sea posible.
En la ingesta: validar la estructura, la terminología, las relaciones y la identidad de la fuente.
Durante la transformación: conservar el linaje, las unidades, la procedencia y las decisiones semánticas.
En producción: monitorizar la entrega, las distribuciones, el comportamiento del esquema y el impacto en el negocio.
Tras los incidentes: documentar la causa raíz y convertir los fallos recurrentes en controles preventivos.
Los kits de desarrollo de software programáticos permiten integrar las comprobaciones de calidad directamente en los pipelines de datos y las aplicaciones. Así se reduce la distancia entre el momento en que un ingeniero modifica una transformación y el momento en que un equipo de gobernanza descubre la consecuencia. Aun así, las comprobaciones deben ser observables, versionadas, comprobables y estar vinculadas a responsables.
La calidad de los datos se vuelve duradera cuando los equipos la tratan como una propiedad operativa de cada pipeline, no como una inspección final antes de la publicación.
Los programas sanitarios más sólidos también se resisten a una definición estrecha de «limpio». Monitorizan la completitud por subgrupo y entorno, distinguen los valores válidos de los valores significativos, contrastan la puntualidad con los plazos clínicos y revisan si los modelos o informes se comportan de forma distinta tras cambios en las fuentes. La mejora continua consiste en afinar umbrales, retirar comprobaciones ruidosas, ampliar el linaje e implicar a los profesionales clínicos cuando las anomalías técnicas puedan afectar a la atención.
Entonces, ¿qué es la gestión de la calidad de datos en el sector sanitario? Es la práctica continua de mantener la información apta para su uso clínico, operativo, de investigación, de salud pública y regulatorio previsto. Las organizaciones que integran esta disciplina en la captura, el intercambio, los pipelines y los sistemas de decisión pueden convertir los datos en un activo controlado en lugar de una fuente recurrente de incertidumbre.
digna ofrece calidad y observabilidad de datos dentro de la base de datos para conjuntos de datos sanitarios, con detección de anomalías, validación a nivel de registro, monitorización de la puntualidad y seguimiento de esquemas en su propio entorno. Visite digna para evaluar un enfoque modular que haga más fiables los datos clínicos, operativos y regulatorios.
Las identidades de paciente duplicadas y los episodios que apuntan a registros que ya no existen son fallos de relación tanto como errores de valor. Para saber cómo comprobar esos vínculos entre la historia clínica electrónica, el laboratorio y los sistemas de reporting, consulte integridad referencial en los datos sanitarios.
Preguntas frecuentes
¿Qué es la gestión de la calidad de datos en el sector sanitario?
Es la disciplina continua de comprobar que los datos clínicos, operativos, de investigación, de salud pública y regulatorios son completos, precisos, coherentes, significativos y están disponibles cuando se necesitan. El trabajo va desde los controles en el punto de captura, pasando por la validación del intercambio, la detección de anomalías y la remediación, hasta el linaje y la gobernanza, en lugar de ser un proyecto de limpieza puntual.
¿Qué dimensiones utiliza la OMS para evaluar la calidad de los datos sanitarios?
El marco Data Quality Review de la OMS utiliza la completitud, la consistencia interna, la comparación externa con una fuente independiente y la consistencia externa de los datos de población, como los denominadores. También respalda expectativas de precisión, fiabilidad y puntualidad. Los equipos deberían convertir cada dimensión en umbrales para un conjunto de datos y un flujo de trabajo concretos, en lugar de usar una única puntuación para toda la organización.
¿Por qué un registro completo no demuestra que los datos sanitarios sean buenos?
La completitud no equivale a la precisión. Un valor puede estar presente y tener el tipo correcto, pero ser erróneo para el paciente, para el episodio o en su significado tras el intercambio. Los datos ausentes, incorrectos, tardíos y semánticamente desalineados son modos de fallo distintos, y cada uno necesita su propio control, desde comprobaciones en las interfaces hasta líneas base de entrega y mapeo terminológico.
¿Por qué las auditorías periódicas no bastan para los datos clínicos?
Las auditorías solo detectan los fallos cuando los datos ya han llegado a informes y modelos. Una revisión encontró errores en el 86,3 % de los documentos clínicos electrónicos muestreados. La observabilidad continua complementa las auditorías al señalar cargas ausentes de centros, flujos con retraso, cambios de esquema y variaciones en las tasas de nulos o en las distribuciones de códigos cuando todavía hay tiempo para actuar.
¿Cómo se construye un marco escalable de calidad de datos sanitarios?
Se parte de las decisiones que respalda cada conjunto de datos y después se añaden controles por capas: validación de registros, monitorización de volúmenes y distribuciones de los conjuntos de datos, monitorización de la entrega frente a patrones de llegada aprendidos y monitorización estructural de la deriva de esquemas. Ejecutar las comprobaciones dentro de la base de datos limita el movimiento de datos sensibles, y cada incidente debe conservar responsable, registros afectados y estado de la remediación.


