Fuentes de datos disparatadas: Una guía práctica de integración
|
7
minuto de lectura
Es probable que ya haya vivido esto. Una reunión matutina de lunes comienza con una persona diciendo que el CRM indica que el último trimestre fue fuerte, finanzas dice que la historia del margen parece diferente y el almacén de productos muestra un tercer número completamente distinto. Nadie está mintiendo, pero la sala se queda en silencio porque cada informe describe una versión ligeramente diferente del negocio.
Eso es lo que hace que las fuentes de datos dispares sean tan frustrantes. La ruptura rara vez comienza con una interrupción dramática, comienza con pequeñas decisiones: una marca de tiempo interpretada de una manera en una canalización, una regla de reembolso actualizada en otra, o una definición de “cliente activo” que se desvió lo suficiente como para deformar el panel de control. Si ha heredado una pila de informes que creció a través de iniciativas pasadas, fusiones, intercambios de proveedores y soluciones “temporales” que nunca se fueron, ya sabe lo normal que se siente esto.
Tabla de contenidos
Estrategias de integración entre las que vale la pena elegir
Una lista de verificación práctica para su próximo proyecto de integración
Cuando sus informes dejan de coincidir
Un responsable de finanzas entra con una hoja de cálculo, un analista de productos abre el panel del almacén y el equipo de CRM señala su propia vista de ingresos. Los tres números parecen razonables a primera vista, lo que hace que el desacuerdo sea peor, no mejor. El equipo no recibe una señal clara de falla, sino tres historias plausibles que no pueden ser todas ciertas al mismo tiempo.
Ese suele ser el momento en que la gente culpa al almacén, a la capa de BI o al último trabajo de ETL que tocaron. La causa suele estar río arriba. Una canalización puede haber convertido las marcas de tiempo a la hora local, otra puede haber aplicado una nueva política de reembolsos y una tercera puede seguir contando un “cliente activo” según una definición que nadie documentó después del último lanzamiento.
Es por eso que la conciliación de datos consiste menos en “hacer que los informes coincidan” y más en rastrear qué sistema es el propietario de qué versión de la realidad. Un punto de partida útil es un modelo mental simple: cada fuente tiene sus propias reglas, y esas reglas pueden divergir sin que ningún equipo tenga la intención de causar problemas. Para obtener una definición en lenguaje sencillo de ese problema de conciliación, consulte la descripción general de la conciliación de datos de digna.
Regla práctica: si tres informes no coinciden, no empiece por reescribir el panel de control. Comience por preguntar qué campo, regla o marca de tiempo cambió primero.
La confusión es muy común porque las pilas de datos modernas se construyen a partir de la historia acumulada, no de un diagrama de arquitectura limpio. Eso significa que el mismo evento comercial puede estar representado en un CRM, un sistema financiero, un almacén y una herramienta de soporte, cada uno con su propio ritmo y su propio vocabulario. Una vez que eso sucede, “el número” deja de ser un solo número y se convierte en una negociación entre sistemas.
Qué significan realmente las fuentes de datos dispares
“Dispar” suena como un problema de formato, pero esa es solo la primera capa. Una fuente puede llegar como JSON, otra como CSV, otra como parquet, y la exportación de un proveedor puede estar bloqueada dentro de su propia estructura. Incluso a ese nivel, la forma de los datos ya cambia la manera de ingerirlos, analizarlos y validarlos.
La siguiente capa es el ritmo. Un archivo por lotes nocturno, un flujo de eventos en tiempo real y una hoja de cálculo mantenida manualmente se comportan de manera diferente en una canalización. Si los trata igual, la fuente más fresca puede seguir siendo la menos confiable porque llega en el momento equivocado, con las expectativas incorrectas asociadas.
Luego viene la capa que la mayoría de las guías omiten: la semántica. Dos sistemas pueden tener una columna llamada customer_id, pero uno puede ser la clave principal del sistema de registro mientras que el otro es un identificador de marketing que se anonimizó para los informes de campaña. Las etiquetas coinciden, el significado no, y ahí es donde las uniones ingenuas confunden a las personas.

La pila de desajustes
Una buena manera de pensar en las fuentes de datos dispares es como una pila. Las diferencias de formato se sitúan en la base, los límites del sistema por encima de eso y las diferencias semánticas en la parte superior, donde reside el significado comercial. Cada capa agrava la que está debajo, por lo que una unión puede parecer técnicamente exitosa y aun así ser analíticamente incorrecta.
Cuando los equipos buscan un mejor proceso de descubrimiento en almacenes, API y herramientas heredadas, generalmente necesitan una forma de revelar esas capas de manera temprana. Un punto de partida práctico es la guía de descubrimiento de datos de digna, porque el inventario de fuentes y las comprobaciones de significado deben realizarse antes de que las transformaciones consoliden suposiciones erróneas.
Un conjunto de datos puede estar perfectamente formateado y aun así ser incorrecto para la pregunta que se está planteando.
Ese es el malentendido central. La gente suele asumir que la integración de datos consiste principalmente en mover bytes de un lugar a otro. En la práctica, se trata de alinear el formato, el ritmo, el diseño del sistema y el significado comercial para que la vista final no solo se cargue correctamente, sino que diga la verdad.
Cuatro desafíos prácticos que encontrará primero
Los primeros problemas de integración aparecen rápido y suelen parecer mundanos. La carga útil de un webhook de Stripe llega como JSON anidado, mientras que un ERP heredado todavía emite archivos nocturnos de ancho fijo. El desajuste de forma es obvio, pero el costo es la constante inferencia de esquemas y el tiempo humano dedicado a decidir qué campo es el autoritativo.
Los cuatro modos de falla que surgen temprano
Desafío | Cómo se ve | Síntoma típico |
|---|---|---|
Heterogeneidad de formatos | JSON anidado por un lado, exportaciones de ancho fijo por el otro | Los trabajos de carga se rompen o infieren el esquema incorrecto |
Desajuste de ritmo | Tickets en tiempo real mezclados con archivos de encuestas semanales | Los paneles de control envejecen silenciosamente y confunden a los usuarios |
Variación de calidad | Enriquecimiento de terceros junto a un flujo de clics propio incompleto | Valores nulos, duplicados y agregados inestables |
Conflicto semántico | “País” significa código ISO en un sistema y texto libre en otro | Las uniones tienen éxito, pero el KPI es incorrecto |
El desajuste de ritmo es el que más engaña a los equipos. Los tickets de soporte pueden transmitirse casi en tiempo real mientras que las encuestas de satisfacción del cliente llegan en un CSV semanal, lo que significa que cualquier vista de las “últimas 24 horas” puede estar incompleta sin parecer rota. Si el analista no conoce el perfil de retraso de cada fuente, confundirá las diferencias de frescura con cambios en el negocio.
La variación de calidad es el asesino silencioso. El enriquecimiento de terceros puede coexistir con datos de flujo de clics de origen propio con sesiones faltantes, identificadores duplicados o registros inconsistentes, y el resultado fusionado aún puede parecer lo suficientemente limpio como para pasar una revisión casual. Ese tipo de inestabilidad es exactamente la razón por la que la calidad de la fuente debe tratarse como parte del diseño, no como un trabajo de limpieza posterior.
El conflicto semántico es el más difícil porque se esconde detrás de nombres de campo familiares. Una fuente que utiliza country para códigos ISO, otra que almacena texto libre y una tercera que mantiene una abreviatura desactualizada están todas “correctas” dentro de sus propios sistemas. En el momento en que las compara, el significado comercial se fractura.
Para los equipos que intentan comprender cómo la desviación estructural se convierte en canalizaciones rotas, la guía de desviación de esquemas de digna ayuda a enmarcar el problema como uno operativo, no solo como una molestia de modelado.
Si el nombre del campo le resulta familiar, vaya más despacio. Los nombres familiares son el lugar donde se esconden los errores semánticos.
Es por eso que los proyectos de integración se estancan tan a menudo. Los primeros problemas no son exóticos, son comunes y repetitivos, y obligan a los equipos a elegir entre velocidad y confianza antes de que se defina la forma de la pila de datos.
Estrategias de integración entre las que vale la pena elegir
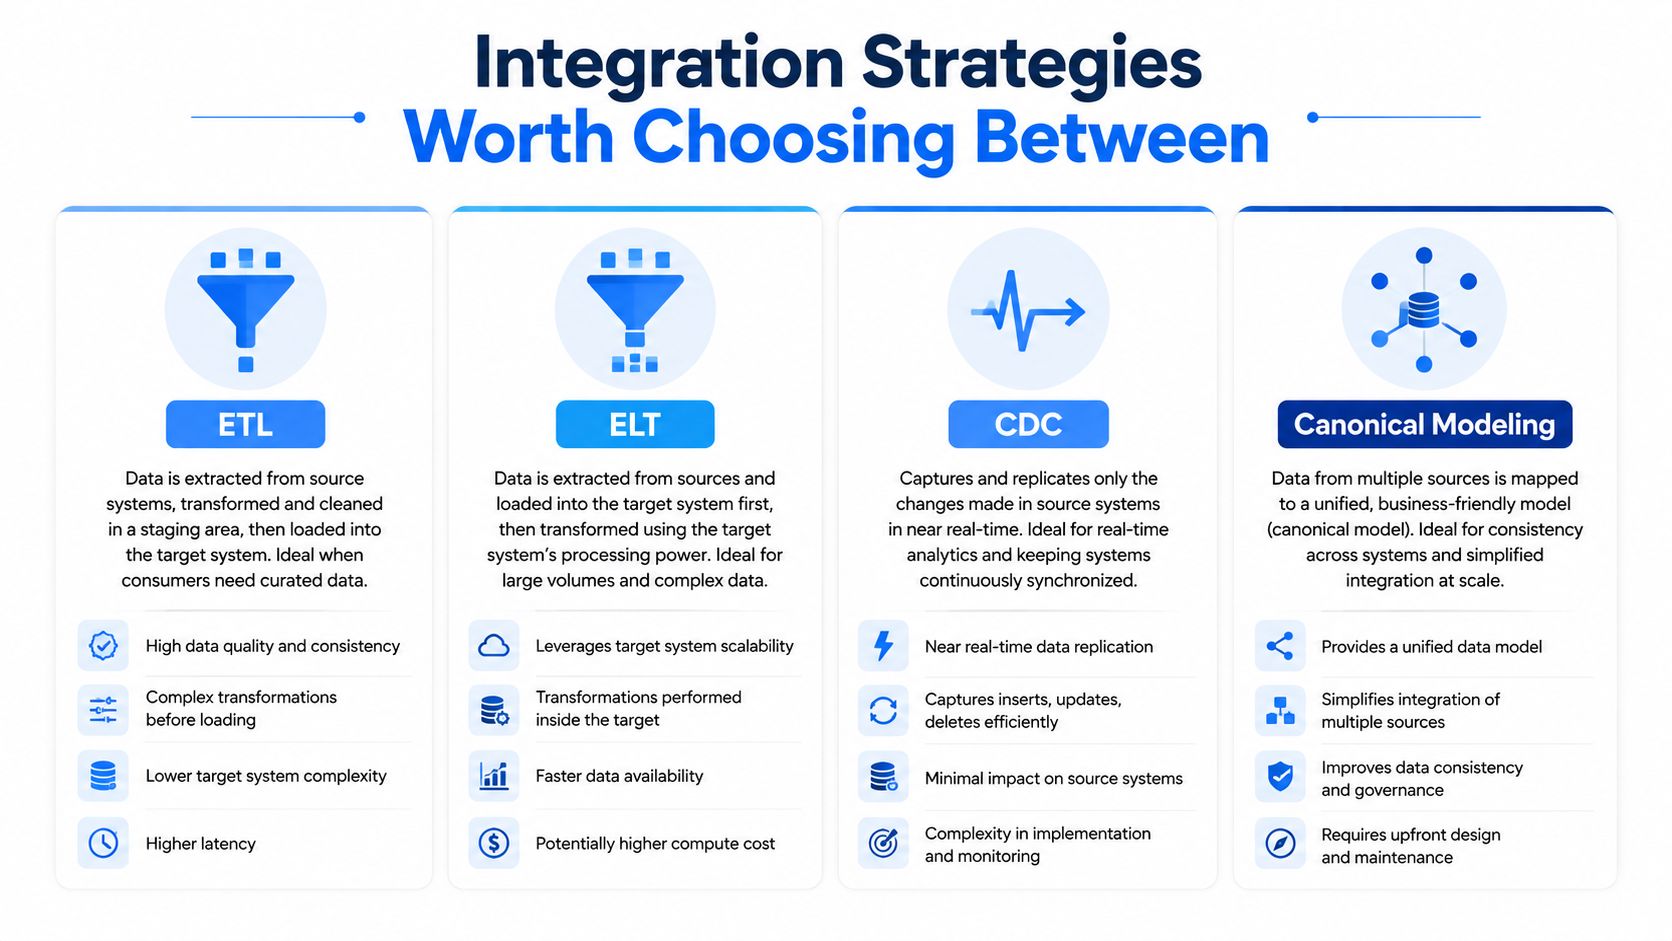
ETL, ELT, CDC y el modelado canónico resuelven problemas diferentes y es fácil darles un mal uso cuando se tratan como una ideología. ETL funciona cuando los consumidores necesitan datos estructurados y curados, y los sistemas de origen son lo suficientemente estables como para poder transformarlos antes de cargarlos sin tener que rehacer el trabajo constantemente. Es una buena opción para consumidores heredados, flujos de cumplimiento normativo (Compliance) y capas de informes que solo deben ver estructuras validadas.
ELT tiene más sentido cuando el almacén de datos es rápido y los analistas quieren fidelidad bruta primero y transformación en segundo lugar. Eso permite a los equipos preservar los detalles de origen y revisar la lógica más tarde sin tener que volver a extraer los datos. Es especialmente útil cuando las preguntas comerciales cambian más rápido que los sistemas de origen.
CDC pertenece a la vía operativa. Cuando los sistemas descendentes deben reflejar los cambios de origen rápidamente, la captura de datos modificados mantiene el retraso lo suficientemente pequeño como para que los flujos de trabajo de productos, soporte o finanzas puedan mantenerse alineados con lo que acaba de suceder. La desventaja es que CDC puede trasladar la incertidumbre más rápido, por lo que aún necesita validación al llegar.
El modelado canónico resuelve un problema completamente diferente: el acuerdo. Si ventas, producto y finanzas necesitan la misma definición de cliente o producto antes de que comience cualquier trabajo descendente, un modelo canónico les brinda un contrato compartido. Es más lento al principio, pero evita que cada equipo invente su propia verdad más adelante.
Las pilas de datos más inteligentes suelen mezclar estos patrones. Un equipo podría cargar CDC en una zona de preparación, usar ELT dentro del almacén de datos, alimentar un modelo canónico en BI y seguir usando ETL para dar forma a las exportaciones para un sistema heredado. Eso no es inconsistencia, es arquitectura adaptada al propósito.
Si está comparando opciones de integración para casos de uso analíticos y sensibles a la privacidad, una solución de BI que prioriza la privacidad puede ser un contexto útil porque el patrón de integración y la capa de consumo generalmente deben diseñarse juntos.
Para proyectos centrados en el almacén de datos, la página de integración del almacén de datos de digna es un punto de referencia útil sobre cómo se conectan en la práctica las capas de carga y servicio.
La estrategia de integración correcta es la que se adapta al consumidor, al requisito de latencia y a la cantidad de confianza que se puede exigir en el límite.
Muchos equipos pierden semanas discutiendo sobre qué patrón es "moderno". Esa discusión pasa por alto el punto clave. La pregunta fundamental es qué patrón mantiene el contrato semántico lo suficientemente claro como para que los equipos descendentes puedan usar los datos sin tener que aplicar ingeniería inversa.
Armonización y validación que se sostienen
La armonización comienza con la deduplicación, pero no del tipo simplista que asume que ya existen claves exactas. Los sistemas independientes rara vez comparten identificadores perfectos, por lo que las claves de bloqueo y la coincidencia probabilística a menudo se vuelven necesarias solo para determinar qué registros probablemente se refieren a la misma entidad. Ese paso debería ocurrir antes de que la lógica de fusión consolide los recuentos de duplicados en una falsa certeza.
Normalize el significado antes que el número
Una vez alineados los registros, normalice la capa de unidades. Las monedas, las zonas horarias, los sistemas de medición y los calendarios fiscales crean desajustes invisibles cuando los equipos asumen que un valor significa lo mismo en todas partes. Un número de ingresos en hora local y un número de ingresos en UTC pueden ser correctos y aun así no ser comparables.
La reconciliación semántica viene a continuación. Las tablas de mapeo y las definiciones autoritativas importan aquí, porque los nombres de los campos a menudo ocultan diferencias en las reglas comerciales que ninguna comprobación de tipo detectará. Un nombre de columna limpio no ayuda si una fuente trata al “cliente” como una cuenta, otra como un usuario y una tercera como una entidad de facturación.
El mismo principio se manifiesta en el trabajo del “registro de oro” (golden record), donde los equipos intentan decidir qué versión de un cliente, producto o ubicación debe prevalecer. Si desea otro marco práctico para ese problema, el enfoque de registro de oro de BatchData es una referencia externa útil sobre cómo una capa de registro compartido cambia la coherencia descendente.
La validación debe situarse por encima de la armonización, no después de ella. Las comprobaciones de esquema pertenecen al límite, las comprobaciones de integridad referencial pertenecen al espacio entre sistemas, las reglas comerciales como las cantidades no negativas pertenecen a la canalización y la conciliación a nivel de fila debe comparar los totales de control de cada fuente. Para una forma estructurada de pensar en esas comprobaciones, la guía de reglas de validación de digna es relevante porque la validación tiene que viajar con los datos, no esperar a que un panel de control se queje.
Dónde pertenece la validación
La validación al final es demasiado tarde. Para cuando el panel de control parece incorrecto, el contexto que explicaría la falla ya ha caducado.
El patrón más sólido es validar en cada traspaso, porque cada traspaso aún conserva el contexto de la fuente, el propietario y la expectativa original. Eso agiliza la resolución y acorta las discusiones. También evita que los equipos traten los datos fusionados como confiables solo porque sobrevivieron a un trabajo de carga.
El monitoreo como sistema de alerta temprana
El monitoreo solo ayuda si detecta la causa antes de que el informe se convierta en un misterio. La forma más limpia de hacerlo es realizar un seguimiento conjunto de la puntualidad (Timeliness), las anomalías y los cambios de esquema, no como colas separadas. Si una fuente llega tarde, el panel de control ya está envejeciendo, incluso si los números aún parecen impecables.
El monitoreo de la puntualidad (Timeliness) es la primera línea de defensa porque los problemas de frescura a menudo comienzan río arriba y se extienden río abajo sin una ruptura visible. Si un SLA se retrasa, el equipo necesita saberlo antes de que los usuarios comerciales comiencen a tomar decisiones basadas en datos desactualizados. Eso importa más cuando una fuente que llega tarde puede alterar un KPI sin cambiar la forma del gráfico.
La detección de anomalías cubre una clase diferente de fallas. Los cambios de volumen, los cambios de distribución y los picos en la tasa de nulos pueden revelar un filtro roto, una unión faltante o un despliegue defectuoso río arriba mucho antes de que alguien note una caída en los ingresos. Ese es el valor de vigilar el comportamiento de la fuente, no solo el resultado en el panel de control.
El seguimiento de esquemas cierra el ciclo. Las adiciones de columnas, los cambios de tipo y la desviación de la anulabilidad son los cambios estructurales silenciosos que rompen a los consumidores descendentes después de que una canalización parece estar “funcionando”. Para los sistemas de datos que necesitan reaccionar a los requisitos cambiantes de clasificación y protección, el NIST señala que el monitoreo debe detectar cambios en el activo mismo y activar controles revisados cuando sea necesario, razón por la cual el seguimiento de esquemas pertenece al ciclo operativo, no solo a la documentación.
Una vista de monitoreo práctica es un panel de control agrupado por fuente, con indicadores de linaje asociados a cada alerta. Eso permite a un ingeniero de guardia rastrear un archivo retrasado, una anomalía de volumen o un cambio de esquema hasta el sistema de origen sin tener que saltar entre herramientas. Los mejores equipos dejan de preguntar “¿Qué informe es incorrecto?” y comienzan a preguntar “¿Qué fuente cambió primero?”.
Señales de monitoreo y lo que detectan
Categoría de señal | Lo que rastrea | Falla detectada a tiempo |
|---|---|---|
Puntualidad (Timeliness) | Retraso en la llegada, cargas faltantes, llegadas anticipadas | Paneles desactualizados y retraso silencioso |
Detección de anomalías | Volumen, distribución, cambios en la tasa de nulos | Filtros rotos, uniones faltantes, rupturas río arriba |
Seguimiento de esquemas | Columnas añadidas, cambios de tipo, desviación de anulabilidad | Fallas en la canalización por cambios estructurales |
La diferencia entre el monitoreo reactivo y el proactivo es el tiempo. Los equipos reactivos se enteran del problema después de que los usuarios se quejan. Los equipos proactivos detectan la causa mientras aún es pequeña, lo que ahorra tanto confianza como tiempo de resolución de incidentes.
Lista de verificación práctica para su próximo proyecto de integración
Comience antes de escribir la primera transformación. Catalogue cada fuente, clasifique su ritmo e identifique al propietario que pueda responder rápidamente a las preguntas sobre el esquema y el significado. Señale las colisiones semánticas de manera temprana, especialmente para campos como cliente, ingresos, país y producto.
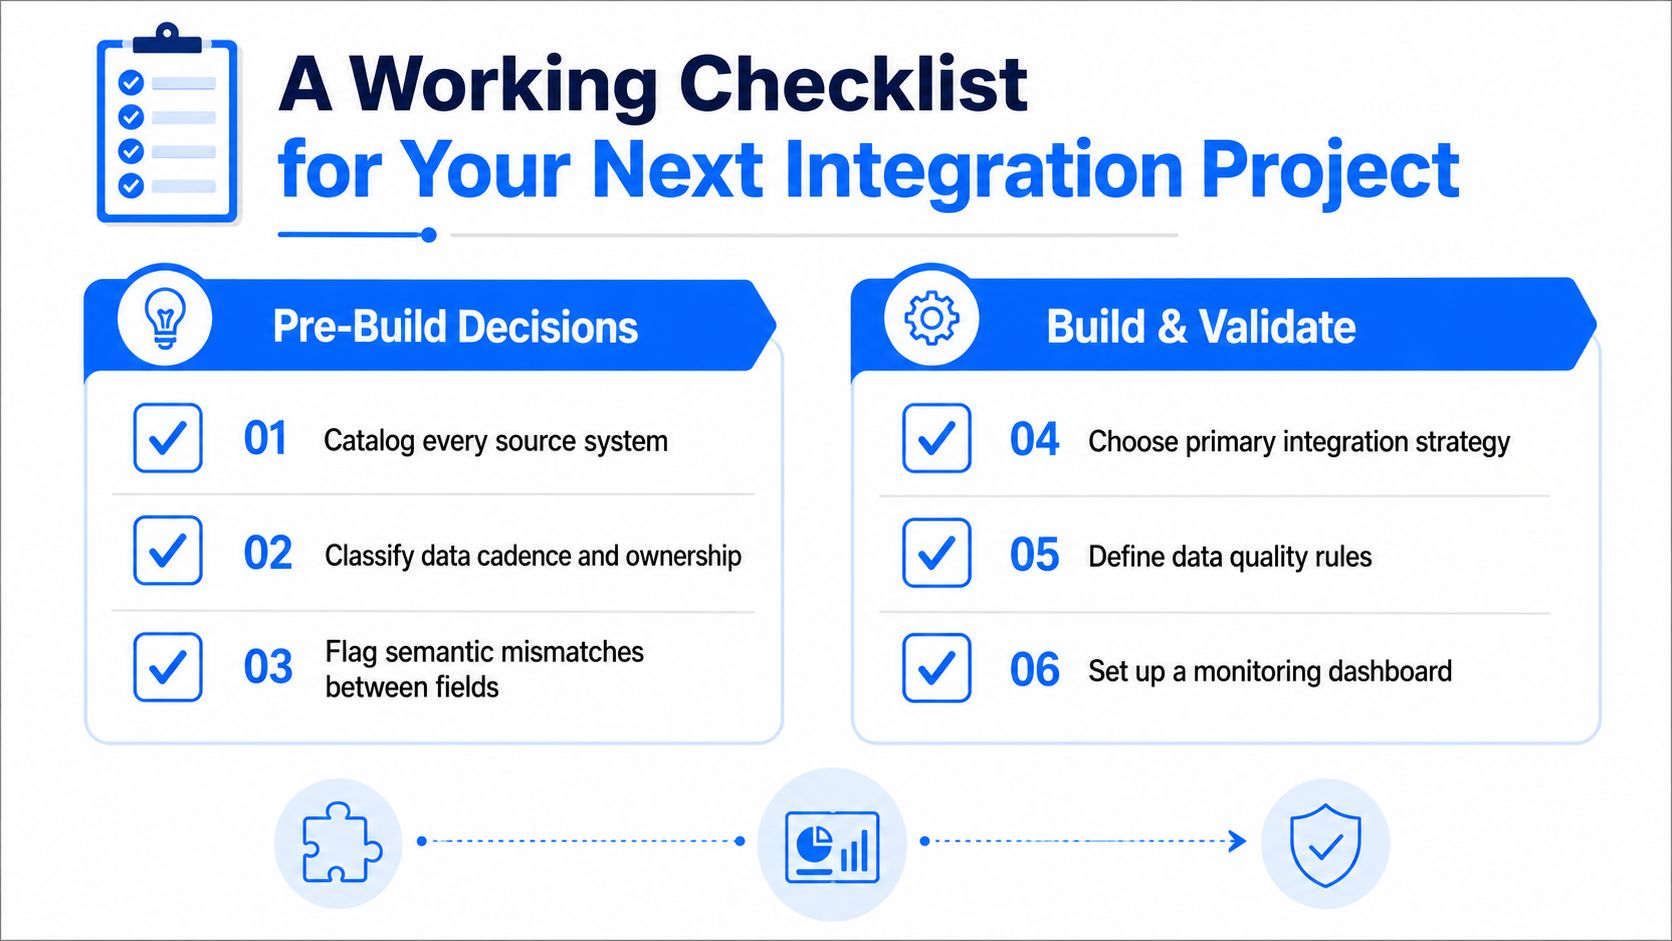
Decisiones previas a la construcción
Catalogue cada sistema de origen, para no descubrir una hoja de cálculo oculta después del lanzamiento.
Clasifique el ritmo y la propiedad, para que los archivos retrasados y los traspasos poco claros no se conviertan en incidentes sorpresa.
Señale los desajustes semánticos, para que los equipos no reutilicen el mismo nombre de campo para diferentes significados comerciales.
Construir y validar
Elija el patrón de integración principal, ETL, ELT o CDC, según el consumidor y la necesidad de latencia.
Documente primero el modelo canónico, para que las transformaciones no codifiquen definiciones en conflicto.
Establezca umbrales de validación y alertas de frescura, para que las cargas incorrectas fallen rápido en lugar de filtrarse en BI.
Agregue monitores de desviación de esquemas y comprobaciones de recuento de filas, para que las fuentes caídas y los cambios estructurales aparezcan antes de que lo hagan los usuarios.
Si necesita una secuencia concreta, realice una auditoría de fuentes de un día, redacte el esquema canónico en una pizarra y conecte una comprobación de Observability en la canalización de mayor tráfico. Eso es suficiente para detener la primera ronda de fallas silenciosas sin esperar a que un comité apruebe la arquitectura.
Si su equipo se enfrenta a informes desalineados, desviación semántica o canalizaciones que solo fallan cuando el panel ya es incorrecto, digna le ofrece una forma de monitorear la puntualidad (Timeliness), la validación, los cambios de esquema y las anomalías dentro de su propio entorno. Visite digna para ver cómo encaja esto en una pila de integración real y utilícelo como punto de partida para crear datos en los que sus equipos puedan confiar.
Preguntas frecuentes
¿Qué significa realmente «fuentes dispares»?
Más que un problema de formato. El formato es solo la primera capa; debajo hay definiciones distintas, cadencias de actualización distintas e ideas distintas sobre qué sistema posee qué versión de la realidad, y eso es lo que hace que los informes discrepen.
¿Por dónde empezar cuando tres informes no coinciden?
No reescribiendo el panel. Empiece preguntando qué campo, regla o marca de tiempo cambió primero, porque la conciliación va menos de hacer que los informes cuadren y más de rastrear qué sistema posee qué versión de la realidad.
¿Por qué producen este problema las pilas modernas?
Porque se construyen a partir de historia acumulada y no de un diagrama de arquitectura limpio. Cada sistema llegó para resolver un problema concreto en un momento concreto, y los solapamientos entre ellos rara vez se diseñaron de forma deliberada.
¿A quién se culpa primero normalmente?
Al almacén, a la capa de BI o al último trabajo ETL que alguien tocó. Ese reflejo es comprensible y casi siempre equivocado, porque la discrepancia suele haber empezado más arriba, en una definición, y no en la capa donde se hizo visible.
¿Qué exige la armonización más allá del mapeo?
Acuerdo sobre la propiedad. Mapear campos entre sistemas resuelve la parte mecánica, mientras que decidir qué sistema es autoritativo para cada concepto es la parte que evita que la misma discusión vuelva cada trimestre.


