El formato de tabla abierto Iceberg explicado con sencillez
|
8
minuto de lectura

Tu panel dice que los ingresos de ayer cayeron, pero el problema es menos evidente. Un motor leyó un directorio antes de que un nuevo lote estuviera plenamente confirmado, otro interpretó una partición de forma distinta y un tercero sigue viendo un esquema antiguo. Los archivos existen y, aun así, la tabla no puede dar una única respuesta fiable.
Ese es el problema que aborda el formato de tabla abierto Iceberg. Añade una capa estructurada de metadatos y transacciones sobre datos almacenados en archivos abiertos, dejando a los equipos libertad para usar motores como Spark, Flink, Trino o Hive. La decisión importante en 2026, sin embargo, no es solo si Iceberg es un buen formato de tabla. Es qué catálogo controla los metadatos, las políticas y la ruta de acceso entre esos motores.
Índice de contenidos
Introducción a los formatos de tabla modernos y por qué importan
Dentro de la arquitectura del formato de tabla abierto Iceberg
Garantías transaccionales, evolución del esquema y estrategias de particionado
Integraciones del ecosistema, patrones de migración y flujos de ejemplo
Buenas prácticas, ajuste de rendimiento y diagnóstico en producción
Introducción a los formatos de tabla modernos y por qué importan
Un lago de datos tradicional suele empezar con un trabajo de ingesta que escribe archivos Parquet en almacenamiento de objetos, un metastore que registra la ubicación de la tabla y un motor de consulta que descubre archivos escaneando carpetas. Eso puede funcionar con datos solo de adición, pero la presión operativa llega enseguida.
Un productor puede escribir en el directorio de fecha equivocado. Un trabajo de reparación puede alterar archivos mientras se ejecuta una consulta de panel. Un analista puede leer una mezcla de archivos viejos y nuevos. Si cambia la disposición de particiones de la tabla, puede que todos los productores y consumidores tengan que entender el cambio manualmente. El lago se comporta entonces menos como una base de datos y más como una carpeta compartida con reglas no documentadas.
Los formatos de tabla abiertos mejoran ese arreglo colocando una abstracción de tabla sobre los archivos. Registran esquemas, instantáneas, metadatos de archivo y commits para que los motores entiendan qué archivos pertenecen a una versión coherente de la tabla. Los datos siguen en formatos de almacenamiento abiertos, pero los usuarios ganan comportamiento de base de datos.
Para los clientes de digna y equipos empresariales similares, la fiabilidad significa más que consultas correctas. Una tabla de reporting debe llegar a tiempo, conservar la estructura esperada, superar validaciones de negocio y exponer suficiente historial para investigar una incidencia. Iceberg ayuda a establecer los cimientos transaccionales y estructurales de la tabla. La observabilidad todavía tiene que operar alrededor de esos cimientos, comprobando si los datos llegaron, si algún valor cambió de forma inesperada y si los consumidores posteriores siguen siendo compatibles. Los equipos que exploran el concepto más amplio pueden usar esta visión general de los formatos de tabla abiertos como contexto adicional.
Regla práctica: trata un formato de tabla abierto como una capa de fiabilidad para archivos, no como una plataforma completa de gobierno.
Apache Iceberg se creó en Netflix en 2017 para abordar problemas de escalabilidad y consistencia en tablas al estilo Hive. Netflix lo donó a la Apache Software Foundation en noviembre de 2018, y el proyecto alcanzó el estatus de primer nivel en Apache en mayo de 2020. Su especificación continuó con la versión estable 1.0.0 en octubre de 2022 y la 1.6.1 en agosto de 2024, según la historia del proyecto Apache Iceberg.
Esta guía empieza por el modelo básico de tabla y luego recorre la arquitectura de metadatos de Iceberg, su comportamiento transaccional, comparaciones de formatos, patrones de migración y operación en producción. El foco final es el gobierno, porque la especificación de archivo es solo una parte de una plataforma de datos empresarial.
Qué es un formato de tabla abierto y cómo funciona
Piensa en un lago de datos en crudo como un almacén lleno de cajas etiquetadas. Los archivos Parquet son las cajas, las carpetas son zonas de almacenaje aproximadas, y un motor de consulta es un operario que busca las cajas que podrían contener una respuesta. Sin un inventario fiable, el operario puede buscar de más, pasar por alto archivos relevantes o combinar cajas de entregas incompatibles.
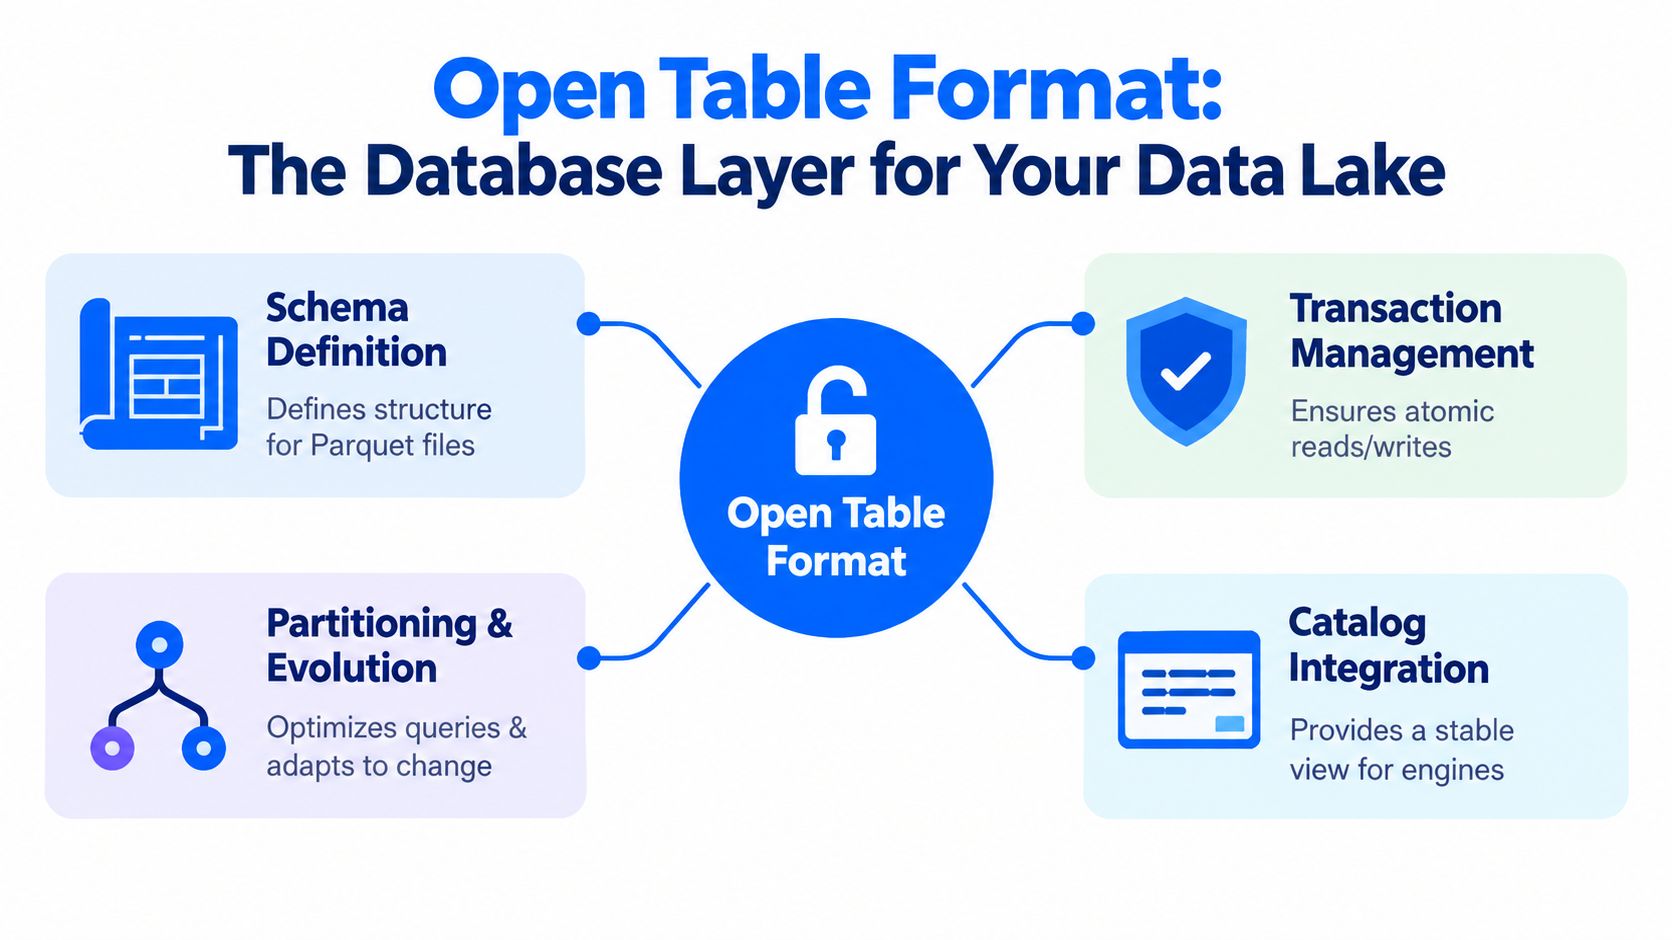
Un formato de tabla abierto añade ese inventario y un conjunto de reglas. Suele implicar tres capas conectadas:
Los archivos de datos contienen los registros reales, normalmente en formatos columnares como Parquet.
Los metadatos de tabla describen esquemas, instantáneas, archivos, estadísticas e información de partición.
Un catálogo da a los motores una vía estable para encontrar los metadatos vigentes y aplicar políticas de acceso.
Esa tercera capa es fácil de subestimar. El formato define cómo se representa el estado de la tabla, mientras que el catálogo define cómo lo localizan los motores. Un trabajo de Spark, una pipeline de Flink y una consulta de Trino solo pueden operar sobre la misma tabla si pueden resolverla a través de un catálogo compatible e interpretar la versión de formato correspondiente.
De archivos a una tabla gestionada
Supón que una pipeline recibe registros de ventas. Escribe archivos de datos Parquet en almacenamiento de objetos, pero no los coloca en una carpeta de fecha esperando que todo lector entienda la disposición. Iceberg registra los archivos en manifiestos, los asocia con una instantánea de tabla y publica un nuevo estado de metadatos mediante el catálogo.
Un lector descubre primero el estado actual de la tabla. Luego usa los metadatos para planificar el escaneo, seleccionando solo archivos que podrían contener registros coincidentes. Eso es distinto de pedir al motor que liste cada objeto e inspeccione cada archivo.
La palabra abierto se refiere a más que al código abierto. Un formato de tabla abierto busca ofrecer una especificación documentada que varios motores puedan implementar. La especificación de Iceberg ha avanzado por versiones formales. La documentación de Apache indica que las versiones 1, 2 y 3 están completas y adoptadas por la comunidad, mientras que la versión 4 sigue en desarrollo activo. La documentación también menciona la 1.11.0 como versión de documentación más reciente en 2026, lo que refleja la inversión continuada en la especificación y documentación de Iceberg.
La apertura reduce la dependencia de un solo motor de consulta, pero no elimina automáticamente el comportamiento específico de cada proveedor. Lectores y escritores siguen necesitando soporte compatible de funciones, y el catálogo puede aplicar sus propias políticas, credenciales o reglas de gobierno. Esa distinción se vuelve central en cuanto varios motores comparten tablas de producción.
Dentro de la arquitectura del formato de tabla abierto Iceberg
La arquitectura de Iceberg se entiende mejor del catálogo hacia abajo. El catálogo apunta al archivo de metadatos vigente. Esos metadatos identifican la instantánea activa y conectan la tabla con una o más listas de manifiestos. Las listas de manifiestos apuntan a archivos de manifiesto, y los manifiestos describen los archivos de datos disponibles para la instantánea.

Siguiendo una lectura de tabla
Una lectura simplificada se ve así:
El motor pide al catálogo la ubicación de metadatos vigente de la tabla.
El archivo de metadatos identifica la instantánea actual.
La instantánea referencia una lista de manifiestos.
La lista de manifiestos identifica archivos de manifiesto.
El motor evalúa las entradas de manifiesto y lee los archivos de datos elegibles.
Los datos en sí permanecen en archivos como Parquet. Para quien quiera una explicación aparte del formato de almacenamiento subyacente, esta guía de Parquet aporta contexto útil. La contribución de Iceberg es la organización a nivel de tabla alrededor de esos archivos.
Los manifiestos guardan valores de partición de los archivos de datos. Cuando una consulta incluye un predicado, el motor puede compararlo con las tuplas de partición y descartar archivos que no puedan coincidir. Eso es poda guiada por metadatos. El motor gasta menos esfuerzo abriendo archivos irrelevantes, y la planificación no depende de interpretar manualmente nombres de directorio.
Iceberg también admite particionado oculto. Un productor puede escribir una marca de tiempo mientras la tabla aplica internamente una transformación de partición, como extraer una fecha o truncar un valor. Productores y consumidores no tienen que gestionar directamente una columna de partición separada, lo que reduce errores por expresiones de partición inconsistentes.
Por qué importan las instantáneas
Cada escritura crea una instantánea nueva. Un lector resuelve una instantánea y planifica contra ese estado coherente, en lugar de observar la tabla mientras se añaden o quitan archivos. Este diseño soporta aislamiento por instantáneas y cambios de tabla serializables y atómicos, de modo que los lectores no ven escrituras parciales ni sin confirmar.
El modelo de instantáneas también habilita el viaje en el tiempo. Un analista que investiga una discrepancia en un panel puede consultar un estado anterior de la tabla, siempre que las instantáneas y archivos relevantes sigan disponibles. Eso hace la investigación histórica más precisa que depender de extractos copiados o carpetas preservadas a mano.
La documentación de rendimiento de Apache Iceberg señala que la arquitectura de metadatos puede permitir que incluso tablas de varios petabytes se lean desde un único nodo sin requerir un motor SQL distribuido solo para cribar los metadatos. La misma documentación cita casos con una mejora de rendimiento de 10x, como describe la documentación de rendimiento de Iceberg. La lección práctica es que el diseño de metadatos puede influir en el coste de planificación tanto como la disposición de archivos influye en el coste de escaneo.
Garantías transaccionales, evolución del esquema y estrategias de particionado
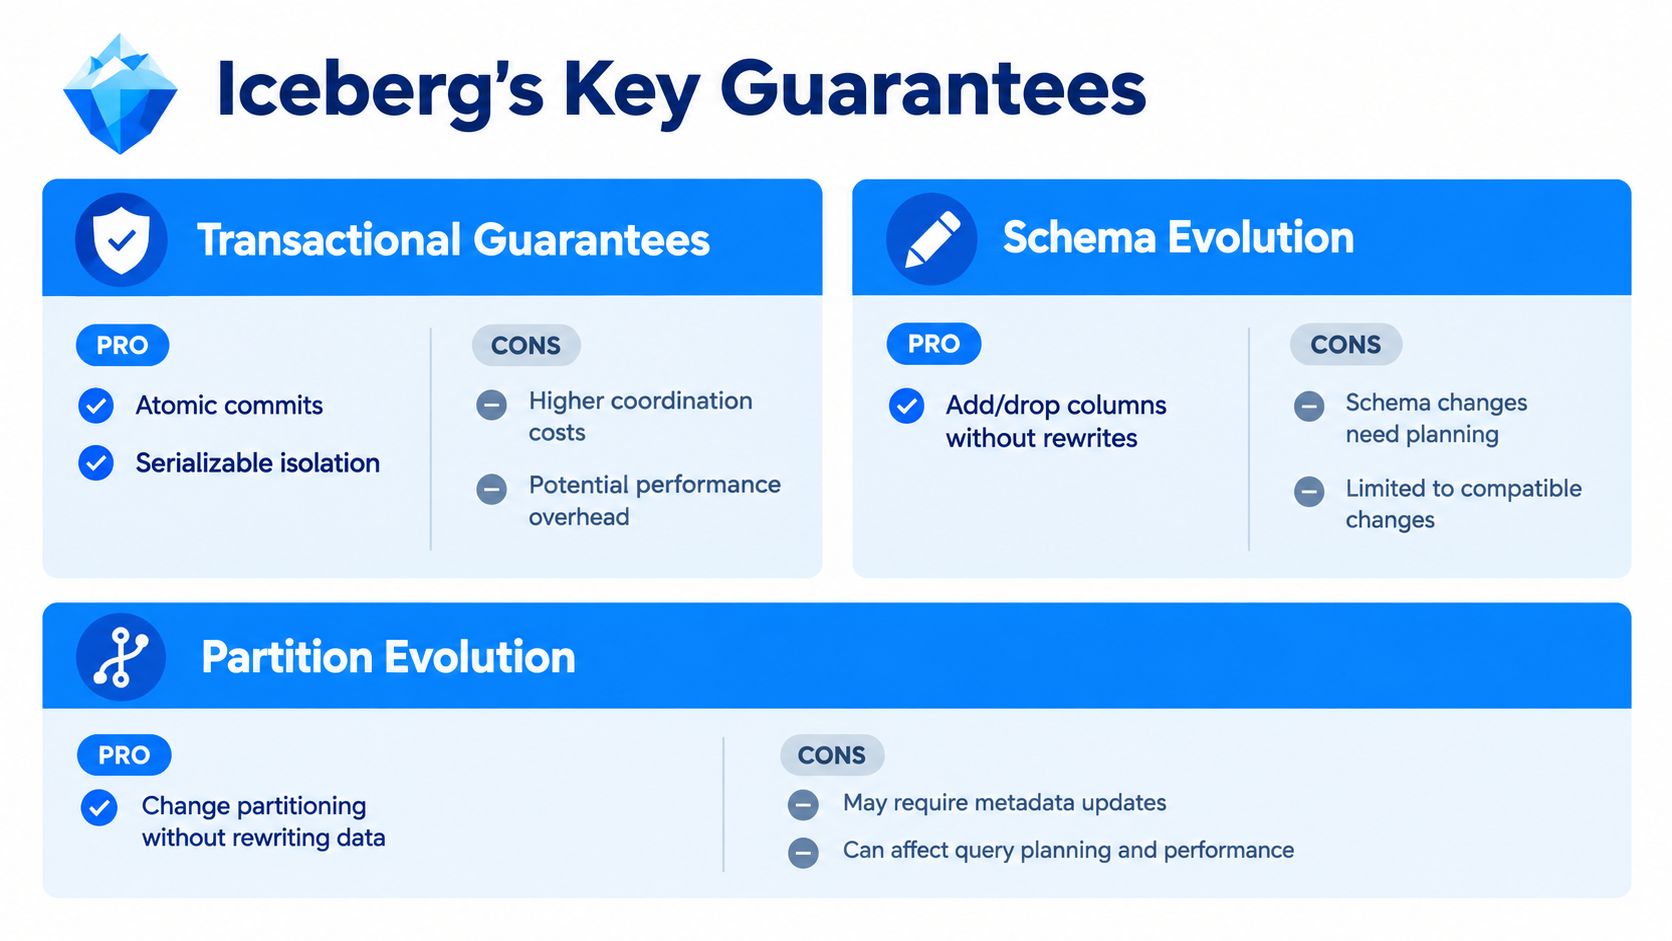
El valor de Iceberg se aprecia mejor cuando una tabla cambia mientras personas y pipelines siguen usándola. Un escritor no publica un estado de tabla a medio terminar. Prepara una instantánea nueva y confirma ese estado de forma atómica. Los lectores siguen viendo la instantánea confirmada anterior hasta que la nueva se hace visible.
Eso da a los equipos aislamiento por instantáneas y cambios de tabla serializables. Los escritores concurrentes siguen necesitando una estrategia de conflictos, y un commit fallido puede requerir lógica de reintento, pero los lectores no combinarán por accidente una escritura incompleta con un estado anterior.
Cambios que evitan reescribir datos
Iceberg admite operaciones de evolución de esquema como añadir, eliminar, renombrar y reordenar columnas sin reescribir los archivos de datos existentes. Los metadatos siguen el esquema lógico, así que renombrar una columna no tiene por qué implicar reescribir físicamente cada archivo histórico.
Esa capacidad no elimina la necesidad de disciplina. Un campo renombrado puede confundir a herramientas posteriores que identifican columnas por nombre, y un campo eliminado puede afectar a informes o modelos. Las comprobaciones de compatibilidad de esquema y los avisos a consumidores siguen siendo importantes, sobre todo cuando distintos motores soportan funciones del formato en niveles distintos. Un sistema de seguimiento como digna Schema Tracker puede situarse junto a la tabla e identificar cambios estructurales antes de que se conviertan en incidencias posteriores.
La evolución de particiones sigue un principio similar. Iceberg trata un cambio de especificación de partición como una operación de metadatos. Los archivos antiguos permanecen en su disposición existente, mientras que los nuevos usan la especificación actualizada. Los equipos pueden adaptar el particionado a nuevos patrones de acceso sin reescribir toda la tabla histórica ni ponerla fuera de servicio.
Elegir el particionado oculto con criterio
El particionado oculto es útil cuando los equipos quieren organización física sin exponer la mecánica de partición a cada productor. Un campo de marca de tiempo puede sostener la poda por fecha sin exigir que cada trabajo de ingesta rellene correctamente una columna de partición equivalente.
Hay una contrapartida. Tras una evolución de particiones, una tabla puede contener archivos escritos bajo especificaciones distintas. Iceberg puede planificar a través de ese historial, pero los operadores aún deben vigilar si las disposiciones antigua y nueva producen un escaneo desigual. Los cambios de partición deberían seguir los patrones de consulta observados, no sustituir la comprensión del acceso al workload.
Borrados a nivel de fila
El formato Iceberg v2 admite borrados a nivel de fila mediante archivos de borrado separados en lugar de reescribir archivos de datos completos. Los borrados posicionales identifican una fila por su ruta de archivo y posición. Los borrados por igualdad identifican filas por coincidencia de valores de columna, lo que puede sostener flujos de actualización y borrado con menor amplificación de escritura, como describe esta explicación de los borrados a nivel de fila en Iceberg.
Los archivos de borrado introducen consideraciones de mantenimiento. Las consultas pueden tener que fusionar datos base e información de borrado, y las operaciones de compactación o reescritura pueden consolidar después la disposición. El formato reduce la carga inmediata de reescritura, pero no elimina la gestión del ciclo de vida.
Comparar Iceberg, Delta Lake y Hudi para tu lakehouse
Iceberg, Delta Lake y Hudi abordan la brecha entre archivos de datos no gestionados y comportamiento de tabla propio de una base de datos. La elección correcta depende del workload, los motores, la estrategia de catálogo y los servicios operativos que tu equipo esté dispuesto a ejecutar.
Criterios | Apache Iceberg | Delta Lake | Apache Hudi |
|---|---|---|---|
Encaje principal | Tablas analíticas multi-motor e interoperabilidad abierta | Fuerte alineación con el ecosistema Databricks | Cargas de lakehouse intensivas en actualizaciones y streaming |
Modelo de metadatos | Arquitectura de instantánea, lista de manifiestos y manifiesto | Diseño centrado en un registro de transacciones | Diseño orientado a línea temporal y servicios de tabla |
Evolución del esquema | Admite cambios como añadir, eliminar, renombrar y reordenar | Admite evolución del esquema, con comportamiento dependiente del runtime y del soporte de funciones | Admite amplias capacidades de evolución del esquema |
Estrategia de particionado | Particionado oculto y evolución de particiones solo por metadatos | La gestión de particiones depende de la configuración de tabla y plataforma | Usa particionado más clustering y servicios de tabla |
Cambios de fila | Archivos de borrado v2, con borrados posicionales y por igualdad | Actualizaciones y borrados mediante operaciones Delta | Fuerte soporte de upserts, borrados y flujos incrementales |
Elección de motor | Diseñado para amplia interoperabilidad entre motores | Especialmente natural dentro de despliegues Databricks | Fuerte integración con Spark y streaming, con soporte más amplio del ecosistema |
Cuestión del catálogo | El catálogo es central para el descubrimiento y el gobierno | El catálogo y los servicios de plataforma afectan mucho a la apertura | El catálogo puede ser menos central para la operación básica, pero el gobierno sigue necesitando servicios alrededor |
Estas descripciones son orientación arquitectónica, no un benchmark universal. La velocidad de consulta depende del tamaño de archivos, la distribución de datos, el orden, la compactación, las versiones de motor, la forma del workload y la implementación del catálogo. Un equipo de plataforma debería probar lecturas y escrituras representativas en lugar de elegir solo por casillas de funciones.
Ajusta el formato al modelo operativo
Elige Iceberg cuando varios motores deban compartir tablas y el equipo valore una capa de tabla ampliamente especificada, con particionado oculto y evolución independiente. Elige Delta Lake cuando la integración profunda con Databricks, los servicios nativos de plataforma y un modelo operativo unificado de proveedor pesen más que la necesidad de neutralidad de catálogo.
Hudi merece consideración cuando las actualizaciones frecuentes, la captura de cambios, el procesamiento incremental o la ingesta en streaming dirigen el diseño. Su enfoque incluye capacidades de motor de almacenamiento y gestión de tablas que pueden moldear cómo la plataforma maneja indexación, compactación e ingesta.
La pregunta más importante suele estar fuera de la especificación de archivo. Un equipo de gobierno necesita un único lugar para gestionar espacios de nombres, propiedad, clasificación, permisos e historial de auditoría. Iceberg aporta transacciones de tabla y metadatos, pero no proporciona por sí solo un sistema completo de políticas entre motores. Los equipos que evalúan Iceberg junto a cargas de Databricks pueden repasar también las consideraciones de calidad de datos en Databricks, sobre todo donde se cruzan los controles de plataforma y los procesos de fiabilidad.
Integraciones del ecosistema, patrones de migración y flujos de ejemplo
Iceberg encaja en un lakehouse por dos interfaces: almacenamiento y catálogo. Spark o Flink pueden producir los datos, Trino o Hive pueden consultarlos, y el almacenamiento de objetos puede guardar los archivos. El catálogo vincula esas actividades a una identidad de tabla y expone los metadatos que necesita cada motor compatible.
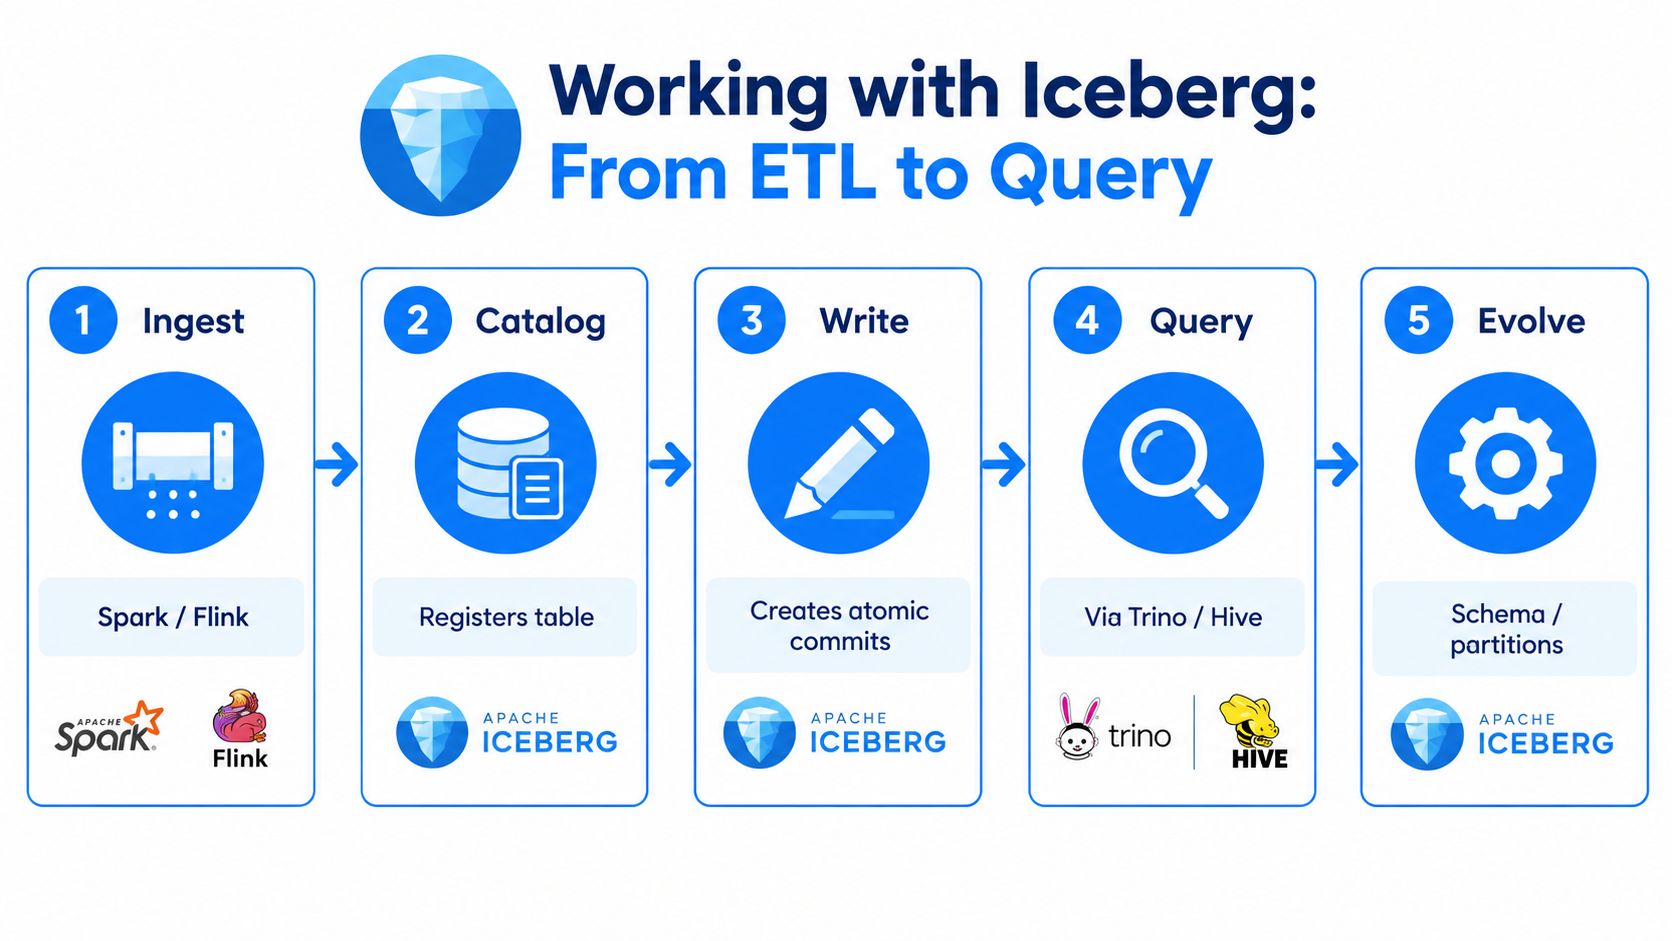
Un flujo representativo se ve así:
Ingesta: Spark o Flink recibe registros por lotes o en streaming.
Catálogo: la tabla se registra mediante un catálogo como Hive Metastore, AWS Glue Catalog o un catálogo REST de Iceberg.
Escritura: el motor crea archivos de datos y publica una instantánea atómica.
Consulta: Trino, Hive, Spark u otro motor compatible resuelve la tabla mediante el catálogo.
Evolución: la persona responsable cambia el esquema o la especificación de partición según evoluciona el workload.
La sintaxis exacta varía según el motor, pero los conceptos se mantienen. Un flujo SQL podría crear una tabla con esquema explícito, insertar registros, alterar una columna y consultar una instantánea anterior. Un trabajo de Spark podría usar la interfaz DataFrameWriterV2 de Iceberg, mientras Flink emplea su sink de Iceberg y la configuración de catálogo.
Migrar sin perder el control
Una migración de Hive a Iceberg puede seguir varias vías. Los equipos pueden convertir datos existentes y registrarlos mediante metadatos de Iceberg, o reescribir archivos para mejorar la disposición, normalizar esquemas y eliminar supuestos de partición heredados. La conversión de metadatos puede reducir la disrupción, mientras que una reescritura crea la oportunidad de optimizar los archivos. La elección depende del estado de la tabla existente y de la tolerancia al trabajo de migración.
Una migración de Delta a Iceberg exige el mismo cuidado, con atención adicional al historial de transacciones, funciones no soportadas, borrados, columnas generadas y dependencias posteriores. Un plan de migración debería inventariar lectores y escritores antes de cambiar la propiedad de la tabla. La guía de planificación de migraciones de datos puede ayudar a organizar dependencias, validación y decisiones de despliegue.
Observabilidad alrededor de la tabla
Las instantáneas de Iceberg te dicen qué estado de tabla se confirmó. No te dicen si una fuente entregó los registros esperados, si los valores de negocio son plausibles o si una métrica clave de un panel se salió de su comportamiento normal. Esas comprobaciones pertenecen al sistema de fiabilidad que lo rodea.
Por ejemplo, un equipo puede validar reglas de registro tras un commit de instantánea, seguir la hora de llegada de cada carga esperada, comparar métricas actuales con el comportamiento histórico y señalar cambios de esquema antes de que fallen los modelos de BI. Las comprobaciones pueden ejecutarse contra la tabla en su sitio, sin copiar los datos a un almacén de monitorización aparte.
Buenas prácticas, ajuste de rendimiento y diagnóstico en producción
La operación de Iceberg en producción gira en torno a mantener sanos a la vez metadatos, archivos, instantáneas y políticas. Una tabla puede seguir siendo transaccionalmente correcta y volverse cara de consultar porque contiene demasiados archivos pequeños, instantáneas obsoletas o disposiciones solapadas de varias especificaciones de partición.
Empieza por la gestión de archivos. Vigila la creación de archivos pequeños, compacta los compatibles y elige ajustes de escritura que produzcan tamaños prácticos para los motores que sirven la tabla. La compactación debería seguir la evidencia del workload. Una tabla usada para lecturas incrementales frecuentes puede necesitar un ritmo de mantenimiento distinto al de una tabla que sirve escaneos analíticos ocasionales.
Los metadatos merecen su propia monitorización. Sigue el crecimiento de manifiestos, la latencia de planificación, la acumulación de instantáneas y los patrones de commits fallidos. Expira instantáneas según los requisitos de recuperación y auditoría, y limpia archivos huérfanos solo tras confirmar que ninguna instantánea activa ni proceso externo sigue dependiendo de ellos.
Regla operativa: el mantenimiento no es limpieza. Es parte del diseño de consulta y recuperación de la tabla.
El diagnóstico se vuelve más sistemático cuando los síntomas se asignan a capas:
Planificación lenta: revisa el número de manifiestos, el crecimiento de metadatos y el tiempo de respuesta del catálogo antes de culpar al motor de consulta.
Escaneos lentos: comprueba la eficacia de la poda, los tamaños de archivo, la distribución de datos y si las especificaciones de partición evolucionadas crean disposiciones desiguales.
Registros que faltan: compara la ventana de ingesta esperada con la instantánea confirmada y valida la entrega de la fuente por separado.
Fallos de esquema: identifica el escritor que cambió el esquema y luego comprueba la compatibilidad de lectores y los supuestos posteriores.
Conflictos de commit: revisa los escritores concurrentes, el comportamiento de reintento y los trabajos de mantenimiento que puedan competir por la misma tabla.
Crecimiento inesperado de almacenamiento: examina instantáneas retenidas, archivos de borrado, escrituras fallidas y archivos de datos huérfanos.
Las actualizaciones de formato requieren un plan de despliegue. Los cambios de versión en Iceberg son opcionales tabla por tabla, así que las tablas antiguas pueden convivir con las nuevas. La encuesta del ecosistema Apache Iceberg de 2025 informó de que el 78,6 % de los encuestados usa Iceberg en exclusiva entre los formatos de tabla abiertos, mientras que un estudio empresarial independiente reportó un 58 % usando Iceberg para analítica crítica de negocio, un 95 % usándolo o planeando usarlo para IA/ML y un 79 % moviendo o planeando mover el resto de datos a Iceberg en 12 meses. Estas cifras proceden del resumen de la encuesta State of the Apache Iceberg Ecosystem 2025, y señalan impulso, no la prueba de que cada organización haya resuelto la operación con versiones mezcladas.
La siguiente preocupación de planificación es Iceberg v3, con capacidades como linaje de filas, vectores de borrado y nuevos tipos lógicos. Prueba lectores y escritores juntos, define puertas de compatibilidad y actualiza tablas representativas antes de un despliegue amplio. El formato puede ser abierto, pero un parque puede acumular deuda de fiabilidad oculta si catálogos, motores y políticas de gobierno evolucionan a ritmos distintos.
El catálogo debería elegirse con el mismo cuidado. Iceberg aporta comportamiento ACID, evolución del esquema y viaje en el tiempo, mientras que el linaje, la clasificación, el control de acceso y los registros de auditoría unificados dependen del catálogo y de la pila de gobierno. Databricks anunció Managed Iceberg, Iceberg v3 y Foreign Iceberg como disponibles de forma general en Unity Catalog el 28 de mayo de 2026, mientras que Snowflake integró Polaris en Horizon Catalog para la interoperabilidad REST de Iceberg, como describen los materiales de la especificación de Apache Iceberg. Esos movimientos del ecosistema refuerzan la decisión central: la apertura entre motores no depende solo de los archivos de tabla, sino también de quién controla el acceso a metadatos y la aplicación de políticas.
digna se ejecuta dentro de tu propio entorno y combina seguimiento de esquema, monitorización de Timeliness, validación en la base de datos, detección de anomalías y observabilidad de plataforma alrededor de tablas y pipelines críticos. Visita digna para ver cómo tu equipo puede monitorizar analítica basada en Iceberg sin mover los datos de producción.
La mayoría de incidencias de Iceberg en producción resultan ser problemas de valores disfrazados de metadatos, así que planifica la gestión de la calidad de los datos junto con la migración.
Preguntas frecuentes
¿Qué problema resuelve Iceberg?
Evita que distintos motores discrepen sobre lo que contiene una tabla. Sin un formato de tabla, un motor puede leer un directorio antes de que un lote esté plenamente confirmado, otro puede interpretar una partición de forma distinta y un tercero puede seguir viendo un esquema antiguo, mientras cada archivo implicado es perfectamente válido.
¿Cómo se estructura una tabla Iceberg?
Iceberg mantiene una cadena de metadatos: una entrada de catálogo apunta a un archivo de metadatos que describe la instantánea actual, esa instantánea apunta a una lista de manifiestos, y los manifiestos enumeran archivos de datos con sus estadísticas. Cada commit escribe metadatos nuevos en lugar de mutar los antiguos, y eso es lo que abarata la reversión.
¿Iceberg admite escritores concurrentes?
Sí, mediante concurrencia optimista. Cada escritor prepara sus cambios y luego intenta intercambiar el puntero de metadatos de la tabla; si otro commit llegó antes, reintenta contra el nuevo estado. Las escrituras en conflicto sobre los mismos archivos fallan de forma ruidosa en vez de sobrescribirse en silencio.
¿Qué motores funcionan con Iceberg?
Spark, Trino, Flink, Dremio, Snowflake y BigQuery, entre otros, leen Iceberg, aunque la cobertura de funciones difiere: algunos motores leen pero no escriben, y las capacidades nuevas llegan de forma desigual. Confirma que las operaciones concretas que necesitas están soportadas por todos los motores de tu pila, no solo por el que usas para probar.
¿Qué suele salir mal con Iceberg en producción?
Archivos pequeños e instantáneas no expiradas, en ese orden. Las escrituras en streaming o por lotes frecuentes producen muchos archivos pequeños y una cadena larga de metadatos, lo que ralentiza la planificación hasta que la compactación y la expiración se ejecutan con regularidad. Ninguna degrada la corrección, así que el síntoma aparece como una latencia de consulta que crece poco a poco.



