El formato de archivo Parquet explicado: guía práctica 2026
|
10
minuto de lectura

Probablemente ya estés lidiando con Parquet, aunque no lo hayas elegido tú. Una exportación del almacén aterriza en S3, tu trabajo de Spark lee una tabla del lago respaldada por archivos Parquet, o Athena sigue escaneando conjuntos que alguien aguas arriba particionó de tres formas distintas durante el último año. La mayoría de los días parece lo bastante rápido e invisible como para que nadie haga preguntas.
Entonces algo se rompe. Una consulta que antes volaba empieza a arrastrarse. Un nuevo escritor despliega una función que un motor puede leer y otro no. Un solo campo renombrado se convierte en una semana de nulos aguas abajo. Ahí es cuando el formato de archivo Parquet deja de ser una extensión y pasa a ser un asunto operativo.
Índice de contenidos
Por qué Parquet se convirtió en el formato columnar por defecto
Dentro de un archivo Parquet: row groups, column chunks y pages
Opciones de codificación y compresión que de verdad importan
Cómo Parquet consigue velocidad: predicate pushdown y poda de columnas
Particionado, tamaño de archivo y buenas prácticas de almacenamiento
Evolución del esquema, interoperabilidad y las trampas silenciosas
Deriva de esquema, Timeliness y observabilidad en pipelines Parquet
Por qué Parquet se convirtió en el formato columnar por defecto
Un patrón analítico habitual es este: un equipo guarda una tabla de ventas ancha con muchos atributos, pero la mayoría de consultas de panel tocan solo un puñado de columnas. En una exportación orientada a filas como CSV, el motor todavía tiene que masticar cada fila como texto. En Parquet, el motor puede centrarse en las columnas que la consulta necesita. Esa diferencia explica por qué se sigue eligiendo para almacenamiento analítico.
Parquet no apareció por casualidad. Empezó como una colaboración de código abierto entre Twitter y Cloudera, con su primera publicación el 13 de marzo de 2013, Parquet 1.0 en julio de 2013, y para el 27 de abril de 2015 ya era proyecto de primer nivel de la Apache Software Foundation, según la documentación del formato de archivo Apache Parquet. La descripción de la propia Apache sigue siendo la más limpia: Parquet es un formato de archivo de datos de código abierto y orientado a columnas para un almacenamiento y recuperación eficientes.
Por qué el almacenamiento columnar cambió la elección por defecto
En términos simples, Parquet guarda los valores por columna en lugar de por fila. Todos los valores de order_total están juntos. Todos los de country están juntos. Eso da dos ventajas a los motores de consulta:
Lectura selectiva: pueden saltarse columnas que tu SQL nunca referencia.
Mejor empaquetado: los valores similares comprimen bien porque el formato puede aplicar codificaciones antes de comprimir.
Esa combinación encaja bien con los motores analíticos modernos y los formatos de tabla de lakehouse. Si quieres una introducción más breve antes de profundizar, digna tiene una útil visión general de Parquet.
Regla práctica: si tu carga consiste sobre todo en escaneos, agregaciones y filtros sobre grandes conjuntos de datos, Parquet suele encajar mejor con el patrón de acceso que los formatos de texto.
Por qué se extendió tanto
Parquet se convirtió en el tejido conectivo entre pipelines de Spark, exportaciones de almacén, lagos de datos en almacenamiento de objetos y formatos de tabla como Iceberg, Delta Lake y Hudi. Los equipos lo valoran porque es abierto, tipado y ampliamente soportado. También les gusta que separe el almacenamiento físico de la elección del motor de consulta. Un archivo escrito en una parte de la pila a menudo puede leerse en otra.
Ese «a menudo» importa. La portabilidad es real, pero no es automática en cuanto entran en producción funciones nuevas y versiones mixtas de motores.
Motor | Soporte nativo de Parquet | Patrón habitual |
|---|---|---|
Spark | Sí | Transformación por lotes y tablas de lakehouse |
BigQuery | Sí | Tablas externas e intercambio de archivos |
Redshift Spectrum | Sí | Consulta de datos en almacenamiento de objetos |
DuckDB | Sí | Analítica local y consultas ad hoc |
Athena | Sí | Escaneos sin servidor sobre datos de lago particionados |
Dentro de un archivo Parquet: row groups, column chunks y pages
Un archivo Parquet cobra sentido si te imaginas una consulta típica de almacén. Una analista pide tres columnas de cincuenta, filtradas a la semana pasada. Que esa consulta se sienta rápida o lenta depende en gran medida de cómo Parquet dispone los bytes dentro del archivo, no solo del motor SQL que lo lee.
Empieza por el row group
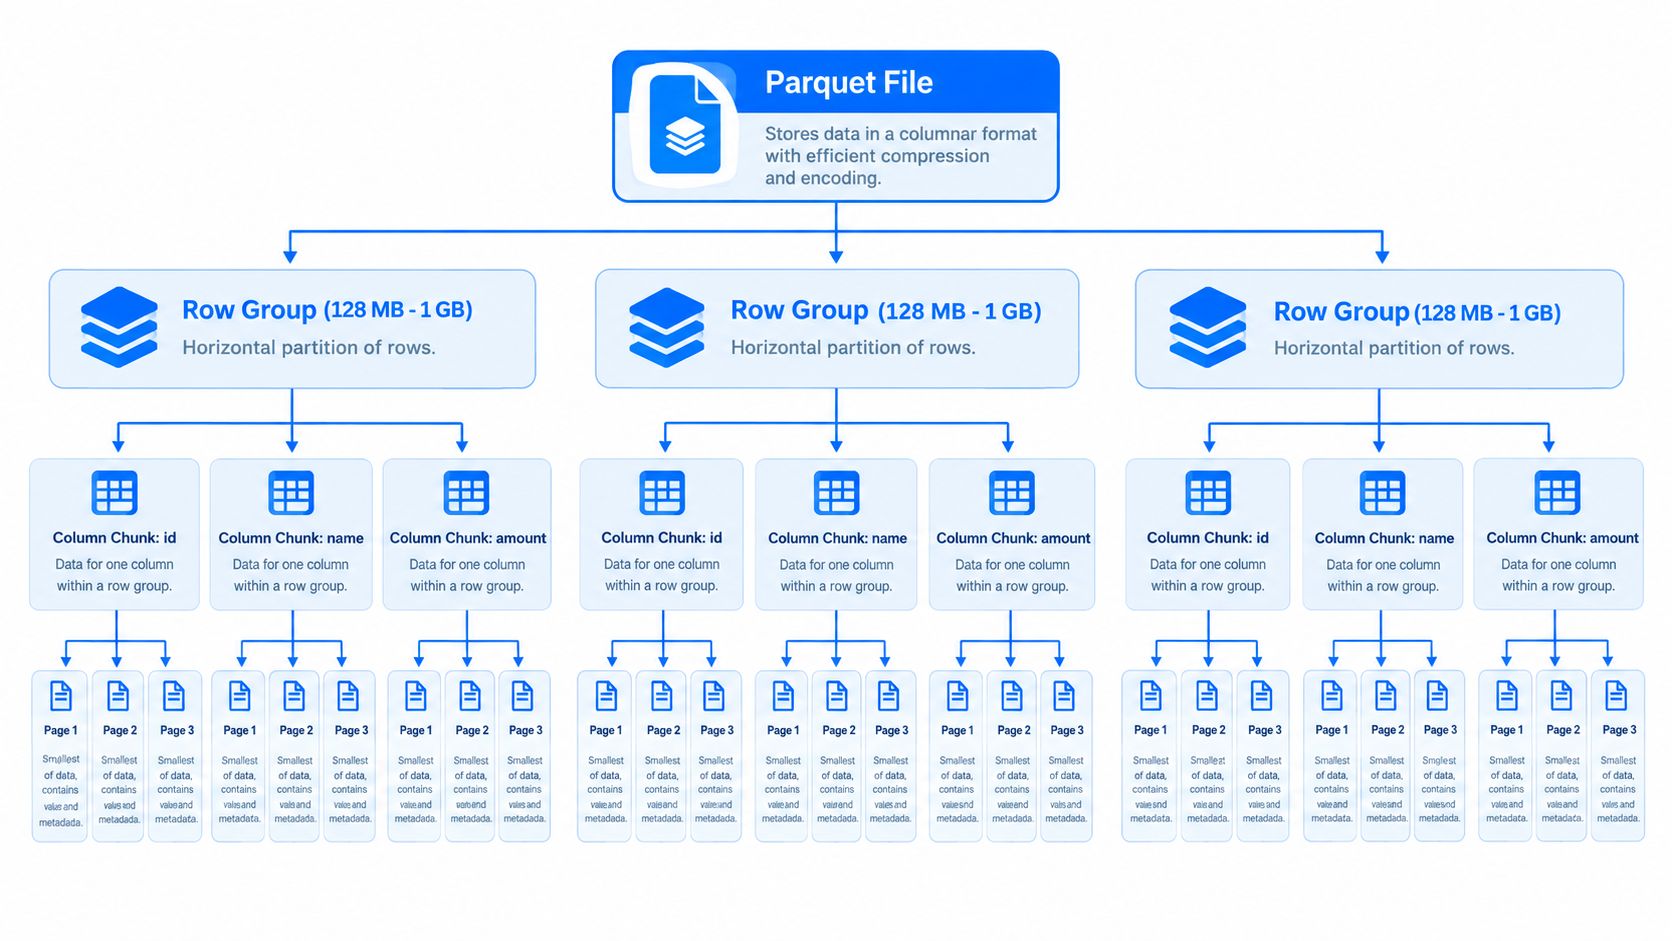
Un archivo Parquet se divide en row groups. Cada row group es una porción horizontal de la tabla, así que contiene el mismo conjunto de columnas para un subconjunto de filas.
El tamaño del row group moldea el comportamiento de lectura más de lo que muchos equipos esperan. Las guías anteriores de Apache Parquet recomiendan row groups grandes, porque los grupos mayores suelen crear column chunks mayores y favorecen la E/S secuencial. En producción, eso puede ayudar a cargas intensivas en escaneo. También crea una concesión. Los row groups muy grandes reducen la sobrecarga de metadatos, pero pueden volver menos ágiles las lecturas selectivas, porque el motor sigue planificando a nivel de row group.
Dentro de cada row group, Parquet guarda exactamente un column chunk por columna del esquema, y cada chunk es contiguo en el archivo, según se define en el repositorio parquet-format. Esa disposición explica en gran parte por qué funciona la poda de columnas. Si una consulta necesita order_total y order_date, el motor puede ignorar los bytes de customer_notes, device_model y todo lo demás.
Luego acércate al column chunk y a la page
Un column chunk contiene los valores de una columna para un row group. Ese chunk se divide luego en pages, las unidades menores que Parquet codifica y comprime.
Las pages importan porque es ahí donde las decisiones de almacenamiento se vuelven concretas. Los metadatos de página registran qué codificación y compresión se usaron. Si existe una página de diccionario, debe aparecer primero en el column chunk, y puede haber como máximo una página de diccionario por column chunk, según la documentación de Apache Parquet sobre column chunks.
Un modelo mental práctico es:
El archivo contiene un objeto Parquet físico.
Los row groups dividen las filas en bloques grandes.
Los column chunks guardan una columna para un row group.
Las pages guardan porciones codificadas y comprimidas de ese chunk.
Aquí ayuda la analogía de una hoja de cálculo. Los row groups son como bandas de filas a lo ancho de la hoja. Los column chunks son las tiras verticales de cada campo dentro de una banda. Las pages son los paquetes menores dentro de cada tira que el lector puede decodificar pieza a pieza.
Por qué el pie determina la planificación de lectura
El pie es donde Parquet guarda el mapa. Almacena el esquema más los metadatos que indican al lector dónde viven los row groups y los column chunks. Antes de que un motor de consulta pueda decidir con criterio qué leer, normalmente necesita ese pie.
Ese diseño es excelente para la planificación analítica. Es más flojo para el acceso puntual.
Si tu carga es «escanea un mes de eventos y agrega», la planificación que empieza por el pie ayuda al motor a ahorrarse trabajo. Si es «trae un registro por ID», el lector todavía tiene que encontrar y parsear el pie antes de localizar la región correcta del archivo. La documentación de Parquet en Apache Arrow también señala que los datos Parquet se decodifican por bloques en lugar de manipularse directamente a nivel de byte, una razón por la que recuperar una sola fila encaja mal con el formato.
Esta es una de las lagunas de producción que las explicaciones básicas de Parquet se saltan. Los equipos suelen oír «columnar significa rápido» y luego aplican Parquet a todo patrón de acceso. Eso se sostiene para la analítica por lotes. Suele romperse en búsquedas guiadas por peticiones, sondas de validación de CDC o flujos de depuración operativa en los que alguien quiere una fila ahora mismo.
El pie también influye después en los problemas de interoperabilidad. Motores distintos pueden coincidir en que el archivo existe y aun así discrepar sobre metadatos recientes, page indexes o estadísticas opcionales. Cuando eso ocurre, el síntoma rara vez es una corrupción dramática. Suele ser más callado. Los filtros dejan de podar tan bien como se esperaba, un motor lee más bytes que otro, o la latencia de consulta se desvía al alza meses después de actualizar un escritor.
Para la analítica, planificar desde el pie es una fortaleza. Para las búsquedas puntuales, es sobrecarga.
Por eso Parquet funciona mejor cuando lo tratas como un formato analítico, observas cómo usan sus metadatos tus motores e investigas cuando los «bytes escaneados» o la tasa de poda de row groups empeoran de golpe.
Opciones de codificación y compresión que de verdad importan
Los equipos suelen mezclar codificación y compresión, pero resuelven problemas distintos. La codificación reestructura los valores dentro de una página. La compresión encoge después el flujo de bytes codificado. En Parquet, esas capas se apilan.
Las codificaciones cambian primero la forma del dato
Parquet admite codificaciones a nivel de página, entre ellas PLAIN, RLE, DELTA_BINARY_PACKED, RLE_DICTIONARY y BYTE_STREAM_SPLIT, y admite códecs de compresión como SNAPPY, GZIP, BROTLI, ZSTD y LZ4_RAW, según resume la referencia del formato Parquet.
Lo que importa en producción es la forma del dato:
Las rutas tipo diccionario ayudan cuando los valores se repiten, como en campos de estado, códigos de país o categorías de producto.
RLE funciona bien cuando los valores repetidos aparecen en rachas, sobre todo tras ordenar.
Las codificaciones tipo delta sirven cuando los valores cambian de forma incremental, como identificadores crecientes o marcas de tiempo.
Byte stream split puede ayudar a algunas cargas numéricas, pero la compatibilidad entre herramientas puede ir por detrás.
Una evaluación empírica de formatos columnares halló que la codificación agresiva por diccionario de Parquet solía ofrecer buena compresión con un rendimiento de decodificación razonable en muchos tipos de datos, y que su ruta de bit-packing más RLE normalmente decodificaba más rápido que enfoques multialgoritmo más complejos, según el artículo de evaluación sobre formatos columnares.
La compresión debe encajar con tu objetivo operativo
Una forma útil de elegir códec es decidir qué estás optimizando:
Lecturas rápidas y amplia compatibilidad: usa Snappy.
Almacenamiento más ajustado con un equilibrio razonable: usa ZSTD donde tu pila de motores lo soporte con comodidad.
Máxima compresión con lecturas y escrituras más lentas: usa GZIP para conjuntos fríos o poco interactivos.
En corto: elige la codificación según el patrón de valores de la columna y luego la compresión según el equilibrio entre almacenamiento y CPU.
Forma del dato | Codificación | Compresión | Por qué funciona |
|---|---|---|---|
Cadenas repetidas en registros | Dictionary o RLE_DICTIONARY | SNAPPY | Los valores repetidos compactan bien y Snappy mantiene baja la sobrecarga de decodificación |
Indicadores de estado o códigos de región ordenados | RLE | ZSTD | Las rachas largas comprimen con eficiencia y ZSTD suele equilibrar ratio y coste de lectura |
Identificadores crecientes o marcas de tiempo ordenadas | DELTA_BINARY_PACKED | GZIP o ZSTD | Los cambios de paso pequeño se codifican de forma compacta antes de que actúe el códec |
Columnas de dimensión mixtas de baja cardinalidad | Dictionary | SNAPPY o ZSTD | Los valores similares se benefician de la búsqueda en diccionario y siguen siendo portables |
Características analíticas con muchos valores en coma flotante | BYTE_STREAM_SPLIT donde esté soportado | ZSTD | Puede mejorar la disposición numérica, pero verifica antes el soporte del lector |
La precaución es la portabilidad. La especificación puede permitir una codificación que tu lector posterior no implemente del todo.
Cómo Parquet consigue velocidad: predicate pushdown y poda de columnas
La velocidad de Parquet viene de no leer datos que no necesitas. Suena obvio, pero se descompone en tres mecanismos distintos con modos de fallo diferentes.
La poda de columnas hace el primer corte
Si tu tabla de hechos tiene muchas columnas y tu SQL toca solo unas pocas, el motor puede leer únicamente esos column chunks. Es la victoria más visible en sistemas analíticos. También explica por qué los equipos que se adentran en la optimización de consultas SQL descubren a menudo que el formato de archivo y la disposición de la tabla importan tanto como el texto de la consulta.
En términos prácticos, una consulta como:
no necesita campos de atribución de marketing, notas de envío ni decenas de dimensiones sin usar. Con Parquet, el planificador puede evitar esos bytes por completo.
Saltarse row groups es donde las decisiones de disposición empiezan a rendir
Los archivos Parquet guardan metadatos que ayudan a los lectores a decidir si merece la pena escanear un row group. Cuando el filtro dice region = 'EMEA' y las estadísticas de un row group muestran solo valores fuera de ese rango, el motor puede saltárselo.
El orden importa. Si escribes las filas en orden aleatorio, las estadísticas de mínimo y máximo pierden selectividad. Si agrupas valores relacionados, esas estadísticas resultan mucho más útiles.
El comportamiento a nivel de página ayuda, pero solo si los datos cooperan
Las pages son las unidades prácticas más pequeñas dentro de un column chunk. Los lectores pueden evitar decodificar partes de un chunk si los metadatos y la lógica de filtrado lo permiten. Las páginas codificadas por diccionario también pueden abaratar los predicados de igualdad, porque los valores repetidos ya se han normalizado en referencias de diccionario.
Dicho esto, estas optimizaciones se debilitan cuando:
Las columnas de texto libre no comprimen ni podan con limpieza
Los campos de alta cardinalidad reparten valores entre muchos grupos
Las búsquedas puntuales necesitan una respuesta diminuta de un archivo grande
Las escrituras sin ordenar desparraman los valores de filtro por el conjunto
Patrón de consulta | Columnas leídas | Row groups escaneados | Bytes leídos | Tiempo total |
|---|---|---|---|---|
Escaneo completo de la tabla | Muchas | La mayoría o todos | Alto | El más lento |
Agregación con poda de columnas | Pocas | La mayoría o todos | Menor | Más rápido |
Consulta analítica con filtro de predicado | Pocas | Solo los grupos seleccionados | El más bajo de los tres | El más rápido cuando las estadísticas son selectivas |
La trampa es suponer que Parquet es «rápido» en todos los sentidos. Es rápido en lectura analítica planificada y secuencial. No está construido como un almacén de servicio indexado.
Parquet frente a ORC, Avro, CSV y JSON
Elegir Parquet resulta más fácil cuando lo comparas con los formatos que los equipos suelen debatir.
Dos formatos analíticos, uno por filas y dos de intercambio
Parquet y ORC apuntan ambos a escaneos analíticos. Son columnares, comprimidos y diseñados para datos tipados. En la práctica general, Parquet tiende a ganar en amplitud de ecosistema entre motores y herramientas de lakehouse. ORC sigue teniendo sentido en algunos entornos centrados en Hive.
Avro es otro animal. Está orientado a filas y encaja mejor con la escritura registro a registro, el intercambio de eventos y pipelines ricos en esquema donde preservar la estructura de la fila importa más que la eficiencia de escaneo.
CSV y JSON son más fáciles para las personas y las herramientas generalistas, pero trasladan el trabajo de parseo y tipado al momento de lectura. Eso suele convertirlos en malas elecciones a largo plazo para grandes conjuntos analíticos.
Usa Parquet cuando esperes escaneos repetidos y lecturas selectivas de columnas. Usa Avro cuando los registros circulen por sistemas de streaming. Reserva CSV y JSON para intercambio, depuración o entregas sencillas.
La decisión real es el encaje con la carga de trabajo
Muchos equipos preguntan: «¿Qué formato es más rápido?». La mejor pregunta es: «¿Rápido para qué?».
Analítica por lotes: Parquet suele encajar mejor.
Pila analítica muy centrada en Hive: ORC quizá merezca una mirada.
Registros en streaming y transporte de eventos: Avro suele ser más limpio.
Inspección ad hoc y amplia compatibilidad de herramientas: CSV sigue ganando.
Intercambio de payloads de API anidados: JSON sigue siendo común pese al coste.
Formato | Disposición | Eficiencia de compresión | Velocidad de escaneo | Evolución del esquema | Mejor encaje |
|---|---|---|---|---|---|
Parquet | Columnar | Fuerte | Fuerte para analítica | Buena, con matices entre lectores | Lagos de datos, BI, analítica por lotes |
ORC | Columnar | Fuerte | Fuerte para analítica | Buena | Entornos analíticos orientados a Hive |
Avro | Orientado a filas | Moderada | Mejor para acceso por filas que para escaneos de columnas | Fuerte para registros | Streaming, payloads de mensajes, intercambio |
CSV | Texto orientado a filas | Débil | Débil en lecturas analíticas grandes | Ninguna integrada | Inspección manual, exportaciones sencillas |
JSON | Texto semiestructurado | Entre débil y moderada | Débil para escaneos grandes | Flexible pero poco exigida | Payloads de API, intercambio anidado |
Particionado, tamaño de archivo y buenas prácticas de almacenamiento
Una historia habitual de producción es esta: el equipo eligió Parquet, los tiempos de consulta pintaban bien el primer mes, y luego el lago se llenó de archivos diminutos, particiones desiguales y tablas que un motor escaneaba rápido mientras otro peleaba con la sobrecarga de planificación. El formato hizo su trabajo. La disposición no.
Elige columnas de partición por las que la gente filtre
El particionado funciona como un índice grueso. Ayuda a los lectores a saltarse carpetas enteras antes siquiera de abrir pies de Parquet. Eso es potente, pero solo cuando la clave de partición coincide con los patrones reales de consulta.
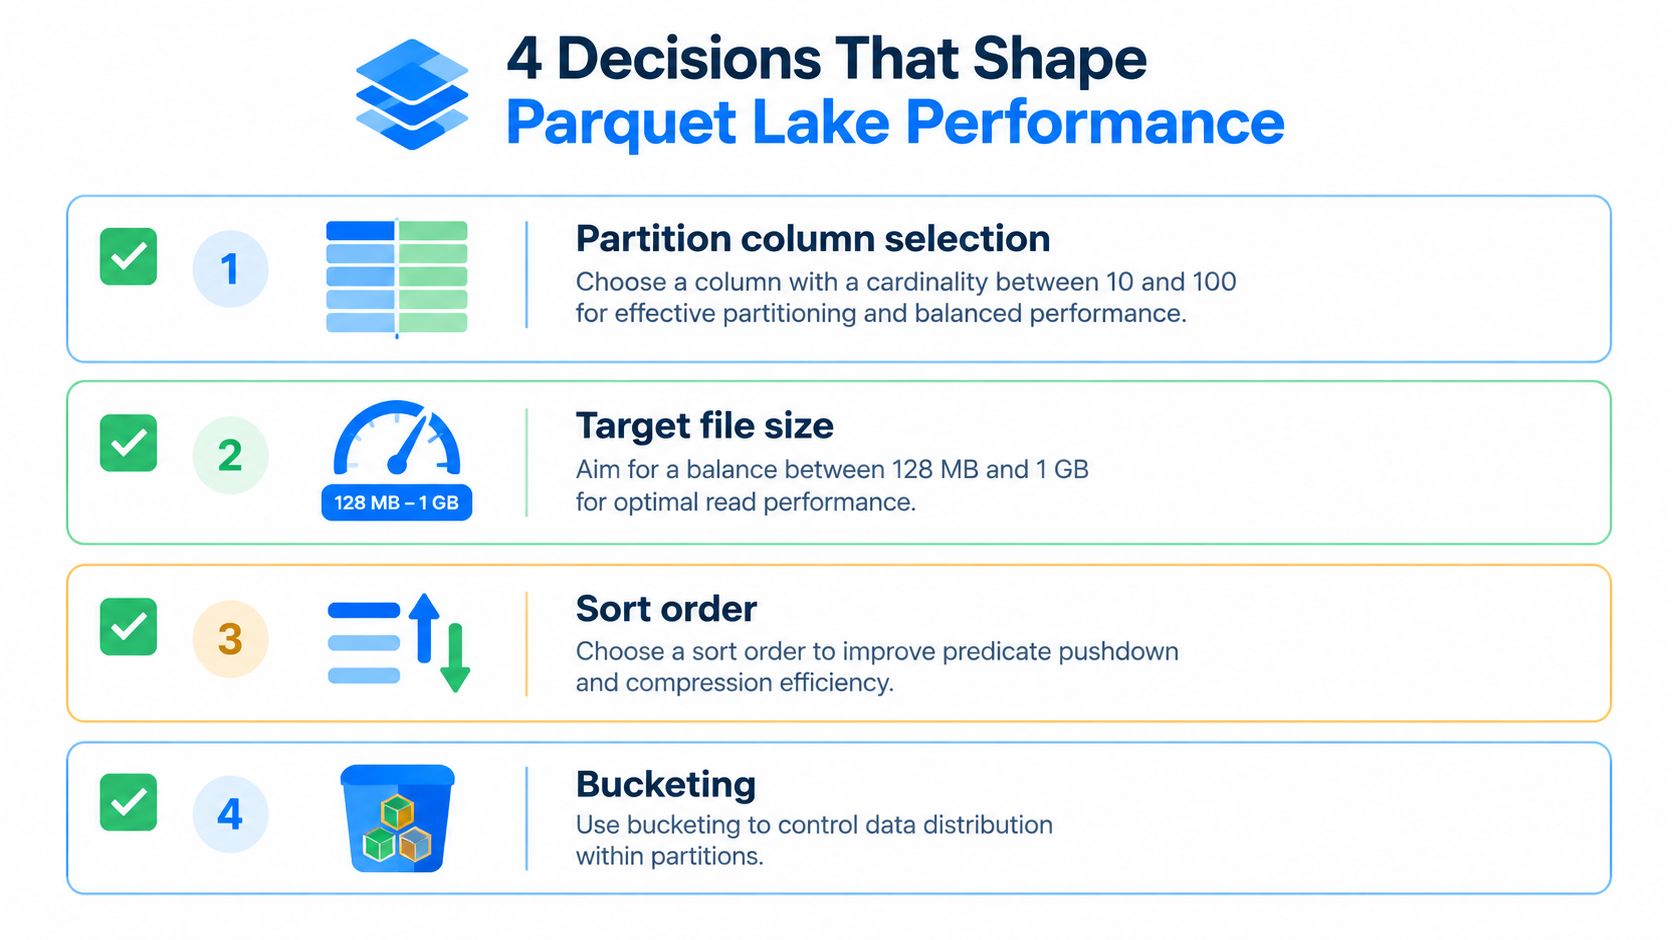
La fecha es el punto de partida habitual porque los informes y los rellenos suelen segmentar por día, semana o mes. Región, entorno, nivel de cliente o unidad de negocio también pueden encajar si esos campos aparecen a menudo en cláusulas WHERE. Una mala clave suele tener uno de dos problemas. O es demasiado amplia para podar mucho, o tan alta en cardinalidad que estalla en incontables directorios y archivos pequeños. Particionar por identificador de usuario es el error clásico.
La concesión pesa más de lo que admiten muchas guías. Un buen particionado acelera las lecturas analíticas amplias. Hace poco por las búsquedas puntuales, porque Parquet todavía necesita los metadatos del pie antes de encontrar el row group adecuado. Si tu carga incluye recuperaciones frecuentes de registros, ningún esquema de particionado convertirá Parquet en un almacén clave-valor.
Para equipos que construyen escritores por lotes y trabajos de compactación, estos consejos de orquestación de ETL con Python son un buen acompañamiento, porque el particionado solo aguanta si el planificador, la lógica de reintentos y las salidas del escritor se mantienen consistentes con el tiempo.
El tamaño de archivo decide si el almacenamiento de objetos resulta ágil o torpe
El tamaño de archivo es donde muchos lagos pierden la forma. Los archivos muy pequeños aumentan la sobrecarga de listado, las lecturas de metadatos y el tiempo de planificación. Los muy grandes pueden reducir el paralelismo y encarecer los reintentos. El punto óptimo depende de tu motor, tu red y tu ruta de escritura, pero el objetivo son archivos estables y aptos para escaneo, y no el tamaño que salga por casualidad de los microlotes anteriores.
El tamaño del row group también cuenta. Los row groups mayores suelen mejorar las lecturas secuenciales y la compresión, pero vuelven menos precisas las lecturas selectivas si tu orden es pobre. Por eso el tamaño de archivo y el orden deberían elegirse juntos, no como perillas de ajuste separadas.
El almacenamiento de objetos añade otra capa de comportamiento. Un lago sobre almacenamiento compatible con S3 no se comporta como un disco local con operaciones de directorio baratas. Los costes aparecen en llamadas de listado, latencia de apertura y dispersión de archivos pequeños. Esta introducción a cómo se comporta S3 como sistema de archivos es una referencia útil para ese modelo mental.
Vigila algunas señales en producción: tamaño medio de archivo por tabla, número de archivos por partición, retraso de compactación y tiempo de planificación frente a tiempo de escaneo. Si el tiempo de planificación sigue subiendo mientras el volumen de datos se mantiene plano, la disposición de archivos suele ser el primer lugar donde mirar.
Ordenar y hacer bucketing ayuda, pero solo en los lugares adecuados
Ordenar es uno de los hábitos de mayor valor para quien escribe Parquet. Cuando los valores similares caen juntos, las estadísticas de row group ganan selectividad, la compresión mejora y los motores pueden saltarse más datos con confianza. Si los analistas filtran a menudo por event_date, customer_region u otro campo selectivo, ordenar por ese campo puede hacer los metadatos del pie mucho más útiles.
El bucketing resuelve otro problema. Puede volver más predecible la distribución dentro de una partición, lo que ayuda a algunos pipelines con muchos joins. También añade carga operativa y no está igual de bien soportado en todos los motores, así que trátalo como una elección específica de la carga y no como algo por defecto.
Una lista de comprobación práctica:
Particiona para los filtros habituales: empieza por campos que aparezcan de forma consistente en los predicados.
Mantén a raya el número de archivos: compacta tras escrituras en streaming o muy paralelas.
Ordena dentro de las particiones: un mejor orden hace que las estadísticas de row group merezcan confianza.
Sigue la deriva de disposición con el tiempo: el aumento de archivos pequeños y la planificación más lenta son avisos tempranos.
Usa el bucketing con criterio: aplícalo donde el comportamiento de los joins justifique el coste de mantenimiento.
Evolución del esquema, interoperabilidad y las trampas silenciosas
La fama de portabilidad de Parquet solo es merecida hasta cierto punto. La realidad incómoda de producción es que la especificación avanza más rápido que muchas pilas de lectores.
Formato abierto no significa soporte uniforme
El material de Apache sobre estado de implementación muestra un soporte fragmentado por motor y año de publicación, con algunas capacidades nuevas aún no implementadas ampliamente y otras solo parcialmente soportadas entre lectores, según la página de estado de implementación de Parquet. La guía de versiones también advierte de que unas funciones son compatibles hacia adelante y otras no.
Eso significa que un lector antiguo podría abrir el archivo pero perder metadatos, quedarse sin mejoras de rendimiento o fallar con codificaciones no soportadas. Trabajos recientes como la codificación adaptativa sin pérdida para coma flotante y los nuevos tipos lógicos amplían la brecha entre lo que el formato puede expresar y lo que cada motor de tu pila consume con fiabilidad.
La trampa suele aparecer meses después del despliegue
Los fallos peligrosos no siempre son ruidosos. A veces un motor lee un campo como se espera, otro devuelve nulos y un tercero cae en una ruta de decodificación más lenta. Eso no se detecta en una prueba rápida si todo el mundo valida solo con el motor que escribe.
Algunos patrones de fallo se repiten:
Desajustes de tipos lógicos: marcas de tiempo, decimales y tipos anidados pueden representarse distinto según el lector.
Huecos de compatibilidad en codificaciones: las codificaciones nuevas pueden sorprender a motores antiguos.
Comportamiento de reserva del diccionario: distintos escritores cambian de estrategia de forma diferente, lo que afecta al tamaño y a la velocidad de escaneo.
Latencia por leer primero el pie: incluso las lecturas diminutas siguen pagando el coste de acceso a metadatos ya comentado.
Si tu equipo gestiona pipelines muy orientados a Databricks y consumidores en varios motores, un enfoque específico de calidad de datos en Databricks se vuelve relevante, porque la deriva de tipos y el desacuerdo entre lectores aparecen primero como incidencias de calidad y no como errores de parseo.
Función | Spark 3.5 | Trino 470 | DuckDB 1.2 | Athena |
|---|---|---|---|---|
Lectura básica de Parquet | Ampliamente soportada | Ampliamente soportada | Ampliamente soportada | Ampliamente soportada |
Codificaciones más nuevas | Verificar por versión | Verificar por versión | Verificar por versión | Verificar por versión |
Tipos lógicos anidados | Normalmente viable, probar con cuidado | Probar con cuidado | Probar con cuidado | Probar con cuidado |
Conservación de metadatos | Varía según el flujo | Varía según el flujo | Varía según el flujo | Varía según el flujo |
No preguntes solo «¿puede este motor leer Parquet?». Pregunta «¿puede esta versión exacta del lector leer con seguridad archivos de esta configuración exacta del escritor?».
Deriva de esquema, Timeliness y observabilidad en pipelines Parquet
El pie de un Parquet no es solo metadato para el lector. En una plataforma madura se convierte en una superficie de observabilidad.

La deriva de esquema suele anunciarse antes en los metadatos
Cuando un escritor añade una columna, cambia un tipo, elimina un campo o altera el comportamiento de orden, esos cambios aparecen en los metadatos del archivo antes de que los paneles posteriores revelen todo el alcance. Eso hace útil inspeccionar el pie para detectar pronto.
Señales habituales de deriva:
Campos nullable inesperados: aparece una columna nueva pero los consumidores no la rellenan de forma consistente.
Ampliación de tipo: campos de tipo entero pasan a numéricos más amplios y la lógica posterior cambia de comportamiento.
Campos eliminados o renombrados: los lectores pueden seguir funcionando, pero la lógica de negocio empieza a leer resultados más vacíos.
Desajuste de particiones: el nombre de los directorios y el esquema del archivo dejan de contar la misma historia.
Timeliness y semántica de archivos van unidas
Los pipelines Parquet también generan problemas propios de frescura. Una tabla puede parecer presente en el almacenamiento mientras un subconjunto de archivos sigue incompleto, retrasado o escrito con metadatos inconsistentes. Los escritores en streaming pueden dejar salidas parciales que confunden a los consumidores si tu plataforma marca el conjunto como «listo» demasiado pronto.
Por eso los ingenieros monitorizan algo más que la hora de llegada. También revisan número de archivos, momento de modificación, consistencia de esquema entre particiones y metadatos del escritor como created_by y la información de orden.
Una forma de operativizar eso es con monitorización del data lake que observe a la vez las señales a nivel de archivo y de conjunto, en lugar de tratar el almacenamiento como una caja negra. En ese contexto, digna encaja como una opción para equipos que quieren monitorizar en su propio entorno los cambios de esquema, la Timeliness, las anomalías y la validación en pipelines de lago y almacén.
Qué vigilar en producción
Si estuviera incorporando a una nueva ingeniera de analítica a un lago muy basado en Parquet, le diría que empezara por cuatro comprobaciones:
Diferencias de pie entre cargas diarias: detecta pronto los cambios silenciosos de esquema.
Crecimiento de archivos pequeños por partición: el dolor de las consultas suele empezar aquí.
Matriz de compatibilidad lector-escritor: mantén una lista explícita por versión de motor.
Timeliness ligada a la preparación completa del conjunto: no alertes solo por carpetas que faltan.
Los metadatos de Parquet más útiles no están ahí para que el archivo quede elegante. Están para ayudarte a detectar problemas antes de que los usuarios pregunten por qué el panel se ve mal.
Parquet funciona bien cuando tu carga encaja con su diseño, pero necesita monitorización disciplinada en cuanto entran en juego varios motores, escritores y consumidores posteriores. digna ayuda a los equipos a seguir el cambio de esquema, la Timeliness, la validación y el comportamiento de los datos dentro de su propio entorno, que es justo donde suelen aflorar primero los problemas de los pipelines Parquet. Si tu lakehouse funciona sobre Parquet y tus incidencias empiezan con deriva silenciosa en lugar de fallos ruidosos, merece un vistazo.
Los metadatos del pie hacen visible pronto la deriva de esquema, pero alguien tiene que vigilarla: ese es el trabajo de una capa de gestión de la calidad de los datos sobre el lago.
Preguntas frecuentes
¿Por qué Parquet se convirtió en el formato columnar por defecto?
Parquet se convirtió en el tejido conectivo entre pipelines de Spark, exportaciones de almacén, lagos en almacenamiento de objetos y formatos de tabla como Iceberg, Delta Lake y Hudi. Los equipos lo adoptaron porque es abierto, tipado y ampliamente soportado, y porque separa el almacenamiento físico de la elección de motor: un archivo escrito por una herramienta sigue siendo legible por otra.
¿Qué codificaciones y códecs de compresión admite Parquet?
Parquet admite codificaciones a nivel de página como PLAIN, RLE, DELTA_BINARY_PACKED, RLE_DICTIONARY y BYTE_STREAM_SPLIT, además de códecs como SNAPPY, GZIP, BROTLI, ZSTD y LZ4_RAW. La codificación reestructura los valores dentro de una página; la compresión encoge después el flujo de bytes codificado. Elige el códec según lo que estés optimizando: velocidad de lectura, coste de almacenamiento o rendimiento de escritura.
¿Qué es el predicate pushdown en Parquet?
El predicate pushdown permite a un lector saltarse datos usando metadatos antes de decodificar nada. Las estadísticas de row group registran el rango de valores presentes, así que un filtro sobre region = 'EMEA' puede descartar los row groups cuyas estadísticas demuestren que no hay coincidencia. Funciona junto con la poda de columnas, que elimina primero las columnas no usadas.
¿Cómo deberían particionarse y dimensionarse los archivos Parquet?
Particiona por columnas por las que la gente filtre de verdad: el particionado actúa como un índice grueso que permite a los lectores saltarse carpetas enteras antes de abrir ningún pie. En cuanto al tamaño, los archivos muy pequeños inflan el listado y la planificación, mientras que los muy grandes reducen el paralelismo y encarecen los reintentos. Ordenar por un campo selectivo afina las estadísticas de row group.
¿Es segura la evolución del esquema de Parquet entre motores?
Solo hasta cierto punto. El material de Apache sobre estado de implementación muestra un soporte fragmentado por motor y año de publicación, con algunas funciones nuevas solo parcialmente implementadas. Los fallos peligrosos son los silenciosos: un motor lee un campo correctamente mientras otro devuelve nulos. Validar solo con el motor que escribe oculta eso durante meses.



