Evaluación de la calidad de datos: definición y guía práctica
|
7
minuto de lectura

Una evaluación de la calidad de datos es un proceso sistemático que mide la idoneidad de los datos para su uso en varias dimensiones, como la exactitud, la completitud, la puntualidad, la consistencia y el linaje, en lugar de limitarse a una única comprobación de exactitud. La idea moderna nace de la definición de “fitness for use” (idoneidad para el uso) de 1996 y hoy incluye marcos estructurados como el modelo de evaluación en seis partes del FMI.
El consejo habitual es limpiar los datos, contar los nulos y seguir adelante. Ese enfoque se viene abajo en cuanto un conjunto de datos técnicamente válido llega tarde, usa definiciones de negocio contradictorias o pierde su trazabilidad antes de llegar a una carga de trabajo de analítica o de machine learning.
Índice
Replantear la definición de evaluación de la calidad de datos
Caso de estudio: la transformación de la calidad de datos en ITSV
Replantear la definición de evaluación de la calidad de datos
Un conjunto de datos limpio puede producir igualmente un resultado poco fiable. Evaluar la calidad de datos no consiste en comprobar si los valores contienen errores. Es un proceso basado en estándares que perfila los datos, mide las dimensiones relevantes para su uso y comprueba si el resultado sirve a un propósito operativo, analítico, regulatorio o de machine learning.
Una tabla técnicamente válida puede fallar igualmente en producción. Los registros de ayer pueden ser exactos pero llegar demasiado tarde para una decisión operativa. Un campo informado puede ocultar una falta de cobertura porque un segmento entero de clientes nunca entró en el conjunto de datos. Dos sistemas pueden cuadrar internamente y, aun así, atribuir significados distintos a “cliente activo”. En analítica e IA, esos conflictos semánticos pueden generar features que parecen consistentes pero representan conceptos de negocio diferentes.
El enfoque más amplio de idoneidad para el uso surgió en la investigación académica sobre calidad de datos durante los años noventa. Wang y Strong definieron en 1996 la calidad de datos como “fitness for use”, desplazando la atención del recuento de errores a las necesidades de los consumidores de datos, como documenta esta revisión de la historia de la evaluación de la calidad de datos.
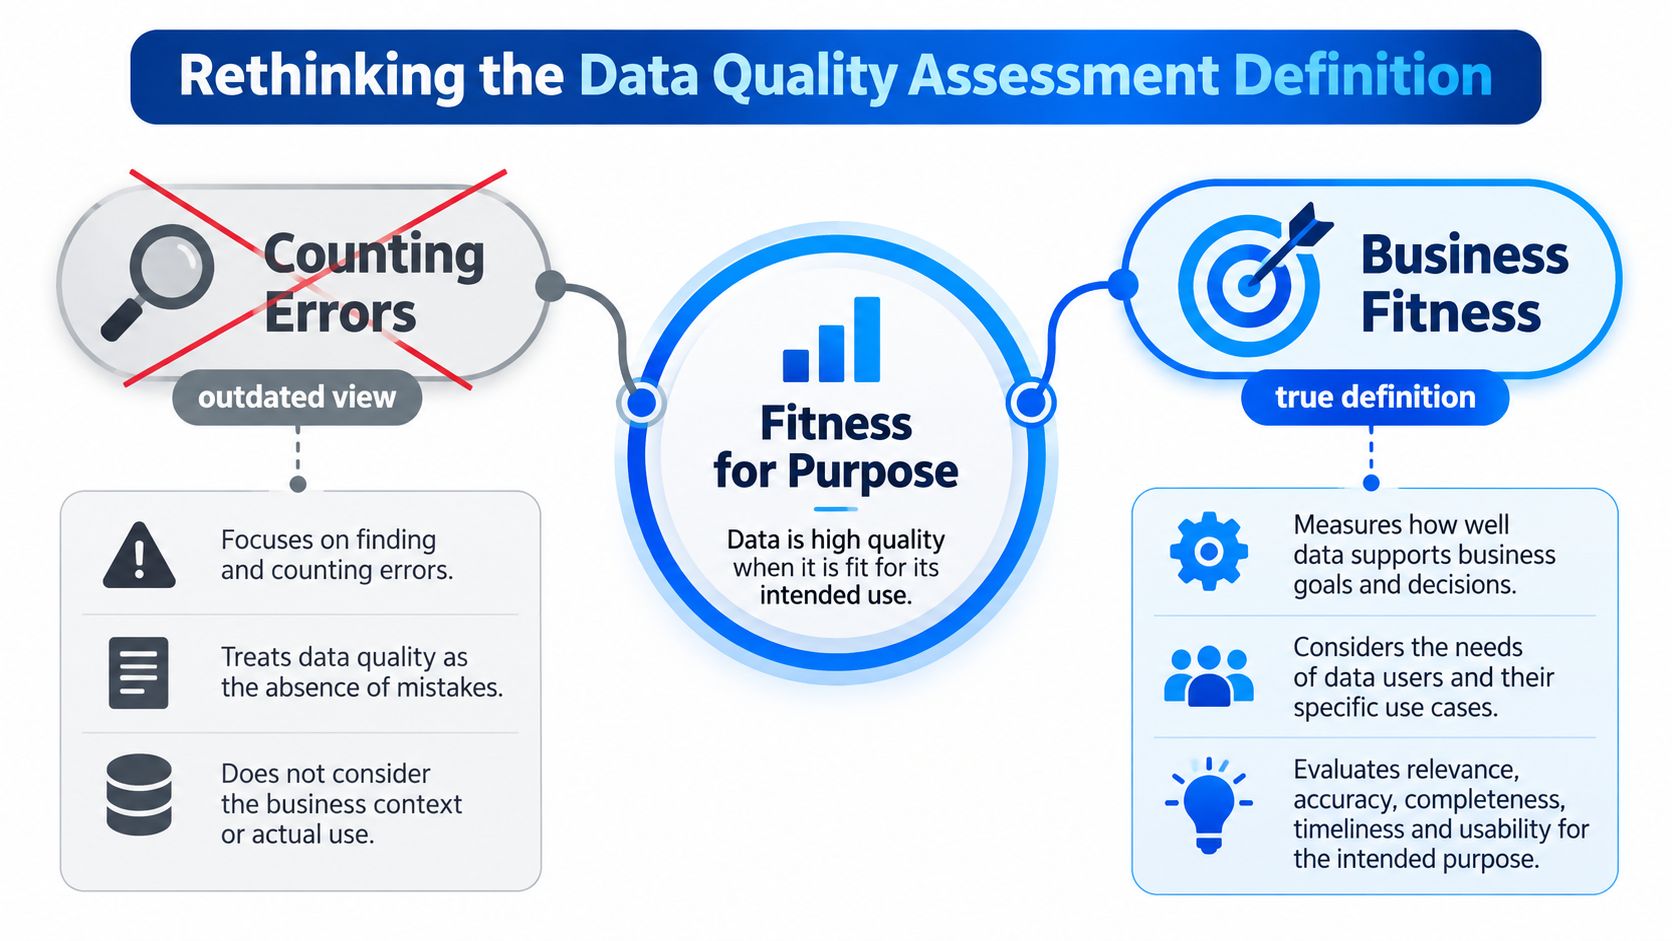
Por qué una sola puntuación no basta
Una única puntuación de exactitud no puede mostrar si las definiciones, el linaje, la actualidad de los datos y la cobertura de la población respaldan una decisión. Una evaluación repetible vincula cada medición con un propósito documentado e identifica los riesgos que importan para esa carga de trabajo.
Uso operativo: ¿Puede el pipeline entregar datos utilizables cuando los procesos posteriores los necesitan?
Uso analítico: ¿Respaldan las definiciones, los joins y la cobertura una conclusión defendible?
Uso regulatorio: ¿Puede la organización explicar el origen, los controles, las transformaciones y las evidencias que hay detrás del resultado?
Uso en IA: ¿Representan los datos de entrenamiento y las features los conceptos de negocio previstos con la consistencia suficiente para la evaluación y el despliegue?
Statistics Canada describe la calidad en su Data Quality Toolkit mediante características como relevancia, cobertura, granularidad, exactitud, fiabilidad, estandarización, actualidad, puntualidad, reproducibilidad y confiabilidad. Esa amplitud explica por qué la evaluación es un control operativo y no un veredicto puntual. Los esquemas, las fuentes, las definiciones, los usuarios y los requisitos cambian, así que las comprobaciones y las responsabilidades deben cambiar con ellos.
Para una introducción más amplia, consulte esta guía sobre qué significa la calidad de datos. La pregunta práctica es si los usuarios adecuados pueden confiar en los datos para una decisión concreta y si la organización puede demostrar por qué.
Las cinco dimensiones clave de la calidad de datos
Una evaluación útil necesita un conjunto reducido de dimensiones que los equipos puedan medir de forma repetida e interpretar en contexto. Estas dimensiones ponen al descubierto modos de fallo distintos. Un conjunto de datos puede superar las comprobaciones de formato y seguir sin ser fiable para analítica o machine learning cuando sus valores tienen un significado de negocio erróneo. Utilice este resumen de las dimensiones de la calidad de datos como modelo de medición y adapte después las reglas a la carga de trabajo.
La exactitud pregunta si los datos reflejan la realidad o una fuente autorizada. Una fecha puede cumplir el formato exigido y aun así ser incorrecta. Las comprobaciones en producción pueden comparar registros con los sistemas de origen, datos de referencia, totales de conciliación o hechos de negocio aprobados. En machine learning, las etiquetas o features inexactas pueden producir un modelo que funciona de forma consistente sobre entradas defectuosas.
La completitud pregunta si están presentes los registros y atributos obligatorios. Distinga entre un nulo permitido y un valor ausente que bloquea un proceso, un análisis o una feature de un modelo. La cobertura también importa. Revise sistemas, poblaciones y periodos relevantes, en lugar de juzgar la completitud solo por las columnas informadas.
La puntualidad mide si los datos llegan con la actualidad suficiente para su uso previsto. Un informe mensual, una alerta operativa y una feature de un modelo pueden tener requisitos de actualidad distintos. Defina ventanas de entrega aceptables y valore las consecuencias del retraso, en lugar de tratar todos los retrasos como igual de graves.
La consistencia comprueba si los valores, relaciones y definiciones equivalentes coinciden entre sistemas y transformaciones. Incluye formatos y códigos, pero también saca a la luz conflictos semánticos. Dos departamentos pueden calcular la misma métrica de forma distinta, lo que deja datos de aspecto limpio que no permiten una comparación ni un conjunto de entrenamiento fiables.
La validez comprueba si los valores se ajustan a las reglas, formatos, listas de referencia y expectativas estructurales declarados. Una regla puede confirmar que un estado pertenece a un conjunto aprobado. Las reglas entre campos comprueban si los atributos relacionados tienen sentido de negocio en conjunto, lo que detecta errores que la validación a nivel de columna pasa por alto.
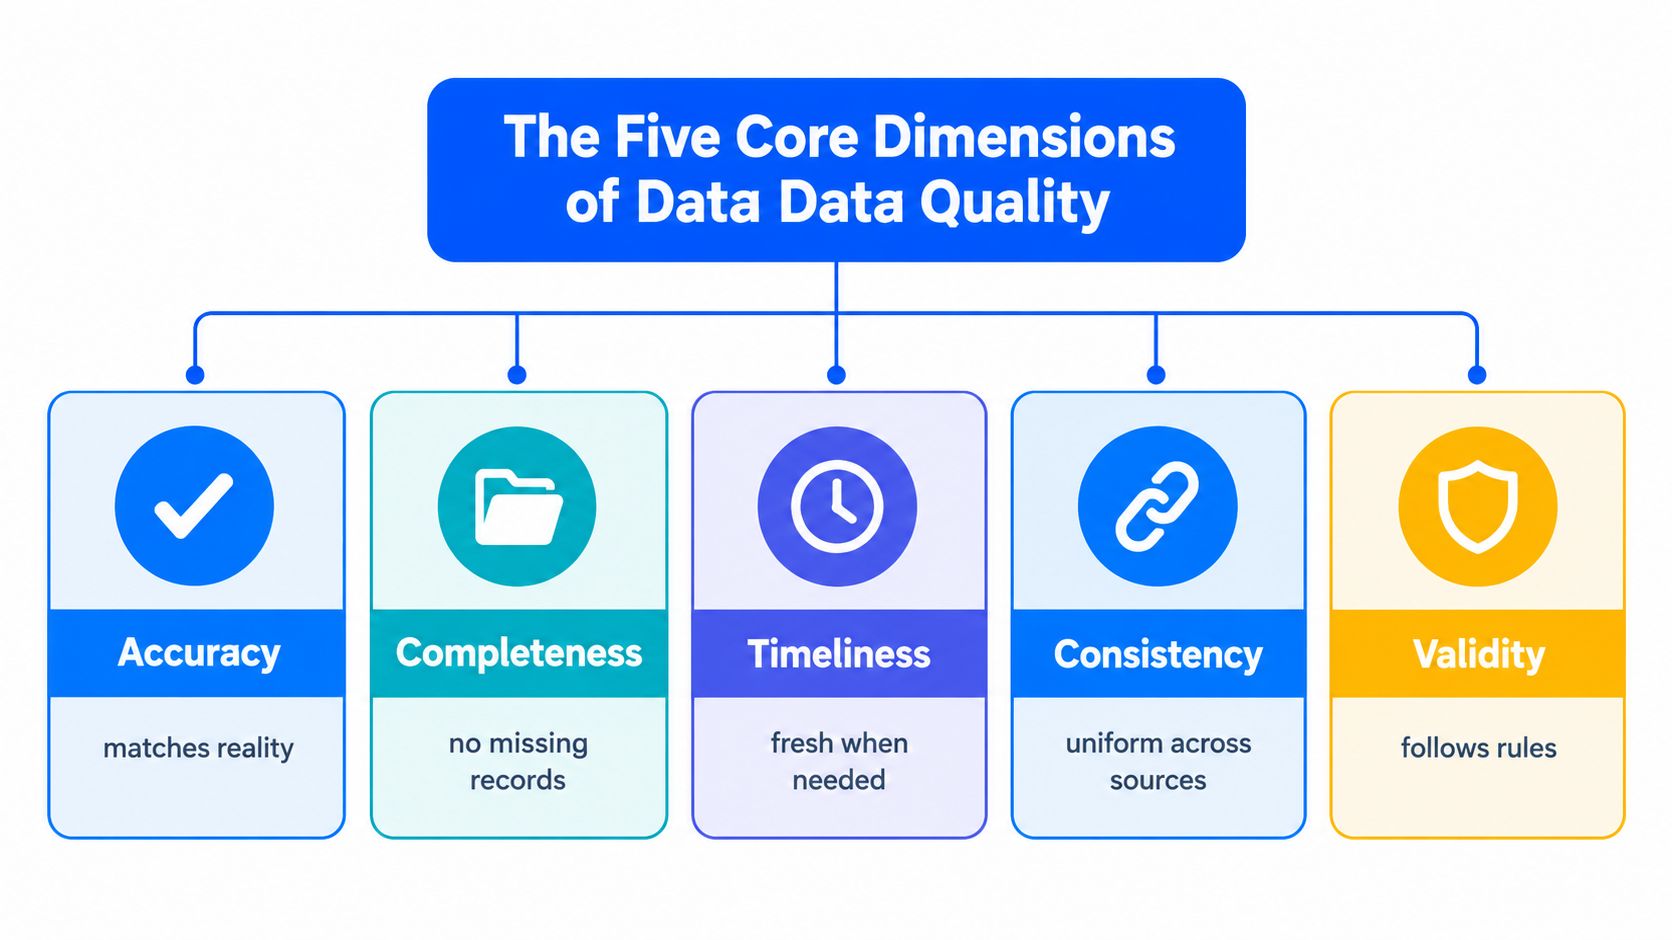
Añadir trazabilidad al modelo
El linaje no es un pilar independiente en el modelo visual, pero los equipos de producción lo necesitan para interpretar cada resultado. Cuando una regla falla, los ingenieros deberían poder identificar la fuente, la transformación, la tabla, el informe o el modelo afectados. Sin esa ruta, una puntuación describe un síntoma sin mostrar dónde debe aplicarse la corrección.
Las directrices relacionadas con ISO distinguen entre calidad sintáctica, calidad semántica y calidad pragmática. La sintaxis abarca la estructura declarada, la semántica el significado previsto y la pragmática el propósito del usuario, como explica este resumen de los conceptos de calidad de ISO 8000. Esa distinción evita que los equipos den por hecho que unos datos técnicamente limpios son automáticamente aptos para analítica o IA.
Cada dimensión necesita un responsable, una regla o métrica, un umbral aceptable y una vía de escalado. Las comprobaciones continuas hacen que esos controles sean accionables, en lugar de dejar el modelo como una simple lista de verificación.
Contexto histórico y estándares
La definición de evaluación de la calidad de datos se desarrolló por etapas. El trabajo académico de los años noventa amplió la calidad desde la simple corrección hasta la idoneidad para el uso. Después llegó la estandarización formal, con la publicación por parte de ISO de su estándar de calidad de datos en 2011, como señala la revisión histórica citada antes. Ese cambio sigue siendo importante, porque un valor puede tener un formato impecable y ser técnicamente válido y, aun así, tener un significado de negocio erróneo para un analista o un modelo de machine learning.
El FMI desarrolló su Data Quality Assessment Framework tras un debate de su Directorio Ejecutivo en diciembre de 1997. En julio de 2001 se presentó un documento y en 2003 el marco se describió públicamente. Su estructura consta de seis partes: empieza por los requisitos previos de la calidad y después examina otras cinco dimensiones. El Data Quality Assessment Framework del FMI separa las condiciones habilitadoras, como la gobernanza y los acuerdos institucionales, de la calidad de los productos y procesos estadísticos.
Esa separación pone de manifiesto un fallo habitual en las empresas. Un equipo puede producir registros técnicamente correctos mediante un proceso no documentado, o mantener una gobernanza formal mientras sus datos siguen incompletos. Ninguno de los dos resultados es fiable para reporting, previsiones o entrenamiento de IA. Por eso, una evaluación debe examinar la responsabilidad, las condiciones legales, la documentación, la capacidad de los procesos y el significado asignado a cada campo, no solo los valores almacenados.
El estándar ISO de perfilado de datos trata el perfilado como base de la evaluación. El perfilado aporta análisis de columnas y estadísticas del conjunto de datos, pero los ingenieros siguen teniendo que relacionar esas observaciones con los requisitos de negocio y las dimensiones de calidad. ISO 8000-61 también vincula la gestión de la calidad de datos con la capacidad de los procesos y la madurez organizativa.
Los estándares convierten opiniones en evidencias
Los estándares no eliminan el criterio. Lo hacen explícito y repetible. Un equipo regulado puede documentar por qué existe un umbral de actualidad, qué registros entran en el alcance, cómo se calcula un fallo y quién acepta el riesgo restante.
Ese rastro de auditoría hace que las directrices gubernamentales también sean útiles en entornos comerciales. El enfoque de la EPA sobre la evaluación de la calidad de datos la plantea como una valoración científica y estadística de si los datos tienen el tipo, la calidad y la cantidad adecuados para su uso previsto. El mismo principio se aplica a la analítica en finanzas, sanidad y sector público.
Los equipos que busquen un contexto de gobernanza más amplio pueden combinar los estándares con las directrices del DAMA DMBOK. La prueba práctica es sencilla: un marco se gana su lugar cuando los ingenieros y los propietarios de los datos pueden usarlo para tomar decisiones coherentes sobre el riesgo semántico, la idoneidad de los modelos y la corrección.
Riesgos operativos de una evaluación deficiente
Una evaluación deficiente rara vez falla con una advertencia roja evidente. Lo más habitual es que un pipeline se ejecute técnicamente con éxito mientras entrega datos que ya no sirven para la decisión asociada a ellos.
Un dashboard desactualizado es un fallo de puntualidad. Una columna de origen renombrada que atraviesa una transformación sin monitorizar es un fallo de esquema y de linaje. Un informe que combina dos medidas válidas pero definidas de forma distinta es un fallo de consistencia y semántico. Cada uno de estos problemas puede pasar inadvertido cuando los equipos solo monitorizan nulos, formatos o la validez a nivel de fila.
Qué falla primero
El incidente visible suele producirse aguas abajo del defecto de calidad:
Los dashboards pierden credibilidad: los analistas encuentran cifras contradictorias y empiezan a conciliar extracciones a mano.
Los pipelines ocultan retrasos: un estado de job correcto puede ocultar un fichero que llegó tarde o que contenía solo una carga parcial.
Los esquemas derivan sin aviso: columnas añadidas, eliminadas o con un tipo distinto pueden cambiar el comportamiento aguas abajo sin generar ningún error en la aplicación.
Los modelos heredan la ambigüedad: un flujo de machine learning puede tratar definiciones contradictorias como features comparables porque los valores parecen estructuralmente válidos.
La corrección se ralentiza: sin linaje ni responsables claros, los equipos discuten dónde empezó el problema en lugar de arreglar el proceso responsable.
El coste no se limita a rehacer trabajo. Los usuarios pueden dejar de confiar en los conjuntos de datos gobernados y crear hojas de cálculo privadas o consultas paralelas. Los ingenieros acaban dando soporte a varias versiones no oficiales de la misma métrica, lo que dificulta las evaluaciones futuras.
Regla práctica: evalúe los modos de fallo que pueden invalidar la decisión, no solo los defectos más fáciles de contar.
La evaluación continua responde a esta realidad operativa. Los equipos pueden perfilar los datos durante la incorporación, pero la monitorización en producción debe vigilar a lo largo del tiempo el comportamiento de entrega, las distribuciones, los cambios estructurales, los resultados de validación y las métricas de negocio. El objetivo no es eliminar todas las anomalías. Se trata de identificar pronto los cambios relevantes, relacionarlos con los consumidores afectados y dar a un responsable evidencias suficientes para actuar.
Reglas manuales frente a observabilidad continua
Las reglas escritas a mano siguen teniendo su lugar. Funcionan bien cuando un requisito es explícito, estable e importante desde el punto de vista legal u operativo. Un campo obligatorio, un código de estado aprobado o una condición de integridad referencial deben seguir siendo deterministas, porque la organización necesita una decisión clara de aprobado o suspenso.
El problema empieza cuando los equipos usan reglas manuales para cualquier patrón posible. Las bibliotecas de reglas crecen más rápido de lo que sus responsables pueden revisarlas, y una regla que tenía sentido para el esquema del año pasado puede volverse irrelevante tras una migración. Además, las comprobaciones estáticas tienden a detectar defectos conocidos y a pasar por alto cambios inusuales pero válidos en volumen, tiempos, distribución o comportamiento.
Enfoque de evaluación | Escalabilidad | Mantenimiento | Capacidad de detección |
|---|---|---|---|
Reglas deterministas manuales | Sólidas para controles específicos y bien definidos | Requieren responsables, revisión y actualizaciones cuando cambian los requisitos | Eficaces para condiciones conocidas y restricciones de negocio |
Perfilado periódico | Útil para explorar conjuntos de datos desconocidos | Poca continuidad operativa entre evaluaciones | Encuentra patrones, nulos, distribuciones y valores atípicos en el momento de la revisión |
Observabilidad continua | Escala en pipelines cambiantes cuando se gestionan las líneas base y las responsabilidades | Requiere ajuste, triaje de incidentes y disciplina de gobernanza | Detecta desviaciones en comportamiento, puntualidad, estructura y tendencias de calidad |
Evaluación híbrida | Combina una monitorización amplia con controles precisos | Equilibra el mantenimiento entre tipos de reglas | Cubre tanto los requisitos explícitos como las anomalías desconocidas hasta ahora |
Elegir la combinación adecuada
Las reglas manuales son adecuadas cuando el negocio puede formular el requisito con precisión y explicar por qué importa un incumplimiento. La detección continua resulta más útil para comportamientos que varían de forma natural, como los tiempos de entrega o las distribuciones de los conjuntos de datos. Los métodos estadísticos y de machine learning pueden establecer patrones esperados, pero no sustituyen el contexto de negocio. Un resultado inusual puede ser un defecto, un cambio estacional legítimo o una modificación planificada.
El patrón que mejor funciona en producción suele ser validación determinista más monitorización adaptativa. Una impone lo que siempre debe cumplirse. La otra vigila los cambios que nadie pensó en codificar de antemano.
Los equipos que estén valorando este equilibrio pueden consultar también este análisis sobre las reglas técnicas de calidad de datos mantenidas manualmente. La decisión de diseño importante no es si ganan las reglas o la observabilidad. Lo que importa es qué evidencias requieren una política fija y qué comportamiento merece una comparación continua con una línea base cambiante.
Cómo realizar una evaluación de la calidad de datos
Una evaluación útil convierte las observaciones en decisiones. El siguiente flujo de trabajo mantiene conectados el perfilado, la medición, el contexto de negocio y la corrección.
Empezar por el perfilado
En primer lugar, inspeccione la estructura y el comportamiento del conjunto de datos. Registre columnas, tipos, patrones de valores, nulos, unicidad, distribuciones, relaciones, historial de entregas y los metadatos disponibles. El perfilado es exploración, no la evaluación final. Le indica lo que parece estar ocurriendo, pero no decide si el patrón es aceptable.
Relacionar los hallazgos con el uso previsto
A continuación, identifique a los consumidores y la decisión que respaldan los datos. Relacione cada hallazgo con dimensiones como exactitud, completitud, puntualidad, consistencia, validez y linaje. Después, documente los requisitos semánticos que el perfilado técnico no puede deducir, como las definiciones de negocio, el alcance, los responsables y la fuente autorizada.
Un valor ausente puede ser aceptable en un flujo de trabajo y descalificante en otro. Un cambio en la distribución puede indicar data drift o reflejar un evento de negocio legítimo. El contexto determina la interpretación.
Definir umbrales
Establezca expectativas medibles por conjunto de datos en lugar de usar valores por defecto para toda la organización. Entre los controles útiles están los campos obligatorios y opcionales, las tasas de nulos aceptables, los límites de actualidad, la detección de cambios de esquema, los volúmenes de filas esperados, los valores permitidos y las condiciones de conciliación. Las directrices de calidad basadas en estándares insisten en dimensiones explícitas y requisitos documentados, lo que hace que los resultados sean más reproducibles.
Validar y priorizar
Aplique reglas de negocio a nivel de registro junto con una monitorización a nivel de conjunto de datos. Después, priorice los fallos según su impacto en el negocio, los consumidores afectados, la exposición regulatoria y el esfuerzo de corrección. Un defecto pequeño en un campo regulatorio crítico puede merecer una actuación más rápida que un defecto mayor en un atributo que no se usa.
El modelo de medición orientado al sector público ofrece un patrón práctico: identificar aserciones vinculadas a políticas, conectarlas con el impacto en el negocio, clasificar los defectos, cuantificar su contribución a la conformidad y presentar los resultados en un formato que permita profundizar en el detalle.
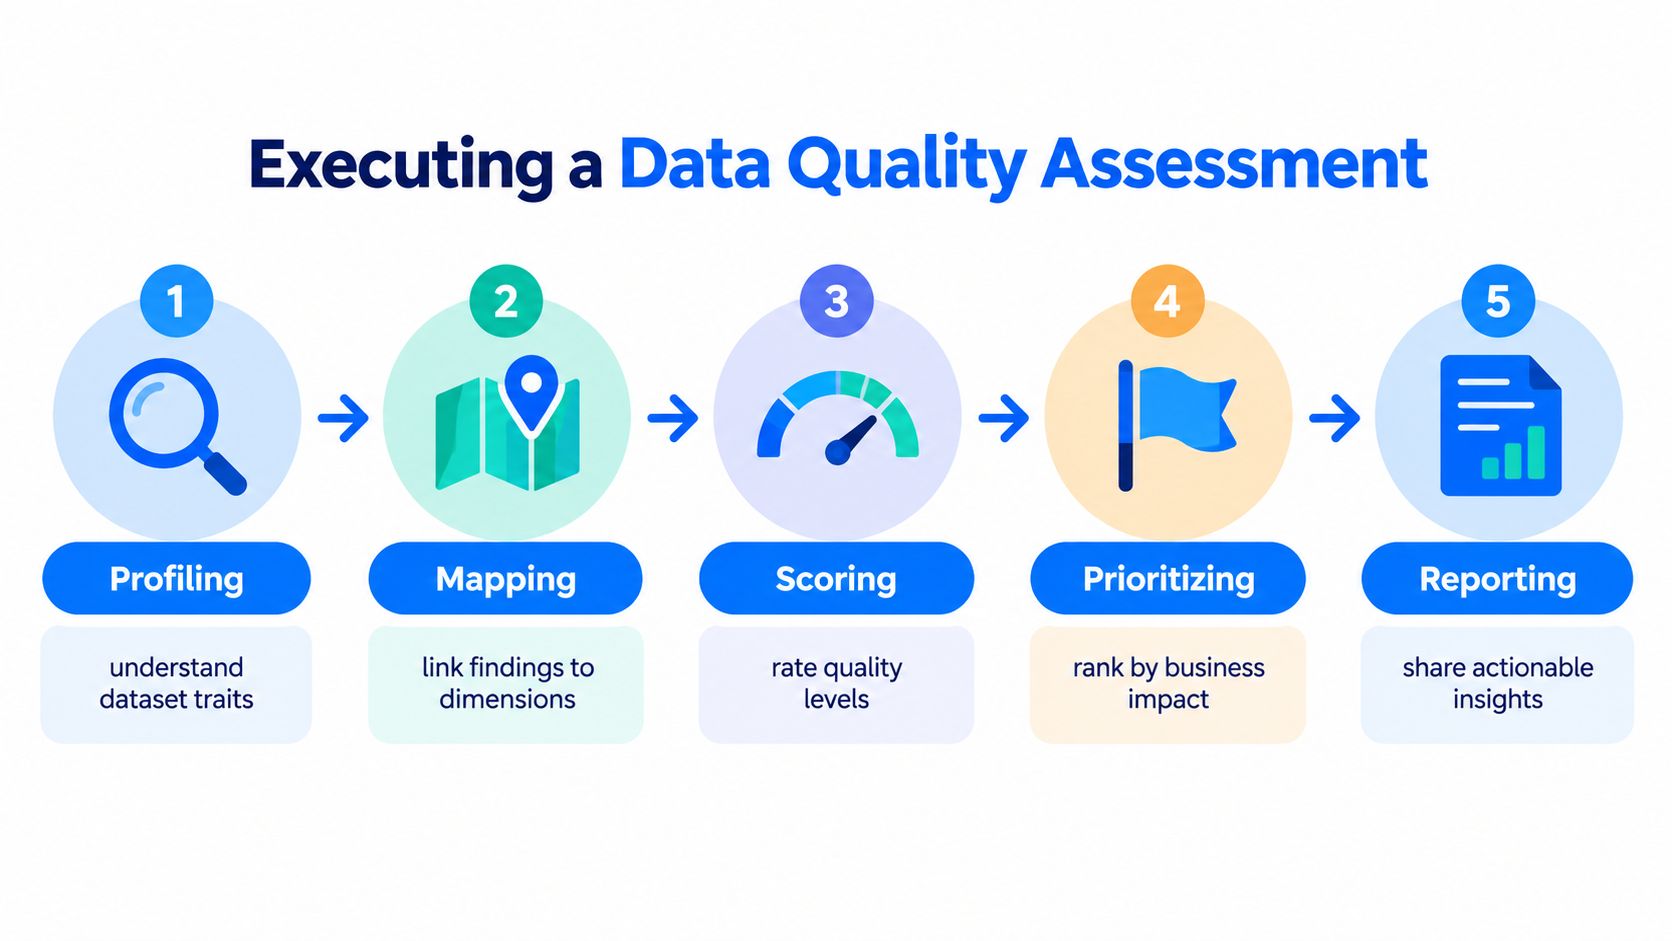
Informar y operacionalizar
Por último, publique el resultado con las evidencias, los responsables, los activos afectados y la siguiente acción. Integre las comprobaciones en el pipeline o en la capa de observabilidad para que la misma evaluación se ejecute cuando cambien los datos, y no solo cuando alguien se acuerde de lanzar una auditoría.
Un flujo de auditoría de la calidad de datos práctico debe conservar el historial. Siga la evolución de los resultados a lo largo del tiempo, registre las excepciones aceptadas y verifique la corrección. Sin evidencias históricas, los equipos no pueden distinguir un incidente nuevo de un defecto recurrente.
Caso de estudio: la transformación de la calidad de datos en ITSV
ITSV, la columna vertebral informática de la seguridad social austriaca, se enfrentaba a la carga de mantenimiento que suponía una gran colección de reglas de calidad escritas a mano. La organización sustituyó 9.000 reglas creadas manualmente por digna Data Anomalies y Data Timeliness, pasando de un modelo centrado principalmente en el mantenimiento de reglas a la observabilidad continua.
El valor del cambio no estuvo solo en tener menos reglas. ITSV necesitaba un enfoque de monitorización capaz de escalar con su entorno de datos sin obligar a los especialistas a recordar cada patrón esperado. La detección continua de anomalías ayudó a reducir el ruido de alertas, mientras que la monitorización de la puntualidad centró la atención en si los datos llegaban según el comportamiento operativo esperado.

Qué demuestra el ejemplo
La transformación ilustra tres lecciones prácticas:
El volumen de reglas no es madurez en calidad: miles de comprobaciones pueden generar una gran obligación de mantenimiento sin cubrir la deriva semántica ni los comportamientos inesperados.
La monitorización adaptativa preserva la atención: reducir las alertas innecesarias da a los ingenieros más tiempo para investigar los cambios relevantes.
El conocimiento debe residir en el sistema: un proceso de monitorización que depende de la memoria de personas concretas se vuelve frágil cuando alguien cambia de puesto o se marcha.
El ejemplo de ITSV no hace obsoletas las reglas deterministas. Los requisitos de negocio críticos siguen necesitando una validación explícita. Lo que muestra es por qué los equipos se benefician de combinar esos controles con una monitorización que aprende el comportamiento normal de los conjuntos de datos y señala las desviaciones para su revisión.
El modelo operativo más sólido también asigna responsabilidades tras la detección. Una anomalía sin contexto, linaje ni responsable se convierte en otro ticket del backlog. Una anomalía vinculada a un proceso afectado y a un responsable claro de la decisión puede convertirse en un flujo de corrección controlado.
Consideraciones para la implantación en la empresa
La adopción en la empresa tiene éxito cuando la arquitectura de evaluación respeta la seguridad, la gobernanza y la forma en que los equipos ya trabajan. Trasladar los datos a un servicio de monitorización independiente puede generar exposición, duplicación y fricción en las aprobaciones innecesarias. La ejecución dentro de la base de datos mantiene el cálculo de métricas y el análisis en las bases de datos del cliente, de modo que los datos permanecen donde están y los equipos siguen obteniendo evidencias de calidad.
La flexibilidad de despliegue importa igual. La instalación en nube privada y on-premises encaja con organizaciones que necesitan controles dentro de su propia nube, nube privada virtual o centro de datos. La elección adecuada depende de la política de seguridad, el diseño de red, la responsabilidad operativa y la rapidez con la que la plataforma deba conectarse a los data warehouses y pipelines existentes.
Diseñar para una responsabilidad compartida
Un data engineer necesita detalles de los incidentes y linaje. Un analytics engineer necesita entender el comportamiento de las métricas. Una parte interesada del negocio necesita un estado claro y una explicación del impacto. Un dashboard centrado en el usuario debería servir a los tres sin obligar a cada grupo a construir su propia interpretación.
Busque una implementación que incluya desde el principio los aspectos operativos básicos:
Cálculo dentro de la base de datos: los datos de origen permanecen en el entorno controlado por el cliente.
Adopción modular: empiece por la capacidad que aborda el riesgo más urgente y amplíe a medida que maduren las responsabilidades y la medición.
Planificación integrada: las evaluaciones se ejecutan de forma consistente en lugar de depender de scripts ad hoc.
Catálogo y colaboración: los hallazgos se conectan con activos, responsables, incidentes y decisiones.
Lógica comercial transparente: entender cómo influyen las tablas activas, los módulos, los entornos y el soporte en el modelo de costes.
La monitorización basada en IA puede reducir el mantenimiento manual, pero sigue necesitando gobernanza. Los equipos deben revisar las líneas base, explicar las excepciones, proteger los datos sensibles y decidir qué hallazgos bloquean el uso posterior. La automatización debe eliminar el trabajo repetitivo de detección y enrutamiento, no la responsabilidad.
Por tanto, la mejor implementación no es ni un gigantesco proyecto de redacción de reglas ni una capa opaca de machine learning. Es un sistema controlado que combina reglas de negocio explícitas, detección adaptativa de anomalías, linaje, monitorización de la puntualidad, conocimiento del esquema y responsabilidades visibles.
digna ofrece una plataforma empresarial de calidad de datos y observabilidad que se ejecuta en el entorno del cliente, con detección de anomalías, monitorización de la puntualidad, validación a nivel de registro, seguimiento de esquemas, ejecución dentro de la base de datos y dashboards compartidos para los equipos de datos y las partes interesadas. Visite digna para descubrir cómo la evaluación continua puede hacer que los datos sean más fiables para la analítica y la IA.
Las reglas cubren los fallos que se pueden prever; para los que no, digna Data Anomalies aprende el volumen, la distribución y el comportamiento normales de cada tabla y señala las desviaciones que ninguna regla escrita a mano había anticipado.
Preguntas frecuentes
¿Qué es una evaluación de la calidad de datos?
Una evaluación de la calidad de datos es un proceso basado en estándares que perfila los datos, mide las dimensiones relevantes para su uso y comprueba si sirven a un propósito operativo, analítico, regulatorio o de machine learning. Va más allá de contar errores, porque una tabla técnicamente válida puede llegar demasiado tarde o tener un significado de negocio erróneo.
¿Cuáles son las dimensiones de una evaluación de la calidad de datos?
El artículo utiliza cinco dimensiones clave: exactitud, completitud, puntualidad, consistencia y validez, a las que se añade el linaje para la trazabilidad. El linaje no es un pilar independiente, pero permite a los ingenieros rastrear una regla fallida hasta la fuente, la transformación, la tabla, el informe o el modelo afectados, de modo que la corrección se aplique en el lugar adecuado.
¿Quién definió la calidad de datos como idoneidad para el uso?
Wang y Strong definieron en 1996 la calidad de datos como idoneidad para el uso (fitness for use), desplazando el foco del recuento de errores a las necesidades de los consumidores de datos. La estandarización formal llegó cuando ISO publicó su estándar de calidad de datos en 2011, y el FMI describió públicamente en 2003 su Data Quality Assessment Framework de seis partes.
¿Cómo se realiza una evaluación de la calidad de datos paso a paso?
Empiece por perfilar la estructura, los nulos, las distribuciones y el historial de entregas, y relacione después los hallazgos con el uso previsto y sus consumidores. A continuación, fije umbrales por conjunto de datos, como límites de actualidad y tasas de nulos aceptables, priorice los fallos según su impacto en el negocio y, por último, integre las comprobaciones en el pipeline para que la evaluación se vuelva a ejecutar cada vez que cambien los datos.
¿Las comprobaciones de calidad de datos deben basarse en reglas manuales o en monitorización automatizada?
La mayoría de los equipos necesitan ambas cosas: reglas deterministas para los requisitos que siempre deben cumplirse y monitorización adaptativa para los comportamientos que nadie codificó de antemano. ITSV, la columna vertebral informática de la seguridad social austriaca, sustituyó 9.000 reglas escritas a mano por digna Data Anomalies y Data Timeliness, manteniendo una validación explícita para los requisitos de negocio críticos.



