Dimensiones de la calidad de los datos: explicación de las 9 métricas principales
|
10
minuto de lectura

La calidad de los datos se define por nueve dimensiones estándar en la DAMA-DMBOK® 2.0 Revised Edition, no por una puntuación universal. Un conjunto de datos cumple con su propósito previsto solo cuando las dimensiones relevantes, como exactitud, exhaustividad, consistencia, actualidad, integridad, timeliness, unicidad, validez y razonabilidad, satisfacen las necesidades de sus usuarios.
La parte contraintuitiva es que los datos exactos aún pueden ser inservibles. Un registro de cliente puede coincidir con la realidad pero llegar después de una decisión de campaña, o una tabla completa puede contradecir los sistemas de origen en los que confían los equipos de negocio. La calidad de los datos es la medida de qué tan bien sirven los datos para su propósito previsto, evaluada a través de múltiples dimensiones distintas en lugar de una sola puntuación.
Tabla de Contenidos
Definiendo la Calidad de los Datos en los Modern Data Stacks
Implementando el Monitoreo Continuo de la Calidad de los Datos
Definiendo la Calidad de los Datos en los Modern Data Stacks
La calidad de los datos describe si los datos son aptos para un propósito comercial, analítico, operativo o regulatorio específico. Un equipo de finanzas puede requerir datos de transacciones altamente exactos y consistentes para la presentación de informes, mientras que un equipo de operaciones puede preocuparse más por si los eventos llegan a tiempo y si cada registro requerido está presente. Ninguno de los dos equipos puede definir la calidad de manera independiente de la decisión que respaldan los datos.
Tratar la calidad como un solo número oculta estas diferencias. Una tabla de almacén de datos podría superar una revisión de exactitud mientras contiene registros faltantes, valores desactualizados, clientes duplicados o formatos inválidos. Una sola puntuación agregada también puede hacer que una falla grave desaparezca detrás de un sólido rendimiento en áreas no relacionadas.
Por qué una sola puntuación falla
La calidad de los datos es un constructo multidimensional. Las revisiones identifican la exactitud, exhaustividad, consistencia, timeliness y relevancia entre las dimensiones citadas con más frecuencia, mientras que marcos más amplios incluyen validez, unicidad, credibilidad, interpretabilidad y seguridad. La consecuencia práctica es directa: mapear cada control al modo de falla que se pretende evitar, en lugar de preguntar si un conjunto de datos es "bueno" o "malo" (repaso de las dimensiones de calidad de datos).
Para un ingeniero de datos, eso significa verificar si llegaron las cargas requeridas, si los valores se ajustan a los tipos y rangos, y si los registros concuerdan entre los sistemas. Para un analista, puede significar confirmar que una métrica tiene una definición estable y un patrón de actualización confiable. Para un propietario de negocio, la pregunta central es si los datos respaldan una decisión sin crear un riesgo inaceptable.
Regla práctica: Comience con la decisión, luego defina las dimensiones que pueden hacer que esa decisión falle.
Los entornos modernos hacen que este contexto sea más difícil de gestionar porque los datos se mueven a través de bases de datos, APIs, pipelines de ETL y ELT, almacenes de datos, tableros de control y almacenes de características de IA. Cada transferencia puede introducir un defecto diferente. Un sistema de origen puede exigir que un campo sea obligatorio mientras que una transformación posterior lo convierte en una columna que admite valores nulos, o un evento tardío puede ser técnicamente válido pero irrelevante para un tablero de control con sensibilidad temporal.
Los equipos que trabajan en almacenes de datos en la nube e integraciones empresariales también pueden beneficiarse al comprender cómo abordan los socios de implementación la arquitectura de la plataforma. Por ejemplo, la asociación de Faberwork LLC con Snowflake proporciona un contexto útil para las organizaciones que diseñan plataformas de datos donde los controles de calidad deben operar en las capas de ingesta, transformación y consumo.
El Marco de las 9 Dimensiones de la Calidad de los Datos
¿Cuáles son las 9 dimensiones de la calidad de los datos? La DAMA-DMBOK® 2.0 Revised Edition identifica nueve dimensiones estándar con un amplio consenso: Exactitud, Exhaustividad, Consistencia, Actualidad, Integridad, Timeliness, Unicidad, Validez y Razonabilidad. La revisión añade la Actualidad al conjunto anterior de ocho dimensiones y utiliza Razonabilidad en lugar de razonabilidad (detalles de la revisión DAMA-DMBOK® 2.0).
Utilice la tabla como una referencia de trabajo, no como un sustituto del contexto empresarial. Cada dimensión describe una forma diferente en que los datos pueden fallar.
Dimensión | Definición | Ejemplo Empresarial |
|---|---|---|
Exactitud | Los datos representan correctamente la entidad, evento o valor del mundo real que describen. | La dirección postal de un cliente coincide con la dirección registrada en una fuente operativa de confianza. |
Exhaustividad | Los registros, campos y valores requeridos están presentes para el uso previsto. | Cada transacción financiera aprobada incluye un identificador de cuenta, un monto y una fecha de contabilización. |
Consistencia | Los datos no entran en conflicto entre sistemas, tablas, registros o reglas de negocio definidas. | El almacén de datos y la base de datos de facturación clasifican la misma cuenta con el mismo estado de cliente. |
Actualidad | Los datos reflejan el estado actual del objeto o proceso del mundo real. | Un registro de inventario refleja la última posición de stock conocida en lugar de un estado anterior. |
Integridad | Las relaciones entre los elementos de datos siguen siendo válidas y lógicamente coherentes. | Cada línea de pedido hace referencia a un registro de pedido y producto existente a través de relaciones válidas. |
Timeliness | Los datos están disponibles dentro del período apropiado para su uso previsto. | Un cuadro de mando de riesgos recibe el flujo de transacciones requerido antes de que comience la revisión de negocio. |
Unicidad | Cada objeto del mundo real aparece solo una vez donde la duplicación distorsionaría el caso de uso. | Un maestro de clientes contiene un registro gobernado para cada entidad de cliente. |
Validez | Los valores se ajustan a su tipo, formato, rango, dominio o regla definidos. | Un estado de transacción pertenece al conjunto de estados permitidos y un monto utiliza el tipo numérico esperado. |
Razonabilidad | Los valores y las relaciones son plausibles en su contexto y no violan el comportamiento comercial esperado. | La cantidad de una venta es técnicamente válida pero se marca porque resulta inverosímil para el contexto del producto y del pedido. |
Las distinciones importan durante el diagnóstico. Un identificador de cliente faltante es un problema de exhaustividad, mientras que un identificador con un formato no válido es un problema de validez. Un cliente duplicado es un problema de unicidad, mientras que un cliente vinculado a la cuenta incorrecta puede indicar una falla de integridad o de exactitud.
Para la implementación, asocie cada dimensión con una métrica y una acción. Una verificación de exhaustividad puede contar los valores obligatorios faltantes, una verificación de unicidad puede identificar duplicados inesperados y una verificación de validez puede probar tipos de datos, formatos, clases y rangos. Los equipos que busquen medidas prácticas adicionales pueden utilizar estos ejemplos de métricas de calidad de datos como punto de partida para diseñar sus propios controles.
Cómo interactúan las dimensiones y crean compensaciones
Las dimensiones de la calidad de los datos no operan de manera independiente. Mejorar una puede hacer que otra sea más difícil de mantener, especialmente cuando los pipelines tienen ventanas de entrega fijas o una calidad de origen desigual.
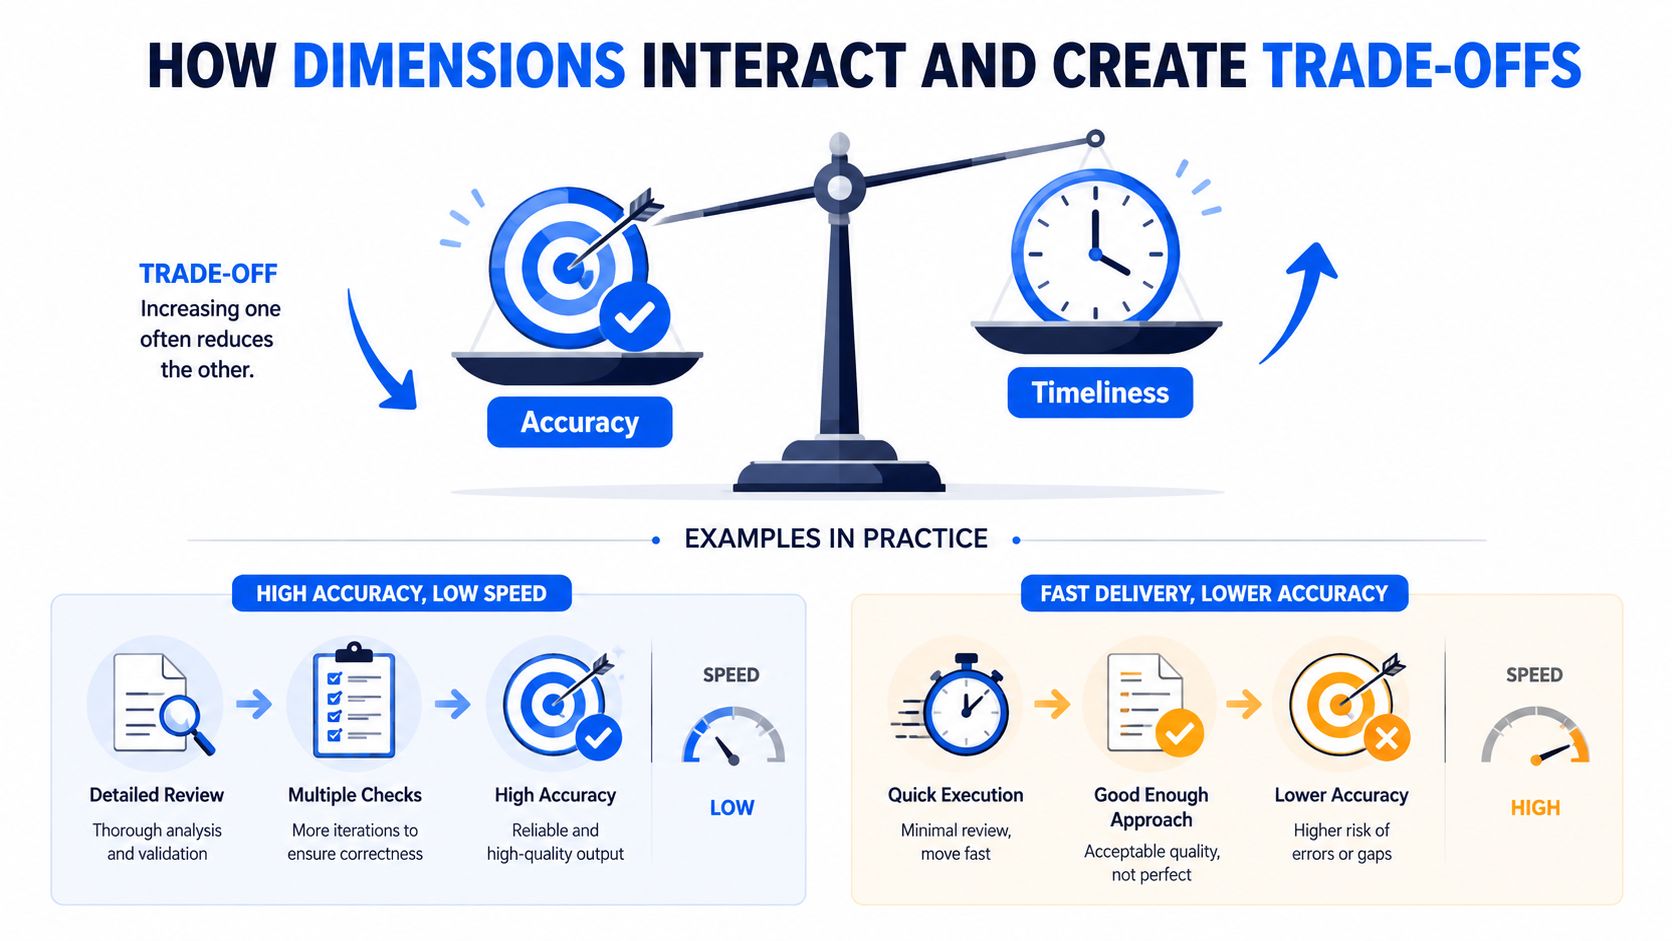
Considere una carga de almacén de datos que recibe transacciones de clientes a lo largo del día. Un equipo de ingeniería puede retrasar la publicación hasta que la conciliación resuelva las discrepancias, mejorando la exactitud y la consistencia. El retraso puede hacer que un tablero de control pierda su ventana de decisión, reduciendo la timeliness y la actualidad. Publicar de inmediato preserva la frescura pero puede exponer registros incompletos o en conflicto.
Conflictos comunes en producción
La exactitud frente a la timeliness es la compensación más clara. Un informe regulatorio puede justificar la retención de datos hasta que finalice la conciliación, mientras que un flujo de trabajo de monitoreo de fraudes puede necesitar una señal imperfecta pero inmediata. Elija en función de las consecuencias de esperar y de actuar con datos provisionales.
La validez frente a la exhaustividad puede entrar en conflicto durante la ingesta. Una regla estricta puede rechazar valores mal formados y proteger a los consumidores posteriores de datos inválidos. El rechazo puede dejar la tabla de destino incompleta a menos que el pipeline ponga en cuarentena los registros, informe de la falla y proporcione una ruta de corrección.
La consistencia frente a la autonomía de la fuente crea otra tensión. Estandarizar el estado del cliente en un CRM, una plataforma de facturación y un almacén de datos mejora la consistencia, pero cada sistema puede usar ese campo para un propósito local legítimo. Una definición canónica gobernada, combinada con atributos documentados específicos del sistema, puede funcionar mejor que forzar la uniformidad en todas partes.
Un pipeline de servicios financieros generalmente priorizará la exactitud, consistencia, exhaustividad e integridad para los informes críticos para el negocio. Un flujo de personalización de comercio electrónico puede priorizar la timeliness y la actualidad, permitiendo al mismo tiempo un enriquecimiento controlado de llegada tardía. Ningún conjunto de prioridades se aplica a todos los casos de uso.
La arquitectura también cambia la compensación. Los pipelines por lotes pueden retener una entrega completa para su conciliación, mientras que los sistemas de transmisión en tiempo real a menudo publican eventos provisionales y los corrigen más tarde. Esas correcciones requieren que los consumidores comprendan las actualizaciones, retractaciones y el estado del registro.
Un objetivo de calidad útil no es tener "datos perfectos". Consiste en tener datos lo suficientemente confiables para una decisión definida, con excepciones conocidas y propietarios responsables.
Monitoree las dimensiones por separado. Un conjunto de datos puede ser exacto pero llegar tarde, o estar completo pero ser inconsistente entre los sistemas de origen. Una sola puntuación agregada puede ocultar la falla que más importa. Las métricas separadas muestran la compensación en lugar de promediarla y diluirla.
De Reglas Estáticas a la Observability Impulsada por IA
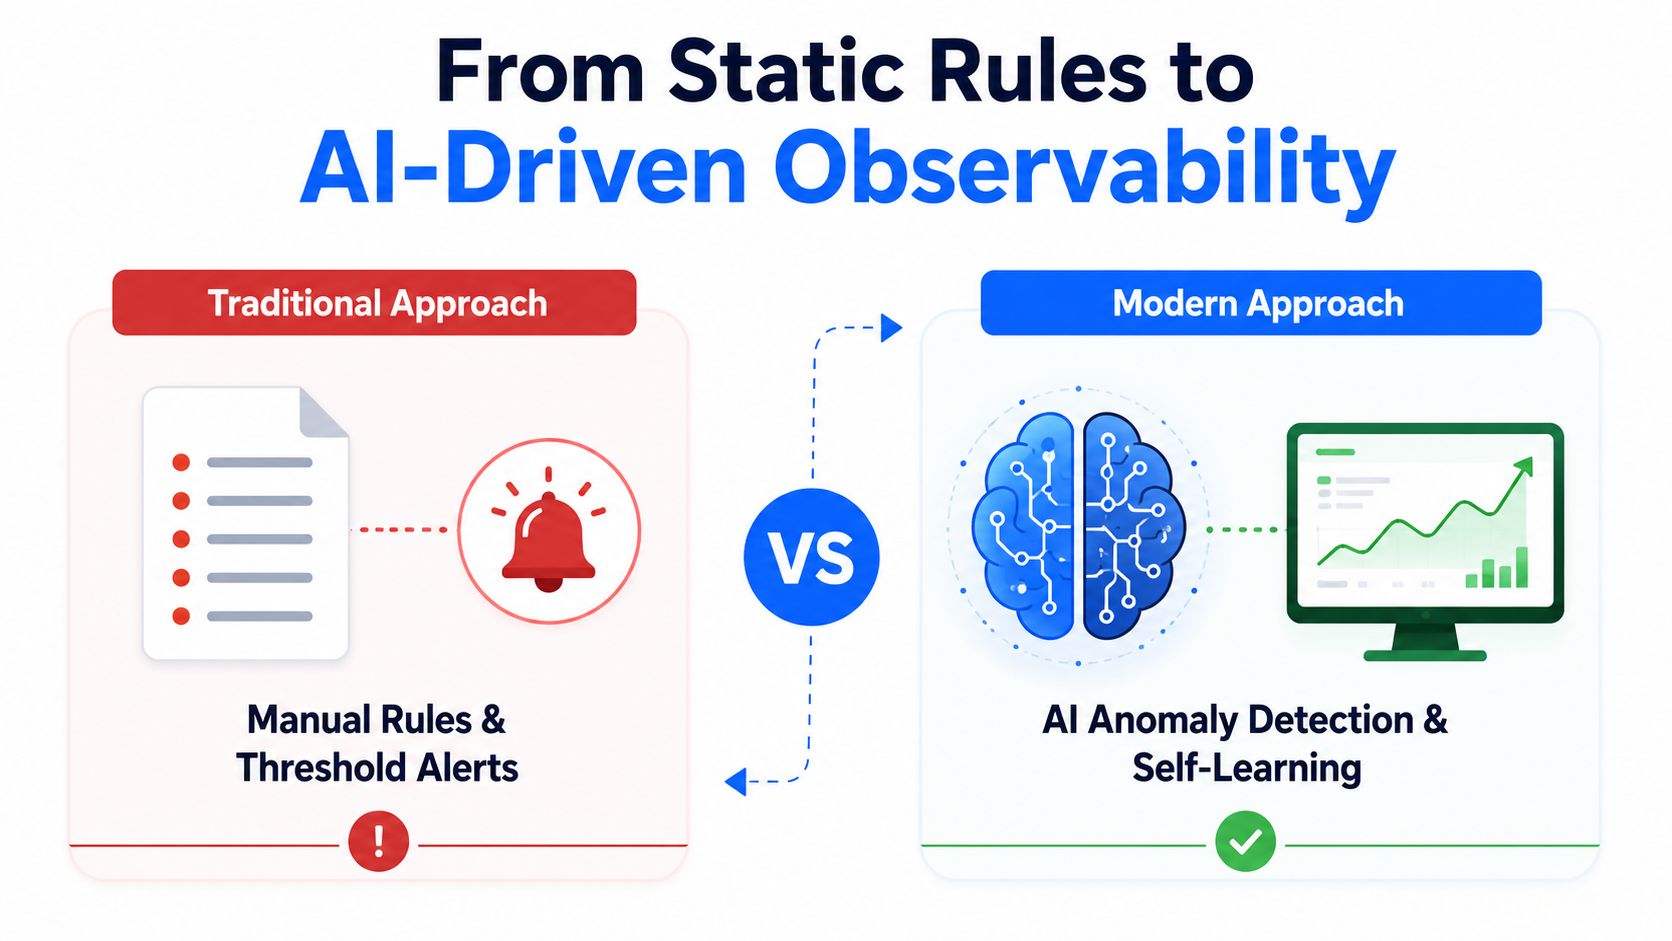
El monitoreo tradicional de la calidad de los datos depende de pruebas SQL escritas a mano, umbrales fijos y alertas configuradas para modos de falla conocidos. Estos controles siguen siendo valiosos. Una regla que requiere un identificador de cuenta no nulo o rechaza un estado inválido es explícita, auditable y fácil de explicar.
La debilidad aparece a gran escala. Los ingenieros deben mantener las reglas a medida que cambian los esquemas, las fuentes, los procesos de negocio y los rangos aceptables. Los umbrales fijos también pueden crear fatiga por alertas cuando la variación estacional o funcional normal activa advertencias repetidamente. Las verificaciones basadas en reglas detectan lo que los equipos anticiparon, pero pueden pasar por alto cambios inusuales en distribuciones, volúmenes o relaciones que nadie codificó.
Qué aporta la observability
La observability moderna combina controles deterministas con líneas de base históricas, detección de anomalías, contexto de linaje y flujos de trabajo de incidentes. En lugar de preguntar únicamente si se cruzó un umbral codificado rígidamente, la plataforma puede evaluar si el comportamiento actual difiere del patrón establecido del conjunto de datos.
Ese enfoque es especialmente útil para métricas como recuentos de filas, distribuciones de valores, comportamiento de nulos y tiempos de entrega. No elimina las reglas de negocio. Las complementa al cubrir comportamientos inesperados que la validación estática podría no anticipar. Los equipos que exploran la observability de IA también pueden revisar la explicación de la observability de IA de Doczen para obtener contexto sobre el monitoreo de sistemas relacionados con IA y el comportamiento de los datos.
El mercado también se está extendiendo más allá de las tablas estructuradas de almacenes de datos. Un estudio de la industria de 2025 informó que el 62% de las organizaciones estaban explorando datos semiestructurados, el 28% los usaban activamente y el 60% estaban evaluando documentos no estructurados (tendencias de data observability en 2025). La misma fuente reportó una madurez de la observability del 88% en América del Norte en comparación con el 47% en Europa, lo que demuestra que la adopción es desigual entre las regiones.
Los registros, documentos, flujos de eventos y corpus de IA multimodal requieren diferentes interpretaciones de exhaustividad y consistencia. Para una colección de documentos, la exhaustividad puede implicar archivos esperados, campos extraíbles o texto utilizable. Para un flujo de eventos, la timeliness puede depender de los patrones de llegada en lugar de una actualización diaria de la tabla.
Los equipos pueden utilizar la descripción general de data observability de digna para comprender cómo encaja el monitoreo continuo junto con la validación, la detección de anomalías, el seguimiento de la timeliness y el monitoreo de esquemas. Un diseño sólido mantiene reglas explícitas para requisitos conocidos y utiliza el comportamiento aprendido para identificar desviaciones que merecen ser investigadas.
Seleccionando las Dimensiones Correctas para su Caso de Uso
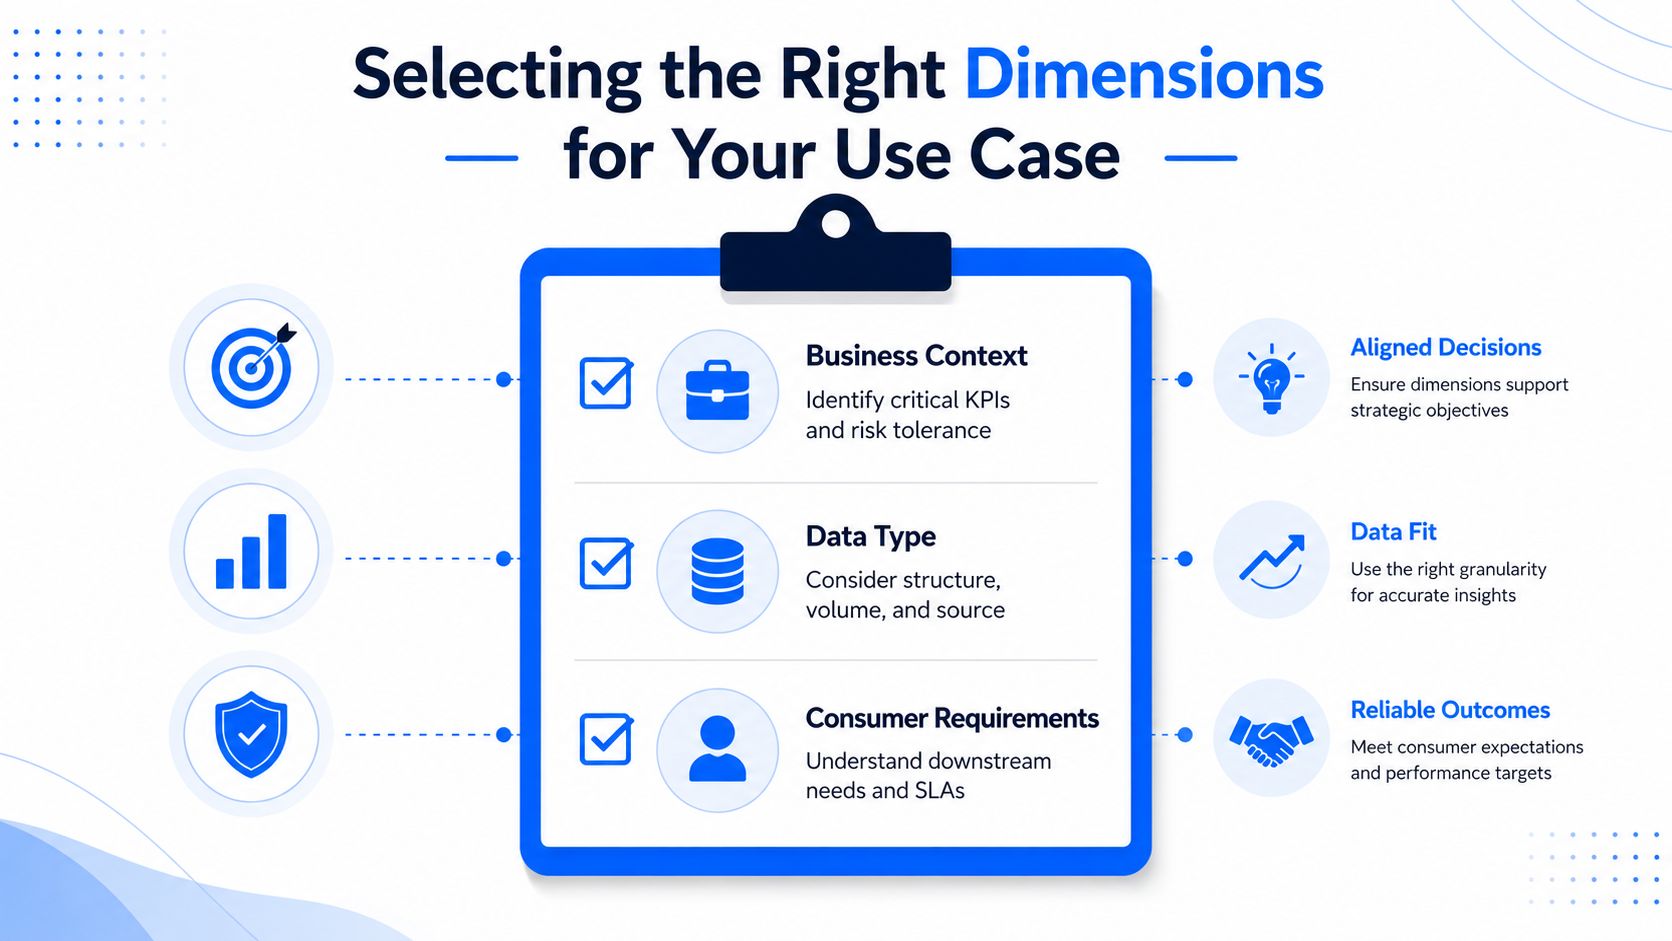
¿Cómo debería elegir un equipo entre las dimensiones de calidad de datos? Comience con la decisión de negocio, identifique los elementos de datos que influyen en ella, comprenda cómo se mueven los datos a través de la arquitectura y luego priorice los modos de falla con las mayores consecuencias operativas, regulatorias o financieras.
Una encuesta de 2025 argumenta que el campo es más amplio y específico del contexto que una lista de verificación estática. Añade dimensiones como accesibilidad, governance, reputación, portabilidad y actualidad, al tiempo que señala que la orientación práctica sobre las compensaciones y el establecimiento de prioridades sigue siendo limitada (encuesta de dimensiones de calidad de datos).
Un método práctico de priorización
Los informes regulatorios suelen comenzar con exactitud, exhaustividad, consistencia e integridad. El equipo debe identificar la fuente de registro, conciliar los totales clave, validar los valores permitidos y conservar evidencia de las excepciones. La timeliness sigue importando, pero la ventana de entrega aceptable puede estar definida por el proceso de presentación de informes en lugar de las operaciones en tiempo real.
La analítica en tiempo real da más peso a la timeliness y la actualidad. Un tablero de control que muestra las condiciones operativas actuales puede resultar engañoso cuando el flujo se retrasa, incluso si cada registro entregado es exacto. La exhaustividad y la consistencia siguen siendo importantes, especialmente cuando los usuarios comparan métricas en vivo con datos históricos del almacén de datos.
Los almacenes de características para IA y aprendizaje automático necesitan controles sólidos de validez, unicidad, timeliness e integridad. Los valores de características inválidos pueden romper las transformaciones o distorsionar las predicciones, los duplicados pueden sobreponderar entidades y las características desactualizadas pueden representar erróneamente el comportamiento actual. Las verificaciones apropiadas deben seguir las definiciones de características del modelo y las expectativas de servicio.
Los Elementos de Datos Críticos, o CDEs, merecen una cobertura más amplia que los atributos de bajo riesgo. Un CDE podría respaldar un informe regulatorio, un proceso de identidad de cliente, un cálculo financiero o una característica de un modelo. Monitoree varias dimensiones relevantes para este, asigne un propietario responsable y defina qué sucede cuando falla una verificación.
Un primer paso práctico se ve así:
Mapear al consumidor: Identifique quién usa los datos y qué decisión depende de ellos.
Rastrear la ruta: Documente la base de datos de origen, las transformaciones ETL o ELT, las tablas del almacén de datos y los productos posteriores.
Nombrar la falla: Elija dimensiones basadas en modos de falla realistas, no en una lista de verificación genérica.
Establecer la respuesta: Decida si bloquear, poner en cuarentena, advertir o registrar una excepción.
Expandir gradualmente: Comience con los elementos de datos de mayor riesgo, luego extienda el monitoreo a medida que mejoren la propiedad y la evidencia.
Para los equipos que diseñan controles medibles, las métricas de calidad de datos de digna ofrecen un punto de referencia relevante para conectar las dimensiones con las mediciones operativas.
Implementando el Monitoreo Continuo de la Calidad de los Datos
El monitoreo continuo significa que las verificaciones de calidad se ejecutan a medida que los datos se mueven y cambian, en lugar de esperar a una auditoría periódica. La distinción importa porque un flujo tardío puede afectar a un tablero de control o a un almacén de características antes de la próxima revisión programada. La timeliness es una dimensión técnica distinta porque los datos pierden valor comercial cuando no están disponibles a la hora esperada. Comúnmente se evalúa frente a los cronogramas de entrega, los umbrales de latencia o los SLAs de frescura, y se refiere a si los datos se procesan con prontitud, están actualizados y son adecuados para la tarea (investigación sobre timeliness de datos).
Un despliegue práctico puede comenzar con un dominio de base de datos o almacén de datos de alto valor. Analice su comportamiento normal, observe los patrones de entrega e identifique qué columnas y tablas respaldan los flujos de trabajo críticos para el negocio. A partir de ahí, agregue controles que coincidan con los riesgos en lugar de intentar monitorear cada objeto a la vez.
Un modelo operativo modular
Una plataforma como digna puede servir como un ejemplo de enfoque modular. El equipo puede comenzar con Data Anomalies para el aprendizaje de la línea base, luego agregar el monitoreo de Timeliness para cargas faltantes o retrasadas, Data Validation para reglas de negocio a nivel de registro y Schema Tracker para campos agregados, eliminados o modificados.
La implementación debe preservar los datos allí donde ya residen. La ejecución en la base de datos permite que la plataforma calcule métricas y ejecute análisis dentro de las bases de datos del cliente, reduciendo el movimiento innecesario y dando soporte a entornos con requisitos de seguridad estrictos. El despliegue puede realizarse en una nube privada o en las instalaciones locales (on-premises), según la infraestructura y el modelo de governance de la organización.
El monitoreo continuo también necesita contexto operativo. Un tablero de control compartido debe conectar las alertas con la tabla afectada, el pipeline, el propietario y el consumidor posterior. Las integraciones con programadores, catálogos y flujos de trabajo de colaboración ayudan a los equipos a pasar de la detección al diagnóstico sin necesidad de crear un proceso manual independiente.
La decisión de diseño más importante es la política de respuesta. Una regla de validez fallida podría bloquear un Release, mientras que una métrica inusual puede generar una alerta de investigación. Una entrega faltante puede enviar un aviso urgente a un ingeniero de guardia para un flujo crítico, pero generar una notificación de menor prioridad para un conjunto de datos no esencial. El monitoreo funciona cuando ayuda a las personas a actuar, no cuando produce un flujo de advertencias sin filtrar.
Utilice las capacidades de monitoreo de calidad de datos de digna como referencia sobre cómo se pueden combinar la detección de anomalías, la validación, la timeliness y los controles de esquema en un modelo operativo continuo.
Construyendo su Estrategia de Calidad de Datos
La gestión de la calidad de los datos es la práctica continua de definir, medir, monitorear y mejorar la calidad de los datos en toda una organización. Combina controles técnicos con propiedad, definiciones de negocio, respuesta a incidentes y governance.
Una hoja de ruta práctica es:
Auditar el estado actual: Analice las bases de datos prioritarias, las tablas del almacén de datos, los pipelines y los informes posteriores.
Identificar los CDEs: Marque los elementos de datos cuya falla podría afectar el cumplimiento regulatorio, los ingresos, las operaciones, los clientes o los resultados de la IA.
Priorizar las dimensiones: Seleccione las dimensiones que coincidan con el caso de uso y el riesgo de cada CDE.
Implementar el monitoreo: Combine la validación explícita con el monitoreo de anomalías, timeliness y esquemas.
Revisar y mejorar: Utilice los incidentes y los comentarios de las partes interesadas para refinar las reglas, los umbrales, la propiedad y la cobertura.
La lección central es simple: la calidad es multidimensional, priorizada y continua. Las reglas manuales siguen teniendo su lugar, pero necesitan contexto, propiedad y un monitoreo capaz de detectar tanto las violaciones conocidas como el comportamiento inesperado.
digna proporciona una plataforma empresarial de calidad y Data Observability para monitorear el comportamiento de los datos, validar registros, rastrear la timeliness, detectar cambios de esquema y analizar métricas de negocio y de plataforma dentro del propio entorno del cliente. Visite digna para explorar un enfoque modular para el monitoreo continuo en almacenes, lagos de datos, bases de datos y pipelines.


