Conjunto de control de calidad: guía práctica de diseño
|
8
minuto de lectura

Tu panel se ve bien hasta que finanzas cierra el mes y pregunta por qué los ingresos están sobrevalorados. La pipeline no se cayó. El almacén no se vino abajo. Un paso de transformación descartó filas con customer_id nulo, y todos los agregados posteriores siguieron avanzando como si nada.
Ese tipo de fallo es la razón por la que los equipos necesitan más que pruebas dispersas y correos de alerta. Necesitan un conjunto de datos de control de calidad que actúe como memoria operativa de la pipeline: qué se comprobó, cómo es «lo normal», qué cambió, quién responde del problema y cómo distinguir un incidente real del ruido.
Muchos equipos ya saben que deberían validar los datos. La pregunta difícil es dónde invertir el esfuerzo. Algunos conjuntos necesitan seguimiento continuo de esquema y umbrales de frescura. Otros necesitan unas pocas reglas de negocio estrictas y revisión manual ocasional. Tratar todas las tablas igual suele generar proliferación de reglas, fatiga de alertas y puntos ciegos justo donde más importan.
Tabla de contenidos
Ejemplos reales de conjuntos de control de calidad en la práctica
Cómo diseñar un conjunto de control de calidad para tus pipelines
Elegir el enfoque de monitorización adecuado para cada conjunto
Ideas erróneas frecuentes que minan los programas de calidad
Qué es realmente un conjunto de datos de control de calidad
Un conjunto de control de calidad suele aparecer tras un incidente doloroso. Un patrón común es un panel financiero que informa ingresos muy por encima de los reales porque los registros aguas arriba se filtraron mal, se duplicaron o se cargaron parcialmente. Nadie lo nota al ingerir porque la pipeline sigue «terminando bien».
Un conjunto de datos de control de calidad es el registro estructurado y consultable de cómo detectas y diagnosticas ese tipo de fallo. No es solo una tabla de resultados de pruebas. Contiene los controles alrededor de los datos: reglas de validación, líneas base esperadas, registros muestreados que conviene inspeccionar y metadatos de auditoría que dicen qué ocurrió y cuándo.
Dónde encaja en el stack
Los equipos lo confunden a menudo con artefactos vecinos.
No son registros de validación en bruto. Los registros te dicen que una comprobación se ejecutó. Normalmente no conservan contexto suficiente para comparar el comportamiento histórico o investigar la deriva.
No es un catálogo de datos. Un catálogo dice qué es un conjunto, quién lo posee y quizá de dónde salió. No suele guardar historial de aprobados y fallos ni evidencia de anomalías.
No es un fixture de pruebas. Los fixtures ayudan a verificar transformaciones en condiciones controladas. Un conjunto de control de calidad vive junto a la operación de producción y evoluciona con ella.
La forma más limpia de pensarlo es así: la pipeline produce datos de negocio, y el conjunto de control de calidad produce evidencia sobre la fiabilidad de esos datos.
Regla práctica: si tu equipo no puede responder «qué cambió, cuándo empezó y fue una violación de regla o un desplazamiento de comportamiento» desde un único sitio, seguramente aún no tienes un conjunto de control de calidad de verdad.
Por qué tiene que mantenerse vivo
Esto no es un entregable de gobernanza puntual. Es un activo operativo vivo. El trabajo normativo ha empujado la calidad de datos hacia características explícitas y controles medibles. ISO/IEC 25012 e ISO/IEC 25024 establecieron tanto un modelo general de calidad como medidas cuantitativas, y por eso los equipos modernos separan cada vez más «describir los datos» de «medir la calidad».
Esa distinción importa en producción. Los datos cambian de forma. Los sistemas aguas arriba renombran campos. La latencia de origen se desplaza tras el despliegue de un proveedor. Un conjunto de control de calidad útil tiene que absorber esos cambios en vez de fosilizarse tras la primera implementación.
Si necesitas una base concisa de la disciplina general, esta panorámica de la calidad de datos es buena compañera del modelo operativo descrito aquí.
Componentes esenciales de un conjunto de control de calidad
Un conjunto de control de calidad se vuelve útil cuando separa detección de diagnóstico. La detección te dice que algo va mal. El diagnóstico te dice por qué, dónde y quién debe actuar. La mayoría de implementaciones fallidas solo hacen la primera parte.
Los cinco componentes que importan
Todo diseño operativo en el que confío contiene cinco capas.
Componente | Propósito | Almacenamiento típico |
|---|---|---|
Capa de metadatos | Identifica responsable, SLA, puntero de linaje, criticidad y ruta de escalada | Tabla de catálogo, esquema de control, almacén de gobernanza |
Reglas de validación | Imponen restricciones de esquema, nulabilidad, lógica de negocio y formatos aceptados | Código versionado más tabla de reglas |
Líneas base estadísticas | Capturan el comportamiento esperado: distribuciones, patrones de nulos, volumen y cardinalidad | Tablas de métricas en el almacén o en la capa de observabilidad |
Muestras de referencia | Conservan registros dorados, casos límite y ejemplos malos conocidos para revisión | Tablas de muestras dedicadas o conjuntos de revisión curados |
Pistas de auditoría | Guardan resultados con marca de tiempo, deltas de deriva, incidentes y notas de resolución | Tablas de historial de QC, sistema de incidentes, capa de observabilidad |
Qué hace cada capa
La capa de metadatos ancla la propiedad. Si una comprobación falla y nadie sabe quién posee el conjunto ni qué proceso posterior depende de él, la alerta tiene poco valor.
La capa de reglas de validación caza los fallos deterministas. Violaciones de clave primaria, transiciones de estado ilegales, formatos de fecha rotos y valores imposibles van aquí. Aquí también empieza a importar la lógica consciente del esquema, sobre todo con estructuras anidadas o cambiantes. Entender los distintos tipos de esquema y patrones de cambio ayuda a evitar reglas frágiles que se rompen cada vez que un sistema de origen añade un campo.
La capa de líneas base estadísticas caza comportamientos que aún pasan las reglas duras pero ya no son normales. Una tabla puede ser válida y aun así sospechosa si la distribución de categorías oscila de forma inesperada, los duplicados suben o un origen llega más tarde de lo habitual.
Por qué faltar un componente debilita a los demás
Las muestras de referencia y las pistas de auditoría son donde muchos programas recortan. Eso suele salir caro.
Sin muestras de referencia, los ingenieros no pueden inspeccionar rápido casos límite ni comparar los registros malos de hoy con patrones de fallo ya conocidos.
Sin pistas de auditoría, cada incidente empieza de cero. Los equipos pierden el historial de cuándo empezó la deriva, si el mismo problema ha vuelto y si ajustar umbrales mejoró o empeoró las cosas.
Una comprobación que solo dice «falló» apenas mejora no tener comprobación. Quien opera necesita evidencia, no solo estado.
Las mejores implementaciones tratan el conjunto de control de calidad como un pequeño modelo operativo de la propia pipeline: reglas, métricas, ejemplos e historial en un único lugar consultable.
Dimensiones de calidad clave que debes monitorizar
Un solo validador no cubre los modos de fallo en producción. La calidad se rompe por ejes distintos, y cada eje necesita su propia lógica de control.
Las guías independientes de QC de conjuntos tratan exactitud, completitud, consistencia, unicidad y Timeliness como dimensiones de control separadas, porque un conjunto puede estar completo y ser erróneo, estar al día y ser inconsistente, o mantenerse estructuralmente intacto y estar rancio. Esa misma guía recomienda combinar comprobaciones deterministas con revisión estadística de anomalías, ausencias y estabilidad de esquema, porque muchos fallos aparecen primero como desplazamientos de frecuencias o de latencia y no como defectos evidentes a nivel de fila, como expone esta guía de comprobaciones de calidad de conjuntos de datos.

Seis dimensiones, seis modos de fallo
Exactitud significa que el valor coincide con la realidad o con una fuente fiable. Aquí van las conciliaciones contra totales contables, sistemas de verdad o datos de referencia aprobados.
Completitud pregunta si están presentes los registros y campos requeridos. Picos de nulos, cargas parciales y particiones ausentes suelen aparecer aquí primero.
Consistencia comprueba si la misma entidad de negocio se representa igual entre sistemas. Códigos de divisa discordantes y etiquetas de estado contradictorias son ejemplos habituales.
Unicidad protege del doble conteo y de las colisiones de identidad. Eventos duplicados e identificadores de transacción repetidos pueden corromper los informes.
Validez impone expectativas de formato y dominio. Un campo puede estar presente y ser único y aun así ser inválido si viola reglas de patrón, rango o valores enumerados.
Timeliness comprueba si los datos llegaron cuando el negocio lo espera. Un conjunto técnicamente correcto puede seguir siendo inservible si llega demasiado tarde para informes o decisiones.
La Timeliness necesita un umbral real
La frescura es donde la monitorización vaga suele fallar. Un modelo práctico se basa en umbrales: compara la marca de tiempo más reciente del conjunto con la hora actual y alerta cuando la diferencia supera el SLA definido. Un ejemplo de observabilidad de datos lo describe como una comprobación de frescura en la que una tabla horaria incumple si el retraso supera su umbral permitido.
Eso es mucho más útil que llamar a algo «tardío» sin un reloj asociado.
Si quieres una referencia aparte sobre cómo esas dimensiones se traducen en comprobaciones operativas, conviene tener a mano esta guía de dimensiones de la calidad de datos.
Ejemplos reales de conjuntos de control de calidad en la práctica
La forma más fácil de entender un conjunto de control de calidad es mirar qué guarda cuando los equipos lo usan como activo vivo en lugar de como lista estática.
Patrones de ejemplo desde producción
Ejemplo | Dimensión de calidad | Artefactos guardados | Señal operativa |
|---|---|---|---|
Revisión de un conjunto de entrenamiento anotado | Exactitud | Procedencia de etiquetas, identificadores de revisores, marcas de desacuerdo, estado de consenso, revisiones expertas muestreadas | Deriva sistemática de quienes etiquetan o clases ambiguas |
Alimentación de un registro de esquemas de eventos | Validez e integridad de esquema | Cambios de columnas, marcas de tiempo, autor, notas de compatibilidad, instantánea de esquema previa | Renombrado de campo que rompe, cambio de tipo o deriva silenciosa |
Panel de SLA de frescura | Timeliness | Ventanas de llegada esperadas, tiempos reales de ingesta, historial de incumplimientos, estado del origen | Retraso crónico, cargas perdidas, entrega inestable del origen |
Los datos etiquetados necesitan su propio registro de QC
Los conjuntos anotados son un ejemplo potente porque los equipos suelen suponer que las etiquetas están «acabadas» al terminar la curación. No lo están. Un artículo de NeurIPS informó una tasa media de error de etiquetas del 3,4 % en los conjuntos de evaluación de diez conjuntos de referencia, suficiente para afectar a la selección de modelos y al ranking de benchmarks, según el artículo de conjuntos y benchmarks de NeurIPS.
Por eso los buenos conjuntos de control de calidad para datos etiquetados registran la procedencia de los revisores, el número de desacuerdos, las revisiones expertas muestreadas y los criterios de aceptación por nivel de riesgo. El mismo artículo menciona flujos que revisan de nuevo el 10-20 % de los datos para mejorar el acuerdo en contextos de mayor riesgo.
Cuando las etiquetas dirigen el comportamiento del modelo, el desacuerdo no es ruido que esconder. Es una señal de calidad que guardar e investigar.
El historial de esquema debería ser consultable
En flujos de eventos y tablas compartidas del almacén, la deriva de esquema suele ser el incidente previo al incidente. Un productor renombra un campo. Una transformación posterior sigue ejecutándose pero empieza a devolver nulos. Un panel se rompe más tarde, lejos de la causa raíz.
Un conjunto de control de calidad útil guarda instantáneas de esquema a lo largo del tiempo, además de quién cambió qué y si el cambio era retrocompatible. Eso convierte «ayer se rompió algo» en una consulta: ¿qué cambió aguas arriba antes de la rotura?
La frescura merece su propio artefacto
La monitorización de Timeliness también funciona mejor con un conjunto dedicado detrás. En lugar de una alerta binaria, guarda las ventanas de llegada esperadas, las marcas de llegada reales y el historial de incumplimientos por origen. Eso permite separar retrasos puntuales de inestabilidad crónica del origen y ajustar la escalada según el impacto.
Cómo diseñar un conjunto de control de calidad para tus pipelines
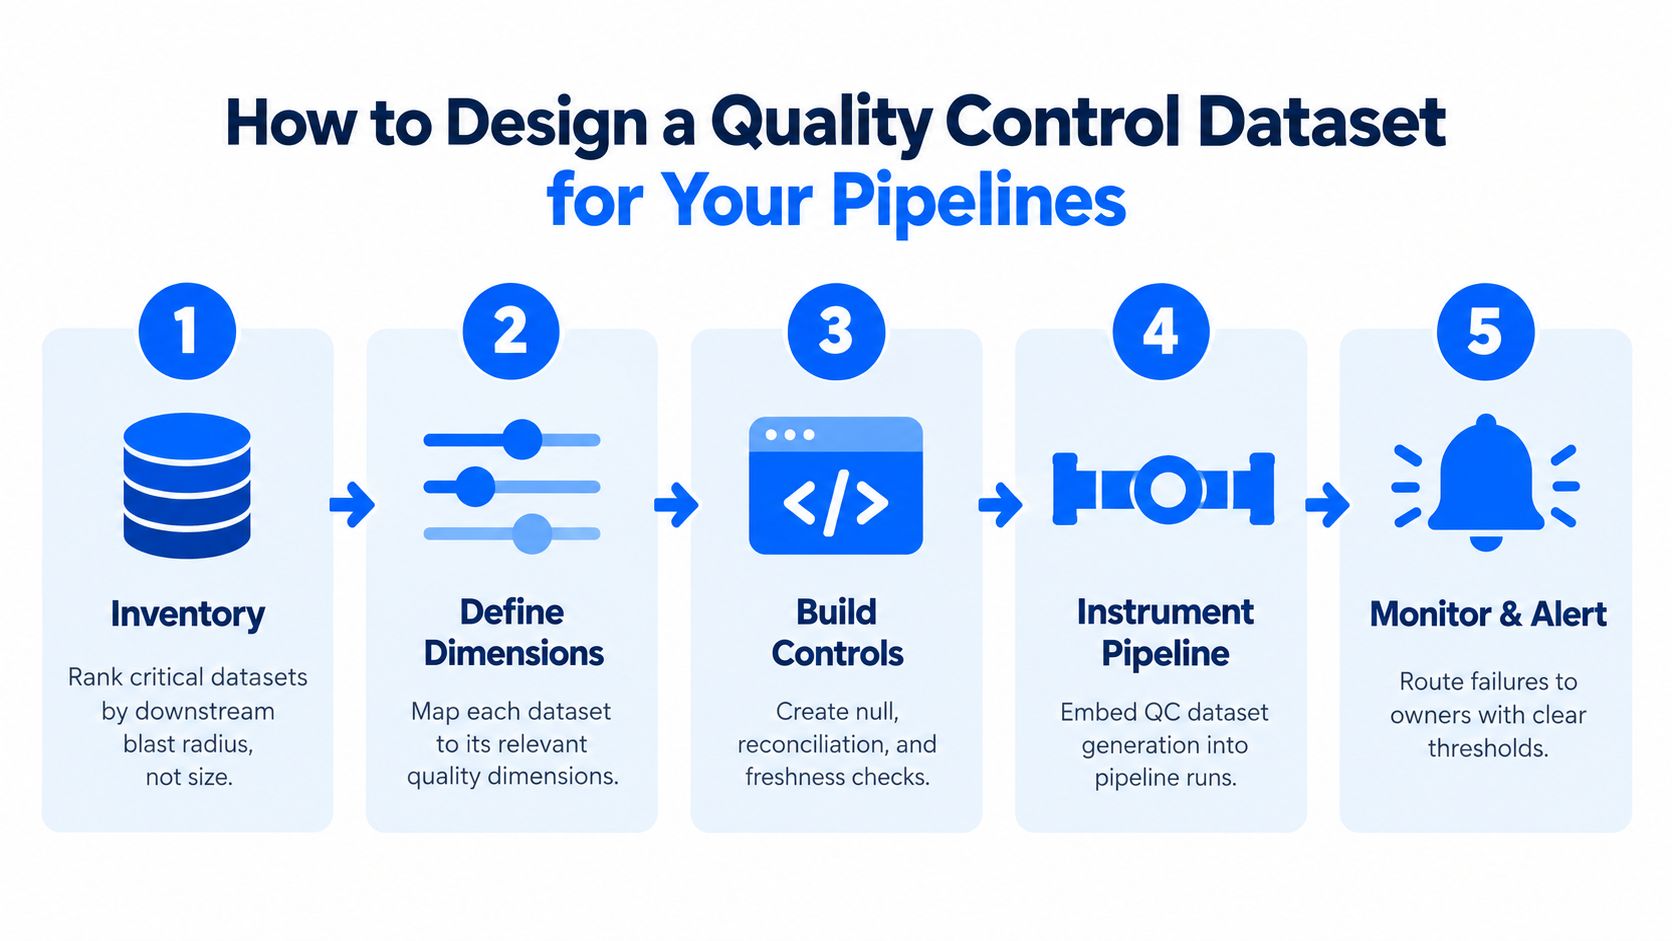
Los equipos suelen diseñarlo al revés. Empiezan con una herramienta, generan todas las comprobaciones que se les ocurren y luego se ahogan en alertas. La mejor secuencia empieza por el impacto de negocio.
Empieza por el radio de impacto, no por el número de conjuntos
Inventaría tus conjuntos críticos y ordénalos por las consecuencias posteriores si se estropean. El reconocimiento de ingresos, los informes regulatorios, los paneles de dirección y las características de modelo usadas en decisiones de producción están por encima de las tablas de análisis puntual.
Define para cada nivel qué dimensiones importan más y qué constituye aviso frente a incumplimiento. No asignes el mismo estándar a todos. Una tabla de dimensión de referencia puede necesitar validez estricta y revisión manual ocasional. Un flujo de eventos de clientes puede necesitar monitorización continua de unicidad, esquema y Timeliness.
Ajusta el control al modo de fallo
Usa estrategias de validación distintas para dimensiones distintas.
Las reglas deterministas funcionan mejor para conformidad de esquema, nulabilidad, rangos aceptados y lógica de negocio.
Las líneas base estadísticas funcionan mejor para volumen, cambios de distribución, oscilaciones de cardinalidad y ausencias inusuales.
La revisión de anomalías ayuda cuando el comportamiento cambia pero la regla exacta no puede especificarse del todo por adelantado.
Guarda las reglas como código siempre que puedas. La regla debería versionarse con la lógica de transformación que protege. Además, ata cada regla a un identificador de conjunto, un responsable y una ruta de escalada. Un control que falla sin propiedad se convierte en un fantasma de Slack que todos ignoran.
Emite los resultados al propio conjunto de QC
El conjunto de control de calidad no debería limitarse a definir comprobaciones. También debería guardar los resultados de esas comprobaciones.
Como mínimo, registra:
Contexto de ejecución: identificador de ejecución de la pipeline, nombre del conjunto, entorno, marca de tiempo
Resultado del control: aprobado, aviso, fallo, omitido
Evidencia: filas infractoras, métricas resumen, deltas de deriva o diferencia de esquema
Metadatos operativos: responsable, severidad, enlace al ticket, nota de resolución
Una plataforma puede ayudar si encaja en tu entorno. Por ejemplo, el enfoque de digna sobre validación de datos y comprobaciones continuas de calidad alinea las validaciones deterministas con la monitorización continua en vez de tratarlas como programas separados.
Mantén la gobernanza pegada a la operación
Un conjunto de control de calidad sobrevive a la rotación de personal solo si alguien lo mantiene. Añade una cadencia de revisión, criterios de retirada para reglas obsoletas y un bucle de retroalimentación tras los incidentes. Si una comprobación salta constantemente sin resultados accionables, revísala o quítala. Si un incidente se coló, convierte esa lección en un control o una línea base nueva.
Hábito operativo: todo incidente de datos relevante debería terminar con una pregunta: ¿qué debería recordar el conjunto de control de calidad para que esto sea más fácil de detectar la próxima vez?
Elegir el enfoque de monitorización adecuado para cada conjunto
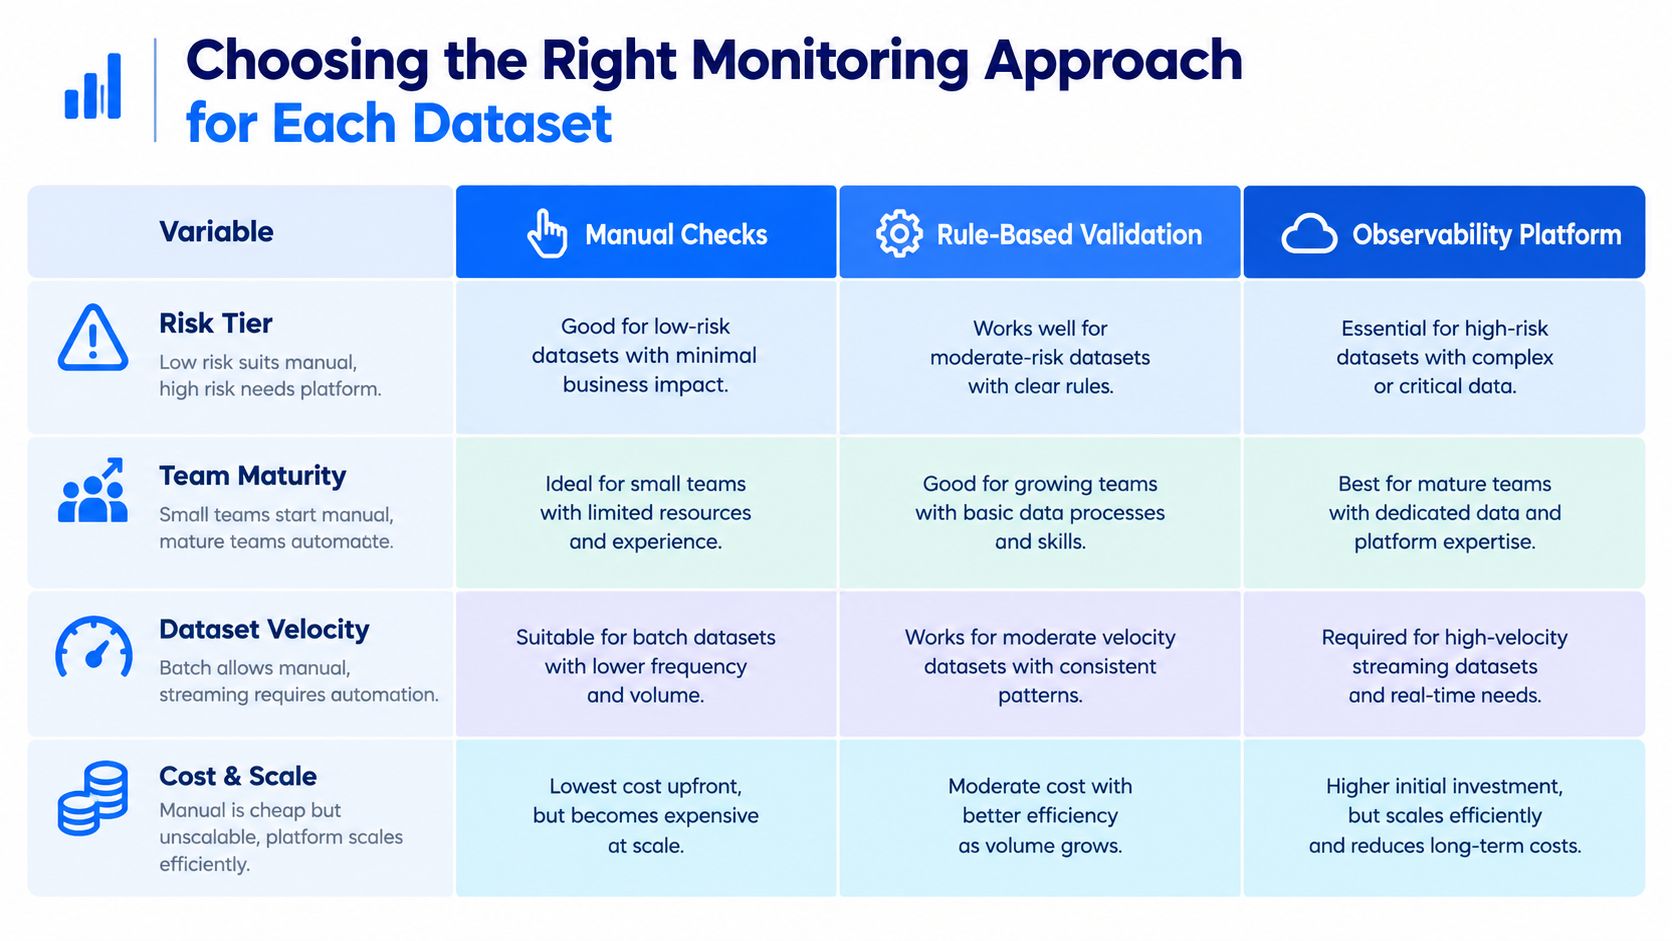
La estrategia de monitorización no es una escalera de madurez. Es una decisión de triaje. La respuesta correcta depende del riesgo, la velocidad y lo caro que salga fallar.
Un informe reciente del sector halló que el 61 % de las organizaciones sigue dependiendo de comprobaciones manuales o validación con SQL, el 27 % usa una plataforma de observabilidad dedicada y el 31 % cita la visibilidad limitada de la salud de las pipelines como mayor reto, según el informe de tendencias 2025 de calidad y observabilidad de datos de Integrate.io. Encaja con lo que viven muchos equipos. El problema no suele ser si el QC importa. Es decidir dónde compensa automatizar.
Cuándo encaja cada enfoque
Las comprobaciones manuales siguen teniendo sentido para datos de referencia de bajo volumen, correspondencias legales y flujos donde el juicio humano pesa más que la velocidad. Se rompen en cuanto los datos cambian a menudo o los incidentes requieren respuesta rápida.
La validación basada en reglas cubre buena parte de las pipelines importantes. Funciona bien cuando el negocio puede definir restricciones claras y el equipo de ingeniería mantiene las reglas cerca del código de transformación.
Las plataformas de observabilidad se ganan su sitio en sistemas de alta velocidad, multiorigen y gran radio de impacto. Ahí necesitas líneas base, monitorización de frescura, seguimiento de esquema, contexto de linaje y alertas centralizadas.
Señales de escalada que vigilar
Sube un conjunto en la pila de monitorización cuando veas patrones como estos:
Falsos positivos al alza: los umbrales son demasiado frágiles para el comportamiento actual
Apagafuegos manual frecuente: los ingenieros dedican demasiado tiempo a investigar problemas recurrentes
Quejas por datos rancios: las partes interesadas pierden confianza porque el equipo detecta el retraso demasiado tarde
Propiedad entre varios equipos: los fallos cruzan fronteras de productor y consumidor y necesitan contexto compartido
Para equipos que evalúan opciones de observabilidad, esta panorámica de la observabilidad de datos resulta útil porque plantea el problema en torno a la visibilidad operativa y no a la monitorización genérica.
Ideas erróneas frecuentes que minan los programas de calidad
La mayoría de los programas débiles no fracasan porque los equipos no se preocupen. Fracasan porque las suposiciones de partida son erróneas.
Las suposiciones que causan problemas
Idea errónea | Realidad operativa | Acción correctiva |
|---|---|---|
Más reglas siempre mejoran la calidad | La proliferación de reglas crea ruido y oculta fallos importantes | Priorizar controles por riesgo y capacidad de acción |
Con una curación puntual basta | El comportamiento de los datos cambia con orígenes, esquemas y usos | Revisar umbrales y líneas base de forma programada |
La observabilidad sustituye a la gobernanza | Las herramientas sacan a la luz incidentes pero no asignan propiedad | Definir responsables, severidad y rutas de remediación |
Los conjuntos de QC son solo para ML | Analítica, finanzas y pipelines regulatorias sufren los mismos patrones de fallo | Aplicar el modelo en todos los dominios de datos operativos |
La calidad es solo del equipo de datos | Productores y responsables de negocio definen muchas expectativas críticas | Compartir la propiedad por conjunto y tipo de control |
Por qué persisten estas creencias
«Añadir más reglas» suena seguro porque parece concreto. En la práctica, demasiadas comprobaciones de poco valor entierran el puñado que protege el negocio. Los equipos dejan de fiarse de las alertas y los incidentes reales se funden con el ruido de fondo.
«Una limpieza puntual» es otra trampa. La sola evolución de esquema hace decaer los controles estáticos. En entornos operativos, el seguimiento de esquema tiene que ser continuo. La documentación de digna, por ejemplo, describe monitorización continua de esquemas de tablas, columnas y tipos de datos con comparaciones frente a instantáneas previas y alertas por panel, API, correo, Slack o webhooks. Ese es el modelo mental correcto aunque uses otra herramienta.
Qué funciona en su lugar
El patrón duradero es más estrecho y más estricto.
Elige menos comprobaciones con responsables claros.
Refresca las líneas base cuando cambie el comportamiento del origen.
Trata los incidentes como entrada para el diseño de controles.
Guarda la evidencia en el conjunto de QC, no enterrada en hilos de chat.
Un programa de calidad se vuelve creíble cuando quien opera puede decir qué fallos importan, quién responde y cómo aprende el sistema del incidente.
Juntarlo todo y siguientes pasos
Un modelo operativo viable tiene cuatro capas. Empieza por las dimensiones de calidad que importan para cada conjunto. Respalda esas dimensiones con componentes estructurales como reglas, líneas base, muestras e historial de auditoría. Elige un enfoque de monitorización acorde al riesgo y al ritmo de cambio del conjunto. Después cierra el bucle convirtiendo los incidentes en actualizaciones de umbrales, reglas nuevas o comprobaciones retiradas.
Suena más pesado de lo que es. En un sprint, un equipo puede inventariar los conjuntos críticos, ordenarlos por impacto posterior, definir un pequeño conjunto de controles para cada uno y encaminar los fallos a los canales de incidentes existentes. Empieza primero por comprobaciones deterministas. Añade líneas base estadísticas cuando el equipo tenga suficiente historial para saber cómo es lo normal.

El primer paso no tiene por qué ser ambicioso. Elige tres conjuntos esta semana. Para cada uno, anota un responsable, una expectativa de completitud y un umbral de frescura. La dirección actual de la comunidad de datos federal estadounidense es una señal útil: el informe de 2025 de la American Statistical Association sostiene que las agencias deberían ofrecer métricas de calidad fácilmente disponibles, preservar datos históricos y metadatos, y estandarizar citas e identificadores, como describe el informe The Nation's Data at Risk 2025. Es la misma disciplina operativa que necesitan los buenos equipos de datos del sector privado.
Los equipos que mejoran más rápido no intentan monitorizarlo todo a la vez. Hacen medible un conjunto crítico y luego repiten el patrón.
digna da a los equipos una forma de ejecutar calidad y observabilidad de datos dentro de su propio entorno, con ejecución dentro de la base de datos para que el SQL de monitorización corra en el almacén y solo se guarden resultados y metadatos en la capa de observabilidad, como se describe en las prácticas de pipelines de datos de digna. Si estás construyendo un conjunto de control de calidad y necesitas seguimiento de esquema, monitorización de Timeliness, validación y detección de anomalías sin mover datos de producción sensibles, visita digna.
Un conjunto de QC registra lo que encontraron tus comprobaciones; la observabilidad de la plataforma de datos es lo que mantiene esas comprobaciones en marcha y hace que se note cuando se paran.
Preguntas frecuentes
¿Qué es un conjunto de datos de control de calidad?
Un conjunto vivo que registra los resultados de tus comprobaciones de calidad, situado junto a las pipelines que vigila y no dentro de ellas. Tiene que seguir vivo porque un registro de QC rancio describe un sistema que ya no existe, lo cual es peor que no tener ninguno.
¿Cuáles son sus componentes esenciales?
Cinco: las propias comprobaciones, los resultados que emiten, el historial de esquema, el registro de frescura y los metadatos de gobernanza que atan cada control a un responsable. Quita uno y los demás se debilitan: los resultados sin historial de esquema, por ejemplo, no pueden explicar por qué una comprobación empezó a fallar.
¿Qué dimensiones de calidad debería monitorizar?
Seis dimensiones se corresponden con seis modos de fallo distintos, y la Timeliness es la que necesita un umbral real en vez de una noción vaga de «reciente». Un flujo técnicamente presente pero cuatro horas pasada su ventana de decisión ya ha fallado, aunque todos sus valores sean correctos.
¿Cómo se decide qué conjuntos cubrir?
Empieza por el radio de impacto, no por el número de conjuntos. Una tabla que alimenta informes regulatorios o una cifra de cara al cliente merece controles antes que una tabla que nadie consulta, por grande que sea. Después ajusta el control al modo de fallo en vez de aplicar las mismas comprobaciones genéricas en todas partes.
¿Qué ideas erróneas minan estos programas?
La creencia de que una pipeline que termina bien significa datos correctos, y que más comprobaciones equivalen a más cobertura. El ejemplo inicial lo demuestra: una transformación descartó en silencio filas con customer_id nulo y todos los agregados posteriores siguieron avanzando como si nada hubiera pasado.



