¿Cómo se validan los datos? Guía para pipelines modernos
|
8
minuto de lectura

Probablemente se lo pregunte porque algo ya se ha roto. Una cifra de un dashboard se disparó de la noche a la mañana, un modelo empezó a producir resultados extraños o una conciliación falló y nadie confía en el pipeline hasta que alguien revisa los logs. Ese es el contexto real detrás de la pregunta cómo se validan los datos. No es académica. Es operativa.
Una buena validación no consiste en añadir unas cuantas comprobaciones de nulos y darlo por terminado. Consiste en decidir qué debe cumplirse a nivel de registro, qué debe mantenerse estable a lo largo del pipeline, qué puede variar sin riesgo y qué debe detener la línea de inmediato. En los stacks modernos, eso también implica protegerse de problemas que las guías básicas ignoran, especialmente la deriva silenciosa del esquema y el coste de imponer en exceso reglas que no importan al negocio.
Índice
Por qué la validación de datos es más que marcar casillas
Un dashboard de ingresos rara vez falla porque un ingeniero olvidara una comprobación. Falla porque los equipos tratan la validación como un paso de limpieza puntual en lugar de como parte del diseño del pipeline. Cuando alguien se da cuenta de que las cifras son incorrectas, los datos erróneos ya han pasado por transformaciones, joins, modelos de BI e informes aguas abajo.
Por eso la validación de datos debe estar en varios puntos de control, no solo en el resultado final. El patrón más sólido es priorizar la prevención. Las reglas de validación deben detectar los problemas donde los datos entran en el sistema y, de nuevo, después de los pasos de transformación en los que la lógica puede introducir nuevos errores. La introducción de Great Expectations a la validación de pipelines lo deja claro al hacer hincapié en la validación en la ingesta y después de cada transformación, junto con una documentación repetible para la auditabilidad.
La confianza es el verdadero resultado
Las organizaciones dicen que quieren datos limpios. Lo que realmente quieren son decisiones fiables. Si el departamento financiero tiene que cuestionar cada informe, si los analistas tienen que inspeccionar manualmente cada actualización o si los ingenieros de ML no confían en los datos de entrenamiento, la plataforma funciona técnicamente, pero falla a nivel operativo.
La validación protege la confianza de varias formas concretas:
Bloquea entradas erróneas conocidas: los campos obligatorios, los formatos válidos y las reglas de negocio detienen pronto los defectos evidentes.
Acota el alcance de los incidentes: cuando las comprobaciones se ejecutan en cada punto crítico, los equipos saben dónde entró el problema.
Hace que los fallos sean accionables: una regla fallida es más útil que una queja vaga del tipo «el dashboard se ve mal».
Facilita el cumplimiento normativo: una validación repetible y unos metadatos publicados dan a los equipos un proceso auditable.
Regla práctica: no valide los datos solo en función de lo que ha visto antes. Valídelos frente a lo que el negocio dice que debe cumplirse.
La limpieza reactiva llega demasiado tarde
Muchos equipos siguen dependiendo de la limpieza aguas abajo. Parece práctico hasta que un campo erróneo ya se ha agregado en los informes o se ha enviado a sistemas de cara al cliente. Limpiar a posteriori es más lento, más caro y más difícil de auditar.
Un modelo operativo mejor es el siguiente:
Defina las expectativas de negocio antes de escribir código.
Hágalas cumplir en la ingesta.
Vuelva a comprobarlas después de cada transformación relevante.
Registre los resultados para que los fallos sean trazables y repetibles.
La validación no es burocracia. Es el control de ingeniería que impide que los registros erróneos, los datos desactualizados y los esquemas rotos se conviertan en decisiones de negocio.
Las dimensiones fundamentales de la validación de datos
Un pipeline puede superar todas las comprobaciones básicas y aun así dañar la confianza. El fallo habitual no es un nulo en un campo obligatorio. Son datos que parecen aceptables, recorren el stack y dejan de reflejar la realidad del negocio sin que nadie lo detecte, tras un cambio en el origen, una carga retrasada o una nueva ruta de código aguas arriba.
Por eso la validación necesita más estructura que una barrera de aprobado o suspenso. Los equipos necesitan una forma de decidir qué debe imponerse, qué debe monitorizarse y qué puede tolerarse brevemente porque el coste de bloquear es mayor que el coste de revisar. Un buen punto de partida son seis dimensiones de calidad. Ofrecen a los equipos un vocabulario común para decidir dónde está el riesgo y qué grado de rigor debe tener cada control.
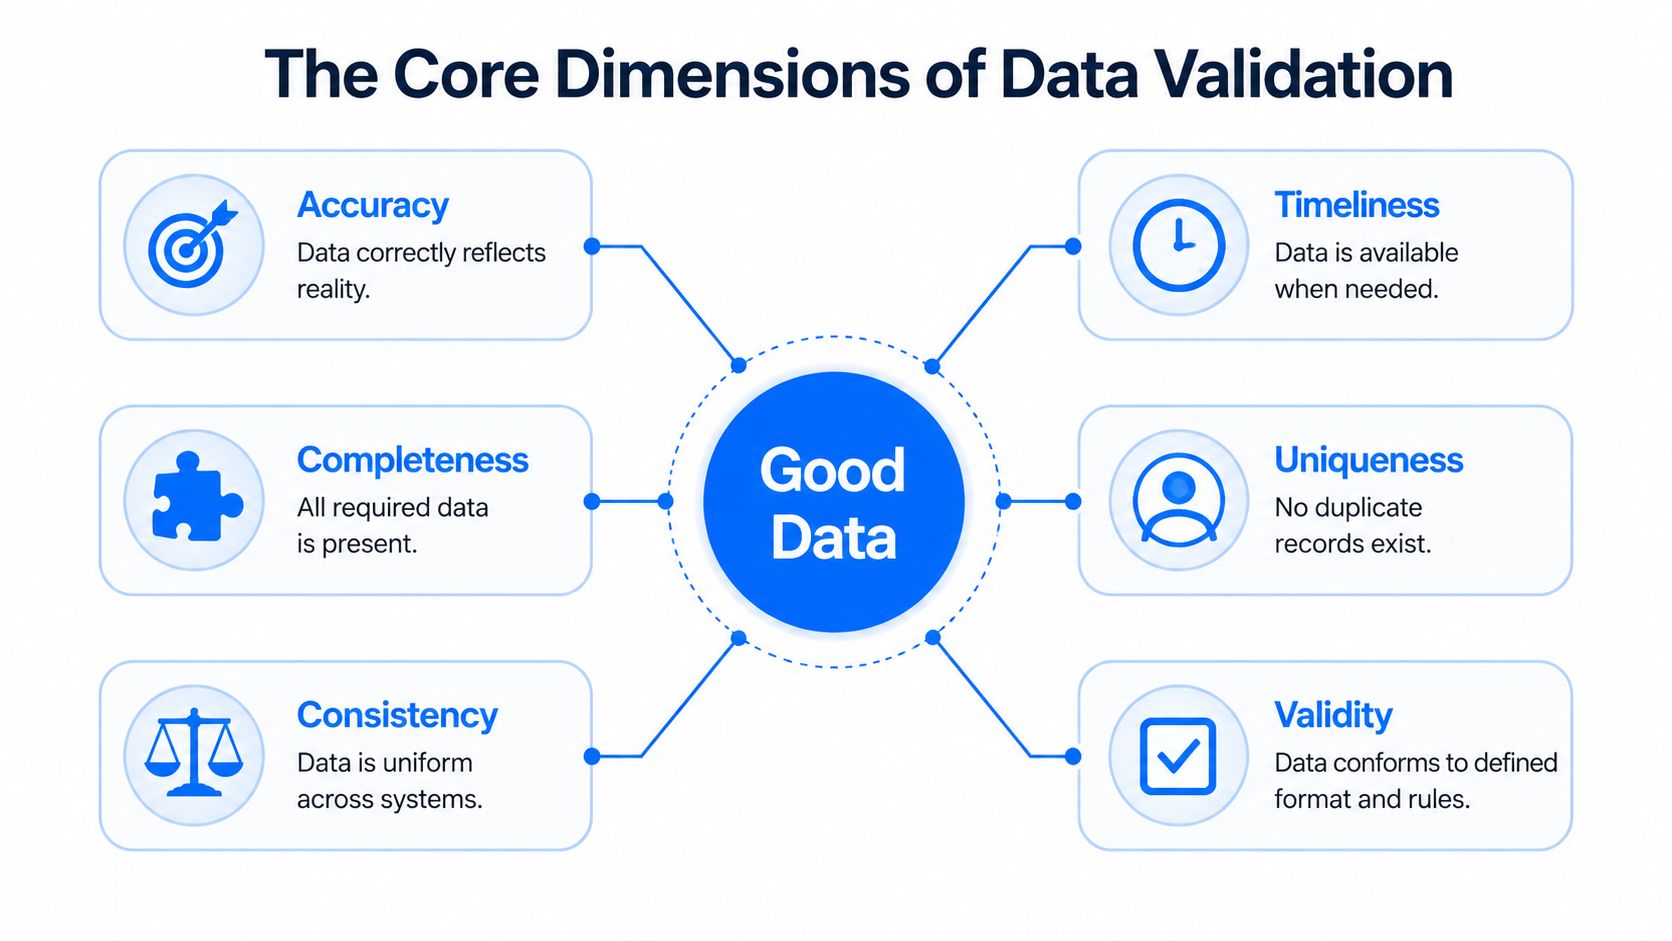
Los buenos datos tienen seis dimensiones
Estas dimensiones suenan conocidas porque lo son. El error es tratarlas como una lista de comprobación en lugar de como clases de fallo distintas con costes de negocio distintos.
Dimensión | Qué significa en la práctica | Impacto típico cuando falla |
|---|---|---|
Exactitud | El valor refleja el evento o la entidad del mundo real | Precios erróneos, saldos erróneos, estado del cliente erróneo |
Completitud | Los datos obligatorios están presentes donde el proceso depende de ellos | Joins rotos, informes inutilizables, features del modelo ausentes |
Coherencia | El mismo concepto se representa de la misma manera en todos los sistemas | Problemas de conciliación, lógica duplicada, discrepancias en los informes |
Puntualidad | Los datos llegan dentro de la ventana que espera el negocio | Dashboards desactualizados, operaciones retrasadas, SLA incumplidos |
Unicidad | Un registro o entidad aparece una sola vez cuando así debe ser | Clientes duplicados, cargos duplicados, recuentos inflados |
Validez | Los valores se ajustan a los formatos, dominios y reglas permitidos | Errores de análisis, eventos rechazados, transacciones no válidas |
La puntualidad merece más atención de la que suele recibir. He visto equipos aprobar un conjunto de datos porque todos los campos superaban las comprobaciones de tipo y de rango, mientras las operaciones trabajaban con los datos del día anterior. La tabla era válida. La decisión seguía siendo errónea.
Lo mismo ocurre con la unicidad y la coherencia. Una transacción duplicada puede salir más cara que un campo opcional ausente. Un código de estado que significa una cosa en el sistema de origen y otra en el almacén de datos puede superar la validación del esquema y aun así romper los informes financieros. La validación funciona mejor cuando la severidad sigue al impacto en el negocio, no a la pulcritud técnica.
Cada tipo de validación detecta una clase de riesgo distinta
Cada dimensión necesita un tipo de control distinto. Si los equipos solo validan la estructura, pasan por alto el significado. Si solo vigilan las distribuciones, pasan por alto las infracciones de reglas estrictas. Una buena cobertura surge de combinar varios tipos de comprobaciones y asignar a cada uno un modo de aplicación.
Utilice esta correspondencia:
La validación del esquema comprueba la estructura: presencia de columnas, tipo de datos, nulabilidad y cambios de contrato.
La validación sintáctica comprueba el formato: fechas, códigos de divisa, identificadores, booleanos y patrones de texto estandarizados.
La validación semántica comprueba el significado de negocio: fecha de fin posterior a la de inicio, transiciones de estado que coinciden con el flujo de trabajo, precios coherentes con las reglas del producto.
La validación relacional comprueba la integridad entre tablas: claves foráneas, registros huérfanos y completitud entre padres e hijos.
La validación estadística comprueba la deriva de comportamiento: cambios de volumen, de tasa de nulos, de cardinalidad y anomalías en las distribuciones.
La deriva silenciosa del esquema se sitúa entre estas categorías y provoca algunos de los incidentes más difíciles de diagnosticar. Un equipo de origen puede ampliar un campo, reutilizar un enum con otro fin, cambiar el tratamiento de las zonas horarias o empezar a enviar una nueva columna opcional que el código aguas abajo ignora. Nada se bloquea. Las cifras simplemente dejan de cuadrar. En estas situaciones, las comprobaciones automáticas de contratos y los monitores basados en perfiles demuestran su valor. Los equipos que evalúen herramientas gratuitas de validación de datos para comprobar esquemas y monitorizar la deriva deberían buscar tanto la aplicación de reglas estrictas como las alertas basadas en tendencias, porque una sin la otra deja puntos ciegos.
Un campo puede ser válido por su tipo y aun así no serlo para la decisión que respalda.
Esa es la brecha que las guías básicas suelen pasar por alto.
Un proceso práctico de diseño de reglas empieza en lenguaje llano. Defina qué debe cumplirse, quién depende de ello, qué ocurre si falla y si el pipeline debe bloquear, poner en cuarentena, advertir o registrar el evento para su revisión. La introducción de IBM a las dimensiones clave de la calidad de los datos es útil aquí porque plantea la calidad como la idoneidad para el uso, que es exactamente como debe priorizarse la validación en los sistemas de producción.
La decisión de diseño final es económica. Bloquear cada anomalía suena disciplinado, pero puede detener las operaciones que generan ingresos, retrasar a los consumidores aguas abajo e inundar a los equipos de alertas de poco valor. Dejar pasar todo es peor. Los programas de validación sólidos separan los fallos de alto riesgo de la variación tolerable, imponen automáticamente los primeros y monitorizan la segunda con una titularidad clara. Así es como la validación mejora la fiabilidad sin convertir el pipeline en un generador constante de incidentes.
Implementar la validación a nivel de registro y de pipeline
La validación funciona mejor cuando se aplica en dos niveles a la vez. Primero, inspeccione cada registro en busca de infracciones de reglas. Después, inspeccione el pipeline como sistema en busca de pérdidas, discrepancias y roturas estructurales. Si solo hace una de las dos cosas, quedan huecos abiertos.
Empiece por las reglas a nivel de fila
A nivel de registro, la base es sencilla. Las buenas prácticas del sector exigen una validación a nivel de fila que aplique ocho reglas específicas (campos obligatorios, comprobación de tipos, validación de formato, restricciones de rango, unicidad, integridad referencial, lógica de negocio y validación entre campos) a cada registro, junto con un registro de auditoría que contabilice los aprobados y fallidos de cada ejecución con fines de cumplimiento y depuración, como se describe en la guía de Flatfile sobre validación de datos.
Un patrón SQL práctico es el siguiente:
No es vistoso, pero es eficaz. Se trata de que cada fallo sea explícito y clasificable.
Normalmente necesitará una combinación de comprobaciones:
Campos obligatorios: bloquee los nulos en claves, fechas y atributos críticos para la operación.
Comprobaciones de tipo y formato: exija que las fechas sean fechas, los booleanos sean booleanos y los códigos se ajusten a formatos de referencia.
Restricciones de rango: detecte valores imposibles o peligrosos antes de que distorsionen la lógica aguas abajo.
Reglas entre campos: valide relaciones como las fechas de inicio y fin, los signos de débito y crédito o las combinaciones de país y formato de código postal.
Después, valide el pipeline como sistema
Las comprobaciones de filas no lo detectan todo. Un pipeline puede superar las reglas a nivel de registro y aun así estar roto si la mitad de los datos nunca llegó, si un join multiplicó las filas duplicadas o si los recuentos de origen y destino ya no cuadran.
Ahí es donde importan las comprobaciones a nivel de pipeline:
Comparación del número de filas: compare los recuentos de origen y destino después de las cargas y transformaciones.
Monitorización de duplicados: compruebe si las claves que deberían ser únicas siguen siéndolo después de joins o uniones.
Integridad referencial: confirme que los valores de las claves foráneas existen en las tablas referenciadas.
Comprobaciones de coherencia de agregados: compare totales, distribuciones y patrones de nulos entre etapas.
Comprobaciones de paridad en migraciones: para los campos críticos durante las migraciones, valide cada fila cuando el negocio no pueda tolerar pérdidas silenciosas.
La guía de digna sobre validación en migraciones resulta especialmente útil aquí. Señala que para los campos críticos durante las migraciones de datos es necesaria una validación del 100 % a nivel de fila para confirmar que los recuentos de registros coinciden entre origen y destino, verificando a la vez que no se han creado duplicados, que no se han perdido registros sin que nadie lo note y que no existen registros parciales, mientras que los conjuntos de datos grandes pueden recurrir a un muestreo estadísticamente significativo con detección de anomalías cuando la comprobación manual completa no resulta práctica.
Mantenga las comprobaciones pesadas en el almacén de datos
La validación de tablas grandes suele fallar porque los equipos extraen demasiados datos del almacén de datos y los inspeccionan en el código de la aplicación. Es lento, caro y difícil de escalar. Traslade el trabajo pesado a la base de datos siempre que sea posible.
La validación dentro de la base de datos encaja mejor para:
comprobaciones de unicidad en claves de negocio compuestas
integridad referencial entre conjuntos de datos
comprobaciones de umbrales y rangos en tablas grandes
comparaciones de perfiles sobre tasas de nulos o distribuciones de categorías
Si quiere un punto de partida ligero antes de crear su propio marco, merece la pena revisar estas herramientas gratuitas de validación de datos de digna junto con opciones como los tests de dbt, Great Expectations y las comprobaciones SQL nativas del almacén de datos.
El almacén de datos ya está optimizado para escanear, comparar, agregar y combinar. Deje que la validación se haga allí en lugar de exportar el problema a otro sitio.
Automatizar la validación y gestionar los fallos
Las comprobaciones manuales puntuales están bien para depurar. No son un modelo operativo. Si la validación no se ejecuta automáticamente cada vez que cambian los datos, su equipo depende de la suerte y de la curiosidad.
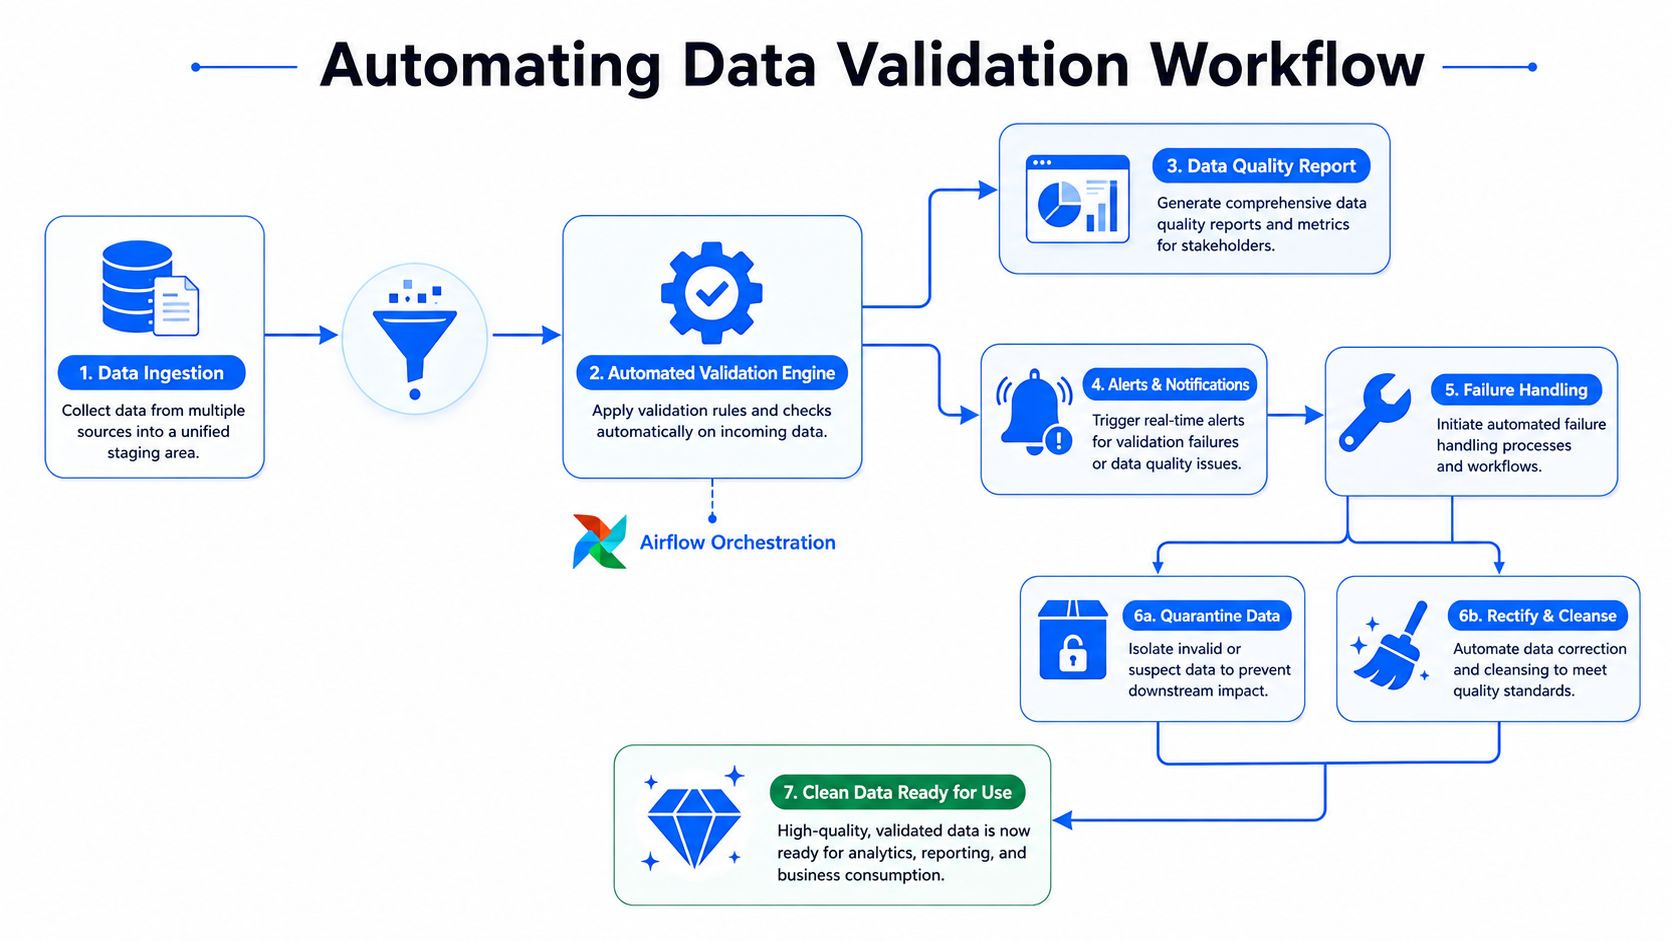
Automatice las comprobaciones donde cambian los datos
El patrón de automatización más limpio es el basado en eventos o en la orquestación. Ejecute las comprobaciones después de la ingesta, después de las transformaciones principales y antes de publicar los datos en las capas de servicio. Airflow, dbt y las tareas del almacén de datos admiten este patrón.
Una secuencia duradera es la siguiente:
Ingiera los datos y valide el esquema de inmediato.
Ejecute las reglas a nivel de registro en las tablas de aterrizaje.
Ejecute comprobaciones de agregados y de paridad después de las transformaciones.
Escriba los resultados de aprobado/fallido en una tabla de auditoría.
Active la acción adecuada ante el fallo.
La observabilidad y la validación empiezan a converger. La validación le dice si una regla se ha cumplido. La observabilidad le ayuda a entender los cambios de tendencia, los retrasos en la puntualidad y si el mismo fallo se repite en distintas ejecuciones. Una introducción útil es este resumen de los conceptos de observabilidad de datos y el diseño de flujos de trabajo.
Una breve demostración puede ayudar a concretar el patrón de orquestación:
Elija las acciones ante fallos según el riesgo de negocio
No todas las comprobaciones fallidas merecen la misma respuesta. En este punto, los equipos suelen reaccionar en exceso o quedarse cortos.
Un modelo de decisión útil consiste en clasificar los fallos en tres grupos:
Tipo de fallo | Ejemplo | Mejor acción |
|---|---|---|
Parada total | Clave primaria ausente, periodo financiero no válido, rotura referencial en una tabla de hechos crítica | Detener el pipeline |
Cuarentena | Un subconjunto de filas infringe el formato o la lógica de negocio | Desviar los registros erróneos para su revisión |
Advertir y continuar | Deriva menor en un campo descriptivo no crítico | Alertar y monitorizar |
El equilibrio es económico, no solo técnico. Los datos del sector muestran que los problemas de calidad de los datos causan entre el 20 y el 30 % de la pérdida de ingresos en finanzas y sanidad, pero no existe ningún marco estándar para calcular el punto en el que el esfuerzo de validación supera la reducción marginal del riesgo, según el análisis de Twilio sobre técnicas de validación e impacto en el negocio. Esa laguna importa. Los equipos tienen que decidir dónde la aplicación estricta compensa su coste y dónde genera fricción sin reducir mucho el riesgo.
Si su stack también alimenta sistemas generativos, la calidad de los datos y la monitorización de modelos empiezan a solaparse. Al evaluar los controles aguas abajo, conviene encontrar la plataforma de monitorización de LLM adecuada para ver cómo encajan la fiabilidad de las entradas, el comportamiento de los prompts y la monitorización en producción.
Evite la fatiga de alertas
Demasiados equipos inundan Slack y el correo electrónico con alertas de poco valor hasta que nadie las lee. Una buena automatización genera señales, no ruido.
Algunos hábitos funcionan bien:
Enrute según la severidad: los avisos al personal de guardia deben ser poco frecuentes. La mayoría de los problemas deben ir a dashboards o colas de tickets.
Agrupe los fallos relacionados: si diez tablas fallan porque cambió un esquema aguas arriba, envíe un solo incidente.
Incluya contexto: cada alerta debe indicar qué falló, dónde, cuándo y qué hizo el sistema a continuación.
Revise los patrones periódicamente: la guía de Cube sobre buenas prácticas de validación describe una cadencia útil en entornos empresariales, en los que los equipos revisan los patrones de error cada trimestre y actualizan las reglas cada año, en lugar de dejar umbrales obsoletos.
Las alertas deben decirle a un ingeniero qué ha pasado y qué hacer a continuación. Si solo anuncian «validación fallida», son trabajo sin terminar.
Estrategias avanzadas a escala empresarial
A escala empresarial, las reglas estáticas siguen importando, pero dejan de ser suficientes. Se necesitan controles para cambios que nadie programó de forma explícita, sobre todo cuando las herramientas de BI, los servicios de ETL y las aplicaciones de origen siguen evolucionando por debajo.
La deriva silenciosa del esquema es el problema empresarial que las guías básicas pasan por alto
Muchos fallos no provienen de un nulo o de un valor fuera de rango. Provienen de un cambio estructural sutil. Se renombra una columna, un tipo cambia de entero a cadena o una herramienta aguas arriba ajusta automáticamente un esquema de forma que la ingesta sigue funcionando, pero la lógica aguas abajo se rompe.
Por eso el seguimiento del esquema debe tratarse como validación, no solo como higiene de metadatos. El riesgo es mayor de lo que muchos equipos suponen. Informes recientes del sector de 2025-2026 indican que el 65 % de los fallos de los pipelines de ML se deben a cambios de esquema no detectados y no a errores en los valores de los datos, pero los protocolos de validación estándar rara vez incluyen el seguimiento de versiones del esquema, según se cita en este análisis de la deriva del esquema y los fallos de los pipelines.
Una práctica madura de validación del esquema incluye:
Seguimiento de versiones: registre los cambios estructurales a lo largo del tiempo.
Comprobaciones de compatibilidad: decida qué cambios son retrocompatibles y cuáles deben bloquear la publicación.
Titularidad: haga que un equipo sea responsable de aprobar los cambios de esquema.
Comprobaciones del impacto aguas abajo: vincule las alertas de cambios de esquema con los modelos, dashboards o API afectados.
Añada detección de anomalías y puntualidad
Las reglas codificadas de forma fija solo detectan lo que ya se sabe que hay que buscar. Los sistemas empresariales necesitan otra capa que detecte cambios inesperados en las distribuciones, los patrones de nulos, la combinación de categorías y los tiempos de entrega.
Este es un ámbito en el que el soporte de una plataforma ayuda. Herramientas como los tests de dbt y Great Expectations gestionan bien la validación basada en reglas. Para la monitorización dentro de la base de datos de anomalías, puntualidad, reglas a nivel de registro y cambios de esquema, una opción es digna, que ejecuta los análisis dentro del entorno del cliente y saca a la luz tendencias, retrasos y cambios estructurales sin exportar datos de producción.
La puntualidad merece el mismo trato que las comprobaciones de contenido. Los datos que llegan tarde pueden invalidar los dashboards aunque cada fila cumpla las reglas de tipo y formato. Monitorice las ventanas de llegada esperadas y señale las cargas retrasadas antes de que las partes interesadas descubran por su cuenta informes desactualizados.
Los equipos que crean flujos de soporte con IA se topan con un problema similar en la capa de aplicación. Los datos pueden ser estructuralmente válidos y aun así dar lugar a resultados poco fiables si no se controlan las entradas y las instrucciones. Por eso las recomendaciones sobre el diseño de prompts para una IA de soporte fiable son útiles en paralelo con la validación de datos. Abordan otra versión de la misma disciplina: definir entradas aceptables y reducir los modos de fallo silenciosos.
La gobernanza evita que las reglas se deterioren
Las reglas de validación envejecen mal cuando nadie es responsable de ellas. Un equipo las escribe, otro cambia el proceso de origen y, seis meses después, las comprobaciones son ruidosas o irrelevantes.
Un modelo sostenible incluye:
Definiciones de reglas en lenguaje llano: las partes interesadas del negocio deberían poder revisarlas sin leer SQL.
Responsables asignados: un propietario de datos, un data steward o un equipo de gobernanza debe mantener cada regla.
Registro de auditoría: conserve los recuentos de aprobados y fallidos y los metadatos de cada ejecución.
Revisión programada: revise periódicamente los umbrales, las suposiciones y las excepciones.
Esa capa de gobernanza es la que convierte la validación de una colección de scripts en un sistema de control operativo.
Un marco pragmático para la validación de datos
Un programa de validación práctico empieza por el riesgo, no por la cobertura. Los equipos se meten en problemas cuando escriben decenas de comprobaciones para datos de bajo impacto y luego pasan por alto los pocos modos de fallo que pueden corromper los informes de ingresos, romper los flujos de trabajo de los clientes o introducir features erróneas en los modelos. Un marco mejor plantea primero dos preguntas: ¿qué puede fallar sin que se detecte y cuál es el coste para el negocio si ocurre?

Un modelo de trabajo para equipos que necesitan resultados
Empiece por los activos de datos que conllevan el mayor riesgo operativo o regulatorio. En la práctica, eso suele incluir las medidas financieras, los identificadores de clientes, los campos de cumplimiento normativo y las entradas de los modelos. Defina un conjunto reducido de reglas para cada uno y vincule cada regla a una acción. Si una comprobación falla, decida si el pipeline debe detenerse, poner en cuarentena los datos afectados o continuar con una alerta.
Utilice un modelo de aplicación mixto, porque no todos los defectos deben tratarse igual:
Aplique reglas estrictas a las invariantes: claves primarias, campos obligatorios, integridad referencial y formatos fijos.
Use la detección de anomalías para cambios difíciles de enumerar de antemano: cambios de distribución, picos de nulos, variaciones de volumen y llegadas con retraso.
Haga un seguimiento explícito de la deriva del esquema: los cambios silenciosos de columnas y de tipos suelen romper la lógica aguas abajo antes de que nadie lo note.
Asigne un responsable a cada regla: alguien tiene que revisar el ruido, aprobar las excepciones y retirar las comprobaciones obsoletas.
Muchas guías básicas se quedan cortas en este aspecto. Tratan la validación como una barrera de aprobado o suspenso. Los sistemas de producción necesitan, en cambio, un modelo basado en el riesgo. Una clave primaria ausente en una tabla financiera merece una parada total. Un cambio menor en un atributo de baja prioridad quizá solo necesite una advertencia y un ticket. El objetivo no es la máxima aplicación. El objetivo son datos fiables a un coste que el equipo pueda sostener.
Qué hacer primero esta semana
Empiece por un pipeline cuestionado. Elija aquel que la gente ya pone en duda en las reuniones, porque ya tiene un impacto visible en el negocio y un ciclo de retroalimentación natural.
Después, haga cinco cosas:
Nombre las cinco condiciones de negocio que deben cumplirse.
Asocie cada condición a una comprobación técnica a nivel de registro o de pipeline.
Clasifique cada fallo según su impacto: detener, poner en cuarentena, advertir o solo registrar.
Añada un historial de ejecuciones para que el equipo pueda ver los fallos repetidos y la deriva a lo largo del tiempo.
Revise los falsos positivos después de la primera semana y ajuste las reglas ruidosas.
Esa secuencia funciona porque obliga a tomar decisiones de compromiso desde el principio. Los equipos aprenden qué controles protegen la confianza y cuáles solo generan fatiga de alertas. También pone de manifiesto los modos de fallo reales antes de que nadie invierta en un gran catálogo de reglas que será caro de mantener.
La validación de datos funciona mejor como un sistema operativo para la fiabilidad. Combina reglas deterministas, detección de deriva, conocimiento del esquema, titularidad y gestión de fallos en un único proceso capaz de sobrevivir a orígenes cambiantes y a una complejidad creciente de los pipelines.
Si busca una forma práctica de combinar validación dentro de la base de datos, detección de anomalías, monitorización de la puntualidad y seguimiento del esquema en un único flujo de trabajo, eche un vistazo a digna. Está diseñado para equipos que necesitan validar registros, detectar la deriva y monitorizar la fiabilidad de los pipelines sin sacar los datos de producción de su propio entorno.
Como la deriva silenciosa del esquema escapa a las reglas a nivel de registro, digna Schema Tracker cubre la parte de seguimiento de versiones de la validación al detectar columnas añadidas, eliminadas o con un tipo modificado antes de que se rompa la lógica aguas abajo.
Preguntas frecuentes
¿Cómo se validan los datos en un pipeline?
Valide en varios puntos de control en lugar de solo en el resultado. La secuencia del artículo es: validar el esquema en la ingesta, ejecutar reglas a nivel de registro en las tablas de aterrizaje, ejecutar comprobaciones de agregados y de paridad después de las transformaciones, escribir los resultados de aprobado/fallido en una tabla de auditoría y, por último, activar la acción ante el fallo que corresponda al riesgo de negocio.
¿Cuáles son las seis dimensiones de la calidad de los datos?
Las seis dimensiones son exactitud, completitud, coherencia, puntualidad, unicidad y validez. El artículo las trata como clases de fallo distintas con costes de negocio distintos: una transacción duplicada puede costar más que un campo opcional ausente, y una tabla puede superar todas las comprobaciones de tipo mientras las operaciones siguen trabajando con los datos del día anterior.
¿Qué reglas de validación a nivel de fila debe superar cada registro?
La guía de Flatfile, citada en el artículo, enumera ocho: campos obligatorios, comprobación de tipos, validación de formato, restricciones de rango, unicidad, integridad referencial, lógica de negocio y validación entre campos. Combínelas con un registro de auditoría de aprobados y fallidos por ejecución. Un sencillo patrón SQL con CASE puede señalar ID de pedido nulos, importes negativos o fechas de pedido futuras.
¿Qué debe ocurrir cuando falla una comprobación de validación de datos?
Adapte la respuesta al riesgo de negocio. Las paradas totales detienen el pipeline ante problemas como una clave primaria ausente o un periodo financiero no válido. La cuarentena desvía un subconjunto de filas erróneas para su revisión. Advertir y continuar es adecuado para una deriva menor en un campo descriptivo no crítico, que recibe una alerta y monitorización en lugar de un bloqueo.
¿Por qué la deriva del esquema es un problema de validación de datos?
Los cambios estructurales suelen escapar a las comprobaciones de valores: una columna renombrada o un cambio de tipo de entero a cadena pueden mantener la ingesta en marcha mientras rompen la lógica aguas abajo. Los informes citados en el artículo atribuyen el 65 % de los fallos de los pipelines de ML a cambios de esquema no detectados, por lo que el seguimiento de versiones, las comprobaciones de compatibilidad y la titularidad forman parte de la validación.


