Cómo medir la integridad de los datos: 8 métodos prácticos
|
8
minuto de lectura
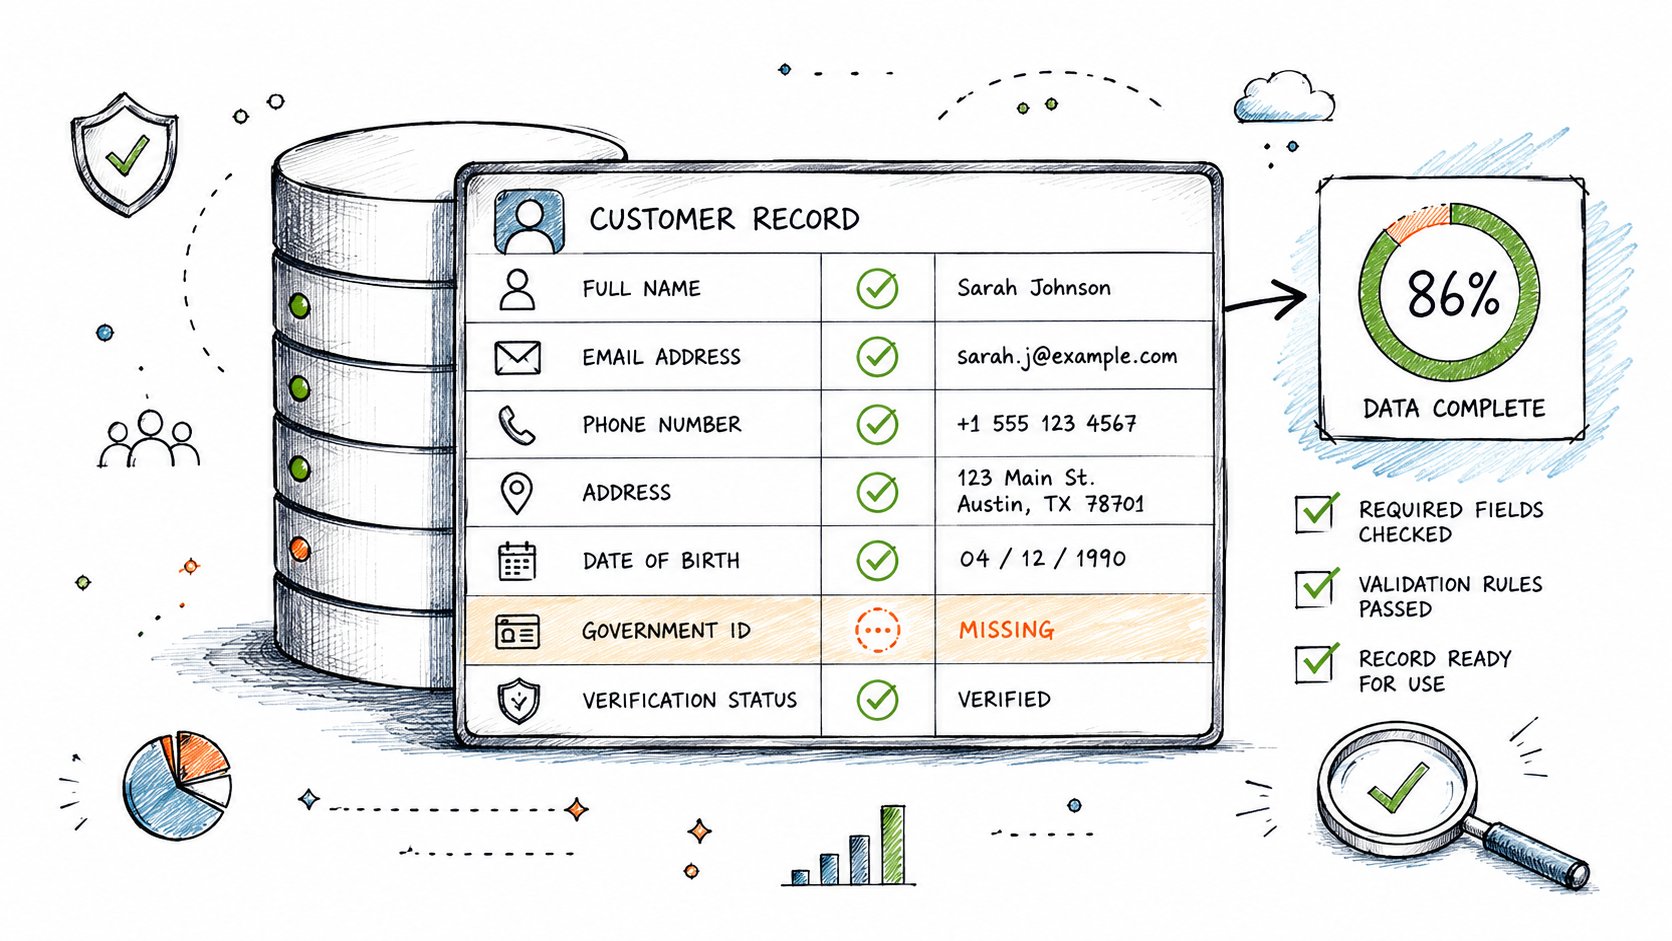
La completitud de datos (Data Completeness) se mide comparando los datos requeridos presentes con los datos esperados. La fórmula básica es Tasa de completitud = (Registros con datos / Total de registros) × 100, por lo que 9,800 números de teléfono completados de 10,000 valores esperados produce una tasa de completitud del 98% (Data Quality Sense explica el cálculo estándar).
Un pipeline de transacciones puede reportar una carga exitosa y, al mismo tiempo, dejar al negocio con datos incompletos. El recuento de registros puede disminuir drásticamente, los campos obligatorios del cliente pueden contener más valores NULL de lo habitual o un archivo de reporte completo puede no llegar nunca. El pipeline se ejecutó, pero el conjunto de datos puede no ser lo suficientemente completo para la decisión que espera en etapas posteriores.
La completitud de datos es el grado en que todos los datos requeridos para un uso previsto están presentes. Eso incluye valores de campos faltantes, registros faltantes, transacciones faltantes, conjuntos de datos faltantes, períodos históricos faltantes y atributos requeridos faltantes. Un registro de cliente con un nombre y dirección válidos pero sin un ID de cliente está incompleto para cualquier proceso que dependa de ese identificador.
Por lo tanto, un monitoreo confiable debe ir más allá de un único porcentaje. Debe examinar los campos completados, los registros completos, los volúmenes de registros, los conjuntos de datos esperados, los tiempos de entrega y los cambios históricos inusuales. Los ocho métodos prácticos a continuación construyen esa perspectiva paso a paso, y luego conectan cada medición con la validación, la detección de anomalías, la puntualidad y el análisis histórico en digna.
Tabla de contenidos
5. Verificación de completitud de conjuntos de datos y períodos
6. Detección de anomalías y análisis de tendencias históricas para la completitud
7. Evaluación de completitud de datos frente a precisión y validez
1. Tasa de completitud de campos
El perfil de un cliente puede contener un nombre y una dirección pero seguir siendo inutilizable si su ID de cliente requerido está en blanco. La tasa de completitud de campos mide esta primera capa de completitud: cuántos valores esperados en una columna están completados. Los valores NULL, las cadenas de texto vacías y otros marcadores definidos para valores faltantes entran en esta verificación.
Utilice el siguiente cálculo:
Tasa de completitud = valores completados / valores esperados × 100
Por ejemplo, si una tabla de cuentas contiene 4,500 direcciones de correo electrónico esperadas y 4,365 están completadas, la tasa de completitud del campo es del 97%. Este método basado en porcentajes sigue las pautas de completitud de Data Quality Sense.
El denominador debe coincidir con la regla de negocio. Se puede requerir un ID de cliente para cada transacción, por lo que todas las filas de transacciones pertenecen al denominador. Un campo que se aplica solo a clientes elegibles debe medirse frente a esa población elegible. Contar las filas no aplicables como faltantes haría que la puntuación pareciera peor de lo que realmente es el proceso.
Set thresholds by business use
El 100% es el punto de referencia ideal para muchos campos regulados bajo governance. Los niveles de servicio de los campos obligatorios pueden establecerse por encima del 95%, según el riesgo comercial y las consecuencias de los valores faltantes, tal como SailPoint describe estas prácticas para establecer objetivos. Un identificador de transacción puede requerir una cobertura total, mientras que un atributo descriptivo de menor riesgo puede permitir una ausencia limitada si los usuarios intermedios conocen la restricción.
Establezca un umbral para cada campo importante en lugar de confiar en el promedio de un único conjunto de datos. Un promedio puede ocultar una brecha grave en una columna de identificador. Data Quality Sense recomienda tratar la tasa de nulos como una señal central de completitud, así que combine la tasa con comprobaciones explícitas de valores NULL y vacíos.
En digna, digna Data Validation puede ejecutar estas comprobaciones para IDs de clientes, montos de transacciones, marcas de tiempo, números de cuenta y otros atributos obligatorios. Guarde los resultados por campo y sistema de origen. Ese historial respalda la validación en la ingesta, la detección de anomalías después de un cambio y la comparación posterior de la completitud a lo largo de los períodos.
Regla práctica: Documente qué campos requiere cada proceso de negocio antes de establecer los umbrales. Un porcentaje tiene sentido solo cuando su población esperada y su uso previsto están claros.
2. Monitoreo del recuento de registros
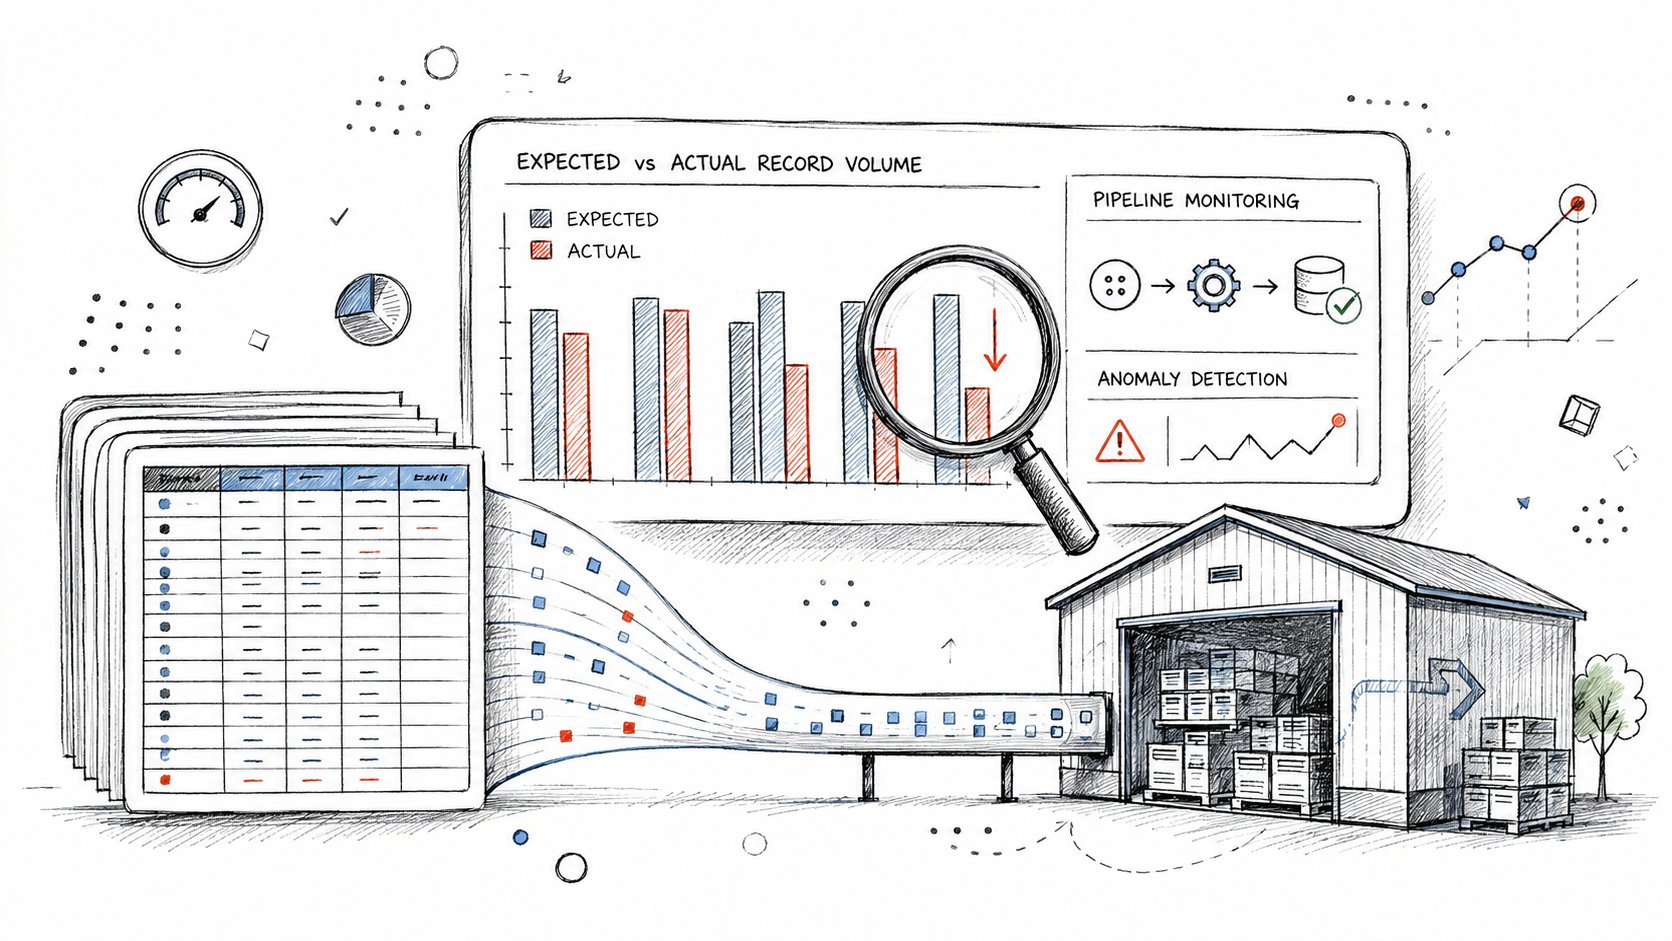
Un conjunto de datos puede contener campos bien completados y aun así estar incompleto porque nunca llegaron registros enteros. El monitoreo del recuento de registros compara la cantidad de filas cargadas con un volumen esperado, un mínimo definido o el comportamiento histórico del mismo conjunto de datos.
Considere una tabla de transacciones diarias que normalmente recibe 10 millones de registros pero de repente contiene solo 7 millones. Ese cambio puede indicar una carga de datos incompleta o la falta de registros de origen. El ejemplo es parte del escenario operativo proporcionado e ilustra por qué un estado de pipeline exitoso no demuestra que se hayan entregado todos los eventos de negocio esperados.
Las comprobaciones de recuento de registros funcionan a dos niveles. Una regla absoluta puede marcar un recuento por debajo de un mínimo definido por el negocio. Una comprobación comparativa puede alertar sobre un cambio inusual frente al historial del propio conjunto de datos. El segundo enfoque es valioso cuando el volumen legítimo varía según el día de la semana, la temporada, la región o el ciclo contable.
Investigate drops and increases
Una disminución repentina es una advertencia obvia, pero un incremento inesperado también puede indicar duplicación, archivos reproducidos, una explosión de joins o un cambio en el sistema de origen. Los equipos deben conservar el recuento junto con la hora de carga, la partición, el origen y la fecha comercial para que los investigadores puedan acotar rápidamente el alcance afectado.
Evite copiar un rango genérico de otro conjunto de datos. Establezca el comportamiento esperado a partir del historial de la propia tabla, luego considere los ciclos comerciales conocidos, como el procesamiento de fin de mes o la demanda estacional. Los datos de origen también pueden llegar en lotes, por lo que la comprobación debe ejecutarse en un punto en el que se espera que la carga esté completa.
digna Data Anomalies puede identificar comportamientos de volumen de registros inusuales sin obligar a los ingenieros a mantener un umbral separado para cada tabla. Correlacione la señal de volumen con la completitud de los campos. Un recuento de filas más bajo combinado con un aumento de IDs de clientes faltantes apunta hacia un problema de ingesta más amplio, mientras que un recuento más bajo con una cobertura de campos estable puede sugerir una partición o segmento de negocio faltante.
El monitoreo del recuento de registros también se aplica a las filas faltantes dentro de un período. Si un sistema de origen debe entregar transacciones para cada región o unidad de negocio, compare los recuentos por esas dimensiones en lugar de hacerlo solo a nivel de tabla total. Un total que parece completo puede ocultar una extracción regional faltante compensada por una mayor actividad en otros lugares.
3. Monitoreo de la tasa de NULLs
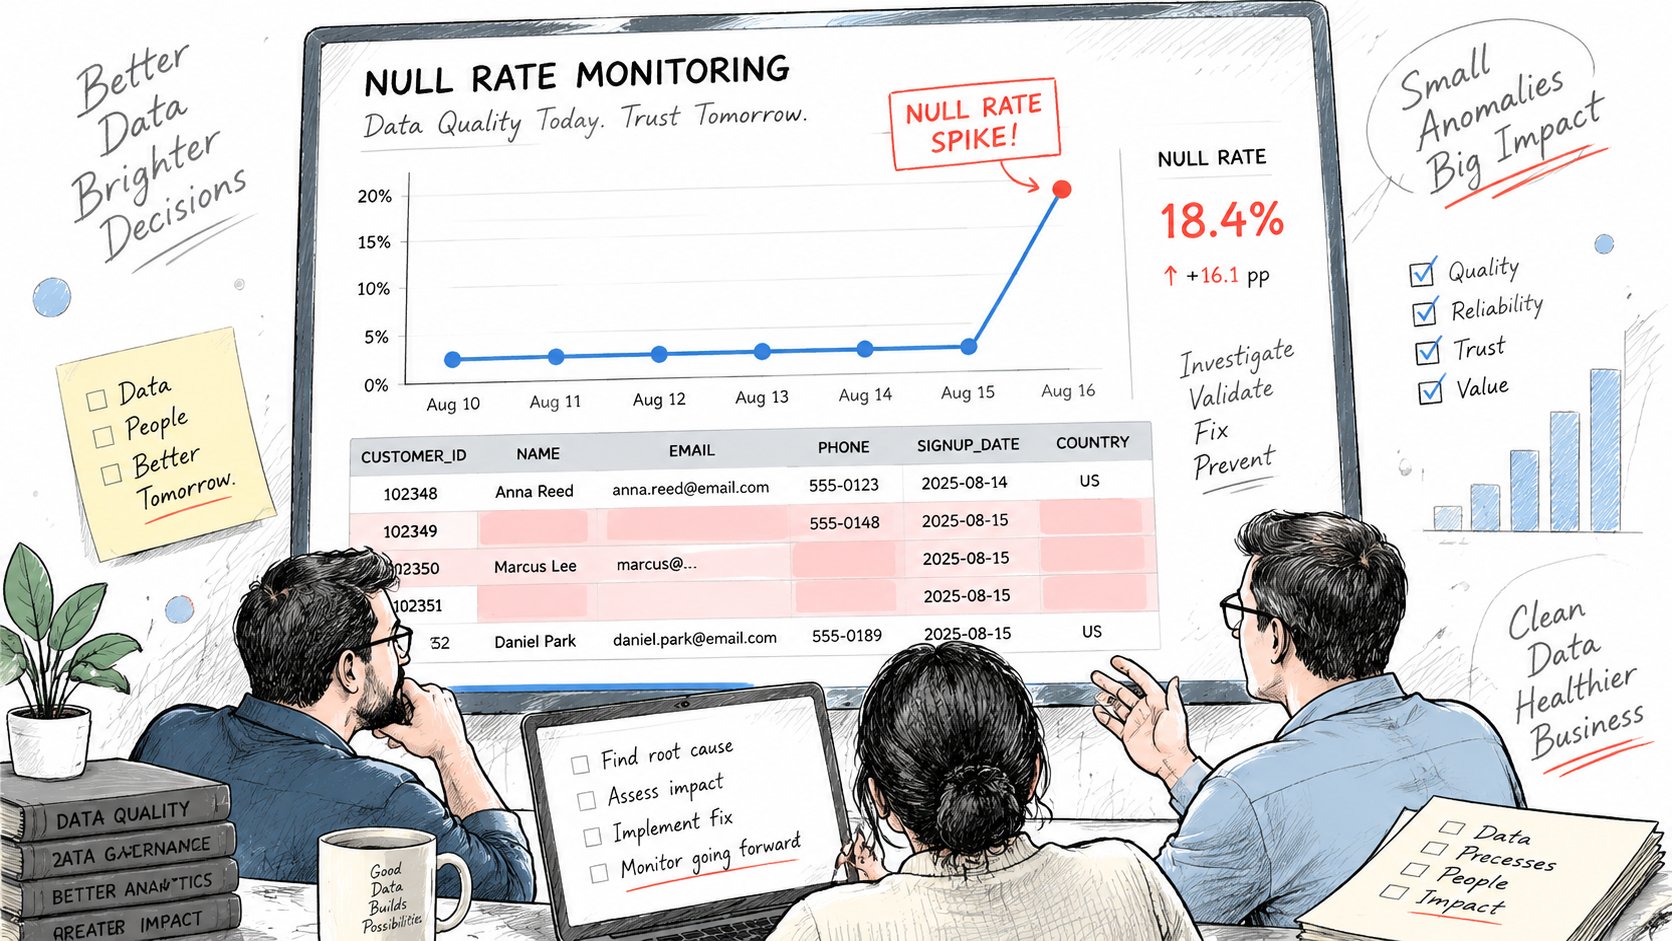
El monitoreo de la tasa de NULLs mide la proporción de valores esperados que faltan y realiza un seguimiento de esa proporción a lo largo del tiempo. A nivel de campo, se calcula como:
Tasa de NULLs = valores nulos o vacíos / total de valores esperados × 100
La completitud y la tasa de NULLs describen lados opuestos de la misma condición. La completitud muestra lo que está poblado; la tasa de NULLs muestra lo que está ausente. Data Quality Sense identifica la tasa de NULLs como una medida central de completitud.
La tasa actual es solo una parte de la evaluación. Un campo con una ausencia de datos estable y aceptada puede respaldar su proceso previsto, mientras que un aumento repentino puede indicar una interfaz rota, un mapeo modificado, una transformación fallida o un comportamiento de origen alterado. Compare el resultado actual con la propia línea base del campo y conéctelo con los resultados de validación, el tiempo de carga y los cambios de origen.
Tratar la ausencia de datos como contexto, no solo como un recuento
Un NULL no siempre significa lo mismo. Puede representar un valor que no se capturó, un campo que no se aplica, una omisión intencional o un estado especial codificado de manera diferente entre sistemas. Antes de calcular una medida de completitud calificada, clasifique los NULLs, las cadenas en blanco, el texto de marcadores de posición y los códigos especiales. La documentación independiente sobre calidad de datos advierte que una medición de ausencia de datos rudimentaria puede inducir a error si los valores faltantes están mal codificados.
Las reglas de elegibilidad evitan que la no aplicabilidad permitida aparezca como una falla. Por ejemplo, compare un campo de contacto de facturación solo entre aquellos registros para los cuales se requiere un contacto de facturación. También separe los orígenes y las rutas de ingesta, porque un maestro de clientes y un sistema de servicio ingresado manualmente pueden tener patrones normales diferentes.
Un modelo de monitoreo práctico combina cuatro comprobaciones:
Requisito estático: Alerta cuando un campo obligatorio supera su tasa de NULLs aceptada.
Cambio histórico: Alerta cuando la tasa actual difiere inusualmente de la línea base del campo.
Comparación de fuentes: Examina el comportamiento por sistema de origen, región o ruta de ingesta.
Correlación de cambios: Revisa los despliegues, los cambios de interfaz y las actualizaciones de mapeo junto con los cambios en la tasa de NULLs.
La referencia de completitud de Data Quality Sense describe los recuentos completados, nulos e incompletos como vistas de monitoreo útiles. Estos recuentos conectan una alerta con la investigación. Los analistas pueden identificar los registros, orígenes, períodos y condiciones comerciales afectados, para luego comparar el patrón de ausencia de datos con fallas de validación o cargas retrasadas.
4. Evaluación de la completitud de registros
La completitud de campos pregunta si las columnas individuales están completadas. La completitud de registros pregunta si cada registro contiene el conjunto completo de atributos requeridos para un proceso en particular. Esta distinción importa porque varios campos pueden parecer aceptables individualmente mientras que los mismos registros de clientes permanecen parcialmente completados.
Suponga que un registro de cliente requiere un ID de cliente, nombre, correo electrónico y dirección. La completitud de registros cuenta cuántos registros de clientes contienen los cuatro atributos requeridos. Un resultado como el 97% de los registros de clientes contienen todos los atributos requeridos brinda a los propietarios de procesos una perspectiva diferente a la de cuatro porcentajes de campo separados. La definición y el cálculo a nivel de registro se describen en las pautas de completitud de The Pedowitz Group.
Los requisitos correctos dependen del uso posterior. Un proceso de suscripción de riesgos puede necesitar una solicitud de préstamo completa antes de su revisión. Un proceso de facturación puede necesitar un número de cuenta, una dirección de servicio y un contacto de facturación. Un conjunto de datos de reporte puede requerir una marca de tiempo y una clave comercial, incluso cuando un campo descriptivo es opcional.
Encontrar el patrón detrás de los registros incompletos
Comience con una regla a nivel de registro que evalúe todos los campos obligatorios en conjunto. Luego conserve los motivos de falla individuales. El resultado combinado le indica cuántos registros son utilizables, mientras que los motivos a nivel de campo muestran qué impide que se utilicen los registros restantes.
Por ejemplo, un registro de compra de comercio electrónico puede requerir un ID de pedido, un ID de cliente, un ID de producto, cantidad, precio y marca de tiempo. Un registro al que le falte uno de esos valores debería fallar la regla de registro completo si el análisis de ingresos depende de la combinación completa.
Utilice digna Data Validation para realizar comprobaciones a nivel de registro frente a requisitos de negocio explícitos. Separe los tipos de registros cuando sus requisitos difieran. Un cliente, una transacción, un reclamo y una orden de servicio no deberían compartir automáticamente una misma definición de completitud.
Un registro completo no es lo mismo que un conjunto de datos completo. Necesita ambas perspectivas para comprender si las filas individuales son utilizables y si la población esperada llegó en absoluto.
Realice el seguimiento de dos resultados:
Cobertura de registros completos: La proporción de registros que cumplen con todos los requisitos para el proceso previsto.
Composición de fallas: Los campos que más a menudo faltan dentro de los registros incompletos.
Esta combinación respalda la remediación. Si un pequeño número de campos falla en muchos registros, corrija el origen o el mapeo. Si fallan muchos campos en un grupo pequeño de registros, investigue un origen, tipo de registro o partición de ingesta en particular.
5. Verificación de completitud de conjuntos de datos y períodos
Algunas fallas de completitud ocurren por encima del nivel de filas y columnas. El conjunto de datos esperado completo puede estar ausente, puede faltar un período de reporte o un origen puede dejar de entregar datos para una región en particular. La verificación de completitud de conjuntos de datos y períodos pregunta si los archivos, tablas, particiones y fechas comerciales esperadas existen en absoluto.
Las comprobaciones típicas incluyen:
Llegada de archivos esperada: Confirmar que llegó el archivo diario de ventas o de liquidación.
Cobertura de períodos: Verificar que todos los días, meses o trimestres esperados estén representados.
Cobertura de fuentes: Comprobar que cada región comercial o sistema ascendente haya entregado datos.
Presencia de particiones: Confirmar que el almacén de datos contenga las particiones de fecha y de entidad esperadas.
Un conjunto de datos puede superar la validación a nivel de campo porque las filas que llegaron están perfectamente completadas. Ese resultado aún no justifica la publicación de un reporte si falta un período de reporte completo. La completitud debe evaluarse frente al calendario de reportes y al alcance del negocio.
Agregar el tiempo de entrega a la definición de completitud
El tiempo de entrega proporciona una señal operativa. Si se espera un archivo diario dentro de una ventana definida y no ha llegado, el conjunto de datos no está disponible para el proceso, incluso si eventualmente aparece. digna Timeliness puede monitorear los patrones de llegada, marcar cargas faltantes o retrasadas y calcular los tiempos de entrega esperados a partir del comportamiento observado.
Para un marco de comprobaciones de completitud de datos práctico, defina una expectativa para cada conjunto de datos:
Nombre el origen y el destino.
Especifique la fecha comercial o partición esperada.
Defina la ventana de entrega y la zona horaria.
Registre las dependencias de archivos o trabajos ascendentes.
Establezca una acción de recuperación para una entrega faltante o retrasada.
Este enfoque ayuda a los equipos a detectar un archivo de ventas diario faltante antes de que un panel de control se ejecute con una brecha silenciosa. También respalda la recopilación de datos para equipos IEP, donde los períodos esperados y los registros requeridos deben rastrearse explícitamente en lugar de inferirse a partir de los datos que estén disponibles.
Documente las fuentes alternativas y los procedimientos de reejecución. Un conjunto de datos faltante puede deberse a una interrupción de la fuente, una falla del programador, un archivo rechazado o una dependencia que se completó tarde. La alerta debe orientar a los investigadores hacia esas posibilidades en lugar de tratar cada ausencia como el mismo defecto.
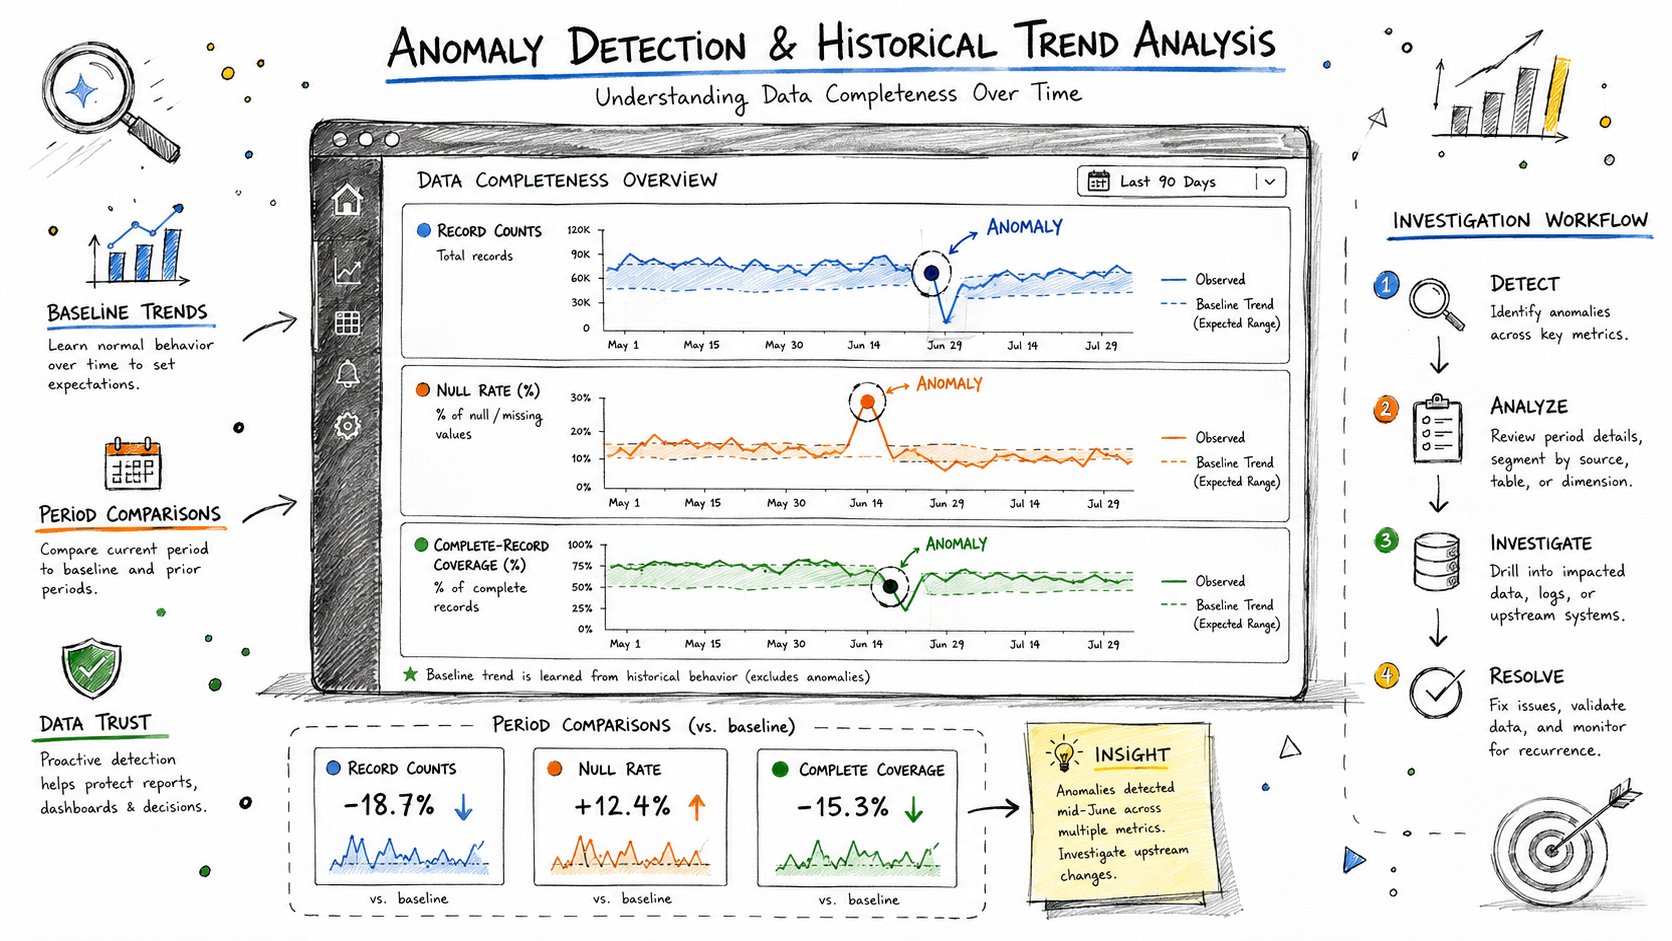
6. Detección de anomalías y análisis de tendencias históricas para la completitud
Las reglas fijas identifican requisitos conocidos. La detección de anomalías y el análisis de tendencias históricas identifican patrones de completitud que cambian sin una condición de falla predefinida. Las señales útiles incluyen las tasas de NULLs, los valores completados, los recuentos de registros, la cobertura de registros completos, los tiempos de entrega y la presencia de períodos esperados.
Un conjunto de datos puede deteriorarse gradualmente. Los recuentos de registros pueden disminuir a lo largo de varias cargas, o un campo requerido puede quedar menos poblado después de un cambio en el sistema. Cada métrica puede permanecer por encima de su umbral de alerta mientras el riesgo general crece. La comparación histórica hace que esa dirección sea visible, de forma muy parecida a comparar la lectura de hoy con la línea base establecida de un paciente en lugar de juzgarla por sí sola.
Utilice el enfoque de detección de anomalías en series de tiempo de digna para comparar el comportamiento actual de completitud con los patrones aprendidos. El objetivo es marcar cambios significativos para su revisión, no clasificar cada desviación como un defecto.
Combinar líneas base con el criterio del dominio
Una anomalía se vuelve útil solo después de verificar su contexto. Un proceso de conciliación de fin de mes puede producir un patrón recurrente. Un nuevo flujo de trabajo de registro puede cambiar intencionalmente qué campos se completan. Una migración de origen puede crear una transición temporal que requiera un manejo separado.
Revise las señales con una cadencia regular y conserve las observaciones. digna Data Analytics proporciona contexto histórico para tendencias, volatilidad, fallas recurrentes y diferencias entre períodos. Los analistas pueden preguntar cuándo comenzó el cambio, si afecta a todas las fuentes y si sigue un cronograma.
Utilice esta secuencia:
Detectar: Encontrar un cambio inusual en el volumen, la tasa de NULLs o la cobertura de registros completos.
Localizar: Desglosar la señal por origen, región, partición, tipo de registro o proceso.
Correlacionar: Compararla con implementaciones, cambios de esquema, eventos operativos y retrasos en la entrega.
Validar: Preguntar al propietario del dominio si el cambio es esperado.
Remediar: Corregir la fuente o el pipeline, luego confirmar que la métrica regrese a un estado aceptable.
Almacene las observaciones de completitud de manera consistente. La recolección diaria es adecuada para muchos conjuntos de datos operativos, mientras que los pipelines de alto volumen pueden necesitar comprobaciones más frecuentes. El análisis de tendencias es confiable solo cuando la definición de la métrica, el alcance y el comportamiento esperado se mantienen estables. Conserve esos detalles con cada observación para que las comparaciones posteriores no confundan un cambio de medición con un cambio en la calidad de los datos.
7. Evaluación de completitud de datos frente a precisión y validez
La completitud es necesaria, pero no responde a todas las preguntas sobre la calidad de los datos. La completitud pregunta si los datos requeridos están presentes. La precisión pregunta si representan correctamente la realidad. La validez pregunta si se ajustan a las reglas definidas.
Un número de teléfono demuestra claramente la diferencia:
Valor faltante: Un problema de completitud.
Presente pero con formato incorrecto: Un problema de validez.
Con formato correcto pero perteneciente a otra persona: Un problema de precisión.
La misma distinción se aplica a un ID de cliente. Un ID completado puede satisfacer una comprobación de completitud de campo mientras falla la validez si viola el formato o la relación esperados. También puede fallar la precisión si identifica al cliente equivocado.
Monitorear las dimensiones de forma conjunta
Utilice digna Data Validation para aplicar comprobaciones explícitas de valores requeridos, formatos, rangos, relaciones y lógica de negocio. Esta guía de herramientas de comprobación de validez proporciona un contexto útil para tratar la validación como algo más amplio que la detección de NULLs.
Una vista de calidad compartida debería mostrar las dimensiones por separado y en conjunto. La ruta de remediación difiere:
Falla de completitud: Encontrar por qué el valor, registro o período está ausente.
Falla de validez: Corregir la regla de formato, dominio, tipo o relación.
Falla de precisión: Comparar el valor con una fuente confiable o un evento del mundo real.
Los requisitos condicionales también importan. Un atributo puede ser obligatorio solo cuando otro campo indica que el registro es elegible. Una puntuación global de completitud rudimentaria puede penalizar omisiones de diseño válidas a menos que la regla incluya esa condición.
Evitar la falsa tranquilidad de una puntuación alta
Un conjunto de datos con cada campo obligatorio completado aún puede contener direcciones incorrectas, números de cuenta inválidos o montos de transacciones erróneos. Por el contrario, un conjunto de datos puede contener valores precisos para las filas que recibió mientras carece de un período de origen completo.
La completitud es evidencia de que la información requerida está presente. No es evidencia de que la información sea correcta, válida, oportuna o suficiente para cada análisis.
Priorice los problemas según su impacto en el negocio. Un campo constantemente completado con valores incorrectos puede crear un riesgo mayor que un atributo opcional con ausencias ocasionales. Los usuarios de negocio deben ayudar a definir esa prioridad porque comprenden cómo afecta cada defecto a los reportes, las operaciones, el Compliance y las decisiones.
8. Estrategia de monitoreo continuo
Un programa de completitud confiable combina validación determinista, detección de anomalías, monitoreo de puntualidad y análisis histórico. Cada capa responde a una pregunta diferente. La validación pregunta si se cumplen los requisitos conocidos. La detección de anomalías pregunta si el comportamiento actual difiere de la línea base normal. El monitoreo de puntualidad comprueba si los datos esperados llegan cuando se requieren, mientras que el análisis histórico muestra si una brecha es aislada, recurrente, estacional o si está empeorando.
Comience por definir qué hace que un registro sea utilizable y qué hace que un conjunto de datos sea utilizable. Luego conecte cada definición con la medición adecuada:
Validación de campos obligatorios: Detectar valores obligatorios faltantes, como un ID de cliente o el monto de una transacción.
Validación a nivel de registro: Confirmar que un registro elegible contenga todos los atributos necesarios para su uso previsto.
Monitoreo de recuento de registros: Identificar poblaciones faltantes o inesperadamente duplicadas.
Monitoreo de puntualidad: Detectar entregas retrasadas, adelantadas o ausentes.
Detección de anomalías: Marcar cambios inusuales en el volumen, las tasas de NULLs, el comportamiento de entrega o la cobertura de registros completos.
Análisis histórico: Comparar la completitud a lo largo de los períodos para identificar recurrencias y cambios a largo plazo.
Monitoreo de esquema: Detectar cambios estructurales que puedan introducir nuevas ausencias de datos.
Estas capas funcionan como varios instrumentos en un mismo panel de control. Una comprobación de campo puede mostrar que los valores están presentes, mientras que una comprobación de recuento de registros revela que una población de origen completa nunca llegó. Una alerta de puntualidad puede entonces explicar por qué cambiaron ambas señales.
digna respalda este modelo operativo a través de Data Validation, Data Anomalies, Data Analytics, Timeliness y Schema Tracker. El cálculo y análisis de métricas se ejecutan dentro de las bases de datos del cliente. Las opciones de despliegue en nube privada e instalaciones locales respaldan los requisitos de control empresarial.
Correlacionar señales antes de asignar la responsabilidad
Suponga que las fallas de validación aumentan mientras los recuentos de registros disminuyen y una fuente llega tarde. Juntas, estas señales pueden indicar una única extracción ascendente incompleta. Trate el evento como una única investigación en lugar de abrir tickets separados que oculten la conexión.
Una rutina práctica es:
Definir los campos obligatorios y los registros elegibles con los propietarios de negocio.
Establecer expectativas de volumen, cobertura de períodos y tiempos de llegada.
Aplicar comprobaciones deterministas a los requisitos conocidos.
Establecer líneas base para métricas de completitud importantes.
Correlacionar alertas entre validación, anomalías, puntualidad y cambios de esquema.
Revisar los problemas recurrentes y las tendencias con los propietarios de datos.
Revisar las reglas cuando cambien los procesos de negocio o los sistemas de origen.
Interprete la ausencia de datos de acuerdo con la elegibilidad, la codificación, el contexto de origen y el uso posterior. Se puede esperar un valor faltante para un registro no elegible, mientras que un período faltante o un conjunto de datos ausente puede indicar una falla en la entrega. Las investigaciones sobre mecanismos de datos faltantes señalan que los indicadores de presencia por sí solos pueden no mostrar si la ausencia de datos es estructuralmente informativa o sesgada.
Comparación de 8 puntos: Cómo medir la completitud de datos
Método | 🔄 Complejidad de implementación | ⚡ Requerimientos de recursos | 📊 Resultados esperados | 💡 Casos de uso ideales | ⭐ Ventajas clave |
|---|---|---|---|---|---|
Tasa de completitud de campos | Bajo, comprobaciones SQL/NULL simples | Bajo, cómputo/almacenamiento mínimo | % de completitud a nivel de campo; identificar campos faltantes | Cumplimiento de campos requeridos, auditorías, validaciones básicas | Transparente, fácil de implementar, accionable |
Monitoreo del recuento de registros | Bajo, recuentos periódicos y líneas base | Bajo, agregaciones ligeras, recuentos históricos | Detecta cargas faltantes y anomalías de volumen | Monitoreo de carga por lotes/transmisión, detección de fallas en pipelines | Detección rápida de conjuntos de datos faltantes; bajo costo |
Monitoreo de la tasa de NULLs | Medio, seguimiento de tendencias y establecimiento de líneas base | Medio, métricas históricas y monitoreo | Tendencias/picos en proporciones de NULLs a lo largo del tiempo | Campos donde la ausencia de datos indica cambios en los orígenes | Sensible a problemas emergentes; advertencias tempranas |
Evaluación de completitud de registros | Medio–Alto, reglas de múltiples campos por registro | Medio, cómputo de validación por registro | % de registros que cumplen con todos los atributos requeridos | Procesos posteriores que necesitan registros completos (suscripción de riesgos, facturación) | Métrica relevante para el negocio; prioriza la remediación |
Verificación de completitud de conjuntos de datos y períodos | Bajo, comprobaciones de presencia/cronograma | Bajo, comprobaciones mínimas + metadatos de cronograma | Confirma la llegada de conjuntos de datos/archivos y la cobertura del período | Lotes programados, reportes regulatorios/periódicos | Evita reportes con períodos faltantes; simple de aplicar |
Detección de anomalías y análisis de tendencias históricas | Alto, líneas base de ML y análisis de series de tiempo | Alto, almacenamiento histórico, cómputo de ML | Detecta desviaciones inusuales y degradación lenta | Pipelines complejos, patrones estacionales, monitoreo empresarial | Detecta problemas sutiles/graduales; menos falsos positivos |
Evaluación de completitud frente a precisión y validez | Alto, integra múltiples dimensiones de calidad | Alto, comprobaciones multidimensionales y herramientas | Perfil de calidad holístico (completitud+precisión+validez) | Data Governance, priorización de remediación, auditorías | Evita correcciones parciales; se enfoca en el impacto comercial |
Estrategia de monitoreo continuo (Integrada) | Alto, combina reglas, anomalías, analíticas | Alto, múltiples módulos, correlación de alertas | Cobertura integral con alertas correlacionadas y contexto | Empresas con pipelines críticos y fuentes heterogéneas | Combina las fortalezas de todos los métodos; reduce los problemas no detectados |
Del porcentaje de completitud a la confianza en los datos
Ninguna métrica única demuestra que un conjunto de datos esté completo para cada propósito. Una tasa de completitud de campos puede mostrar que los valores requeridos están completados, pero no revelará un archivo faltante, una región comercial ausente, una entrega tardía o una disminución lenta en el volumen de registros. Un porcentaje de registros completos puede mostrar que las filas son utilizables, pero no demostrará que llegó la población esperada.
El modelo de medición más sólido progresa a través de varios niveles:
A nivel de campo: ¿Están completados los valores requeridos?
A nivel de registro: ¿Cada registro utilizable contiene todos los atributos requeridos?
A nivel de volumen: ¿Llegó el número esperado de registros?
A nivel de conjunto de datos: ¿Están presentes los archivos, tablas y particiones esperados?
A nivel de período: ¿Los datos cubren cada fecha comercial o período de reporte requerido?
A nivel de puntualidad: ¿Llegaron los datos dentro de su ventana esperada?
A nivel de comportamiento: ¿Las tasas de NULLs, los recuentos y los valores completados se comportan normalmente?
A nivel de dimensión de calidad: ¿Los datos presentes también son precisos y válidos?
Esta vista estructurada evita que un estado de pipeline exitoso se convierta en una falsa señal de tranquilidad. También ayuda a los equipos a asignar al propietario correcto. Un valor obligatorio faltante puede pertenecer a un equipo de aplicación de origen. Una partición faltante puede pertenecer a la ingesta. Un archivo retrasado puede requerir una investigación del pipeline o del programador. Un cambio de esquema puede requerir coordinación con los consumidores intermedios.
Definir lo que es "completo" para la decisión
El nivel aceptable de completitud depende del uso previsto. Las pautas de calidad de datos de la Universidad de Greifswald señalan que no existe un límite universal para la ausencia de datos aceptable. La pregunta relevante es si los registros completos restantes respaldan la decisión, el reporte, el modelo o el proceso operativo.
Eso significa que un equipo de governance debería documentar:
Qué atributos son obligatorios.
Qué registros son elegibles para cada requisito.
Qué orígenes y períodos se esperan.
Qué ventana de entrega se aplica.
Qué brechas de completitud bloquean la publicación o el procesamiento.
Qué patrones de ausencia de datos requieren investigación incluso cuando se supera un umbral.
Luego mida tanto la puntuación como el motivo detrás de ella. Un único promedio puede ocultar una columna, origen, región o período crítico. Desglose las métricas por las dimensiones que importan al proceso y conserve suficiente historial para identificar fallas recurrentes.
Convertir el monitoreo en una práctica operativa
Una implementación práctica comienza con reglas deterministas para los requisitos conocidos. Agregue comprobaciones de volumen esperado y entrega. Establezca líneas base históricas para las tasas de NULLs y las poblaciones de registros. Cuando se active una alerta, investigue las señales correlacionadas en lugar de tratar cada métrica de forma independiente. Revisa las tendencias con los propietarios de negocio para que los cambios legítimos del proceso no se confundan con defectos.
digna ofrece una ruta modular para este trabajo. digna Data Validation puede aplicar valores requeridos y reglas de negocio a nivel de registro. digna Data Anomalies puede identificar cambios inusuales en el comportamiento relacionado con la completitud. digna Data Analytics puede proporcionar contexto histórico. digna Timeliness puede monitorear patrones de llegada y cargas faltantes. Schema Tracker puede detectar cambios estructurales que puedan introducir nuevos problemas de completitud.
La plataforma ejecuta comprobaciones y cálculos de métricas en las bases de datos del cliente, con opciones de despliegue en nube privada e instalaciones locales para organizaciones que necesitan que los datos permanezcan en su propio entorno. Esa arquitectura respalda un enfoque controlado en almacenes de datos, lagos y pipelines, mientras que un panel compartido ofrece a ingenieros, analistas y partes interesadas una vista común de incidentes y tendencias.
La completitud de datos (Data Completeness) no es solo un porcentaje. Es una declaración sobre si la información requerida para un propósito de negocio real está presente, disponible en el momento adecuado y es lo suficientemente estable como para confiar en ella. Mida los valores individuales, los registros completos, los volúmenes de registros, los períodos esperados, el comportamiento de entrega y los cambios históricos. Luego conecte esas señales con la precisión y la validez para que los equipos sepan no solo qué falta, sino también si los datos que llegaron pueden respaldar la decisión.
digna combina Data Validation, Data Anomalies, Data Analytics, Timeliness y Schema Tracker para ayudar a los equipos a monitorear la completitud en todos los datos empresariales. Visite digna para explorar una plataforma de Observability modular que se ejecuta en su entorno y le ayuda a investigar valores faltantes, cargas faltantes, cambios inusuales y problemas de calidad de datos relacionados.


