Analítica de autoservicio: una guía completa para 2026
|
6
minuto de lectura
La mayoría de los consejos sobre analítica de autoservicio comienzan con el problema equivocado. Tratan la parte difícil como si fuera la interfaz, y luego asumen que los paneles de control de arrastrar y soltar producirán, de algún modo, decisiones confiables por sí mismos. En las empresas reguladas, eso es al revés. La limitación radica en si la organización cuenta con una capa semántica gobernada, metadatos confiables, controles de acceso y comprobaciones de calidad de datos lo suficientemente sólidas como para permitir que los usuarios no técnicos se muevan rápidamente sin romper la lógica de los informes ni el cumplimiento (Compliance).
La categoría se volvió popular porque los usuarios de negocio querían hacer preguntas sin tener que esperar a los equipos centrales, y las plataformas modernas ahora facilitan esto con consultas en lenguaje natural, exploración visual y preparación automatizada. Pero el cambio histórico de los informes propiedad de TI al análisis por línea de negocio solo funciona cuando el entorno de datos está seleccionado, no cuando se deja caer a los usuarios en tablas en bruto y se les dice que lo resuelvan por sí mismos.
Tabla de Contenidos
Por qué fracasan la mayoría de las iniciativas de analítica de autoservicio
Componentes principales de la arquitectura de analítica de autoservicio
Modelos de gobernanza que equilibran la velocidad y el control
Lista de verificación para la selección de herramientas y estrategia de despliegue
Por qué fracasan la mayoría de las iniciativas de analítica de autoservicio
El modo de fallo más común es sencillo. Los equipos compran una herramienta de BI, la apuntan a datos compartidos y a eso lo llaman analítica de autoservicio. El primer mes parece prometedor porque la gente puede hacer clic por aquí y por allá y construir paneles de control. El segundo mes expone el problema central: comienza la desviación de métricas, la lógica de negocio se bifurca por equipo y ya nadie confía en los números.
Una herramienta no crea un significado compartido. Una capa semántica gobernada sí lo hace. Sin ella, un panel de control de finanzas calcula los ingresos de una manera, un equipo de ventas regional los calcula de otra, y la dirección obtiene dos versiones de la misma respuesta. Ahí es donde se rompe el autoservicio, no en la interfaz de usuario, sino en la ausencia de una capa de definición común.
La interfaz es la parte fácil
El diseño de arrastrar y soltar reduce la barrera de habilidades, pero también reduce la barrera para la inconsistencia si la gobernanza es débil. Los usuarios pueden crear paneles de control más rápido de lo que los analistas pueden revisarlos, lo que suena eficiente hasta que el catálogo se llena de conjuntos de datos duplicados e informes de aspecto similar que responden a diferentes preguntas de negocio. El resultado es la dispersión de paneles de control, no la autonomía.
Regla práctica: si un usuario de negocio puede construirlo más rápido de lo que un administrador de datos puede nombrarlo, aprobarlo y clasificarlo, la organización aún no tiene analítica de autoservicio. Tiene informes descontrolados.
El otro fracaso oculto es el acceso. Cuando los usuarios realizan consultas en tablas de producción en bruto, cada campo se convierte en un posible problema de política y cada consulta en un asunto de soporte. Es por eso que las implementaciones empresariales modernas separan la presentación del almacenamiento y colocan la aplicación de políticas entre ellos. El objetivo no es restringir a los usuarios. Es evitar que construyan accidentalmente sobre datos que no deberían ver, o que utilicen una métrica que nadie pueda reproducir más tarde.
Componentes principales de la arquitectura de analítica de autoservicio
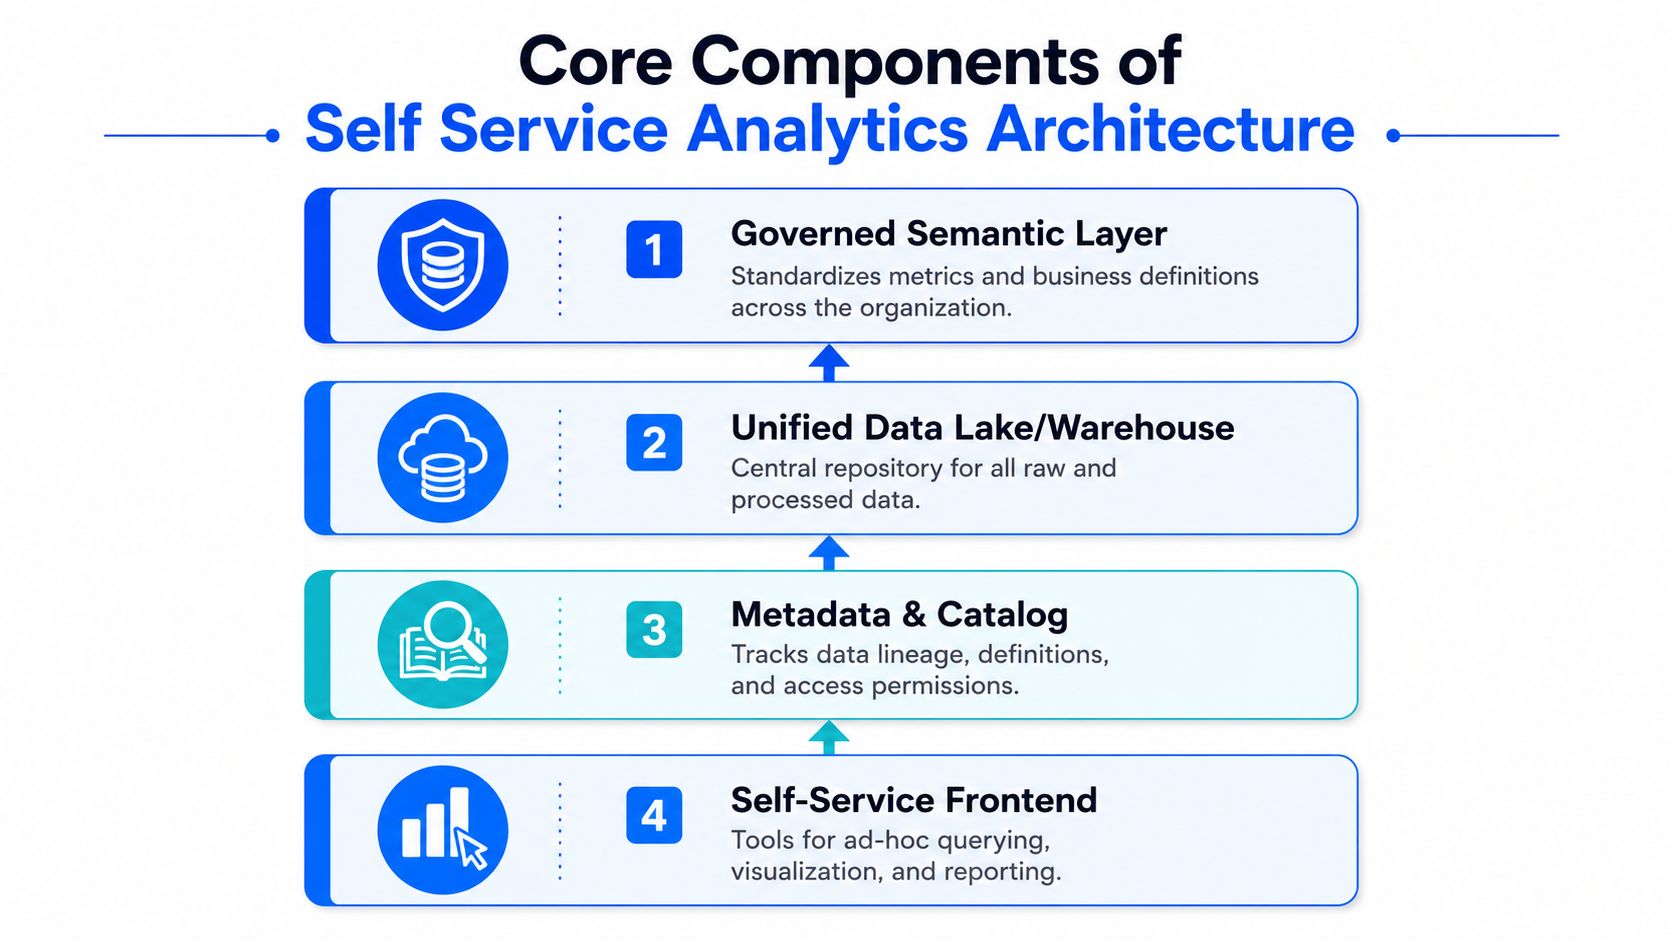
Una arquitectura empresarial que funcione necesita cuatro capas, cada una de las cuales resuelve un problema diferente. La pila de tecnologías no es complicada por capricho, es complicada porque cada capa elimina un modo de fallo específico. El objetivo es permitir que los usuarios se muevan de forma independiente mientras la plataforma mantiene intactos el significado, la seguridad y el rendimiento.
Significado gobernado antes que acceso amplio
La capa semántica gobernada es la parte que muchas organizaciones posponen, y suele ser la razón por la que la adopción se vuelve complicada más adelante. Estandariza las definiciones de negocio para que un KPI signifique lo mismo en todos los departamentos, incluso si las visualizaciones difieren. Eso importa más que cualquier pulido visual en la interfaz, porque los usuarios pueden tolerar una interfaz ligeramente tosca, pero no tolerarán discusiones sobre el significado de una métrica.
La capa de catálogo y metadatos viene a continuación, porque los usuarios no pueden descubrir lo que no pueden encontrar. Los buenos metadatos les indican quién es el propietario de un conjunto de datos, qué tan fresco es, qué contiene y de dónde proviene su linaje. En la práctica, eso transforma el descubrimiento de datos de una búsqueda a ciegas a un proceso de selección, razón por la cual las plataformas y los equipos de datos siguen insistiendo en los glosarios de negocio y los catálogos de búsqueda en lugar de más hojas de cálculo ad hoc.
La capa de control de acceso es donde la gobernanza se vuelve real en lugar de aspiracional. Los permisos basados en roles, el acceso específico a conjuntos de datos y los flujos de trabajo de solicitud para datos restringidos evitan que el autoservicio se convierta en una exposición descontrolada. Esto es especialmente importante en entornos financieros, sanitarios, de telecomunicaciones y del sector público, donde la auditabilidad forma parte del modelo operativo.
El aislamiento del rendimiento importa más de lo que la gente piensa
La última capa es el cómputo autoaprovisionado, o alguna forma equivalente de aislar el trabajo ad hoc de las cargas de trabajo de producción compartidas. Sin cuotas o cómputo en entornos aislados (sandboxed), unas pocas uniones (joins) exploratorias pueden ralentizar el almacén de datos para todos los demás. Eso no solo perjudica el rendimiento, sino que destruye la confianza en la plataforma.
Un punto de referencia sólido para los flujos de trabajo de descubrimiento de datos es el descubrimiento de datos en entornos empresariales gobernados, porque la misma disciplina que ayuda a los usuarios a encontrar conjuntos de datos también les ayuda a evitar su uso indebido. Los equipos que evalúan a los socios de entrega también pueden comparar cómo enfoca el trabajo de analítica gobernada la oferta de análisis de datos de Bidwell, especialmente cuando la organización necesita tanto usabilidad empresarial como disciplina en la plataforma.
Una plataforma que expone tablas en bruto y lo llama empoderamiento está ahorrando tiempo de configuración a costa de la confianza futura.
Modelos de gobernanza que equilibran la velocidad y el control
La gobernanza no es un modelo único. Es un conjunto de compensaciones entre consistencia, autonomía y sobrecarga operativa. El enfoque equivocado suele ser el que suena más simple en una presentación de diapositivas. El control centralizado es seguro, la gobernanza federada es práctica y las configuraciones completamente descentralizadas son rápidas solo hasta la primera disputa sobre la definición de un KPI o una política de acceso.
Tres modelos, tres riesgos diferentes
El control centralizado funciona cuando la presión de cumplimiento (Compliance) es alta y las poblaciones de usuarios son pequeñas. Cada solicitud fluye a través de un equipo de datos central, lo que brinda consistencia y una revisión estricta, pero también crea una cola de espera. Ese modelo protege las definiciones, pero ralentiza el negocio y puede hacer que el autoservicio parezca un ejercicio de marca en lugar de un cambio operativo real.
La gobernanza federada es el modelo que terminan adoptando la mayoría de las empresas reguladas porque divide la responsabilidad de una manera útil. Los equipos centrales estandarizan las métricas principales, las reglas de acceso y los umbrales de calidad. Los equipos de dominio crean informes y visualizaciones dentro de esos límites. Eso mantiene la autonomía lo suficientemente alta para que los equipos se muevan, al tiempo que preserva los estándares empresariales que la dirección y los auditores necesitan.
La gobernanza descentralizada y democrática otorga a los equipos la mayor libertad. Puede funcionar en entornos pequeños y de bajo riesgo con usuarios muy alineados, pero es frágil a escala empresarial. Las definiciones se desvían, la lógica duplicada se propaga y nadie puede saber qué panel de control es el definitivo. Si la organización ya tiene problemas con la consistencia de las métricas, este modelo empeora el problema.
Modelo | Fortaleza | Debilidad | Mejor encaje |
|---|---|---|---|
Control centralizado | Máxima consistencia | Aprobaciones más lentas | Casos de uso estrechos y altamente regulados |
Gobernanza federada | Equilibrio entre autonomía y estándares | Requiere una gestión disciplinada (governance) | Grandes empresas con múltiples dominios |
Descentralizado y democrático | Experimentación local más rápida | Mayor riesgo de desviación de métricas | Equipos pequeños, menor presión de cumplimiento (Compliance) |
Convertir las políticas en reglas operativas
Las buenas listas de verificación de gobernanza son concretas. Un catálogo debe mostrar la propiedad, la frecuencia de actualización, notas sobre la calidad y definiciones de negocio para los campos clave. Los procedimientos de acceso deben detallar quién puede ver qué, cómo solicitar datos restringidos y qué comprobaciones de privacidad o cumplimiento (Compliance) se aplican antes de la aprobación. Las reglas de validación deben ser visibles para las personas que usan los datos, no estar ocultas en algún sistema de tickets.
Es por eso que la estrategia de Data Governance debe diseñarse como un modelo operativo, no como un documento de políticas. Si las reglas no están integradas en el análisis diario, los usuarios crearán soluciones alternativas. Una vez que eso sucede, la gobernanza comienza a existir solo en papel.
Las mejores configuraciones federadas no intentan eliminar la variación local. Mantienen estables las métricas principales y permiten que los equipos adapten la capa de presentación a sus propias preguntas. Ese es el equilibrio que preserva la velocidad sin permitir que los informes se fragmenten en versiones competidoras de la verdad.
Requisitos de calidad de datos y Observability
El autoservicio falla cuando la calidad de los datos es invisible. Un panel de control puede parecer correcto mientras la carga subyacente está obsoleta, un esquema cambia sin previo aviso o una regla a nivel de registro se rompe de una manera que solo afecta a un equipo descendente. Los usuarios no ven la causa raíz, solo ven que el informe dejó de coincidir con la realidad.
Qué se necesita monitorear
La primera puerta es el monitoreo de ingesta. Si los datos llegan tarde, incompletos o en el formato incorrecto, el análisis descendente hereda el problema de inmediato. La segunda puerta es el seguimiento de esquemas y linaje, porque las adiciones de columnas, los cambios de tipo y las transformaciones ascendentes pueden invalidar los paneles de control sin previo aviso. La tercera es la detección de anomalías, que ayuda a sacar a la superficie rupturas estadísticas que los umbrales simples pasan por alto. La cuarta es un panel de calidad que hace visibles la frescura, la precisión y la cobertura tanto para los ingenieros como para las partes interesadas del negocio.
Estas comprobaciones importan más en empresas que no pueden simplemente enviar datos sensibles al entorno de un proveedor para su inspección. La ejecución dentro de la base de datos mantiene el análisis dentro de los sistemas controlados por el cliente, lo cual es la opción adecuada cuando las restricciones de privacidad, residencia o cumplimiento (Compliance) son estrictas. También reduce la cantidad de esfuerzo especializado necesario para el monitoreo rutinario, porque la plataforma puede vigilar los datos allí donde ya residen.
Una secuencia práctica de monitoreo
Comprobar la frescura primero. Las cargas tardías crean informes obsoletos antes de que alguien se dé cuenta. Si la Timeliness no es visible, los usuarios de negocio asumen que el panel de control está actualizado cuando no lo está.
Hacer seguimiento de los cambios estructurales a continuación. El seguimiento de esquemas detecta campos renombrados o eliminados antes de que se rompa una capa de BI.
Estar atento a los valores atípicos y a la desviación. Las anomalías en el volumen, la distribución o las reglas de negocio a menudo aparecen antes de que los humanos las detecten en un panel de control.
Exponer los resultados en una vista compartida. Los paneles de calidad hacen evidente qué conjuntos de datos son lo suficientemente estables para el autoservicio y cuáles necesitan atención.
Regla general: la calidad de los datos para el autoservicio no es una tarea de back-office. Es el plano de control para cada informe, modelo y decisión que depende de datos compartidos.
Los programas de Observability más sólidos no inundan a los equipos con alertas. Reducen el ruido al aprender el comportamiento de referencia y mostrar las excepciones que importan. Esa es la diferencia entre el monitoreo como un teatro y el monitoreo como una salvaguarda operativa.
Casos de uso empresariales en industrias reguladas
Un proveedor de seguros sociales es un ejemplo útil de lo que cambia cuando la gobernanza se diseña adecuadamente. El equipo dejó de mantener 9,000 reglas de calidad de datos creadas a mano y pasó a la detección de anomalías impulsada por IA, lo que redujo las alertas diarias de más de 140 a señales accionables. La lección exacta no se trata solo del recuento de alertas. Se trata de que el mantenimiento de reglas dejó de dominar el flujo de trabajo de calidad, por lo que los ingenieros pudieron dedicar tiempo a los fallos que cambiaban los resultados.
Ese patrón se repite en todos los sectores regulados. En el sector de la salud, el monitoreo de Timeliness detecta cargas de datos tardías antes de que los paneles de control de atención al paciente se queden obsoletos. En telecomunicaciones, el seguimiento de esquemas protege los análisis de facturación de cambios ascendentes que, de otro modo, se propagarían en cascada en informes rotos. En finanzas y el sector público, la necesidad es más amplia, porque la presentación de informes reproducibles y la auditabilidad importan tanto como la comodidad del usuario.
Para los equipos que necesitan rutas educativas estructuradas en torno a estos cambios operativos, cursar un MBA en operaciones y cadena de suministro puede ayudar a los profesionales a comprender el control de procesos, aunque el trabajo de analítica en sí sigue dependiendo de un diseño de plataforma sólido y de la disciplina de gobernanza.
What these deployments have in common
Las organizaciones que logran que el autoservicio perdure no tratan a todos los conjuntos de datos de la misma manera. Separan las métricas estándar de alta confianza del trabajo experimental. También asignan la propiedad claramente, de modo que los analistas saben quién cura la capa semántica, quién aprueba el acceso y quién responde cuando aparece un problema de datos.
La parte importante no es que cada industria tenga gráficos diferentes. Es que cada una tiene una tolerancia al error diferente. Un panel de facturación, un panel de pacientes y un informe de beneficios públicos necesitan controles independientes, incluso si se encuentran en la misma plataforma.
Implementation Roadmap and Success Metrics
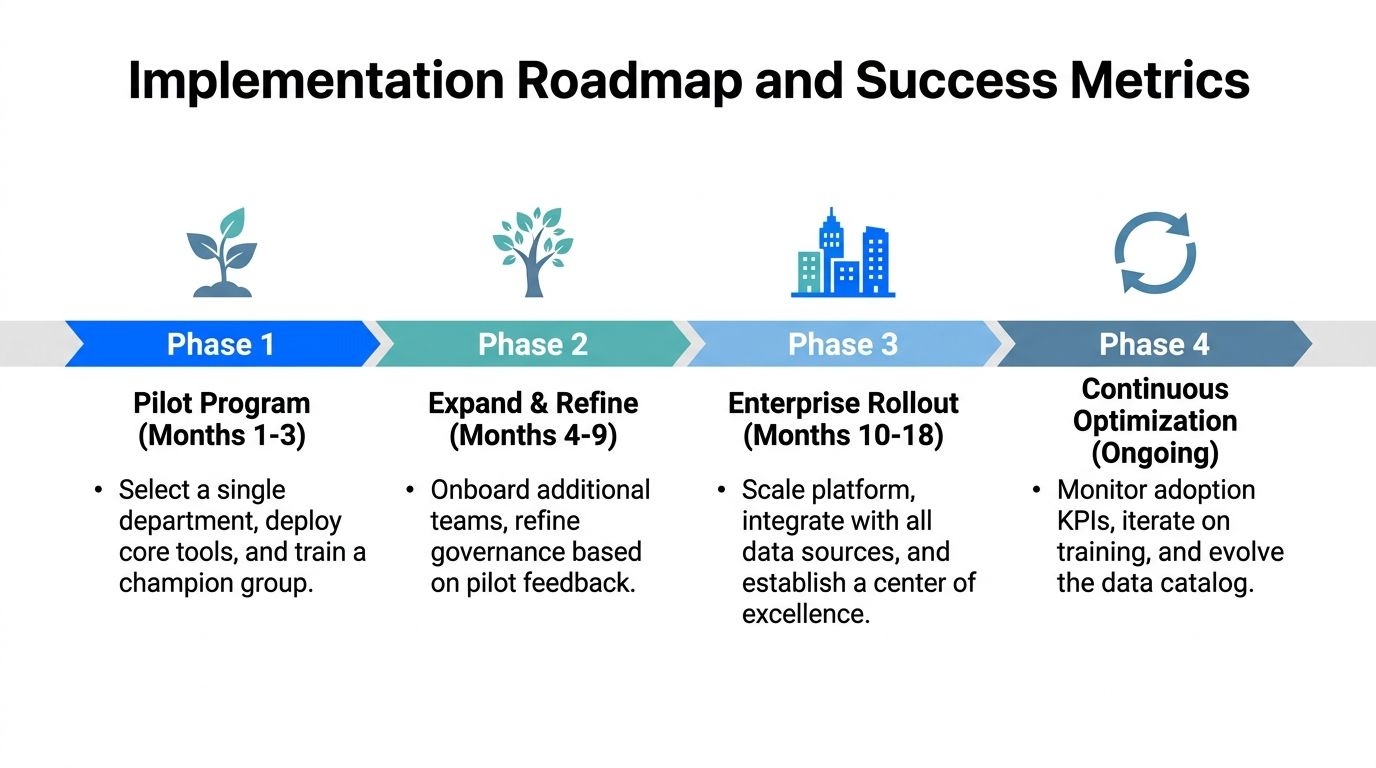
La ruta de despliegue más limpia es aquella que se mantiene pequeña el tiempo suficiente para demostrar el modelo. Comience con un equipo piloto que tenga una presión empresarial real pero un radio de impacto limitado, y luego expándase solo después de que las definiciones, el acceso y las comprobaciones de calidad se mantengan firmes bajo el uso diario. Si el piloto crece demasiado rápido, la gobernanza se diluye antes de que el proceso sea estable.
Measure the rollout like an operating program
Las métricas correctas son operativas, no estéticas. El tiempo de obtención de información (time-to-insight) indica si los usuarios se mueven más rápido. La carga de trabajo del equipo de datos muestra si los analistas se ven libres de solicitudes repetitivas. La adopción del panel de control indica si el negocio confía en la plataforma lo suficiente como para usarla. La frecuencia de incidentes de calidad de datos muestra si el entorno se está volviendo más seguro o simplemente más concurrido.
Esas medidas funcionan mejor cuando se les hace seguimiento juntas. Si el tiempo de obtención de información mejora pero la frecuencia de incidentes aumenta, la organización podría estar moviéndose rápido a costa de la confianza. Si la adopción es baja y la carga de trabajo nunca disminuye, la plataforma puede ser útil pero no estar integrada en el trabajo diario. El objetivo es vigilar el equilibrio, no solo la velocidad.
Common rollout mistakes
Expandir el piloto demasiado pronto: Los equipos a menudo añaden más departamentos antes de que la capa semántica y las reglas de gobernanza estén estables.
Capacitar de forma insuficiente a los usuarios: Una plataforma de autoservicio sin inducción (onboarding) solo traslada la confusión del equipo de datos al usuario de negocio.
Ignorar el trabajo de mantenimiento: Los glosarios, los permisos y las comprobaciones de calidad necesitan una propiedad continua, no un lanzamiento único.
Tratar los paneles de control como el producto: El producto es el modelo operativo que mantiene confiables los paneles de control.
Los mejores programas evolucionan hacia un centro de excelencia que cura definiciones compartidas, apoya a los equipos de dominio y mantiene saludable el catálogo. Eso es lo que convierte la analítica de autoservicio de un despliegue de herramientas a una capacidad duradera.
Tool Selection Checklist and Deployment Strategy
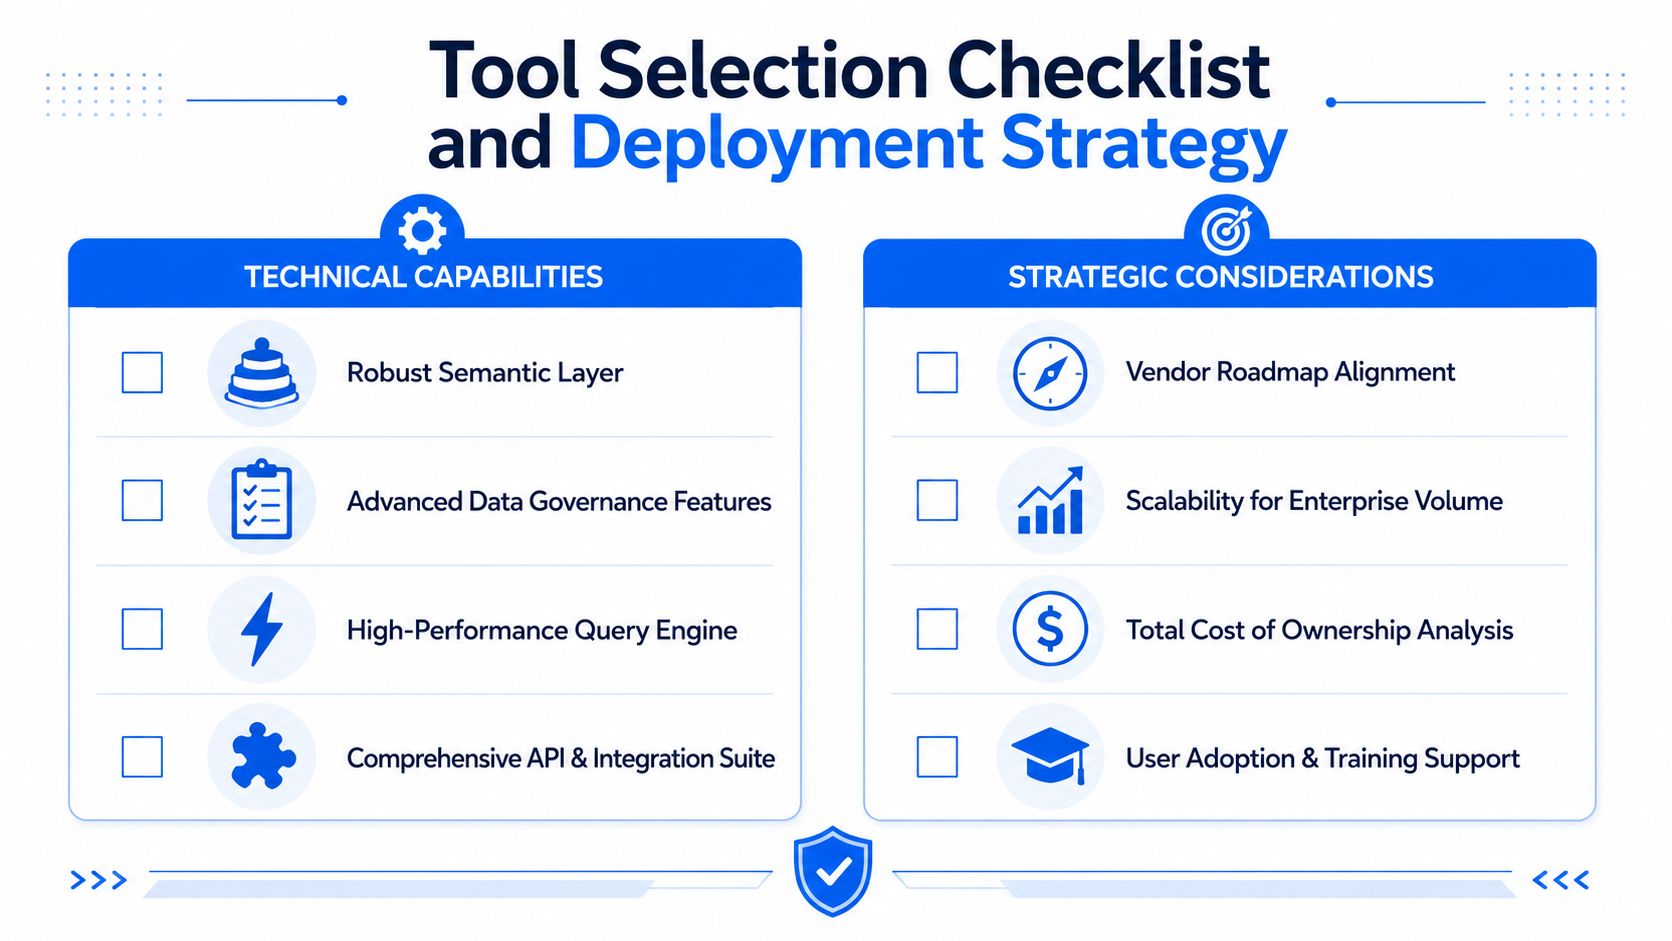
La selección de herramientas debe comenzar con la arquitectura, no con capturas de pantalla. Una interfaz pulida es útil, pero no compensará un soporte semántico débil, una automatización de gobernanza deficiente o una plataforma que no se adapte a su modelo de seguridad. Los compradores empresariales deben evaluar las herramientas de la misma manera que evalúan la infraestructura, preguntándose qué se rompe bajo un uso real.
What to check before you buy
Soporte sólido para la capa semántica. Verifique que las definiciones de negocio se puedan centralizar y reutilizar entre equipos.
Funciones de Data Governance. Confirme que el acceso basado en roles, las aprobaciones y la aplicación de políticas estén integrados.
Integración de Observability. Asegúrese de que el seguimiento de calidad, frescura y esquemas se pueda conectar al flujo de trabajo analítico.
Flexibilidad de despliegue. La nube privada, las instalaciones locales (on-premise) o los entornos controlados por el cliente importan cuando la residencia de los datos es una limitación.
Profundidad de API e integración. La plataforma debe encajar en los almacenes de datos, catálogos y herramientas de tuberías (pipelines) existentes.
Escalabilidad para volumen empresarial. El éxito del piloto no significa que la plataforma pueda sobrevivir a una adopción amplia.
Soporte para capacitación y adopción. Los usuarios de negocio necesitan habilitación, no solo acceso.
Costo total de propiedad. Los costos ocultos suelen aparecer en la sobrecarga de gobernanza y la carga de soporte, no en la línea de la licencia.
Una buena estrategia de despliegue es escalonada. Ejecute la nueva plataforma en paralelo con la pila de informes actual el tiempo suficiente para validar los resultados y detectar brechas. Incorpore a los usuarios en oleadas, comenzando con el grupo que más se beneficiará y que pueda tolerar algún cambio de proceso. Mantenga disponible la ruta anterior hasta que el nuevo flujo de trabajo sea de confianza.
La comprobación más importante es si la herramienta ayuda a la organización a imponer un significado consistente sin ralentizar a los usuarios. Si no puede hacer eso, no importará lo bien que se haya visto la demostración.
Si está desarrollando analítica de autoservicio para una empresa regulada, digna puede ayudarle a implementar la capa de calidad y Observability sin exponer datos sensibles a un entorno de terceros. Visite digna para ver cómo la detección de anomalías dentro de la base de datos, el monitoreo de Timeliness, el seguimiento de esquemas y la validación respaldan una analítica confiable a escala.


