10 alternativas a Bigeye para Data Observability
|
7
minuto de lectura

Elegir una alternativa a Bigeye basada únicamente en la detección de anomalías repite el problema que los compradores intentan resolver. La mayoría de las plataformas consolidadas pueden identificar comportamientos inusuales de volumen, frescura, esquema o distribución. Difieren de manera más marcada en dónde se ejecutan las comprobaciones, cómo validan los equipos los registros, cómo se cubren el linaje y los pipelines, cómo ingresan las alertas en los flujos de trabajo operativos, cómo escala la fijación de precios y cuánto control de la infraestructura conserva el cliente.
Esa distinción importa porque los equipos de observabilidad aún pasan un tiempo sustancial reaccionando después de que los usuarios se encuentran con datos erróneos. Una encuesta a líderes de gestión de datos reveló que solo el 7% resuelve los problemas de datos antes de que los usuarios se vean afectados, mientras que el 39% pasa entre el 20 y el 40% de su tiempo solucionando problemas en los pipelines. La misma investigación encontró que el 51% necesita unas pocas horas y el 36% necesita unos días o más para resolver un solo incidente, lo que hace que la prevención, la velocidad de investigación y el ajuste del despliegue sean más importantes que una larga lista de funciones. (Resumen del informe Kensu de CDO Magazine)
La siguiente comparación evalúa diez alternativas a Bigeye frente a criterios empresariales prácticos: ubicación de los datos, cobertura de anomalías, validación, puntualidad, monitoreo de esquemas, despliegue, señales de precios y esfuerzo de migración. También mapea cada opción con las capacidades modulares de digna, para que los equipos puedan distinguir una amplia suite de observabilidad SaaS de una plataforma en base de datos diseñada para operaciones en nube privada, VPC o local (on-premises).
Tabla de contenidos
1. digna
Dónde encaja mejor digna
2. Monte Carlo Data
La compensación frente al control en la base de datos
3. Acceldata
Amplia cobertura frente a una adopción focalizada
4. Anomalo
La detección de anomalías no es toda la capa de control
5. Soda
Dónde importa la propiedad de las reglas
6. Metaplane, ahora parte de Datadog
Inicio rápido, perímetro empresarial más estrecho
7. IBM Data Observability por Databand
El ajuste depende de la propiedad y las adquisiciones
8. Lightup
Activación automática frente a un despliegue modular controlado
9. Telmai
Los formatos abiertos cambian la prueba de migración
10. Kensu
Profundidad de instrumentación frente a ejecución residente en datos
Las 10 mejores alternativas a Bigeye: comparación de características
Convierta la lista de preseleccionados en una decisión de migración segura
1. digna
digna es la opción más sólida cuando el control del despliegue y la residencia de los datos coexisten con la cobertura de observabilidad. Se ejecuta dentro del propio entorno del cliente, incluyendo una nube privada, VPC o centro de datos local, y realiza el cómputo de métricas y las comprobaciones dentro de las bases de datos del cliente. Esa arquitectura mantiene los datos de producción en su lugar, reduce el movimiento innecesario y respalda los requisitos de governance para datos sensibles de finanzas, atención médica, telecomunicaciones y sector público. La orientación sobre el monitoreo en la base de datos respalda este modelo porque las comprobaciones pueden ejecutarse donde residen los datos en lugar de copiar registros sensibles a otro lugar. (Guía de monitoreo de calidad de datos de digna)
La plataforma combina la detección automática con controles deterministas. Data Anomalies aprende el comportamiento normal e identifica continuamente cambios inusuales sin requerir que los equipos escriban cada regla de monitoreo. Timeliness aprende los patrones de entrega esperados y marca las llegadas faltantes, tardías o tempranas. Data Validation aplica reglas de negocio a nivel de registro, mientras que Schema Tracker detecta cambios estructurales como columnas añadidas o eliminadas y tipos de datos modificados. Data Analytics añade análisis de volatilidad y tendencias históricas, lo que ayuda a los equipos a separar un evento único de un patrón de confiabilidad que empeora.
Dónde encaja mejor digna
El diseño modular de digna permite que un equipo comience con una capacidad y se expanda a medida que madura su modelo operativo. El programador, el catálogo de datos, las integraciones y las funciones de colaboración están disponibles desde la selección del módulo inicial, y un panel compartido ofrece a los ingenieros de datos, analistas y partes interesadas una vista común de incidentes, tendencias y estado. El proveedor afirma que la instalación hasta los primeros conocimientos toma menos de dos horas, una afirmación que de todos modos debe probarse frente a los permisos, la topología de la base de datos y la revisión de seguridad del comprador.
La fijación de precios utiliza una tarifa base más un cargo por tabla activa y por módulo. El modelo no tiene tarifas por API, volumen de escaneo o volumen de alertas, lo que brinda al área de compras una señal de uso más clara que la fijación de precios que cambia con cada consulta o notificación. La contrapartida es que una presencia de tablas muy grande puede requerir un dimensionamiento cuidadoso, y el despliegue privado traslada las responsabilidades de infraestructura, permisos y mantenimiento al cliente.
Regla práctica: Elija digna cuando mantener los datos dentro de su entorno sea un requisito de primer orden, luego valide el costo total frente a las tablas activas y los módulos seleccionados antes de firmar.
Consulte la plataforma de data observability digna para conocer la arquitectura y el modelo de módulos.
Pros: Ejecución en la base de datos, despliegue privado, monitoreo de anomalías y puntualidad impulsado por IA, validación a nivel de registro, seguimiento de esquemas, flujos de trabajo compartidos y licencias modulares.
Contras: El precio por tabla activa y por módulo requiere dimensionamiento para grandes entornos, y el despliegue privado requiere propiedad operativa interna.
2. Monte Carlo Data
Monte Carlo Data es una amplia suite de observabilidad para organizaciones que monitorean almacenes de datos, lagos, sistemas ETL, activos de BI y pipelines de IA o agentes. Sus monitores automatizados cubren frescura, volumen, esquema y distribución, mientras que la detección de anomalías basada en aprendizaje automático identifica desviaciones del comportamiento esperado. El linaje a nivel de columna y de panel conecta los incidentes con los activos descendentes, ayudando a los equipos a evaluar el impacto más allá de la tabla afectada.
La plataforma también respalda la respuesta operativa. El triaje de incidentes y el enrutamiento de alertas a Slack, Jira y herramientas relacionadas conectan la detección con la propiedad y la remediación. Esto convierte a Monte Carlo en un candidato para pilas de datos modernas y grandes con muchos conectores y flujos de trabajo establecidos. Los compradores deben verificar que el linaje llegue a las columnas, paneles y etapas del pipeline específicos utilizados por sus equipos.

La compensación frente al control en la base de datos
El elemento diferenciador de Monte Carlo es la amplitud operativa. digna adopta un enfoque diferente al ejecutar comprobaciones dentro de las bases de datos del cliente y combinar la detección de anomalías con puntualidad, validación, seguimiento de esquemas y análisis históricos a través de una interfaz modular. Por lo tanto, la decisión depende del modelo operativo: Monte Carlo se adapta a los equipos que priorizan el linaje y la cobertura del ecosistema, mientras que digna se adapta a los equipos que requieren que los datos permanezcan en su entorno.
El despliegue y la migración requieren su propia prueba de concepto. Los equipos deben probar la cobertura de los conectores, la precisión del linaje, la propiedad de las alertas, las reglas de validación y el esfuerzo necesario para traducir los monitores existentes de Bigeye. Los precios de Monte Carlo no se muestran públicamente, por lo que el área de compras debe solicitar una cotización basada en el alcance monitoreado y los requisitos de integración.
Pros: Amplia cobertura de conectores, linaje de extremo a extremo, flujos de trabajo de incidentes y alcance a escala empresarial.
Contras: Los precios se basan en cotizaciones y la amplitud puede superar las necesidades inmediatas de un equipo más pequeño.
Revise esta alternativa de enterprise data observability de Monte Carlo para comparar su arquitectura y enfoque modular con el modelo operativo más amplio de Monte Carlo.
3. Acceldata
Acceldata se dirige a entornos heterogéneos donde la calidad de los datos es solo una parte de la confiabilidad. Su alcance abarca plataformas de datos, pipelines, trabajos, costos y rendimiento, incluidos entornos de nube, locales, híbridos, Hadoop y de big data en general. Eso lo hace especialmente relevante para los equipos de plataforma que modernizan la infraestructura heredada sin tener que volver a estructurar cada carga de trabajo antes de que pueda comenzar la observabilidad.
La plataforma organiza las operaciones en torno a un modelo de observar, detectar, diagnosticar y actuar. En la práctica, los compradores deben evaluar qué tan bien conecta ese flujo de trabajo las señales de calidad con la ejecución del pipeline, el comportamiento de la plataforma, la governance y la optimización. Data Observability Cloud de Acceldata añade flujos de trabajo parametrizados y documentación, mientras que su posicionamiento híbrido aborda un punto ciego común en las herramientas diseñadas primero para la nube.
Amplia cobertura frente a una adopción focalizada
Acceldata puede ser una opción sólida para grandes entornos con múltiples generaciones de tecnología, pero su amplitud puede superar lo que necesita un equipo de análisis pequeño. Los precios se gestionan a través del equipo de ventas y están restringidos, por lo que una prueba de concepto debe incluir el esfuerzo de despliegue, los límites de propiedad y el costo de activar capacidades que el equipo tal no utilice de inmediato.
digna aborda la misma inquietud empresarial a través de la modularidad y la ejecución en la base de datos. Sus módulos Data Anomalies, Timeliness, Data Validation, Schema Tracker y Data Analytics se enfocan en el comportamiento y la confiabilidad de los datos mientras mantienen los cálculos dentro de las bases de datos del cliente. Acceldata es el candidato de preselección más natural cuando el rendimiento de la plataforma, la infraestructura y la governance deben coexistir en la misma vista operativa. digna es más atractiva cuando el despliegue controlado y la adopción modular incremental son las restricciones primarias.
Utilice las herramientas de data observability de digna como punto de referencia al comparar la amplitud de la plataforma con el monitoreo enfocado residente en los datos.
Pros: Soporte híbrido y local, amplia visibilidad de la plataforma y combinación de observabilidad, governance y optimización.
Contras: El alcance puede ser excesivo para equipos más pequeños y la fijación de precios requiere la intervención de ventas.
4. Anomalo
Anomalo es una plataforma de calidad de datos nativa de IA construida en torno a la detección automatizada de problemas con una escritura mínima de reglas. Su enfoque no supervisado está diseñado para identificar comportamientos anormales en datos estructurados, semiestructurados y no estructurados, y luego respaldar la investigación de la causa raíz. Eso lo hace atractivo para los equipos que desean cobertura de anomalías rápidamente sin mantener una gran biblioteca de comprobaciones creadas manualmente.
Su énfasis en el ecosistema es claro. Las integraciones profundas con Databricks, Snowflake y socios de catálogo pueden reducir la fricción de configuración cuando esos sistemas ya respaldan el entorno de datos. Se dispone de opciones de despliegue empresarial y acuerdos de nivel de servicio, pero el comprador aún debe distinguir la detección de anomalías del control determinista. Un modelo puede identificar que un conjunto de datos cambió inesperadamente, mientras que una regla crítica para el negocio aún requiere una condición de validación explícita.
La detección de anomalías no es toda la capa de control
digna cubre el mismo caso de uso de anomalías de baja configuración a través de Data Anomalies, pero añade módulos separados para Data Validation, Timeliness y Schema Tracker. Esa separación importa para los equipos que necesitan tanto líneas base aprendidas como reglas de negocio auditables. Un control de desviación de esquema, por ejemplo, compara una estructura entrante con un esquema de referencia u objetivo y alerta cuando cambian las columnas o los tipos de datos. (Guía práctica de detección de desviación de esquema)
Los precios de Anomalo no son públicos y requieren la intervención de ventas. Los detalles de autoservicio publicados también son más limitados que los de algunos competidores de SaaS, por lo que la planificación de la migración debe incluir una evaluación técnica, una revisión de seguridad y un análisis comercial en lugar de depender únicamente de una demostración del producto.
Pros: Escritura mínima de reglas, incorporación rápida centrada en anomalías, opciones de despliegue empresarial y sólidas integraciones con almacenes de datos.
Contras: La fijación de precios no es pública y los equipos pueden necesitar controles adicionales para la aplicación explícita de reglas de negocio y requisitos de despliegue en la base de datos.
5. Soda
Soda combina una ruta de entrada de código abierto con un producto de observabilidad gestionado. Soda Core admite comprobaciones y contratos de datos como código, incluidas definiciones basadas en YAML y comprobaciones integradas, para que los ingenieros puedan colocar la validación dentro del desarrollo de pipelines y los flujos de trabajo de CI/CD. Soda Cloud añade monitoreo de métricas, establecimiento de líneas base históricas, detección de anomalías, colaboración y flujos de trabajo de governance.
Ese modelo dual cambia la cuestión de la migración. Un equipo puede comenzar con una CLI y un flujo de trabajo de código abierto, para luego pasar a capacidades gestionadas cuando necesite monitoreo y colaboración centralizados. Este camino puede reducir la dependencia del proveedor, pero la observabilidad avanzada y la governance siguen estando asociadas con el producto gestionado Cloud, no solo con la capa de código abierto.
Dónde importa la propiedad de las reglas
Soda se adapta a los equipos que desean que los ingenieros expresen las expectativas de calidad de los datos cerca del código y la orquestación. Está menos alineado directamente con las organizaciones que desean un monitoreo aprendido de anomalías y entregas sin mantener extensas definiciones de pruebas. digna ofrece ambos lados a través de los módulos automáticos Data Anomalies y Timeliness, además de los módulos explícitos Data Validation y Schema Tracker.
La frescura y la Timeliness deben probarse por separado durante la migración. La frescura comprueba si los registros llegaron dentro de un intervalo esperado, mientras que la puntualidad se pregunta si los datos pasaron a estar disponibles dentro del intervalo de decisión. (Guía de control de calidad de datos empresariales) Esa distinción puede exponer brechas ocultas por un monitor genérico de "frescura".
La lista pública de precios de Soda Cloud no está publicada, por lo que los compradores necesitan una cotización basada en las fuentes, las comprobaciones, los usuarios y el alcance gestionado.
Pros: Entrada de código abierto, comprobaciones como código, integración en pipelines y un camino claro hacia la observabilidad gestionada.
Contras: La colaboración avanzada y la governance requieren Soda Cloud, y los precios de Cloud se gestionan a través de ventas.
Compare los modelos operativos en esta alternativa a Soda para la calidad de datos empresariales.
6. Metaplane, ahora parte de Datadog
Metaplane se enfoca en una incorporación rápida de SaaS para pilas de datos modernas. Su detección de anomalías basada en aprendizaje automático tiene en cuenta la estacionalidad y las tendencias, mientras que el linaje a nivel de columna y el análisis de impacto ayudan a los equipos a comprender las consecuencias descendentes. Data CI/CD detecta regresiones en las solicitudes de extracción (pull requests), y las alertas en Slack o Microsoft Teams conectan la detección con la comunicación de ingeniería existente.
La opción Snowflake Native App representa una distinción arquitectónica significativa. Mantiene los datos en el almacén y permite el pago mediante créditos de Snowflake, lo que puede simplificar la revisión de seguridad y las compras para equipos centrados en Snowflake. Sin embargo, esto no equivale a un control amplio de nube privada o local. Los compradores con entornos heterogéneos o regulados deben probar cómo cambia la profundidad de las funciones fuera de la ruta de Snowflake.
Inicio rápido, perímetro empresarial más estrecho
La ruta de entrada gratuita para siempre de Metaplane admite la experimentación, y su modelo de acceso de solo lectura puede facilitar las discusiones iniciales de seguridad. La contrapartida es la amplitud de funciones. Es posible que no reemplace a una suite empresarial más grande cuando los equipos necesitan una governance amplia, múltiples modelos de despliegue o una cobertura profunda en plataformas más antiguas.
El punto de comparación de digna no es solo la velocidad de incorporación. Ofrece ejecución en la base de datos, despliegue en nube privada o local, un panel compartido y módulos que cubren anomalías, puntualidad, validación, cambios de esquema y análisis históricos. Los equipos deben comparar el tiempo necesario para conectar una fuente representativa, configurar permisos, investigar una alerta y producir evidencia para la governance.
Un punto de partida útil es esta explicación de qué hace una plataforma de observabilidad, para luego validar los detalles frente a su propio almacén y pila de orquestación.
Pros: Incorporación rápida, entrada gratuita, acceso de solo lectura, linaje, comprobaciones de CI/CD y una opción de despliegue nativa de Snowflake.
Contras: La suite es más estrecha que las plataformas empresariales más grandes y las capacidades varían según los sistemas de datos.
7. IBM Data Observability por Databand
IBM Data Observability por Databand se centra en la confiabilidad de los pipelines y los trabajos. Monitorea trabajos, realiza un seguimiento de los acuerdos de nivel de servicio y alerta a los equipos sobre fallas o riesgos de entrega en las herramientas de orquestación y almacenes de datos. El marco de soporte, compras, documentación y contratación de IBM puede ser decisivo para las empresas reguladas que ya están estandarizadas en los servicios de IBM.
Esta opción se centra menos en el autoservicio ligero y más en adaptar la observabilidad a un modelo operativo empresarial establecido. Los equipos deben esperar un proceso de adquisición e implementación definido por los estándares internos, los requisitos de soporte y la governance de la integración. La experiencia puede ser adecuada para organizaciones que valoran la responsabilidad del proveedor y la continuidad de la contratación por sobre la activación rápida de pruebas.
El ajuste depende de la propiedad y las adquisiciones
La fijación de precios se gestiona mediante contratos y puede utilizar licencias por unidades de recursos en algunos SKU. Esto dificulta una comparación directa a menos que el comprador defina los trabajos monitoreados, los entornos, los usuarios, las expectativas de soporte y los supuestos de renovación antes de solicitar una cotización.
digna ofrece una ruta diferente. Sus licencias modulares comienzan con un módulo y se expanden por tabla activa y módulo, mientras que su arquitectura en la base de datos mantiene el análisis dentro del entorno del cliente. Por lo tanto, la comparación práctica se realiza entre un modelo de confiabilidad de pipelines centrado en IBM y un modelo modular de calidad y observabilidad de datos que incluye Data Anomalies, Data Analytics, Timeliness, Data Validation y Schema Tracker.
IBM es un candidato de preselección sensato cuando los canales existentes de soporte y compras de IBM tienen un peso sustancial. digna merece una evaluación más detallada cuando los ingenieros de datos y los equipos de governance necesitan una interfaz compartida tanto para el comportamiento aprendido como para los controles de calidad explícitos.
Pros: Soporte de IBM, contratación empresarial, documentación, alineación de governance y monitoreo de SLA de pipelines.
Contras: La experiencia puede ser menos de autoservicio y la fijación de precios se gestiona mediante ventas, siendo posible la licencia por unidades de recursos en algunas ofertas.
8. Lightup
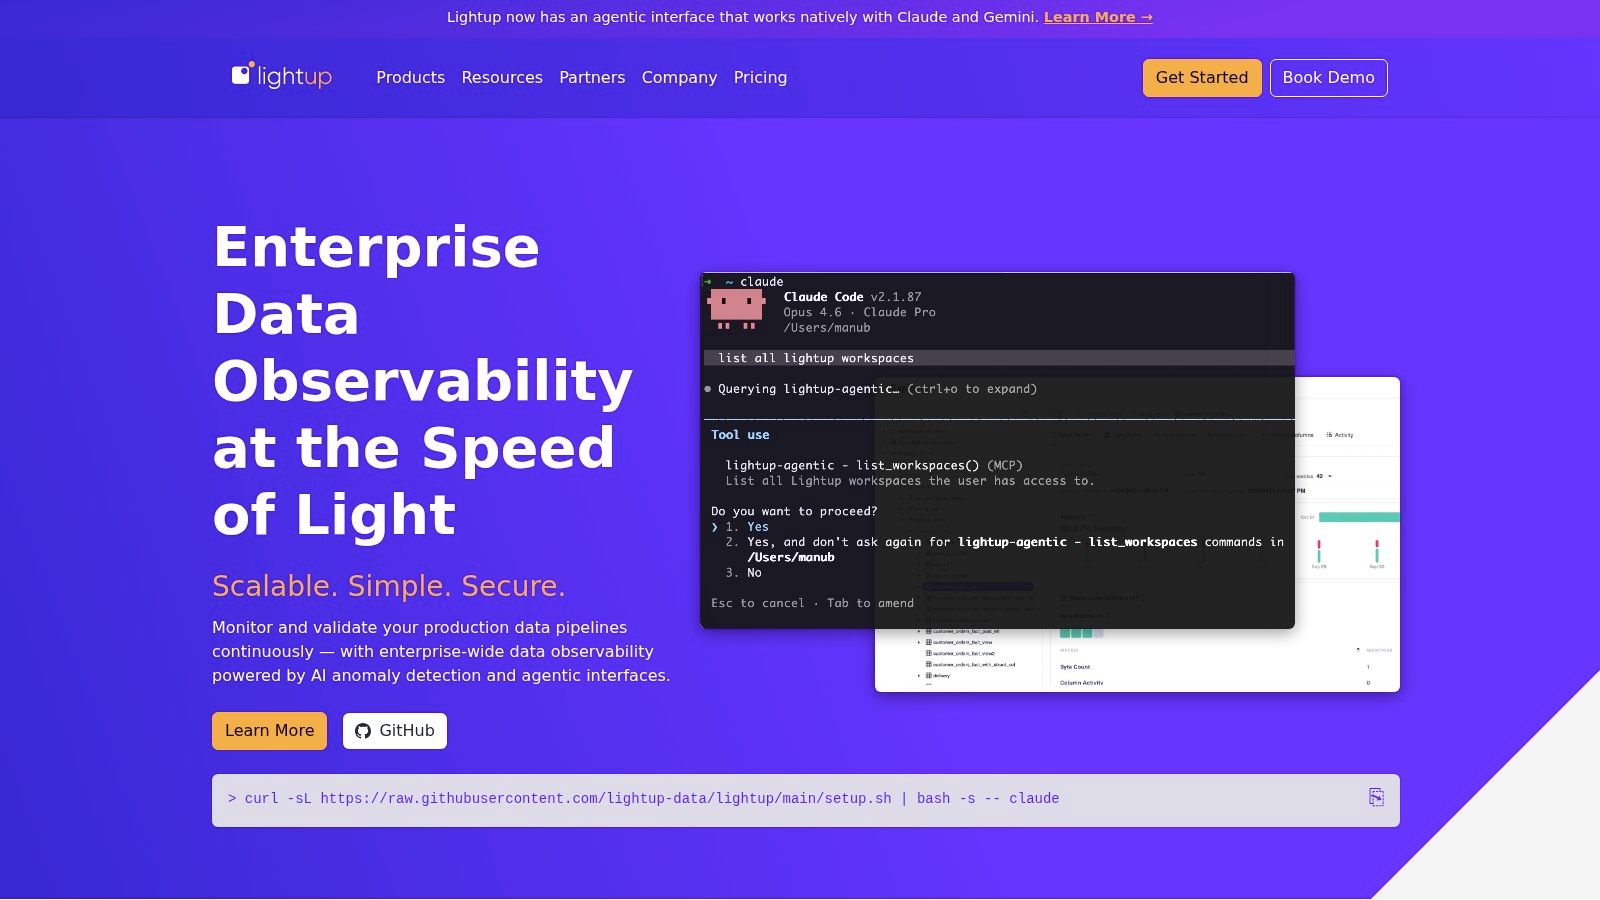
Lightup combina comprobaciones basadas en reglas con detección de anomalías por IA, linaje, conciliación y gestión de incidentes. Su enfoque Zero-Config Auto Metrics está diseñado para crear una cobertura de línea base rápidamente, mientras que las recomendaciones de IA ayudan a los equipos a identificar dónde puede ser útil un monitoreo adicional. Las integraciones con Collibra, Alation, sistemas de tickets y herramientas de alerta extienden la plataforma a los flujos de trabajo de governance e incidentes.
La estructura de los planes Cloud y Enterprise ofrece a los compradores una pregunta útil sobre el despliegue en lugar de una simple pregunta sobre las características. Un despliegue en la nube puede reducir la responsabilidad operativa, mientras que las opciones empresariales o híbridas pueden adaptarse mejor a las restricciones de residencia de datos y acceso. La evaluación debe confirmar dónde se realiza el cálculo de métricas, qué datos de producción salen del entorno y cómo se administran los permisos.
Activación automática frente a un despliegue modular controlado
La rápida activación de Lightup puede acortar el tiempo hasta la primera cobertura. digna ofrece una idea similar de adopción incremental a través de licencias modulares, pero su elemento diferenciador es que las comprobaciones y el cálculo de métricas se ejecutan dentro de las bases de datos del cliente. Eso puede importar más que la velocidad de configuración inicial para los equipos que manejan datos de producción sensibles.
No hay precios públicos disponibles en dólares, por lo que la cotización debe separar las tarifas de la plataforma, el alcance monitoreado, el nivel de despliegue, las integraciones y el soporte. Los compradores también deben probar si las métricas generadas automáticamente producen incidentes útiles o simplemente amplían la superficie de alertas. El objetivo no es activar todos los monitores posibles. Es identificar las fallas de manera temprana sin obligar a los ingenieros a revisar eventos de bajo valor.
Pros: Configuración rápida de línea base, detección de anomalías por IA, linaje, conciliación, integraciones de governance y rutas de despliegue en la nube o empresariales.
Contras: Los precios requieren una cotización y la visibilidad de su ecosistema es menor que la de los líderes de mercado más grandes.
9. Telmai
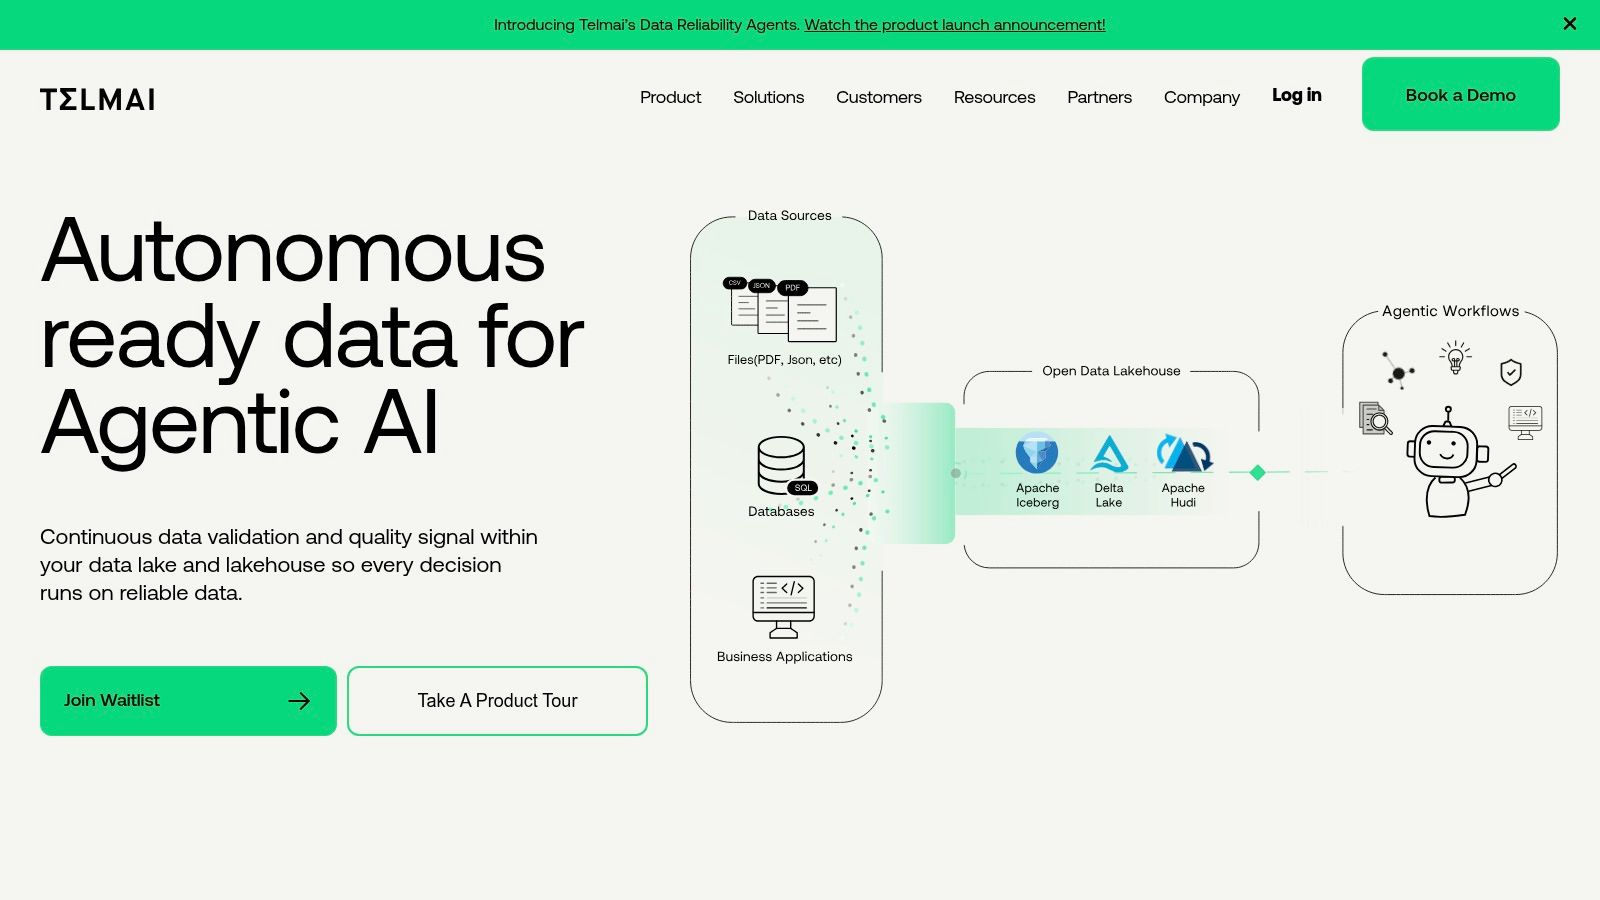
Telmai está diseñado para arquitecturas abiertas y entornos de lakehouse construidos en torno a Iceberg, Hudi o Delta. Su posicionamiento sin código y de bajo código, la detección de anomalías sin reglas, el monitoreo de desviaciones, las comprobaciones de puntualidad, el monitoreo de esquemas y las consultas de problemas en inglés simple se dirigen a equipos que desean una amplia cobertura sin construir cada detector manualmente.
La función Root-cause Investigator de la plataforma tiene como objetivo ir más allá de la primera alerta hacia la explicación. La disponibilidad en AWS Marketplace también puede simplificar una prueba inicial o una ruta de compra para equipos que ya operan a través de AWS. Esa conveniencia no elimina la necesidad de modelar el alcance monitoreado, las responsabilidades de despliegue y la forma en que la plataforma interactúa con los formatos de tabla abiertos.
Los formatos abiertos cambian la prueba de migración
Telmai es un candidato sólido cuando la apertura del lakehouse es el principal requisito arquitectónico. El ajuste de digna es más fuerte cuando el equipo también necesita ejecución en la base de datos, despliegue privado, validación a nivel de registro, puntualidad aprendida por IA y una interfaz compartida que abarque a ingenieros, analistas y partes interesadas de la governance.
La práctica de la observabilidad de datos generalmente agrupa la calidad, la frescura, el linaje y los cambios de esquema como señales de monitoreo centrales, con comprobaciones en tiempo real que ayudan a prevenir fallas en los análisis descendentes y la IA. (Investigación sobre señales de observabilidad de datos) Durante una POC, compare no solo si ambas plataformas detectan la misma desviación, sino también si cada una puede explicar el problema en el lenguaje operativo preferido del equipo.
Los precios de Telmai no son públicos y dependen del alcance monitoreado y del despliegue. Su presencia en la comunidad también es menor que la de los proveedores establecidos desde hace más tiempo, por lo que los compradores deben evaluar la documentación, el soporte de implementación y la propiedad interna.
Pros: Sólida adaptación a lakehouse y formatos abiertos, cobertura de anomalías sin reglas, investigación en lenguaje natural y disponibilidad en AWS Marketplace.
Contras: Los precios dependen de la cotización y la presencia en la comunidad es menor que la de los proveedores establecidos.
10. Kensu
Kensu utiliza agentes desplegables para observar los datos en movimiento y en reposo. Su enfoque instrumenta los pipelines donde se utilizan los datos, recopilando linaje en tiempo real, esquemas y métricas de calidad en herramientas como dbt, Databricks o Spark, Azure Data Factory y Snowflake. Eso puede reducir los puntos ciegos en entornos distribuidos donde un monitor exclusivo del almacén ve el destino pero no la ruta de transformación que lo produjo.
Los controles de tipo interruptor de circuito y los flujos de trabajo de incidentes extienden a Kensu más allá de la notificación pasiva. Una Edición de la Comunidad y opciones de prueba de concepto pueden ayudar a los desarrolladores a evaluar el modelo de instrumentación antes de comprometerse con un despliegue más amplio. La pregunta clave de la migración es si el equipo desea agentes integrados en los pipelines o prefiere comprobaciones que se ejecuten directamente en la base de datos.
Profundidad de instrumentación frente a ejecución residente en datos
El modelo de Kensu de observar donde se usan los datos puede revelar un contexto que el monitoreo exclusivo de tablas pasa por alto. digna toma un camino diferente con la ejecución en la base de datos, manteniendo el cálculo y el análisis de métricas dentro de las bases de datos del cliente mientras cubre anomalías, análisis, puntualidad, validación y cambios de esquema a través de módulos separados.
Los precios de Kensu no están publicados y suelen gestionarse a través del equipo de ventas. Los detalles del sitio web también son más escasos que los de proveedores más grandes, y parte del material se entrega a través de la documentación o canales profesionales. Por lo tanto, la evaluación debe incluir un recorrido de la implementación, permisos de los agentes, comportamiento ante fallas, responsabilidad de actualización y retención de evidencia.
Pros: Instrumentación de pipelines en tiempo real, monitoreo de linaje y esquemas, visibilidad distribuida y opciones de evaluación de la comunidad.
Contras: La fijación de precios no es pública y los equipos deben evaluar la sobrecarga operativa de desplegar y mantener agentes.
Las 10 mejores alternativas a Bigeye: comparación de características
Proveedor | Capacidades principales | Puntos únicos de venta | Público objetivo | Despliegue y Seguridad | Precios y Valor |
|---|---|---|---|---|---|
🏆 digna | Detección de anomalías, Timeliness, validación de registros, Schema Tracker, métricas y análisis en base de datos | ✨ Ejecución en base de datos, aprendizaje de línea base por IA, despliegue modular, rápido tiempo de obtención de valor (TTV) ★★★★★ | 👥 Ingenieros de datos, BI/análisis, governance; finanzas/atención médica/telecomunicaciones/sector público | Se ejecuta dentro de la infraestructura del cliente (nube privada/VPC/local); el proveedor no accede a los datos de producción | 💰 Precios modulares transparentes: base + por tabla activa/módulo; predecible pero dependiente de la escala |
Monte Carlo Data | Monitores de frescura, volumen, esquema y distribución; linaje de columnas/paneles; flujos de trabajo de incidentes | ✨ Amplia cobertura de conectores/pilas de tecnología; sólidas referencias empresariales ★★★★ | 👥 Grandes empresas con diversas pilas de tecnología y equipos de análisis | Conectores en la nube/SaaS en almacenes de datos, lagos, ETL, BI | 💰 Precios empresariales basados en cotizaciones; puede ser pesado para equipos pequeños |
Acceldata | Observabilidad de plataformas/pipelines/trabajos, costos, rendimiento, flujos de trabajo parametrizados | ✨ Soporte híbrido/local + enfoque en governance y optimización ★★★★ | 👥 Entornos grandes y heterogéneos; empresas que modernizan big data | Opciones de despliegue en la nube, local e híbrido; controles empresariales | 💰 Precios gestionados por ventas; adecuado para grandes entornos |
Anomalo | Detección de anomalías no supervisada, análisis de causa raíz, integraciones (Databricks/Snowflake) | ✨ Detección sin reglas, rápido tiempo de obtención de valor ★★★★ | 👥 Equipos que necesitan una detección rápida de anomalías sin reglas pesadas | SaaS con opciones de despliegue empresarial; sólidas integraciones en la nube | 💰 Basado en cotizaciones; SLAs empresariales disponibles |
Soda | Comprobaciones/contratos como código (Soda Core OSS); Soda Cloud para establecimiento de líneas base y alertas | ✨ Entrada de código abierto (más de 50 comprobaciones) → ruta de migración a Cloud gestionado ★★★ | 👥 Desarrolladores/ingenieros que desean una ruta centrada en código abierto e integración en pipelines | Código abierto (CLI) + Cloud gestionado; se integra con almacenes de datos y orquestadores | 💰 Código abierto gratuito; Soda Cloud = contacto con ventas para precios |
Metaplane (Datadog) | Detección de anomalías por ML, linaje de columnas, Data CI/CD, Snowflake Native App | ✨ Incorporación rápida, nivel gratuito para siempre, opción nativa de Snowflake ★★★★ | 👥 Equipos pequeños a medianos, organizaciones centradas en Snowflake, POCs rápidas | SaaS + Snowflake Native App (los datos permanecen en el almacén) | 💰 Nivel gratuito disponible; planes de pago / precios de Datadog |
IBM Data Observability (Databand) | Observabilidad de pipelines/trabajos, seguimiento de SLA, integraciones de orquestación y almacenes de datos | ✨ Soporte de IBM, compras y ajuste empresarial/regulatorio ★★★ | 👥 Empresas reguladas y compradores estandarizados en IBM | Despliegues empresariales, soporte de IBM/marcos de productos | 💰 Precios gestionados por contratos/ventas; modelo de compras empresariales |
Lightup | Comprobaciones de reglas + detección de anomalías por IA, linaje, conciliación, gestión de incidentes | ✨ Zero-config Auto Metrics para una cobertura rápida ★★★ | 👥 Equipos que desean una cobertura automática rápida y colaboración | Planes Cloud y Enterprise; opciones híbridas | 💰 Basado en cotizaciones; claridad en los planes Cloud vs Enterprise |
Telmai | Observabilidad de lagos/lakehouse (Iceberg/Hudi/Delta), desviaciones/puntualidad/esquemas, consultas en inglés simple | ✨ Enfoque en formatos abiertos, consultas de problemas en inglés simple, disponibilidad en AWS Marketplace ★★★ | 👥 Equipos de lakehouse, entornos de formatos abiertos, preparación para GenAI | Despliegues en la nube; opción de compra en Marketplace (AWS) | 💰 Precios por alcance; se requiere interacción con ventas |
Kensu | Linaje basado en agentes, métricas de esquema y calidad, observaciones y perfiladores en tiempo real | ✨ Observación de dónde se usan los datos; edición de comunidad/POC ★★★ | 👥 Equipos que necesitan instrumentación en tiempo real y evaluación de desarrollo | Despliegue de agentes en pipelines; telemetría en tiempo real | 💰 Precios gestionados por ventas; Edición de la Comunidad para evaluación |
Convierta la lista de preseleccionados en una decisión de migración segura
La alternativa adecuada a Bigeye depende menos de la cantidad de monitores en una demostración que de cómo se comporta la plataforma frente a la ubicación real de sus datos, el modelo de propiedad y el proceso de incidentes. La demanda del mercado se está moviendo en esa dirección. Un estudio de mercado proyecta la categoría de data observability desde 3.51 mil millones de USD en 2026 hasta 6.03 mil millones de USD para 2031, con una tasa de crecimiento anual compuesta esperada del 11.42% durante ese período. (Estudio de mercado de data observability de 2026) El crecimiento por sí solo no identifica el producto adecuado, pero sí indica que los equipos están tomando una decisión de infraestructura a largo plazo en lugar de comprar una capa de alerta temporal.
Comience con un inventario, no con una tarjeta de puntuación de proveedores. Elabore una lista de tablas, pipelines, paneles, modelos y consumidores operativos críticos. Marque qué activos contienen datos sensibles, qué sistemas se ejecutan en redes privadas o locales y qué cargas de trabajo no pueden tolerar la copia de datos de producción. Luego clasifique los controles requeridos:
Cobertura de anomalías: Identifique los comportamientos que necesitan líneas base aprendidas, incluidos el volumen, la distribución, las métricas comerciales y las señales de la plataforma.
Requisitos de puntualidad: Defina los intervalos de llegada y de decisión por separado. Un conjunto de datos puede llegar dentro de un intervalo nominal de frescura y aun así perder el momento en que un proceso comercial lo necesita.
Reglas de validación: Documente la lógica de negocio a nivel de registro, los controles regulatorios, las condiciones de conciliación y las comprobaciones que deben permanecer explícitas en lugar de inferidas.
Monitoreo de esquemas: Especifique cómo deben afectar las columnas añadidas, los campos eliminados y los cambios de tipo a los consumidores descendentes.
Flujo de trabajo de investigación: Mida si un ingeniero puede pasar de la alerta al activo afectado, la causa probable, el propietario y la remediación sin tener que alternar entre herramientas desconectadas.
Pruebe a los finalistas con cargas de trabajo representativas, no con una muestra limpia. Incluya una tabla de alto valor, un pipeline retrasado, un cambio de esquema planificado, un cambio de distribución inesperado y una violación de reglas. Compare la calidad de las alertas, el tiempo de investigación, la utilidad del linaje y el esfuerzo necesario para ajustar los monitores. No cuente las alertas como un éxito. Cuente las alertas que conducen a una acción clara.
El modelado de costos necesita el mismo realismo. Algunos proveedores cotizan por alcance monitoreado, otros usan señales de recursos o uso, y digna utiliza una tarifa base más un precio por tabla activa y por módulo, sin tarifas por API, volumen de escaneo o volumen de alertas. Pida a cada proveedor que modele el crecimiento utilizando sus tablas activas, módulos seleccionados, entornos, integraciones y requisitos de soporte. La evidencia de la dispersión de herramientas es importante aquí: el 46.7% de las organizaciones ejecutan de dos a tres herramientas de observabilidad en paralelo, mientras que solo el 7.4% depende de una única plataforma unificada. (Resumen de la encuesta independiente sobre observabilidad) La consolidación puede mejorar la claridad del flujo de trabajo, pero solo si el reemplazo cubre los controles que obligaron a los equipos a añadir herramientas complementarias.
El mapeo de módulos de digna proporciona una base de comparación práctica:
Data Anomalies: Aprendizaje de línea base impulsado por IA y detección continua de anomalías sin configuración manual de reglas.
Data Analytics: Análisis estadístico, de volatilidad y de tendencias históricas para comprender la confiabilidad a lo largo del tiempo.
Timeliness: Cronogramas de entrega aprendidos por IA, tiempos de entrega esperados, cargas tardías, datos faltantes y llegadas tempranas.
Data Validation: Aplicación de reglas de negocio a nivel de registro para controles de calidad, auditoría y compliance.
Schema Tracker: Detección continua de columnas añadidas o eliminadas y cambios de tipo de datos.
Ejecución en la base de datos: Cómputo de métricas y análisis dentro de las bases de datos del cliente, manteniendo los datos en su lugar.
Opciones de despliegue: Instalación en nube privada o local dentro de la nube, VPC o centro de datos del cliente.
Panel compartido: Una interfaz para ingenieros, analistas, equipos de governance y otras partes interesadas.
Componentes incluidos: Programador, catálogo de datos, integraciones y funciones de colaboración desde la selección del módulo inicial.
Licencias modulares: Comience con un módulo y expándase por tabla activa y módulo.
Disciplina de migración: Mantenga a Bigeye y la alternativa seleccionada ejecutándose con las mismas cargas de trabajo representativas el tiempo suficiente para comparar la detección, la investigación, el comportamiento de los costos y el esfuerzo de propiedad.
Documente los criterios de reversión antes de que comience la migración. Decida qué constituye un ruido de alertas inaceptable, incidentes no detectados, cómputo inesperado, integraciones fallidas o evidencia insuficiente para la governance. Avance por fases, comenzando con un conjunto delimitado de activos críticos y expandiéndose solo después de que los propietarios confirmen que el nuevo flujo de trabajo funciona. Retire Bigeye después de que el reemplazo haya demostrado cobertura, manejo de incidentes, controles de acceso y comportamiento de costos en producción, no simplemente después de que compras haya aprobado el contrato.
La mejor opción puede ser Monte Carlo para un linaje amplio, Acceldata para entornos híbridos de pila completa, Soda para comprobaciones como código, Metaplane para una incorporación rápida en pilas modernas, Telmai para formatos de lakehouse abiertos, Kensu para instrumentación de pipelines basada en agentes, o IBM Data Observability de Databand para operaciones empresariales centradas en IBM. Puede ser digna cuando los requisitos decisivos sean el despliegue privado, la ejecución residente en datos, la adopción modular, el monitoreo aprendido de anomalías y puntualidad, la validación explícita y el control de esquemas. El ajuste depende de la arquitectura y del modelo operativo, por lo que la preselección debe finalizar con una prueba de carga de trabajo y una decisión de propiedad, no con una clasificación genérica.
digna combina la detección de anomalías impulsada por IA, el monitoreo de puntualidad, la validación a nivel de registro, el seguimiento de esquemas, el análisis histórico y la ejecución en la base de datos dentro de su propio entorno. Visite digna para evaluar una alternativa modular a Bigeye para los requisitos de su plataforma de datos, governance y confiabilidad.


