Was ist eine Parquet-Datei und warum nutzen Teams sie?
|
9
min. Lesezeit
Parquet ist ein quelloffenes spaltenorientiertes Dateiformat, das gleichartig typisierte Werte zusammen ablegt und Footer-Metadaten nutzt, damit Query-Engines nur die benötigten Spalten lesen und irrelevante Daten überspringen können. Es entstand als gemeinsame Anstrengung von Twitter und Cloudera, erschien erstmals im Juli 2013 und wurde am 27. April 2015 zum Top-Level-Projekt der Apache Software Foundation.
Wenn Sie hier sind, haben Sie vermutlich eines von drei Problemen. Ihre Warehouse-Abfragen wurden langsamer, nachdem ein Datensatz gewachsen ist. Ihr Lake ist voller CSV-Exporte, die sich leicht erzeugen, aber mühsam scannen lassen. Oder Ihr Team nutzt bereits Parquet, doch die Leistung schwankt weiterhin heftig zwischen „schnell genug“ und „warum läuft dieses Dashboard in einen Timeout?“
Diese Verwirrung ist normal. Die meisten Erklärungen beantworten was ist eine Parquet-Datei mit einer Zeile: „ein komprimiertes spaltenorientiertes Format“. Das stimmt, ist aber unvollständig. In der Praxis geht es bei Parquet ebenso sehr um Metadaten, Schemadisziplin und Entscheidungen zum Dateilayout wie um Kompression.
Ein sauberer Parquet-Datensatz kann sich mühelos anfühlen. Ein unordentlicher kann teure Scans, brüchige nachgelagerte Jobs und merkwürdiges Verhalten erzeugen, wenn Schemata über Dateien hinweg auseinanderlaufen. Deshalb lieben Data Engineers Parquet und beschweren sich zugleich darüber.
Inhaltsverzeichnis
Wie spaltenorientierte Speicherung einfach erklärt funktioniert
Bewährte Praktiken für Partitionierung, Schemaevolution und Tempo
Einführung in Parquet für moderne Analytik
Eine vertraute Szene: Eine Analytics Engineerin öffnet ein Modell, das früher schnell durchlief, ergänzt zwei weitere Monate Daten, und plötzlich schleppt sich jede Abfrage. Die Rohdaten liegen im Objektspeicher. Manche Dateien sind CSV, manche JSON-Exporte, manche Parquet. Das BI-Team will schnellere Dashboards. Das Plattformteam will geringere Scankosten. Niemand will jede Pipeline neu schreiben.
An dieser Stelle kommt meist Parquet ins Gespräch.
Apache Parquet wurde als quelloffenes, spaltenorientiertes Dateiformat für effiziente Speicherung und Abfrage geschaffen, mit Entwurfsideen, die von Googles Dremel-Forschung beeinflusst waren. Es entstand aus einer gemeinsamen Anstrengung von Twitter und Cloudera, erschien erstmals im Juli 2013 und wurde am 27. April 2015 zum Top-Level-Projekt der Apache Software Foundation, wie die Projekthistorie von Apache Parquet zeigt.
Für moderne Analytik ist der Reiz einfach. Parquet organisiert Daten so, wie Analystinnen große Tabellen abfragen. Die meisten analytischen Workloads lesen nicht jedes Feld jedes Datensatzes. Sie lesen eine Teilmenge der Spalten, wenden Filter an und aggregieren.
Warum Teams von Rohdateien zu Parquet wechseln
Ein zeilenbasierter Export wie CSV ist leicht einzusehen, zwingt Engines aber, sich durch Daten zu wühlen, die oft nicht gebraucht werden. Parquet ist für eine andere Aufgabe gebaut.
Spaltenfokussierte Lesevorgänge: Es funktioniert gut, wenn Abfragen wenige Spalten über viele Zeilen berühren.
Speichereffizienz: Gleichartig typisierte Werte liegen zusammen, was die Kompression besser wirken lässt.
Engine-freundliche Metadaten: Reader können Dateimetadaten nutzen, um das Scannen irrelevanter Teile eines Datensatzes zu vermeiden.
Der Haken ist, dass Parquet kein universeller Standard für alles ist. Für analytische Scans ist es großartig. Es ist nicht wie eine OLTP-Speicher-Engine für häufige Einzelzeilen-Zugriffe und -Updates entworfen.
Parquet hilft am meisten, wenn Ihr Zugriffsmuster breit und analytisch ist, nicht transaktional und zeilenweise.
Diese Unterscheidung zählt in Lakehouse-Umgebungen noch mehr, wo die Wahl des Dateiformats mit Partitionierung, Schemaevolution und Abfrageplanung zusammenspielt. Wenn Sie einen solchen Stack betreiben, hilft es, Entscheidungen zum Dateiformat mit umfassenderen Praktiken zur Datenqualität im Lakehouse zu verbinden.
Die Frage hinter der Frage
Wenn Menschen fragen, was eine Parquet-Datei ist, meinen sie oft etwas Praktischeres:
Wird es meine Abfragen schneller machen?
Wird es Speicher sparen?
Bricht es, wenn Schemata sich entwickeln?
Sollte ich es für jeden Datensatz nutzen?
Das sind die nützlichen Fragen. Am Ende sollten Sie sie präziser beantworten können als mit „Parquet ist komprimiert und spaltenorientiert“.
Wie spaltenorientierte Speicherung einfach erklärt funktioniert
Denken Sie an eine Tabelle mit Spalten wie customer_id, country, signup_date und revenue. Ein zeilenorientiertes Format legt jeden Datensatz zusammen ab. Ein spaltenorientiertes Format legt alle Werte von customer_id zusammen, alle Werte von country zusammen und so weiter.
Das klingt abstrakt, bis Sie es auf eine Abfrage übertragen.
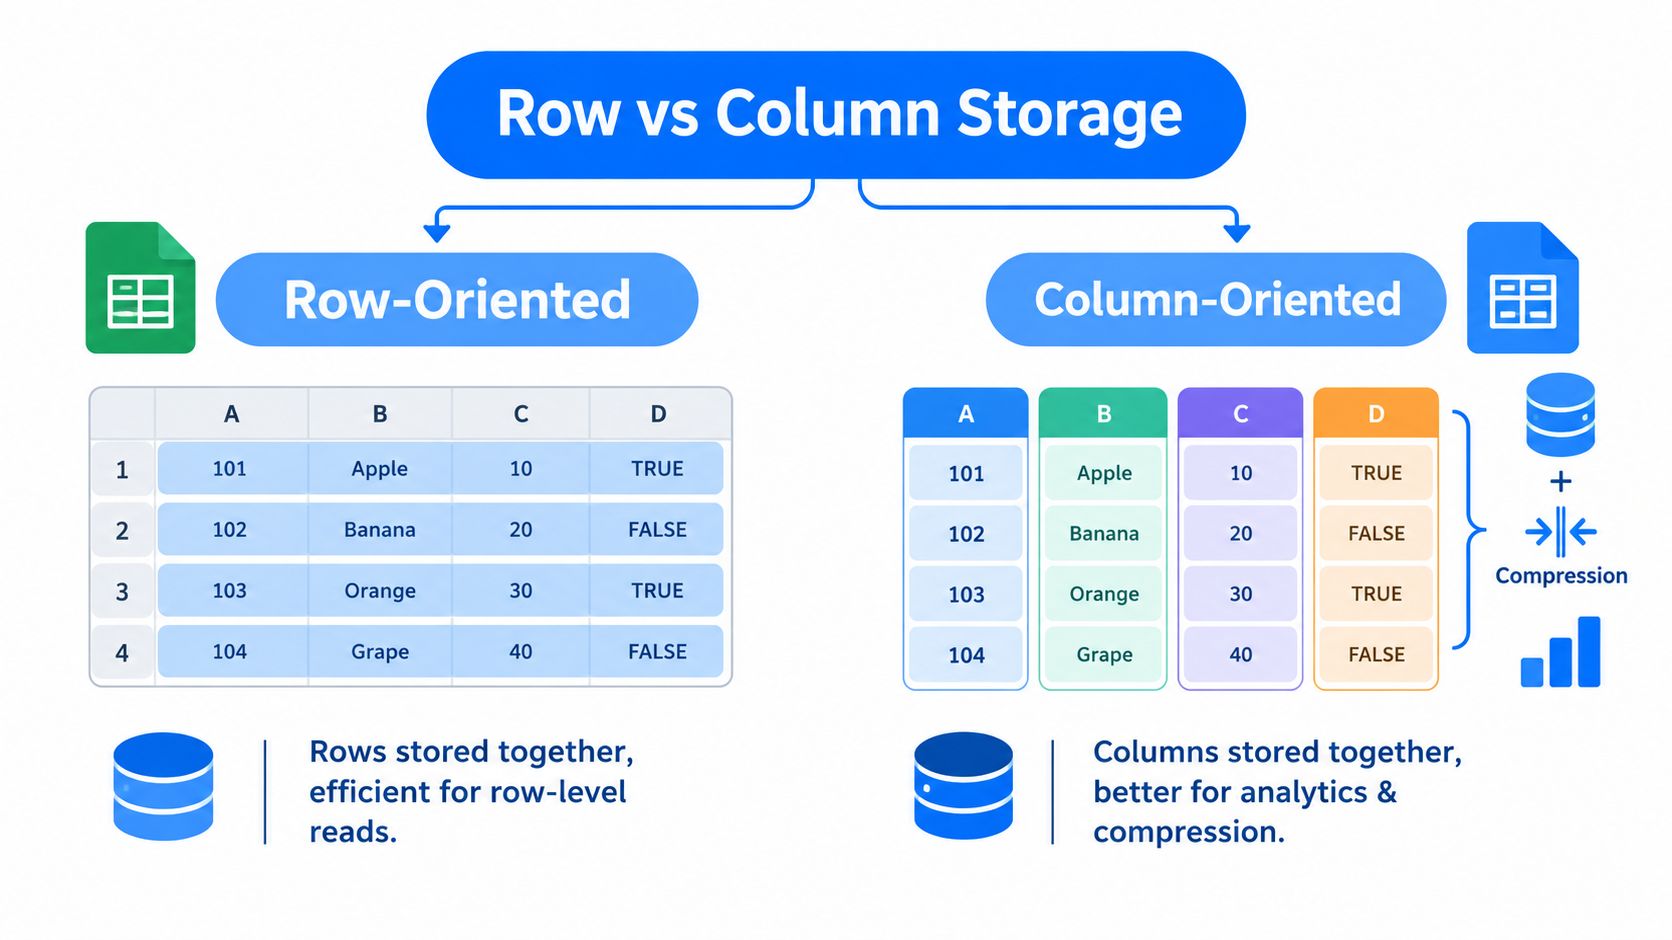
Zeilenspeicherung gegenüber Spaltenspeicherung
Angenommen, Sie führen aus:
select country, sum(revenue) from sales where signup_date >= ... group by country
Eine zeilenorientierte Datei zwingt die Engine, jeden vollständigen Datensatz zu lesen, einschließlich der Spalten, die Ihre Abfrage nicht nutzt. Eine spaltenorientierte Datei erlaubt der Engine, sich auf country, revenue und signup_date zu konzentrieren.
Das ist die erste große Idee: Spalten-Pruning. Der Reader überspringt unberührte Spalten vollständig.
Die zweite große Idee ist Kompression. Wenn ähnliche Werte beieinanderliegen, wirkt Kompression meist besser. Eine Spalte voller Datumswerte verhält sich anders als eine Spalte voller Text, und eine Spalte mit wiederkehrenden Kategorien anders als ein Freitextfeld für Notizen.
Warum gleichartig typisierte Werte helfen
Parquet unterstützt eingebaute Spalten-Encodings und Kompressionscodecs, und das Format dokumentiert Codecs wie Snappy, Gzip, LZO und Zstandard. Weil gleichartig typisierte Werte zusammen abgelegt sind, verbessert dieses Layout die Speichereffizienz und gibt Teams einen Kompromiss zwischen CPU-Kosten und Dateigröße für analytische Workloads, wie in der Parquet-Encoding-Dokumentation beschrieben.
Hier die praktische Fassung:
Wiederholte Werte komprimieren gut: Ländercodes, Statusfelder, boolesche Werte.
Numerische Folgen lassen sich effizient kodieren: IDs und Zeitstempel profitieren oft von spezialisierten Encodings.
Breite Tabellen profitieren von Projektion: Wenn Ihr Dashboard 5 von 80 Spalten braucht, muss die Engine nicht für alle 80 zahlen.
Praktische Regel: Wenn Ihre Nutzerinnen meist viele Zeilen, aber nur einen Bruchteil der Spalten scannen, arbeitet spaltenorientierte Speicherung mit Ihrem Workload statt gegen ihn.
Wo es zu Missverständnissen kommt
Viele hören „spaltenorientiert“ und nehmen an, Parquet sei automatisch für jeden Anwendungsfall schneller. Ist es nicht.
Parquet ist für analytische Scans optimiert, besonders wenn Sie wenige Spalten über viele Datensätze brauchen. Für zeilenweise Zugriffsmuster, hochfrequente Updates oder Workloads, die ständig einzelne Datensätze per Schlüssel holen, ist es weniger natürlich.
Ein hilfreiches Denkmodell ist dieses:
CSV: leicht zu erzeugen, im großen Maßstab schwer effizient zu scannen
Zeilenbasierte Binärformate: besser für das Lesen ganzer Datensätze
Parquet: am besten, wenn die Abfrageform nach Spalten selektiv und nach Zeilenzahl groß ist
Wenn Sie aus diesem Abschnitt nur eines behalten, dann dies: Parquet beschleunigt Analytik, weil es ändert, was die Engine lesen muss, nicht bloß, weil es Dateien schrumpft.
Im Inneren einer Parquet-Datei, vom Header bis zum Footer
Sobald Sie die spaltenorientierte Idee verstanden haben, folgt die Dateianatomie. Parquet wird dann mehr als „CSV, aber komprimiert“.
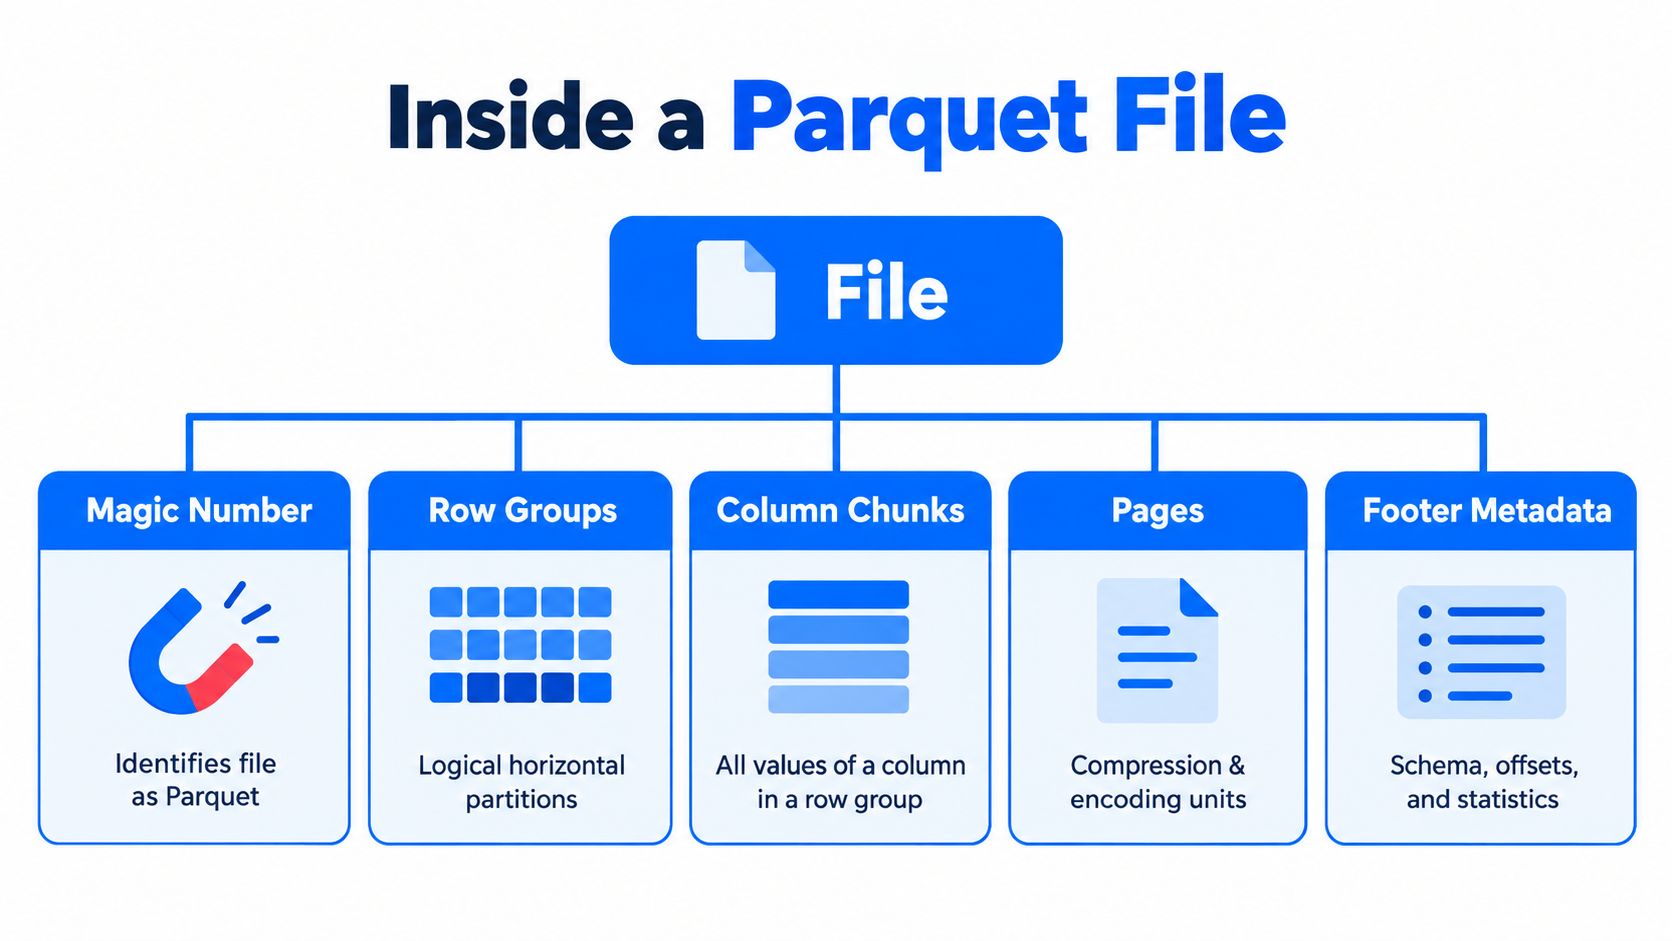
Eine Parquet-Datei beginnt mit einer 4-Byte-Magic-Number, PAR1, und enthält Footer-Metadaten, die Schema, Positionen der Column Chunks, Encodings und Statistiken festhalten. Dieser Entwurf lässt Engines nur benötigte Spalten lesen und irrelevante Row Groups bei Scans überspringen, wie die Dokumentation zum Parquet-Dateiformat beschreibt.
Die Datei hat Schichten
Es hilft, sich eine Parquet-Datei als Behälter mit verschachtelten Teilen vorzustellen.
Header
Beginnt mit der Magic Number
PAR1.Signalisiert, dass die Datei dem Parquet-Format folgt.
Row Groups
Horizontale Partitionen innerhalb der Datei.
Jede Row Group enthält Daten für einen Ausschnitt von Zeilen.
Column Chunks
Innerhalb jeder Row Group wird jede Spalte getrennt abgelegt.
Eine Abfrage, die drei Spalten liest, braucht nur die Chunks dieser Spalten.
Pages
Kleinere Einheiten innerhalb der Column Chunks.
Encodings und Kompression werden auf dieser Ebene angewendet.
Footer
Speichert das Schema und die strukturelle Karte der Datei.
Enthält Metadaten darüber, wo Chunks liegen und wie sie kodiert sind.
Warum der Footer so wichtig ist
Der Footer ist der Teil, den viele Einführungen unterschätzen. Hier wird Parquet intelligent.
Die wahre Stärke von Parquet liegt in den Metadaten. Die Datei speichert nicht nur Werte. Sie speichert genug Struktur, damit Engines unnötige Arbeit vermeiden.
Diese Metadaten können einem Reader sagen, wo ein Column Chunk beginnt, wie Werte kodiert wurden und welche Statistiken für das Pruning verfügbar sind. Anders gesagt: Die Engine öffnet die Datei nicht blind und liest, bis sie findet, was sie braucht. Sie startet mit einer Karte.
Für Teams mit vielen Dateien in einem Lake ist das der Grund, warum Praktiken des Metadatenmanagements so wichtig sind. Schnelle Analytik hängt von organisierter Dateistruktur, konsistenten Schemata und lesbaren Metadaten ab, nicht davon, einmal Parquet gewählt zu haben und weiterzuziehen.
Was Row Groups in der Praxis leisten
Row Groups sind ein nützlicher Kompromiss. Sie machen eine Datei groß genug für effiziente Scans und dennoch teilbar für parallele Arbeit.
Angenommen, Ihre Abfrage filtert auf eine Datumsspalte. Wenn Metadaten anzeigen, dass eine Row Group vollständig außerhalb des Filterbereichs liegt, kann die Engine diese Row Group überspringen. Wählt die Abfrage nur eine Teilmenge der Spalten, kann sie zudem die nicht benötigten Column Chunks innerhalb passender Row Groups ignorieren.
Diese Kombination ist oft der Punkt, an dem Parquet gewinnt:
Spalten überspringen, die Sie nicht brauchen
Row Groups überspringen, die nicht passen können
Pages nur dort dekodieren, wo es nötig ist
Warum die Dateianatomie den Betrieb beeinflusst
Wenn Parquet sich schlecht verhält, ist das Problem selten „Parquet ist langsam“. Meist ist es eines davon:
zu viele winzige Dateien
schlecht gewählte Row-Group-Größen
inkonsistente Schemata über Teildateien hinweg
schwache oder fehlende Statistiken
teure Metadatenermittlung in großen Tabellen
Deshalb behandeln erfahrene Engineers Parquet zugleich als Speicherformat und als operatives System. Die Dateiinterna sind elegant. Beim Verhalten auf Datensatzebene beginnen die schweren Teile.
Kompression, Encodings und Leistungskompromisse
Viel von der Effizienz von Parquet stammt aus etwas Einfachem: Sobald Werte desselben Typs beieinanderliegen, kann das Format sie klüger kodieren und komprimieren als eine reine Textdatei.
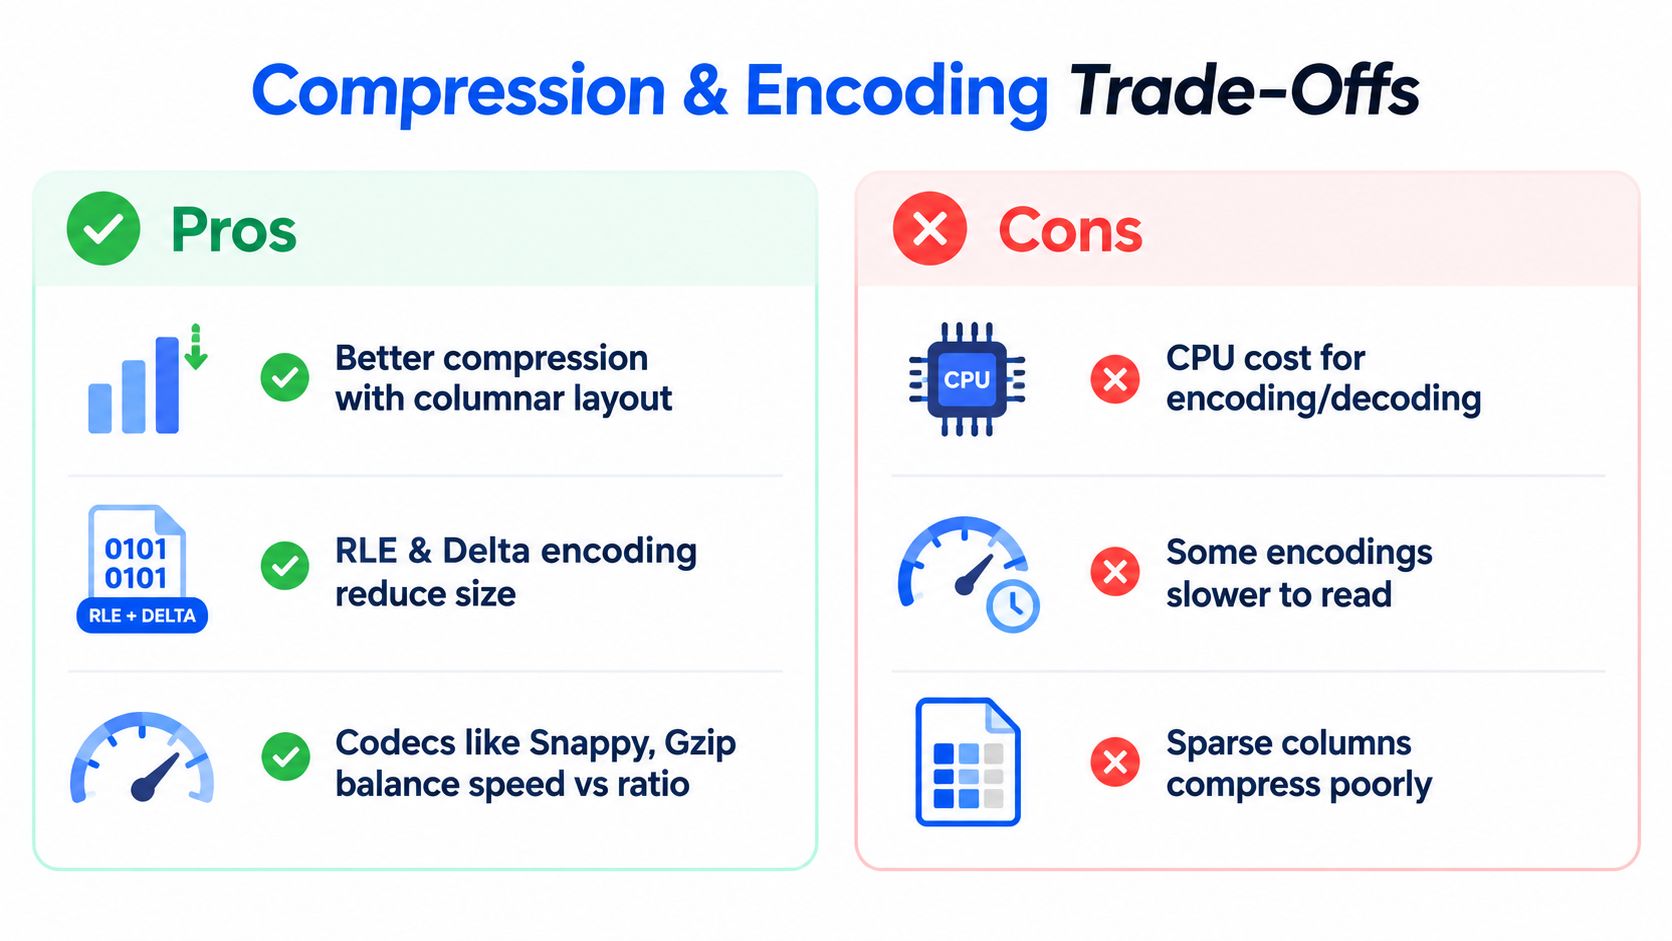
Entscheidend ist, wo das geschieht. Parquet unterstützt mehrere Encoding- und Kompressionsmechanismen auf Page-Ebene. Das Format umfasst Encodings wie PLAIN, RLE, DELTA_BINARY_PACKED, RLE_DICTIONARY und BYTE_STREAM_SPLIT sowie Kompressionscodecs wie SNAPPY, GZIP, BROTLI, ZSTD und LZ4_RAW, wie in der Referenz zum Parquet-Format zusammengefasst.
Erst Encoding, dann Kompression
Eine einfache Denkhilfe:
Encoding ändert, wie Werte dargestellt werden.
Kompression schrumpft die kodierten Bytes.
Das hängt zusammen, ist aber nicht dieselbe Entscheidung.
Eine Textspalte mit geringer Kardinalität kann von einer wörterbuchartigen Behandlung profitieren. Eine numerische Reihe passt womöglich zu einem deltaorientierten Encoding. Danach kann ein Codec wie Snappy oder ZSTD die Pages weiter komprimieren.
Parquet-Encodings und -Codecs im Überblick
Mechanismus | Beispiele | Am besten für | Kompromiss |
|---|---|---|---|
Encoding | PLAIN | Einfache Daten, breite Kompatibilität | Weniger kompakt bei wiederholten Werten |
Encoding | RLE | Wiederholte Werte oder geringe Kardinalität | Weniger nützlich, wenn Werte stark variieren |
Encoding | DELTA_BINARY_PACKED | Geordnete oder allmählich veränderliche numerische Daten | Kann zusätzliche Dekodierarbeit bedeuten |
Encoding | RLE_DICTIONARY | Wiederholte kategoriale Werte | Wörterbuch-Overhead hilft nicht jeder Spalte |
Encoding | BYTE_STREAM_SPLIT | Bestimmte numerische Layouts | Reader-Unterstützung und Workload-Passung zählen |
Codec | SNAPPY | Schnelle analytische Lesevorgänge | Meist größere Dateien als bei schwereren Codecs |
Codec | GZIP | Bessere Reduktion der Dateigröße | Mehr CPU für Kompression und Dekompression |
Codec | BROTLI | Anwendungsfälle mit aggressiver Kompression | Kann die Rechenkosten erhöhen |
Codec | ZSTD | Ausgewogen zwischen Größe und Tempo in vielen Workloads | Ergebnisse hängen von Engine-Unterstützung und Einstellungen ab |
Codec | LZ4_RAW | Szenarien mit schneller Dekompression | Kompressionsrate kann weniger aggressiv ausfallen |
Kleiner ist nicht immer schneller
Teams optimieren oft das Falsche zu stark. Die kleinste Datei auf der Platte erzeugt nicht automatisch die schnellste Abfrage.
Wenn ein Codec Bytes aggressiv zusammenpresst, aber mehr CPU zum Dekodieren kostet, kann die Gesamtlaufzeit steigen. Ist dagegen Speicher oder Netzwerkübertragung die größere Einschränkung, kann dichtere Kompression sich lohnen.
Für Analytik ist die gewinnende Wahl meist jene, die die Gesamtarbeit über Speicher, I/O und CPU hinweg senkt. Nicht jene, die die kleinste Datei erzeugt.
Deshalb zählt Testen. Engines wie Spark, Trino, DuckDB und Warehouse-Laufzeiten gehen unterschiedlich mit Dateigrößen, Page-Struktur und Dekompressionsaufwand um. Dieselbe Abwägung taucht allgemein beim Abfragetuning auf, nicht nur bei Dateiformaten, weshalb breitere Gewohnheiten zur SQL-Optimierung auch nach der Einführung von Parquet wichtig bleiben.
Wie sich das zu anderen Formaten verhält
Kompression ist auch ein guter Punkt, um Parquet von benachbarten Formaten abzugrenzen:
CSV bietet wenig strukturelle Hilfe für effiziente typisierte Kompression.
Avro ist zeilenorientiert, was ändert, was gut komprimiert und was effizient liest.
ORC ist ebenfalls spaltenorientiert und analytikorientiert.
Delta ergänzt Tabellenverhalten über Parquet, statt Parquets Speicherlayout zu ersetzen.
Ja, Parquet ist für Analytik oft kleiner und schneller als CSV. Doch sein echter Vorteil entsteht aus der Kombination von Layout, Metadaten, Encodings und selektivem Lesen.
Parquet im Vergleich zu CSV, Avro, ORC und Delta
Formatvergleiche werden unübersichtlich, wenn Menschen fragen: „Welches ist das beste?“ Das ist meist die falsche Frage. Die nützliche lautet: welches Format passt zum Zugriffsmuster und Betriebsmodell dieses Datensatzes?
Beginnen Sie beim Workload, nicht bei der Loyalität
CSV ist weiterhin verbreitet, weil es universell ist. Sie können es fast überall öffnen. Doch Universalität bringt schwache Typisierung, schwache Metadaten und teure Scans mit sich.
Avro ist besser, wenn es Ihnen um zeilenorientierten Austausch, ereignisartige Pipelines oder das Lesen ganzer Datensätze geht. ORC konkurriert in analytischen Umgebungen direkter mit Parquet, besonders in Stacks, die um Hive-artige Optimierung gewachsen sind. Delta ist wieder etwas anderes. Es bezeichnet meist eine Transaktions- und Tabellenverwaltungsschicht über Parquet-Dateien.
Die Wahl zwischen Parquet, CSV, Avro, ORC und Delta
Format | Layout | Idealer Workload | Zu beachtende Einschränkung |
|---|---|---|---|
Parquet | Spaltenorientiert | Analytische Scans über große tabellarische Daten | Kann bei Schemadrift und schlechtem Dateilayout operativ mühsam werden |
CSV | Zeilenartiger Klartext | Einfacher Austausch, schnelle Exporte, manuelle Durchsicht | Schwache Typisierung, keine reichen Metadaten, ineffiziente große Scans |
Avro | Zeilenorientiert binär | Ereignis-Pipelines, Serialisierung, Verarbeitung ganzer Datensätze | Weniger effizient als spaltenorientierte Formate für selektive Analytik |
ORC | Spaltenorientiert | Analytik in Ökosystemen, die ORC-Werkzeuge bevorzugen | Die Passung hängt von Engine-Unterstützung und Teamstandards ab |
Delta | Tabellenschicht über Parquet | Lakehouse-Workloads mit Bedarf an Tabellensemantik und Datenverwaltung | Ergänzt operative Konzepte über das Dateiformat hinaus |
Die feine Frage, die übersprungen wird
Viele Teams fragen, was eine Parquet-Datei ist, führen es ein und hören dort auf. Die bessere Anschlussfrage lautet: sollte dieser Workload weiterhin Parquet als Standard nutzen?
Diese Frage zählt heute mehr, weil das Format sich weiterentwickelt. Die Dokumentation des Parquet-Projekts von 2026 zeigt aktive Änderungen, darunter Variant-Unterstützung als Vorschau und einen vorgeschlagenen File-Logical-Type für unstrukturierte Nutzlasten, was auf eine Ausweitung über klassische analytische Tabellen hinaus hindeutet. Doch diese Fähigkeiten sind im Ökosystem noch nicht breit ausgereift, weshalb die Workload-Passung mehr zählt als Einheitsstandards, wie in der Dokumentation zu den Parquet-Formatversionen vermerkt.
Das hat 2025 und 2026 eine praktische Folge. Teams wählen Formate zunehmend nach Zugriffsmuster:
analytische Scans über stabile tabellarische Daten
zeilenweiser Ereignistransport
tabellenverwaltete Lakehouse-Operationen
halbstrukturierte oder stark wahlfreie Zugriffs-Workloads
Für Plattformteams mit Databricks-artigen Lakehouse-Stacks spielt die Formatwahl auch mit Governance- und Zuverlässigkeitsentscheidungen wie dem Datenqualitätsmanagement für Databricks-Umgebungen zusammen.
Eine einfache Entscheidungsregel
Nutzen Sie Parquet, wenn Ihr dominantes Muster analytische Lesevorgänge über große Datensätze sind und Ihr Werkzeugsatz es gut unterstützt. Seien Sie vorsichtiger, wenn der Workload zu häufigen Zeilenupdates, stark veränderlichen halbstrukturierten Nutzlasten oder Zugriffsmustern neigt, denen wahlfreier Abruf wichtiger ist als breite Scans.
Parquet ist oft ein starker Standard. Es ist nur nicht mehr der einzige vernünftige Standard.
Parquet-Dateien in der Praxis prüfen und erzeugen
Theorie hilft, doch die meisten Engineers wollen irgendwann drei konkrete Fragen beantworten:
Welches Schema steckt in dieser Datei?
Wie viele Row Groups hat sie?
Welche Kompressions- oder Encoding-Entscheidungen wurden genutzt?
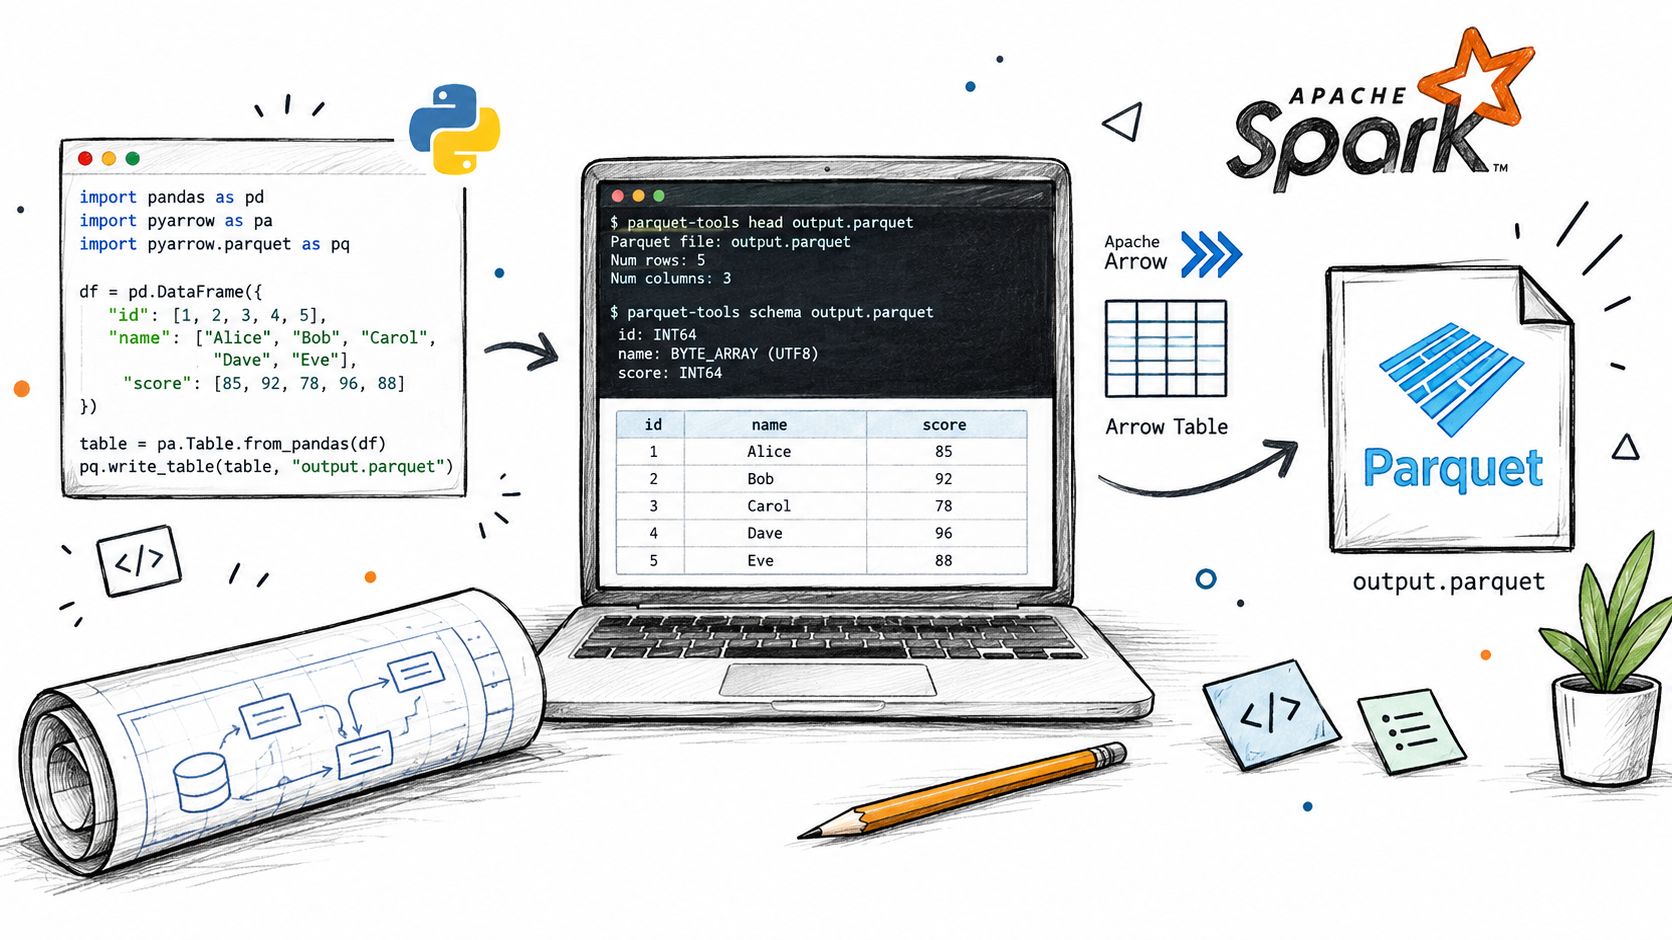
Eine Datei prüfen
Eine leichte Gewohnheit ist, Parquet zu prüfen, bevor Sie nachgelagertes Abfrageverhalten debuggen.
Mit parquet-tools schauen Engineers üblicherweise auf Schema und Metadaten:
Mit PyArrow in Python:
Mit Spark:
Wonach suchen Sie?
Schemaform: Sind Spaltennamen und Typen so, wie Sie es erwarten?
Anzahl der Row Groups: Zu viele können auf Überfragmentierung hindeuten.
Kompressionsdetails: Nützlich, wenn Speicher und Laufzeit nicht zusammenpassen.
Nullbarkeit und Feldänderungen: Oft der erste Hinweis auf nachgelagerte Brüche.
Parquet aus Python und Spark schreiben
Parquet zu erzeugen ist meist unkompliziert. Die operativen Details zählen mehr als die Syntax.
Mit pandas und PyArrow:
Mit Spark:
Diese Zeilen sind der leichte Teil. Wichtiger sind die Fragen:
Schreiben Sie sinnvolle Dateigrößen?
Passen Partitionen zu den tatsächlichen Filtern?
Erzeugen alle Writer dasselbe Schema?
Bringen Append-Jobs Drift hinein?
Werkzeuge sind nur die halbe Arbeit
Ein Datensatz kann gültige Parquet-Dateien enthalten und sich als Tabelle dennoch schlecht verhalten. Deshalb kombinieren Teams die Dateiprüfung oft mit Überwachung von Schemaänderungen, Frische und Datenverhalten. Zu dieser Kategorie zählen engine-eigene Metadatenprüfung, Katalogwerkzeuge und Plattformen wie digna, das Datenverhalten überwacht, Datensätze validiert, Timeliness verfolgt und Schemaänderungen innerhalb der Kundenumgebung erkennt.
Wenn Ihr Abfrageplan vernünftig aussieht, die Leistung aber weiter schwankt, prüfen Sie die Dateien und die Datensatzmetadaten, bevor Sie die Engine beschuldigen.
In der Praxis ist die beste Debugging-Schleife kurz: die Datei prüfen, das Tabellenlayout prüfen, den Abfrageplan prüfen und dann die Schemaevolution über Partitionen oder Append-Batches hinweg prüfen.
Bewährte Praktiken für Partitionierung, Schemaevolution und Tempo
Die meisten „Parquet-Leistungsprobleme“ kommen nicht von Parquet selbst. Sie kommen davon, wie Teams Datensätze über die Zeit schreiben, anhängen, partitionieren und weiterentwickeln.
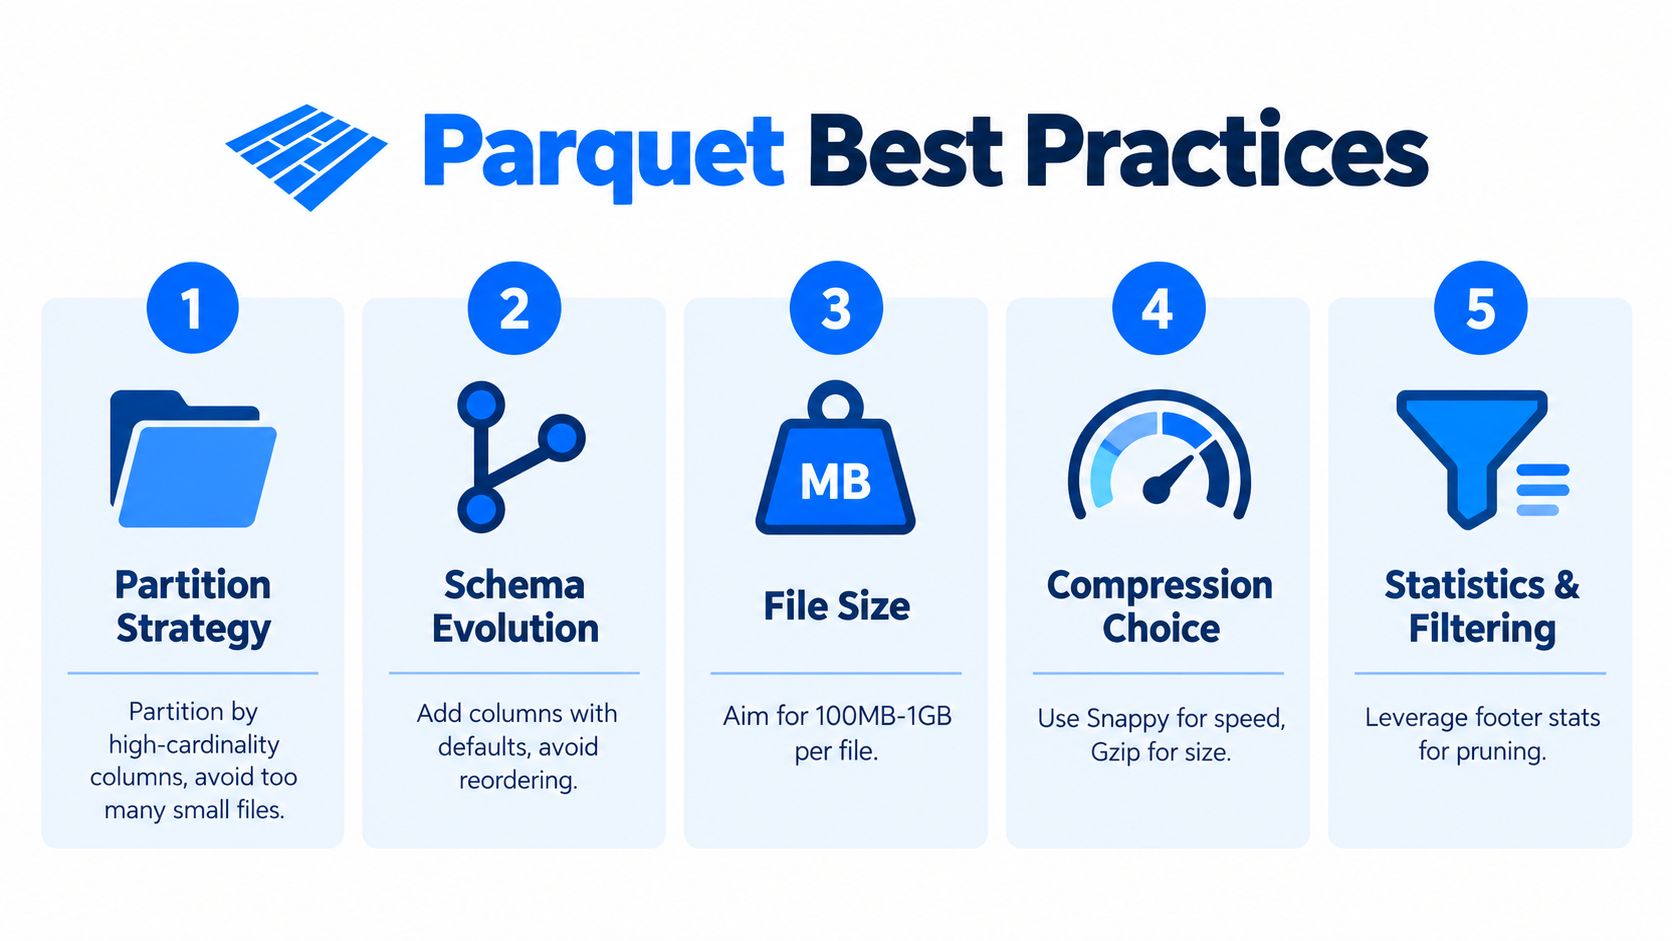
Behandeln Sie das Layout als Teil des Datenmodells
Die Parquet-Spezifikation empfiehlt große Row Groups von 512 MB bis 1 GB, was hilft, Scaneffizienz und parallele Verarbeitung für große analytische Datensätze auszubalancieren, gemäß den Konfigurationshinweisen zu Parquet.
Diese Empfehlung überrascht, weil viele reale Datensätze in weit kleinere Stücke zerfallen. Kleine Dateien und winzige Row Groups erzeugen Overhead bei Planung, Metadatenverwaltung und Aufgabenverteilung.
Einige praktische Gewohnheiten helfen:
Partitionieren Sie zurückhaltend: Partitionieren Sie nach Feldern, auf die Menschen filtern. Zu viele Partitionen erzeugen Dateiwildwuchs und Metadatenprobleme.
Streben Sie gesunde Dateigrößen an: Groß genug für effiziente Scans, nicht so fragmentiert, dass die Planung dominiert.
Halten Sie Writer konsistent: Gemischte Schreibeinstellungen über Jobs hinweg erzeugen oft ungleichmäßige Leistung.
In der Schemaevolution verstecken sich die Kosten
Ein oft übersehener Aspekt in Diskussionen darüber, was eine Parquet-Datei ist: Der schwierige Teil ist oft nicht das Dateiformat. Es ist das effiziente Lesen von Datensätzen mit gemischten Schemata.
Apache Spark weist darauf hin, dass Parquet Schemaevolution unterstützt, doch das Zusammenführen von Schemata über Teildateien hinweg ist vergleichsweise teuer und standardmäßig deaktiviert, sofern nicht ausdrücklich aktiviert. Das heißt, viele reale Parquet-Probleme sind Probleme des Metadatenmanagements in Data Lakes, besonders bei fortlaufend angehängten Datensätzen, wo stiller Schemadrift beim Lesen teure Volltabellenscans auslösen kann, wie in der Projektdokumentation zu Parquet beschrieben.
Das Dateiformat mag in Ordnung sein. Der Datensatz kann dennoch schwer effizient zu lesen sein, wenn jeder Batch eine leicht abweichende Form schreibt.
Deshalb zählt Schema-Governance. Teams brauchen ein klares Modell für erlaubte Änderungen, Erkennung von Drift und Einblick in die nachgelagerte Wirkung. Ein praktischer Ausgangspunkt ist ein gemeinsames Verständnis von Schematypen und Änderungsmustern, bevor Pipelines sich unabhängig entwickeln.
Wie guter Betrieb aussieht
Die gesündesten Parquet-Datensätze teilen meist ein paar Merkmale:
Append-Disziplin: neue Daten landen in einer vorhersehbaren Struktur.
Schemaprüfung: hinzugefügte Spalten sind bewusst, nicht zufällig.
Metadatenbewusstsein: Engineers prüfen Row Groups, Partitionen und Scanverhalten.
Timeliness-Prüfungen: verspätete oder unvollständige Ladevorgänge verderben keine nachgelagerten Annahmen.
Wenn Sie eine Sache aus diesem Artikel behalten, dann diese: Parquet ist stark, weil es Engines erlaubt, unnötige Arbeit zu vermeiden. Doch wenn Ihre Dateien zu klein, Ihre Partitionen zu unruhig oder Ihre Schemata zu uneinheitlich sind, verliert die Engine diesen Vorteil schnell.
Wenn Parquet-Leistung in Ihrem Lake immer wieder zu einem Problem von Schemadrift oder fehlender Metadatensicht wird, kann digna Ihnen helfen, strukturelle Änderungen, Timeliness, Qualität auf Satzebene und allgemeines Datenverhalten zu überwachen, ohne Daten aus Ihrer eigenen Umgebung zu bewegen. Das erleichtert es, die operativen Probleme rund um Parquet-Datensätze zu erkennen, bevor sie zu kaputten Dashboards oder teuren Scans werden. Mehr dazu unter digna.
Eine gültige Datei ist noch kein verlässlicher Datensatz — Data Observability beobachtet die Signale zu Schema, Frische und Volumen, auf die Parquet-Metadaten allein nicht reagieren.
Häufig gestellte Fragen
Was ist eine Parquet-Datei?
Ein quelloffenes spaltenorientiertes Dateiformat, das gleichartig typisierte Werte zusammen ablegt und Footer-Metadaten nutzt, damit Query-Engines nur die benötigten Spalten lesen und irrelevante Daten überspringen. Es begann als gemeinsame Anstrengung von Twitter und Cloudera, erschien erstmals im Juli 2013 und wurde später ein Top-Level-Apache-Projekt.
Wie unterscheidet sich spaltenorientierte von zeilenorientierter Speicherung?
Zeilenspeicherung hält alle Felder eines Datensatzes zusammen; Spaltenspeicherung gruppiert die Werte jedes Feldes über Datensätze hinweg. Weil gleichartig typisierte Werte nebeneinanderliegen, kodieren und komprimieren sie weit besser, und eine Abfrage, die drei Spalten berührt, muss den Rest nie lesen.
Warum ist der Footer so wichtig?
Er enthält das Schema und die Karte, wo Row Groups und Column Chunks liegen, sodass ein Reader ihn konsultiert, bevor er entscheidet, was er öffnet. Das macht die Planung für analytische Scans günstig — und einen beschädigten Footer unverhältnismäßig teuer, denn die Datenpages können intakt und dennoch unerreichbar sein.
Ist eine kleinere Parquet-Datei immer schneller?
Nein. Kleiner ist nicht immer schneller: Ein aggressiver Codec spart Bytes auf der Platte, kostet aber bei jedem Lesen CPU, was die Dashboard-Latenz eher steigen als sinken lässt. Wählen Sie zuerst das Encoding passend zum Wertemuster der Spalte, dann den Codec für die Abwägung zwischen Speicher und CPU.
Wann sollten Sie Parquet gegenüber CSV, Avro, ORC oder Delta wählen?
Beginnen Sie beim Workload statt bei der Formattreue. Parquet passt zu wiederholten analytischen Scans über eine Teilmenge der Spalten; Avro passt zu zeilenweisen Schreibvorgängen und Ereignisaustausch; CSV bleibt nützlich für Durchsicht und einfache Übergaben; Delta ergänzt Transaktionsgarantien, die Parquet allein nicht bietet.



