Was ist ein Schema in einer Datenbank? Ihr Leitfaden für 2026
|
8
min. Lesezeit

Wahrscheinlich suchen Sie nicht nach der Bedeutung eines Schemas, weil Sie sich für Datenbanktheorie interessieren. Sie suchen danach, weil sich etwas weiter unten in der Kette fragil anfühlt. Ein Dashboard ist nach einem Routine-Release ausgefallen. Eine Pipeline schlägt plötzlich bei einer Tabelle fehl, die sich „nicht geändert hat“. Ein Modell hat weiter Scores berechnet, aber die Ergebnisse ergaben keinen Sinn mehr.
Das ist der praktische Grund, sich mit Schemas zu befassen. Oft stehen die Datenwerte im Mittelpunkt, während sich die Struktur um diese Werte unbemerkt im Hintergrund verändert. Genau dort beginnen viele kostspielige Ausfälle.
Wenn Sie zuerst die Lehrbuchantwort möchten, hier ist sie: Ein Datenbankschema ist der strukturelle Bauplan, der festlegt, wie Daten organisiert sind, einschließlich Tabellen, Spalten, Datentypen, Constraints und Beziehungen wie Fremdschlüsseln, wie in Oracles Definition der Struktur eines Datenbankschemas beschrieben. Diese Definition ist jedoch nur der Ausgangspunkt. In realen Systemen ist das Schema auch ein Vertrag. Ändert sich dieser Vertrag unkontrolliert, tragen Pipelines, Dashboards und ML-Systeme oft als Erste den Schaden.
Inhaltsverzeichnis
Der stille Fehler hinter einem defekten Dashboard
Ein typischer Ausfall beginnt an einem völlig gewöhnlichen Morgen. Ein BI-Entwickler öffnet ein Umsatz-Dashboard und sieht leere Felder, wo gestern noch Trends zu sehen waren. Eine Data Engineerin prüft die Orchestrierungsschicht und stellt fest, dass eine nachgelagerte Transformation fehlgeschlagen ist. Das Quellsystem läuft. Die Rechenleistung ist in Ordnung. Nichts wirkt überlastet.
Die Ursache erweist sich als kleiner, als alle erwartet hatten. Ein vorgelagertes Team hat eine Spalte umbenannt, ein Feld entfernt oder einen Typ von ganzzahligen Werten auf Strings umgestellt. Niemand hat es angekündigt. Keine Migration hat das Analytics-Team erreicht. Die Pipeline war weder überlastet noch schlecht konfiguriert. Sie hat eine Struktur erwartet und eine andere erhalten.
Deshalb wirken einführende Erklärungen zu Schemas oft unvollständig. Sie beschreiben ein Schema als Struktur, was zutrifft, gehen aber nicht auf die betrieblichen Folgen ein. Aktuelle Branchenanalysen zeigen, dass 60 bis 70 Prozent der Ausfälle von Datenpipelines auf unerwartete Schemaänderungen statt auf Probleme mit dem Datenvolumen zurückgehen, ein Punkt, den Cockroach Labs in seiner Betrachtung von Schemarisiken hervorhebt.
Warum diese Fehler schwer zu diagnostizieren sind
Schemabezogene Incidents sind unübersichtlich, weil sie nicht immer lautstark fehlschlagen. Manchmal stürzt der Job beim Parsen ab. Manchmal überspringt eine Transformation unbemerkt ein Feld. Manchmal lädt das Dashboard weiterhin, aber eine Kennzahl ist nun falsch, weil ein Join nicht mehr übereinstimmt oder ein Cast plötzlich Nullwerte liefert.
Die meisten Teams überwachen Zeilenanzahl und Aktualität, bevor sie die Struktur überwachen. Das ist die falsche Reihenfolge, wenn die Struktur das ist, worauf jede nachgelagerte Annahme beruht.
Ein defektes Dashboard ist meist nur das sichtbare Symptom. Das eigentliche Problem liegt eine Ebene tiefer, im Vertrag, der festlegt, wie die Daten aussehen sollen.
Die eigentliche Lektion
Wenn Sie nur Werte überwachen, übersehen Sie eine große Klasse von Fehlern. Schemas verdienen dieselbe betriebliche Aufmerksamkeit wie Code, Jobs und Infrastruktur. Für moderne Datenteams ist die Frage „Was ist ein Schema in einer Datenbank?“ keine akademische Frage. Es ist eine Frage der Zuverlässigkeit.
Der Bauplan Ihrer Datenbank
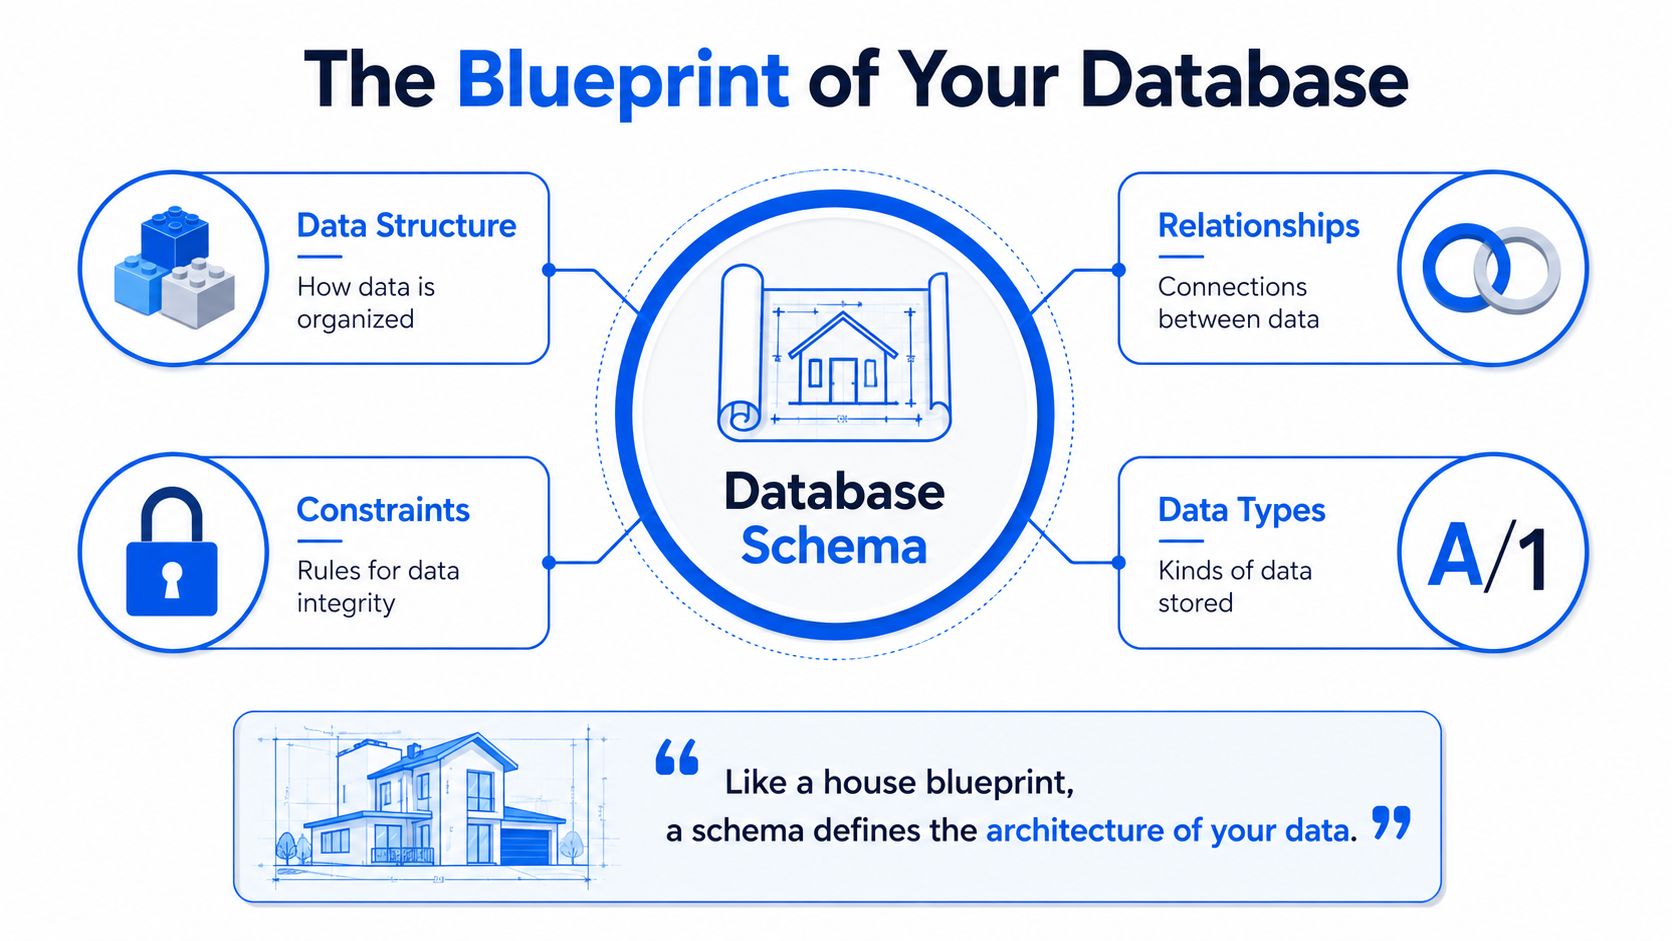
Am einfachsten verstehen Sie ein Schema, wenn Sie es sich als Bauplan eines Gebäudes vorstellen. Der Bauplan enthält weder die Möbel noch die Menschen im Haus. Er legt die Räume, die Türen, die tragenden Wände und die Regeln fest, denen der Bau folgen muss.
In einer relationalen Datenbank ist die formale Variante strenger. In relationalen Datenbankmanagementsystemen ist ein Schema formal als eine Menge von Integritäts-Constraints definiert, also logischen Formeln, die das Einfügen von Daten verhindern, die strukturelle Regeln verletzen, und dient als datenfreier Bauplan von Tabellen, Feldern, Datentypen und Beziehungen, wie in IBMs Überblick zum Datenbankschema erläutert.
Was der Bauplan tatsächlich umfasst
Ein praxisnahes Schema definiert in der Regel mehrere Kernelemente:
Tabellen bilden die wichtigsten Entitäten ab, die Sie speichern, etwa
customers,ordersoderpayments.Spalten definieren die Attribute jeder Tabelle, etwa
customer_id,emailodercreated_at.Datentypen legen fest, welche Art von Wert eine Spalte aufnehmen kann, etwa Integer, Text oder Zeitstempel.
Constraints setzen Regeln wie
PRIMARY KEY,NOT NULLoder Eindeutigkeit durch.Beziehungen verbinden Tabellen über Schlüssel, meist über Fremdschlüsselreferenzen.
Übertragen auf die Bauplan-Analogie sind Tabellen die Räume, Spalten die Einbauten, Datentypen die Materialspezifikationen und Constraints die Bauvorschriften, die fehlerhafte Konstruktionen verhindern.
Warum Constraints in der Produktion wichtig sind
Die Formulierung „Menge von Integritäts-Constraints“ klingt abstrakt, bis Sie selbst mit fehlerhaften Daten zu tun hatten. Constraints verhindern bestimmte Fehlerklassen, bevor sie in die Datenbank gelangen. Ein Primärschlüssel verhindert doppelte Identitäten. Ein Fremdschlüssel verhindert verwaiste Datensätze. Ein Typ-Constraint verhindert, dass eine Zeitstempelspalte Freitext akzeptiert.
Das ist wichtig, weil Vorbeugung günstiger ist als Bereinigung. Wenn die Datenbank strukturelle Regeln beim Schreiben durchsetzt, müssen nachgelagerte Jobs nicht raten, ob zentrale Annahmen noch gelten.
Schemaelement | Funktion | Typischer Fehler ohne Management |
|---|---|---|
Tabellendefinition | Organisiert Entitätsdaten | Fehlende oder doppelte Fachkonzepte |
Spaltendefinition | Beschreibt jedes Attribut | Fehlerhafte Transformationen bei geänderten Namen |
Datentyp | Steuert das zulässige Werteformat | Cast-Fehler, zunehmende Nullwerte, falsche Aggregationen |
Constraint | Setzt Integrität durch | Duplikate, ungültige Referenzen, inkonsistente Datensätze |
Beziehung | Verbindet Entitäten über Tabellen hinweg | Falsche Joins und irreführende Berichte |
Praxisregel: Wenn ein Feld wichtig genug ist, um darauf zu joinen, danach zu filtern oder es in ein Modell einzuspeisen, sollte seine Schemadefinition als Teil Ihres Produktionsvertrags behandelt werden.
Was funktioniert und was nicht
Was funktioniert, ist eine explizite Struktur. Klare Zuständigkeiten für Tabellen. Geprüfte DDL-Änderungen. Constraints, die der geschäftlichen Realität entsprechen.
Was nicht funktioniert, ist ein Schema als Dokumentation zu behandeln, die einmal erstellt und dann vergessen wird. Der Bauplan schützt Sie nur, wenn die Teams ihn mit dem Gebäude, das sie verändern, abgestimmt halten.
Konzeptionelle, logische und physische Schemas
Ein Datenbankschema wird meist als Definition dafür gelehrt, wie Daten organisiert sind. In der Praxis existiert diese Definition auf mehreren Ebenen, und jede Ebene beeinflusst eine andere Art von Entscheidung. Wenn ein Team sie vermischt, werden Schemaänderungen schwerer zu prüfen, Zuständigkeiten verschwimmen und das Produktionsrisiko steigt.
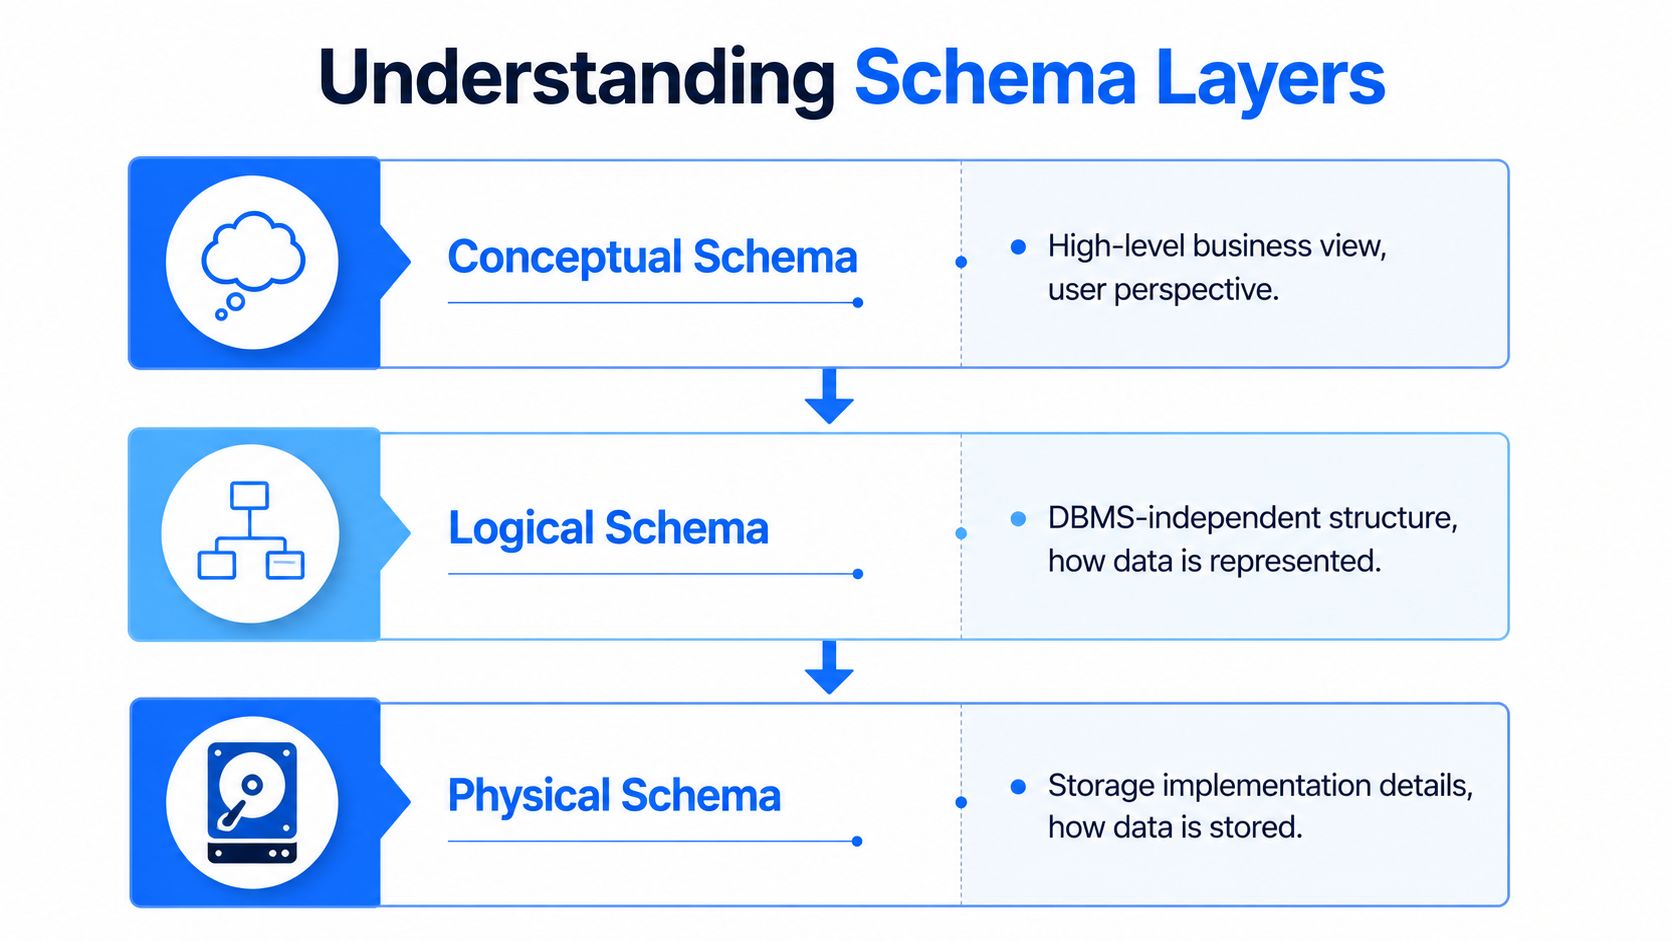
Die klassische Drei-Ebenen-Sicht stammt aus der ANSI/SPARC-Architektur: konzeptionell, logisch und physisch. IBMs Überblick über die Drei-Schema-Architektur ist ein Beispiel für dieses Modell in der Praxis.
Ein E-Commerce-Beispiel über drei Ebenen
Nehmen Sie ein Handelssystem als konkretes Beispiel.
Auf der konzeptionellen Ebene definiert das Business die Kernobjekte: Kunden, Produkte, Bestellungen und Zahlungen. Diese Ebene erfasst die Bedeutung und die Regeln der Geschäftsdomäne. Sie beantwortet Fragen wie, was eine Bestellung ist, wer ein Kunde ist und ob eine Erstattung zu den Zahlungen oder zu den Bestellungen gehört.
Auf der logischen Ebene wird diese Geschäftssicht zu einem Datenmodell. Engineers definieren Entitäten, Attribute, Schlüssel und Beziehungen wie customers zu orders, orders zu order_items und payments zu orders. Der Fokus liegt auf Struktur und Konsistenz, nicht auf Speicherdetails.
Auf der physischen Ebene wird der Entwurf in einer bestimmten Datenbank-Engine ausführbar. Hier kommen Datentypen, Indizes, Clustering, Partitionierung, Dateilayout und Engine-spezifische Optionen ins Spiel. An dieser Stelle beginnen Performance, Speicherkosten und Betriebsverhalten bei Systemen auseinanderzulaufen, die auf dem Whiteboard ähnlich aussehen.
Warum die Unterscheidungen in der Produktion wichtig sind
Jede Ebene scheitert auf andere Weise.
Ein konzeptioneller Fehler liefert Ihnen das falsche Geschäftsobjekt. Ein logischer Fehler führt zu fehlerhaften Joins, doppelten Entitäten oder Modellen, die Analysten mit eigenem SQL umgehen. Ein physischer Fehler verlangsamt Abfragen, bläht den Speicher auf und macht aus routinemäßigen Schemaänderungen riskante Migrationen.
Diese Trennung hilft auch bei der Incident Response. Wenn ein Dashboard ausfällt, weil customer_tier von einer Tabelle in eine andere verschoben wurde, ist das Problem logisch. Wenn das Dashboard weiterhin läuft, die Abfragezeit nach einer Partitionsänderung aber sprunghaft steigt, ist das Problem physisch. Wenn zwei Teams uneins sind, ob Testnutzer als Kunden zählen, ist das Problem konzeptionell. Wer die richtige Ebene identifiziert, verkürzt die Behebung.
Das Schema als Namensraum
Relationale Systeme verwenden das Wort Schema auch in einem zweiten Sinn: als Namensraum für Objekte wie finance, sales oder analytics. In Plattformen wie SQL Server und PostgreSQL gruppiert dieser Namensraum Tabellen, Views und andere Objekte innerhalb einer benannten Grenze mit eigenen Zugriffsregeln.
Das ist betrieblich relevant. Das Design der Namensräume beeinflusst die Rechteverwaltung, die Isolation von Deployments und die Zuständigkeit für Objekte. Ein Team könnte zugriffsbeschränkte Gesundheitstabellen in einem Schema speichern und kuratierte Reporting-Views in einem anderen veröffentlichen. Gut umgesetzt verringert das versehentliche Offenlegung und erleichtert die Durchsetzung von Zuständigkeiten.
Der Haken: Engineers verwenden für beide Konzepte oft dasselbe Wort. Manchmal bedeutet „Schemaänderung“, dass sich ein Spaltentyp geändert hat. Manchmal bedeutet es, dass ein Objekt von staging nach analytics verschoben wurde. Das sind unterschiedliche Ereignisse mit unterschiedlichem Wirkungsradius. Werden sie gleich behandelt, übersehen Reviews die nachgelagerten Auswirkungen, und Schema-Drift wird später zu fehlerhaften Pipelines.
Schema-on-Write vs. Schema-on-Read
Nicht jedes System wendet die Struktur in derselben Phase an. Hier werden viele Diskussionen zur Frage „Was ist ein Schema in einer Datenbank?“ moderner. Die Antwort hängt davon ab, wann Sie den Vertrag durchsetzen.
Schema-on-Write
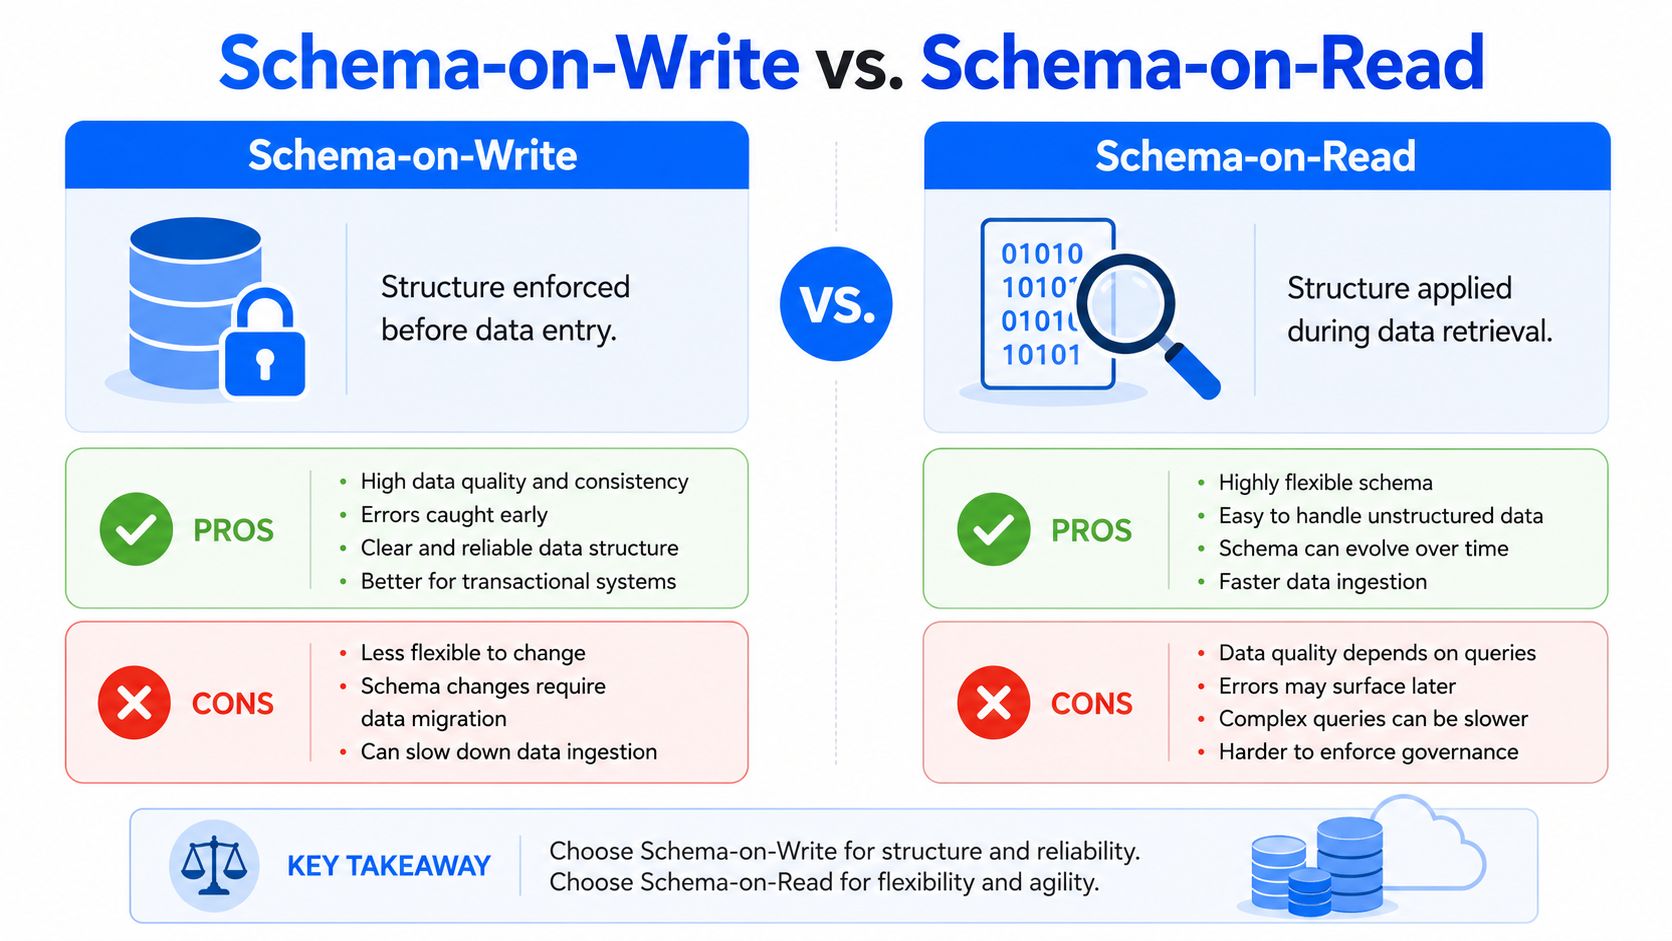
Klassische relationale Systeme folgen in der Regel dem Prinzip Schema-on-Write. Daten müssen der erwarteten Struktur entsprechen, bevor die Datenbank sie akzeptiert. Wenn die Tabelle einen Zeitstempel erwartet und fehlerhaften Text erhält, sollte der Schreibvorgang fehlschlagen oder über eine kontrollierte Transformation abgewiesen werden.
Diese Starrheit ist in transaktionalen Systemen nützlich. Zahlungen, Bestellungen, Kontostände und Identitätsdaten profitieren von einer strengen Struktur, weil die Konsumenten Konsistenz mehr brauchen als Flexibilität.
Vorteile
Hohe Integrität bei der Aufnahme: Ungültige Datensätze werden frühzeitig blockiert.
Sauberere nachgelagerte Nutzung: Analysten und Anwendungen arbeiten mit vorhersehbaren Strukturen.
Klare Verträge: Produzenten und Konsumenten wissen, welche Form erwartet wird.
Nachteile
Langsamere Anpassung: Eine Änderung des Modells erfordert meist eine Migrationsplanung.
Mehr Abstimmung: Vor- und nachgelagerte Teams müssen sich vor dem Release abstimmen.
Weniger nachsichtig bei der Rohdatenaufnahme: Semistrukturierte Eingaben müssen vorverarbeitet werden.
Schema-on-Read
Data Lakes und Landing Zones für Rohdaten nutzen häufig Schema-on-Read. Teams nehmen die Daten zuerst auf und wenden die Struktur später beim Abfragen oder Transformieren an. Das funktioniert gut, wenn die Eingaben vielfältig, semistrukturiert oder schnell veränderlich sind.
Die Flexibilität ist real. Das betriebliche Risiko ebenso. Wenn jeder Konsument die Struktur anders ableitet, kann derselbe Rohdatensatz zu mehreren Interpretationen führen.
Ansatz | Am besten geeignet für | Hauptstärke | Hauptrisiko |
|---|---|---|---|
Schema-on-Write | Transaktionale Systeme, kuratierte Warehouses | Konsistenz vor der Speicherung | Starrheit bei Änderungen |
Schema-on-Read | Rohdaten-Lakes, explorative Analysen, heterogene Datenaufnahme | Flexibilität bei der Aufnahme | Inkonsistente nachgelagerte Interpretation |
Was sich in der Praxis bewährt
Der Fehler liegt nicht darin, sich für das eine oder das andere zu entscheiden. Der Fehler liegt in der Annahme, dass Schemamanagement mit Schema-on-Read überflüssig wird. Das wird es nicht. Sie brauchen weiterhin Verträge, Katalogisierung, Validierung und Änderungsüberwachung. Andernfalls wird der Lake zu einem Ort, an dem Konsumenten immer wieder dieselben strukturellen Überraschungen erleben.
Ein bewährtes Muster besteht darin, bei der Aufnahme Flexibilität zuzulassen und dann eine strengere Struktur durchzusetzen, sobald die Daten in kuratierte Schichten wandern. So können Teams schnell Daten aufnehmen, ohne dass nachgelagerte Analysen und Modelle auf Vermutungen basieren.
Wenn sich Baupläne ändern: Schema-Evolution und Drift
Kein Produktionsschema bleibt eingefroren. Produkte erhalten neue Funktionen. APIs ändern sich. Quellanwendungen versionieren ihre Payloads. Regulierungen erzwingen neue Felder. Teams teilen eine Tabelle in drei auf oder führen zehn zu einer zusammen. Die Änderung selbst ist nicht das Problem.
Das Problem ist, ob die Änderung bewusst und sichtbar erfolgt.
Schema-Evolution versus Schema-Drift
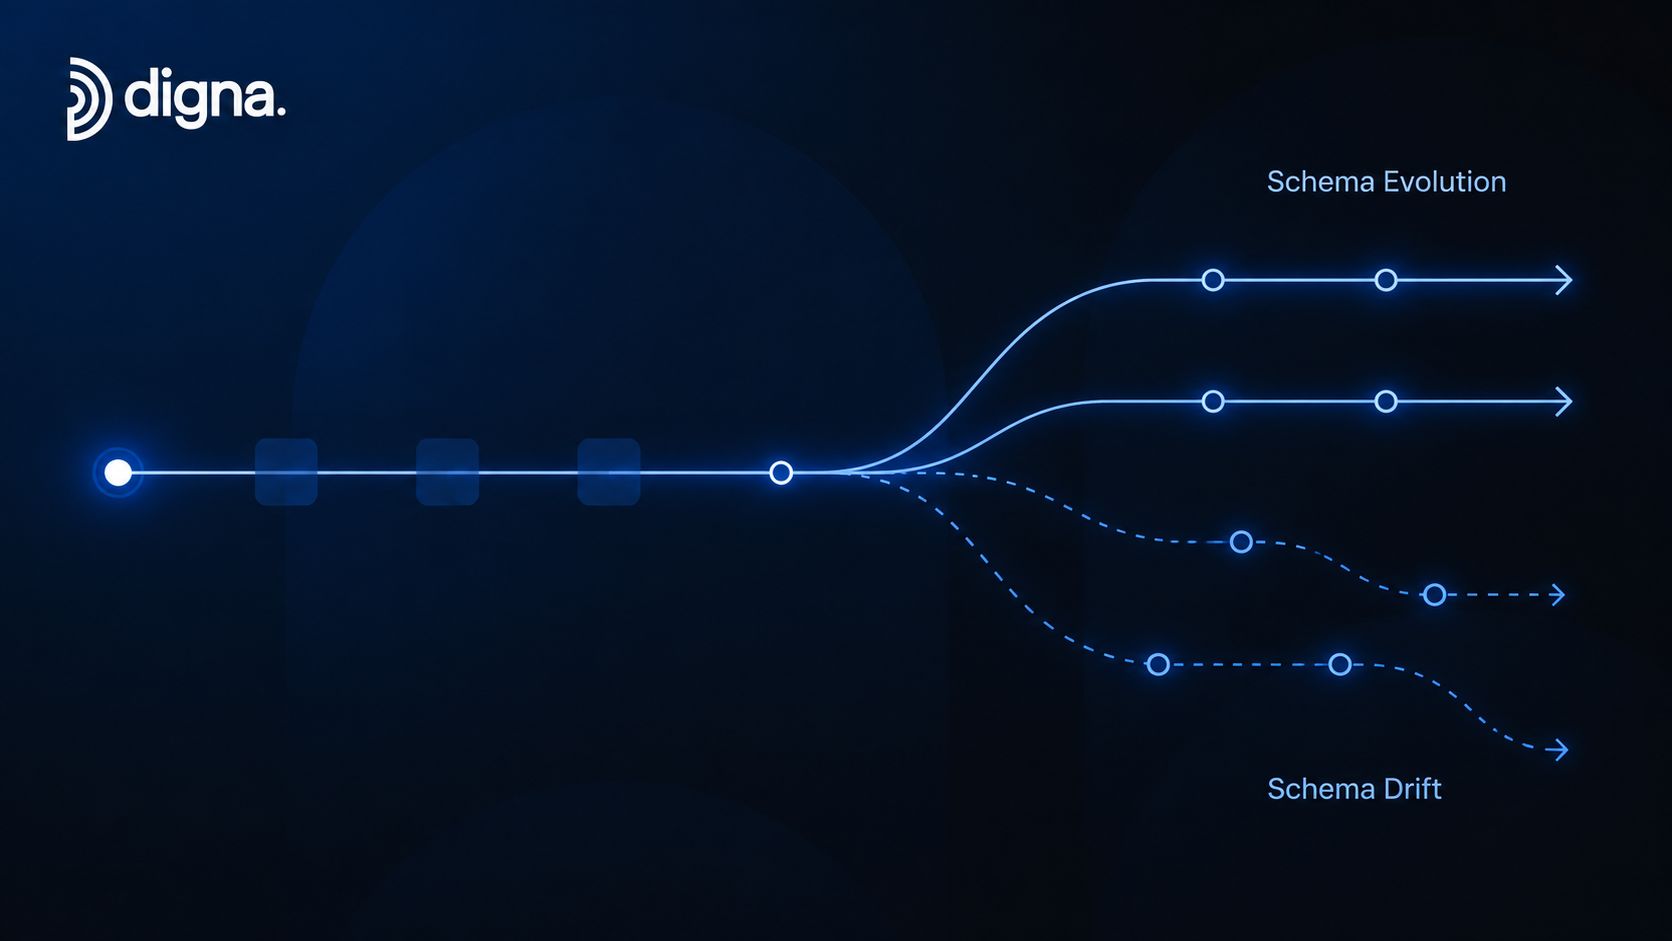
Schema-Evolution ist eine geplante Änderung. Ein Team führt eine neue nullable Spalte ein, veröffentlicht die Migration, aktualisiert den Vertrag und stimmt sich mit den Konsumenten ab. Es mag weiterhin Arbeit anfallen, aber zumindest ist die Änderung beabsichtigt.
Schema-Drift entsteht, wenn Spalten ohne geeignete Migrationskontrollen hinzugefügt, entfernt oder geändert werden. Laut dieser Erklärung zu Schema-Drift und nachgelagerten Ausfällen können solche Änderungen nachgelagerte Anwendungen unerwartet lahmlegen.
Wenn Sie eine tiefergehende Analyse dieses Fehlermodus wünschen, ist dieser Leitfaden dazu, wie strukturelle Änderungen Datenpipelines lahmlegen, hilfreich, weil er Drift als Problem der betrieblichen Zuverlässigkeit einordnet und nicht nur als Modellierungsproblem.
Fünf häufige Ursachen in realen Systemen
Diese Ursachen begegnen mir am häufigsten:
Feature-Entwicklung in Quellanwendungen
Produktteams fügen Felder für neue Workflows hinzu, aber die Analytics-Konsumenten erfahren nie von dem Release.Typänderungen bei Service-Refactorings
Ein Service liefert IDs plötzlich als Strings statt als numerische Werte, oder ein Datumsfeld ändert sein Format.Überarbeitungen von Drittanbieter-APIs
Anbieter fügen verschachtelte Attribute hinzu, kündigen Felder ab oder benennen Payload-Schlüssel um.Ungeprüfte manuelle Datenbankänderungen
Jemand führt DDL direkt in der Produktion oder in einer gemeinsam genutzten Umgebung aus, ohne Migrationspfad.Abweichungen zwischen Umgebungen
Dev, Staging und Produktion stimmen nicht mehr überein, sodass sich das Verhalten der Pipeline nach dem Deployment ändert.
Wie gesunde Evolution aussieht
Gute Evolution ist nachvollziehbar dokumentiert. Die DDL ist versioniert. Die Konsumenten wissen, was sich geändert hat. Für Tabellen mit hoher Tragweite gibt es Kompatibilitätsfenster. Nach dem Deployment laufen Validierungsprüfungen.
Geplante Schemaänderungen sind normales Engineering. Nicht nachverfolgte Schemaänderungen sind Brandbeschleuniger für Incidents.
Diese Unterscheidung ist wichtig, weil beide Ereignisse auf Tabellenebene identisch aussehen können. Der Unterschied liegt in Governance, Sichtbarkeit und der Frage, ob nachgelagert überhaupt jemand die Chance hatte, sich vorzubereiten.
Die hohen Kosten stiller Schemaänderungen
Eine Schemaänderung wird in dem Moment teuer, in dem nachgelagerte Systeme annehmen, dass die alte Struktur noch gilt. Die Lehrbuchdefinition eines Schemas ist einfach. Es definiert Tabellen, Spalten, Typen und Beziehungen. In der Produktion entscheidet es außerdem darüber, ob Ihr Dashboard vertrauenswürdig ist, ob Ihre Feature-Pipeline noch zu den Trainingsannahmen passt und ob Engineers den Nachmittag damit verbringen, Arbeit auszuliefern, oder damit, die Folgen zu debuggen.

Szenario eins: Die Pipeline schlägt sofort fehl
Das ist der sichtbare Fehlermodus. Eine Quellspalte wird entfernt oder umbenannt. Eine Transformation referenziert das alte Feld. Der Job schlägt fehl, Alerts werden ausgelöst, und die Engineerin in Rufbereitschaft hat einen konkreten Fehler, dem sie nachgehen kann.
Ein solcher Ausfall ist teuer, aber zumindest begrenzt. Das Team vergleicht Versionen, korrigiert die Transformation, führt den Job erneut aus und erklärt den nachgelagerten Nutzern die Verzögerung. Sie verlieren Engineering-Zeit und Aktualität, aber in der Regel nicht lange das Vertrauen, weil der Fehler offensichtlich ist.
Szenario zwei: Das Dashboard läuft weiter, zeigt aber falsche Werte
Das ist der Incident, den Teams unterschätzen.
Eine Typänderung, eine Schlüsselabweichung oder ein geändertes Verhalten bei Nullwerten kann die Pipeline grün lassen, während die Kennzahl falsch wird. Der Join läuft weiterhin, aber es passen weniger Zeilen zusammen. Der Cast läuft weiterhin, aber ungültige Werte werden zu Null. Umsatz landet in der falschen Kategorie, oder ein KPI fällt aus Gründen, die nichts mit dem Geschäft zu tun haben.
Sobald das passiert, verlässt das Problem die Datenplattform und erreicht die Entscheidungsfindung. Analysten beginnen, Modelllogik, Warehouse-Tabellen und Quell-Feeds nachzuverfolgen. Führungskräfte stellen die Zahl in Frage, bevor irgendjemand das Schema in Frage stellt. Die Kosten bestehen dann nicht mehr nur aus Rechenleistung oder Engineering-Stunden. Es geht um langsamere Entscheidungen, wiederholte Validierungsarbeit und geringeres Vertrauen in jeden Bericht, der auf diesem Datensatz basiert.
Stille Schemaprobleme sind gefährlich, weil das Ergebnis weiterhin brauchbar aussieht.
Deshalb gehört Schemamanagement zur Zuverlässigkeitsarbeit und nicht nur zur Dokumentation.
Szenario drei: Das ML-System verschlechtert sich ohne offensichtlichen Fehler
ML-Pipelines verzeihen weniger als viele Reporting-Workflows. Ein Modell kann weiterhin Scores berechnen, während sich das Feature-Set von dem entfernt, was im Training erwartet wurde.
Ein numerisches Feld kommt als Text an. Ein kategorialer Wert erhält eine neue Kodierung. Eine dünn besetzte Spalte wird nach einem Anwendungs-Release anders befüllt. Keine dieser Änderungen muss eine Exception auslösen, um Schaden anzurichten. Sie können Feature-Verteilungen verschieben, in der Vorverarbeitung verankerte Annahmen brechen und einen Training-Inference-Skew erzeugen, dessen Diagnose Tage dauert.
In der Praxis wird Schema-Drift zu einem Problem des KI-Betriebs. Teams brauchen Prüfungen der Feature-Struktur, bevor die Modellausgabe als vertrauenswürdig gilt. Ein Workflow zur Nachverfolgung von Schemaänderungen für produktive Datenbestände hilft, solche Änderungen zu erkennen, bevor sie nachgelagerte Scoring- oder Retraining-Jobs erreichen.
Kosten, die Sie auch ohne gemeldeten Incident spüren
Auch wenn niemand einen Incident eröffnet, kommt die Rechnung trotzdem:
Unterbrechung der Engineering-Arbeit: Data Engineers und Analytics Engineers unterbrechen geplante Arbeit, um strukturellen Abweichungen über Systeme hinweg nachzugehen.
Vertrauensverlust: Fachanwender verlangen eine manuelle Validierung, bevor sie auf Basis von Dashboard-Zahlen handeln.
Reibung bei Releases: Jede vorgelagerte Änderung fühlt sich riskant an, weil die nachgelagerten Auswirkungen schwer vorherzusagen sind.
Verschwendung bei Speicher und Abfragen: Mangelnde Schemadisziplin führt oft zu doppelten Feldern, inkonsistenten Typen, breiteren Tabellen als nötig und teureren Verarbeitungsmustern.
Was funktioniert und was scheitert
Teams erzielen bessere Ergebnisse, wenn sie Schemaänderungen als Produktionsänderungen mit Auswirkungen auf Konsumenten behandeln. Prüfen Sie die DDL. Vergleichen Sie die aktuelle Struktur mit einer Baseline. Prüfen Sie, ob gemeinsam genutzte Modelle, Dashboards und Feature-Pipelines noch dem Vertrag entsprechen, auf dessen Grundlage sie gebaut wurden.
Was scheitert, ist informelle Abstimmung. Eine Nachricht im Chat, Release Notes, die niemand liest, oder die Annahme, dass eine grüne Pipeline bedeutet, dass die Daten noch korrekt sind. Betrieblich ist das Schema Teil der Vertragsoberfläche der Plattform. Wenn Sie diese Oberfläche nicht überwachen, werden stille Ausfälle zu einem wiederkehrenden Kostenfaktor.
Best Practices für Schemamanagement und -Monitoring
Manuelles Schemamanagement scheitert meist an Teamgrenzen. Ein Pull Request wird im Anwendungs-Repository gemergt, aber das Analytics-Team beobachtet dieses Repository nicht. Jemand aktualisiert einen Drittanbieter-Connector, aber der Modellverantwortliche sieht die Release Notes nie. Dokumentation existiert, hinkt der Realität aber hinterher.
Besser ist es, das Schema als beobachtbares Produktions-Asset zu behandeln.
Einen Änderungsprozess aufbauen, den die Teams tatsächlich nutzen
Ein schwergewichtiges Governance-Modell klingt auf dem Papier gut und wird in der Praxis oft umgangen. Halten Sie den Prozess so schlank, dass Produktentwickler ihn auch befolgen.
Nutzen Sie einige einfache Regeln:
DDL-Änderungen versionieren: Bewahren Sie Tabellendefinitionen und Migrationen in der Versionsverwaltung auf.
Tabellenzuständigkeit festlegen: Jeder wichtige Datensatz sollte ein Team haben, das strukturelle Änderungen freigibt.
Auswirkungen auf Konsumenten einstufen: Halten Sie fest, ob eine Änderung additiv, inkompatibel oder verhaltensändernd ist.
Rollout-Hinweise für gemeinsam genutzte Tabellen verlangen: insbesondere für Fakten und Dimensionen im Warehouse sowie für ML-Feature-Quellen.
Struktur überwachen, nicht nur Aktualität
Das Monitoring der Aktualität sagt Ihnen, ob Daten angekommen sind. Es sagt Ihnen nicht, ob ihre Form noch nutzbar ist. Zeilenanzahlen zeigen Ihnen das Volumen. Sie zeigen Ihnen nicht, ob eine Schlüsselspalte umbenannt wurde.
Deshalb muss Schema-Monitoring die aktuelle Struktur mit einer bekannten Baseline vergleichen und DDL-Änderungen wie hinzugefügte Spalten, entfernte Spalten und Typänderungen melden. Eine Option ist der digna Schema Tracker, der Tabellenschemas, Spalten und Datentypen überwacht, um strukturelle Änderungen zu erkennen. Das übergeordnete Muster ist wichtiger als die Wahl des Anbieters. Nutzen Sie eine Plattform, interne Tools oder Warehouse-native Prüfungen, aber stellen Sie sicher, dass die Struktur Teil Ihres operativen Monitorings ist.
Schema-Alerts in die Incident Response einbinden
Ein Schema-Alert, der in einem vergessenen Postfach landet, hilft wenig. Das Signal muss die Personen erreichen, die für Pipelines, Dashboards und Modelleingaben verantwortlich sind.
Ein praxistaugliches Betriebsmuster sieht so aus:
Alerts an dieselben Kanäle wie Pipeline-Incidents leiten: Bereitschaftssysteme, Chat-Benachrichtigungen oder Incident-Tools.
Definitionen vor und nach der Änderung beifügen: Engineers brauchen den exakten strukturellen Diff, keine vage Warnung.
Betroffene Assets nach Möglichkeit verlinken: Dashboards, Jobs, Feature-Tabellen und nachgelagerte Konsumenten.
Validierung nach der Änderung durchführen: Prüfen Sie nach strukturellen Updates kritische Joins, Regeln auf Zeilenebene und zentrale Kennzahlen.
Kernaussage: Wenn Ihr Team einen fehlgeschlagenen Job innerhalb von Minuten erkennt, eine geänderte Spalte aber erst, wenn sich ein Stakeholder beschwert, ist Ihr Monitoring-Stack unvollständig.
Das Schema nützlich halten
Gute Schemas sind nicht nur korrekt. Sie sind auch wartbar. Normalisieren Sie dort, wo es die Integrität verbessert und Duplikate reduziert. Verwenden Sie Namenskonventionen, die personelle Wechsel im Team überdauern. Vermeiden Sie es, geschäftskritische Semantik in schwach typisierten Feldern zu verstecken, wenn ein sauberes Modell den Vertrag explizit machen würde.
Behandeln Sie Schemamanagement nicht als einmalige Designübung. In laufenden Systemen ist es kontinuierliche Betriebsarbeit.
Wenn Schemaänderungen zu den schnellsten Wegen gehören, Pipelines, Dashboards und Modelleingaben lahmzulegen, brauchen sie erstklassiges Monitoring. digna hilft Teams, strukturelle Änderungen gemeinsam mit Datenqualität, Aktualität, Validierung und Anomalieerkennung nachzuverfolgen, sodass Schemaprobleme sichtbar werden, bevor sie zu nachgelagerten Incidents werden.
Eine Schemaänderung zu erkennen ist nur die halbe Arbeit. Um zu bestätigen, dass kritische Joins und Regeln auf Zeilenebene nach einem strukturellen Update weiterhin gelten, lesen Sie mehr über digna Data Validation.
Häufig gestellte Fragen
Was ist ein Schema in einer Datenbank?
Ein Schema ist der strukturelle Bauplan einer Datenbank. Es definiert Tabellen, Spalten, Datentypen, Constraints und Beziehungen wie Fremdschlüssel, ohne die Daten selbst zu enthalten. In relationalen Systemen ist es formal eine Menge von Integritäts-Constraints, und in der Produktion fungiert es zudem als Vertrag, auf den Pipelines, Dashboards und Modelle angewiesen sind.
Was ist der Unterschied zwischen konzeptionellen, logischen und physischen Schemas?
Diese drei ANSI/SPARC-Ebenen scheitern auf unterschiedliche Weise. Die konzeptionelle Ebene definiert Geschäftsobjekte wie Kunden und Bestellungen, die logische Ebene überführt sie in Entitäten, Schlüssel und Beziehungen, und die physische Ebene ergänzt Datentypen, Indizes und Partitionierung für eine bestimmte Engine. Eine verschobene Spalte customer_tier ist ein logisches Problem, eine langsame Partition ein physisches.
Was bedeutet Schema-on-Write im Vergleich zu Schema-on-Read?
Bei Schema-on-Write müssen Daten der erwarteten Struktur entsprechen, bevor die Datenbank sie akzeptiert, was sich für Zahlungen, Bestellungen und kuratierte Warehouses eignet. Schema-on-Read nimmt Daten zuerst auf und wendet die Struktur erst bei der Abfrage an, wie es in Data Lakes üblich ist. Ein bewährtes Muster lässt bei der Aufnahme Flexibilität zu und setzt eine strengere Struktur durch, sobald die Daten in kuratierte Schichten wandern.
Was ist der Unterschied zwischen Schema-Evolution und Schema-Drift?
Schema-Evolution ist geplant: Ein Team fügt eine nullable Spalte hinzu, veröffentlicht die Migration, aktualisiert den Vertrag und stimmt sich mit den Konsumenten ab. Schema-Drift bedeutet, dass Spalten ohne Migrationskontrollen hinzugefügt, entfernt oder geändert werden. Beides kann auf Tabellenebene identisch aussehen. Der Unterschied liegt in Governance, Sichtbarkeit und der Frage, ob nachgelagerte Teams die Chance hatten, sich vorzubereiten.
Warum legen Schemaänderungen Datenpipelines lahm?
Nachgelagerte Jobs gehen davon aus, dass die alte Struktur noch gilt. Eine umbenannte Spalte, ein entferntes Feld oder eine Typänderung von Integer zu String kann daher einen Job zum Absturz bringen oder, schlimmer noch, ihn grün lassen, während Joins weniger Zeilen zuordnen. Cockroach Labs, im Artikel zitiert, führt 60 bis 70 Prozent der Pipeline-Ausfälle auf unerwartete Schemaänderungen zurück.



