Was ist ein offenes Tabellenformat
|
10
min. Lesezeit

Sie sind vermutlich hier, weil Ihr Lake in einem Werkzeug bereits wie eine Tabelle aussieht, sich in einem anderen aber wie ein Haufen Dateien verhält.
Ein Finanz-Dashboard verändert sich nachträglich. Ein Backfill repariert eine Abfrage und zerstört eine andere. Spark-Schreibvorgänge gelingen, Trino liest veraltete Daten, und niemand kann eine einfache Frage beantworten: Welche Version dieses Datensatzes ist die richtige? An diesem Punkt hören Menschen auf zu fragen „welches Dateiformat sollen wir nehmen?“ und beginnen zu fragen: Was ist ein offenes Tabellenformat eigentlich?
Die kurze Antwort ist einfach. Ein offenes Tabellenformat ist die Metadatenschicht, die Object Storage wie eine Datenbanktabelle verhalten lässt. Die längere Antwort zählt mehr, denn das Format selbst ist nur die halbe Geschichte. Die andere Hälfte ist, wie Ihr Team es betreibt: Kompaktierung, Schemakontrolle, Kataloge und Observability.
Inhaltsverzeichnis
Der Moment, in dem ein Data Lake seine Vertrauenswürdigkeit verliert
Ein typischer Fehler nimmt seinen Anfang.
Das Finanzteam prüft den gestrigen Umsatzbericht und stellt fest, dass er nicht mehr zum Dashboard passt. Keine Pipeline ist rot. Kein Orchestrator zeigt eine fehlgeschlagene Aufgabe. Die Dateien liegen weiterhin im Object Storage. Doch irgendwo zwischen einem Streaming-Append und einem Wartungsjob haben Reader eine unvollständige Sicht auf die Tabelle erwischt.
Warum roher Speicher auf subtile Weise bricht
Object Storage ist sehr gut darin, Dateien zu halten. Er ist für sich genommen kein Tabellensystem.
Wenn Sie Parquet-Dateien in einem Ordner ablegen und diesen Ordner revenue nennen, haben Sie die Fragen, die Analystinnen interessieren, noch nicht beantwortet:
Welche Dateien gehören gerade zur Tabelle
Welcher Schreibvorgang erzeugte die aktuelle Version
Welches Schema sollte ein Reader verwenden
Wie sah die Tabelle letzte Woche aus
Welche Dateien darf eine Abfrage gefahrlos ignorieren
Ohne diese Metadatenschicht muss jede Engine den Zustand aus Verzeichnislisten und Dateinamen erschließen. Das funktioniert eine Weile. Dann schreibt jemand Partitionen neu, kompaktiert Dateien oder ändert einen Spaltentyp, und Reader sehen aus demselben Speicherpfad unterschiedliche Wahrheiten.
Rohe Dateien können Daten korrekt speichern und trotzdem unzuverlässige Analytik erzeugen.
Die fehlende Schicht
Ein offenes Tabellenformat ergänzt den fehlenden Nachweis des Tabellenzustands neben den Daten selbst. Statt Speicher als „welche Dateien auch immer unter diesem Präfix liegen“ zu behandeln, hält es eine geregelte Sicht auf die Tabelle fest: aktuelle Dateien, historische Snapshots, Schema und Layout-Metadaten.
Deshalb entdecken Teams, die in Data-Lake-Monitoring investieren, oft dasselbe Muster. Das Problem ist meist nicht nur ein fehlerhafter Dateischreibvorgang. Es ist, dass der Plattform eine verlässliche Möglichkeit fehlt, den Tabellenzustand über Reader und Writer hinweg zu beschreiben.
Der Unterschied wirkt klein, bis zur ersten stillen Inkonsistenz. Danach wird er grundlegend.
Was ein offenes Tabellenformat tatsächlich leistet
Eine neue Pipeline liefert Ersatzdateien für revenue. Der Spark-Job endet. Eine Analystin aktualisiert ein Dashboard in Trino. Ein Machine-Learning-Feature-Job liest dieselbe Tabelle über eine andere Engine. Alle drei Abfragen treffen denselben Speicherpfad, sehen aber nicht immer dieselbe Antwort.
Genau diese Lücke soll ein offenes Tabellenformat schließen.
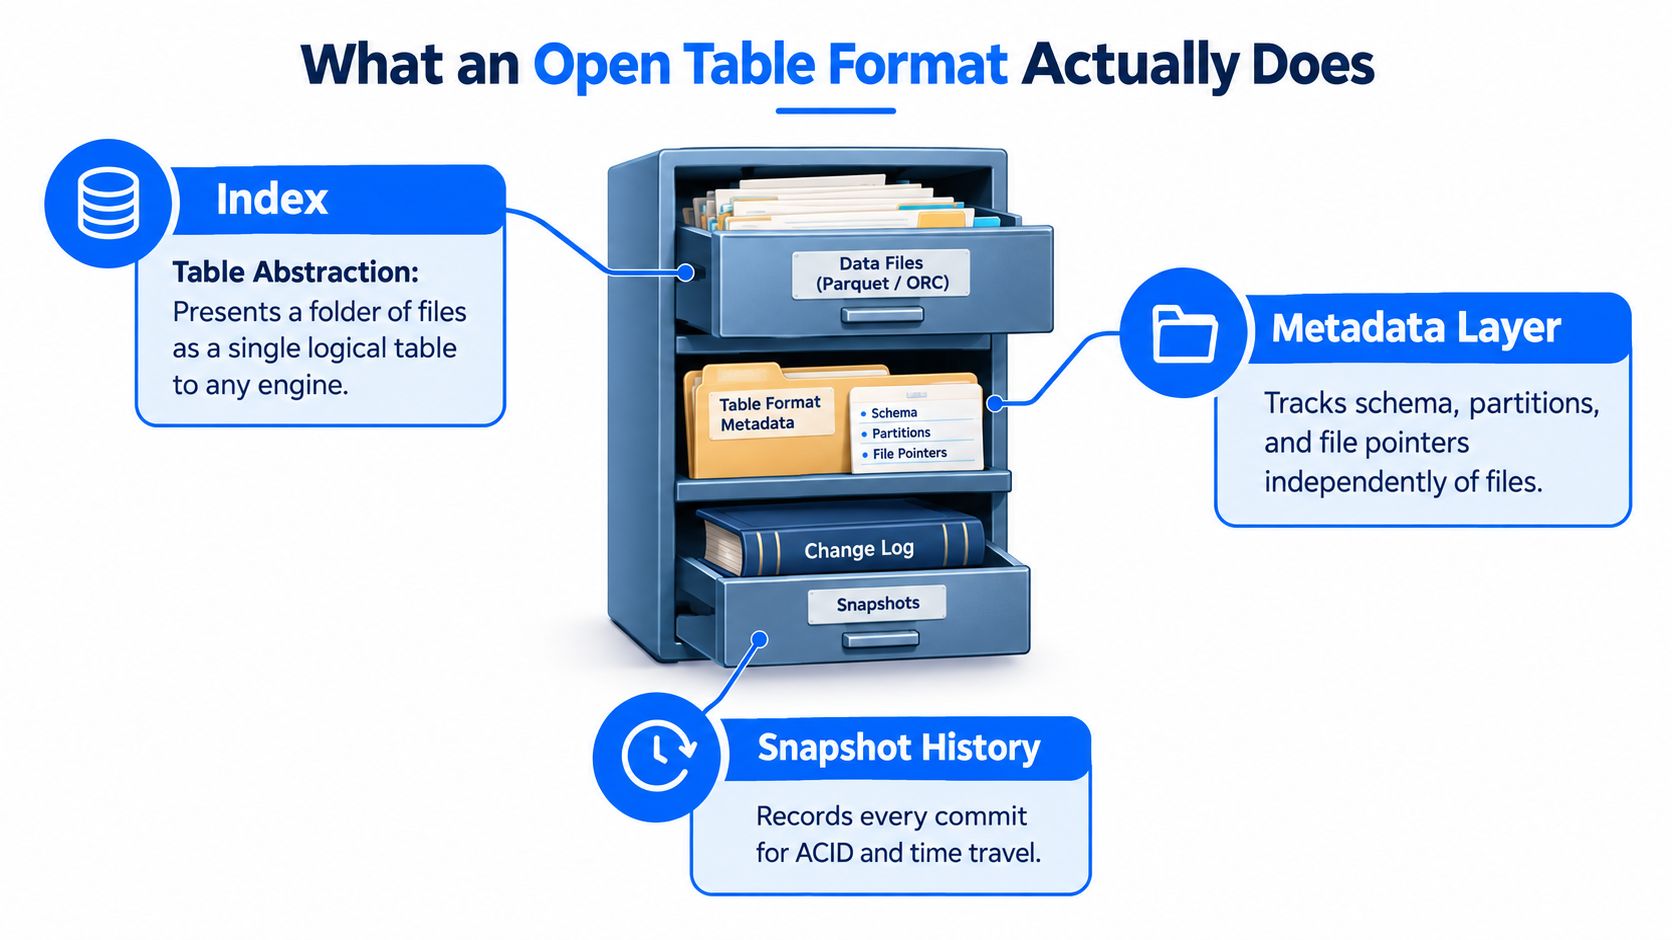
Es liegt über den Dateien und definiert den Tabellenzustand
Offene Tabellenformate werden oft mit Dateiformaten verwechselt, weil beide im selben Speicher-Bucket auftauchen. Sie lösen verschiedene Probleme.
Parquet, ORC und Avro definieren, wie eine einzelne Datei Zeilen und Spalten speichert. Ein offenes Tabellenformat definiert, wie eine Sammlung von Dateien zu einer logischen Tabelle wird, die viele Engines sicher lesen und schreiben können. Databricks beschreibt offene Tabellenformate als Metadatenschicht über Parquet, ORC oder Avro im Object Storage, die Tabellenfunktionen wie ACID-Transaktionen, Schemaevolution und Time Travel ergänzt, in seiner Übersicht zu offenen Tabellenformaten.
Wenn diese Unterscheidung noch verschwommen wirkt, hilft dieser Leitfaden dazu, was Parquet ist und wie es spaltenorientierte Daten speichert. Parquet beantwortet „wie ist diese Datei codiert?“. Ein Tabellenformat beantwortet „welche Dateien bilden die Tabelle, und welcher Version sollen Reader trauen?“
Das Format wirkt wie die Steuerungsebene der Tabelle
Ein nützliches Denkmodell ist eine Git-Historie für Datendateien, mit strengeren Regeln rund um Nebenläufigkeit und Schema. Das Tabellenformat führt Buch über den aktuellen Zustand und den Weg dorthin. Query-Engines müssen keine Ordner durchsuchen und raten. Sie können die Tabellenmetadaten lesen und erhalten eine exakte Antwort.
In der Praxis erledigt diese Metadatenschicht vier Aufgaben.
Dateizugehörigkeit erklären
Das Format hält fest, welche Dateien gerade zur Tabelle gehören. Schreibt die Kompaktierung zehn kleine Dateien in eine größere um, folgen Reader dem Metadatenzeiger auf die gültige Menge, statt Altes und Neues zu vermischen.Snapshots atomar veröffentlichen
Ein Schreibvorgang wird als neuer, committeter Snapshot sichtbar. Reader sehen die alte oder die neue Version, nicht einen Zwischenzustand, in dem die Hälfte der Dateien getauscht ist.Schema als Tabellenmetadaten führen
Spaltennamen, Typen, Feld-IDs und zulässige Änderungen leben in der Tabellendefinition, nicht nur in dem, was ein Writer zufällig ausgegeben hat. Das zählt, sobald verschiedene Engines Spalten umbenennen, Typen weiten oder verschachtelte Felder ergänzen.Layout- und Pruning-Metadaten speichern
Partitionswerte, Dateistatistiken und mitunter Löschmetadaten helfen Engines, irrelevante Dateien zu überspringen und Abfragen effizient zu planen.
Die operative Schicht wird von Teams meist unterschätzt
Die Funktionsliste ist der einfache Teil. Beim Betriebsmodell verdienen sich offene Tabellenformate ihr Geld.
Sobald ein Format den Tabellenzustand besitzt, muss Ihr Team entscheiden, wer die Kompaktierung verantwortet, wer Schemaänderungen genehmigt und welcher Katalog die Quelle der Wahrheit ist. Das sind Produktionsfragen, keine Prospektfragen. Verantwortet niemand die Kompaktierung, häufen sich kleine Dateien und die Abfrageleistung driftet. Darf jeder Writer das Schema frei ändern, kann ein schlechtes Deployment nachgelagerte Reader brechen. Nutzt Spark eine Katalogsicht und Trino eine andere, sind Sie wieder bei mehreren Wahrheiten, nur mit besserem Branding.
Das Format liefert die Mechanismen. Ihr Plattformteam braucht weiterhin Regeln.
Warum der Unterschied im Alltag zählt
Ohne Tabellenformat heißt Daten schreiben oft „Dateien wurden hochgeladen“. Mit Tabellenformat heißt Daten schreiben „eine neue Tabellenversion wurde committet und veröffentlicht“.
Das ist ein stärkerer Vertrag für jedes nachgelagerte System. Batch-Jobs, BI-Abfragen und Streaming-Reader können sich auf den Tabellenzustand einigen. Engines können über gemeinsame Metadaten zusammenspielen statt über Konventionen im Speicherpfad. Data Engineers können über Wartungsarbeiten wie Kompaktierung oder Partitionsevolution nachdenken, ohne jedes Umschreiben als potenziellen Ausfall zu behandeln.
Ein offenes Tabellenformat ist also die Schicht, die Object Storage in ein Tabellensystem verwandelt, das Menschen mit Zuversicht betreiben können. Das Dateiformat zählt weiterhin. Der verborgene Gewinn ist, dass die Metadaten Ihrem Team einen kontrollierten Weg geben, den Tabellenzustand konsistent zu halten, während Schreibvorgänge, Schemata und Engines sich vermehren.
Wie sich das Format von Hive zum Lakehouse entwickelte
Die Geschichte zählt, weil jedes Format geschaffen wurde, um einen bestimmten Schmerz zu beheben, und nicht, um eine Funktionsmatrix zu gewinnen.
Eine nützliche Zeitachse aus der Geschichte und Entwicklung offener Tabellenformate verortet Apache Hive 2008, Apache Hudi 2016, Apache Iceberg 2017 und Delta Lake 2017 bis 2019. Diese Abfolge zeigt, wie schnell die Tabellenschicht des Lakehouse reifte, sobald Teams an die Grenzen früher Data-Lake-Muster stießen.

Hive löste das Problem einer Epoche
Hive gab frühen Hadoop-Teams eine Möglichkeit, Dateien auf HDFS als Tabellen zu behandeln. Sein Partitionsmodell stützte sich stark auf die Verzeichnisstruktur. Das passte zu den Annahmen der Zeit.
Diese Annahmen alterten im Cloud-Object-Storage schlecht. Verzeichnisartige Partitionierung wurde brüchig. Listing- und Rename-Verhalten fühlten sich nicht wie HDFS an. Langlebige Tabellen wurden unhandlich, wenn sich Partitionsstrategien änderten.
Die nächste Welle behob konkrete Fehlerbilder
Jedes neuere Format reagierte auf eine andere operative Schwäche.
Apache Hudi entstand 2016, um Workloads zu unterstützen, die Upserts auf Satzebene und inkrementelle Verarbeitung in Data-Lake-Umgebungen brauchten.
Apache Iceberg kam 2017, um Probleme rund um große analytische Tabellen, Metadatenskalierung und Partitionsevolution anzugehen.
Delta Lake nahm 2017 bis 2019 Gestalt an, als transaktionslogbasierter Weg, verlässliches ACID-Verhalten in offenen Speicher zu bringen.
Damit war die Branche über „wie legen wir Dateien in einen Lake?“ hinaus bei „wie teilen sich mehrere Engines vertrauenswürdige Tabellen auf günstigem Speicher?“ angekommen.
Der Name Lakehouse kam nach der technischen Wende
Die architektonische Wende kam zuerst. Das Etikett Lakehouse folgte.
Wenn Sie den breiteren Stack-Kontext rund um Formate, Kataloge, Engines und Governance wollen, ist dieser Leitfaden dazu, was ein Lakehouse ist und wie man Datenqualität erhält, die Gesamtsicht. Der wichtige Punkt hier ist enger: Offene Tabellenformate wurden zur Schicht, die Lakehouse-Versprechen technisch glaubwürdig machte.
Bis 2025 bis 2026 war diese Schicht weiter gereift. Dieselbe Zeitachse hält fest, dass Icebergs v3-Tabellenspezifikation 2025 ratifiziert wurde und Iceberg 1.10 und 1.11 stabile Unterstützung für Funktionen wie Deletion Vectors, Variant-Typen, Geodatentypen und Nanosekunden-Zeitstempel brachten, in dieser späteren Phase der Formatentwicklung.
Iceberg, Delta Lake und Hudi im Vergleich
Eine Formatentscheidung wirkt während der Evaluierung meist einfach. Dann startet die Produktion, ein Streaming-Job fällt zurück, kleine Dateien häufen sich, zwei Engines sind sich über Schemaänderungen uneins, und die Frage taucht auf: Wer verantwortet die Tabellenwartung, und wie vorhersehbar ist diese Arbeit?
Apache Iceberg, Delta Lake und Apache Hudi sind allesamt produktionsreife Tabellenformate. Der nützliche Vergleich ist nicht bloße Funktionsgleichheit. Es geht darum, wie jedes Format Metadaten organisiert, Schreibvorgänge koordiniert und die Verantwortung für operative Pflichten wie Kompaktierung, Aufräumen und engine-übergreifende Kompatibilität zuweist.
Der größte Unterschied liegt in der Metadatenarchitektur
Die Speicherdateien mögen alle im Object Storage liegen, doch jedes Format führt das „Inhaltsverzeichnis“ der Tabelle anders. Dremios Überblick zur Architektur von Iceberg, Delta Lake und Hudi ist ein guter Bezugspunkt:
Delta Lake erfasst Tabellenänderungen in einem sequenziellen Transaktionslog unter
_delta_log.Iceberg verfolgt den Tabellenzustand über Snapshot-Metadaten und Manifest-Dateien, die beschreiben, welche Datendateien zu welcher Version gehören.
Hudi führt eine Zeitachse von Aktionen, einschließlich Commits und Wartungsvorgängen wie Kompaktierung, Clustering und Cleaning.
Diese Entwurfsentscheidung wirkt auf mehr als die Leseleistung. Sie ändert, wie schnell Metadaten wachsen, wie sicher mehrere Engines schreiben können, wie Partitionsänderungen behandelt werden und wie viel Routinepflege die Tabelle von Ihrem Team braucht.
Iceberg, Delta Lake und Hudi auf einen Blick
Dimension | Apache Iceberg | Delta Lake | Apache Hudi |
|---|---|---|---|
Metadatenentwurf | Snapshot-Metadaten mit Manifestlisten und Manifesten | Sequenzielles Transaktionslog in | Zeitachse unveränderlicher Instants für Schreibvorgänge und Tabellendienste |
Partitionierungsmodell | Hidden Partitioning und Partitionsevolution, sodass sich das logische Partitionsschema ändern kann, ohne ältere Dateien neu zu schreiben | Partitionsverhalten wird über den log-verfolgten Tabellenzustand und Writer-Konventionen gesteuert | Auf ingestionslastige Layouts ausgelegt, mit Diensten, die Dateien im Lauf der Zeit umorganisieren |
Nebenläufigkeitsstil | Snapshot-Isolationsmodell rund um Tabellenversionen und Metadatentausch | Logbasiertes Commit-Protokoll mit optimistischen Nebenläufigkeitsmustern | Zeitachsenbasiertes Commit-Protokoll, oft gepaart mit Hintergrunddiensten |
Beste Passung | Geteilte analytische Tabellen über mehrere Engines hinweg | Spark-zentrierte Plattformen, besonders wo Delta-native Werkzeuge zum Alltag gehören | Häufige Upserts, Change Capture und inkrementelle Verarbeitung |
Wichtigster Kompromiss | Starke Interoperabilität, doch Katalogdisziplin zählt und engine-übergreifende Schreibregeln müssen explizit sein | Operative Muster fallen dort am leichtesten, wo Spark und Delta-bewusste Werkzeuge den Standard setzen | Die Schreibflexibilität ist stark, aber Kompaktierung und Clustering brauchen aktive Planung und klare Verantwortung |
Interoperabilitätshaltung | Breite Unterstützung über Engines und Kataloge hinweg. Die Apache-Iceberg-Spezifikation ist ein Grund, warum viele Teams es als neutralste Option für geteilte Tabellen sehen | Starkes Spark-Erbe, mit wachsender Kompatibilität im weiteren Ökosystem | Die Interoperabilität hat sich verbessert, doch die Betriebsannahmen sind weiterhin eher ingestionsorientiert als engine-neutral |
Die bessere Entscheidungsbrille: Wer betreibt die Tabelle?
Vergleicht ein Team nur Häkchen, wirken alle drei ähnlich. In der Praxis erzeugen sie unterschiedliche Bereitschaftsarbeit.
Iceberg passt oft zu Organisationen, die eine Tabelle von mehreren Engines lesen lassen und über eine Katalogschicht steuern wollen. Der Vorteil ist Portabilität. Der Preis ist Disziplin. Schemaänderungen, Sortierreihenfolgen, Dateigrößen, Snapshot-Aufbewahrung und Katalogkonsistenz brauchen klare Verantwortung, besonders sobald mehr als eine Compute-Engine schreiben darf.
Delta Lake passt oft zu Plattformen, die bereits auf Spark-Abläufen und Delta-bewussten Werkzeugen aufbauen. Der operative Pfad kann geradlinig sein, weil Transaktionsmodell und umgebende Werkzeuge eng abgestimmt sind. Der Kompromiss ist, dass die Interoperabilitätsstrategie mit der Zeit wichtiger wird, wenn die Plattform über ihre ursprünglichen Engine-Annahmen hinauswächst.
Hudi passt oft zu ingestionslastigen Systemen, in denen Updates auf Satzebene und inkrementeller Konsum zum Kerndesign gehören. Diese Stärke bringt sichtbarere Tabellendienste mit sich. Kompaktierung, Clustering und Cleanup sind keine Nebensache. Jemand muss sie planen, überwachen und entscheiden, wann Schreiblatenz mehr zählt als Lese-Layout.
Hier hört Verlässlichkeitsarbeit auch auf, von Qualitätsarbeit getrennt zu sein. Ein verspäteter Kompaktierungsjob, eine ungeprüfte Schemaänderung oder eine Engine, die mit falschen Katalogeinstellungen schreibt, kann Vorfälle erzeugen, die Analystinnen als „schlechte Daten“ erleben. Teams mit Spark-zentrierten Plattformen bewerten die Formatwahl oft zusammen mit Praktiken für Datenqualitätsmanagement in Databricks, weil Tabellenkorrektheit und Datenqualitätsprüfungen im selben Produktionsablauf zusammentreffen.
Das falsche Format scheitert selten während einer Demo. Es scheitert bei der Wartungsaufgabe, von der Ihr Team annahm, sie erledige sich von selbst.
ACID, Time Travel und Schemaevolution erklärt
Ein Tabellenformat wird beim ersten Produktionsfehler real. Eine Pipeline schreibt die Hälfte ihrer Dateien, scheitert am Rest, und eine Analystin aktualisiert das Dashboard genau im falschen Moment. Ohne Transaktionskontrolle legt der Lake dieses Chaos direkt offen. Mit einem offenen Tabellenformat sehen Reader weiterhin den letzten gültigen Tabellenzustand, bis der neue vollständig committet ist.
ACID heißt, die Tabelle hat einen klaren Commit-Punkt
Der praktische Nutzen von ACID im Lakehouse ist simpel. Reader sehen keine halbfertige Arbeit.
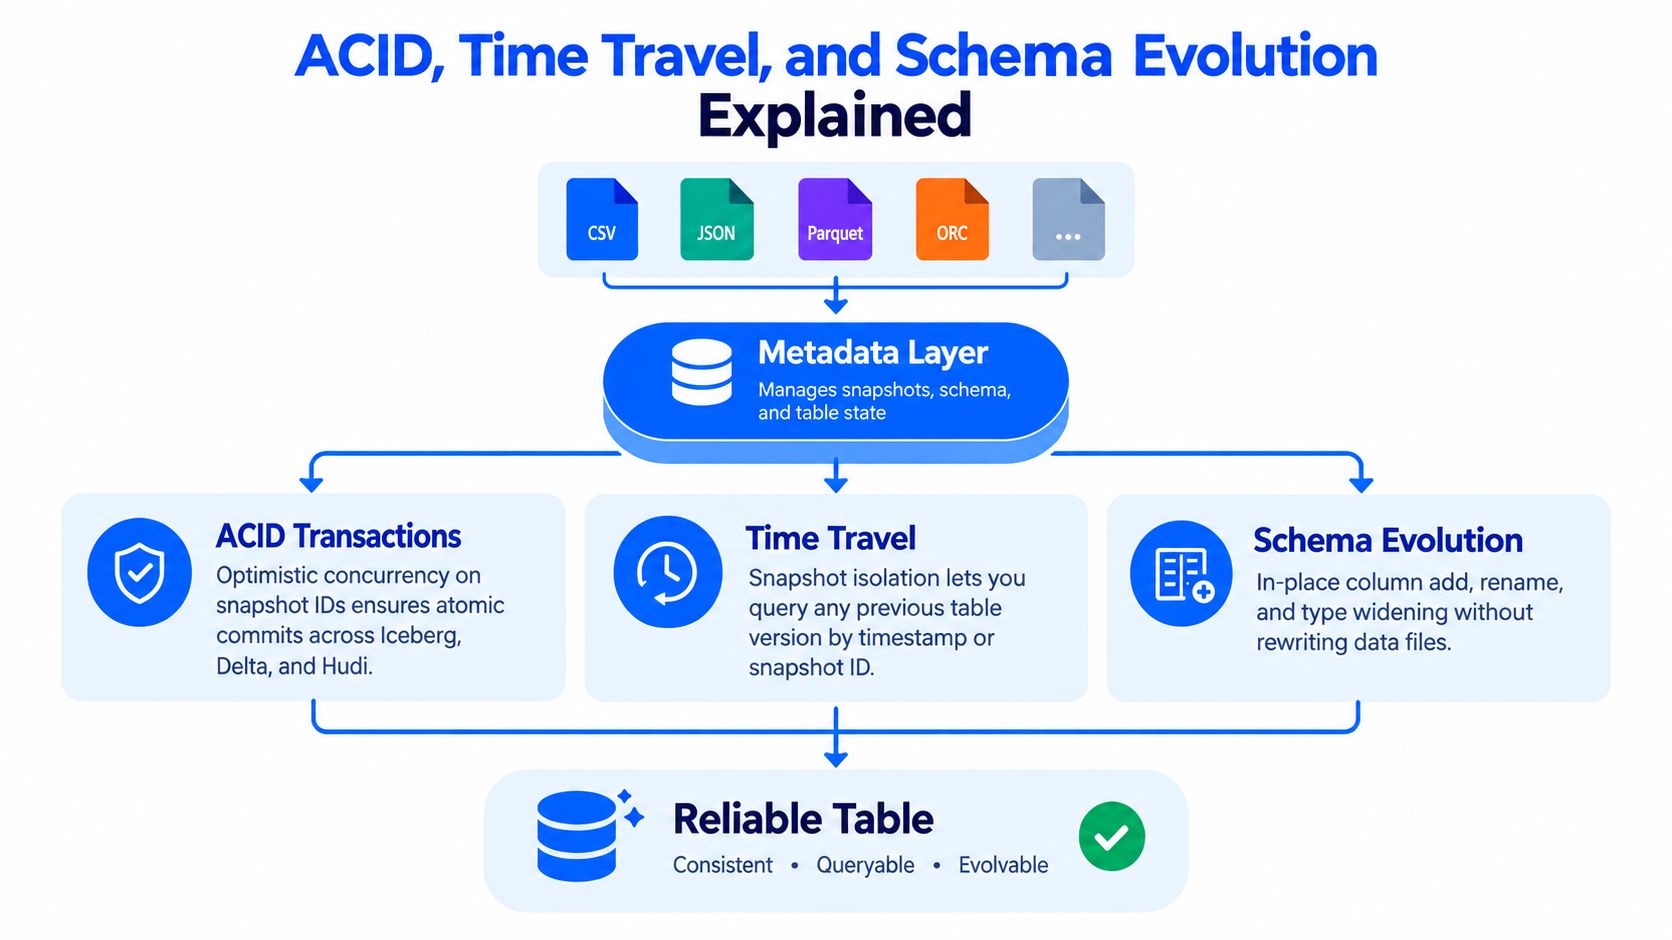
Unter der Haube veröffentlichen diese Formate Änderungen über Metadaten-Commits. Datendateien mögen im Object Storage bereits existieren, doch sie werden erst Teil der Tabelle, wenn die neue Metadatenversion angenommen ist. Das liefert Ihnen Verhalten, das Datenteams von einer Datenbank erwarten, obwohl der zugrunde liegende Speicher weiterhin aus Dateien in einem Lake besteht.
In der Praxis heißt das:
ein Batch-Job kann eine vollständige Aktualisierung als einen atomaren Commit veröffentlichen
ein Streaming-Job kann weiter anhängen, während Reader auf einem konsistenten Snapshot bleiben
ein fehlgeschlagener Schreibvorgang kann verwaiste Dateien hinterlassen, wird aber nicht zur Tabellenwahrheit
nebenläufige Writer brauchen Konfliktregeln, Retry-Logik und Katalogkoordination, um sich nicht gegenseitig zu stören
Der letzte Punkt wird leicht unterschätzt. ACID ist nicht nur ein Reader-Feature. Es ist auch ein Steuerungsmechanismus für mehrere Writer, und die operativen Details unterscheiden sich nach Format, Engine und Katalogaufbau.
Mit Time Travel debuggen Teams und reproduzieren Datenzustände
Time Travel heißt, die Tabelle kann ältere committete Versionen offenlegen, nicht nur die aktuelle. Das klingt nach Komfortfunktion, bis ein Bericht sich nach einem Backfill ändert oder ein Löschjob mehr Datensätze entfernt als beabsichtigt.
Wenn Sie mit historischen Daten in Snowflake gearbeitet haben, ist das Denkmodell ähnlich. Sie fragen einen früheren Tabellenzustand ab, statt Rohdateien aus dem Backup wiederherzustellen.
Die nützliche Frage lautet nicht „unterstützt das Format Time Travel?“. Die nützliche Frage lautet „wie lange bewahren wir Historie, wer steuert die Aufbewahrung, und was passiert, wenn die Speicherbereinigung läuft?“. Teams feiern historische Lesevorgänge oft während der Evaluierung und entdecken später, dass aggressives Snapshot-Ablaufen genau die Version entfernt hat, die sie für eine Prüfung oder Vorfallsanalyse brauchten.
Time Travel ist nur so verlässlich wie die Aufbewahrungsrichtlinie dahinter.
Schemaevolution trennt kontrollierte Änderung von versehentlichem Bruch
Schemaevolution erlaubt einer Tabelle, ihre Form über die Zeit zu ändern, ohne jede alte Datei neu schreiben zu müssen. Dazu gehören meist das Hinzufügen nullable Spalten, einige Typerweiterungen und in bestimmten Formaten das Umbenennen von Spalten über stabile Feldidentität statt über die reine Spaltenposition.
Die Funktion klingt nachsichtig. Der Produktionseinsatz sollte das Gegenteil sein.
Ein sicherer Prozess für Schemaänderungen beantwortet einige konkrete Fragen:
Wer darf eine Schemaänderung in der Produktion genehmigen
Welche Engines dürfen dieses neue Schema schreiben
Ob nachgelagerte Reader mit der Änderung umgehen können
Wie Partitionsänderungen bestehende Jobs und Annahmen betreffen
Ob der Katalog das neue Schema über alle Werkzeuge hinweg gleich auslegt
Hier gewinnen Teams entweder Flexibilität oder schaffen langlaufende Aufräumarbeit. Eine Spaltenumbenennung mag auf Formatebene gültig sein und dennoch BI-Extrakte, dbt-Modelle oder Ingestion-Code brechen, die auf den alten Namen verwiesen. Eine Typerweiterung mag die Schreibvalidierung bestehen und dennoch Join-Verhalten oder Null-Behandlung weiter unten verändern.
Schemaevolution ist eine Formatfähigkeit. Schema-Governance ist eine Betriebsentscheidung.
Dasselbe Muster gilt auch für ACID und Time Travel. Das Format liefert den Mechanismus. Verlässlichkeit entsteht aus Verantwortung: wer Änderungen genehmigt, wer die Aufbewahrung abstimmt, wer Dateien aufräumt und wer entscheidet, welchen Engines das Schreiben zugetraut wird.
Die eigentliche Frage nach der Einführung
Ein Lakehouse fühlt sich direkt nach dem ersten erfolgreichen Schreibvorgang meist gesund an. Abfragen laufen. Time Travel funktioniert. Alle haken die Funktionsliste ab und gehen weiter.
Dann beginnen die Betriebsfragen. Welcher Katalog ist die Quelle der Wahrheit. Welche Engines dürfen schreiben. Wer führt die Kompaktierung aus. Wer genehmigt Schemaänderungen, die technisch gültig, für nachgelagerte Jobs aber riskant sind. Diese Entscheidungen prägen die tägliche Verlässlichkeit stärker als die Wahl des Dateiformats allein.
Der Katalog setzt die Verkehrsregeln
Ein offenes Tabellenformat definiert, wie Tabellenmetadaten und Datendateien zusammenpassen. Der Katalog entscheidet, wie Systeme diese Tabelle finden, Änderungen koordinieren und Richtlinien anwenden. In der Praxis wirkt der Katalog wie die Flugsicherung des Lakehouse. Die Flugzeuge mögen alle korrekt gebaut sein, doch Sie brauchen trotzdem eine Stelle, die Starts, Landungen und Routenänderungen koordiniert.
Uplatz' Überblick zu Konvergenz und Divergenz offener Tabellenformate verweist auf die wachsende Rolle von Übersetzungs- und Interoperabilitätsprojekten wie Apache XTable, Hudis nativer Iceberg-Ausgabe und Delta Lake UniForm. Er hält außerdem eine Produktionsrealität fest, die in Formatvergleichen untergeht. Viele Unternehmen betreiben mehr als ein Format, und die Interoperabilität hängt weiterhin stark von Engine-Unterstützung, Katalogverhalten und cloud-spezifischen Einschränkungen ab.
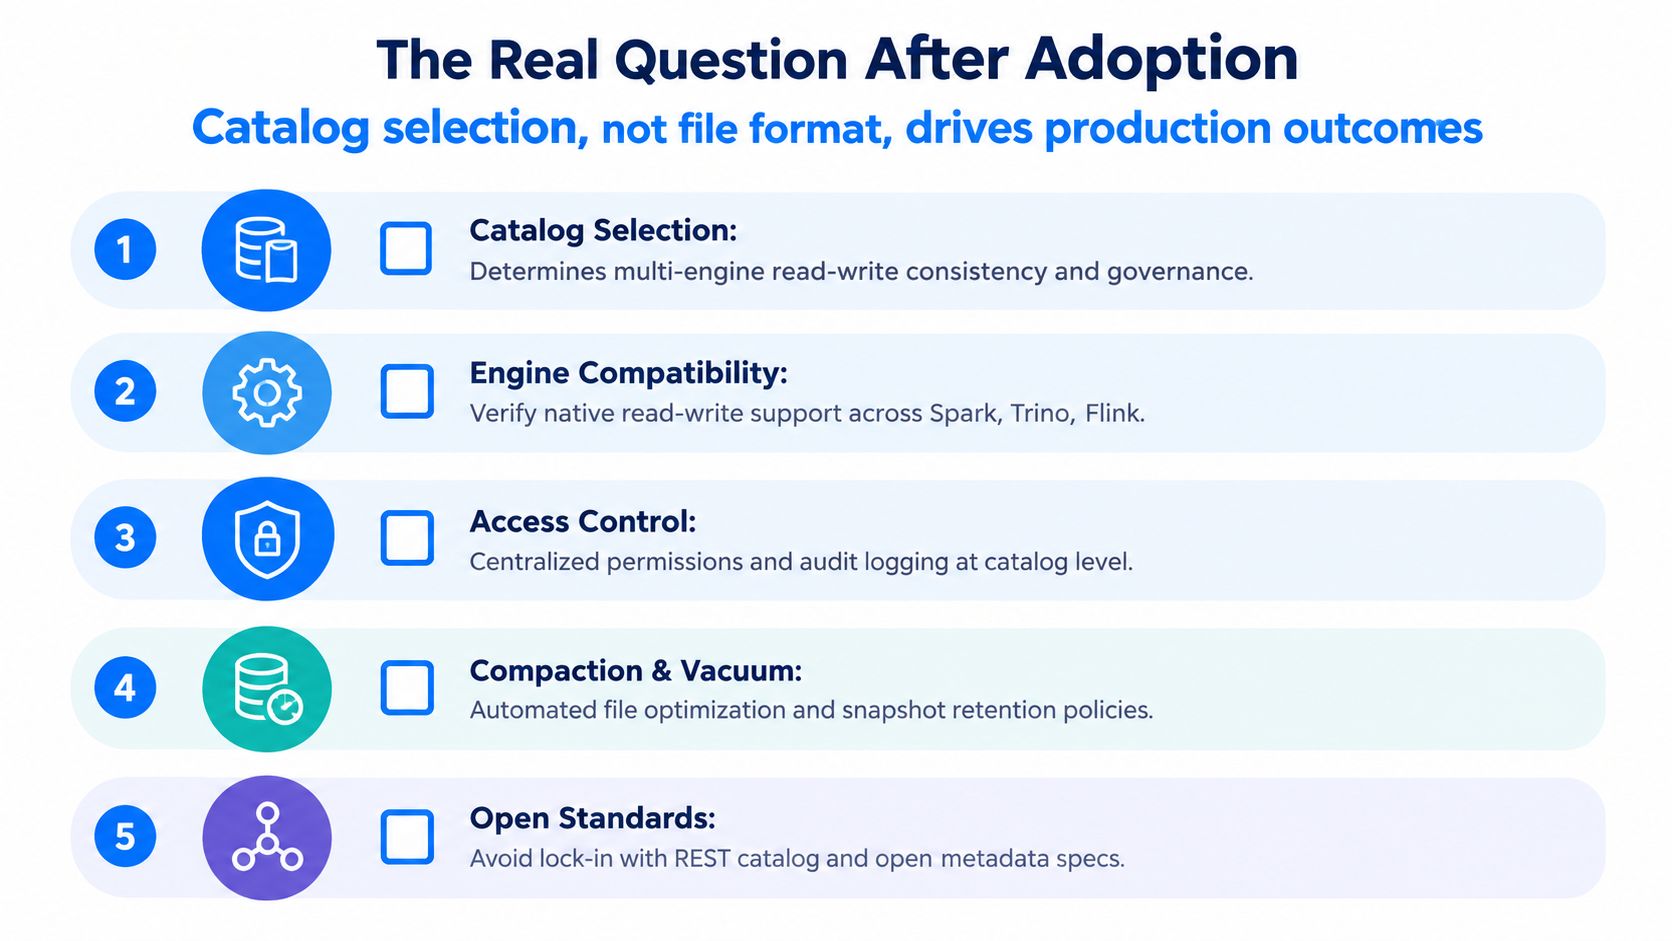
Deshalb kann dieselbe Iceberg-, Delta-Lake- oder Hudi-Tabelle in einem Aufbau vorhersehbar und in einem anderen fragil wirken. Ein REST-Katalog, Glue, Hive Metastore, Nessie, Polaris oder eine vom Anbieter verwaltete Steuerungsebene unterscheiden sich bei Auffindbarkeit, Berechtigungen, Branching-Modellen, Schreibkoordination und Fehlerbehandlung.
Die Verantwortung für Kompaktierung wird zum Betriebsmodell
Kompaktierung klingt nach Hintergrundwartung. In der Produktion ähnelt sie eher Garbage Collection gemischt mit Index-Tuning. Gut gemacht hält sie die Abfrageplanung vernünftig und die Leseleistung stabil. Schlecht gemacht verbrennt sie Cluster-Zeit, kämpft mit Ingestion-Workloads und erzeugt Aufräumarbeit nach fehlgeschlagenen Rewrites.
Jemand muss verantworten:
Kompaktierungstakt
Sortier- und Clustering-Entscheidungen
Snapshot-Bereinigung und Aufbewahrung
Rollback-Schritte, wenn die Wartung es schlimmer macht
Erkennung verwaister Dateien
Das sind keine Format-Häkchen. Es sind wiederkehrende Jobs mit Fehlerbildern, Kostenabwägungen und klarem Bedarf an Verantwortung. Eine offene Bewertung bei Shirokoff zu offenen Tabellenformaten spricht das direkt an und nennt Metadaten-Overhead, Wartungsaufwand, Lernkurvenkosten und uneinheitliche Governance über Werkzeuge hinweg.
Verlässlichkeit hängt davon ab, wer Änderungen kontrolliert
Produktionsteams lernen außerdem, dass Governance selten allein in den Tabellendateien lebt. Spaltenmaskierung, Kontrollen auf Zeilenebene, Prüfpfade und PII-Kennzeichnung hängen meist davon ab, dass Katalog und Query-Engines sie konsistent durchsetzen.
Teams, die diese Tabellen verlässlich halten, beobachten die Metadatenschicht wie eine Anwendungs-Steuerungsebene. Sie verfolgen Snapshot-Alter, fehlgeschlagene Commits, Dateianzahlen, verwaiste Dateien, Wartungsrückstand und welcher Writer den Tabellenzustand zuletzt geändert hat. Teams, die nur die Gesundheit des Object Storage beobachten, übersehen oft die früheren Warnzeichen. Der Bucket sieht gut aus, während die Tabelle schwerer zu vertrauen wird.
Ein praktischer Rollout-Plan für Data-Engineering-Teams
Ein sauberer Rollout beginnt klein, aber er sollte nicht vage beginnen. Sie wollen einen Piloten, der operative Kanten früh offenlegt.
Phase 1 wählt die Steuerungsebene
Wählen Sie zuerst den Katalog. Das Dateilayout zählt, doch der Katalog entscheidet, wie Engines Tabellen finden, Schreibvorgänge koordinieren und Richtlinien durchsetzen.
Bewerten Sie Optionen wie REST-orientierte Kataloge, Hive-Metastore-artige Aufbauten und cloud-native Kataloge anhand praktischer Fragen:
Welche Engines müssen nativ lesen und schreiben
Wo liegen Tabellenverantwortung und Berechtigungen
Wie werden Schemaänderungen geprüft
Was passiert, wenn der Katalog nicht verfügbar ist
Überspringen Sie diesen Schritt, bauen Sie ihn später oft unter Druck nach.
Phase 2 legt die Basis für Sicherheit und Governance
Definieren Sie vor breiter Einführung den minimalen Betriebsvertrag.
Dazu gehören meist SSO, RBAC, Verschlüsselung bei Übertragung und Speicherung, kontrollierte Dienstidentitäten und eine Richtlinie für Zeilen- oder Spaltenbeschränkungen, wo nötig. Ebenso Erwartungen an Lineage, PII-Kennzeichnung und Genehmigungswege für Schemaänderungen.
Eine nützliche Werkzeugoption in dieser Phase ist digna, das in der Umgebung der Kundin oder des Kunden läuft und Datenverhalten, Timeliness, Satzvalidierung, Schemaänderungen und Plattformkennzahlen über Lakes, Warehouses und Pipelines hinweg überwacht. Für offene Tabellenformate zählt das, weil Verlässlichkeitsprobleme oft zuerst als veraltete Snapshots, Schema-Drift, verzögerte Schreibvorgänge oder Anomalien bei Geschäftskennzahlen auftauchen statt als harte Pipeline-Ausfälle.
Phase 3 belastet den Schreibpfad
Validieren Sie die Architektur nicht mit einem einzigen Tagesbatch.
Nutzen Sie einen Pilotdatensatz mit mehreren täglichen Writern, mindestens einem Wartungsablauf und einer Query-Engine außerhalb der primären Writer-Engine. Nehmen Sie einen Job für Hidden Partitioning oder Layout-Optimierung in den Versuch auf, damit Ihr Team Snapshot-Änderungen, Kompaktierungseffekte und Rollback-Entscheidungen unter realistischen Bedingungen bewältigen muss.
Ein guter Pilot sollte einige unbequeme Fragen erzeugen. Wer genehmigt Schemaänderungen? Wer wird bei fehlgeschlagenen Commits alarmiert? Welche Reader sind während Wartungsfenstern erlaubt? Das sind genau die Probleme, die früh auftauchen sollten.
Phase 4 instrumentiert die Metadatenschicht
Speicherüberwachung allein sagt Ihnen nicht genug.
Verfolgen Sie Signale wie:
Snapshot-Alter für die Frische des veröffentlichten Tabellenzustands
Kompaktierungsrückstand damit Dateiwildwuchs die Leistung nicht verschlechtert
Muster von Writer-Fehlern über Engines hinweg
Schema-Drift-Ereignisse bevor nachgelagerte Dashboards brechen
Wachstum verwaister Dateien nach Retries oder abgebrochenen Vorgängen
Wenn Sie die Gesundheit des Tabellenmetadatenpfads nicht sehen können, arbeiten Sie überwiegend auf Hoffnung.
Offene Tabellenformate lösen das Problem der Tabellenschicht, doch sie ersetzen keine disziplinierte Eigenverantwortung im Betrieb. digna hilft Teams, Schemaänderungen, Timeliness, Anomalien und Plattformverhalten in der eigenen Umgebung zu überwachen, was zu den Fehlerbildern passt, die nach der Lakehouse-Einführung auftreten. Wenn Ihre Tabellen bereits mehrere Engines und Wartungsjobs umspannen, lohnt ein Blick darauf, wie digna Ihnen helfen kann, die metadatengetriebene Verlässlichkeitsschicht zu beobachten und nicht nur die Dateien darunter.
Teams, die auf Databricks ausrollen, ergänzen in derselben Phase meist Observability für die Databricks-Plattform, damit Garantien auf Tabellenebene und Prüfungen auf Wertebene gemeinsam landen.
Häufig gestellte Fragen
Wie haben sich Tabellenformate von Hive aus entwickelt?
Hive definierte eine Tabelle als Verzeichnislayout, sodass Partitionen Ordner waren und die Dateiliste die Quelle der Wahrheit. Das brach im Object Storage zusammen, wo Listings langsam und eventuell konsistent sind. Moderne Formate verlagerten die Tabellendefinition in Metadatendateien und beseitigten so die Abhängigkeit von der Verzeichnisstruktur.
Was bedeutet ACID für eine Data-Lake-Tabelle?
Es bedeutet, dass ein Schreibvorgang entweder vollständig sichtbar wird oder gar nicht, und dass nebenläufige Reader nie einer laufenden Änderung ausgesetzt sind. Auf einem Lake entsteht diese Garantie durch das atomare Tauschen eines Metadatenzeigers, nicht durch ein Datenbank-Transaktionslog, weshalb sie über reinem Object Storage funktioniert.
Kann man das Schema einer Tabelle ändern, ohne sie neu zu schreiben?
Ja. Das Hinzufügen, Entfernen, Umbenennen oder Umordnen von Spalten wird in Metadaten erfasst und beim Lesen angewendet, sodass bestehende Datendateien unberührt bleiben. Der Haken ist, dass Reader dieselben Regeln umsetzen müssen — eine Engine mit teilweiser Unterstützung kann für eine umbenannte Spalte Nullwerte liefern, statt einen Fehler zu werfen.
Warum verhält sich ein Lake in einem Werkzeug wie eine Tabelle und in einem anderen wie ein Haufen Dateien?
Weil die Garantie in der Metadatenschicht liegt und nur Engines sie erhalten, die diese Schicht lesen. Ein Werkzeug, das direkt auf die zugrunde liegenden Parquet-Dateien zeigt, umgeht die Commit-Historie vollständig und sieht, was gerade im Speicher liegt, einschließlich Dateien aus einem nie committeten Schreibvorgang.
Wie sieht ein vernünftiger Rollout aus?
Konvertieren Sie zuerst eine gut verstandene Tabelle, lassen Sie das Original parallel weiterschreiben und ziehen Sie Konsumenten schrittweise um, während Sie Ergebnisse vergleichen. Klären Sie vor dem Go-live, wer Snapshot-Ablauf und Kompaktierung verantwortet, denn unbetreute Wartung ist der häufigste Grund, warum ein erfolgreicher Pilot im folgenden Quartal verfällt.


