Was ist die Monte-Carlo-Simulation?
|
7
min. Lesezeit

Sie befinden sich in einer Besprechung unter Zeitdruck, ein Dashboard wackelt und jemand fragt nach einer einzelnen Zahl. Der Plattform-Inhaber möchte eine Prognose für die Pipeline-Latenz, der Finanzleiter benötigt eine Budgetübersicht für einen Produktstart und der Logistikmanager starrt auf Verkehrsdaten, Wetterbedingungen und Hafenverzögerungen. Eine einzige Schätzung fühlt sich ordentlich aufgeräumt an, verbirgt aber den Teil, auf den es am meisten ankommt: die Spanne der plausiblen Ergebnisse.
Die Monte-Carlo-Simulation ist die Methode, die diese eine Schätzung in eine Verteilung von Zukünften verwandelt. Dies geschieht, indem Gewissheit durch wiederholte Zufallsstichproben ersetzt wird. Anschließend zeigen die Ergebnisse, was wahrscheinlich, was riskant und was bloßes Rauschen ist. Aus diesem Grund taucht sie immer wieder in der Finanzwelt, im Ingenieurwesen und in Enterprise-Datensystemen auf, die Entscheidungen unter Unsicherheit treffen müssen.
Inhaltsverzeichnis
Eine Frage, für die Sie Monte Carlo bereits benötigen
Warum das die Diskussion verändert
Die Kernidee hinter der Monte-Carlo-Simulation
Die Mathematik ohne den Nebel
Wie eine Monte-Carlo-Simulation tatsächlich abläuft
Die vier Schritte in einfacher Sprache
Monte Carlo im Vergleich zu geschlossener Form und Sensitivitätsanalyse
Eine schnelle Entscheidungsregel
Wo die Monte-Carlo-Simulation in der realen Arbeit auftaucht
Die vier Bereiche, in denen sie sich bezahlt macht
Ehrliche Kompromisse und typische Fallstricke
Die Fallstricke, die Ergebnisse unbemerkt verzerren
Eine Notebook-Checkliste, die Sie ehrlich hält
Von Monte-Carlo-Ideen zu Enterprise Data Observability mit digna
Warum die Monte-Carlo-Perspektive zur Observability passt
Was ein Team zuerst tun kann
Eine Frage, für die Sie Monte Carlo bereits benötigen
Ein Plattform-Inhaber wird während einer Management-Präsentation nach der Latenz zum Monatsende gefragt, aber das Team verfügt nur über eine zweiwöchige, verrauschte Historie. Ein Finanzleiter muss verteidigen, ob ein Produktstart im Budget bleibt, während sich Werbeausgaben und Lieferantenlaufzeiten ständig verschieben. Ein Logistikmanager benötigt eine erwartete Lieferzeit, wenn sich Verkehr, Wetter und Dockverfügbarkeit gleichzeitig verändern. In jedem dieser Fälle klingt eine einzige Schätzung zwar selbstbewusst, ist aber wahrscheinlich falsch.
Die Falle besteht darin, dass die Schätzung das gesamte Problem auf eine einzige Zahl reduziert. Sie sagt nichts darüber aus, wie oft sich Dinge verzögern, wie schlimm die Verspätungen im Einzelfall sind oder ob das Ergebnis stabil genug ist, um darauf zu vertrauen. Eine Monte-Carlo-Simulation ersetzt diese eine Zahl durch Tausende plausibler Zukünfte, die alle aus derselben Unsicherheit abgeleitet sind.
Warum das die Diskussion verändert
Sobald Sie eine Verteilung anstelle einer Punktschätzung sehen, ändert sich die Fragestellung. Sie fragen nicht mehr: „Wie lautet die Antwort?“, sondern: „Wie breit ist das Risikoband und was treibt es an?“ Das ist eine viel bessere Frage für Budgets, Zeitpläne und operative SLAs.
Die Methode ist einfach zu beschreiben, auch wenn die Modellierung Sorgfalt erfordert. Sie definieren die unsicheren Eingangsgrößen, ziehen viele Stichproben daraus, berechnen jedes Mal das Ergebnis und fassen die Streuung zusammen. Wenn Sie eine entsprechende Einführung darüber wünschen, wie Rohdatenverteilungen dieses Denken beeinflussen, zeigt sich, dass die Verteilung von Daten eine Rolle spielt, bevor man einer Simulation vertrauen kann.
Ein Monte-Carlo-Modell verspricht keine Gewissheit. Es liefert Ihnen ein ehrlicheres Bild der Unsicherheit, die Sie ohnehin bereits haben.
Die Kernidee hinter der Monte-Carlo-Simulation
Ein gutes mentales Modell beginnt mit einer Dartscheibe. Platzieren Sie zufällige Punkte auf einem Quadrat, zählen Sie, wie viele im Kreis landen, und nutzen Sie dieses Verhältnis, um π zu schätzen. Das ist der Kern des Monte-Carlo-Denkens: Wiederholte Zufallsversuche können Aufschluss über etwas geben, das direkt nur schwer zu berechnen ist. Die frühe Geschichte der Methode umfasst Vorläuferideen wie das Buffonsche Nadelproblem aus dem 18. Jahrhundert, gefolgt von der systematischen Anwendung im 20. Jahrhundert für schwierige Integrations- und Unsicherheitsprobleme PMC-Review.
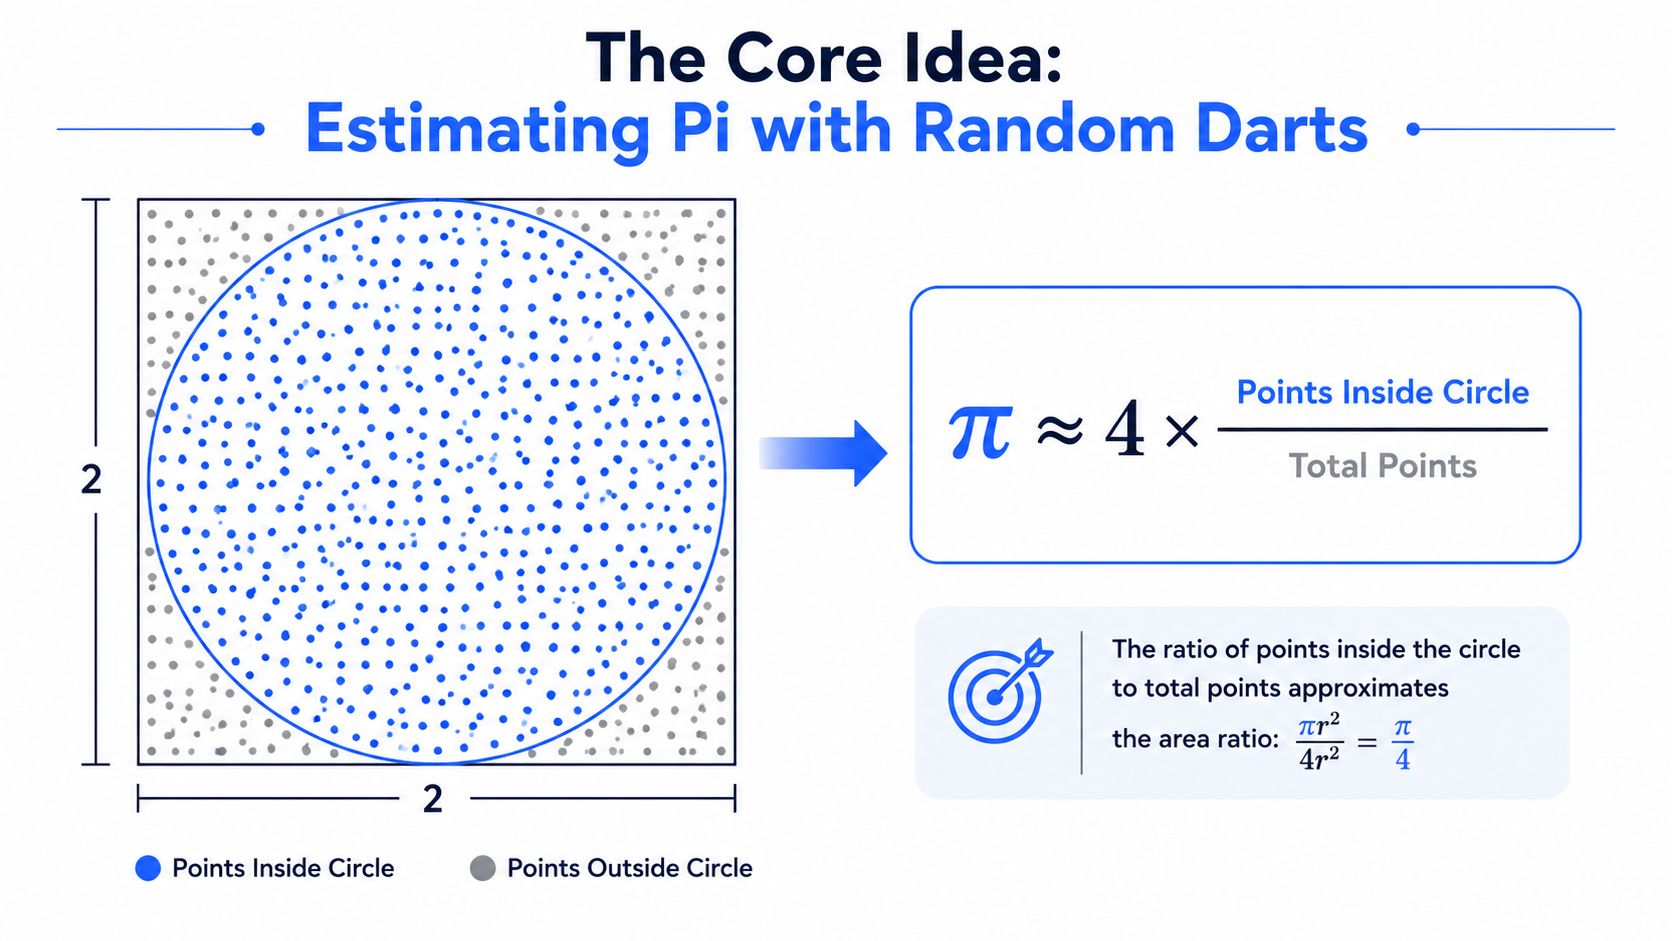
Auf moderner technischer Ebene bedeutet eine Monte-Carlo-Simulation die Schätzung eines Erwartungswerts, vereinfacht geschrieben als E[f(X)], indem viele Zufallsstichproben der unsicheren Eingangsgrößen X gezogen, die Funktion f jedes Mal ausgewertet und die Ergebnisse gemittelt werden. Das ist derselbe Kernansatz, der in der Finanzwelt, im Ingenieurwesen, in der Zuverlässigkeitsanalyse sowie in den Natur- und Sozialwissenschaften verwendet wird, wo der Computer Tausende oder Millionen von Durchläufen startet, um die Variabilität zu untersuchen PMC-Review.
Die Mathematik ohne den Nebel
Sie benötigen keine geschlossene Formel für das gesamte System. Sie brauchen nur zwei Dinge: eine Methode, um Stichproben aus den Eingaben zu ziehen, und eine Methode, um das Ergebnis für jeden Durchlauf zu berechnen. Deshalb ist Monte Carlo so nützlich für nichtlineare Modelle und unübersichtliche, reale Systeme – die Methode ist nicht auf elegante Algebra angewiesen, um zu funktionieren.
Das Gesetz der großen Zahlen besagt, dass sich der Durchschnitt der simulierten Ergebnisse mit wachsendem Stichprobenumfang dem tatsächlichen Erwartungswert annähert. Der Zentrale Grenzwertsatz liefert den praktischen Grund, warum sich dies stabil anfühlt: Der Standardfehler schrumpft näherungsweise mit der Quadratwurzel des Stichprobenumfangs. Die Vorlesungsunterlagen des MIT zur Finanzwirtschaft verdeutlichen diese Skalierung: Der direkte Schätzfehler sinkt tendenziell um etwa σ/√n, weshalb sich die Präzision durch das Hinzufügen weiterer Durchläufe nur langsam verbessert MIT OCW.
Praktische Regel: Wenn Ihr Problem als Stichprobe erfasst und ausgewertet werden kann, lässt es sich in der Regel mit Monte Carlo schätzen, selbst wenn die exakte Algebra umständlich oder unmöglich wird.
Diese Allgemeingültigkeit ist der entscheidende Punkt. Die Methode existiert, weil sich viele reale Systeme weigern, sich in eine saubere Formel pressen zu lassen.
Wie eine Monte-Carlo-Simulation tatsächlich abläuft
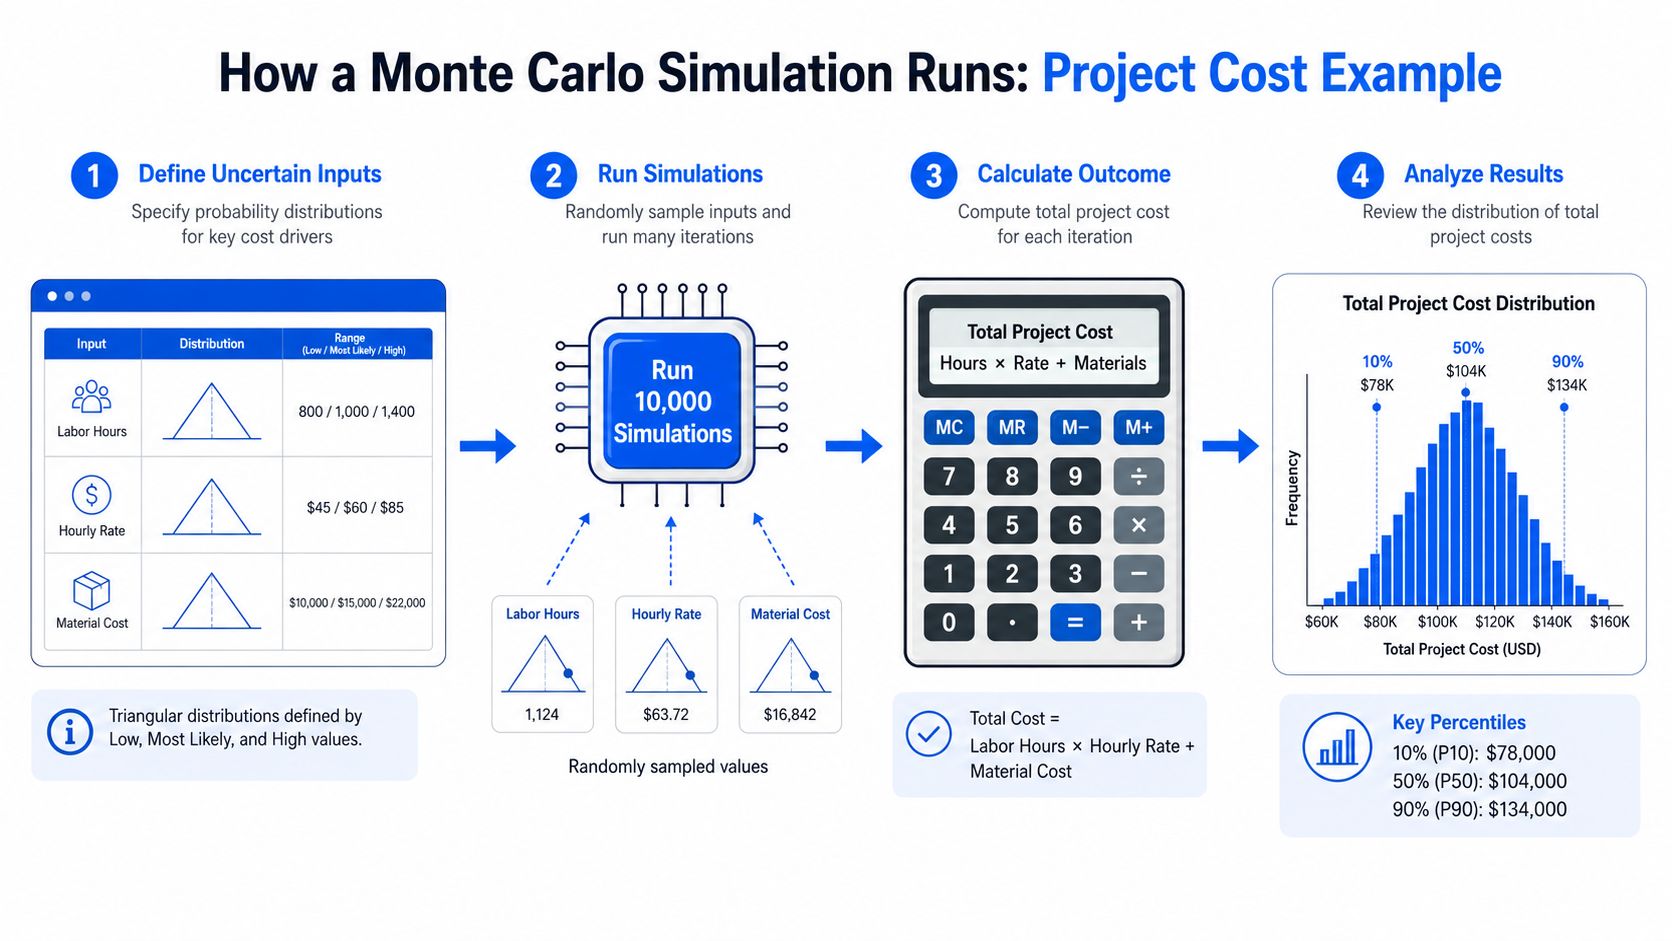
Ein praktisches Beispiel macht die Schleife leichter verständlich. Angenommen, Sie schätzen die Gesamtprojektkosten und die unsicheren Faktoren sind Arbeitsstunden, Stundensatz und Materialkosten. Sie kennen eine dieser Eingangsgrößen nicht genau, also beschreiben Sie jede einzelne als Wahrscheinlichkeitsverteilung statt als festen Wert – oft unter Verwendung historischer Daten, Expertenmeinungen oder beider Quellen.
Die vier Schritte in einfacher Sprache
Definieren Sie zuerst die Eingaben und wählen Sie Verteilungen, die zu ihnen passen. Eine Dreiecksverteilung ist bei Projektarbeiten üblich, da man oft eine niedrige, eine wahrscheinliche und eine hohe Schätzung kennt, selbst wenn man keine perfekt gemessene Kurve vorliegen hat.
Zweitens: Ziehen Sie aus jeder Eingangsverteilung einen Wert, um ein einzelnes Szenario zu erstellen. Dieses eine Szenario stellt eine mögliche Welt dar, und Sie berechnen das Ergebnis – in diesem Fall die Gesamtkosten.
Drittens: Wiederholen Sie diese Ziehungs- und Auswertungsschleife viele Male. Moderne Lehr- und Forschungsquellen beschreiben dies als eine computergestützte experimentelle Methode, die Tausende oder Millionen von Zufallsdurchläufen generieren kann, um Verteilungen und Risiken zu untersuchen PMC-Review.
Viertens: Fassen Sie die Ergebnisliste als eigene Verteilung zusammen. Sie können sich den Mittelwert, den Median, das Histogramm und die für eine Entscheidung relevanten Perzentile ansehen, da diese Ihnen zeigen, wie sich die Kosten über die gesamte Spanne plausibler Ergebnisse hinweg verhalten.
Operative Gewohnheit: Beobachten Sie den gleitenden Mittelwert, während die Simulation läuft. Wenn er sich ständig weiterbewegt, haben Sie wahrscheinlich noch nicht genügend Durchläufe ausgeführt, als dass sich die Schätzung einpendeln könnte.
Ein einfacher Pseudocode-Entwurf sieht so aus:
Eine minimale Python-Version ist ebenso direkt:
Für einen tieferen Einblick in die Aufbereitung von Datennahmen vor dem Start eines Modells ist die Seite über statistische Methoden zur Datenanalyse ein nützlicher Begleiter. Die entscheidende Frage bei der Implementierung ist die Konvergenz: Wenn weitere Stichproben das Ergebnis nicht mehr wesentlich verändern, haben Sie meist einen brauchbaren Endpunkt erreicht.
Monte Carlo im Vergleich zu geschlossener Form und Sensitivitätsanalyse
Ein Projektkostenmodell kann auf drei verschiedene Arten angegangen werden, und jede beantwortet eine andere Frage. Die geschlossene mathematische Form liefert eine direkte Lösung, wenn die Formeln handhabbar sind. Die Sensitivitätsanalyse verändert jeweils eine Variable, um zu sehen, welche Annahme das Ergebnis maßgeblich beeinflusst. Die Monte-Carlo-Simulation spielt viele vollständige Szenarien durch und liefert die Streuung der Ergebnisse, einschließlich der Wahrscheinlichkeit einer Budgetüberschreitung.
Dimension | Geschlossene mathematische Form | Sensitivitätsanalyse | Monte-Carlo-Simulation |
|---|---|---|---|
Hauptfrage | Wie lautet die exakte Antwort? | Welche Eingabe ist am wichtigsten? | Welche Ergebnisse sind plausibel und wie oft treten sie auf? |
Eingaben | Feste Formeln, oft exakt | Es ändert sich jeweils eine Variable | Viele unsichere Eingaben variieren gemeinsam |
Ausgabe | Einzelne Zahl oder exakter Ausdruck | Gewichtete Einflussfaktoren oder Änderungsrichtung | Vollständige Verteilung der Ergebnisse |
Beste Anwendung | Lineare, handhabbare Modelle | Isolieren von Treibern | Risiko, Tail-Verhalten, interagierende Unsicherheiten |
Schwachstelle | Versagt, wenn die Mathematik zu komplex wird | Übersieht Wechselwirkungen | Benötigt Stichproben, Validierung und Rechenleistung |
Die geschlossene mathematische Form ist effizient, wenn das Modell einfach genug ist. Die Sensitivitätsanalyse ist nützlich, wenn Sie wissen müssen, welche Annahme Sie zuerst korrigieren sollten. Monte Carlo ist das richtige Werkzeug, wenn Unsicherheiten aus vielen interagierenden Eingangsgrößen resultieren, Korrelationen eine Rolle spielen oder das Modell nichtlinear ist.
Ein anschaulicher Weg, darüber nachzudenken, ist der Abwägungsprozess zwischen Bias und Varianz. Eine deterministische Abkürzung kann elegant, aber irreführend sein, während eine reichhaltigere Simulation mehr von der Realität abbilden kann, sofern die Eingaben fundiert sind.
Eine schnelle Entscheidungsregel
Wenn Sie nur eine grobe Richtung benötigen, kann eine Sensitivitätsanalyse ausreichen. Wenn das Modell in geschlossener Form vorliegt und die Eingaben stabil sind, nutzen Sie die exakte Mathematik. Wenn das Ergebnis von vielen unsicheren Faktoren abhängt und die Entscheidung an den Extremwerten (Tails) hängt, rechtfertigt Monte Carlo den Rechenaufwand.
Für Teams, die Daten-Workflows aufbauen, gilt dieselbe Logik für die Überprüfung von Anomalien. Die Seite über Methoden zur Ausreißeridentifikation ist relevant, wenn ein einzelner fehlerhafter Datenpunkt ein ansonsten fehlerfreies Modell verfälschen kann.
Wo die Monte-Carlo-Simulation in der realen Arbeit auftaucht
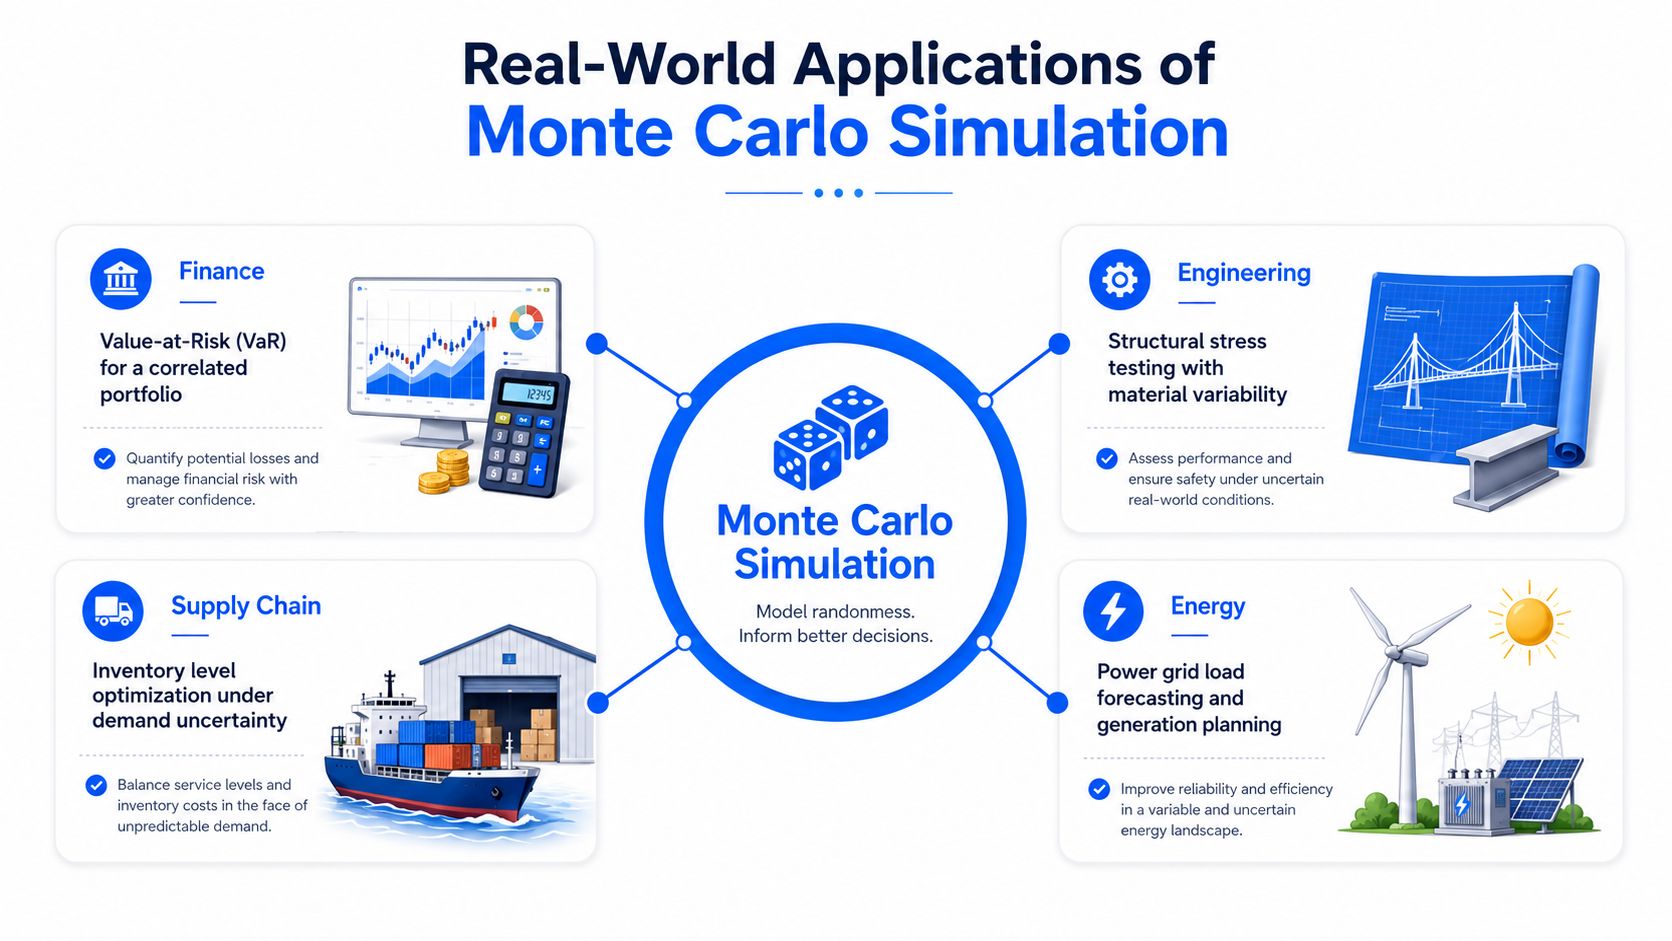
Die stärksten Anwendungsfälle haben alle dieselbe Struktur: Die Entscheidung hängt von den Extremwerten (Tails) ab, nicht nur vom Mittelwert. In der Finanzwelt unterstützt Monte Carlo den Value-at-Risk bei Portfolios korrelierter Vermögenswerte, da das gemeinsame Verhalten dieser Vermögenswerte das Abwärtsrisiko bestimmt. Im Ingenieurwesen hilft sie bei der Zuverlässigkeitsanalyse, wenn verschiedene Komponenten mit unterschiedlichen Raten ausfallen und somit die Systemsicht wichtiger ist als jedes Einzelteil.
Die vier Bereiche, in denen sie sich bezahlt macht
Bei der Timeliness-Planung kann ein Monte-Carlo-Modell die Wahrscheinlichkeit der Verletzung eines SLA abschätzen, wenn jede Stufe in der Pipeline Schwankungen aufweist. Das ist weitaus nützlicher als eine einzelne geschätzte Ankunftszeit, da Betreiber wissen müssen, wie wahrscheinlich die ungünstigen Fälle sind.
In der Data Observability taucht dieselbe Idee bei der Anomalieerkennung auf. Eine Plattform kann Signale zu Aktualität, Volumen und Schema als unsichere Eingaben behandeln, plausible Metrikzustände simulieren und abschätzen, ob eine Warnung einen echten Vorfall oder nur Rauschen widerspiegelt. Das passt hervorragend zur Anomalie-Arbeit im Monte-Carlo-Stil von digna, und die Seite über das Aufspüren von Datenanomalien in Ihrer Datenplattform mit Monte-Carlo-Simulationen deckt genau diesen Anwendungsfall ab.
In der Lieferketten- und Energieplanung wiederholt sich dieses Muster. Unsicherheiten bei der Nachfrage, Bestandsrisiken und Lastprognosen lassen sich viel besser beurteilen, sobald das Modell eine Spanne wahrscheinlicher Ergebnisse anstelle einer einzigen optimistischen Prognose liefert.
Wenn sich die Entscheidung ändert, sobald sich die Extremwerte verändern, ist eine Punktschätzung meist zu dünn, um darauf zu vertrauen.
Hier zeigt sich auch eine wichtige Lektion für Systeme. Monte Carlo ist nicht nur für Finanzanalysten oder Wissenschaftler gedacht. Jedes Team, das die Frage beantworten muss: „Was passiert, wenn sich mehrere unsichere Dinge gleichzeitig bewegen?“, befindet sich bereits im Terrain von Monte Carlo.
Ehrliche Kompromisse und typische Fallstricke
Monte Carlo ist mächtig, aber kein Allheilmittel. Die wichtigste Einschränkung ist die langsame Fehlerskalierung: Der direkte Schätzfehler sinkt um σ/√n, sodass eine Halbierung des Fehlers weitaus mehr Rechenleistung erfordert, als die meisten erwarten MIT OCW. Aus diesem Grund sind Methoden zur Varianzreduktion so wichtig: Sie verringern die Varianz des Schätzers, ohne dessen Erwartungswert zu verändern, was Ihnen ein engeres Konfidenzintervall bei gleichem CPU-Budget liefert Frontiers in Physics.
Die Fallstricke, die Ergebnisse unbemerkt verzerren
Die erste Falle ist die Qualität der Eingangsdaten. Wenn die Verteilungen nicht der Realität entsprechen, liefert die Simulation lediglich eine eleganter verpackte, falsche Antwort. Ein Gaußsches Tail kann in einem Risikomodell beruhigend aussehen, während die reale Welt in Wahrheit viel extremere Ausreißer (fat-tailed) aufweist.
Die zweite Falle ist die Blindheit gegenüber Korrelationen. Einsteiger simulieren Eingaben oft unabhängig voneinander, weil es einfacher ist, und erhalten dann Ergebnisse, die zu glatt und zu vorteilhaft ausfallen. Dieser Fehler ist besonders kostspielig bei Portfolio-Analysen, Zuverlässigkeitsmodellen und jedem System, in dem gemeinsame Treiber sich parallel bewegen.
Die dritte Falle ist eine Konvergenz, die nur nach Augenmaß gut aussieht. Ein gleitender Mittelwert, der sich optisch einpendelt, kann dennoch Instabilitäten in den Extremwerten verbergen. Sie benötigen daher eine klare Abbruchregel und kein bloßes Bauchgefühl.
Die vierte Falle ist die unbemerkte Varianz durch seltene Ereignisse. Wenn das Ereignis, um das es Ihnen geht, nur selten eintritt, kann es bei zu wenigen Durchläufen gänzlich unberücksichtigt bleiben. Dadurch wirkt das Ergebnis sicherer, als es tatsächlich ist. Monte Carlo kann Extremwerte unterschätzen, wenn die gewählten Verteilungen zu zahm sind, insbesondere im Finanzsektor und bei systemischen Risiken Analytica über Monte Carlo im Finanzwesen.
Eine Notebook-Checkliste, die Sie ehrlich hält
Validieren Sie jede Eingabe anhand historischer Daten oder Fachwissen, bevor Sie simulieren.
Berücksichtigen Sie Korrelationen, wo sich gemeinsame Treiber parallel bewegen.
Wählen Sie eine Abbruchregel basierend auf der Stabilität des Ergebnisses, nicht nur auf einer willkürlichen Anzahl an Durchläufen.
Geben Sie ein Konfidenzband an, nicht nur eine einzige Antwort.
Betrachten Sie das Modell als einen von mehreren Annahmesätzen, nicht als endgültige Wahrheit.
Der Leitfaden für ETL-Migrationsstrategien ist eine nützliche Erinnerung daran, dass auch nachgelagerte Datensysteme von der Qualität der Annahmen abhängen. Wenn die vorgelagerte Datenstruktur fehlerhaft ist, bleibt das nachgelagerte Ergebnis verrauscht – ganz gleich, wie elegant die Berechnung auch sein mag.
Von Monte-Carlo-Ideen zu Enterprise Data Observability mit digna
In der Enterprise Observability äußert sich die Monte-Carlo-Denkweise in Form von Baseline-Lernen und probabilistischer Alarmierung. digna überwacht Tabellen, Pipelines, Aktualitätsmuster und Geschäftsmetriken direkt in der eigenen Umgebung des Kunden und lernt so, wie normales Verhalten aussieht, ohne dass Teams starre Regeln fest einprogrammieren müssen. Das ist wichtig, weil Daten nicht einfach nur ankommen – sie kommen mit Schwankungen, Saisonalitäten und gelegentlichen Ausfällen an.
Warum die Monte-Carlo-Perspektive zur Observability passt
Der entscheidende Schritt besteht darin, die erwartete Aktualität, Zeilenanzahl und Nullwert-Raten als Verteilungen und nicht als feste Schwellenwerte zu behandeln. Sobald eine Plattform diese Baseline gelernt hat, kann sie Echtzeitwerte mit dem gelernten Bereich vergleichen und abschätzen, ob der aktuelle Zustand ungewöhnlich ist. Das ist dieselbe Logik, die Monte Carlo in anderen Bereichen anwendet: wiederholte Stichproben, um die Spanne plausibler Ergebnisse zu verstehen.
Der praktische Ablauf ist leicht nachzuvollziehen. digna lernt eine Aktualitäts-Baseline aus dem historischen Eingangsverhalten, zieht Stichproben für erwartete Verzögerungszustände aus dieser gelernten Verteilung und bewertet dann die aktuelle Beobachtung anhand dieser Zustände, um zu entscheiden, ob die Latenz anomal erscheint. Das Ergebnis ist ein konfidenzbasiertes Signal, nicht nur ein einfacher Ja/Nein-Alarm.
Dieser Ansatz fügt sich natürlicherweise in Migrations- und Pipeline-Änderungsprozesse ein. Wenn ein Team Datenflüsse verlagert oder Quellen überarbeitet, liefert der Leitfaden für ETL-Migrationsstrategien den operativen Rahmen, während eine Observability im Monte-Carlo-Stil dabei hilft zu beurteilen, ob das neue Verhalten abweicht.
Was ein Team zuerst tun kann
Aktivieren Sie das Baseline-Lernen für kritische Dashboards und Pipelines, damit das System normales Verhalten kennt, bevor es Ausnahmen meldet.
Vergleichen Sie beobachtete Verteilungen mit statischen Schwellenwert-Alarmen, da Schwellenwerte allein Schwankungen nicht erfassen.
Nutzen Sie Konfidenzbänder zur Priorisierung von Bereitschaftseinsätzen, damit die verrauschtesten Signale nicht die Warteschlange dominieren.
Für Teams, die diese Ideen an einem zentralen Ort zusammenführen möchten, zeigt die Seite über die Monte-Carlo-Datenalternative für Enterprise Data Observability, wie dieses Muster auf das operative Monitoring übertragen wird.
Der übergeordnete Punkt ist einfach: Das Monte-Carlo-Denken hilft Ihnen, eine bessere Frage zu stellen: „Wie wahrscheinlich ist es, dass dieser Zustand real ist?“ In der Observability ist diese Frage oft wichtiger als die Frage, ob eine Metrik eine feste Linie überschritten hat.
Wenn Sie versuchen möchten, Entscheidungen zur Datenzuverlässigkeit mit weniger Rätselraten zu treffen, besuchen Sie digna und sehen Sie, wie Baseline-Lernen, Timeliness-Überwachung und Anomalieerkennung auf einer einzigen Observability-Plattform zusammenwirken. Es ist ein praktischer Weg, um Unsicherheitsbetrachtungen im Monte-Carlo-Stil auf Pipelines, Dashboards und Geschäftsmetriken anzuwenden, die sich keine fehleranfälligen Fehlalarme leisten können.
Häufig gestellte Fragen
Was ist eine Monte-Carlo-Simulation?
Die Schätzung eines Erwartungswerts, schlicht als E[f(X)] geschrieben, indem man viele Zufallsstichproben der unsicheren Eingaben X zieht, die Funktion f jedes Mal auswertet und die Ergebnisse mittelt. Praktisch ersetzt sie eine Schätzung durch Tausende plausibler Zukünfte aus derselben Unsicherheit.
Warum ist eine Verteilung besser als ein Punktwert?
Weil sie die gestellte Frage verändert. Wer eine Verteilung statt einer Zahl sieht, fragt nicht mehr „Was ist die Antwort?“, sondern „Wie breit ist das Risikoband, und was treibt es?“, und das ist die bessere Frage für Budgets, Termine und operative SLAs.
Warum funktioniert wiederholtes Zufallsziehen überhaupt?
Wegen des Gesetzes der großen Zahlen: Der Mittelwert der simulierten Ergebnisse bewegt sich mit wachsender Stichprobe auf den wahren Erwartungswert zu. Deshalb offenbart eine oft genug beworfene Dartscheibe eine Fläche, die sich direkt nur umständlich berechnen ließe.
Wann ist Monte Carlo besser als eine geschlossene Formel?
Wenn sich das System eleganter Algebra widersetzt. Man braucht keine geschlossene Lösung für das Gesamtsystem, und genau deshalb passt die Methode zu nichtlinearen Modellen und unordentlichem realem Verhalten. Was sich abtasten und auswerten lässt, kann Monte Carlo meist schätzen.
Liefert Monte Carlo Gewissheit?
Nein, und das anzunehmen ist die Hauptfalle. Ein Monte-Carlo-Modell verspricht keine Gewissheit, es quantifiziert Unsicherheit unter den gelieferten Annahmen. Die ehrliche Ausgabe ist ein Risikoband mit benannten Treibern und keine selbstbewusste Einzelzahl.