Vorteile der Datenqualität für moderne Unternehmen
|
8
min. Lesezeit

Minderwertige Datenqualität ist nach wie vor einer der schnellsten Wege, um den Wert einer Datenplattform zu schmälern. Der IBM-Bericht für 2025 zeigt, dass 43 % der Chief Operations Officers die Datenqualität mittlerweile als ihre wichtigste Datenpriorität einstufen. Zudem schätzen mehr als ein Viertel der Unternehmen die jährlichen Verluste durch mangelhafte Datenqualität auf mehr als 5 Millionen USD, wobei 7 % Verluste von 25 Millionen USD oder mehr melden (IBM Institute for Business Value). Das ist längst kein reines Bereinigungsproblem mehr, sondern ein Problem des Betriebsmodells.
Die Teams, mit denen ich zusammengearbeitet habe, spüren den Schmerz meist zuerst bei der Nacharbeit, nicht in den Schlagzeilen. Analysten vertrauen den Dashboards nicht mehr, Entwickler jagen unpassenden Zahlen hinterher und Geschäftsanwender erstellen Schatten-Tabellenkalkulationen, weil sich die offiziellen Zahlen ständig ändern. Die Kosten bestehen nicht nur aus schlechten Berichten. Sie äußern sich in langsameren Entscheidungen, mehr manueller Validierung und schwindendem Vertrauen in jede KI- oder Analyse-Initiative, die auf denselben Daten aufbaut.
Inhaltsverzeichnis
Die wahren Kosten schlechter Datenqualität
Der schnellste Weg, das Vertrauen in eine Datenplattform zu verlieren, besteht darin, Datenqualität als bloße Aufräumaufgabe zu bezeichnen. Die Kosten zeigen sich in verpassten SLA-Fristen, Nacharbeit und Entscheidungen, die auf veralteten oder inkonsistenten Inputs basieren. Gartners Ausführungen zum Thema Datenqualität beziffern den durchschnittlichen jährlichen Verlust durch mangelhafte Datenqualität auf 12,9 Millionen USD pro Unternehmen (Gartner data quality topic). Frühere Branchenuntersuchungen brachten schlechte Datenqualität zudem mit jährlichen Kosten von rund 600 Milliarden USD für US-Unternehmen in Verbindung – weshalb das Problem seit jeher operativer und nicht kosmetischer Natur ist (IBM Institute for Business Value, Gartner study PDF).
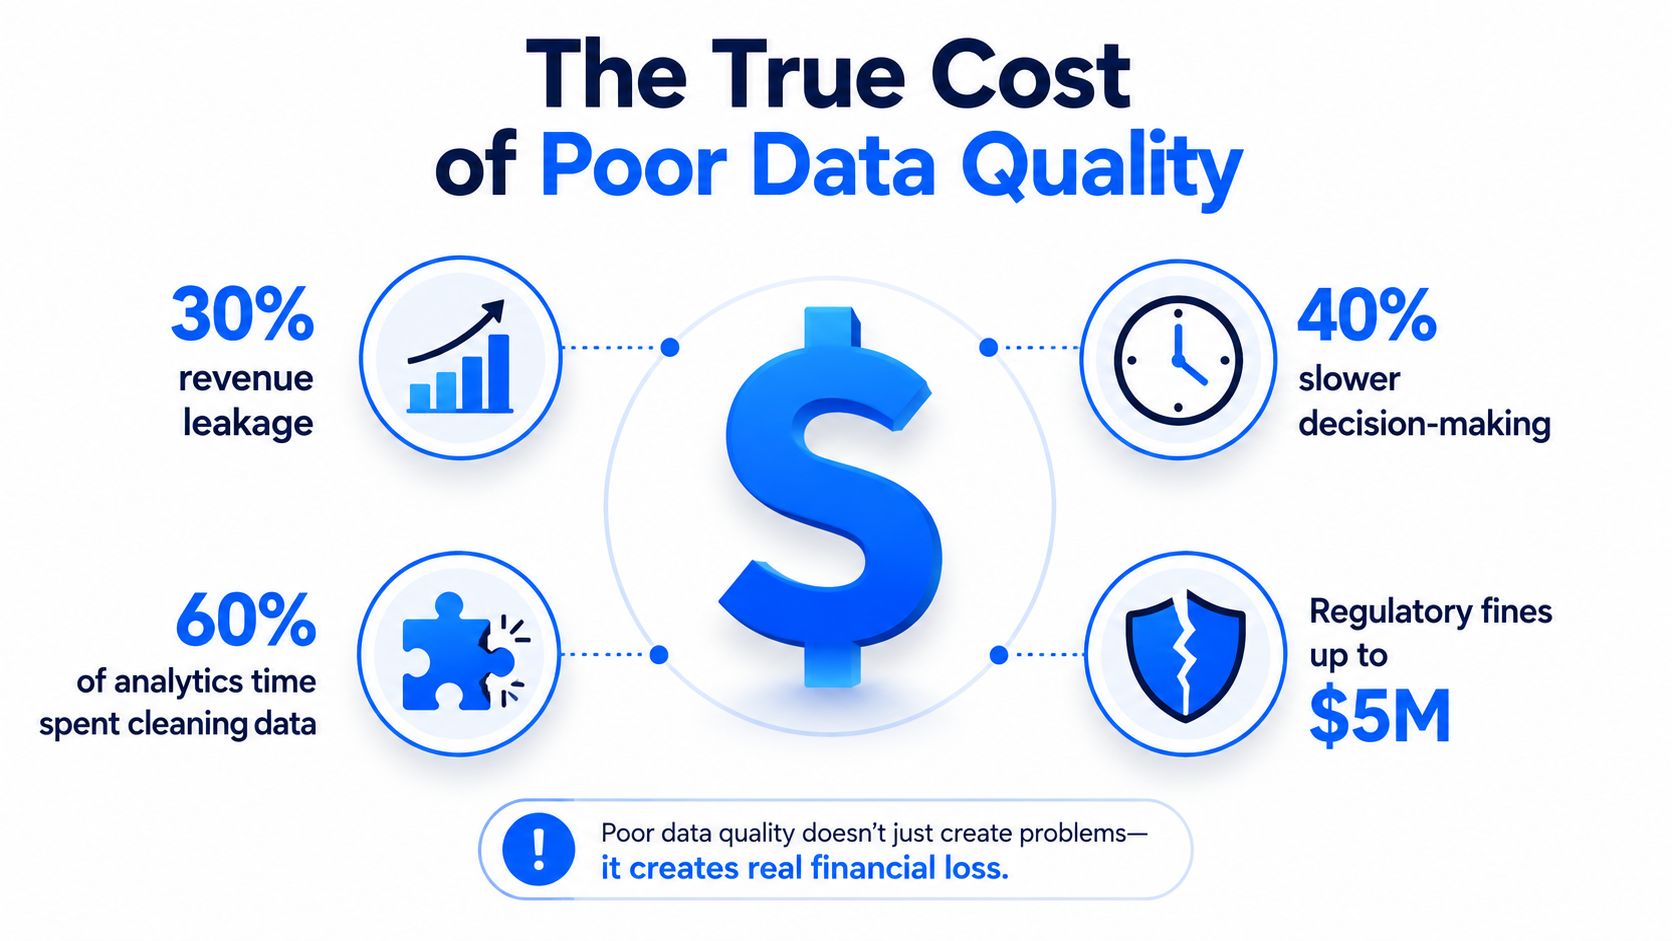
Wohin das Geld tatsächlich fließt
Der Verlust macht sich meist an drei Stellen bemerkbar. Teams verschwenden Stunden damit, widersprüchliche Zahlen abzugleichen, anstatt produktive Arbeit zu leisten. Schlechte Inputs erhöhen die Betriebskosten, da jede nachgelagerte Korrektur teurer ist, als das Problem bereits vorgelagert abzufangen. Zudem verfälschen sich Entscheidungen, wenn Daten unvollständig, veraltet oder inkonsistent sind.
Praktische Regel: Wenn ein Datenproblem einen Analysten, einen Finanzverantwortlichen und einen Entwickler erreicht, ist das Problem bereits teuer.
Diese Kosten wirken sich gleichzeitig auf Finanzen, Betrieb, Compliance und KI-Programme aus. Ein schneller Weg, dies zu veranschaulichen, ist der data downtime cost calculator, der vagen Frust in konkrete Incident-Kosten, Zeitverlust und Nacharbeit umrechnet.
Der Business Case umfasst mehr als nur sauberere Dashboards
Der Wertbeitrag ist nicht abstrakt. Forschungsbasierte Analysen zum Geschäftswert verknüpfen eine Steigerung der Arbeitsproduktivität in der IT um 1,9 % mit rund 21,7 Millionen USD für ein durchschnittliches Unternehmen. Dies zeigt, wie kleine Prozessverbesserungen große finanzielle Erträge erzielen können, wenn sie im gesamten Unternehmen skaliert werden. Dieselbe Logik gilt für Datenqualitätskontrollen, da jeder vermiedene Korrekturzyklus die Zeit von Analysten und Entwicklern schont und die Entscheidungsfindung beschleunigt.
Manuelle Prüfungen führen zudem zu verdecktem Dokumentationsaufwand. Teams, die sich auf implizites Wissen verlassen, verbringen mehr Zeit damit zu erklären, warum eine Pipeline ausgefallen ist, als die Pipeline selbst zu reparieren. Das ist einer der Gründe, warum automatisierte Dokumentations-Workflows für Entwickler bei derselben Zuverlässigkeitsdiskussion eine Rolle spielen – denn transparentere Systeme lassen sich einfacher verwalten und fallen seltener aus (automated documentation workflows for developers).
Die praktische Erkenntnis ist einfach. Schlechte Daten führen nicht nur zu schlechten Berichten. Sie mindern die Produktivität, erhöhen die Betriebskosten und schwächen das Vertrauen in jede Zahl, die von Führungskräften freigegeben wird.
Technische Vorteile automatisierter Observability
Manuelle Regelwerke versagen schnell, sobald sich Pipelines täglich ändern. Eine kleine Auswahl handgefertigter Prüfungen kann bekannte Fehler abfangen, übersieht jedoch unbekannte Anomalien, schleichende Schemaänderungen und verspätet eintreffende Daten, die eine statische Regel nicht verletzen. Automatisierte Observability schließt diese Lücke, indem sie normales Verhalten erlernt, auf Abweichungen achtet und Probleme meldet, bevor nachgelagerte Verbraucher sie in fehlerhafte Berichte oder instabile Modelle verwandeln.
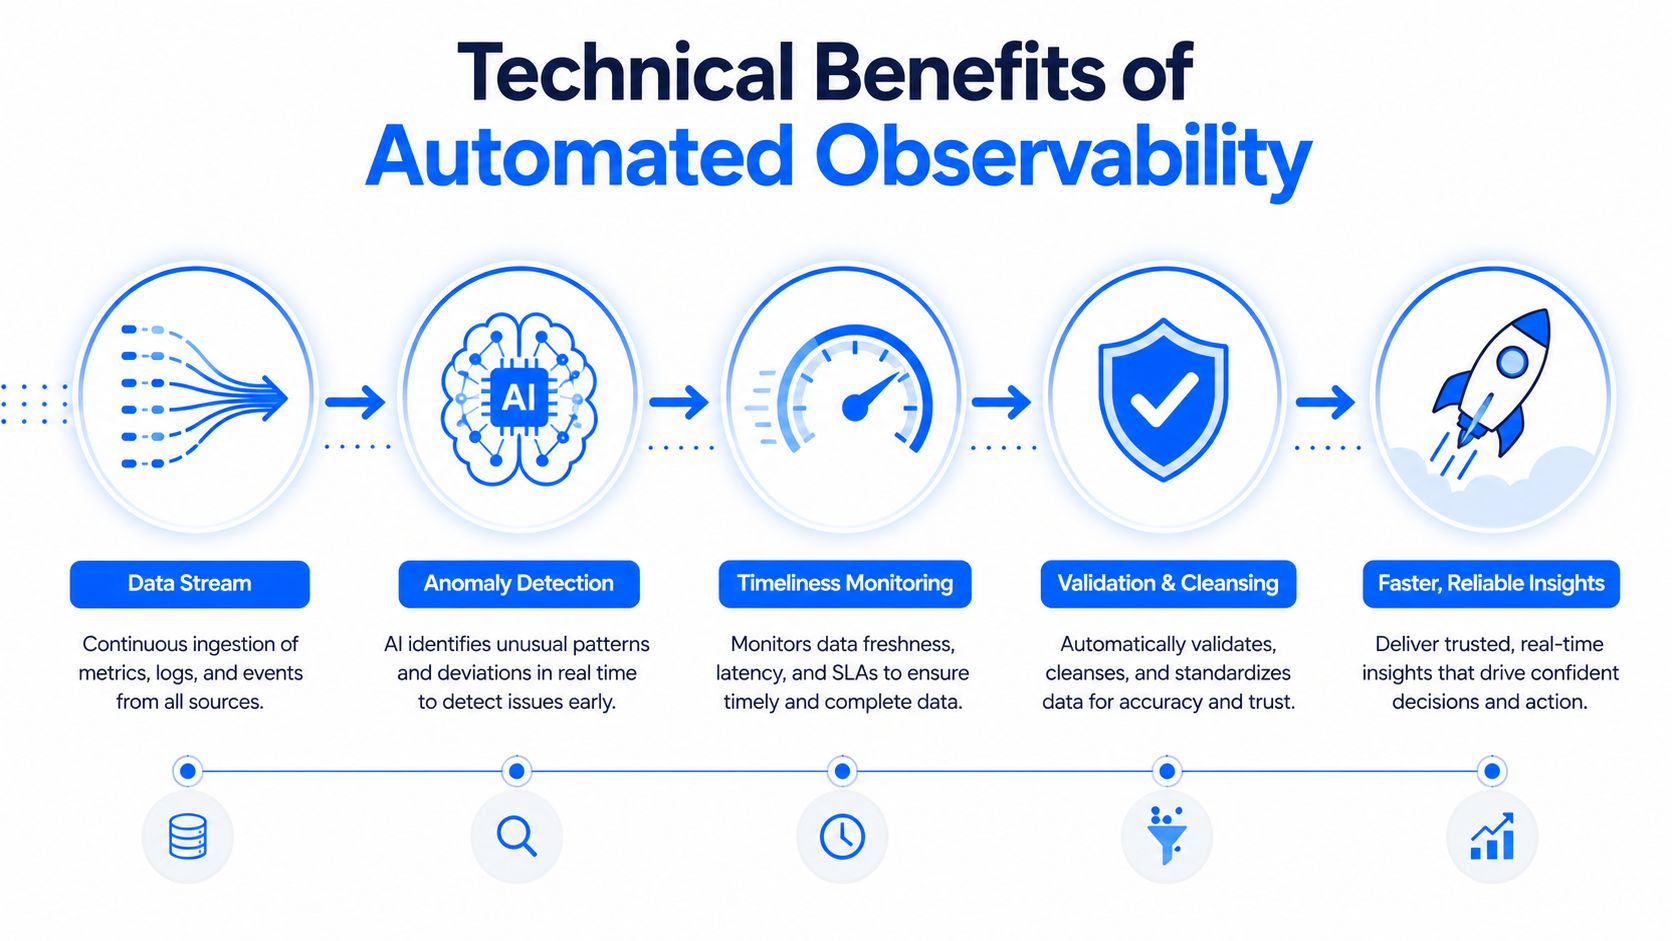
Bei der Anomalieerkennung geht es um Unbekanntes, nicht nur um Schwellenwerte
Herkömmliche Prüfungen funktionieren gut bei bekannten Fehlermustern, sind jedoch ungenau, wenn sich die Struktur eines Datensatzes verändert. KI-gestützte Anomalieerkennung lernt das erwartete Verhalten im Laufe der Zeit und schlägt Alarm, wenn sich Volumen, Verteilung oder Beziehungen außerhalb des Baselines bewegen. Das ist wichtig, da viele kostspielige Vorfälle als subtile Veränderungen und nicht als offensichtliche Systemausfälle beginnen.
Forschungsergebnisse von Google zur Datenqualität für maschinelles Lernen betonen, dass vertrauenswürdige KI von Genauigkeit, Vollständigkeit und Konsistenz in den Trainings- und Testdaten abhängt, da instabile Inputs das Modellverhalten schwächen und geschäftliche KPIs verfälschen können, selbst wenn die Pipelines weiterhin laufen (Google research). In der Praxis muss die Erkennung erfolgen, bevor fehlerhafte Datensätze in Dashboards oder Retraining-Prozessen landen.
Timeliness-Überwachung und Schema-Tracking schützen die Pipeline
Verspätete Daten und sich ändernde Strukturen gehören zu den häufigsten Gründen, warum Teams das Vertrauen in ihre Pipelines verlieren. Eine veröffentlichte Studie zeigt, dass Schema-Überwachung Datenintegrationsfehler um 67,9 % reduzierte und die Zeit bis zur Erkennung von 19,7 Stunden auf 1,3 Stunden verkürzte (Google research). Dies ist eine bedeutende operative Verbesserung, da kürzere Erkennungsfenster bedeuten, dass weniger Benutzer veraltete Metriken sehen und seltener Entwickler für Notfallreparaturen herangezogen werden müssen.
Kontinuierliche Überwachung ist günstiger als die Reaktion auf Vorfälle. Jede Stunde, die Sie früher erkennen, ist eine Stunde weniger, in der Sie erklären müssen, warum das Dashboard falsch war.
Die Kosten des Abwartens zeigen sich noch deutlicher in Umgebungen mit starker Drift. Eine Analyse besagt, dass Schema-Drift für 70 % aller Pipeline-Ausfälle verantwortlich ist und Unternehmen etwa 40 % der Entwicklungszyklen für datenbezogene Nacharbeiten aufwenden, wenn Drift erst spät entdeckt wird (DataGaps). Selbst wenn diese Zahlen keine allgemeingültigen Konstanten sind, ist der Trend unübersehbar. Manuelle Prüfungen leisten zu wenig und kommen zu spät.
Die Ausführung direkt in der Datenbank ist entscheidend
Eine moderne Observability-Ebene sollte dort arbeiten, wo die Daten bereits liegen. Die In-Database-Ausführung minimiert Datenbewegungen, wahrt Sicherheitsgrenzen und reduziert den Overhead, der entsteht, wenn große Tabellen in eine separate Validierungsebene geladen werden müssen. Das ist einer der Gründe, warum Teams Plattformen wie dignas data observability evaluieren, da diese Lösung Daten direkt vor Ort prüft, anstatt sie zu duplizieren.
Der technische Gewinn übersetzt sich direkt in geschäftlichen Nutzen. Eine bessere Anomalieerkennung reduziert die Nacharbeit. Die Timeliness-Überwachung verkürzt das Zeitfenster von Vorfällen. Das Schema-Tracking verhindert lautlose Fehler, die andernfalls Analyse- und KI-Funktionen beeinträchtigen würden. Dies sind zwar technische Kontrollen, doch die Führungsebene spürt das Ergebnis in Form von weniger fehlerhaften Dashboards, weniger Eskalationen und weniger Zeitaufwand für Bereinigungen.
Datenqualität als Fundament für KI-Bereitschaft
KI-Systeme sind nur so vertrauenswürdig wie die Daten, die sie verarbeiten. Das klingt selbstverständlich, doch viele Teams müssen diese Erfahrung erst auf die harte Tour machen. Sie entwickeln zuerst Modelle und stellen dann fest, dass fehlende Felder, veraltete Werte oder inkonsistente Definitionen die Ergebnisse unzuverlässig machen. Sobald dies geschieht, wird es schwieriger, der KI zu vertrauen, sie zu steuern und zu skalieren.

KI-Bereitschaft beginnt mit zuverlässigen Inputs
Datenqualität ist die Kontrollebene für die KI-Bereitschaft. Wenn Trainingsdaten unvollständig oder inkonsistent sind, übernimmt das Modell diese Schwächen. Wenn Produktionsdaten abweichen, verschlechtern sich die Ergebnisse, selbst wenn der Code unverändert bleibt. Der Fehler sieht oft wie ein Modellproblem aus, aber die eigentliche Ursache ist die Instabilität der Daten.
Der Forrester-Bericht „Data Quality Solutions“ für 2025 stellt fest, dass diese Tools helfen, „Datenzuverlässigkeit und Vertrauen in einen Wettbewerbsvorteil zu verwandeln“ und „die KI-Bereitschaft und -Einführung zu beschleunigen“ (Forrester). Das deckt sich mit den Erfahrungen der Teams in der Praxis. Datenqualität entwickelt sich von einer reinen Aufräumarbeit zu einer permanenten Bereitschaftsfunktion.
Echtzeit-governance wird zum Standard
Laut Board.org haben 39 % der Datenverantwortlichen Schwierigkeiten, der Unternehmensführung den Nutzen von Governance zu demonstrieren, was erklärt, warum dieser Arbeit in vielen Unternehmen immer noch klare Erfolgsnachweise fehlen (Board.org). Die Antwort liegt in operativen Belegen. Echtzeit-Überwachung, Lineage und Schema-Tracking bieten Verantwortlichen konkrete Anhaltspunkte, wenn sie Ausgaben rechtfertigen oder einen Vorfall erklären müssen.
Eine Vorschau auf einen Governance-Benchmark zeigte zudem, dass 69 % der Daten- und Analyse-Verantwortlichen Echtzeit-Datenüberwachung als Governance- und Datenqualitätspraxis einsetzen (Forrester). Das entspricht dem Wandel im Betriebsmodell, den ich am häufigsten beobachte. Dezentrale Teams können nicht auf monatliche Audits warten, während sich Modelle, Berichte und Produktentscheidungen ständig ändern.
Die praktische Erkenntnis ist einfach. Wenn KI von der Datenebene abhängt, muss die Datenqualität wie eine Laufzeitinfrastruktur behandelt werden und nicht wie ein Thema für vierteljährliche Überprüfungen. Teams benötigen eine data discipline that keeps AI models grounded in reliable inputs, denn das Ziel sind nicht schönere Dashboards, sondern der Schutz der Vertrauensgrenze zwischen Rohdaten und automatisierten Entscheidungen.
Branchenspezifische Anwendungsfälle und Lösungen
Datenqualität wird greifbar, wenn sie mit Branchenrisiken verknüpft ist. Finanzwesen, Gesundheitswesen und Telekommunikation haben jeweils unterschiedliche Fehlermuster, teilen jedoch dieselbe Anforderung: Die Zahlen müssen stimmen, wenn das Unternehmen danach handelt. Eine Plattform muss diese Unterschiede abbilden können, ohne jedes Team in dasselbe starre Regelwerk zu zwingen.
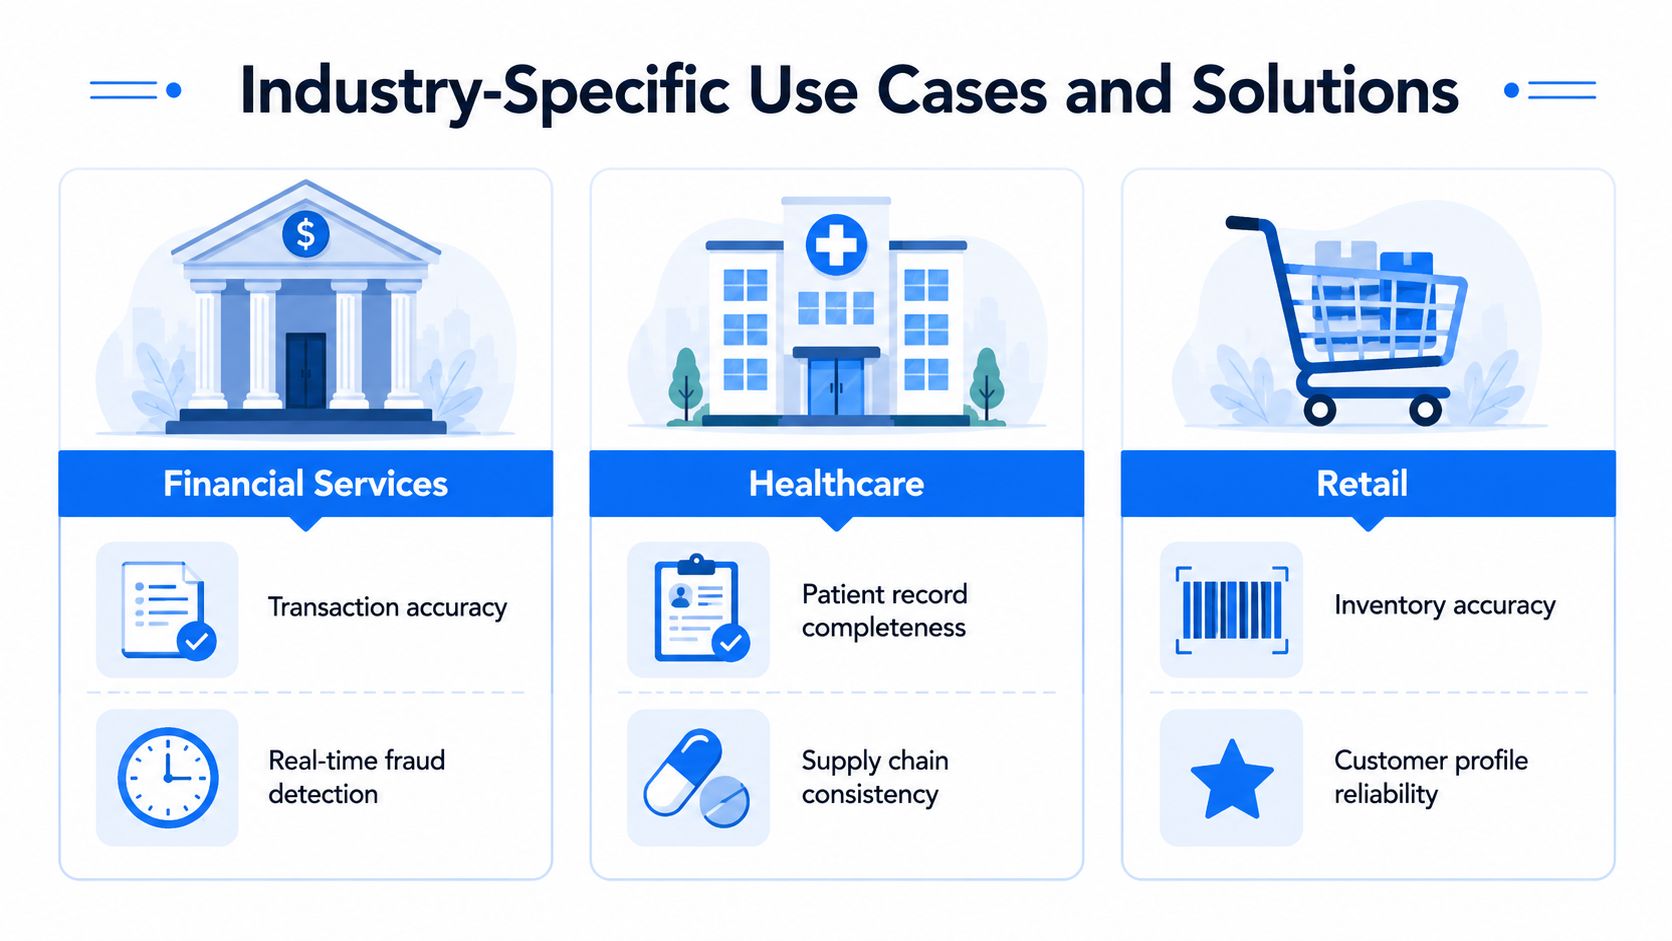
Finanzwesen benötigt Rückverfolgbarkeit und schnelle Ausnahmebehandlung
Bei Finanzdienstleistungen steht das Vertrauen in Transaktions- und Regulierungsdaten meist an erster Stelle. Eine einzige übersehene Ausnahme kann die Risikoberichterstattung verfälschen oder eine Wirtschaftsprüfung verzögern. Hier spielen Validierung auf Datensatzebene, Timeliness-Überwachung und Schema-Tracking zusammen, da eine Transaktion, die sich verspätet oder im falschen Moment ihre Struktur ändert, ein Berichtsproblem verursacht, noch bevor es jemand bemerkt.
Eine modulare Plattform wie digna passt in dieses Umfeld, da sie Finanz-, Risiko-, Regulierungs- und Transaktionsdaten durch Validierung, Anomalieerkennung, Lieferungsüberwachung und die Kontrolle von Schemaänderungen überwacht. Der Nutzen liegt nicht nur in weniger Fehlern, sondern in einer besseren Rückverfolgbarkeit, wenn ein Fachbereich wissen möchte, warum sich eine Zahl geändert hat.
Gesundheitswesen hängt von Vollständigkeit und Konsistenz ab
Im Gesundheitswesen geht es um die klinische Zuverlässigkeit auf andere Weise. Fehlende Felder in Patientenakten, inkonsistente Code-Nutzung oder verzögert eintreffende operative Daten können die Pflegekoordination und Berichterstattung erschweren. Automatische Überwachung hilft Teams, diese Probleme frühzeitig zu erkennen, bevor nachgelagerte Dashboards oder operative Workflows auf fehlerhaften Inputs aufbauen.
In regulierten Umgebungen entstehen die tatsächlichen Kosten oft durch Verzögerungen. Eine späte Korrektur kann teurer sein als eine präventive Prüfung.
Dasselbe Prinzip gilt für Lieferkettendaten im Gesundheitswesen, wo Konsistenz ebenso wichtig ist wie Genauigkeit. Wenn sich Produkt- oder Bestandsdaten unerwartet verändern, kann sich das Problem schnell auf den gesamten Betrieb ausweiten. Kontinuierliche Qualitätskontrollen verringern das Risiko, Korrekturen im Nachhinein hinterherlaufen zu müssen.
Telekommunikation benötigt Skalierung und stabile Kundendaten
Telekommunikationsteams verarbeiten riesige Mengen an Kunden- und Betriebsdaten, was bedeutet, dass sich kleine Inkonsistenzen schnell verbreiten können. Ein doppeltes Kundenprofil, ein fehlendes Event oder ein fehlerhaftes Schema können Berichte und Service-Workflows in großem Stil beeinträchtigen. Die praktische Lösung sind gezielte Validierungen, Anomalieerkennung und Verfügbarkeitsprüfungen, die Verschlechterungen sofort aufdecken.
In diesem Bereich ist auch Webclaw's duplicate detection guide eine nützliche Zusatzressource, da die Dublettenbereinigung zu den Problemen gehört, die anfangs unbedeutend wirken, bis sie die Kontengenauigkeit und nachgelagerte Analysen beeinträchtigen. Der entscheidende Punkt ist, dass branchenspezifische Qualitätskontrollen dann am besten funktionieren, wenn sie modular genug sind, um dem tatsächlichen Risikoprofil des jeweiligen Bereichs zu entsprechen.
Messung von ROI und Governance-Auswirkungen
Viele Teams können ihre Datenqualitätsarbeit beschreiben. Nur wenige können sie belegen. Diese Lücke ist der Grund, warum Governance-Budgets hinterfragt werden. Die Führungsebene wünscht sich keine Vertrauensphilosophie, sondern Beweise dafür, dass das Programm Vorfälle verhindert, Nacharbeit reduziert oder Abläufe beschleunigt hat.
Metrik-Kategorie | KPI-Beispiel | Geschäftliche Auswirkung |
|---|---|---|
Reduzierung von Vorfällen | Weniger Datenvorfälle pro Monat | Weniger Unterbrechungen für Analysten und seltener Eskalationen |
Erkennungsgeschwindigkeit | Kürzere Zeit bis zur Erkennung von Anomalien oder Schemaänderungen | Kleinerer Schadensradius und schnellere Behebung |
Timeliness | Geringere Quote verspäteter Dateneingänge | Zuverlässigere Berichte und aktuellere Entscheidungen |
Validierungsabdeckung | Höherer Prozentsatz kritischer Tabellen mit automatisierten Prüfungen | Weniger manuelle Überprüfungen und seltener übersehene Probleme |
Nacharbeit | Weniger Aufwand für die Neuerstellung oder den Abgleich von Berichten | Geringere Personalkosten und schnellere Abschlusszyklen |
Governance-Nachweis | Sichtbarere Audit-Trails und Lineage-Belege | Höheres Vertrauen der Führungsebene und Unterstützung bei der Compliance |
Starten Sie mit operativen KPIs, nicht mit abstrakten Werten
Die aussagekräftigsten Scorecards beginnen mit Kennzahlen zu Vorfällen. Messen Sie, wie oft fehlerhafte Daten den Benutzer erreichen, wie lange die Fehlersuche dauert und wie viel Zeit für die Behebung benötigt wird. Das sind keine Eitelkeitsmetriken. Sie spiegeln sich direkt in der Arbeitszeit von Analysten und Entwicklern sowie in geschäftlichen Verzögerungen wider.
Eine zweite Ebene sollte die Qualität der Erkennung messen. Wenn das Schema-Tracking eine folgenschwere Änderung abfängt, bevor sie nachgelagerte Verbraucher erreicht, ist das ein Governance-Erfolg mit einem klaren operativen Ergebnis. Wenn die Anomalieerkennung die Zeitspanne zwischen dem Auftreten eines Problems und der Alarmierung verkürzt, verringert das Team den Schadensradius. Dies sind die Kontrollmechanismen, die zeigen, ob die Plattform das Unternehmen schützt.
Verknüpfen Sie Metriken mit Nacharbeit und Entscheidungslatenz
Sobald die Vorfall-Metriken transparent sind, setzen Sie diese in Bezug zur eingesparten Arbeit. Weniger fehlerhafte Ladevorgänge bedeuten weniger korrigierte Dashboards. Eine bessere Timeliness bedeutet weniger Wartezeit auf aktualisierte Zahlen. Eine stärkere Validierung bedeutet weniger manuelle Stichproben und weniger Diskussionen darüber, ob ein Bericht vertrauenswürdig ist.
Ein praktischer Ausgangspunkt für diese Argumentation ist der data quality business case, denn Finanz- und Betriebsverantwortliche wollen letztlich dasselbe: eine nachvollziehbare Verbindung von der Kontrolle zum Ergebnis. Diese Argumentation ist am überzeugendsten, wenn Sie aufzeigen, welche Kontrollen welche Art von Fehlern verhindert haben.
Erstellen Sie eine Scorecard, die die Führungsebene auch tatsächlich liest
Halten Sie die Scorecard kompakt. Konzentrieren Sie sich nur auf die Metriken, die die geschäftlichen Auswirkungen widerspiegeln, und nicht auf jedes interne Signal, das die Plattform sendet. Wenn ein KPI keine Entscheidung beeinflusst, kein Risiko mindert oder keine Zeit spart, gehört er nicht in die Management-Ansicht.
Faustregel: Wenn sich eine Datenqualitätskennzahl nicht mit einem Vorfall, einer Prozessverzögerung oder einem Kostenfaktor verknüpfen lässt, ist sie für die Berichterstattung an die Führungsebene wahrscheinlich zu abstrakt.
Deshalb kombinieren die erfolgreichsten Programme technische Kennzahlen mit geschäftlichen Kennzahlen. Sie behaupten nicht nur, dass sich die Daten verbessert haben. Sie belegen, dass die Anzahl der Vorfälle sank, die Nacharbeit zurückging und die Governance einfacher nachzuweisen wurde.
Häufige Fehlermuster und Misconceptions
Die am wenigsten erfolgreichen Datenqualitätsprogramme scheitern meist aus vorhersehbaren Gründen. Der erste ist das übermäßige Vertrauen in manuell erstellte Regeln. Entwickler schreiben Prüfungen für das, was sie heute wissen – morgen ändert sich die Quelle und das Regelwerk deckt das Problem nicht mehr ab. Der zweite ist die Annahme, Datenqualität sei ein einmaliges Projekt und keine kontinuierliche Betriebsdisziplin.
Eine viel zitierte Analyse zum Thema Schema-Drift besagt, dass Drift für 70 % aller Pipeline-Ausfälle verantwortlich ist und Teams etwa 40 % der Entwicklungszyklen für datenbezogene Nacharbeiten aufwenden, wenn dieser zu spät erkannt wird (DataGaps). Genau deshalb greifen regelmäßige manuelle Prüfungen zu kurz. Sie können zwar den letzten bekannten Zustand bestätigen, schützen aber nicht vor neuen Strukturen, neuen Werten oder neuen zeitlichen Mustern.
Warum manuelle Regeln bei echten Arbeitslasten versagen
Manuelle Prüfungen sind anfällig, weil sie darauf angewiesen sind, dass jemand den nächsten Fehler voraussieht. Je mehr Pipelines Sie betreiben, desto unrealistischer wird das. Wenn jede neue Quelle ein eigenes Set an individuellen Validierungen erfordert, verbringt das Team seine Zeit am Ende mit der Pflege von Prüfungen, anstatt die Plattform zu verbessern.
Der bessere Ansatz ist die Nutzung kontinuierlicher Überwachung für das Unbekannte und gezielter Validierungen für die bekannten Geschäftsregeln. Dieses Gleichgewicht hält das System sowohl flexibel als auch auditierbar.
Warum die Bereinigung von Dubletten nicht die ganze Lösung ist
Die Erkennung von Dubletten ist wichtig, aber sie ist nur ein Teilaspekt der Qualität. Wenn sich Teams ausschließlich auf Dubletten konzentrieren, übersehen sie möglicherweise Timeliness-Probleme, strukturelle Änderungen und inkonsistente geschäftliche Definitionen. Deshalb sollte die Dublettenbereinigung Teil eines umfassenderen Qualitätsmodells sein und nicht das gesamte Modell darstellen.
Wenn Teams die Bereinigung als einmaliges Projekt betrachten, verschlechtert sich die Qualität der Plattform, sobald sich die nächste Datenquelle ändert. Die bessere Methode ist, davon auszugehen, dass Drift auftreten wird, und diese kontinuierlich zu überwachen. Nur so lassen sich lautlose Fehler reduzieren.
Implementierung einer Modern Data Quality-Strategie
Eine moderne Strategie beginnt mit der Zuweisung von Verantwortung. Jemand muss für jeden kritischen Datensatz, jede Geschäftsregel und jeden Alarmierungspfad verantwortlich sein. Ohne diese Zuweisung werden Probleme zwar zur Kenntnis genommen, aber nie gelöst. Unternehmen, die dies erfolgreich umsetzen, verlassen sich nicht auf vage Zuständigkeitsbeschreibungen. Sie weisen die Verantwortung auf Domänenebene zu und machen sie transparent.
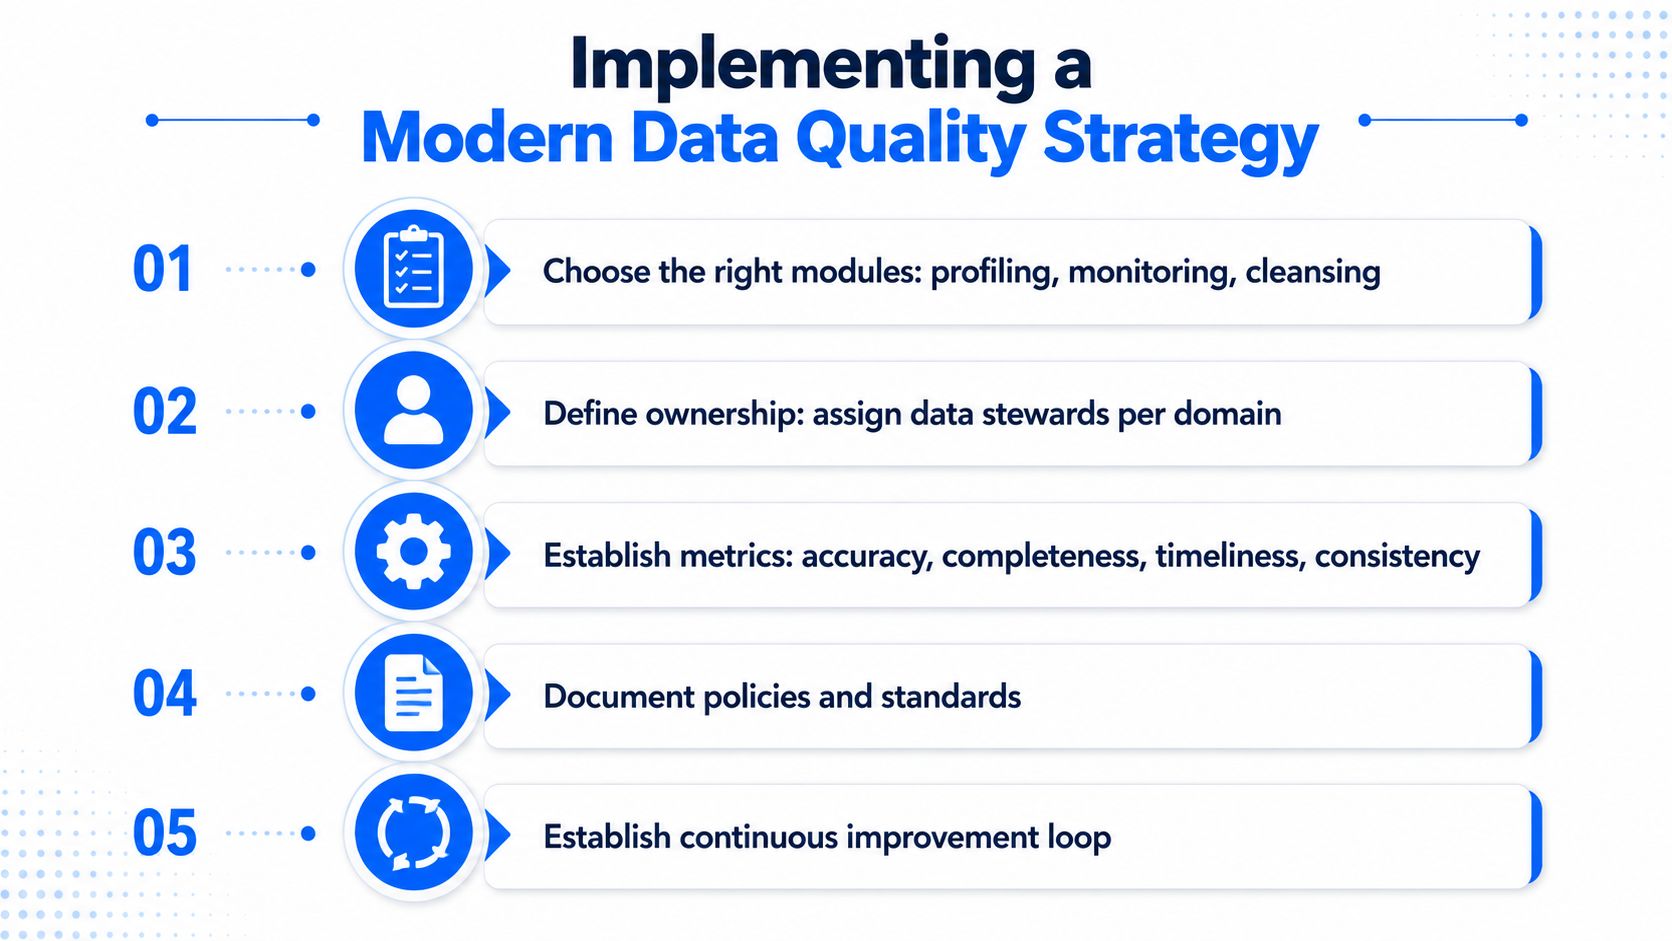
Wählen Sie die Kontrollen, die zum Risiko passen
Beginnen Sie mit Profiling, Anomalieerkennung, Timeliness-Überwachung, Schema-Tracking und Validierung. Diese fünf Kontrollen decken die meisten Fehlermuster ab, die in der Produktion auftreten. Eine Plattform sollte es Ihnen ermöglichen, mit einem Modul zu beginnen und dieses bei Bedarf zu erweitern, anstatt eine sofortige Gesamteinführung zu erzwingen.
Die Ressource data governance for reliable data ist hier ein nützlicher Begleiter, denn Governance funktioniert nur, wenn Regeln, Verantwortlichkeiten und Feedbackschleifen so praxisnah sind, dass sie täglich gelebt werden können. Das ist der entscheidende Filter: ob die Kontrollen zum operativen Tempo passen.
Lassen Sie die Daten an Ort und Stelle und halten Sie die Feedbackschleife kurz
Die Ausführung direkt in der Datenbank ist wichtig, da sie unnötige Datenbewegungen reduziert und die Kontrollebene nah an der Single Source of Truth hält. Dies vereinfacht die Sicherheit und erleichtert die Skalierung über Warehouses, Lakes und Pipelines hinweg. Zudem verkürzt es den Weg von der Erkennung bis zur Behebung – dem Schritt, bei dem Unternehmen oft wertvolle Zeit verlieren.
Ein solider Implementierungsplan sollte Folgendes umfassen:
Verantwortlichkeiten klar definieren. Weisen Sie Stewards für kritische Domänen zu, damit Warnmeldungen nicht in einem gemeinsamen Posteingang untergehen.
Richtlinien und Standards dokumentieren. Schreiben Sie die wichtigen Regeln auf, insbesondere für regulierte oder geschäftskritische Felder.
Feedbackschleifen automatisieren. Leiten Sie Vorfälle an die Verantwortlichen weiter, die die vorgelagerten Ursachen beheben können, und kurieren Sie nicht nur die Symptome.
Messen, was die Führungsebene spürt. Verfolgen Sie die Anzahl der Vorfälle, die Erkennungsgeschwindigkeit, Nacharbeit und Aktualität und berichten Sie diese Zahlen regelmäßig.
Klein anfangen, dann erweitern. Erproben Sie das Modell an einem kritischen Datensatz, bevor Sie die Abdeckung ausweiten.
Bauen Sie auf langfristige Akzeptanz
Die besten Datenqualitätsprogramme werden nicht als lästige Compliance-Pflicht empfunden, sondern als gemeinsame Infrastruktur. Entwickler vertrauen ihnen, weil sie Notfallreparaturen reduzieren. Analysten vertrauen ihnen, weil sich die Zahlen nicht mehr ohne Erklärung ändern. Die Führungsebene vertraut ihnen, weil die Governance-Story durch transparente Kennzahlen untermauert wird.
Ein praktischer Leitfaden zur Umsetzung steht Ihnen unter data quality implementation zur Verfügung. Dies ist besonders hilfreich, wenn Sie von manuellen Prüfungen zu automatisierter Observability wechseln möchten, ohne dabei die Kontrolle über Verantwortlichkeiten und Auditierbarkeit zu verlieren. Genau das ist das Ziel einer modernen Strategie: weniger Bereinigungsaufwand, mehr Vertrauen und eine Qualitätsebene, die mit dem Unternehmen wächst.
Wenn Sie bereit sind, Datenqualität in eine messbare Kontrollebene anstatt in eine wiederkehrende Aufräumaufgabe zu verwandeln, besuchen Sie digna und erfahren Sie, wie sich das datenbankinterne Monitoring, die Validierung, die Timeliness und das Schema-Tracking in Ihren eigenen Stack integrieren lassen. Die schnellsten Erfolge erzielen Sie meist mit einem kritischen Datensatz, einem klaren Verantwortlichen und einer automatisierten Schleife, die verhindert, dass fehlerhafte Daten jemals wieder das Geschäft beeinträchtigen.
Häufig gestellte Fragen
Wo zeigen sich die Vorteile von Datenqualität zuerst?
In der Nacharbeit und nicht in Schlagzeilen. Der Verlust landet in verpassten SLA-Terminen, wiederholter Abstimmung und Entscheidungen auf veralteten oder inkonsistenten Eingaben, lange bevor er in einem Vorfallbericht auftaucht.
Wie ordnen Führungskräfte Datenqualität heute ein?
IBMs Bericht von 2025 nennt, dass 43 % der Chief Operations Officers Datenqualität als ihre wichtigste Datenpriorität einstufen. Damit steht sie über den meisten Initiativen, die sie sonst stützen soll.
Welche Verluste werden berichtet?
Mehr als ein Viertel der Organisationen schätzt jährliche Verluste von über 5 Millionen USD durch mangelhafte Datenqualität, und 7 % berichten Verluste von 25 Millionen USD oder mehr, laut IBM Institute for Business Value.
Wann ist ein Datenproblem bereits teuer?
Wenn es eine Analystin, eine Finanzverantwortliche und einen Engineer erreicht. Dann beschäftigen sich drei Personen mit einem Defekt, und das ist ein verlässliches Signal, dass die Kosten die eigene Zeit des Datenteams überschritten haben.
Warum schadet es, Qualität als Hauswirtschaft zu bezeichnen?
Weil es der schnellste Weg ist, Vertrauen in eine Datenplattform zu verlieren. Qualität als Aufräumen zu rahmen setzt sie in Konkurrenz zur Feature-Arbeit, und die Kontrollen, die den nächsten Vorfall verhindert hätten, werden nie finanziert.



