Datenvollständigkeit: Was die DAMA sagt und wie man sie misst
|
6
min. Lesezeit

Der beliebteste Ratschlag zur Vollständigkeit von Daten ist auch der irreführendste: Zählen Sie die NULL-Werte und betrachten Sie die Arbeit als erledigt. Was ist Datenvollständigkeit? Es ist der Grad, in dem alle für einen bestimmten Zweck erforderlichen Daten vorhanden sind. Diese Definition ändert die Frage von „Gibt es leere Zellen?“ zu „Enthält dieser Datensatz das, was der Geschäftsprozess, Bericht, das Modell oder die Kontrolle benötigt?“
Ein ausgefülltes Feld kann immer noch den falschen Wert enthalten, während ein NULL-Wert in einem optionalen Feld unter Umständen keine praktischen Auswirkungen hat. Vollständigkeit ist daher eine Frage der Gebrauchstauglichkeit und kein Anspruch auf abstrakte Perfektion. Die Leitlinien der Vereinten Nationen zu Abdeckung und Vollständigkeit treffen dieselbe begriffliche Unterscheidung in der amtlichen Statistik, wo die Vollständigkeit registrierte Ereignisse mit der Gesamtheit in der Welt vergleicht, die sie darstellen sollen.
Inhaltsverzeichnis
Die fünf Arten von Vollständigkeit, die es wert sind, gemessen zu werden
Wie sich Vollständigkeit von Genauigkeit und Validität unterscheidet
Was Datenvollständigkeit wirklich bedeutet
Datenvollständigkeit ist der Grad, in dem alle für einen bestimmten Zweck erforderlichen Daten vorhanden sind. In einem Unternehmensdatensatz kann dies bedeuten: ausgefüllte Pflichtattribute, vollständige Geschäftsdatensätze, erwartete Datensatzbestände, erforderliche Berichtszeiträume oder alle Quelldatensätze, die von einem nachgelagerten Prozess benötigt werden.
Aus diesem Grund ist Vollständigkeit nicht nur das Fehlen von NULL-Werten. Angenommen, eine Kundentabelle enthält eine fehlende Kunden-ID. Das ist ein Vollständigkeitsfehler, wenn die ID für Verknüpfungen, Abstimmungen oder Berichte erforderlich ist. Eine fehlende sekundäre Marketingpräferenz ist möglicherweise akzeptabel, wenn die beabsichtigte Verwendung nicht davon abhängt.
Diese Unterscheidung trennt die Vollständigkeit auch von anderen Datenqualitätsdimensionen. Wenn eine Adresse vorhanden, aber falsch ist, betrifft das Problem die Genauigkeit. Wenn eine Telefonnummer vorhanden ist, aber das erforderliche Format verletzt, betrifft das Problem die Validität. Die Vollständigkeit fragt nur, ob die erforderlichen Informationen innerhalb des definierten Rahmens existieren.
Beginnen Sie mit dem Geschäftszweck
Bevor Sie eine Kennzahl auswählen, ermitteln Sie, was die Daten unterstützen müssen:
Die aufsichtsrechtliche Berichterstattung erfordert unter Umständen jede meldepflichtige Einheit und jedes Pflichtattribut.
Die operative Verarbeitung kann von IDs, Datumsangaben und Statusfeldern abhängen.
Die Analytik toleriert möglicherweise fehlende Anreicherungsattribute, solange der Kernbestand verfügbar bleibt.
Die KI-Entwicklung erfordert ausreichende Felder, Datensätze und Zeiträume für die beabsichtigte Analyse, da das Fehlen von Werten die analysierbare Stichprobengröße verringern und zu verzerrten oder unpräzisen Schätzungen führen kann, wie in dieser vom NIH gehosteten Übersicht über fehlende Daten beschrieben.
Praktische Regel: Definieren Sie, was „vollständig genug“ bedeutet, bevor Sie es messen. Andernfalls meldet ein Dashboard eine Zahl, ohne dass jemand weiß, ob diese Zahl die Entscheidung unterstützt.
Eine nützliche Arbeitsdefinition lautet: Die erforderlichen Datensätze, Felder, Beziehungen und Lieferzeiträume sind im erwarteten Umfang und Rhythmus für einen definierten Anwendungsfall vorhanden. Diese Definition gibt Dateneigentümern etwas an die Hand, das sie in Kontrollen umsetzen können.
Die fünf Arten von Vollständigkeit, die es wert sind, gemessen zu werden
Unternehmen benötigen mehr als eine Sichtweise auf die Vollständigkeit, da fehlende Werte und fehlende Datenbestände unterschiedliche Fehler darstellen. Die folgenden fünf Typen decken gängige Überwachungsanforderungen in Unternehmen ab, wobei Teams die Kombination auswählen sollten, die den geschäftlichen Anforderungen entspricht.
Attributvollständigkeit
Die Attributvollständigkeit fragt, ob erforderliche Felder ausgefüllt sind. Typische Beispiele sind:
Fehlende Kunden-IDs
Fehlende Transaktionsdaten
Fehlende Kontonummern
NULL-Geschäftsattribute, die für einen Bericht oder Prozess erforderlich sind
Ein Kundendatensatz ist zwar vorhanden, aber wenn seine ID fehlt, ist der Datensatz für die Deduplizierung oder Verknüpfungen möglicherweise unbrauchbar. Das entsprechende Maß ist der Anteil der erwarteten Datensätze, die einen Wert im angegebenen Attribut enthalten.
Datensatzvollständigkeit
Die Datensatzvollständigkeit fragt, ob jeder verfügbare Datensatz alle Pflichtfelder zusammen enthält. Eine Transaktion hat vielleicht eine Transaktions-ID und einen Betrag, aber es fehlen Kunden-ID, Währung oder Transaktionsdatum. Würde man die Zeile als vorhanden zählen, würde dies die Tatsache verschleiern, dass der Datensatz operativ nicht vollständig ist.
Vollständigkeit der Datensatzanzahl
Die Vollständigkeit der Datensatzanzahl vergleicht den gelieferten Datenbestand mit dem erwarteten Datenbestand. Wenn beispielsweise eine tägliche Transaktionstabelle, die normalerweise 10 Millionen Datensätze enthält, plötzlich nur noch 7 Millionen Datensätze enthält, liegt ein Problem mit der Vollständigkeit des Datenbestands vor, selbst wenn in jeder gelieferten Zeile die Felder perfekt ausgefüllt sind.
Das DAMA-Forschungsdokument zur Datenqualität unterstützt diese breitere Sichtweise, indem es die Vollständigkeit über Datensätze, Dateien, Attribute und Metadaten hinweg diskutiert.
Zeitliche Vollständigkeit
Die zeitliche Vollständigkeit prüft, ob alle erwarteten Termine oder Berichtszeiträume vorhanden sind. Eine Finanzpipeline kann erfolgreich geladen werden, obwohl ein Berichtstag, ein Monat oder eine Partition fehlt. Die Tabelle enthält zwar gültige Zeilen, aber die Zeitreihe ist unvollständig.
Datensatzgruppen-Vollständigkeit
Die Datensatzgruppen-Vollständigkeit fragt, ob jeder von einem nachgelagerten Prozess benötigte Datensatz vorhanden ist. Ein monatlicher Berichtsworkflow benötigt möglicherweise Kunden-, Transaktions-, Produkt- und Wechselkursdatensätze. Wenn eine Quelle nicht eintrifft, sind die Eingaben des Workflows unvollständig, selbst wenn die anderen Tabellen befüllt sind.
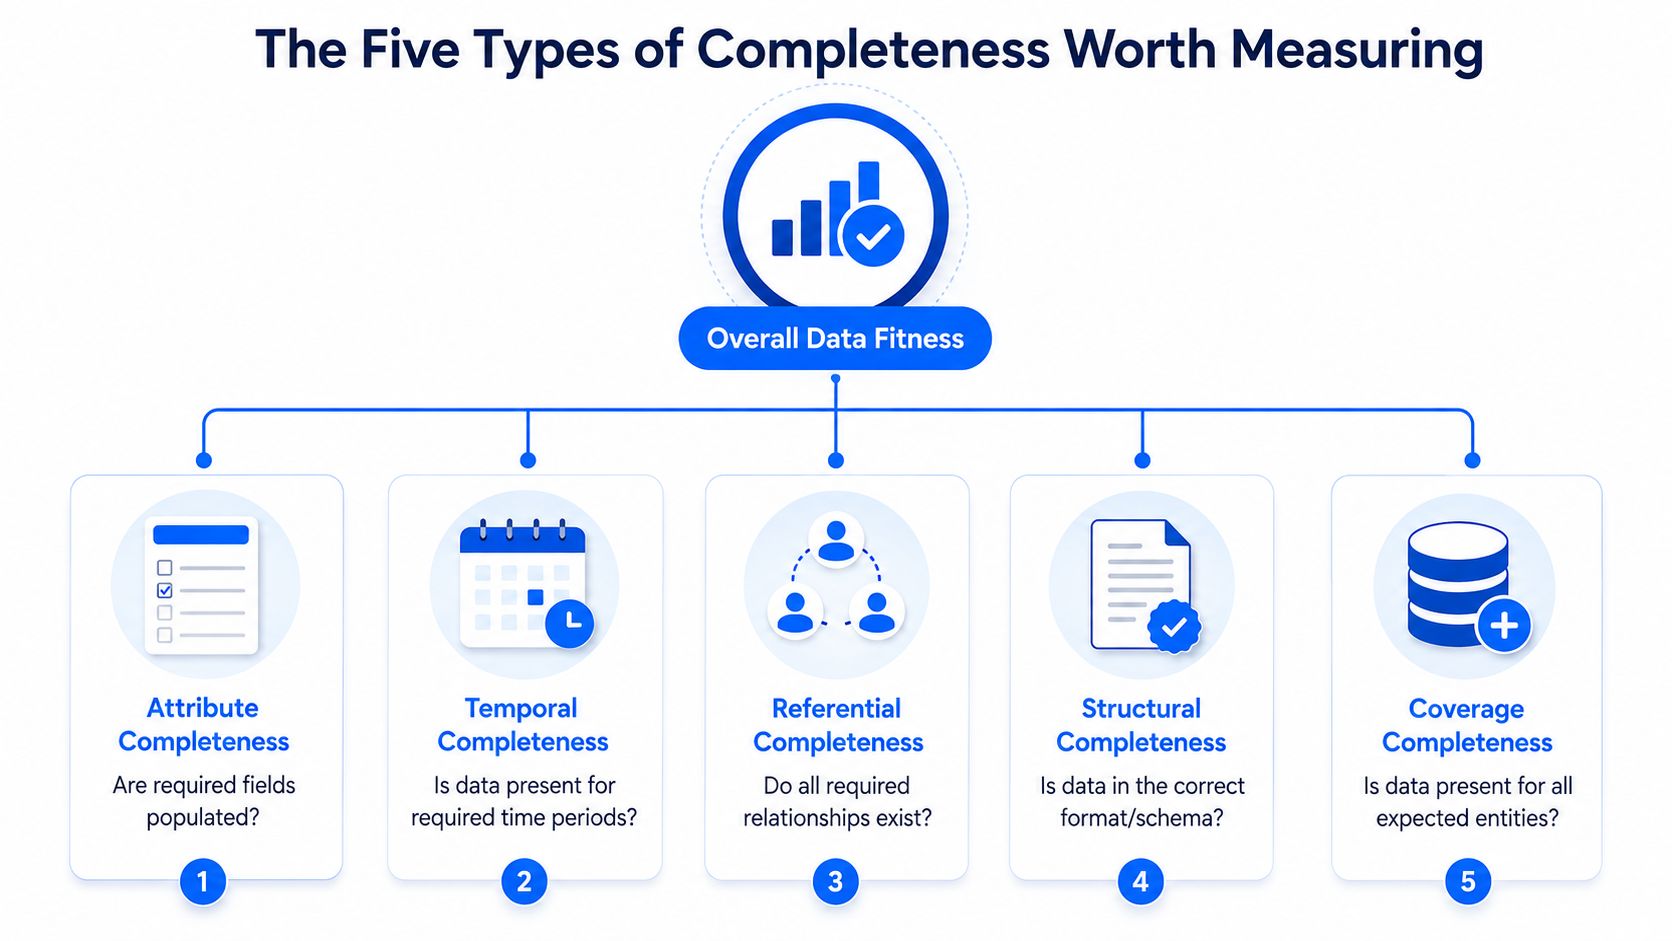
Diese Prüfungen sind nicht austauschbar. Ein Team benötigt möglicherweise Attribut- und Datensatzvollständigkeit für einen Kundenstamm, Datensatzanzahl- und zeitliche Vollständigkeit für Transaktionen und Datensatzgruppen-Vollständigkeit für eine Orchestrierungsabhängigkeit.
Wie DAMA und DMBOK an das Thema Vollständigkeit herangehen
DAMA International und die DAMA-DMBOK® 2.0 Revised Edition behandeln Vollständigkeit als eine Dimension der Datenqualität. Das Framework ist am nützlichsten, wenn Teams die Vollständigkeit in Relation zu den geschäftlichen Anforderungen und der Gebrauchstauglichkeit anwenden, anstatt sie als universelle technische Bewertung zu behandeln. Die Übersicht über DAMA und Data-Management-Frameworks bietet einen entsprechenden Kontext für die Positionierung der Datenqualität innerhalb breiterer Managementpraktiken.
Die Formulierung von DAMA deckt sich mit einer praktischen Frage: Was muss bekannt sein, damit diese Daten ihre beabsichtigte Rolle erfüllen können? Die Leitlinien der britischen Regierung zur Datenqualität besagen, dass Daten vollständig sind, wenn alle für eine bestimmte Verwendung erforderlichen Daten vorhanden sind, und empfehlen, die Vollständigkeit für kritische Daten zu messen und nicht für jedes Feld in jedem Datensatz.
Das bedeutet, dass eine 100%ige Vollständigkeit nicht automatisch die richtige Anforderung für jeden Datensatz ist. Eine Vollständigkeitsrate von 98 % kann für einen analytischen Anwendungsfall akzeptabel sein, für die aufsichtsrechtliche Berichterstattung jedoch inakzeptabel. Diese Werte veranschaulichen eine Governance-Entscheidung, keine universellen Schwellenwerte.
Anforderungen nach Auswirkung festlegen
Eine nützliche Richtlinie verbindet Vollständigkeit mit Konsequenzen:
Identifizieren Sie den Bericht, das Modell, den Prozess oder die Kontrolle, die die Daten verbrauchen.
Definieren Sie die Datensätze und Attribute, ohne die sie nicht funktionieren können.
Legen Sie gemeinsam mit dem Dateneigentümer einen akzeptablen Vollständigkeitsschwellenwert fest.
Dokumentieren Sie, was passiert, wenn der Schwellenwert unterschritten wird.
Überprüfen Sie die Anforderung, wenn sich der Anwendungsfall ändert.
Ein Primärschlüssel, ein regulatorisches Attribut oder eine Transaktions-ID verdient in der Regel eine strengere Behandlung als eine optionale beschreibende Anreicherung. Der Beitrag von DAMA besteht in dem Vokabular und der Disziplin, diese Unterscheidung explizit zu machen. Sie ersetzt nicht die lokalen Eigentumsentscheidungen.
Metriken und Formeln zur Messung der Vollständigkeit
Metriken zur Datenvollständigkeit sollten das Fehlen von Daten messen, das sich auf einen definierten Anwendungsfall auswirken kann. Ein starkes Messmodell kombiniert Indikatoren auf Feld-, Datensatz-, Bestands-, Zeit- und Datensatzgruppenebene, anstatt sich auf eine einzige Null-Zählung zu verlassen.
Die Grundformel lautet:
Vollständigkeitsrate = ausgefüllte erforderliche Werte / erwartete erforderliche Werte × 100
Für die Attributvollständigkeit ist „ausgefüllte erforderliche Werte“ die Anzahl der Datensätze mit einem Wert im ausgewählten Feld. Bei der Datensatzvollständigkeit zählt der Zähler die Datensätze, die jedes Pflichtattribut enthalten. Für die Vollständigkeit des Datenbestands vergleichen Sie die gelieferten Datensätze mit dem erwarteten Datensatzbestand. Der Nenner muss die geschäftliche Definition der erwarteten Daten widerspiegeln, nicht bloß die Anzahl der zufällig eingetroffenen Zeilen.
Kernkennzahlen
NULL-Rate: Der Anteil der Datensätze, bei denen ein ausgewähltes Feld fehlt. Sie hilft dabei, Lücken auf Feldebene zu finden, zeigt aber keine fehlenden Datensätze oder Datensatzgruppen auf.
Pflichtfeldabdeckung: Der Anteil der erwarteten Werte, die für Pflichtattribute ausgefüllt sind.
Datensatzanzahl: Die Anzahl der Datensätze, die für einen bestimmten Ladevorgang, eine Partition, eine Entität oder einen Zeitraum geliefert wurden.
Abweichung der Datensatzanzahl: Die Differenz zwischen dem beobachteten und dem erwarteten Volumen unter Verwendung einer dokumentierten Baseline oder eines Quellenabgleichs.
Verfügbarkeit von Datensatzgruppen: Ob jede erforderliche Quelle, Tabelle, Datei oder Partition vorhanden ist.
Zeitliche Abdeckung: Ob alle erforderlichen Termine und Berichtszeiträume vertreten sind.
Vollständigkeitstrends: Die Entwicklung der einzelnen Kennzahlen im Laufe der Zeit, was hilft, einen einmaligen Vorfall von einer kontinuierlichen Verschlechterung zu unterscheiden.
Metrik | Was sie misst | Typische Verwendung |
|---|---|---|
NULL-Rate | Fehlende Werte in einem ausgewählten Attribut | Erforderliche Kunden-ID oder Kontonummer |
Pflichtfeldabdeckung | Ausgefüllte Pflichtwerte im Vergleich zu erwarteten Werten | Operative und regulatorische Kontrollen |
Datensatzanzahl | Gelieferter Zeilenbestand | Batch- und Event-Stream-Überwachung |
Abweichung der Datensatzanzahl | Abweichung vom erwarteten Volumen | Erkennung von Zeilenverlusten oder unvollständigen Ladevorgängen |
Zeitliche Abdeckung | Vorhandensein der erforderlichen Zeiträume | Finanzen, Betrieb und Zeitreihenanalyse |
Verfügbarkeit von Datensatzgruppen | Vorhandensein der erforderlichen Datenquellen | Nachgelagerte Abhängigkeitsprüfungen |
Vollständigkeitstrend | Veränderung der Vollständigkeit im Laufe der Zeit | Analyse wiederkehrender Probleme und von Prozess-Drift |
Die Leitlinien zu Datenqualitätsmetriken von digna bieten zusätzlichen Kontext für die Auswahl von Kennzahlen. Die wichtige Governance-Entscheidung besteht darin, kritische Attribute und Datenbestände zu priorisieren. Wenn jedes Feld gleichermaßen gemessen wird, entsteht Rauschen, was es schwieriger machen kann, eine schwerwiegende Lücke zu erkennen.
Wie sich Vollständigkeit von Genauigkeit und Validität unterscheidet
Vollständigkeit fragt, ob die erforderlichen Daten vorhanden sind. Genauigkeit fragt, ob sie korrekt sind. Validität fragt, ob sie den erforderlichen Regeln oder dem Format entsprechen. Diese Dimensionen können unabhängig voneinander fehlschlagen, weshalb Teams es vermeiden sollten, alle drei mit einem einzigen generischen Etikett wie „Qualitätsproblem“ zu versehen.
Nehmen wir als Beispiel die Telefonnummer eines Kunden:
Vollständigkeit: Ist eine Telefonnummer vorhanden, wenn das Unternehmen eine solche verlangt?
Validität: Entspricht der Wert dem akzeptierten Telefonnummernformat?
Genauigkeit: Stimmt der Wert mit der tatsächlichen Telefonnummer des Kunden überein?

Vollständigkeit und Genauigkeit
Eine fehlende Telefonnummer ist ein Vollständigkeitsproblem. Eine korrekt formatierte Telefonnummer, die jedoch einem anderen Kunden gehört, ist ein Genauigkeitsproblem. Das Feld ist in beiden Fällen vorhanden, aber nur ein Wert stellt die reale Entität korrekt dar.
Die Erklärung der Datenqualitätsdimensionen von Dataversity beschreibt die Vollständigkeit als ein Maß dafür, welche Informationen fehlen, und nicht dafür, ob die gespeicherten Informationen genau oder valide sind. Diese Trennung ist wichtig, da sich die Behebung unterscheidet. Fehlende Daten erfordern möglicherweise eine Vervollständigung im Quellsystem oder eine erneute Verarbeitung, während ungenaue Daten eine Überprüfung, Korrektur oder Stammdatenpflege erfordern können.
Vollständigkeit und Validität
Eine fehlende Telefonnummer ist unvollständig. Eine Telefonnummer, die Buchstaben enthält, obwohl das Schema ein numerisches Muster vorschreibt, ist ungültig. Eine korrekt formatierte, aber falsche Telefonnummer ist ungenau.
Frage | Dimension | Beispiel |
|---|---|---|
Ist der erforderliche Wert vorhanden? | Vollständigkeit | Telefonnummer fehlt |
Entspricht er der Regel? | Validität | Telefonnummer hat ein ungültiges Format |
Entspricht er der Realität? | Genauigkeit | Nummer gehört jemand anderem |
Die Unterscheidung von IBM zwischen Vollständigkeit, Genauigkeit und Validität bestärkt dieses Drei-Fragen-Modell. Verwenden Sie es bei der Zuweisung von Verantwortlichkeiten, beim Entwerfen von Tests und beim Erklären von Vorfällen gegenüber geschäftlichen Stakeholdern.
Überwachung der Vollständigkeit in modernen Pipelines
Eine technisch erfolgreiche Pipeline führt nicht zwangsläufig zu vollständigen Daten. Stellen Sie sich ein Warehouse vor, das täglich Kunden- und Transaktionsdaten empfängt: Der ETL-Job wird beendet, die Orchestrierung meldet Erfolg und die Zieltabelle ist verfügbar, aber das Transaktionsvolumen ist deutlich niedriger als normal und die erforderlichen Kunden-IDs weisen einen starken Anstieg der NULL-Werte auf.
Ein einzelner Pipeline-Status kann nicht beide Zustände erkennen. Der erste ist ein Problem mit der Datensatzanzahl oder dem Datenbestand. Der zweite betrifft die Attributvollständigkeit. Ein Überwachungskonzept muss die Daten nach der Bereitstellung prüfen und nicht nur, ob der Code ohne Ausführungsfehler lief.

Mehrschichtige Kontrollen nutzen
Deterministische Validierung prüft bekannte Anforderungen, wie z. B. dass eine obligatorische Kunden-ID nicht
NULLsein darf.Anomalieerkennung identifiziert unerwartete Änderungen im Datensatzvolumen, bei Null-Raten, Verteilungen oder dem Lieferverhalten.
Historische Analysen zeigen, ob die Abweichung isoliert, saisonal bedingt oder wiederkehrend ist oder Teil einer längerfristigen Verschlechterung darstellt.
Pünktlichkeitsüberwachung prüft, ob die erwarteten Daten zum erforderlichen Zeitpunkt und im gewünschten Rhythmus eingetroffen sind.
In diesem Szenario können Datenvollständigkeitsprüfungen für Unternehmens-Pipelines um Zeilenverlust, Feldverlust, fehlende Datensätze und fehlende Felder herum organisiert werden. Die Kontrolle sollte auch die für die Lücke verantwortliche Quellpartition oder -lieferung identifizieren, damit Ingenieure der Ursache nachgehen können, anstatt nur einen roten Status zu beobachten.
Ein erfolgreicher ETL-Lauf beweist nur, dass der Prozess ausgeführt wurde. Er beweist nicht, dass die erforderlichen Geschäftsdaten auch angekommen sind.
Kontinuität ist wichtig, da sich die Vollständigkeit im Laufe der Zeit ändert. Ein heute noch sauberer Datensatz kann nach dem Release eines Quellsystems, einem geänderten Extraktionsfilter, einer verspäteten Partition oder einer Workflow-Übergabe unvollständig werden. Durch eine kontinuierliche Überwachung wird der Zustand nahe dem Zeitpunkt der Änderung sichtbar.
Wie kann digna die Datenvollständigkeit unterstützen?
digna unterstützt die Datenvollständigkeit durch dedizierte Funktionen für explizite Regeln, ungewöhnliches Verhalten und historischen Kontext. Jede Funktion adressiert eine andere Ebene, sodass ein Team ein einzelnes Modul nicht als vollständigen Ersatz für alle Vollständigkeitskontrollen betrachten sollte.
digna Data Validation
digna Data Validation unterstützt bekannte, regelbasierte Anforderungen, darunter:
Erforderliche Felder dürfen nicht
NULLsein.Jede Transaktion muss eine erforderliche ID haben.
Obligatorische Geschäftsattribute müssen ausgefüllt sein.
Definierte Vollständigkeitsregeln müssen erfüllt sein.
Dies ist die primäre Funktion für Anforderungen, die direkt formuliert und Datensatz für Datensatz ausgewertet werden können.
digna Data Anomalies
digna Data Anomalies kann unerwartete Änderungen im Verhalten bezüglich der Vollständigkeit identifizieren, wie z. B. plötzliche Anstiege der NULL-Raten, unerwartete Einbrüche bei der Datensatzanzahl, signifikante Verteilungsänderungen und ungewöhnliche Abweichungen von historischen Datenmengen.
Die Anomalieerkennung identifiziert ungewöhnliches Verhalten. Sie beweist nicht automatisch, dass die Daten unvollständig sind. Eine legitime saisonale Änderung kann ungewöhnlich aussehen, während ein subtiler Vollständigkeitsfehler innerhalb eines breiten historischen Musters verbleiben kann. Teams benötigen weiterhin den geschäftlichen Kontext und gegebenenfalls explizite Validierungsregeln.
digna Data Analytics
digna Data Analytics bietet historischen Kontext für Vollständigkeitsmetriken. Teams können Trends bei der Datensatzanzahl, Trends bei der NULL-Rate, die historische Vollständigkeit, wiederkehrende Muster fehlender Daten und Änderungen zwischen Berichtszeiträumen untersuchen.
Vollständigkeitsanforderung | Beispiel | digna-Funktion |
|---|---|---|
Erforderliche Werte | Erforderliches Feld darf nicht | Data Validation |
Datensatzvolumen | Erwartete Anzahl von Datensätzen | Data Anomalies |
Historische Vollständigkeit | Verschlechterung im Laufe der Zeit erkennen | Data Analytics |
Verfügbarkeit von Datensatzgruppen | Erwartete Datenquelle ist vorhanden | Data Validation / Data Anomalies |
Die Zuordnung ist bewusst gewählt. Die Validierung setzt bekannte Bedingungen durch, Anomalien decken unerwartetes Verhalten auf und die Analytik hilft festzustellen, ob ein Problem isoliert oder wiederkehrend auftritt.
Wichtige Erkenntnisse und häufig gestellte Fragen
Datenvollständigkeit ist ein dynamischer geschäftlicher Zustand, keine statische Null-Prüfung. Definieren Sie die erforderlichen Daten für jeden Anwendungsfall, messen Sie die relevante Ebene und überwachen Sie, ob Datensätze, Attribute, Zeiträume und Datensatzgruppen weiterhin wie erwartet eintreffen.
Was ist Datenvollständigkeit?
Es ist der Grad, in dem alle für einen bestimmten Zweck erforderlichen Daten vorhanden sind. Der Umfang hängt von der Gebrauchstauglichkeit ab.
Welche Arten von Datenvollständigkeit gibt es?
Zu den gängigen Typen gehören die Attribut-, Datensatz-, Datensatzanzahl-, zeitliche und Datensatzgruppen-Vollständigkeit. Jede davon adressiert ein anderes Risiko fehlender Daten.
Wie wird Datenvollständigkeit gemessen?
Verwenden Sie Kennzahlen wie die NULL-Rate, die Pflichtfeldabdeckung, die Datensatzanzahl, die Abweichung der Datensatzanzahl, die Verfügbarkeit von Datensatzgruppen, die zeitliche Abdeckung und Vollständigkeitstrends.
Was sagt DAMA über Datenvollständigkeit?
DAMA-DMBOK behandelt Vollständigkeit als eine Dimension der Datenqualität und setzt Anforderungen in Beziehung zu geschäftlichen Anforderungen und der Gebrauchstauglichkeit.
Ist eine 100%ige Datenvollständigkeit immer erforderlich?
Nein. 100 % ist nicht universell angemessen. Eine Anforderung sollte die Konsequenzen fehlender Daten für die beabsichtigte Verwendung widerspiegeln.
Was ist der Unterschied zwischen Vollständigkeit und Genauigkeit?
Die Vollständigkeit fragt, ob der erforderliche Wert vorhanden ist. Die Genauigkeit fragt, ob dieser Wert korrekt ist.
Was ist der Unterschied zwischen Vollständigkeit und Validität?
Vollständigkeit betrifft das Vorhandensein. Die Validität betrifft die Einhaltung definierter Formate, Regeln oder Standards.
Wie kann die Datenvollständigkeit kontinuierlich überwacht werden?
Kombinieren Sie regelbasierte Validierung, Datensatz- und Lieferüberwachung, Anomalieerkennung und historische Analysen über Batch-, Streaming- und systemübergreifende Pipelines hinweg.
Welche digna-Module unterstützen die Datenvollständigkeit?
digna Data Validation, digna Data Anomalies und digna Data Analytics unterstützen unterschiedliche Anforderungen an die Vollständigkeit. Sie sollten auf die spezifische Kontrolle abgestimmt und nicht als austauschbar behandelt werden.
digna bietet Funktionen für Data Validation, Data Anomalies und Data Analytics zur Überprüfung erforderlicher Werte, zur Identifizierung ungewöhnlicher Datensatz- und Null-Raten-Verhalten sowie zur Analyse der Vollständigkeit im Zeitverlauf. Besuchen Sie digna, um zu sehen, wie diese Kontrollen in Ihren Ansatz zur Überwachung der Datenqualität passen können.
Häufig gestellte Fragen
Was bedeutet Datenvollständigkeit tatsächlich?
Den Grad, in dem alle für einen bestimmten Zweck erforderlichen Daten vorhanden sind. Der Zweck ist das entscheidende Wort, denn Vollständigkeit lässt sich nicht beurteilen, ohne zu wissen, was die Daten tragen sollen.
Warum führt das Zählen von NULL-Werten in die Irre?
Weil es eine andere Frage beantwortet. Ein gefülltes Feld kann dennoch den falschen Wert enthalten, während ein NULL in einem optionalen Feld gar keine praktische Wirkung hat. Eine Nullzählung misst Anwesenheit statt Hinlänglichkeit.
Womit beginnt man vor der Metrikwahl?
Mit dem fachlichen Zweck. Aufsichtsrechtliches Reporting verlangt womöglich jede meldepflichtige Entität und jedes Pflichtattribut, während ein exploratives Dataset Lücken verträgt, die anderswo inakzeptabel wären, und die Metrik muss dieser Anforderung folgen.
Wie rahmt DAMA Vollständigkeit?
Als Anwesenheit relativ zur Anforderung und nicht als absolute Eigenschaft einer Tabelle. Genau diese Rahmung trennt Vollständigkeit von den übrigen Qualitätsdimensionen, die fragen, ob vorhandene Werte korrekt, konsistent oder aktuell sind.
Kann eine Tabelle vollständig und dennoch unbrauchbar sein?
Ja. Vollständigkeit stellt nur fest, dass die erforderlichen Daten da sind. Sie sagt nichts darüber, ob diese Werte genau sind, rechtzeitig eintrafen oder mit derselben Entität in einem anderen System übereinstimmen.



