Anomalieerkennung in Sensordaten: Ein praktischer Leitfaden
|
8
min. Lesezeit

Ein Vibrations-Dashboard leuchtet während der Nachmittagsschicht rot auf. Der Bediener überprüft die Maschine, findet aber keine offensichtlichen Mängel. Der Alarm wurde durch einen Temperaturkanal ausgelöst, der auf einen wärmeren Raum reagierte, während ein separater Vibrationskanal allmählich auf einen Ausfall zusteuerte, ohne seinen festen Grenzwert zu überschreiten. Bis jemand die Signale miteinander verknüpft, hat der Detektor entweder zu oft Fehlalarm geschlagen oder zu lange geschwiegen.
Das ist die Realität beim Einsatz der Anomalieerkennung in Sensordaten. Industrielle Datenströme sind verrauscht, multimodal, zeitabhängig und verändern sich ständig. Ein Detektor, der bei einem sauberen Benchmark gut abschneidet, kann dennoch versagen, wenn Sensoren driften, Zeitstempel asynchron sind, Kanäle sich gemeinsam verändern oder die Anlage ihr Betriebsregime wechselt. Die praktische Frage ist nicht nur, welches Modell die beste Bewertung erzielt. Es geht darum, ob das System aussagekräftige Abweichungen schnell genug erkennt, damit ein Bediener oder Ingenieur reagieren kann.
Inhaltsverzeichnis
Warum die Anomalieerkennung bei Sensoren schwieriger ist, als es aussieht
Die entscheidenden Produktionsbedingungen
Feature-Engineering für Sensorströme
Zeitliche Synchronisierung vor der Feature-Berechnung
Features an das Ausfallmuster anpassen
Ein praktisches Feature-Menü
Das passende Erkennungsmodell auswählen
Statistische Baselines
Klassisches maschinelles Lernen
Deep Learning
Umgang mit Saisonalität, Drift und korrelierten Kanälen
Die Baseline vorsichtig neu kalibrieren
Gekoppelte Kanäle berücksichtigen
Ehrliche Bewertung der Erkennungsleistung
Ereignisbezogene Bewertung nutzen
Bereitstellungsarchitekturen für Echtzeit-Monitoring
Das Muster an die Entscheidung anpassen
In-Database-Scoring nicht außer Acht lassen
Sicherer Produktivstart
Die Checkliste vor dem Start durchgehen
Eskalationswege klar definieren
Warum die Anomalieerkennung bei Sensoren schwieriger ist, als es aussieht
Ein Turbinen-Vibrationssensor liefert unter Umständen noch Stunden nach dem Lockern einer Montagehalterung fast unveränderte Werte. Der mechanische Zustand hat sich zwar verändert, doch das Signal kann sich so langsam verschieben, dass es unter einem statischen Schwellenwert bleibt. Eine Regel, die erst ab einem bestimmten Wert alarmiert, geht von einem Normalbetrieb aus. Ein Ingenieur, der den Trend, den Rotationskontext und die damit verbundenen Kanäle prüft, erkennt hier jedoch womöglich einen sich anbahnenden Fehler.
Diese Diskrepanz beschreibt das Problem in der Produktion. Industrielle Systeme kombinieren Vibration, Temperatur, Druck, Stromstärke, Steuersignale, Bilder und andere Modalitäten – jede mit unterschiedlichem Abtastverhalten und eigenen Ausfallmustern. Fehlende Datenpunkte erzeugen Lücken, verrauschte Messwerte erzeugen Spitzen und korrelierte Kanäle können eine legitime Betriebsänderung wie eine Anomalie aussehen lassen. Der Detektor muss das Normalverhalten für eine bestimmte Anlage, einen bestimmten Betriebszustand und einen bestimmten Zeitraum erlernen, anstatt sich lediglich auf einen globalen Standardbereich zu verlassen.
Praktische Regel: Betrachten Sie den „Normalzustand“ als gelernten Betriebskontext und nicht als starre Zahl.
Die Forschung auf diesem Gebiet spiegelt dieselbe Entwicklung wider. Frühere Methoden zur Anomalieerkennung stützten sich stark auf Statistik und Signalverarbeitung. Spätere Arbeiten erweiterten dies um maschinelles Lernen und Deep Learning. Eine Studie aus dem Jahr 2020 über intelligente Anomalieerkennung in Sensorsystemen beschreibt die lange Geschichte statistischer und signalverarbeitender Methoden und grenzt konventionelle Verfahren von datengestützten Ansätzen ab. Eine separate Übersicht zur Anomalieerkennung bei Industriemaschinen wertete 84 Studien aus den Jahren 2016 bis 2023 aus und verdeutlicht das rasante Wachstum der modernen industriellen Forschung.
Die entscheidenden Produktionsbedingungen
Eine Erkennungs-Pipeline muss mehrere Bedingungen berücksichtigen, bevor sie ein nützliches Ergebnis liefern kann:
Änderungen des Betriebsregimes: Last, Drehzahl, Umgebungstemperatur, Produktionsrezepte und Schichtmuster verändern das erwartete Signal.
Sensordrift: Kalibrierungsänderungen und Alterung können die Baseline verschieben, während die Maschine selbst vollkommen intakt bleibt.
Korrelierte Kanäle: Temperatur, Vibration und Stromstärke können auf denselben mechanischen oder elektrischen Zustand reagieren.
Ungleichmäßige Abtastung: Ein Kanal liefert Daten in kurzen Abständen, während ein anderer nur sporadisch berichtet. Einfache zeilenweise Verknüpfungen können Beziehungen daher verfälscht darstellen.
Verzögerte Labels: Instandhaltungsteams dokumentieren selten den exakten Moment, in dem eine Anomalie begann, was die Zeitfenster für Training und Evaluierung unsicher macht.
Latenz und Lokalität: Eine Sicherheitsentscheidung muss eventuell direkt an der Maschine getroffen werden, während tiefere Analysen auf einer zentralen Plattform laufen können.
Diese Bedingungen erklären, warum die auf sauberen Datensätzen ermittelte Benchmark-Genauigkeit in der Praxis oft enttäuscht. Benchmarks bieten meist geordnete Zeitstempel, stabile Verteilungen und eindeutige Labels. Werkshallen liefern dagegen Sensorausfälle, Wartungseingriffe, wechselnde Arbeitslasten und Anomalien, die sich erst schleichend entwickeln. Ein Modell kann auf dem Papier glänzen, in der Realität aber Alarme zu spät, zu oft oder ohne ausreichenden Kontext auslösen, als dass ein Bediener sinnvoll einschreiten könnte.
Für Teams, die für die umliegenden Pipelines verantwortlich sind, bietet Data Observability für betriebliche Zuverlässigkeit Kontrollmechanismen, um eine echte Maschinenanomalie von einer verspäteten, fehlenden, fehlerhaften oder strukturell veränderten Datenübertragung zu unterscheiden. Der Detektor kann ein Signal, das nie ankam oder das falsche Format hat, nicht zuverlässig interpretieren. Die Betriebsüberwachung muss daher sowohl die Ausrüstung als auch den Datenpfad umfassen, der sie abbildet.
Feature-Engineering für Sensorströme
Rohe Sensorwerte sind ohne Betriebskontext nur wenig aussagekräftig für ein Modell. Eine Temperatur von 70 Grad kann bei einer bestimmten Last normal, bei einer anderen jedoch verdächtig sein. Ein Vibrationswert, der isoliert betrachtet harmlos erscheint, kann nach einem anhaltenden Anstieg kritisch werden. Nützliche Features erfassen den lokalen Kontext, zeitliche Veränderungen und die Beziehungen zwischen den Kanälen.
Zeitliche Synchronisierung vor der Feature-Berechnung
Wählen Sie einen Analyse-Rhythmus, der zum Latenzbudget des Detektors passt, und führen Sie dann eine bewusste Resampling-Methode für jeden Kanal durch. Ein hochfrequenter Vibrationsstrom sollte bei einem längeren Ausfall nicht einfach vorwärtsgerichtet aufgefüllt werden; ebenso wenig sollten Daten für Zeiträume interpoliert werden, in denen die Anlage offline war. Nutzen Sie Imputations- und Fehlendenindikatoren, damit der Detektor gemessene Werte von rekonstruierten Werten unterscheiden kann.
Die zeitliche Synchronisierung hängt auch von der Qualität der Systemzeit ab. Ein Uhrenversatz zwischen Geräten oder Gateways kann falsche Verzögerungsbeziehungen vortäuschen, wenn ein Kanal scheinbar einen anderen erklärt. Überprüfen Sie die Reihenfolge der Zeitstempel, Duplikate, Abtastlücken und die Einheitlichkeit der Maßeinheiten, bevor Sie Datenströme zusammenführen. Ein gut konzipiertes Feature auf der Grundlage falsch synchronisierter Signale bleibt fehlerhaft.
Bewahren Sie bei multimodalen Anlagen nach Möglichkeit die ursprünglichen Kanalzeitstempel oder Qualitätsflags auf. Ein einheitlicher Rhythmus erleichtert zwar die Feature-Berechnung, kann jedoch kurze Lücken kaschieren und einen langsamen Kanal präziser erscheinen lassen, als er tatsächlich ist. Die richtige Wahl hängt vom Ausfallmuster und dem Zeitfenster zum Handeln ab, nicht allein von einer ordentlichen Tabelle.
Features an das Ausfallmuster anpassen
Ein rollierender Z-Score misst, wie weit der aktuelle Messwert im Verhältnis zur jüngsten Streuung von einem gleitenden Mittelwert abweicht. Ein kurzes Zeitfenster, wie etwa fünf Minuten, kann einen plötzlichen Amplitudensprung aufdecken. Ein längeres Zeitfenster, wie etwa 30 Minuten, kann eine langsamere Drift aufzeigen, die ein kurzes Fenster fälschlicherweise als normal einstufen würde. Das bekannte Verfahren berechnet Mittelwert und Standardabweichung über ein gleitendes Fenster und markiert Werte außerhalb eines gewählten Schwellenwerts. Eine Referenzimplementierung nutzt einen Schwellenwert von 3, was bei einer Normalverteilung etwa 3 von 1.000 Punkten entspricht, wie im Beispiel zur Z-Score-Anomalieerkennung von Ericsson beschrieben.
Die Differenzenbildung beantwortet eine andere Frage. Differenzen erster Ordnung zeigen Sprünge zwischen aufeinanderfolgenden Beobachtungen. Differenzen zweiter Ordnung zeigen Änderungen der Bewegungsgeschwindigkeit und helfen dabei, eine beschleunigte Drift oder eine sich anbahnende Instabilität zu erkennen. Beide Operationen können das Rauschen verstärken; glätten oder aggregieren Sie stark schwankende Signale daher zuerst. Diese Vorverarbeitung verursacht jedoch eine Verzögerung, die in das Monitoring-Budget passen muss.
Lag-Features (Verzögerungswerte) mit einem bis zehn Schritten bieten klassischen Modellen einen kompakten Blick auf die jüngste Historie. Sie eignen sich für Prozesse, bei denen der nächste Messwert von den letzten Werten abhängt, erhöhen jedoch die Dimensionalität und werden bei einer dichten Abtastung redundant. Rollierende Perzentile beschreiben die lokale Streuung, ohne eine symmetrische Verteilung vorauszusetzen, was sie nützlich für Ausreißer und asymmetrisches Betriebsverhalten macht.
Ein praktisches Feature-Menü
Methode | Was erfasst wird | Bester Einsatzzweck |
|---|---|---|
Rollierender Z-Score | Lokale Abweichung vom jüngsten Mittelwert und der Streuung | Amplitudendrift und kurzzeitige Abweichungen |
Differenz erster Ordnung | Änderung zwischen aufeinanderfolgenden Messwerten | Plötzliche Sprünge und Unstetigkeiten |
Differenz zweiter Ordnung | Änderung der Bewegungsgeschwindigkeit | Beschleunigter Anstieg und sich anbahnende Instabilität |
Lag-Features (Verzögerungen) | Jüngster autoregressiver Kontext | Kurze zeitliche Abhängigkeiten in klassischen Modellen |
Rollierende Perzentile | Lokale Verteilungsgrenzen | Verrauschte Signale und nicht-gaußförmige Abweichungen |
Kanalübergreifende Residuen | Abweichung nach Berücksichtigung eines verwandten Signals | Gekoppeltes Verhalten von Temperatur, Stromstärke, Drehzahl und Vibration |
Kanalübergreifende Residuen bieten oft einen größeren Mehrwert als eine weitere Transformation desselben Signals. Schätzen Sie das erwartete Verhalten eines Kanals anhand eines damit verknüpften Kanals und überwachen Sie das Residuum (die verbleibende Abweichung). Überprüfen Sie diese Beziehung regelmäßig bei Änderungen von Arbeitslast und Kalibrierung, da Korrelationen driften können, selbst wenn beide Sensoren intakt sind.
Für eine genauere Betrachtung der Feature-Erstellung empfiehlt sich neben dem spezifischen Anlagenwissen ein Blick in Leitfäden zur Anomalieerkennung in Sensor-Zeitreihen. Die Auswahl der Features ist wichtiger als deren reine Menge. Jede Transformation sollte eine konkrete Überwachungsfrage beantworten, bei einem Alarm nachvollziehbar sein und nicht mehr Latenz oder Rechenleistung beanspruchen, als die betriebliche Entscheidung zulässt.
Das passende Erkennungsmodell auswählen
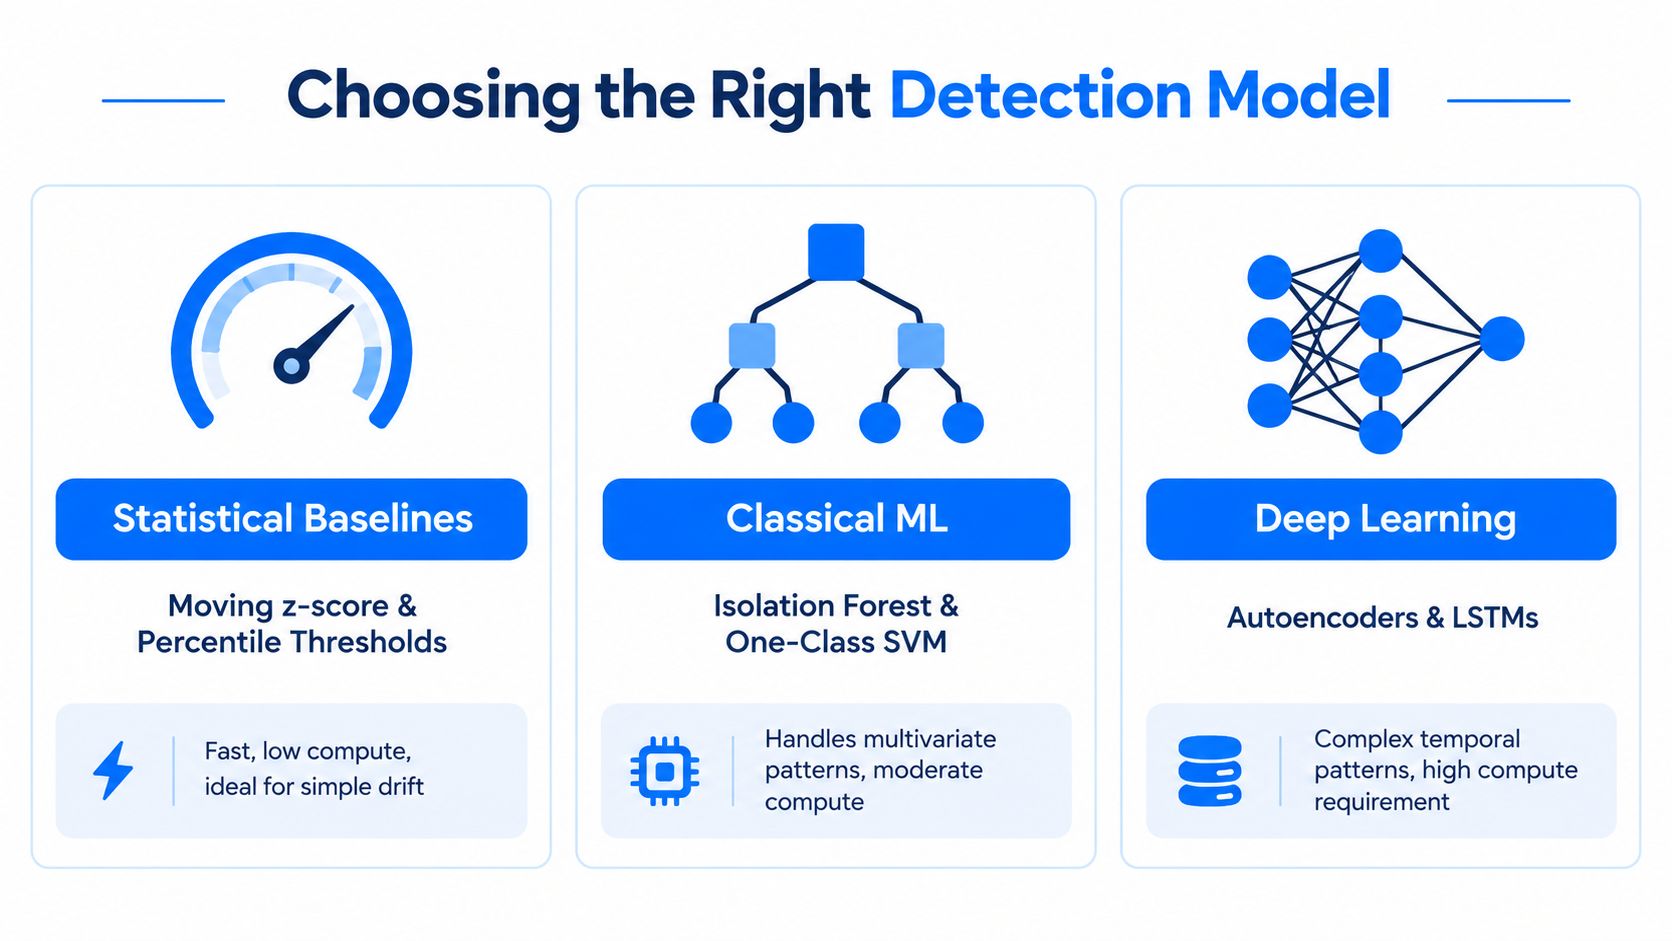
Es gibt keinen einzelnen Detektor, der für jedes Sensorregime optimal ist. Statistische Methoden sind ressourcenschonend und leicht erklärbar, klassisches maschinelles Lernen bewältigt kompakte multivariate Räume, und Deep Learning kann komplexe zeitliche Beziehungen modellieren. In der Praxis teilt man den verschiedenen Ansätzen meist spezifische Aufgaben zu, anstatt ein einziges Modell mit allen Alarmen zu belasten.
Statistische Baselines
Gleitende Z-Scores, rollierende Perzentile und Schwellenwerte für Residuen eignen sich hervorragend als erste Instanz. Sie sind schnell, leicht zu überprüfen und ideal für einfache Drifts oder abrupte Änderungen. Ihre Schwäche ist der fehlende Kontext. Ein fester Schwellenwert versagt, wenn sich das Betriebsregime ändert, und ein kurzes rollierendes Fenster stuft einen dauerhaften Fehler unter Umständen fälschlicherweise als neuen Normalzustand ein.
Adaptive Baselines können den Aufwand für die manuelle Konfiguration verringern. Eine dokumentierte Implementierung lernt eine Baseline aus den Messwerten der vorherigen sieben Tage, aktualisiert diese einmal pro Stunde und setzt mindestens 100 Messwerte voraus, bevor die Baseline etabliert wird, wie in der Dokumentation zu Sensor-Anomalie-Baselines beschrieben. Diese Mechanismen sind nützliche Muster, benötigen jedoch Schutzmaßnahmen, um zu verhindern, dass das System aus einem fehlerbehafteten Zeitraum lernt.
Klassisches maschinelles Lernen
Isolation Forest und One-Class SVM sind nützlich, wenn Anomalien in ungewöhnlichen Regionen eines multivariaten Feature-Raums auftreten. Sie können rollierende Statistiken, Verzögerungen, Residuen und den Betriebskontext kombinieren, ohne dass ein riesiges Archiv mit gelabelten Fehlern nötig ist. Sie sind oft einfacher bereitzustellen als Sequenzmodelle, können jedoch an Zuverlässigkeit einbüßen, wenn sich Feature-Verteilungen verschieben oder seltene Fehler unzureichend repräsentiert sind.
Hier ist Vorsicht geboten. Bei einem industriellen Anomalie-Benchmark erreichte der Isolation Forest mit oder ohne Skalierung nur einen mittleren F1-Score von 0,171, während LOF einen mittleren F1-Score von 0,100 erzielte, wie aus den berichteten Ergebnissen zur industriellen Anomalieerkennung hervorgeht. Diese Ergebnisse machen die Algorithmen nicht unbrauchbar. Sie zeigen vielmehr, warum eine unüberwachte Baseline das Vertrauen an der Zielanlage erst erarbeiten muss, anstatt es einfach aus der Theorie zu übernehmen.
Deep Learning
LSTM-Autoencoder und transformatorbasierte Detektoren können komplexe zeitliche Abhängigkeiten und kanalübergreifende Beziehungen abbilden. Sie eignen sich besser, wenn ein Fehlermuster auf einer Sequenz und nicht auf einem einzelnen isolierten Datenpunkt basiert. Sie erfordern jedoch mehr Rechenleistung, eine sorgfältige Gestaltung der Zeitfenster und verlässliche Daten aus dem fehlerfreien Normalbetrieb.
Praxisnahe Ergebnisse verdeutlichen sowohl das Potenzial als auch die Tücken. Ein mit einem Isolation Forest kombinierter LSTM-Autoencoder erreichte bei einer Bewertung von Sensoranomalien eine Genauigkeit von 95,7 % und einen F1-Score von 0.93, wie in dieser Studie zur Identifizierung von Sensoranomalien berichtet wird. Ein separater Autoencoder für industrielle Steuerungssysteme meldete eine Präzision von 0,993 und eine Genauigkeit von 96 %, während der Recall jedoch nur bei 0,673 und der F1-Score bei 0,771 lagen, dokumentiert in der Autoencoder-Studie für industrielle Steuerungssysteme. Eine hohe Präzision kann also mit einer zu hohen Zahl unentdeckter Fehler einhergehen.
Eine mehrstufige Architektur ist meist effektiver. Statistische Regeln können offensichtliche Abweichungen abfangen, klassische Modelle werden für multivariate Residuen eingesetzt, und unklare oder zeitlich komplexe Fälle werden an ein tieferes Modell übergeben. Details zur Implementierung von Python-basierten Anomalie-Workflows finden Sie in den Praktiken zur Python-Datenanomalieerkennung parallel zu Ihrer modellspezifischen Dokumentation.
Umgang mit Saisonalität, Drift und korrelierten Kanälen
Eine Produktionslinie kann im Mehrschichtbetrieb laufen, sich im Tagesverlauf erwärmen und Lagerverschleiß entwickeln, während sich das Lastprofil ändert. Ein starrer Schwellenwert wertet jede dieser Änderungen als Fehler. Der Detektor muss erwartbare Schwankungen von echten Hinweisen darauf unterscheiden, dass sich der Prozess oder die Sensorbeziehung verändert hat.
Die Baseline vorsichtig neu kalibrieren
Ein rollierender Z-Score kann tägliche Betriebszyklen ausgleichen und gleichzeitig Abweichungen vom jüngsten Muster erkennen. Er birgt jedoch ein Risiko: Ein Fehler, der sich über das gesamte Zeitfenster hinweg schleichend entwickelt, wird unter Umständen Teil der Baseline. Definieren Sie das Zeitfenster anhand des Prozesszyklus und der gewünschten Alarmierungsgeschwindigkeit, nicht nach praktischen Standardwerten.
Die STL-Zerlegung trennt Trend, saisonales Verhalten und Rauschen und bewertet dann die verbleibende Abweichung anstelle des Rohwerts. Nutzen Sie dieses Verfahren, wenn ein Kanal ein wiederkehrendes Muster aufweist. Perzentil-Schwellenwerte erfordern weniger Annahmen, da sie lokale Grenzen anhand jüngster Beobachtungen neu berechnen; sie müssen jedoch vor verunreinigten Trainingsphasen geschützt werden.
Ein Konzept für adaptive Schwellenwerte berechnet seine Baseline täglich neu auf Basis der vergangenen sieben Tage, nutzt minutengenaue Daten zur Bestimmung des 99. Perzentils und fügt einen Schwankungsterm hinzu, der auf dem Interquartilsabstand zwischen dem 25. und 75. Perzentil basiert, wie in der auto-adaptiven Schwellenwertmethode von Dynatrace beschrieben. Diese Implementierung verdeutlicht eine allgemeine Regel: Das jüngste Verhalten kann das erwartete Verhalten nur dann definieren, wenn anormale Zeiträume ausgeschlossen oder geringer gewichtet werden.
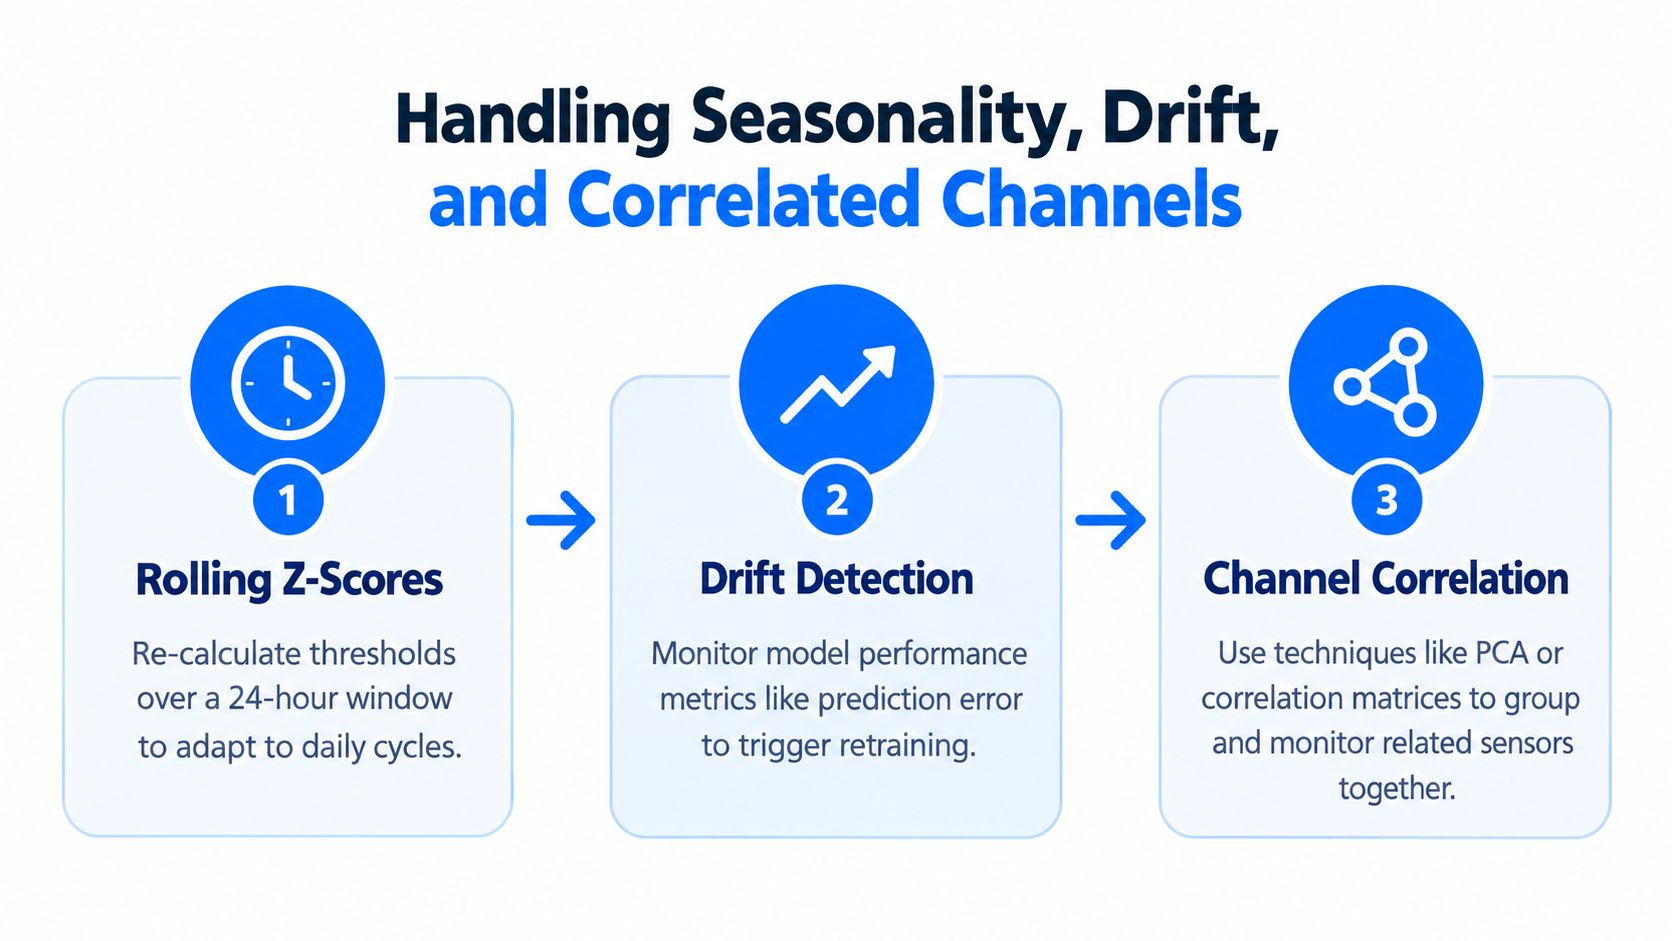
Überwachen Sie die Modell-Drift-Erkennung für Sensor-Baselines mit Modell-Drift-Erkennung für Sensor-Baselines. Analysieren Sie Feature-Verteilungen, Residuen und Alarmeffekte separat. Eine Baseline kann fehlerfrei wirken, selbst wenn sich die Beziehung zwischen einem Sensor und seinen Betriebsbedingungen bereits verändert hat.
Gekoppelte Kanäle berücksichtigen
Temperatur, Vibration und Stromstärke verändern sich oft gemeinsam, da Drehzahl oder Last alle drei Parameter beeinflussen. Eine isolierte Bewertung führt in solchen Fällen zu Alarmen bei völlig legitimen Betriebsänderungen. Korrelierte Kanäle sollten daher stets im Verhältnis zum Betriebskontext und zueinander bewertet werden.
Die Residuenbildung ist ein bewährter erster Schritt. Wenn die Drehzahl einen Großteil der Vibrationsamplitude erklärt, setzen Sie die Vibration in Relation zur Drehzahl und bewerten Sie das Residuum. Die Hauptkomponentenanalyse (PCA) kann korrelierte Kanäle zu latenten Betriebsmustern komprimieren, während Korrelationsmatrizen Gruppen identifizieren können, die in derselben Überwachungsregel zusammengefasst werden sollten. Die Forschung zu stark verrauschten industriellen Datenströmen untersucht zudem hybride Methoden wie die Kombination von PCA mit Autoencodern, wie in dieser Forschung zur Anomalieerkennung bei stark verrauschten Sensoren erörtert.
Entscheidungsregel: Nutzen Sie ein adaptives Zeitfenster, wenn der Prozess stabil bleibt, sich die Baseline jedoch verschiebt. Führen Sie ein neues Training durch, wenn sich die Beziehung zwischen den Eingangsdaten und dem erwarteten Verhalten grundlegend verändert hat oder wenn validierte Vorfälle systematische Fehler aufzeigen.
Berücksichtigen Sie die Latenz bei der Entscheidungsfindung. Ein Mehrkanalmodell, das die geforderte Reaktionszeit überschreitet, ist weniger nützlich als eine einfachere Residuenregel, die kontinuierlich läuft. Verknüpfen Sie Kanalbeziehungen mit Drift-Prüfungen und leiten Sie unklare Fälle zur Überprüfung weiter, anstatt zuzulassen, dass sie unbemerkt in die Baseline einfließen.
Ehrliche Bewertung der Erkennungsleistung
Die reine Genauigkeit ist oft die am wenigsten aussagekräftige Kennzahl bei der Anomalieerkennung. Wenn Fehler selten sind, kann ein Detektor hervorragende Werte erzielen, indem er fast immer „normal“ prognostiziert, dabei aber keinen einzigen relevanten Vorfall erfasst. Auch ohne künstliche Gewichtung ist die praktische Erkenntnis klar: Bewerten Sie die Ereignisse, die für das Bedienpersonal tatsächlich relevant sind, und nicht bloß einzelne Datenzeilen.
Die Präzision zeigt Ihnen, wie viele Alarme berechtigt waren. Der Recall gibt an, wie viele der tatsächlich vorhandenen Anomalien vom Detektor gefunden wurden. Beide Werte sagen jedoch nichts darüber aus, ob das System rechtzeitig reagiert hat. Messen Sie die Verzögerung ab dem tatsächlichen Beginn der Anomalie und nicht erst ab dem Ende eines Berechnungsfensters. Ein verspäteter Alarm kann technisch zwar korrekt, betrieblich jedoch nutzlos sein.
Ereignisbezogene Bewertung nutzen
Ein praxisnahes Evaluierungsset sollte folgende Kriterien umfassen:
Präzision und Recall: Berechnen Sie beide Werte auf Basis gelabelter Zeitfenster, die mit Wartungsprotokollen und dem Betriebskontext abgeglichen wurden.
Erkennungsverzögerung: Messen Sie die verstrichene Zeit vom frühestmöglichen Beginn einer Anomalie bis zum ersten Alarm, der ein Handeln ermöglicht.
Alarmvolumen: Erfassen Sie die Alarme pro Schicht und Anlage, anstatt nur aggregierte Modellmetriken zu betrachten.
Fehlalarm-Belastung: Dokumentieren Sie Fehlalarme pro Bedienerstunde, damit das Ergebnis die tatsächliche Belastung der Mitarbeitenden widerspiegelt.
Analyse verpasster Ereignisse: Untersuchen Sie Anomalien, die das System nicht erkannt hat – insbesondere schleichende Drifts und kanalübergreifende Fehler.
Eine Benchmark-Studie zur funktionalen Anomalieerkennung ergab, dass die Leistung stark vom Typ der Anomalie abhängt und eine simulationsbasierte Bewertung unerlässlich ist, da kein einzelner Detektor für alle Muster gleichermaßen zuverlässig arbeitet. Dieses Ergebnis spricht für eine Testumgebung, die abrupte Spitzen, langsame Anstiege, Pegelverschiebungen, fehlende Daten, korrelierte Änderungen und verrauschte Intervalle umfasst, wie im Benchmark zur funktionalen Anomalieerkennung beschrieben.
Metrik | Was gemessen wird | Schwachstelle bei Sensordaten |
|---|---|---|
Genauigkeit (Accuracy) | Anteil aller korrekten Klassifizierungen | Kann unerkannte, seltene Fehler kaschieren |
Präzision (Precision) | Anteil der Alarme, die echten Anomalien entsprechen | Eine hohe Präzision kann das Resultat zu seltener Alarmierung sein |
Recall (Sensitivität) | Anteil der erkannten tatsächlichen Anomalien | Kann eine übermäßige Alarmierung ohne zeitlichen Kontext begünstigen |
F1-Score | Harmonische Gewichtung von Präzision und Recall | Behandelt jeden Datenpunkt gleich, selbst wenn sich ein Ereignis über viele Punkte erstreckt |
Erkennungsverzögerung | Zeitspanne vom Auftreten der Anomalie bis zum ersten Alarm | Labels dokumentieren oft den Wartungszeitpunkt statt des physischen Beginns |
Alarmvolumen | Die durch das Modell verursachte Arbeitsbelastung im Betrieb | Gesamtsummen können eine einzelne fehlerhafte Anlage oder Schicht maskieren |
Die Fachliteratur liefert eine wichtige Warnung. Der zeitliche Kontext verbesserte die Erkennung auf einem OPC UA-Industriedatensatz um 2,27 % F1, 2,33 % Präzision und 3,02 % Recall, wenn ein sequenzieller Speicher zweiter Ordnung hinzugefügt wurde, wie aus der Industrial IoT-Studie zum sequenziellen Speicher hervorgeht. Eine solche Verbesserung ist jedoch nur dann wertvoll, wenn sie einer anlagenspezifischen Schattenbewertung standhält.
Betreiben Sie das neue Modell im Schattenmodus (Shadow Mode) parallel zu den bestehenden Regeln. Halten Sie die Alarme des neuen Modells in dieser Phase für das Bedienpersonal unsichtbar, vergleichen Sie den Zeitpunkt der Ereignisse und die Arbeitsbelastung mit bekannten Vorfällen und analysieren Sie jede Abweichung gründlich, bevor Sie das Modell offiziell einführen.
Für Unsicherheitsanalysen bei seltenen Ereignissen kann eine Monte-Carlo-Simulation für operative Tests Teams dabei helfen, das Verhalten von Alarmrichtlinien unter variierenden Signalbedingungen zu untersuchen, ohne ein synthetisches Ergebnis voreilig als Beleg für die reale Produktionsleistung zu werten.
Bereitstellungsarchitekturen für Echtzeit-Monitoring
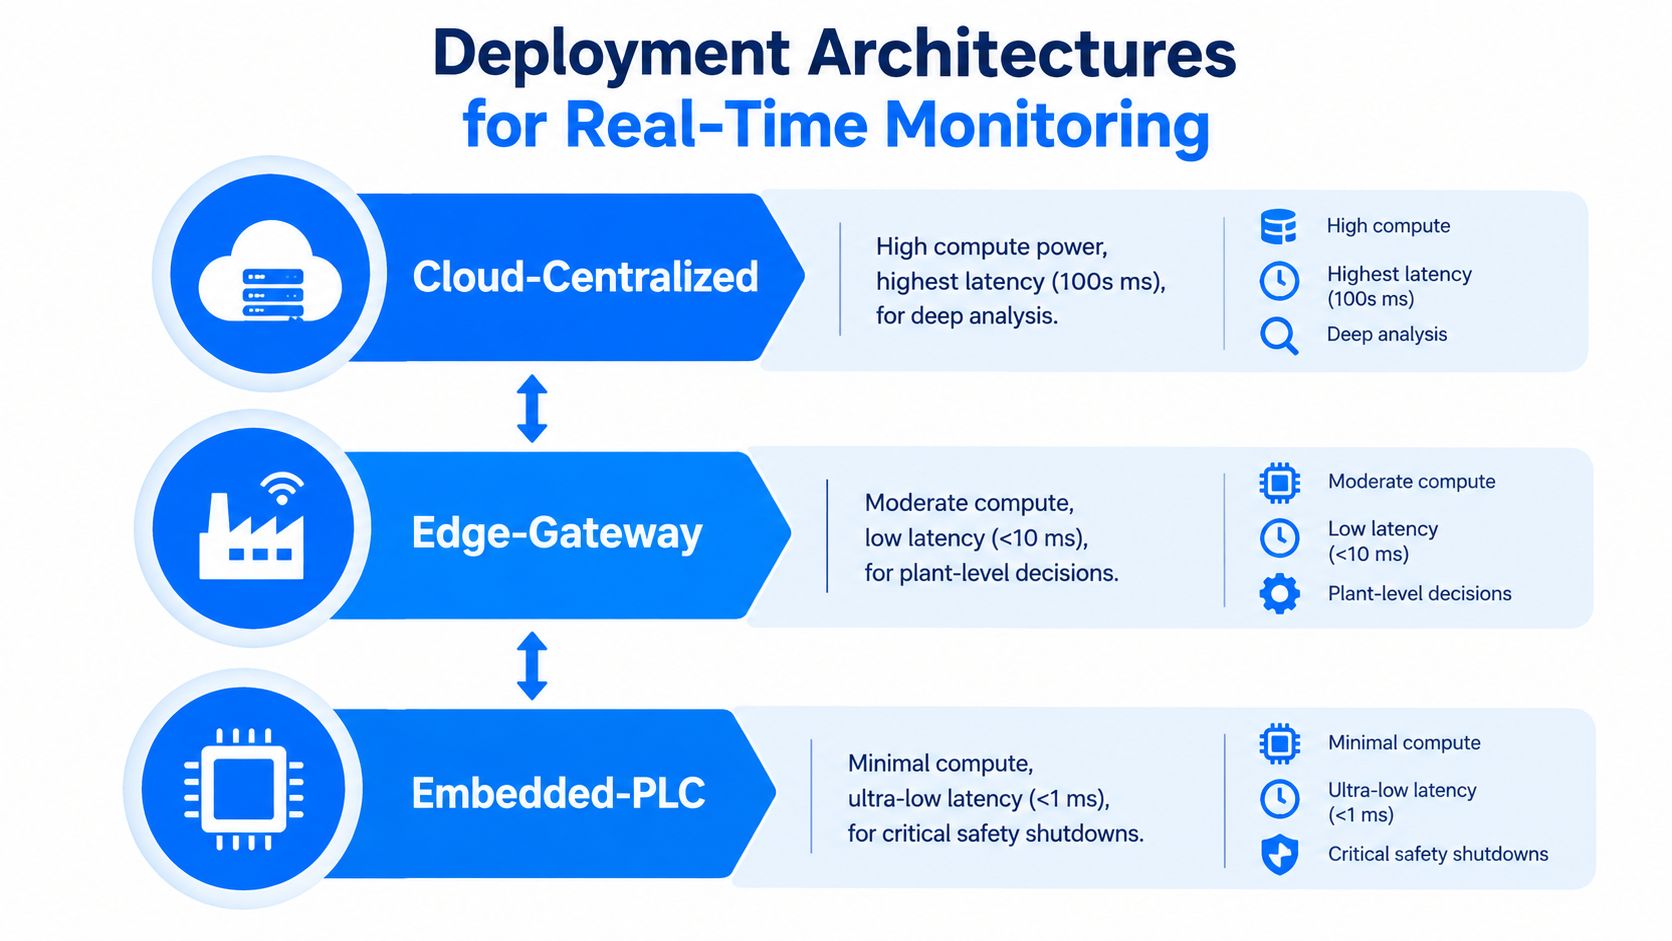
Die Architektur richtet sich nach den Gegebenheiten. Wenn eine Entscheidung direkt an der Maschine getroffen werden muss, verursacht das Senden jedes Rohdatenpunkts an eine entfernte Cloud unnötige Latenz und schafft eine riskante Abhängigkeit von der Netzwerkverfügbarkeit. Wenn dagegen eine flottenweite Trendanalyse gefragt ist, überfordert die Integration eines großen Modells in jede einzelne Steuerung die operativen Kapazitäten.
Das Muster an die Entscheidung anpassen
Eingebettete SPS- oder In-Sensor-Inferenz eignet sich für kritische, lokale Aktionen. Ein kompakter Detektor läuft direkt dort, wo das Signal in das Steuerungssystem eingeht, wodurch Netzwerklatenzen vermieden werden. Die Nachteile sind jedoch stark begrenzte Ressourcen, komplizierte Modell-Updates und strenge Testanforderungen. Nutzen Sie diesen Ansatz für einfache, sicherheitsrelevante Entscheidungen, nicht pauschal für alle analytischen Aufgaben.
Edge-Gateway-Inferenz bietet mehr Spielraum für Feature-Engineering und komplexe Mehrkanalmodelle, während die Daten innerhalb des Werks verbleiben. Ein Gateway kann Daten von lokalen Systemen empfangen, Berechnungsfenster verarbeiten und nur die Ergebnisse oder ausgewählte Features weiterleiten. Dieses Muster empfiehlt sich, wenn Datensicherheit und Ausfallsicherheit wichtiger sind als eine zentralisierte, einfache Struktur.
Cloud- oder zentrale Inferenz bietet die höchste Rechenleistung und erleichtert das flottenweite Re-Training. Sie eignet sich für tiefe Analysen, standortübergreifende Vergleiche und langfristige Modellentwicklungen, setzt jedoch eine stabile Internetverbindung voraus und erhöht das Übertragungsvolumen sensibler Rohdaten.
In-Database-Scoring nicht außer Acht lassen
Für flottenweite Zusammenfassungen und historische Analysen kann das Scoring direkt in einer Zeitreihendatenbank wie TimescaleDB oder InfluxDB das unnötige Streamen jedes einzelnen Datenpunkts in die Cloud reduzieren. Es hält zudem die Feature-Berechnungen nah am Speicherort der Daten und erleichtert Datenökonomen, die ohnehin mit SQL arbeiten, die Untersuchung. Die Einschränkung besteht darin, dass die Verarbeitung direkt in der Datenbank harte Echtzeitanforderungen der Steuerungsebene oft nicht erfüllen kann.
Die Zusammenarbeit zwischen Cloud und Edge wird für industrielle Sensornetzwerke immer praktikabler, da sie die lokale Erkennung von der zentralen Analyse trennt. Forschungsarbeiten zur Cloud-Edge-kollaborativen Anomalieerkennung beschreiben diese Aufteilung als Antwort auf Latenz- und Skalierbarkeitsgrenzen, während neuere, auf Edge-Systeme ausgerichtete Arbeiten den Fokus auf echtzeitfähige und ressourceneffiziente Erkennung legen.
Achten Sie auf eine einheitliche Versionierung der Modelle über alle Standorte hinweg. Dokumentieren Sie bei jedem Alarm die Sensorkonfiguration, die Feature-Definitionen, den Kalibrierungszustand und die Modellversion. Speichern Sie im Falle eines Vorfalls ausreichend Rohdaten für die spätere Fehleranalyse, definieren Sie die Aufbewahrungsfristen jedoch mit Bedacht, da hochfrequente Rohdatenfenster sehr schnell anwachsen können.
Richten Sie Ihre Entscheidung an drei Leitfragen aus: Wie schnell muss die Entscheidung vorliegen, dürfen Rohdaten das Werk verlassen und welche Rechenleistung verträgt das Gerät vor Ort? Die Antwort führt in der Praxis oft zu einer hybriden Bereitstellung: lokales Scoring kombiniert mit zentralisiertem Re-Training und tiefgehender Analyse.
Sicherer Produktivstart
Das beste Modell nützt nichts, wenn die Alarmierungsprozesse in der Praxis nicht akzeptiert werden. Das Bedienpersonal bewertet das System danach, ob Alarme zu einem nützlichen Zeitpunkt eintreffen, ausreichend Kontext bieten und ein echtes, handlungsrelevantes Ereignis verlässlich von normalen Prozessschwankungen unterscheiden können. Die Praxisnähe sollte über den Produktivstart entscheiden, nicht die Komplexität der Systemarchitektur.
Die Checkliste vor dem Start durchgehen
Beginnen Sie mit einer Schattenphase von zwei bis vier Wochen parallel zu den bestehenden Regeln und orientieren Sie sich an dem im Einführungsplan festgelegten Zeitraum, anstatt diesen als universelle Garantie zu betrachten. Reagieren Sie in dieser Phase noch nicht auf die neuen Alarme. Vergleichen Sie diese stattdessen mit Wartungsprotokollen, Notizen des Bedienpersonals, bekannten Eingriffen und dem bisherigen Alarmstrom.

Optimieren Sie anschließend die Empfindlichkeit anhand der gewonnenen Erkenntnisse:
Schattenphase: Analysieren Sie, welche Alarme die Bediener erreicht hätten und ob sie echten, nachvollziehbaren Ereignissen entsprachen.
Schwellenwert-Tuning: Finden Sie die Balance zwischen unentdeckten Ereignissen und der Alarmbelastung anhand realer Betriebsphasen statt simulierter Benchmark-Dateien.
Ausfallkonzept (Fallback): Definieren Sie klare Rollback-Szenarien, manuelle Overrides und sichere Systemzustände für den Fall, dass das Modell, die Feature-Pipeline, das Gateway oder die Datenquelle ausfallen.
Kontinuierliches Monitoring: Überwachen Sie den Drift der Eingangsdaten, die Verfügbarkeit von Features, die Verteilung der Ergebnisse, die Alarmeffekte und die Modellleistung nach dem Produktivstart.
Das Modell-Monitoring benötigt eine direkte Feedbackschleife zu den Vorfällen. Ein Re-Training sollte auf verifizierten, gelabelten Vorfällen und signifikanten Änderungen im Betriebsverhalten basieren, nicht auf einem willkürlich gewählten Kalenderdatum. Wenn ein Sensor ausgetauscht, ein Prozess angepasst oder eine Maschine gewartet wird, dokumentieren Sie diesen Kontext, damit das Modell den Eingriff nicht fälschlicherweise als unerklärte Anomalie interpretiert.
Eskalationswege klar definieren
Kritische Anomalien müssen innerhalb einer definierten maximalen Reaktionszeit direkt an die zuständigen Bereitschaftsingenieure gemeldet werden. Weniger kritische Ereignisse können in eine wöchentliche Überprüfungsliste einfließen, in der Ingenieure Muster analysieren, Labels bestätigen und entscheiden, ob die Baseline oder die Feature-Definitionen angepasst werden müssen. Jeder Alarm sollte Angaben zur betroffenen Anlage, den Zeitstempel, die beteiligten Kanäle, die konkreten Feature-Werte, die Modellversion und einen Link zu den relevanten Rohdaten enthalten.
Der einzig wahre Erfolgsmaßstab ist das Vertrauen der Bediener. Ein Detektor hat sich in der Praxis bewährt, wenn die Verantwortlichen auf seine Alarme reagieren, ohne jede einzelne Meldung anzuzweifeln.
Ein System, das Fehlalarme bei einem theoretischen Benchmark minimiert, das Schichtteam in der Praxis jedoch mit Meldungen überflutet, ist gescheitert. Ein einfacherer Detektor, der die entscheidenden Ereignisse zuverlässig erfasst, seine Ergebnisse nachvollziehbar darstellt und bei Fehlern sicher reagiert, stiftet weitaus mehr Nutzen als ein hochkomplexes Modell, das niemand warten kann. Das Ziel der Anomalieerkennung in Sensordaten besteht nicht darin, isoliert betrachtet beeindruckende Kennzahlen zu liefern. Es geht darum, den Menschen an den Maschinen rechtzeitig fundierte Entscheidungshilfen an die Hand zu geben.
digna unterstützt Teams dabei, anormales Datenverhalten, die Timeliness, Validierungsregeln und strukturelle Veränderungen in ihrer eigenen Umgebung zu überwachen. Dies ergänzt Sensor-Anomalie-Pipelines, die auf verlässliche Eingangsdaten angewiesen sind. Besuchen Sie digna, um zu erfahren, wie Sie mit diesem datenbankintegrierten Observability-Ansatz Datenlücken und unerwartete Abweichungen erkennen können, bevor sie die industrielle Überwachung beeinträchtigen.
Häufig gestellte Fragen
Warum ist Sensor-Anomalieerkennung schwerer als gedacht?
Weil „normal“ ein gelernter Betriebskontext ist und keine feste Zahl. Ein Vibrationssensor an einer Turbine kann stundenlang nahezu flach bleiben, nachdem sich eine Halterung gelöst hat, sodass ein fester Schwellenwert Gesundheit meldet, während sich der mechanische Zustand längst geändert hat.
Welche Produktionsbedingungen brechen ein Sensormodell?
Sechs wiederholen sich: Änderungen des Betriebsregimes durch Last, Drehzahl und Schichtmuster; Sensordrift durch Kalibrierung und Alterung; korrelierte Kanäle, die auf dieselbe Bedingung reagieren; ungleichmäßige Abtastung, die naive Zeilen-Joins irreführend macht; verzögerte Labels aus Wartungsaufzeichnungen; und Latenzgrenzen, wenn eine Sicherheitsentscheidung nah an der Maschine fallen muss.
Wie bereitet man Sensor-Features auf?
Richten Sie die Zeit aus, bevor Sie irgendetwas berechnen. Wählen Sie eine Analysetaktung, die zum Latenzbudget des Detektors passt, resamplen Sie jeden Kanal bewusst und bewahren Sie bei multimodalen Anlagen die ursprünglichen Kanal-Zeitstempel oder Qualitätsflags. Rohe Sensorwerte sind ohne Betriebskontext schwache Eingaben.
Welche Features erfassen welche Fehler?
Passen Sie das Feature an das Muster an. Ein rollierender z-Score misst den Abstand zu einem jüngsten Mittelwert relativ zur jüngsten Streuung, ein längeres Fenster wie 30 Minuten zeigt langsamere Drift, die ein kurzes Fenster als normal aufnimmt, Differenzbildung beantwortet eine andere Frage, und Lag-Features geben klassischen Modellen eine kompakte jüngste Historie.
Warum überlebt Benchmark-Genauigkeit die Produktion nicht?
Weil saubere Datensätze genau die Bedingungen auslassen, die Fehler verursachen: Regimewechsel, Drift, korrelierte Kanäle, ungleichmäßige Abtastung und unsichere Labels. Auch die umgebenden Pipeline-Kontrollen zählen, denn sie trennen eine echte Maschinenanomalie von einem verspäteten, fehlenden, fehlerhaften oder strukturell veränderten Feed.



