S3 als Dateisystem
|
7
min. Lesezeit

Das Einbinden von S3 als Dateisystem ist in der Regel die falsche Standardeinstellung. Teams greifen darauf zurück, weil der Pfad vertraut aussieht, Altsysteme weiterlaufen und das Versprechen, „einfach den Bucket einzubinden“, kostengünstiger klingt als das Umschreiben von Pipelines. Dieser Shortcut verbirgt jedoch eine semantische Diskrepanz, und in der Unternehmensanalytik äußert sich diese Diskrepanz in Form von Latenzspitzen, seltsamem Konsistenzverhalten, unübersichtlicher governance und überraschenden Betriebskosten.
Die sicherere Regel ist einfach: Nutzen Sie S3 als das, was es ist – ein Objektspeicher –, es sei denn, Sie haben eine sehr spezifische Arbeitslast, die Dateisemantiken erfordert. Wenn Sie den Mount als reine Komfortschicht statt als Architekturentscheidung betrachten, werden Sie am Ende die Abstraktion debuggen, anstatt Daten bereitzustellen.
Inhaltsverzeichnis
Warum das Einbinden von S3 als Dateisystem meist die falsche Standardeinstellung ist
Objektspeicher und POSIX-Dateisysteme im Vergleich
Zuweisung von Dateiopoperationen zu S3-Verhalten
Konsistenzverhalten, das Sie nicht ignorieren können
Die Operationen, die immer noch zu Stolpersteinen werden
Mount-Optionen von s3fs und FUSE bis hin zu S3 Files
Vergleichen Sie den Stack, nicht das Marketing
Analytische Arbeitslasten auf einer S3-Dateisystemschicht
Optimieren Sie für die Arbeitslast, die Sie tatsächlich haben
Enterprise-governance und Observability für den S3-Dateizugriff
Prüfen Sie die Objektschicht, nicht nur den Mount
Wann S3 als Dateisystem tatsächlich Sinn macht
Nutzen Sie es, wenn der Kompromiss bewusst eingegangen wird
Warum das Einbinden von S3 als Dateisystem meist die falsche Standardeinstellung ist
Der häufige Fehler besteht in der Annahme, dass ein Bucket, nur weil er wie ein Verzeichnis aussehen kann, sich auch wie eines verhalten sollte. Diese Annahme führt in Teams zu Problemen, da der Mount die Tatsache verschleiert, dass S3 im Kern immer noch ein Objektspeicher ist – mit anderer Performance, Konsistenz und anderem Metadatenverhalten als eine lokale Festplatte oder eine NFS-Freigabe. Der Objektspeicher speichert Ihre Bytes zwar problemlos, übernimmt aber nicht die Garantien, auf die sich Ihre Anwendung verlässt.
In der Produktion fangen dort die Probleme an. Entwickler nutzen Mounts, um alte Skripte am Leben zu erhalten, und stellen dann fest, dass umbenennungsintensive Jobs, gemeinsame Schreibzugriffe und Metadaten-Scans wie eine Übersetzungsschicht und nicht wie ein natives Dateisystem wirken. Das Ergebnis sind oft mehr bewegliche Teile, mehr versteckte Wiederholungsversuche und mehr Stellen, an denen Kosten durch ausufernde Anfragen und Cache-Verwerfungen entstehen.
Praktische Regel: Nur weil eine Arbeitslast einen „Ordner benötigt“, bedeutet das nicht, dass sie ein Dateisystem braucht.
AWS selbst hat S3 auf eine Weise weiterentwickelt, die dies belegt. Seit dem Start am 14. März 2006 mit rund 1 Petabyte Kapazität auf etwa 400 Speicherknoten in 15 Racks und einer Gesamtbandbreite von 15 Gbit/s wuchs S3 bis März 2026 zu einer Plattform heran, die global mehr als 500 Billionen Objekte speichert und mehr als 200 Millionen Anfragen pro Sekunde verarbeitet, verteilt auf 123 Verfügbarkeitszonen in 39 AWS-Regionen (AWS S3 history and scale). Diese Skalierbarkeit macht S3 hervorragend für Objekt-Arbeitslasten, aber sie macht es nicht wie von Zauberhand zu einer POSIX-Festplatte. Wenn Ihre Architektur auf lokalem Dateiverhalten aufbaut, müssen Sie begründen, warum der Mount dort hingehört.
Für Teams, die eine Plattform von Grund auf neu konzipieren, lautet die erste Frage nicht „Können wir es einbinden?“, sondern „Welche Fehleranfälligkeit kaufen wir uns damit ein?“. Wenn Sie eine fundierte Überprüfung des Systemdesigns zu dieser Frage wünschen, ist this data system architecture guide der richtige Ausgangspunkt.
Objektspeicher und POSIX-Dateisysteme im Vergleich
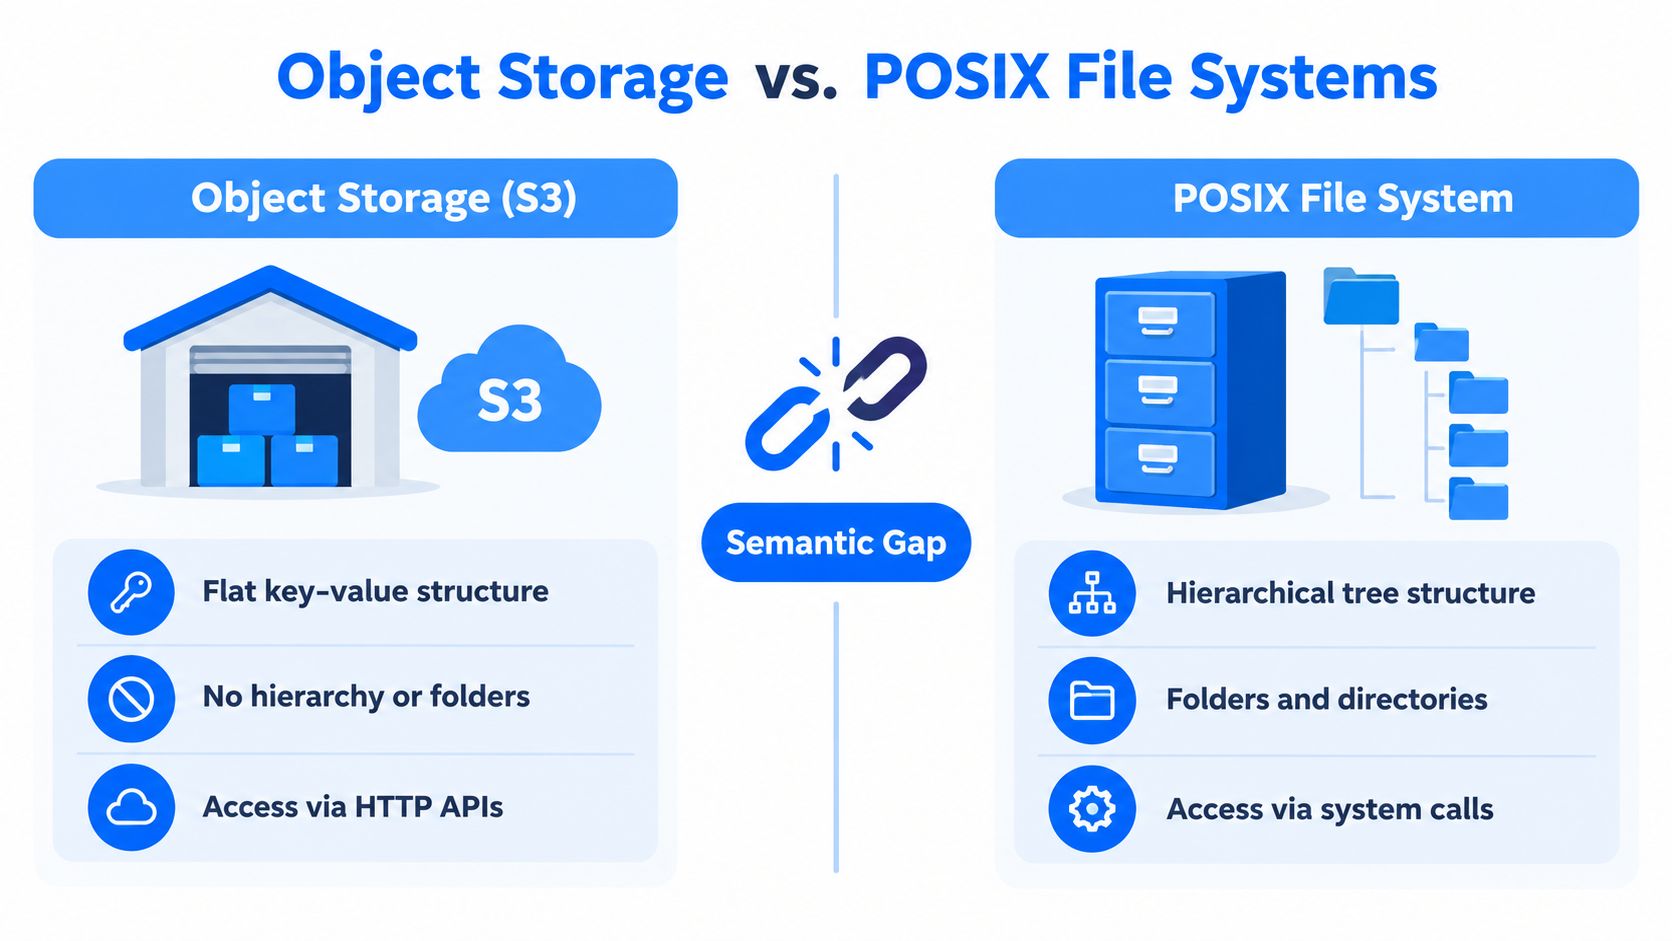
Denken Sie in den Begriffen eines Lagers. Ein Bucket ist eine Lagerhalle, ein Objekt ist eine versiegelte Kiste und der Schlüssel ist das Etikett auf der Kiste. Sie können Kisten verschieben, ersetzen und Etiketten auflisten, aber Sie können eine Kiste nicht öffnen und eine einzelne Seite darin bearbeiten, so wie Sie ein Dokument auf einem Laptop bearbeiten würden. Das ist die semantische Lücke, die jede Mount-Schicht verbergen muss.
Zuweisung von Dateiopoperationen zu S3-Verhalten
Beginnen wir mit open. Unter POSIX ist das Öffnen einer Datei ein normaler Systemaufruf in ein hierarchisches Dateisystem. Unter S3 ist das „Öffnen“ in Wahrheit die Entscheidung des Clients, ein Objekt abzurufen oder einen Schreibpfad über eine Übersetzungsschicht vorzubereiten. Das System kann dafür sorgen, dass es sich vertraut anfühlt, aber der Mechanismus bleibt objektbasiert.
Betrachten wir nun Teilschreibzugriffe (partial write) und Überschreiben (overwrite). In einem Dateisystem können Sie Bytes oft direkt ändern. Bei S3 wird das Objekt ersetzt. Aus diesem Grund können dateiorientierte Workflows, die von inkrementellen Änderungen ausgehen, teuer oder umständlich werden, wenn sie in Objektoperationen übersetzt werden (object-store behavior and overwrite differences). Das Speichermodell verhält sich nicht wie ein veränderbarer Block aus gemeinsam genutztem Speicher.
Schließlich gibt es noch rename und atomic rename. In POSIX sind Umbenennungssemantiken Teil des Dateisystem-Vertrags. In S3 ist das Umbenennen ein Emulationsmuster, meist ein Kopieren plus Löschen oder ein Umschreiben von Metadaten in der Mount-Schicht. Hier treten die Überraschungen auf, da sich das Verschieben eines Verzeichnisses in eine Flut von Objektoperationen statt in eine einzige atomare Aktion verwandeln kann.
Ein Mount kann Namen übersetzen. Er kann keine Semantiken erfinden.
Die einminütige Erklärung für Entscheidungsträger ist ungeschminkt: S3 ist ein flacher Objekt-Namensraum mit einer darüber liegenden dateiähnlichen Darstellung. POSIX ist ein hierarchisches Dateisystem mit nativer Verzeichnis- und Mutationssemantik. Je mehr sich Ihre Arbeitslast auf atomare Änderungen, Sperren und Umbenennungsverhalten stützt, desto mehr muss die Übersetzungsschicht vortäuschen, was das Speicher-Backend nie versprochen hat.
Konsistenzverhalten, das Sie nicht ignorieren können
Die S3-Konsistenz ist der Punkt, an dem viele Dateisystem-Annahmen Risse bekommen. Amazon S3 bietet mittlerweile eine starke Read-after-Write-Konsistenz für GET, PUT und LIST in allen AWS-Regionen, und AWS versichert, dass das, was Sie schreiben, auch das ist, was Sie lesen (S3 consistency model). Dadurch wird eine wichtige Klasse von Überraschungen eliminiert, aber S3 wird dadurch noch lange nicht zu einem POSIX-Dateisystem.
Die Operationen, die immer noch zu Stolpersteinen werden
Probleme können immer noch entstehen, wenn die Anwendung eine Dateisystem-Koordinierung voraussetzt, die nicht existiert. Workflows zum Überschreiben, verzeichnisartige Umbenennungsmuster und metadatenintensive Zugriffspfade hängen immer noch von der Mount-Schicht ab, um Synchronisierungs- oder Caching-Verhalten hinzuzufügen, das S3 selbst nicht bietet. Wenn Teams dies ignorieren, kommt es schließlich zu veralteten Lesevorgängen, Race Conditions oder Split-Brain-Szenarien in Workflows mit mehreren Clients – insbesondere, wenn mehrere Schreiber denselben Namensraum berühren.
Das Risiko ist nicht theoretisch. Ein Job schreibt Daten, ein zweiter Job listet denselben Präfix auf, und beide Jobs glauben, denselben logischen Pfad zu besitzen. Wenn die Pipeline eine atomare Verzeichnisersetzung oder Dateisperren erwartet, muss die Abstraktion die Koordinierung über der Objektsemantik bereitstellen, und diese Koordinierung wird zu einer weiteren Fehlerquelle.
Operation | POSIX-Verhalten | S3-Verhalten | Risiko für Dateisystem-Benutzer |
|---|---|---|---|
Erstellen und Lesen | Natives Erstellen der Datei, gefolgt von sofortigem Lesen | Stark konsistent für neue Objekte | Geringeres Risiko, aber das Mount-Verhalten ist weiterhin wichtig |
Überschreiben | Semantik der In-Place-Dateiaktualisierung | Semantik des Objektersatzes | Leser erhalten möglicherweise kein dateiähnliches Aktualisierungsverhalten |
Verzeichnis umbenennen | Atomar wirkende Verschiebung im Namensraum | Emuliert durch Objektoperationen oder Metadatenschicht | Verwaiste Schlüssel, unvollständige Verschiebungen, versteckte Wiederholungsversuche |
Verzeichnis auflisten | Native Verzeichnis-Metadaten | Präfixbasierte Auflistung von Objektschlüsseln | Große Auflistungen können langsam und betrieblich unruhig werden |
AWS S3 Files liefert ein weiteres Signal dafür, dass die Abstraktion Grenzen hat. Die Dokumentation weist explizite Quotas wie 25.000 Verbindungen pro Dateisystem und 10.000 Zugriffspunkte pro Dateisystem aus – eine Erinnerung daran, dass der Mount nicht dasselbe ist wie eine lokale Festplatte (S3 Files limits and behavior). Planen Sie mit diesen Limits, anstatt sie wegzuwünschen.
Für Pipeline-Teams ist es am sichersten, jeden konsistenzsensiblen Workflow über einen klaren Verantwortlichen und einen expliziten Validierungsschritt zu leiten. Wenn Sie eine praktische Checkliste für diese Art von Abweichungsprüfung benötigen, nutzen Sie data consistency checks als Modell dafür, wie Sie über das Problem nachdenken sollten.
Mount-Optionen von s3fs und FUSE bis hin zu S3 Files
Nicht jeder S3-Mount ist gleich aufgebaut. Einige Optionen existieren, um Altsysteme am Leben zu erhalten, andere, um den betrieblichen Aufwand zu verringern, und wieder andere lassen sich besser als Zugriffsschichten denn als echte Dateisysteme beschreiben. Die richtige Wahl hängt davon ab, ob Sie Lesezugriff, Write-Through-Verhalten, gemeinsame Mutationen oder eine sauberere Methode zur Versorgung von Analytics-Engines benötigen, die bereits nativ mit Objektspeichern kommunizieren.
Vergleichen Sie den Stack, nicht das Marketing
s3fs und ähnliche FUSE-basierte Mounts sind meist die erste Anlaufstelle für Teams, die eine schnelle Kompatibilitätsbrücke benötigen. Sie sind praktisch, fügen aber eine zusätzliche Prozessebene, zusätzliche Latenz und mehr Raum für Engpässe hinzu, wenn ein einzelner Knoten zum Nadelöhr wird. Für eine leichte interaktive Nutzung oder als Migrationsgerüst können sie in Ordnung sein, aber sie sind eine schlechte Standardeinstellung für hochfrequentierte Enterprise-Pipelines.
Goofys und Mountpoint for S3 gehören zur selben großen Familie von Kompatibilitätsschichten. Sie können bestimmte Zugriffsmuster verbessern, beseitigen jedoch immer noch nicht die semantische Diskrepanz zwischen Objektspeicher und Dateisemantik. Nutzen Sie sie, wenn das primäre Ziel lautet: „Sorge dafür, dass dieses Tool jetzt läuft“, und nicht „Baue die Plattform dauerhaft darauf auf“.
Das neuere S3 Files von AWS verfolgt einen anderen Ansatz. AWS positioniert es als gemeinsam genutztes Dateisystem für EC2, Lambda, EKS und ECS, mit NFS 4.1- und 4.2-Zugriff sowie bidirektionaler Synchronisierung zwischen dem eingebundenen Dateisystem und dem Bucket (S3 Files behavior and regions). Das macht es nativer als ein einfaches FUSE-Shim, aber es ist immer noch keine POSIX-Festplatte. Der Design-Kompromiss eignet sich besser für den gemeinsamen Zugriff als für wahlfreie Schreibzugriffe im Datenbankstil.
Native Objektspeicher-APIs sind die sauberste Lösung, wenn Ihre Engine diese bereits unterstützt. Spark, Trino und DuckDB erzielen eine bessere Parallelisierung und eine sauberere Skalierung, wenn sie direkt mit S3 kommunizieren, anstatt über einen Mount zu gehen, der versucht, Verzeichnisse zu imitieren. Wenn das Tool bereits weiß, wie man parallele Auflistungen, vektorisierte Lesevorgänge oder Predicate Pushdown durchführt, zwingen Sie es nicht in ein Dateikorsett.
Option | Stack | Schreibunterstützung | Durchsatz-Obergrenze | Beste Eignung |
|---|---|---|---|---|
s3fs | FUSE-basierter Client | Eingeschränkt, kompatibilitätsorientiert | Oft durch den Client-Knoten limitiert | Altsysteme und kurzlebige Migrationsarbeiten |
Andere FUSE-Mounts | Kompatibilitätsschicht | Variiert je nach Implementierung | Hängt vom Übersetzungsoverhead ab | Leseintensive Zugriffe mit geringer Parallelität |
S3 Files | AWS-verwaltete Dateisystemschnittstelle über S3 | Bidirektionale Synchronisierung | Besser für gemeinsamen Zugriff, dennoch nicht POSIX-nativ | Gemeinsam genutzte Compute-Ressourcen und dateiorientierte Zusammenarbeit |
Native Objekt-APIs | Direkte S3-SDK- oder Engine-Integration | Vollständige Objektsemantik | Skaliert mit der Parallelität des Objektspeichers | Spark, Trino, DuckDB und moderne Analytik |
Die Empfehlung ist eindeutig: Nutzen Sie schreibgeschützte Mounts, wenn Sie alte Tools beibehalten müssen. Nutzen Sie Write-Through-Mounts nur mit expliziten Wiederholungsversuchen, Ownership-Regeln und Rollback-Pfaden. Bevorzugen Sie native Objekt-APIs, wann immer das Tool diese unterstützt, da dies der Pfad ist, der für die Analytik sauber skaliert. Wenn Sie einen breiteren Blickwinkel auf das Pipeline-Design werfen möchten, ist der ETL data pipeline guide der Rahmen, den Ihr Plattform-Team nutzen sollte, bevor es einen Mount genehmigt.
Analytische Arbeitslasten auf einer S3-Dateisystemschicht
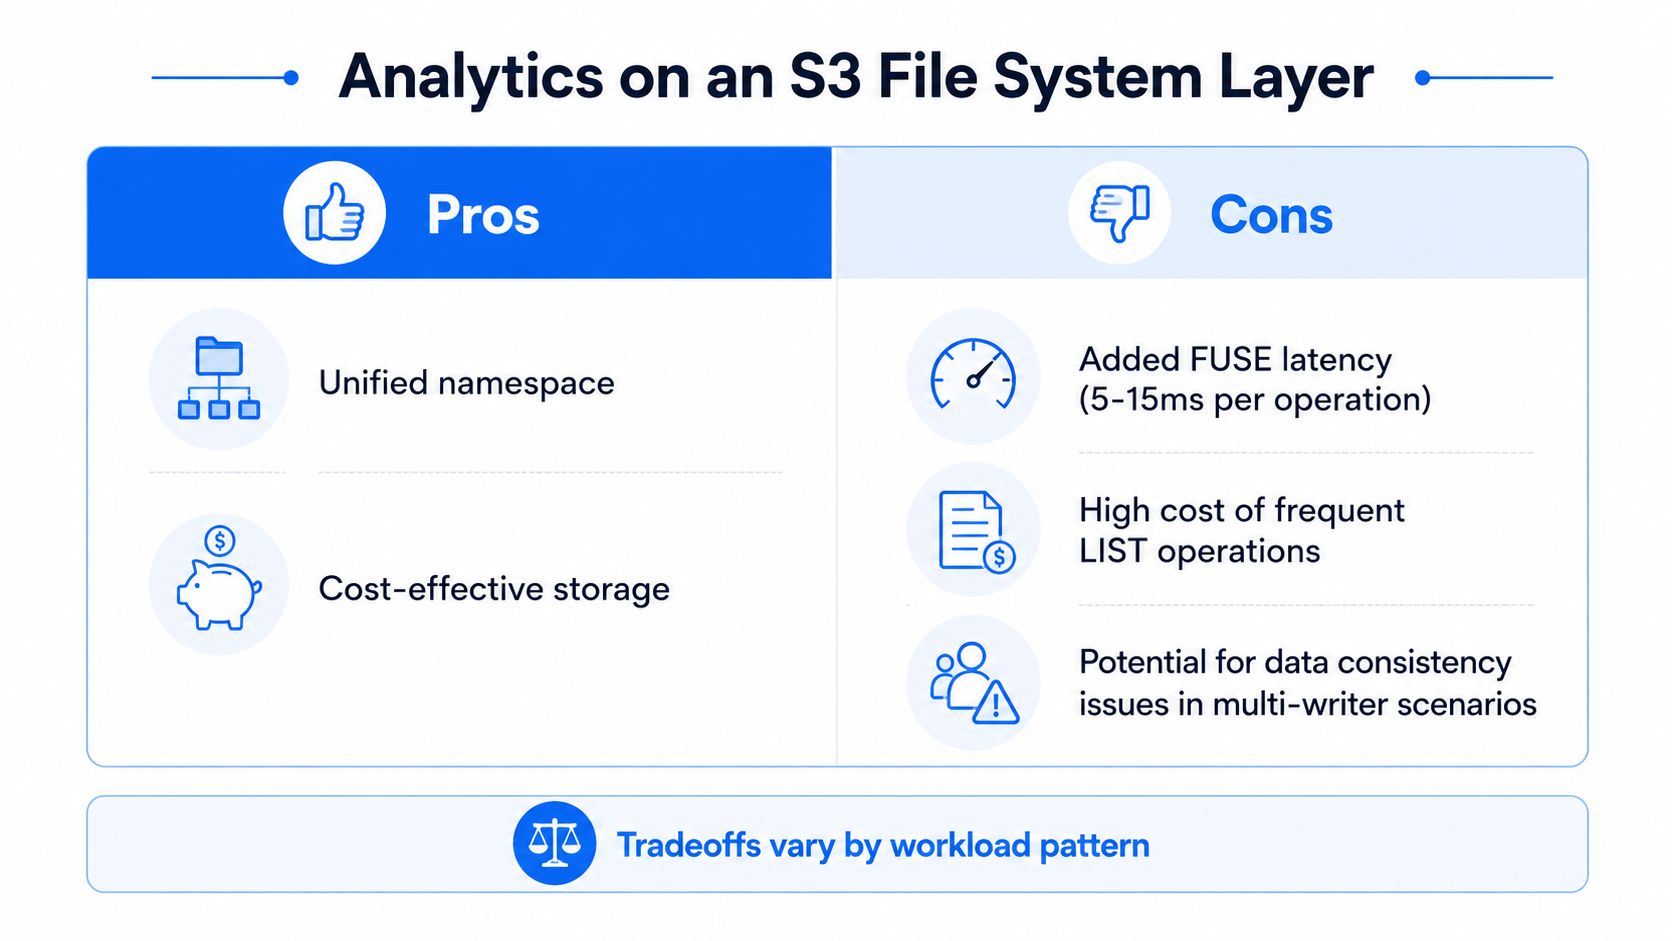
Analytische Arbeitslasten legen die Schwachstellen schnell offen, da sie sowohl mit Bytes als auch mit Metadaten arbeiten. Spark- und Hive-Jobs können gestaffelte Lesevorgänge tolerieren, wenn das Zugriffsmuster weitgehend sequenziell ist. Sobald die Arbeitslast jedoch anfängt, Verzeichnisse zu scannen, Partitionen umzubenennen oder viele kleine Dateien zu erzeugen, wird die Mount-Schicht sowohl zeitlich als auch in Bezug auf die Control-Plane-Kommunikation teuer. Trino und DuckDB schneiden meist besser ab, wenn sie direkt mit S3 sprechen können, da sie so eine Dateilabstraktion umgehen, die nie für Metadaten mit hoher Fluktuation gebaut wurde.
Optimieren Sie für die Arbeitslast, die Sie tatsächlich haben
Wenn der Job batchorientiert ist, kann das Bereitstellen von Daten über S3 immer noch sinnvoll sein, sofern das Lesemuster vorhersehbar ist und die Ausgabe einmalig geschrieben wird. Konzentrieren Sie sich in diesem Fall darauf, unnötige Verzeichnis-Scans zu reduzieren, und lassen Sie die Engine größere Blöcke lesen, anstatt so zu tun, als ob jede Zeile einen unabhängigen Dateizugriff verdient. Tools, die Read-Ahead, parallele GET-Bereiche oder Predicate Pushdown unterstützen, übertreffen in der Regel einen generischen Mount, da sie näher an der Objektsemantik bleiben.
Der andere kritische Punkt sind kleine Dateien. Eine Dateisystemschicht lässt die Flut an kleinen Dateien harmlos aussehen, bis Auflistungen und Metadatenoperationen den Job dominieren. Umbenennungsintensive Tabellenschreibvorgänge werden ebenfalls zum Problem, da der Mount ein Verhalten emulieren muss, das der Objektspeicher nativ nicht bietet. Hier spielen Tabellenformate wie Iceberg und Hudi ihre Stärken aus, da sie ihre eigenen Konsistenz- und Metadatenschichten kodieren, anstatt sich auf Verzeichnistricks zu verlassen.
Praktische Regel: Wenn Ihr Datenlayout auf Umbenennungen als Commit-Mechanismus beruht, lösen Sie ein Problem des Tabellenformats mit Speicher-Tricks.
Auch die Kostenfrage spielt eine Rolle. Häufige LIST-Operationen auf großen Buckets sind ein Anti-Pattern für Mount-basierte Analysen, da jede dateiorientierte Bequemlichkeit in zusätzliche Anfragen und Latenzen umschlagen kann. Aus diesem Grund ist ein direkter S3-Pfad meist die bessere Wahl für große Unternehmensdatensätze – insbesondere, wenn das Plattform-Team bereits ein Monitoring für Abfragemuster, Dateianzahl und Objektfluktuation eingerichtet hat.
Für Teams, die diese Kompromisse messbar machen müssen, ist die betriebliche Sicht ebenso wichtig wie die Query-Engine. Das passende Monitoring-Muster gehört in ein data lake monitoring, nicht in ein einmaliges Mount-Skript.
Enterprise-governance und Observability für den S3-Dateizugriff
Sobald S3 als Dateisystem bereitgestellt wird, muss die governance den Daten folgen und nicht der Illusion von Ordnern. IAM-Grenzen sind weiterhin auf Bucket- oder Präfix-Ebene wichtig, KMS-Verschlüsselung im Ruhezustand (at rest) bleibt essenziell, und VPC-Endpunkt-Richtlinien sind weiterhin wichtig, wenn Sie versehentliche öffentliche Abflüsse verhindern wollen. Der Dateipfad mag für Benutzer vertraut aussehen, aber die darunter liegende Control Plane ist immer noch Objektspeicher. Daher muss Ihr Richtlinienmodell der Objektsemantik entsprechen.
Prüfen Sie die Objektschicht, nicht nur den Mount
Dateisystem-Audit-Logs reichen hier nicht aus. Der Mount kann Operationen auf Objektebene vor Personen verbergen, die nur auf POSIX-Traces schauen. Das bedeutet, dass das Sicherheitsteam S3-Zugriffsprotokolle, CloudTrail-Datenereignisse und Speichertelemetrie in derselben Monitoring-Pipeline benötigt. Andernfalls können Ihnen Abweichungen, veraltete Mounts, kompromittierte Anmeldedaten auf Bastion-Hosts und GET-Muster entgehen, die für den Datei-Client normal, für einen Incident Responder jedoch verdächtig aussehen.
Auch die Datenklassifizierung wird schwieriger. Ein Dateipfad in einem eingebundenen Namensraum lässt sich nicht eins zu eins auf eine ACL oder eine Objektrichtlinie abbilden. Teams benötigen daher explizite Regeln dafür, wer was sehen darf und wo diese Regeln durchgesetzt werden. Wenn derselbe Bucket von mehreren Tools verwendet wird, benötigen Sie zudem Ownership-Konventionen, um uneindeutige Schreibpfade und versehentliche Namensraum-Kollisionen zu vermeiden.
AWS S3 Files bringt hier eine besonders nützliche Betriebsregel mit. Wenn dasselbe Element sowohl im Dateisystem als auch direkt im Bucket geändert wird, behandelt AWS den Bucket als Source of Truth, verschiebt die kollidierende Datei in ein Lost-and-Found-Verzeichnis und empfiehlt, entweder das Dateisystem oder S3 als primären Schreiber festzulegen (S3 Files best practices). Das ist ebenso eine governance-Richtlinie wie ein technisches Detail, da es Teams zwingt, eine Source of Truth zu bestimmen, bevor Chaos entsteht.
Für Enterprise-Datenplattformen besteht die Aufgabe in der kontinuierlichen Überwachung dieser Schicht. Wenn ein Mount abweicht, Zugangsdaten durchsickern oder eine Arbeitslast GET-Anfragen in einer Weise generiert, die nicht zum erwarteten Muster passt, sollte das Plattform-Team dies vor den Fachabteilungen bemerken. Genau diese Art von Transparenz soll eine Plattform für data observability liefern.
Wann S3 als Dateisystem tatsächlich Sinn macht
Nutzen Sie S3 nur dann als Dateisystem, wenn die Arbeitslast diese Abstraktion auch rechtfertigt. Eine kurzlebige Zwischenspeicherung (staging) für einen einzelnen Batch-Job ist in Ordnung. Alte, an POSIX gebundene Tools, die innerhalb des Projektzeitplans nicht umgeschrieben werden können, sind ebenfalls in Ordnung. Weitgehend lesende Analysen auf Parquet oder Tabellenformaten, die ihre eigenen Metadaten bereits selbst verwalten, sind ebenfalls in Ordnung – insbesondere, wenn das Ziel darin besteht, doppelte Kopien und unnötige Datenverschiebungen zu vermeiden.
Nutzen Sie es, wenn der Kompromiss bewusst eingegangen wird
Was definitiv nicht auf einen S3-basierten Mount gehört, ist eine Datenbank mit wahlfreien Schreibzugriffen, ein hochfrequentierter, gemeinsam genutzter Arbeitsbereich oder eine Microservice-Architektur, die den Mount so nutzt, als wäre er eine gemeinsam genutzte Festplatte mit geringer Latenz. Diese Systeme benötigen stärkere Dateisemantiken, als ein Objektspeicher über eine Übersetzungsschicht liefern kann, und sie neigen dazu, genau dort zu scheitern, wo Nebenläufigkeit (concurrency) und Mutationen am wichtigsten sind.
Das saubere Entscheidungsmuster besteht darin, die geplante Arbeitslast anhand von sechs Fragen zu bewerten:
Schreibhäufigkeit: Wenn Schreibvorgänge häufig und klein sind, nehmen Sie Abstand davon.
Auflistungsmuster: Wenn die App ständig Verzeichnisse durchläuft, nehmen Sie Abstand davon.
Latenztoleranz: Wenn ein paar zusätzliche Roundtrips den Workflow unterbrechen, nehmen Sie Abstand davon.
Kostengrenze: Wenn das Wachstum der Anfragen wichtiger ist als die Speicherkosten, nehmen Sie Abstand davon.
Sicherheitskonzept: Wenn die Durchsetzung von Richtlinien allein von der Pfadsemantik abhängt, nehmen Sie Abstand davon.
Rollback-Pfad: Wenn Sie nicht auf direkte S3-APIs oder einen anderen Speicher ausweichen können, fangen Sie gar nicht erst an.
Die ehrliche Empfehlung ist einfach: Nutzen Sie den Mount, wenn Kompatibilität das Ziel ist und die Arbeitslast eng eingegrenzt bleibt. Vermeiden Sie ihn, wenn gemeinsame Mutationen, komplexe Nebenläufigkeit oder datenbankähnliches Verhalten gefordert sind. S3 ist ein hervorragendes Primitiv für Datenplattformen, aber ein Dateisystem-Wrapper macht daraus kein universell einsetzbares NAS.

Wenn Ihr Team vor der Entscheidung steht, S3 als Mount bereitzustellen, kann digna Ihnen helfen, die Datenschicht transparent zu halten – mit einer Observability, die Timeliness, Schemaänderungen, Anomalien und das Plattformverhalten in Ihrer eigenen Umgebung überwacht. Besuchen Sie digna, um zu sehen, wie seine Data Observability-Plattform Ihnen helfen kann, die nachgelagerten Auswirkungen solcher Architekturentscheidungen zu überwachen, bevor ein Mount zu einem Vorfall in der Produktion wird.
Häufig gestellte Fragen
Sollte man S3 als Dateisystem einhängen?
Meist nicht. Das Einhängen ist die falsche Voreinstellung, weil es verdeckt, dass darunter weiterhin ein Objektspeicher liegt, mit anderem Verhalten bei Performance, Konsistenz und Metadaten als bei lokaler Platte oder NFS-Freigabe. Nutzen Sie S3 als Objektspeicher, sofern nicht eine eng umrissene Last echte Dateisemantik braucht.
Warum verhält sich ein Bucket, der wie ein Verzeichnis aussieht, nicht wie eines?
Weil das Verzeichnisbild eine Emulation ist. Der häufige Fehler ist die Annahme, ein Bucket müsse sich wie ein Ordner verhalten, nur weil er so aussehen kann, und genau dort beginnt im Produktivbetrieb der Schmerz.
Wie bilden sich POSIX-Dateioperationen auf S3 ab?
Unvollständig. Öffnen ist in Wahrheit eine Client-Entscheidung, ein Objekt zu holen oder über eine Übersetzungsschicht einen Schreibpfad vorzubereiten, Teilschreibvorgänge und Überschreiben ersetzen das gesamte Objekt, und Umbenennen ist ein Emulationsmuster, meist Kopieren plus Löschen oder ein Metadaten-Rewrite in der Mount-Schicht.
Welche Frage sollte „können wir es mounten?“ ersetzen?
„Welchen Fehlermodus kaufen wir ein?“ Wenn eine Last nur einen Ordner braucht, heißt das nicht, dass sie ein Dateisystem braucht, und wer die Fehlermodusfrage zuerst beantwortet, entfernt den Mount meist ganz aus dem Entwurf.
Wie stark ist S3 seit dem Start gewachsen?
Von rund 1 Petabyte über etwa 400 Speicherknoten in 15 Racks mit 15 Gbit/s Gesamtbandbreite beim Start am 14. März 2006 auf über 500 Billionen Objekte und mehr als 200 Millionen Anfragen pro Sekunde weltweit im März 2026, verteilt auf 123 Availability Zones in 39 AWS-Regionen.



