Parquet File Viewer: das richtige Tool auswählen
|
7
min. Lesezeit

Wahrscheinlich hat Ihnen schon einmal jemand eine .parquet-Datei per Slack, E-Mail oder in einem Cloud Bucket geschickt, und Sie brauchten schnell eine Antwort. Welche Spalten enthält sie? Passt das Schema zum Export von gestern? Enthält die Datei echte Zeilen oder ist sie nur ein weiteres Artefakt einer kaputten Pipeline?
Genau dann merkt man, dass Parquet kein Tabellenformat mit schönerer Dateiendung ist. Es ist effizient, kompakt und in erster Linie für Maschinen gebaut. Wer es auf die falsche Art inspiziert, verschwendet entweder Zeit im Kampf mit dem Tooling oder schafft ein vermeidbares Sicherheitsproblem, weil sensible Daten in die falsche Umgebung wandern.
Inhaltsverzeichnis
Warum Parquet-Dateien spezialisierte Viewer brauchen
Ein normaler Texteditor hilft bei einer Parquet-Datei kaum weiter. Sie bekommen keine lesbaren Zeilen und Spalten, sondern einen binären Blob mit gerade so vielen erkennbaren Fragmenten, dass er Ihre Zeit verschwendet.
Das ist Absicht. Apache Parquet entstand 2013 als gemeinsames Projekt von Twitter und Cloudera, wurde erstmals am 1. Juli 2013 veröffentlicht und später zu einem Top-Level-Projekt der Apache Foundation. Das Format basiert auf spaltenorientierter Speicherung, Row Groups und Thrift-basierten Metadaten, und genau deshalb kann ein normaler Textviewer nichts damit anfangen (Hintergrund zum Parquet-Format).
Was in der Praxis schiefgeht
Ein typisches Szenario aus dem Produktivbetrieb sieht so aus:
Ein Analyst erhält einen Dateiexport von einem Lieferanten.
Ein Data Engineer muss prüfen, ob sich das Schema verändert hat.
Ein Plattformteam muss kontrollieren, ob verschachtelte Felder so kodiert sind, wie es die nachgelagerten Jobs erwarten.
Jemand versucht, die Datei in einem Texteditor oder einem generischen Dateibrowser zu öffnen, und kommt nicht weiter.
Spätestens hier ist ein Parquet File Viewer kein Komfort mehr, sondern grundlegendes Tooling. Seine Aufgabe ist nicht nur, Zeilen anzuzeigen. Er muss ein Speicherformat, das für effiziente Analysen optimiert wurde, in etwas übersetzen, das Menschen sicher und schnell prüfen können.
Wenn Sie eine kurze Auffrischung zum Format selbst brauchen, ist diese Erklärung, was Parquet ist, eine gute Ergänzung, bevor Sie sich für einen Viewer entscheiden.
Warum generische Dateiviewer scheitern
Das Fehlerbild ist vorhersehbar. Generische Viewer gehen davon aus, dass eine Datei entweder zeilenorientierter Text, ein einfacher binärer Container oder ein Dokument mit passendem Renderer ist. Parquet ist nichts davon.
Ein guter Viewer versteht unter anderem:
Schema-Extraktion aus den Metadaten der Datei
Column Projection, damit er nur die Felder anzeigt, die Sie interessieren
Verschachtelte Strukturen, einschließlich Arrays und Nullable-Werten
Speicherbewusste Vorschauen statt eines vorgetäuschten „Datei öffnen“-Verhaltens, das versucht, alles zu laden
Faustregel: Wenn ein Tool eine Parquet-Datei wie eine CSV mit anderer Endung behandelt, ist es das falsche Tool.
Die versteckte Anforderung
Verbreitet ist die Annahme, man brauche einen Viewer, weil Parquet nicht menschenlesbar ist. Das stimmt, greift aber zu kurz. Die eigentliche Anforderung ist, dass die Inspektion von Parquet formatbewusste Logik benötigt.
Sie öffnen nicht einfach eine Datei. Sie befragen eine Speicherstruktur. Das bedeutet: Das beste Tool hängt davon ab, was Sie prüfen müssen, also Zeilen, Schema, Row Groups, Statistiken, Encoding-Verhalten oder Metadaten auf Dateiebene. Der richtige Viewer liefert diese Antworten, ohne einen vollständigen Scan oder unnötige Datenbewegung zu erzwingen.
Die interne Struktur von Parquet verstehen
Der Unterschied zwischen einem schnellen und einem schwerfälligen Parquet File Viewer beginnt beim Dateilayout. Wer dieses Layout nicht versteht, kann schwer beurteilen, ob ein Tool effizient ist oder nur teure Lesevorgänge hinter einer Oberfläche versteckt.
Parquet organisiert Daten als Datei → Row Groups → Column Chunks → Pages. Innerhalb einer Row Group werden die Column Chunks direkt hintereinander geschrieben, und die Page ist die kleinste Einheit, die kodiert und komprimiert wird (Layout der Parquet Data Pages).

Was ein Viewer Ihnen wirklich zeigt
Wenn ein Viewer Row Groups und Column Chunks anzeigt, ist das kein Zusatzfeature für Power-User. Er legt damit das Speichermodell offen.
Das ist im Produktivbetrieb wichtig, weil eine Tabellenvorschau täuschen kann. Eine generische Vorschau zeigt vielleicht zehn Zeilen und lässt die Datei trivial wirken, während die tatsächliche Datei viele Row Groups, ungleich große Chunks, verschachtelte Spalten und Metadaten-Entscheidungen enthält, die beeinflussen, wie nachgelagerte Engines sie lesen.
Für Teams, die mit sich ändernden Data Contracts arbeiten, hilft das Verständnis des Dateilayouts auch beim Nachverfolgen der Schema-Evolution. Ein passendes Begleitthema ist Schema-Typen und der Umgang mit Änderungen, denn die Dateiinspektion wird deutlich einfacher, wenn Ihr Team bereits weiß, nach welchem strukturellen Drift es suchen muss.
Warum der Footer wichtig ist
Parquet speichert entscheidende Metadaten in einem Footer am Ende der Datei. Reader springen in der Regel zu den letzten 8 Bytes, um die Länge des Footers und die abschließenden PAR1-Magic-Bytes zu finden, bevor sie Schema, Row Groups und Spaltenstatistiken parsen (Überblick über das Apache-Parquet-Format).
Dieses eine Detail erklärt viel darüber, warum sich manche Viewer sofort anfühlen und andere nicht. Ein intelligenter Viewer liest die Datei nicht von oben und streamt alles in den Speicher. Er springt ans Ende, parst die Metadaten und entscheidet dann, was er als Nächstes liest.
Ein Parquet Viewer, der mit dem Footer beginnt, kann viele strukturelle Fragen beantworten, bevor er den Großteil des Datensatzes überhaupt anfasst.
Verschachtelte und Nullable-Felder sind keine kosmetischen Details
Die Interna von Parquet erklären auch, warum verschachtelte Spalten in schwachen Tools seltsam dargestellt werden. Ein Column Chunk kann höchstens eine Dictionary Page enthalten, und wenn es eine gibt, muss sie die erste Page im Chunk sein. Die Data Pages enthalten dann Repetition Levels, Definition Levels und kodierte Werte in genau dieser Reihenfolge (Interna der Parquet Column Chunks).
Das ist kein Detailwissen für Trivia-Runden. Es bestimmt, was ein Viewer dekodieren muss, um Arrays, Structs und Nullwerte korrekt darzustellen. Wenn ein Tool alles schlecht flach klopft, ist das oft ein Zeichen, dass es Komplexität versteckt, statt das Format richtig zu verarbeiten.
Worauf Sie bei einem strukturbewussten Viewer achten sollten
Ein Viewer lohnt sich in der Regel, wenn er diese Elemente klar darstellen kann:
Viewer-Funktion | Warum sie wichtig ist |
|---|---|
Schema-Browser | Hilft beim Prüfen von Spaltennamen, Typen und verschachtelter Struktur |
Row-Group-Ansicht | Zeigt, wie die Daten horizontal partitioniert sind |
Details zu Column Chunks | Macht die Speichergrenzen pro Spalte sichtbar |
Page- oder Encoding-Metadaten | Nützlich beim Debuggen von verschachtelten Feldern, Nullability oder Komprimierungsproblemen |
Wenn ein Tool nur „Zeilenvorschau“ bietet, kann das für einen schnellen Check trotzdem reichen. Es reicht aber nicht, wenn Sie Pipeline-Verhalten diagnostizieren, Lieferantenexporte validieren oder verstehen wollen, warum eine Query Engine ganz anders performt als eine andere.
Die wichtigsten Methoden für Parquet File Viewer im Vergleich
Es gibt nicht den einen besten Parquet File Viewer. Es gibt fünf gängige Ansätze, und jeder löst ein anderes Problem. Im Produktivbetrieb besteht der Fehler nicht darin, ein schwaches Produkt zu wählen, sondern die falsche Tool-Klasse für die Aufgabe zu verwenden.
Kommandozeilen-Tools
Wenn Sie schnell lokal prüfen wollen, sind Kommandozeilen-Tools oft der direkteste Weg. parquet-tools ist das klassische Beispiel.
Sie eignen sich gut, um ein Schema auszugeben, Metadaten zu prüfen oder Datensätze zu sampeln, ohne eine IDE zu öffnen. Außerdem passen sie gut in Shell-Workflows und das Debugging in der CI.
Der Kompromiss liegt in der Benutzerfreundlichkeit. Kommandozeilen-Tools sind effizient für Engineers und abweisend für alle anderen. Außerdem erschweren sie die gemeinsame Inspektion, sofern die Ausgabe nicht bewusst festgehalten und geteilt wird.
Python-Bibliotheken
Für Data Engineers sind PyArrow und pandas oft der flexibelste Weg. Sie können das Schema prüfen, ausgewählte Spalten laden, schnelle Filter anwenden und die Inspektion mit Ad-hoc-Validierungslogik kombinieren.
Genau diese Flexibilität macht sie zum Standard. Und genau deshalb werden sie auch leicht falsch eingesetzt.
Ein Notebook oder Skript driftet gern von „kurzer Inspektion“ zu „versehentlich zu viele Daten in den Speicher geladen“. Und sobald lokales Scripting gegen Produktionsextrakte zur Normalität wird, verschwimmen die Sicherheitsgrenzen. Wenn Ihr Team ohnehin breitere Inspektions- und Monitoring-Praktiken evaluiert, lohnt sich ein Vergleich von Kategorien von Data-Profiling-Software parallel zu Dateiviewern.
Spark und verteilte Engines
Spark ist kein Viewer im üblichen Sinn, aber Teams nutzen es ständig so. Wenn die Datei in einer Lakehouse-Umgebung liegt und Sie bereits Zugriff auf einen Cluster haben, kann das Lesen über Spark die betrieblich konsistenteste Option sein.
Am besten funktioniert das, wenn das Ziel die Inspektion innerhalb einer bestehenden Plattform ist und nicht das einmalige Öffnen einer Datei. Spark verarbeitet große Datensätze und Remote Storage ganz selbstverständlich. Der Preis dafür sind ein hoher Einrichtungsaufwand, langsameres Feedback bei einfachen Aufgaben und zu viel Infrastruktur für schlichte „Was steckt in dieser Datei?“-Fragen.
Wenn Sie einen Cluster brauchen, um eine Frage zu beantworten, die ein Footer-bewusstes Tool lokal beantworten könnte, ist Ihr Inspektionsweg zu schwergewichtig.
VS-Code-Erweiterungen und Desktop-Viewer
Diese sind nützlich für Engineers, die eine visuelle Oberfläche wollen, ohne ihren lokalen Workflow zu verlassen. Sie sind meist einfacher als CLI-Tools und leichter als das Hochfahren von Notebooks oder Spark-Sessions.
Das Problem ist die schwankende Qualität. Manche Erweiterungen bieten nur oberflächliche Vorschauen. Andere zeigen Row Groups, Statistiken oder Encoding-Details überhaupt nicht an. Für eine einfache Inspektion kann das genügen. Für das Debugging im Produktivbetrieb oft nicht.
Desktop-Tools sind außerdem nur so sicher wie die Workstation, auf der sie laufen. Das ist relevant, wenn die Datei regulierte oder vertrauliche Daten enthält.
Online-Parquet-Viewer
Online-Viewer sind attraktiv, weil sie den Einrichtungsaufwand eliminieren. Website öffnen, Datei hochladen, Inhalt prüfen.
Dieser Komfort muss sorgfältig abgewogen werden. Manche Teams können sie für nicht sensible Stichproben sicher nutzen. Viele Teams dürfen sie aus Governance-Gründen überhaupt nicht verwenden.
Ein aktueller Viewer beschreibt ein besseres Modell. Nach eigenen Angaben kann er lokale oder entfernte Parquet-Dateien öffnen, sie an Ort und Stelle über HTTP Range Requests lesen und nur die Bytes abrufen, die für die aktuelle Ansicht nötig sind. So lassen sich Dateien mit mehreren Gigabyte in Sekunden öffnen, während die Daten lokal auf dem Rechner des Nutzers bleiben (Produktbeschreibung des Parquet Viewer). Das ist eine deutliche Verbesserung gegenüber naiven Upload-and-Process-Designs.
Eine praktische Entscheidungstabelle
Methode | Am besten für | Was funktioniert | Was nicht funktioniert |
|---|---|---|---|
CLI-Tools | Engineers mit schnellen lokalen Checks | Schnelle Prüfung von Schema und Metadaten | Schlechte UX für nicht technische Nutzer |
PyArrow oder pandas | Ad-hoc-Analysen im Engineering | Flexibel, skriptbar, leicht erweiterbar | Schnell werden zu viele Daten gelesen oder unordentliche lokale Workflows entstehen |
Spark | Plattform-native Inspektion im großen Maßstab | Passt zu großen Data-Lake-Umgebungen | Zu viel Overhead für einfache Checks |
VS Code oder Desktop-Viewer | Leichtgewichtige visuelle Inspektion | Bequeme lokale Oberfläche | Funktionsumfang variiert stark |
Online-Viewer | Schneller Zugriff ohne Einrichtung | Bequem für schnelle Erkundung | Bedenken bei Datenschutz, Governance und Datenbewegung |
Die besten Teams legen sich nicht auf eine Methode für jeden Fall fest. Sie legen fest, wann welche Methode erlaubt ist, wer sie nutzt und welche Art von Daten damit geprüft werden darf.
Parquet-Dateien sicher inspizieren
Sichere Inspektion beginnt, bevor Sie auf „Öffnen“ klicken. Die erste Frage ist nicht, welchen Viewer Sie mögen. Sie lautet, ob sich die Datei prüfen lässt, ohne mehr Daten als nötig zu kopieren und ohne sie in die falsche Umgebung zu verschieben.
Parquet verschafft Ihnen hier einen Vorteil. Ein Viewer kann den I/O erheblich reduzieren, indem er die Footer-Metadaten der Datei nutzt. Da Parquet die Metadaten am Ende der Datei speichert, einschließlich der Positionen von Row Groups und Column Chunks, kann ein Viewer zuerst den Footer parsen und dann nur die benötigten Row Groups oder Spalten lesen, statt den gesamten Datensatz zu scannen. Dieses Layout ermöglicht auch selektive Inspektion und Predicate Pushdown, da Row Groups die wichtigste Einheit der horizontalen Partitionierung sind und jede Row Group genau einen Column Chunk pro Spalte enthält (Metadatenverhalten im Parquet-Dateiformat).
Mit der Struktur beginnen, nicht mit den Zeilen
Die sicherste Reihenfolge ist:
Zuerst die Metadaten öffnen. Schema, Row Groups und Informationen auf Dateiebene ansehen, bevor Sie Datensätze in der Vorschau anzeigen.
Nur benötigte Spalten projizieren. Wenn Sie ein Feld validieren, laden Sie nicht zwanzig.
Selektive Filter nutzen, wo verfügbar. So kann der Viewer irrelevante Gruppen oder Chunks überspringen.
Kleine Ausschnitte in der Vorschau ansehen. Eine Stichprobe reicht meist, um Formatierung oder den Umgang mit Nullwerten zu bestätigen.
Nur dann vollständig lesen, wenn die Aufgabe es erfordert.
Das klingt selbstverständlich, doch viele Teams prüfen Dateien immer noch, indem sie sie komplett in Notebooks laden. Bei winzigen, nicht sensiblen Entwicklungsstichproben ist das in Ordnung. In geteilten oder regulierten Umgebungen ist es eine schlechte Angewohnheit.
Die Methode an die Umgebung anpassen
Dieselbe Datei verdient je nach Speicherort eine andere Behandlung.
Lokale Entwicklungsdatei: Ein CLI-Tool oder lokaler Viewer ist meist in Ordnung, wenn der Datensatz nicht sensibel und der Zugriff kontrolliert ist.
Export aus dem Object Storage: Bevorzugen Sie ein Tool, das remote prüfen und selektiv lesen kann, statt einen vollständigen Download zu erzwingen.
Produktive oder regulierte Daten: Halten Sie die Inspektion innerhalb freigegebener Infrastruktur und begrenzen Sie, wer echte Datensätze in der Vorschau sehen darf.
Gemeinsamer Debugging-Workflow: Halten Sie zuerst die Erkenntnisse zu Schema und Metadaten fest. Viele Incidents lassen sich lösen, ohne Rohwerte offenzulegen.
Ein großer Teil des Schutzes von Kundendaten besteht darin, unnötige Datenbewegung zu vermeiden. Das ist dasselbe Prinzip, das Teams auch in umfassenderen Praktiken zum Schutz von Kundendaten anwenden.
Sicherheitscheck: Wenn Ihr Inspektions-Workflow standardmäßig verlangt, rohe Produktionsextrakte auf persönliche Rechner herunterzuladen, liegt das Problem nicht im Dateiformat. Es liegt im Prozess.
Footer-only-Inspektion nutzen, wenn die Frage strukturell ist
Nicht jede Inspektionsaufgabe braucht überhaupt Datensätze. Manchmal müssen Sie nur Schema, Row-Group-Layout, Key-Value-Metadaten oder grundlegende Statistiken bestätigen.
Deshalb ist die Footer-bewusste Inspektion eine so praktische Trennlinie. Apache Doris stellt dieses Muster direkt über seine Table-Valued Function PARQUET_META bereit, die Parquet-Footer-Metadaten lesen kann, ohne Data Pages zu scannen, und Schema, Row-Group-Statistiken, Metadaten auf Dateiebene, Key-Value-Metadaten, Ergebnisse von Bloom-Filter-Abfragen und sogar versions- oder verschlüsselungsbezogene Metadaten liefert (Referenz zu Apache Doris PARQUET_META).
Das ist ein nützlicher Plausibilitätscheck für jede Viewer-Evaluierung. Wenn eine Datenbankfunktion Ihre Frage allein aus Metadaten beantworten kann, sollte auch ein Dateiviewer keinen vollständigen Datenlesevorgang brauchen.
Ein Workflow, der sich im Produktivbetrieb bewährt
Wenn Teams sicher mit Parquet umgehen, sieht ihr Prozess meist so aus:
Triage zuerst mit Metadaten
Werte nur für die minimal erforderlichen Spalten prüfen
Keine Zwischenkopien exportieren
Schema-Abweichungen getrennt von Anomalien auf Werteebene dokumentieren
Bei sensiblen Datensätzen die Inspektion innerhalb der Plattform bevorzugen
Das ist kein Overengineering. Es verhindert, dass Debugging versehentlich zur Datenexfiltration wird.
Die Performance des Viewers optimieren
Die Geschwindigkeit eines Viewers hängt nicht nur von der Anwendung ab. Oft ist sie ein Nebenprodukt davon, wie die Parquet-Datei ursprünglich geschrieben wurde.
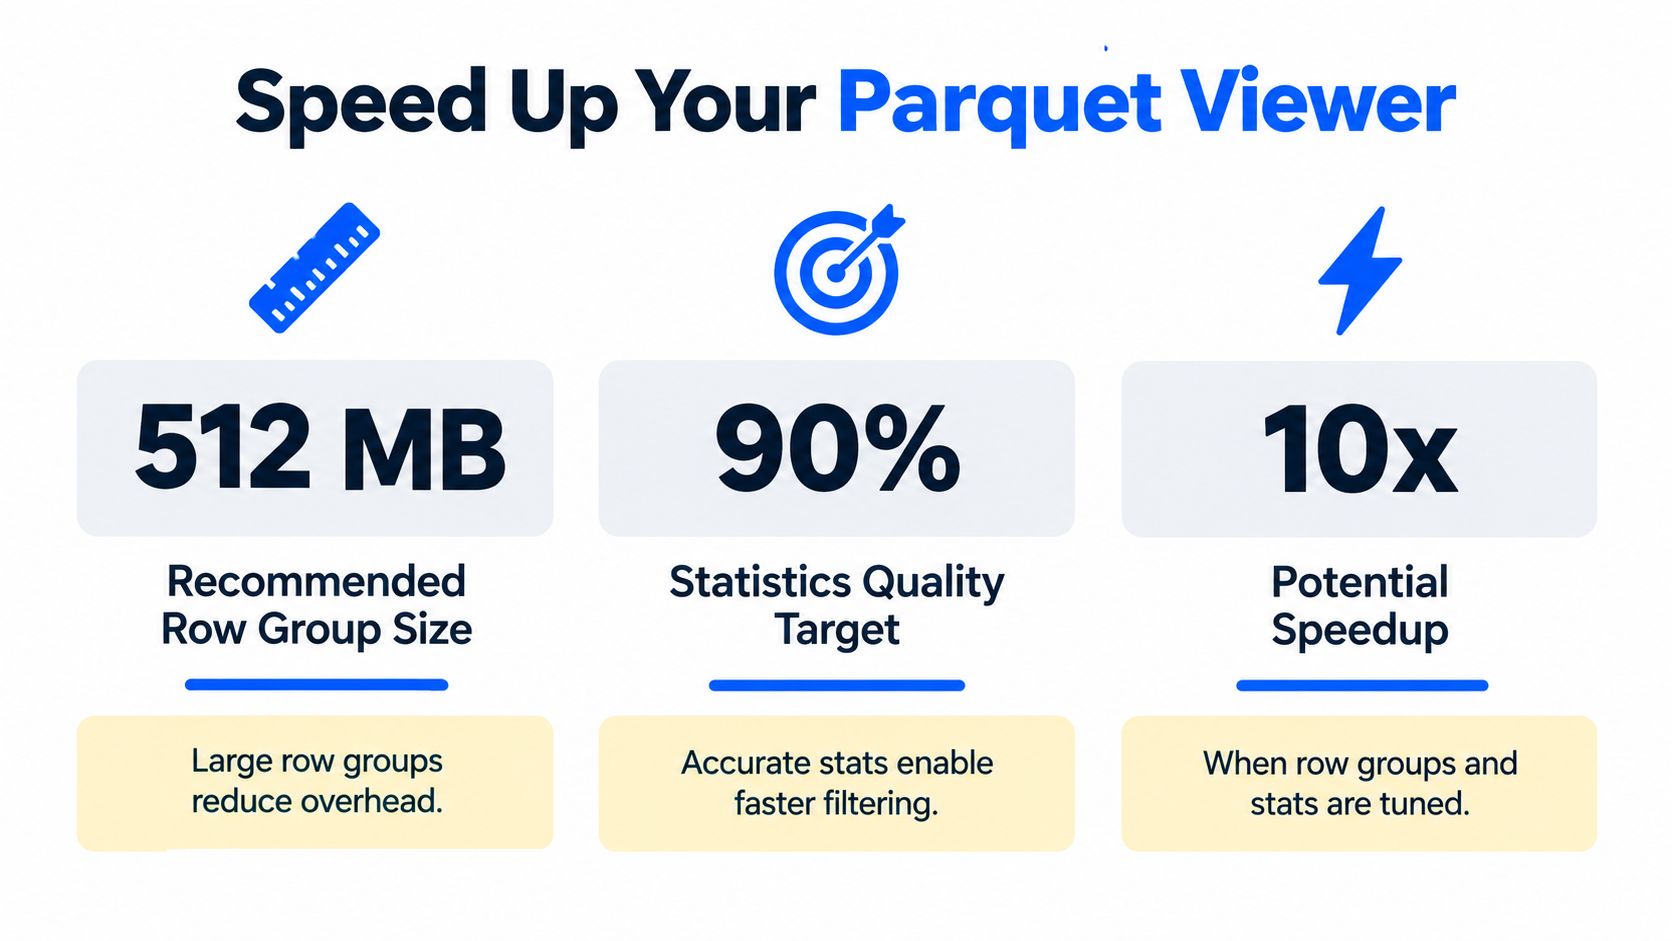
Apache Parquet empfiehlt für optimierte Lesevorgänge große Row Groups von etwa 512 MB bis 1 GB, weil eine ganze Row Group oft die kleinste Einheit ist, die gelesen werden muss. Sind Row Groups zu klein, steigt der Metadaten-Overhead und die Scan-Effizienz sinkt. Größere Gruppen verbessern sequenziellen Zugriff und parallele Verarbeitung. Gleichzeitig ermöglichen Row-Group-Statistiken wie Minimal- und Maximalwerte pro Spalte einem Viewer oder einer Query Engine, irrelevante Chunks zu überspringen, was vor allem bei breiten Tabellen und selektiven Filtern zählt (Konfigurationsempfehlungen für Parquet).
Was die Performance tatsächlich verbessert
Wenn sich ein Parquet File Viewer reaktionsschnell anfühlen soll, achten Sie auf den Schreibpfad genauso wie auf den Lesepfad.
Row Groups sollten bewusst dimensioniert werden. Dateien mit fragmentierten Row Groups lassen sich schwerer effizient prüfen.
Statistiken müssen verlässlich sein. Schwache oder fehlende Statistiken mindern den Wert der selektiven Inspektion.
Breite Schemas brauchen Disziplin. Je mehr Spalten Sie mitführen, desto wichtiger wird Projection.
Verschachtelte Daten müssen sorgfältig getestet werden. Ein Viewer öffnet die Datei vielleicht schnell, braucht aber trotzdem Zeit, um komplexe Strukturen zu dekodieren.
Warum das über die Dateiinspektion hinaus wichtig ist
Schnelle Inspektion ist ein Symptom für gutes Speicherdesign. Langsame, umständliche Inspektion deutet oft auf größere Probleme der Datenplattform hin: inkonsistente Writer-Einstellungen, schwache Schema-Governance oder mangelnde Observability bei der Dateierzeugung.
Deshalb sehe ich das Anzeigen von Parquet-Dateien als mehr als ein Komfortfeature. Oft ist es die erste Stelle, an der Engineers bemerken, dass Dateien so erzeugt werden, dass auch die nachgelagerte Query-Performance leidet. Dieselben Gewohnheiten, die Menschen helfen, Daten effizient zu prüfen, helfen auch Engines, sie effizient zu scannen. Dazu gehören sinnvolle Dateigrößen, gute Statistiken und klare Schemas.
Wenn auch Ihre SQL-Workloads schwächeln, überschneiden sich die Prinzipien der Query-Optimierung oft mit dem, was Sie bei der Parquet-Inspektion entdecken.
Enterprise-Sicherheit und In-Place-Alternativen
In regulierten Umgebungen ist die Hauptfrage meist nicht, ob ein Parquet File Viewer bequem ist. Sondern ob seine Nutzung erfordert, Daten aus freigegebenen Grenzen herauszubewegen.
Hier müssen Teams strikt sein. In den Bereichen Finanzen, Gesundheitswesen, Telekommunikation und öffentlicher Sektor dürfen Analysten oder Engineers oft keine sensiblen Extrakte in externe Dienste hochladen oder lokale Kopien über Laptops verteilen. Selbst wenn der Viewer an sich gut ist, kann der Workflow gegen Governance-Vorgaben verstoßen.
Ein In-Place-Modell ist sicherer, weil Inspektion und Monitoring in der eigenen Umgebung des Kunden bleiben. In der Praxis heißt das: Teams prüfen Strukturen, validieren Datensätze und überwachen Schema-Änderungen, ohne die zugrunde liegenden Daten an Drittsysteme zu exportieren. Außerdem sollte die Rechenleistung nah an den Daten laufen, idealerweise in der Datenbank, damit Teams keine unnötige Datenbewegung verursachen, nur um betriebliche Fragen zu beantworten.
Für die tägliche Engineering-Arbeit verändert das das Ziel. Statt zu fragen „Welcher Viewer soll diese Datei öffnen?“, fragen Teams: „Können wir diese Frage beantworten, ohne die Datei überhaupt zu bewegen?“ Das ist der bessere Standard für den Enterprise-Betrieb.
Wenn Ihr Team diesen In-Place-Ansatz braucht, bietet digna eine Enterprise-Plattform für Datenqualität und Data Observability, die in Ihrer eigenen Umgebung läuft. Sie hilft Teams, Schema-Änderungen nachzuverfolgen, Datensätze zu validieren, das Verhalten von Daten zu überwachen und Analysen nah an den Daten zu halten, und genau das ist das sicherere Muster, wenn die Parquet-Inspektion sensible Produktionsdatensätze berührt.
Den Footer von Hand zu öffnen beantwortet, ob sich das Schema in einer Datei geändert hat. Um hinzugefügte, entfernte oder umtypisierte Spalten über alle Tabellen hinweg automatisch zu erkennen, überwacht der Schema Tracker von digna strukturelle Änderungen in Ihrer eigenen Umgebung, sodass die Daten sie nie verlassen müssen.
Häufig gestellte Fragen
Wie öffne ich eine Parquet-Datei?
Verwenden Sie ein formatbewusstes Tool statt eines Texteditors, denn Parquet ist ein binäres, spaltenorientiertes Format mit Thrift-basierten Metadaten. Zur Auswahl stehen parquet-tools auf der Kommandozeile, PyArrow oder pandas in Python, Spark, VS-Code-Erweiterungen und Online-Viewer, die jeweils zu einer anderen Inspektionsaufgabe und Sensibilitätsstufe der Daten passen.
Warum kann ich eine Parquet-Datei nicht in einem Texteditor öffnen?
Ein Texteditor zeigt nur einen binären Blob, weil Parquet Daten als Row Groups, Column Chunks und komprimierte Pages speichert und das Schema in einem Footer am Ende der Datei liegt. Zum Lesen muss dieser Footer geparst werden, der über die letzten 8 Bytes und die abschließenden PAR1-Magic-Bytes gefunden wird.
Ist es sicher, einen Online-Parquet-Viewer zu verwenden?
Das hängt von den Daten ab. Viewer nach dem Upload-and-Process-Prinzip können für nicht sensible Stichproben akzeptabel sein, aber viele Teams in Finanzwesen, Gesundheitswesen, Telekommunikation und öffentlichem Sektor dürfen sie aus Governance-Gründen nicht nutzen. Viewer, die Dateien an Ort und Stelle über HTTP Range Requests lesen und die Daten lokal halten, sind das sicherere Design.
Kann ich ein Parquet-Schema prüfen, ohne die Daten zu lesen?
Ja, denn Schema, Positionen der Row Groups und Spaltenstatistiken liegen im Footer der Datei. Footer-bewusste Tools parsen zuerst diese Metadaten, und Apache Doris bietet mit PARQUET_META eine Table-Valued Function, die Schema, Row-Group-Statistiken und Key-Value-Metadaten liefert, ohne eine einzige Data Page zu scannen.
Warum ist mein Parquet Viewer bei großen Dateien langsam?
Die Langsamkeit liegt oft daran, wie die Datei geschrieben wurde, und nicht am Viewer selbst. Apache Parquet empfiehlt Row Groups von etwa 512 MB bis 1 GB, da eine ganze Row Group oft die kleinste Leseeinheit ist. Fragmentierte Row Groups, fehlende Statistiken und sehr breite Schemas verlangsamen die Inspektion.



