On-Premises-Datenqualitätstool für Enterprise-Teams erklärt
|
8
min. Lesezeit

Ein Dashboard kann grün sein, während die Daten dahinter bereits fehlerhaft sind. Ein geplanter Ladevorgang verzögert sich, ein Quellsystem fügt eine Spalte hinzu oder eine Kundenverteilung verschiebt sich, ohne dass ein Pipeline-Fehler ausgelöst wird. Die Berichte werden weiterhin aktualisiert, die Jobs werden weiterhin als erfolgreich angezeigt und das Unternehmen entdeckt das Problem erst, wenn ein Analyst ein unerwartetes Ergebnis hinterfragt.
Dieses Fehlermuster ist in großen Infrastrukturen üblich, da Daten heutzutage Warehouses, Lakes, Legacy-Datenbanken, private Netzwerke und Cloud-Dienste durchlaufen. Eine Qualitätsprüfung, die nur eine Plattform überwacht, kann den Punkt übersehen, an dem eine Änderung in die Infrastruktur gelangt ist. Ein Enterprise-Leitfaden dazu, warum Datenprobleme weiterhin Konflikte verursachen verdeutlicht das umfassendere Problem, aber die Frage der Bereitstellung bleibt praxisnah: Wo sollte das Monitoring laufen und wie sollte es über Vertrauensgrenzen hinweg funktionieren?
Ein On-Prem-Datenqualitätstool ist daher mehr als nur eine Hosting-Entscheidung. Es kann ein Betriebsmodell definieren, bei dem Prüfungen nahe an sensiblen Daten ausgeführt werden, Teams die Kontrolle über die Infrastruktur behalten und Ingenieure dennoch eine einheitliche Sicht auf verteilte Systeme erhalten. Die richtige Evaluierung beginnt mit der Fehlererkennung und führt über Sicherheit, hybride Integration und betriebliche Eigenverantwortung bis hin zu den Gesamtbetriebskosten.
Am Ende werden Sie entscheiden können, ob eine On-Premises-Ausführung für Ihre Infrastruktur geeignet ist, welche Funktionen in einem Pilotprojekt getestet werden sollten, wie Sie das Modell mit SaaS vergleichen und wie Sie einen ROI-Case erstellen, der sowohl vermiedene Nacharbeit als auch die Verantwortlichkeiten berücksichtigt, die Ihr Team übernehmen wird.
Inhaltsverzeichnis
Einführung: Warum Datenqualität im Unternehmen unbemerkt scheitert
Was ein On-Prem-Datenqualitätstool wirklich ist
Beginnen Sie dort, wo die Berechnung stattfindet
Trennen Sie Bereitstellung von Zusammenarbeit
Verstehen Sie die Governance-Grenze
On-Prem- vs. SaaS-Datenqualitätstools im Vergleich
Richten Sie die Entscheidung an der Infrastruktur aus
Wesentliche Funktionen, die jedes On-Prem-Tool enthalten sollte
Aktualität und Volumen
Verteilung und Anomalieerkennung
Schema- und Strukturprüfungen
Datensatzvalidierung und Geschäftslogik
Bereitstellungssicherheit und Betriebsmodell für hybride Infrastrukturen
Validieren Sie die Bereitstellungsgrenze
Agieren Sie über Vertrauensgrenzen hinweg
Branchen-Anwendungsfälle: ROI und betriebliche Auswirkungen
Messen Sie betriebliche Auswirkungen, keine Eitelkeitsmetriken
Die Time-to-Value benötigt einen echten Test
So evaluieren und wählen Sie das richtige On-Prem-Datenqualitätstool aus
Einführung: Warum Datenqualität im Unternehmen unbemerkt scheitert
Ein Datenplattform-Ingenieur stellt fest, dass die nächtliche Pipeline erfolgreich abgeschlossen wurde. Der Warehouse-Job weist keinen Fehlerstatus auf, die Aktualisierung des Dashboards wurde abgeschlossen und der BI-Service ist verfügbar. Später stellt ein Governance-Verantwortlicher fest, dass der neueste Bericht einen unvollständigen Ladevorgang verwendet, während ein Analytics-Ingenieur entdeckt, dass sich der Typ einer Quellspalte geändert hat, was das nachgelagerte Verhalten beeinflusst.
Keines dieser Ereignisse muss zwangsläufig zu einem harten technischen Fehler führen. Eine verspätete Datei kann gültige Datensätze enthalten. Eine Tabelle kann auch nach einer Änderung ihrer Verteilung abfragbar bleiben. Eine Schemaänderung kann die Erfassung durchlaufen, während sie Annahmen in einer Transformation oder einem Modell verletzt. Betrieblicher Erfolg und Datenqualität sind unterschiedliche Signale.
Diese Unterscheidung ist besonders in Infrastrukturen von Bedeutung, in denen sensible Systeme On-Premises verbleiben, während Analytics- und KI-Workloads in privaten oder öffentlichen Cloud-Umgebungen ausgeführt werden. Regulierte Branchen wie Behörden, Finanzdienstleistungen und das Gesundheitswesen benötigen häufig Datenresidenz, strenge Sicherheitskontrollen oder Kompatibilität mit Legacy-Systemen. Eine Marktschätzung beziffert On-Premises-Bereitstellungen auf 37,5 % des weltweiten Datenqualitätsmarktes im Jahr 2025 oder rund 1,8 Milliarden US-Dollar, mit einem prognostizierten Wachstum unter dem der Cloud bei einer jährlichen Wachstumsrate (CAGR) von 13,8 % bis 2034 (MarketIntelos Datenqualitätsmarkt-Schätzung). Die installierte Basis verschwindet nicht, nur weil Cloud-Plattformen expandieren.
Praktische Regel: Behandeln Sie Datenqualität als ein Monitoring-Problem in der gesamten Infrastruktur und nicht als einen Test, der an eine einzelne Pipeline gekoppelt ist.
Ein On-Premises-Ansatz wird dann nützlich, wenn die Monitoring-Ebene den Speicherort der Daten respektieren muss. Anstatt sensible Datensätze in einen externen Dienst zu kopieren, kann die Plattform Metriken innerhalb der vom Kunden kontrollierten Infrastruktur berechnen und kontrollierte Metadaten, Vorfälle und Trends an die Personen weitergeben, die sie benötigen.
Dieser Leitfaden baut die Entscheidung schrittweise auf. Er beginnt mit dem Ausführungsmodell, vergleicht die Kompromisse von On-Premises und SaaS, identifiziert die Funktionen, die verschiedene Fehlermuster erkennen, und untersucht anschließend die hybride Sicherheit, die Branchenauswirkungen und die Kosten. Die endgültige Entscheidung lautet nicht „Welches Produkt hat die längste Feature-Liste?“. Es geht darum, ob das Betriebsmodell wichtige Änderungen erkennen, Vertrauensgrenzen wahren, eine verantwortungsvolle Behebung unterstützen und für Ihr Plattform-Team wirtschaftlich sinnvoll bleiben kann.
Was ein On-Prem-Datenqualitätstool wirklich ist
Stellen Sie sich ein Vertriebszentrum vor, das mit empfindlichen Produkten arbeitet. Der Qualitätsprüfer kann jede Lieferung im Lager untersuchen, Messungen protokollieren und melden, ob die Waren die Anforderungen erfüllen. Der Prüfer muss nicht jeden Artikel an eine externe Einrichtung schicken, nur um einen Qualitätswert zu berechnen.
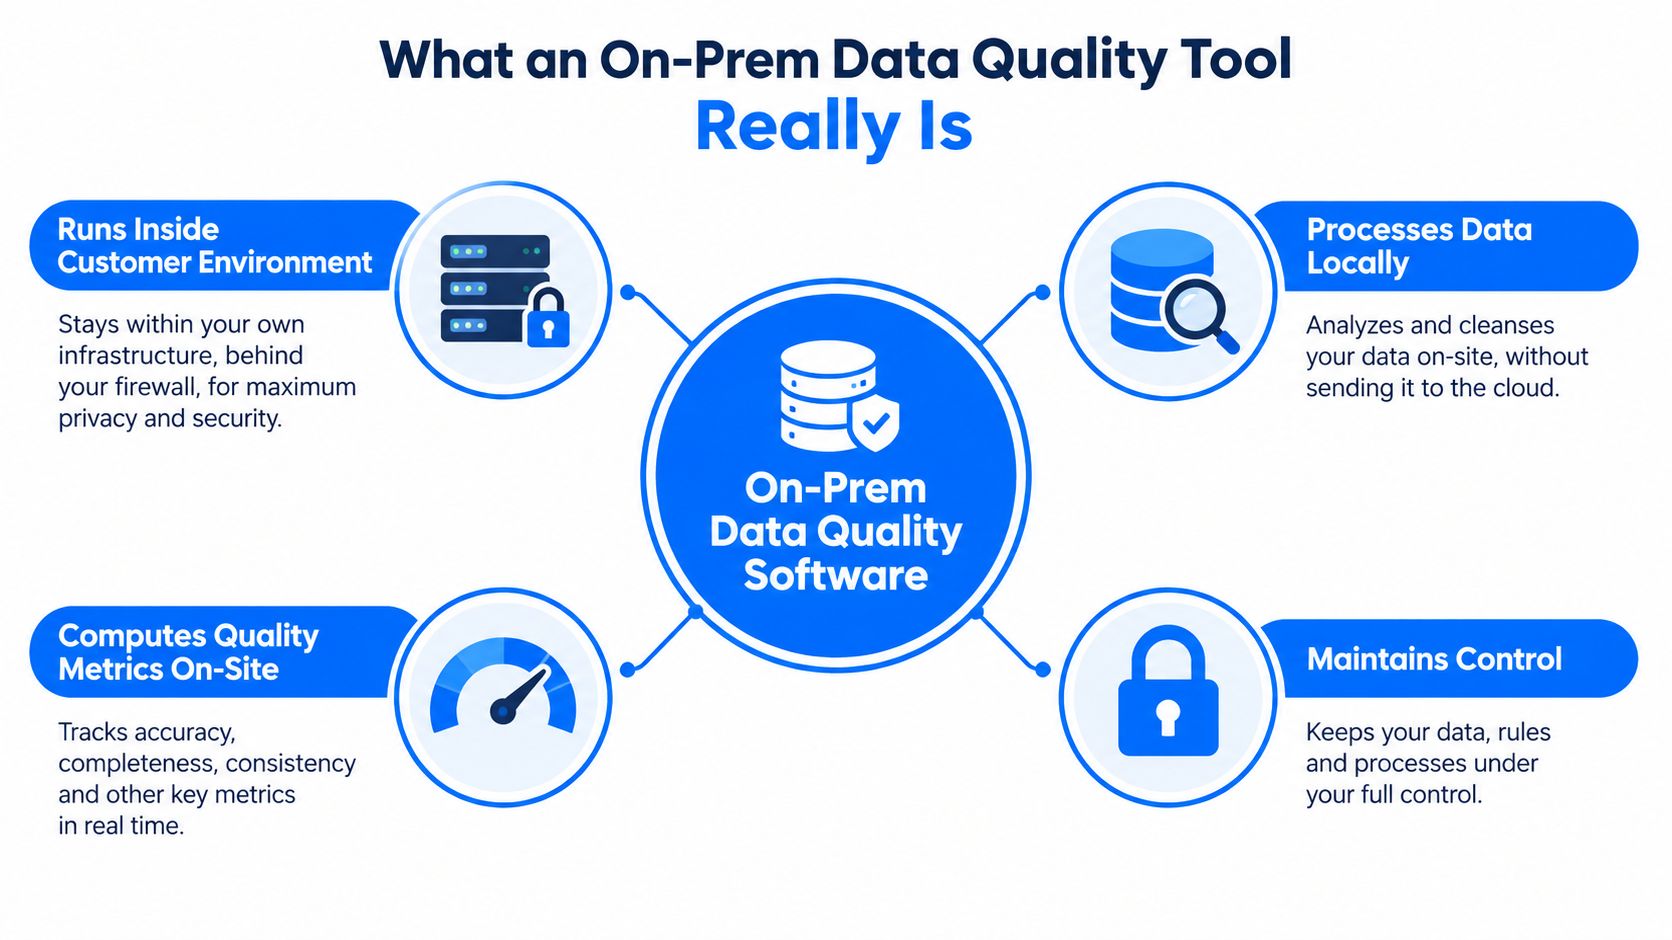
Ein On-Prem-Datenqualitätstool folgt demselben Prinzip. Die Software läuft im eigenen Rechenzentrum des Kunden, in einer Private Cloud, VPC oder einer kontrollierten Infrastruktur. Sie verbindet sich mit Datenbanken und Plattformen, auf denen sich die Datensätze bereits befinden, berechnet dort Qualitätsmetriken und sendet autorisierte Ergebnisse an eine gemeinsame Schnittstelle für Ingenieure, Analysten und Stakeholder.
Beginnen Sie dort, wo die Berechnung stattfindet
Die wichtigste Unterscheidung liegt nicht darin, wo die Benutzeroberfläche gehostet wird. Fragen Sie stattdessen, wo die Plattform Datensätze liest und Analysen durchführt. In-Database-Ausführung bedeutet, dass das Tool Prüfungen innerhalb der Datenbankumgebung des Kunden berechnet, was die Datenbewegung minimiert und sensible Datensätze an Ort und Stelle belässt. Es kann auch eine Metrikberechnung mit geringerer Latenz unterstützen, da die Analyse dort stattfindet, wo die Daten bereits liegen, wie in dignas In-Database-Datenqualitätsrichtlinien beschrieben.
Dieses Design verändert die Sicherheitsdiskussion. Ein Sicherheitsteam kann Datenbankberechtigungen, Netzwerkpfade, Identitätskontrollen und Audit-Protokolle im Rahmen etablierter Unternehmensprozesse überprüfen. Die Datenqualitätsplattform wird zu einem weiteren verwalteten Workload und nicht zu einem neuen Weg für den Export von Produktionsdaten.
Trennen Sie Bereitstellung von Zusammenarbeit
On-Premises bedeutet nicht, dass isolierte Teams ohne eine gemeinsame Sichtweise arbeiten müssen. Eine nützliche Plattform bietet weiterhin Dashboards für den Vorfallsstatus, den Metrikverlauf, Regelergebnisse, Schemaänderungen und die Zuständigkeiten. Die Ausführungsebene kann nah an jeder Datenquelle bleiben, während die Präsentationsebene den verschiedenen Benutzern ein einheitliches Betriebsbild liefert.
Beispielsweise kann ein Ingenieur eine fehlgeschlagene Validierungsabfrage untersuchen, ein Analyst eine Verteilungsverschiebung überprüfen und ein Governance-Verantwortlicher Nachweise darüber benötigen, dass eine Geschäftsregel überwacht wurde. Sie alle betrachten unterschiedliche Konsequenzen desselben zugrunde liegenden Datenzustands.
Verstehen Sie die Governance-Grenze
SaaS-Tools zentralisieren das Monitoring üblicherweise in einer vom Anbieter verwalteten Umgebung. Eine On-Premises-Plattform überlässt stattdessen dem Kunden mehr Kontrolle, einschließlich Bereitstellung, Zugriff, Upgrades, Verfügbarkeit und Integration. Diese Kontrolle kann Residenzanforderungen erfüllen, verursacht aber auch betrieblichen Aufwand.
Die richtige Frage ist daher nicht, ob On-Premises automatisch sicherer ist. Es geht darum, ob Ihr Unternehmen die Monitoring-Ebene unter seinen eigenen Sicherheits- und Plattformstandards betreiben und gleichzeitig eine einheitliche Sicht über Cloud- und Legacy-Umgebungen hinweg wahren kann.
On-Prem- vs. SaaS-Datenqualitätstools im Vergleich
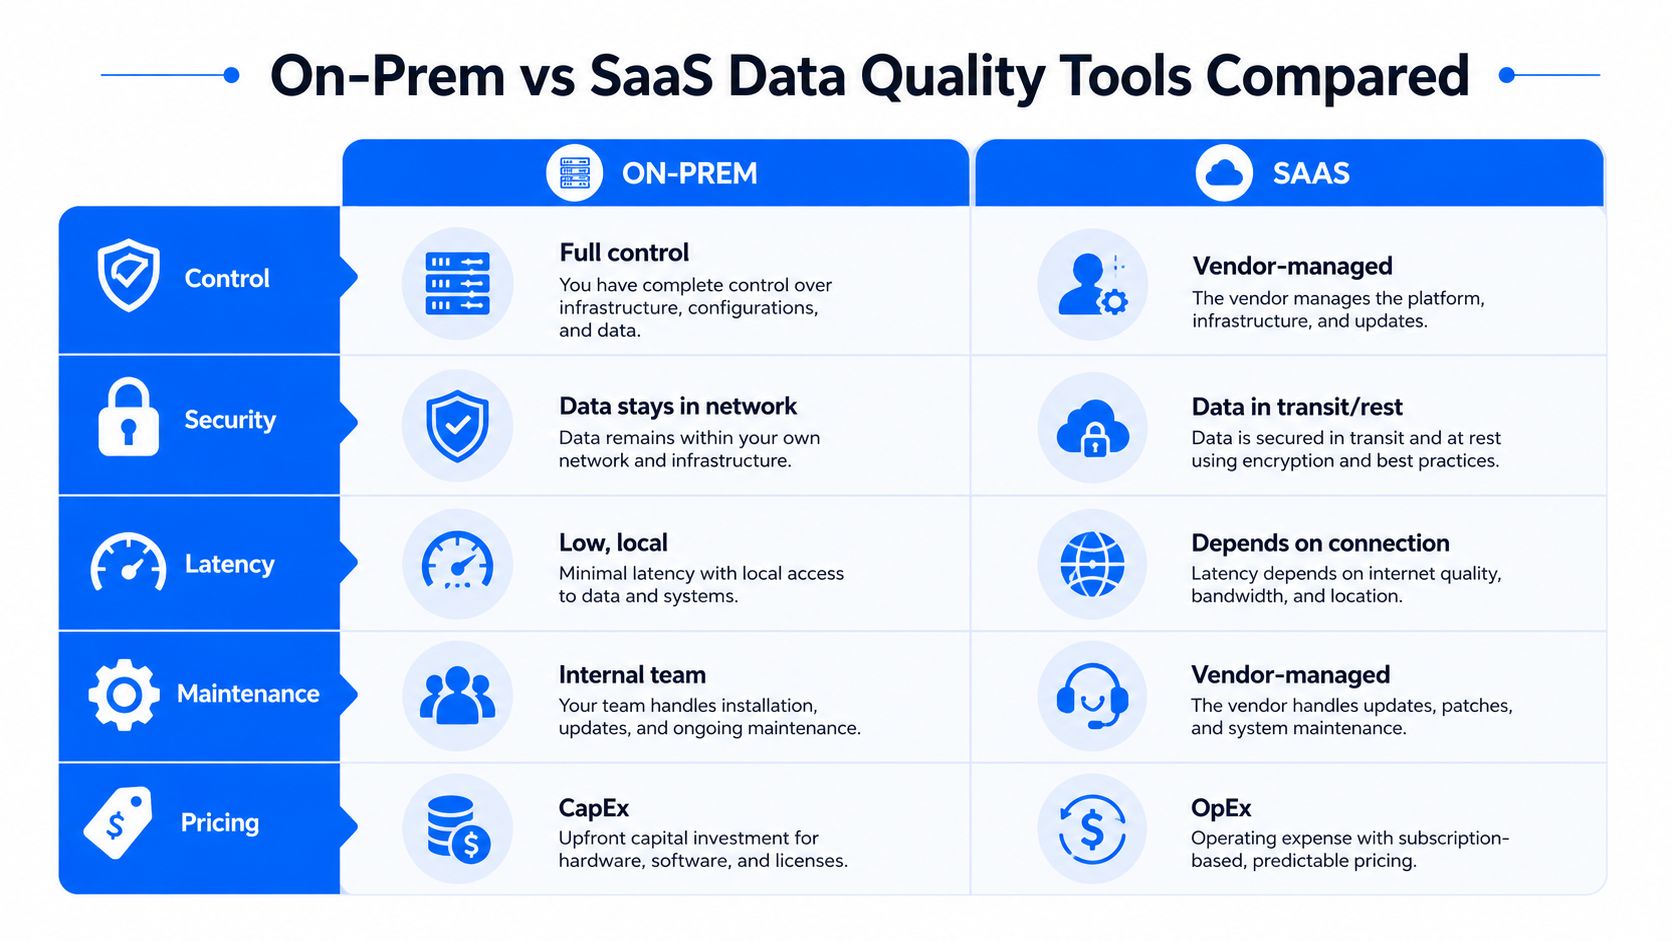
Der Vergleich sollte mit den Rahmenbedingungen beginnen, nicht mit Markenpräferenzen. Ein On-Premises-Tool bietet dem Käufer im Allgemeinen mehr Kontrolle über die Ausführung, die Netzwerkplatzierung und den Zeitpunkt von Upgrades. SaaS reduziert in der Regel die Installations- und Infrastrukturverantwortung, erfordert jedoch möglicherweise, dass Daten, Metadaten oder Monitoring-Ergebnisse eine Grenze überschreiten, die regulierte Teams nicht akzeptieren können.
Evaluierungskriterien | On-Prem-Tool | SaaS-Tool |
|---|---|---|
Kontrolle | Der Kunde kontrolliert Bereitstellung und Infrastruktur | Der Anbieter verwaltet den Dienst |
Sicherheit | Daten können innerhalb des Kundennetzwerks verbleiben | Daten und Monitoring-Verkehr nutzen externe Dienstpfade |
Latenz | Lokale Ausführung kann Datenbewegungen und Verbindungsabhängigkeiten reduzieren | Die Leistung hängt teilweise von der Konnektivität und der Dienstarchitektur ab |
Wartung | Interne Teams verwalten Betrieb und Upgrades | Der Anbieter verwaltet den Großteil des Plattformbetriebs |
Preise | Kann Infrastruktur und interne Betriebskosten beinhalten | Abonnementkosten werden in der Regel als Betriebsausgaben behandelt |
Der Kompromiss liegt in der betrieblichen Verantwortung. On-Premises gibt Infrastruktur- und Sicherheitsteams direkte Kontrolle, erfordert jedoch die Planung von Kapazität, Patching, Backup, Hochverfügbarkeit, Observability für das Tool selbst und Disaster Recovery. SaaS kann diese Pflichten vereinfachen, obwohl der Käufer dennoch Zugriff, Integrationen, Datenverträge (Data Contracts) und die Zuständigkeit für Vorfälle regeln muss.
Richten Sie die Entscheidung an der Infrastruktur aus
On-Premises ist oft die bessere Wahl, wenn Datensätze innerhalb der vom Kunden kontrollierten Infrastruktur verbleiben müssen, wenn Altsysteme nur schwer nach außen hin freigegeben werden können oder wenn Auditoren detaillierte Nachweise über Zugriff und Verarbeitung verlangen. Es eignet sich auch für hybride Infrastrukturen, bei denen das Kopieren von Daten in eine SaaS-Plattform zusätzliche Komplexität in Bezug auf Datenresidenz, Datenschutz oder Netzwerke verursachen würde.
SaaS kann für Teams mit einer vorwiegend cloudnativen Architektur, begrenzten Kapazitäten im Plattformbetrieb und ohne Einschränkungen hinsichtlich der Übermittlung der erforderlichen Monitoring-Daten an einen vom Anbieter verwalteten Dienst einfacher sein. Einfachheit kann entscheidend sein. Ein Tool, das ein Team konsistent bereitstellen, konfigurieren und warten kann, ist wertvoller als eine theoretisch perfekte Plattform, die nie die Produktionsreife erreicht.
Die Entscheidung ähnelt anderen Infrastrukturentscheidungen. Teams, die Cloud-E-Mail mit einem Server vor Ort vergleichen, stehen vor einer ähnlichen Frage bezüglich Kontrolle, Verantwortung und Service-Komfort. Das gleiche Prinzip gilt hier: Wählen Sie die Grenze, die dem Risikomodell und der Betriebsfähigkeit Ihres Unternehmens entspricht.
Eine praktische Übersicht über Datenqualitätssoftware kann Teams dabei helfen, die funktionale Ebene zu strukturieren, aber die Bereitstellung erfordert dennoch eine Bewertung für jeden einzelnen Workload. Identifizieren Sie, welche Datensätze sensibel sind, wo Berechnungen stattfinden müssen, welche Metadaten die jeweilige Umgebung verlassen dürfen und wer die Plattform um zwei Uhr nachts unterstützen wird.
Wesentliche Funktionen, die jedes On-Prem-Tool enthalten sollte
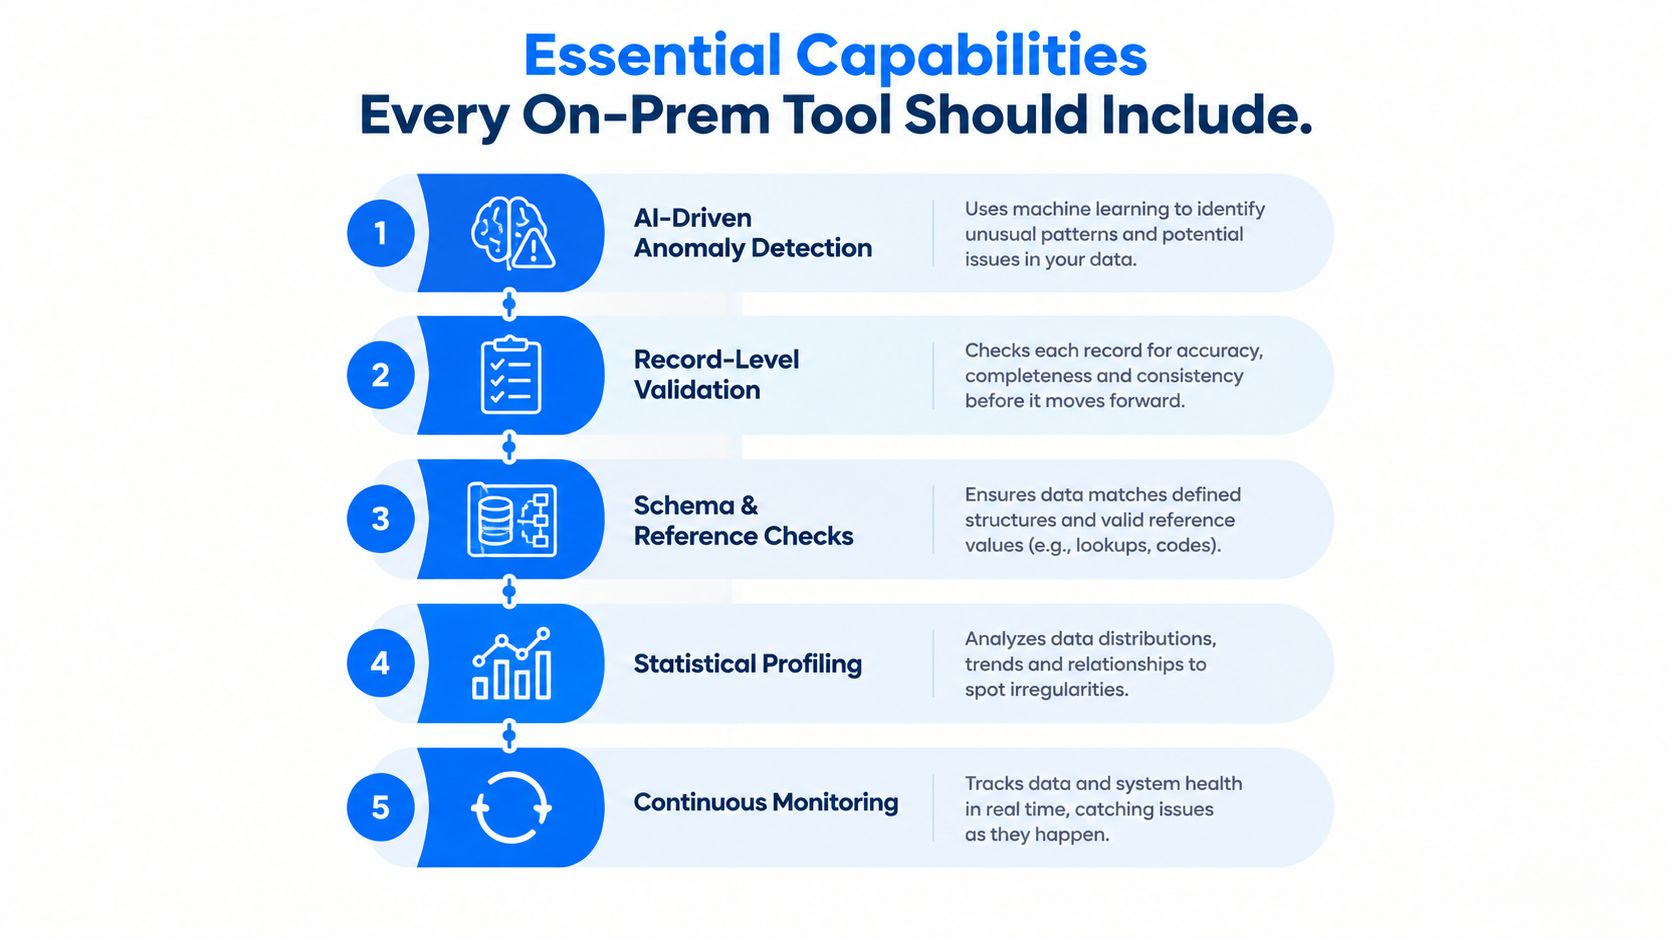
Eine Qualitätsplattform verdient ihren Platz, indem sie verschiedene Arten von Fehlern erkennt, und nicht, indem sie einen einzigen pauschalen Wert liefert. Aktualität, Volumen, Verteilung, Schema und Regelvalidierung offenbaren jeweils unterschiedliche Symptome. Ein praktisches Observability-Modell kombiniert diese Signale, da ein verzögerter Ladevorgang nicht unbedingt ein Schema ändert und ein unbemerktes Korruptionsereignis die Zeilenanzahl möglicherweise nicht verringert.
Aktualität und Volumen
Das Monitoring der Timeliness stellt die Frage, ob Daten zu dem von den Konsumenten erwarteten Zeitpunkt eingetroffen sind. Es sollte normale Liefermuster, Zeitpläne, verspätet eintreffende Daten, fehlende Ladungen, Wiederholungsversuche und Teilladungen berücksichtigen. Die Berechnung der erwarteten Lieferung ist besonders nützlich, da ein fester Schwellenwert eine Quelle mit variablem, aber vorhersehbarem Eingangsverhalten fälschlicherweise als fehlerhaft klassifizieren kann.
Das Volumen-Monitoring fängt eine andere Klasse von Problemen ab. Eine Pipeline kann abgeschlossen werden, obwohl sie weitaus weniger oder mehr Datensätze als üblich lädt. Eine plötzliche Volumenverschiebung kann auf eine upstream vorgenommene Filteränderung, einen fehlerhaften Join, einen Quellausfall oder ein unerwartetes Geschäftsereignis hinweisen, das untersucht werden muss.
Verteilung und Anomalieerkennung
Das Verteilungs-Monitoring blickt in den Datensatz hinein. Es kann Änderungen in Wertmustern, Nullwert-Verhalten, Kategoriegewichtungen oder andere statistische Merkmale identifizieren, die über die reine Zeilenanzahl nicht sichtbar wären. KI-gestütztes Lernen von Baselines kann die Abhängigkeit von manuell konfigurierten Schwellenwerten verringern. Die Plattform lernt das normale Verhalten eines Datensatzes und markiert Abweichungen zur Überprüfung.
Historische Analysen liefern zusätzlichen Kontext. Eine einzelne ungewöhnliche Beobachtung kann harmlos sein, während eine allmähliche Verschiebung historischer Metriken auf Datenverfall oder eine Prozessänderung hindeuten kann. Teams benötigen Trend- und Volatilitätsansichten, um ein einmaliges Ereignis von einem sich entwickelnden Zuverlässigkeitsproblem zu unterscheiden.
Schema- und Strukturprüfungen
Das Schema-Tracking überwacht den Vertrag zwischen Produzenten und Konsumenten. Hinzugefügte oder entfernte Spalten, geänderte Datentypen und veränderte Strukturen können Transformationen, Dashboards oder Modelle beschädigen, selbst wenn die Datenerfassung einen Erfolg meldet.
Eine starke Implementierung protokolliert die Änderung, identifiziert die betroffenen Assets (sofern eine Lineage verfügbar ist) und liefert dem zuständigen Team genügend Kontext, um zu entscheiden, ob die Änderung beabsichtigt ist. Schema-Monitoring sollte nicht nur melden, dass „sich etwas geändert hat“. Es sollte Ingenieuren helfen zu bestimmen, was sich geändert hat und was davon abhängen könnte.
Datensatzvalidierung und Geschäftslogik
Statistische Signale ersetzen keine deterministischen Regeln. Die Validierung auf Datensatzebene prüft, ob Werte Geschäftsbedingungen, Referenzbeziehungen und Audit-Anforderungen erfüllen. Beispiele hierfür sind die Überprüfung, ob ein Status mit einem Lebenszyklusdatum kompatibel ist, ob eine Transaktion einer genehmigten Klassifizierung entspricht oder ob ein Pflichtfeld für einen bestimmten Datensatztyp ausgefüllt ist.
Die fünf Signale ergänzen sich gegenseitig. Die Aktualität zeigt Ihnen, wann Daten eingetroffen sind, das Volumen zeigt Ihnen, wie viele Daten eingetroffen sind, die Verteilung zeigt Ihnen, wie sich ihr Verhalten verändert hat, das Schema zeigt Ihnen, ob sich ihre Struktur verschoben hat, und die Validierung zeigt Ihnen, ob die Datensätze den geschäftlichen Anforderungen entsprechen.
Die In-Database-Ausführung ist bei allen fünf Funktionen von Bedeutung. Die Berechnung von Metriken dort, wo die Daten bereits liegen, reduziert unnötige Datenbewegungen und ermöglicht es dem Tool, nahe an großen oder sensiblen Datensätzen zu arbeiten. Die Plattform benötigt dennoch effiziente Abfragen, eine sinnvolle Zeitplanung, Berechtigungen und Ressourcenkontrollen, da die lokale Ausführung die Notwendigkeit eines verantwortungsvollen Workload-Managements nicht aufhebt.
Bereitstellungssicherheit und Betriebsmodell für hybride Infrastrukturen
Hybride Infrastrukturen offenbaren die Schwäche, On-Premises als reine Installationsoption zu betrachten. Ein Kunde kann Transaktionsdaten im eigenen Rechenzentrum aufbewahren, ein Warehouse in einer Private Cloud betreiben und Cloud-Dienste für Analysen oder Modellentwicklungen nutzen. Die Monitoring-Ebene muss diese Systeme beobachten, ohne jede Vertrauensgrenze in ein Datenexport-Problem zu verwandeln.
Validieren Sie die Bereitstellungsgrenze
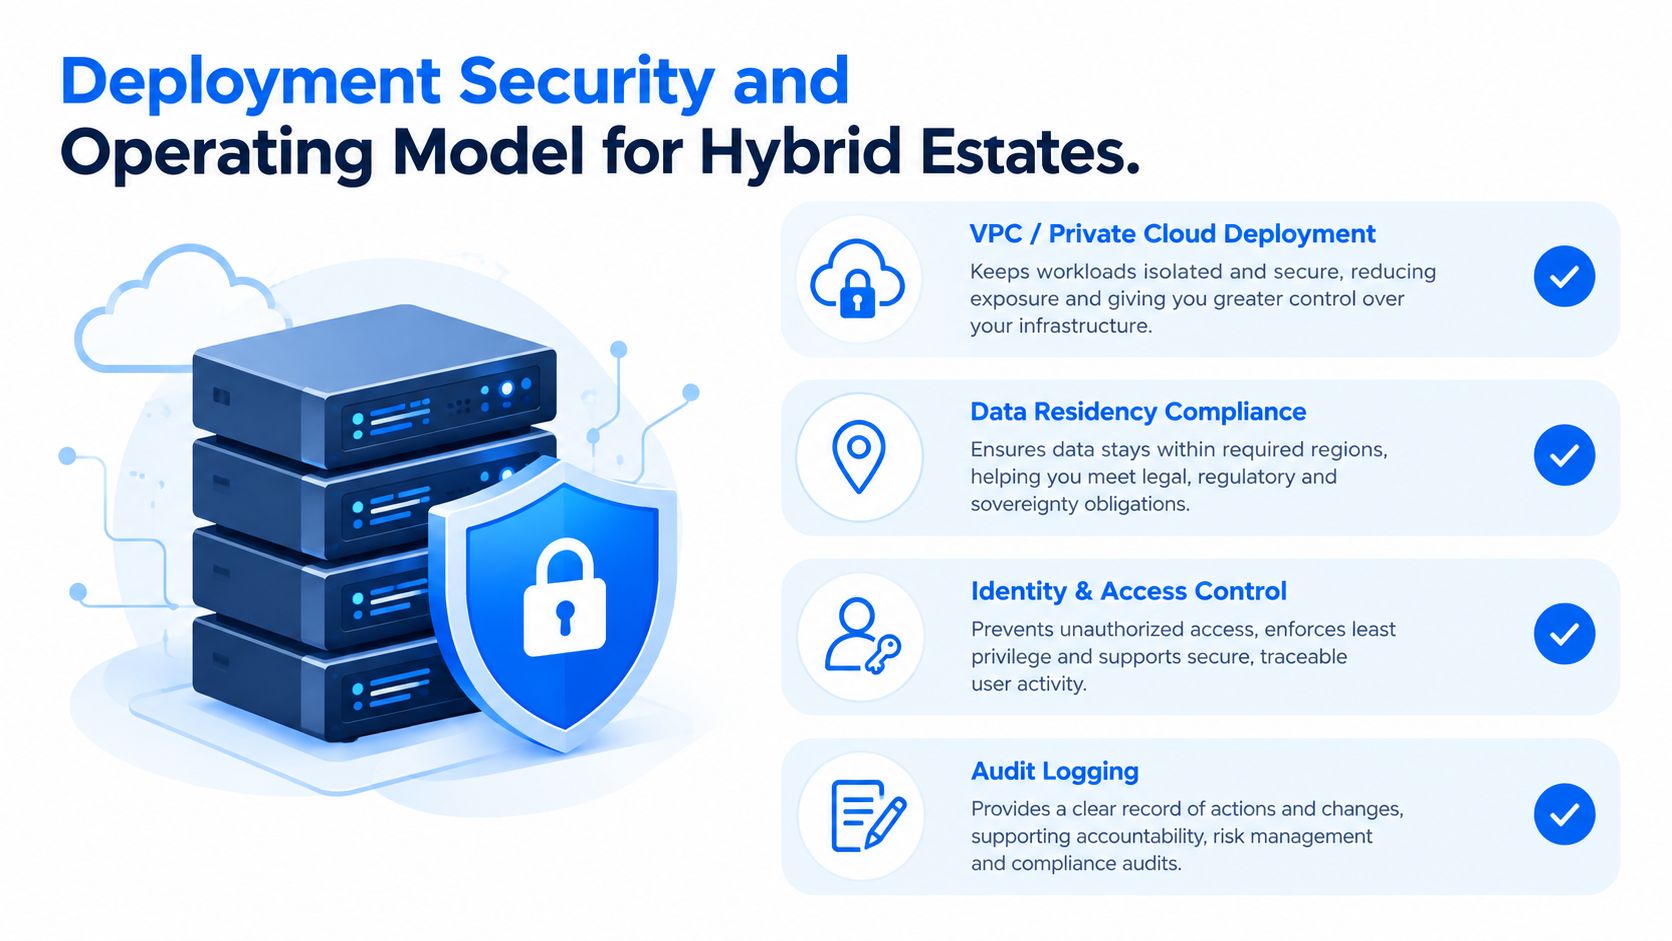
Beginnen Sie mit einer gemeinsamen Überprüfung durch die Teams für Datenplattform, Sicherheit, Infrastruktur, Datenschutz und Governance. Die folgenden Fragen decken Lücken auf, bevor ein Kauf zu einer Ausnahme in der Architektur führt:
Ausführungsort: Wo läuft das Tool und wo werden Abfragen ausgeführt?
Datenbewegung: Verlassen Rohdaten die Umgebung oder liefert die Plattform nur Metriken und Metadaten zurück?
Identität: Kann das Tool die Unternehmensidentitäten und die rollenbasierte Zugriffskontrolle nutzen?
Residenz: Kann jede Datendomäne in der erforderlichen Jurisdiktion und Infrastrukturgrenze verbleiben? Überprüfen Sie die relevanten Anforderungen an die Datenresidenz, bevor Sie Verbindungen genehmigen.
Lineage: Können Teams ein Problem über Cloud- und On-Premises-Assets hinweg zurückverfolgen, ohne sensible Datensätze zu zentralisieren?
Zugriff auf Altsysteme: Kann die Plattform eine Verbindung zu älteren Datenbanken und operativen Systemen herstellen, ohne eine Migration zu erzwingen?
Audit-Nachweise: Werden Regelausführungen, Zugriffsereignisse, Konfigurationsänderungen und Entscheidungen zu Vorfällen protokolliert?
Betrieb: Wer ist für Patching, Upgrades, Backups, Kapazitäten, Zertifikate und Wiederherstellungstests zuständig?
Agieren Sie über Vertrauensgrenzen hinweg
Ein einheitliches Dashboard erfordert nicht zwingend einen einzigen Data Lake für das gesamte Monitoring. Ein verteiltes Modell kann Prüfungen lokal in jeder Umgebung ausführen, Rohdaten an der Quelle belassen und kontrollierte Qualitätsergebnisse über genehmigte Kanäle teilen. Dieser Ansatz bietet zentralen Governance-Teams Transparenz, während lokale Plattformbesitzer die Kontrolle über Zugriff und Ausführung behalten.
Das Betriebsmodell muss zudem die Verantwortlichkeiten definieren. Die Sicherheit kann Verbindungen genehmigen, aber die Dateneigentümer müssen entscheiden, ob eine Anomalie zu erwarten ist. Plattform-Teams warten den Dienst, während Domänen-Teams Fehler in den Quellen oder Transformationen beheben. Ohne diese Rollenverteilung kann eine On-Prem-Installation zu einer weiteren isolierten Monitoring-Insel werden.
Branchen-Anwendungsfälle: ROI und betriebliche Auswirkungen
Die wirtschaftliche Begründung für On-Premises-Datenqualität hängt davon ab, was Fehler Ihr Unternehmen kosten und welche Verantwortlichkeiten es übernehmen kann. Der Lizenzpreis ist dabei nur ein Posten. Die umfassendere Berechnung umfasst die Nacharbeit von Analysten, Untersuchungen durch Entwickler, verzögerte Berichterstattung, unnötigen Plattformverbrauch, Audit-Vorbereitung und die Betriebskosten für die Bereitstellung des Monitoring-Dienstes.
Im Finanzbereich kann ein Team kritische Transaktionen auf Datensatzebene validieren, die Lieferzeiten von Risikodaten überwachen und Schemaänderungen nachverfolgen, bevor aufsichtsrechtliche Berichte fehlschlagen. Teams im Gesundheitswesen priorisieren möglicherweise die Datenresidenz, den kontrollierten Zugriff und den Nachweis, dass Geschäftsregeln auf sensible klinische oder operative Daten angewendet wurden. Telekommunikationsunternehmen benötigen häufig Anomalie- und Volumen-Monitoring für operative Quellen mit hohem Durchsatz, während Teams im öffentlichen Sektor Wert auf Rückverfolgbarkeit und konsistente Kontrollen in älteren Systemen legen können.
Messen Sie betriebliche Auswirkungen, keine Eitelkeitsmetriken
Ein nützliches ROI-Modell fragt nach den Veränderungen, sobald die Erkennung kontinuierlich erfolgt:
Frühzeitigere Erkennung von Vorfällen: Teams identifizieren verspätete Ladevorgänge, bevor veraltete Dashboards die Entscheidungsträger erreichen.
Weniger Zeitaufwand für Untersuchungen: Verteilungs-, Schema- und historische Kontexte grenzen die Suche nach der Ursache ein.
Geringere Nacharbeit: Analysten verbringen weniger Zeit mit der Abstimmung von Berichten, die inkompatible oder unvollständige Eingaben verwendet haben.
Bessere Audit-Bereitschaft: Regelergebnisse und Betriebshistorie liefern Nachweise für Prüfungen.
Kontrollierter Verbrauch: Plattform-Teams können ungewöhnliche Workloads und Datenverhalten erkennen, bevor sie vermeidbare Kosten oder Kapazitätsengpässe verursachen.
Höheres Vertrauen: Geschäftsanwender können den Monitoring-Status einsehen, anstatt sich auf informelle Zusicherungen verlassen zu müssen.
Der Kompromiss liegt auf der Hand. On-Premises kann Datenbewegungen reduzieren und die Compliance unterstützen, jedoch übernimmt der Käufer die Verantwortung für Infrastruktur, Bereitstellung und Wartung. Observability-Studien zeigen, dass 56,8 % der Befragten die Tool-Kosten als Problem nannten, während 29,3 % unvorhersehbare jährliche Rechnungen anführten und 27,3 % auf CapEx und OpEx für das Datenmanagement hinwiesen (ManageEngines State of Observability 2025 Report). Diese Ergebnisse verdeutlichen, wie wichtig es ist, die finanzielle Belastung durch Abonnements mit den internen Arbeits- und Infrastrukturverpflichtungen zu vergleichen, anstatt nur eine angebotene Lizenz zu betrachten.
Die Time-to-Value benötigt einen echten Test
Eine Fallstudie von Acceldata berichtet, dass deren Plattform über eine Milliarde Zeilen für 50 kritische Datenqualitätsregeln in weniger als 2 Stunden überprüft hat (Acceldata-Fallstudien). Dies ist ein vom Anbieter gemeldeter Benchmark, kein Versprechen für jede Infrastruktur.
Die veröffentlichten Implementierungserfahrungen für digna sind ähnlich an Bedingungen geknüpft: „Es hängt stark vom Kunden ab. Wenn alles vorbereitet ist, dauert es nicht länger als 2 Stunden. Dies war bei unserer ersten Installation von digna bei den IT-Services der österreichischen Sozialversicherung der Fall.“ Die praktische Lehre daraus ist, die Vorbereitungsarbeiten explizit zu testen. Verbindungsfreigaben, repräsentative Tabellen, Regeln, Zuständigkeiten und die Weiterleitung von Alarmen bestimmen, wie schnell eine Bereitstellung nützliche Ergebnisse liefert.
So evaluieren und wählen Sie das richtige On-Prem-Datenqualitätstool aus
Nutzen Sie ein Pilotprojekt, um das Betriebsmodell zu testen, nicht nur die Benutzeroberfläche. Wählen Sie repräsentative Datensätze sowohl aus einer Legacy-Umgebung als auch aus einer Cloud-Plattform aus und prüfen Sie, ob das Tool diese überwachen kann, ohne sensible Datensätze in einen externen Dienst zu verschieben.
Ihre Evaluierung sollte folgende Fragen beantworten:
Ausführung: Werden Metriken in der Kundenumgebung oder -datenbank berechnet?
Abdeckung: Kann eine einzige Plattform Anomalieerkennung, Validierung, Aktualität, Schema und historische Analysen kombinieren?
Baselines: Lernt die Anomalieerkennung das Verhalten von Datensätzen, ohne dass Ingenieure jeden Schwellenwert manuell pflegen müssen?
Kontext: Kann ein Alarm betroffene Assets, historisches Verhalten und Zuständigkeiten aufzeigen?
Integration: Lässt es sich mit den bereits genutzten Datenbanken, Warehouses, Schedulern, Identitätssystemen und Benachrichtigungskanälen verbinden?
Betrieb: Kann Ihr Team das Tool unter Einhaltung bestehender Standards patchen, sichern, skalieren und wiederherstellen?
Preise: Ist das Modell verständlich und vermeidet es unvorhersehbare Kosten für jeden Scan, Alarm oder API-Aufruf?
Akzeptanz: Können Ingenieure, Analysten und Governance-Anwender mit derselben Status- und Vorfallsansicht arbeiten?
Beginnen Sie mit einem Modul von hohem Wert und einem Datensatz mit klarer Zuständigkeit. Messen Sie, ob das Pilotprojekt bekannte Fehlermuster bei Aktualität, Verteilung, Schema und Validierung erkennt, und berechnen Sie den internen Aufwand für den Betrieb. Ein gut strukturierter Business Case für Datenqualität sollte vermiedene Nacharbeit, Reaktion auf Vorfälle, Audit-Vorbereitung, Infrastruktur, Plattform-Arbeitsaufwand und den Wert der Aufbewahrung von Daten innerhalb genehmigter Grenzen enthalten.
Das Gespräch mit dem Anbieter sollte auch Nachweise über die Bereitstellung beinhalten, nicht nur eine Feature-Demonstration. Fordern Sie ein Architektur-Review, eine Sicherheitsbegehung, eine repräsentative Integration und einen Test für die Zeit bis zum ersten Alarm an. Wenn Sie sich auf die Beispielplattform beziehen, achten Sie auf die exakte Schreibweise der Marke: digna schreibt sich mit einem kleinen „d“.
digna bietet eine Enterprise-Plattform für Datenqualität und Observability, die in der Umgebung des Kunden läuft – mit In-Database-Ausführung für Anomalieerkennung, Validierung, Aktualität und Schema-Monitoring. Besuchen Sie digna, um ein On-Premises-Betriebsmodell für hybride Dateninfrastrukturen kennenzulernen und zu prüfen, ob es Ihre Anforderungen an Sicherheit, governance und Zuverlässigkeit erfüllt.
Häufig gestellte Fragen
Was macht ein Datenqualitätswerkzeug zu einem On-Premises-Werkzeug?
Der Ort der Berechnung, nicht der Ort der Oberfläche. Entscheidend ist, ob Abfragen innerhalb Ihres Netzwerks ausgeführt werden und ob Rohdatensätze die Umgebung verlassen oder nur Kennzahlen und Metadaten zurückkommen. Diese eine Entwurfsentscheidung verändert die gesamte Sicherheitsdiskussion.
Ist On-Premises automatisch sicherer als SaaS?
Nein, und das ist die falsche Frage. SaaS zentralisiert das Monitoring in einer herstellerverwalteten Umgebung, On-Premises hält die Ausführung in kundeneigener Infrastruktur und verlagert damit auch die operative Verantwortung. Der richtige Vergleich beginnt bei Randbedingungen wie Residenz, Legacy-Zugriff und Auditnachweisen.
Welche Fähigkeiten sollte ein On-Prem-Werkzeug im Pilot belegen?
Fünf einander ergänzende Signale. Aktualität sagt, wann Daten eintrafen, Volumen wie viel eintraf, Verteilung wie sich ihr Verhalten änderte, Schema ob sich die Struktur bewegte, und Validierung ob Datensätze die fachliche Absicht erfüllen. Eine Plattform, die stattdessen einen Gesamtwert liefert, hat ihren Platz nicht verdient.
Was gehört in die Prüfung des Deployments?
Acht Fragen, gemeinsam abgestimmt zwischen Datenplattform, Security, Infrastruktur, Datenschutz und Governance: Ausführungsort, Datenbewegung, Identität und rollenbasierter Zugriff, Residenz je Domäne, Lineage über Grenzen hinweg, Zugriff auf Altdatenbanken, Auditnachweise und wer Patching, Upgrades, Backups und Recovery-Tests verantwortet.
Wie groß ist das On-Premises-Segment?
Eine Marktschätzung beziffert On-Premises-Deployments 2025 auf 37,5 % des globalen Datenqualitätsmarktes, rund 1,8 Milliarden USD, mit 13,8 % CAGR bis 2034 und damit unter dem Cloud-Segment. Das Segment hält sich, weil sensible Systeme vor Ort bleiben, während Analytics in die Cloud wandert.


