Monitoring & Reporting: Ein praktischer Leitfaden für 2026
|
9
min. Lesezeit

Sie kennen das Szenario bereits. Die Dashboards sind grün, der wöchentliche Bericht wurde pünktlich verschickt, und dann kontaktiert Sie ein Produktmanager, weil das Unternehmen Stunden vor Ihrem Alarm bemerkt hat, dass ein Ladevorgang veraltet ist. Das Problem ist meist nicht, dass es den Teams an Daten mangelt, sondern dass sie einen Reporting-Stack aufgebaut haben, der die Realität im Nachhinein beschreibt, anstatt sie zu überwachen, während sie sich verändert.
Diese Lücke zeigt sich zuerst in regulierten Umgebungen. Öffentliche Systeme haben vor langer Zeit gelernt, dass Baseline, Abweichung, Verzögerung und Behebung wichtiger sind als eine einmalige Veröffentlichung. Deshalb betont die CDC bei der Überwachungsarbeit regelmäßige Intervallanalysen, Vergleiche mit den vorherigen 5 Jahren und die Überprüfung von Personen-, Orts- und Zeittrends (CDC-Leitfaden zur Überwachungsanalyse). Die Enterprise-Observability hat diese Logik übernommen, auch wenn die Tools neuer aussehen.
Inhaltsverzeichnis
Warum Monitoring & Reporting oft scheitern, bevor sie beginnen
KPIs definieren, die den Kontakt mit der Realität überstehen
Anomalieerkennung, Timeliness, Validierung und Schema-Tracking
Dashboards und Alarmierung, die verschiedene Stakeholder tatsächlich nutzen
Bereitstellungsoptionen, die Ihre Monitoring-Architektur prägen
Reporting als Entscheidungsnachweis, nicht als Compliance-Nebensache
Warum Monitoring & Reporting oft scheitern, bevor sie beginnen
Ein Team kann das Dashboard bereitstellen, ein paar Alarme einrichten und dennoch den entscheidenden Moment verpassen. Das System sieht in Präsentationen vollständig aus, doch dann bemerkt das Unternehmen das Problem zuerst, weil niemand die Metriken mit einer Entscheidung, einer Verzögerungsschwelle oder einem benannten Verantwortlichen verknüpft hat.
Die tatsächliche Lücke liegt meist zwischen Datenerfassung und Aktion
Die Reporting-Disziplin im öffentlichen Sektor macht dieses Scheitern leicht erkennbar. Von Programmen wird erwartet, dass sie den Ist-Zustand abbilden, Lücken identifizieren und Empfehlungen rund um den lokalen Kontext entwickeln, anstatt davon auszugehen, dass die Erfassung allein das Problem löst. Die UNICEF-Leitlinien zur Stärkung von Monitoring- und Reporting-Systemen besagen in der Praxis genau das, auch wenn die Formulierung diplomatisch bleibt (UNICEF-Monitoring- und Reporting-Systeme). Dieselbe Lücke zeigt sich bei Enterprise-Datenplattformen. Eine Pipeline kann eine Metrik korrekt erfassen und dennoch scheitern, wenn niemand definiert hat, wer sie nutzt, was als Nächstes zu tun ist und wie schnell sie es wissen müssen.
Praktische Regel: Wenn ein Alarm nicht auf einen Verantwortlichen, einen Schwellenwert und einen Behebungsweg verweist, ist er nur ein Kommentar.
Ein schwaches Indikatordesign verschlimmert das Problem. Die UN-Verifizierungsleitlinien verlangen, dass jeder Indikator eine klare Methodik, Maßeinheit, Berechnungsmethode, Datenquelle, Erfassungsmethode, Häufigkeit und ein Tool enthält, da Berichte andernfalls nicht geprüft oder reproduziert werden können (UN-Verifizierungsleitlinien, wie sie in der ECDC-bezogenen Monitoring-Praxis reflektiert werden). Das ist der Teil, den Enterprise-Teams oft überspringen. Ein KPI ohne Vertrag ist eine Vermutung mit einer angehängten Grafik, und er bricht meist zusammen, sobald das Publikum nach einer nachvollziehbaren Antwort fragt.
Kontinuierliches Monitoring schlägt einmalige Einrichtung
Monitoring-Programme scheitern auch, wenn Teams sie als einmalige Einrichtung betrachten. Quellen verändern sich, Schemata ändern sich, Baselines verschieben sich und der Reporting-Rhythmus, der beim Start funktionierte, passt nicht mehr zur Realität. Die CDC-Analyseanweisungen verdeutlichen denselben betrieblichen Punkt durch die Überwachungsarbeit, weshalb ich sie als Erinnerung nutze, dass die Analyse keine vom Monitoring getrennte Phase ist, sondern Teil des Regelkreises (CDC-Leitfaden zur Überwachungsanalyse). In der Praxis sollte die erste Überprüfung fragen, ob das Signal noch zu dem Geschäftsprozess passt, für dessen Überwachung es erstellt wurde.
Hier verbindet sich die historische Reporting-Disziplin mit modernen Observability-Modulen. Öffentliche Systeme wurden um Baseline, Abweichung, Verzögerung und Behebung herum aufgebaut. Moderne Daten-Stacks benötigen dieselbe Logik, nur implementiert mit Schema-Prüfungen, Aktualitätsprüfungen, Verteilungsdrifts und Verantwortlichen-Routing, die zum Bereitstellungsmodell passen. Wenn die Plattform in-database oder on-prem läuft, muss diese Einschränkung das Design von Anfang an prägen, da einige Teams keine Telemetriedaten an einen externen Dienst senden können und andere keine Monitoring-Ebene akzeptieren können, die weit von den überwachten Daten entfernt ist. Dignas Übersicht der Datenqualitätsmetriken ist ein nützlicher Referenzpunkt dafür, wie diese Metriken in der Praxis formuliert werden.
Deshalb lautet die erste Frage, die ich stelle, nicht: „Welches Dashboard haben Sie?“, sondern: „Welche Entscheidung löst dieses Reporting aus, und was hat sich seit letztem Monat geändert?“ Wenn die Antwort vage ist, sammelt der Stack Signale, ohne Aktionen zu erzeugen.
KPIs definieren, die den Kontakt mit der Realität überstehen
Eine Vizepräsidentin fragte einmal, warum ihr Dashboard eine Genauigkeit von 98 % anzeigte, während der Bereitschaftsingenieur im Incident-Kanal auf 62 % starrte. Der KPI sah sauber aus, bis jemand fragte, wie er berechnet wurde, aus welchem System er stammte und was als Fehler galt. Das ist der übliche Moment, in dem der Reporting-Stack aufhört, eine Managementhilfe zu sein, und sich in eine Diskussion über Definitionen verwandelt.
Schreiben Sie jeden KPI als Vertrag, nicht als Slogan
Das Berichtswesen im öffentlichen Sektor hat Baseline, Abweichung, Verzögerung und Behebung schon immer als Teil desselben Regelkreises behandelt. Enterprise-Datenteams benötigen dieselbe Disziplin, denn ein KPI hält nur stand, wenn er erklärt, reproduziert und umgesetzt werden kann. Der ECDC-Monitoring-Rahmen ist eine nützliche Referenz für diese Art von Spezifität, und die praktische Regel ist einfach: Wenn ein Stakeholder die Logik nicht nachvollziehen kann, ist der KPI nicht bereit.
Jeder KPI sollte die Quelle, die Einheit, die Berechnungsmethode, die Häufigkeit, den Verantwortlichen und die Behebungsregel nennen. Dieses Maß an Detailgenauigkeit ist in regulierten Umgebungen am wichtigsten, in denen Teams eine Zahl im Nachhinein verteidigen und zeigen müssen, wie sie zustande gekommen ist.
Nutzen Sie eine einfache Checkliste:
Quelle: die Tabelle, der Stream oder das System of Record, aus dem die Metrik stammt.
Einheit: Zeilen, Minuten, Datensätze, Prozentsatz oder eine andere explizite Einheit.
Berechnungsmethode: die genaue Aggregation oder Logik, die verwendet wird.
Häufigkeit: wie oft sie aktualisiert und wie oft sie überprüft wird.
Verantwortlicher: die Person oder das Team, das für Maßnahmen verantwortlich ist.
Behebungsregel: was passiert, wenn die Metrik die Grenze überschreitet.
Die Unterscheidung zwischen Aktualität, Vollständigkeit und Gültigkeit ist wichtig, da jede auf andere Weise fehlschlägt. Die Aktualität sagt Ihnen, ob die Daten pünktlich angekommen sind. Die Vollständigkeit sagt Ihnen, ob der Datensatz das enthält, was der nachgelagerte Prozess benötigt. Die Gültigkeit sagt Ihnen, ob die Datensätze den geschäftlichen oder strukturellen Regeln entsprechen. Wenn Sie alle drei über denselben Schwellenwert und denselben Alarmkanal laufen lassen, erhalten die Operatoren laute Benachrichtigungen, und wichtige Warnungen verlieren an Aufmerksamkeit.
Ich trenne auch Compliance-Metriken von operativen Metriken und Business-Fit-Metriken. Ein einziges Dashboard sollte nicht alle drei enthalten, ohne die Zielgruppe zu verwirren. Compliance-Teams wollen Nachweise, Plattform-Teams wollen Frühwarnungen und Geschäftsinhaber wollen wissen, ob der Datensatz die von ihnen getroffene Entscheidung noch unterstützt. Regierungs- und equity-orientierte Leitlinien erwarten zunehmend, dass das Monitoring zeigt, ob unterversorgte Bevölkerungsgruppen erreicht werden. Daher muss das KPI-Set die gestellte Frage widerspiegeln, nicht nur die Daten, die leicht zu zählen sind.
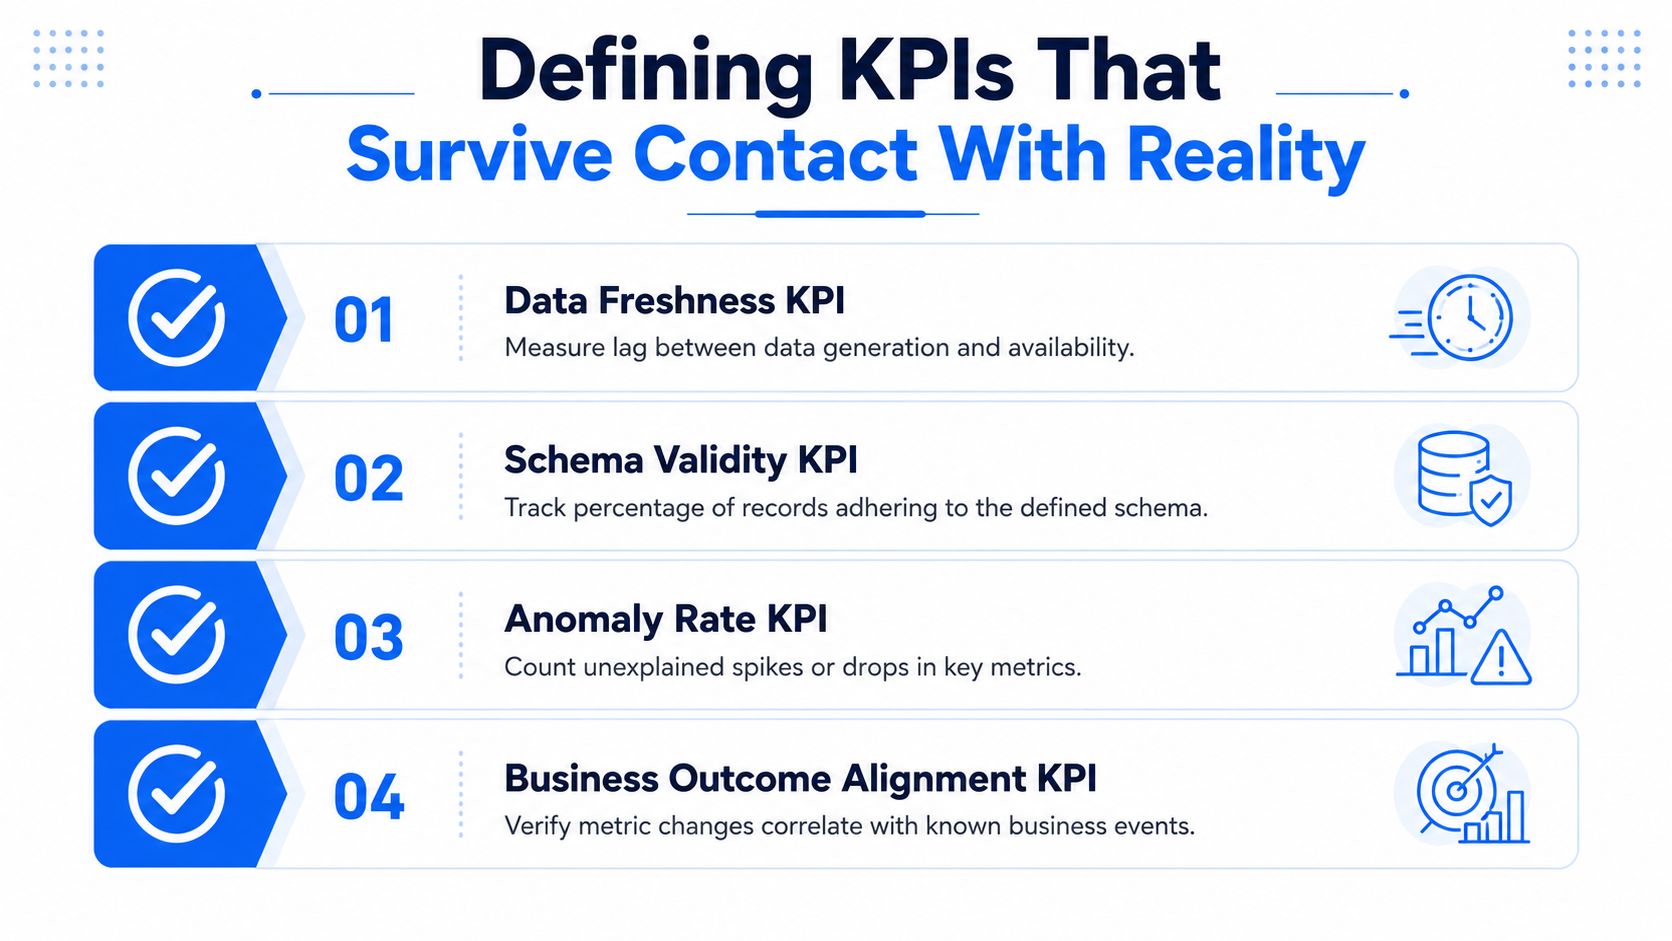
Für Teams, die diese Disziplin in ihren eigenen Stack integrieren möchten, ist der interne Leitfaden zu Datenqualitätsmetriken eine praktische Referenz. Es geht nicht darum, KPIs zu vervielfachen. Es geht darum, jeden einzelnen verteidigungsfähig zu machen, wenn sich die Pipeline fehlerhaft verhält.
Anomalieerkennung, Aktualität, Validierung und Schema-Tracking
Ein Gehaltsteam stellt fest, dass der Monatsend-Feed vom Volumen her normal aussieht, aber ein Quellsystem zu ungewöhnlichen Zeiten abzuweichen begann, eine nachgelagerte Regel gültige Datensätze abgelehnte und eine Spaltenumbenennung einen Reporting-Job abbrach. Das ist die Art von Fehler, die das Monitoring frühzeitig abfangen muss. Die nützliche Ansicht ist nicht ein einzelner Alarmtyp. Es ist die Gesamtheit der Prüfungen, die zeigen, ob die Pipeline verspätet, fehlerhaft, abweichend oder strukturell verändert ist, bevor jemand den Schaden manuell beheben muss.
Vier technische Ebenen entscheiden in der Regel darüber, ob das Monitoring nützlich oder nur dekorativ ist. Sie gehören in ein einziges Zuverlässigkeitsbild, obwohl jede Ebene eine andere Frage beantwortet. Wenn sie in voneinander getrennten Tools liegen, führt das zu doppelten Alarmen, unklarer Zuständigkeit und Incident-Reviews, die länger dauern als die eigentliche Behebung.
Wo die Lücke üblicherweise auftritt
Aktualitäts-Monitoring sollte in einer regulierten Umgebung meist als Erstes eingerichtet werden. Verspätete Ladevorgänge, fehlende Eingänge und Lieferungsdrifts zeigen sich schnell als fehlerhafte Berichte und sind für Stakeholder einfacher zu erklären als schleichende Qualitätsverluste. Wenn Sie In-Database- oder On-Premises-Bereitstellungen nutzen, müssen Aktualitätsprüfungen auch die lokalen Jobfenster, Batch-Zeitpläne und Netzwerkübergaben berücksichtigen, da der Alarm nur dann nützlich ist, wenn er den tatsächlichen Betriebspfad widerspiegelt.
Validierung auf Datensatzebene fängt die Fälle ab, die zwar pünktlich ankommen, aber dennoch die geschäftlichen Regeln verletzen. Ungültige Zustände, unmögliche Werte und Datensätze, die zwar dem Schema entsprechen, aber die Prozesslogik verletzen, gehören hierher. Das historische Berichtswesen im öffentlichen Sektor hat sich schon immer auf diese Art von Disziplin verlassen – zuerst die Baseline, dann die Abweichung, dann die Behebung –, weil ein sauberer Zeitstempel der Bereitstellung nicht bedeutet, dass dem Bericht vertraut werden kann.
Schema-Tracking überwacht hinzugefügte Spalten, entfernte Spalten und Typänderungen. Es schützt nachgelagerte Jobs vor unbemerktem Scheitern, wenn ein vorgelagertes Team eine Änderung ohne Abstimmung vornimmt. In streng kontrollierten Umgebungen ist diese Ebene umso wichtiger, da eine Schemaänderung auch gecachte Extrakte, gespeicherte Prozeduren oder In-Database-Transformationen betreffen kann, die sich schwerer schnell patchen lassen.
Anomalieerkennung vergleicht das aktuelle Verhalten mit einer gelernten Baseline und sucht nach Abweichungen im Volumen, in der Verteilung oder in der Volatilität. Es ist die Ebene, die das Problem abfängt, mit dem niemand gerechnet hat: den plötzlichen Anstieg, den Einbruch oder die schleichende Verschiebung, die andernfalls im routinemäßigen Rauschen untergehen würde. Eine praktische Referenz für diese Art von Monitoring ist die Anomalieerkennung für Zeitreihen, insbesondere wenn Teams normale Saisonalität von einer Änderung unterscheiden müssen, die Aufmerksamkeit verdient.
Ebene | Hauptfrage | Typischer Auslöser | Verantwortlicher |
|---|---|---|---|
Aktualitäts-Monitoring | Sind die Daten pünktlich angekommen? | Verspäteter, fehlender oder vorzeitiger Ladevorgang | Pipeline-Verantwortlicher |
Validierung | Entspricht der Datensatz den Regeln? | Verletzung von Business-Regeln oder ungültiger Wert | Domain-Team oder Verantwortlicher für Datenqualität |
Schema-Tracking | Hat sich die Struktur geändert? | Hinzugefügte, entfernte oder im Typ geänderte Spalte | Vorgelagerter Producer oder Plattform-Team |
Anomalieerkennung | Weicht das Verhalten von der Baseline ab? | Unerklärlicher Anstieg, Einbruch oder Volatilität | Data Engineering oder Observability |
Die Reihenfolge ist wichtiger als die Anzahl der Tools
Beginnen Sie mit der Aktualität, wenn die erste Beschwerde veraltete Berichte betrifft. Beginnen Sie mit der Validierung, wenn fehlerhafte Datensätze zu Nacharbeiten, Audit-Feststellungen oder manuellen Bereinigungen führen. Beginnen Sie mit dem Schema-Tracking, wenn Quelländerungen häufig nachgelagerte Jobs beeinträchtigen. Beginnen Sie mit der Anomalieerkennung erst, wenn die Pipeline so stabil ist, dass ungewöhnliche Muster tatsächlich eine Bedeutung haben, denn davor ist jeder Alarm nur ein weiteres unbestätigtes Symptom.
Halten Sie die Ebenen in der Implementierung getrennt, führen Sie sie jedoch im Reporting zusammen. Der Operator benötigt eine einzige Incident-Ansicht, nicht vier konkurrierende Theorien darüber, was fehlgeschlagen ist. Das gilt insbesondere für On-Premises- und In-Database-Stacks, bei denen die Zugriffspfade enger sind und die Kosten für das Wechseln zwischen Tools hoch sind.
Ein häufiger Fehler ist der Kauf überlappender Prüfungen in der Hoffnung, dass das Dashboard dies aussortiert. Zuverlässiges Monitoring funktioniert besser als geschichtetes System mit klaren Eskalationspfaden und einer einzigen betrieblichen Story. Wenn das Team nicht sagen kann, ob das Problem eine verspätete Bereitstellung, fehlerhafter Inhalt, Schema-Drift oder Verhaltens-Drift ist, muss das Monitoring-Design weiter überarbeitet werden.
Für Teams, die einen sauberen Arbeitsbereich zur Darstellung dieser Aufteilung wünschen, können Sie Ihren Writingmate-Arbeitsbereich einrichten.
Dashboards und Alarmierung, die verschiedene Stakeholder tatsächlich nutzen
Ein Dashboard funktioniert nur, wenn die richtige Person das richtige Signal mit genügend Kontext sieht, um zu handeln. Ingenieure benötigen Details, Analysten benötigen den Trendverlauf und Führungskräfte benötigen eine saubere Zusammenfassung. Wenn eine einzige Ansicht versucht, alle drei zu bedienen, sinkt das Vertrauen schnell.
Bauen Sie für Rollen, nicht für Eitelkeitsmetriken
Die besten Dashboards trennen den aktuellen Status vom historischen Kontext. Die Leitlinien zur technischen Bewertung der NASA sind hier nützlich, da sie eine konsistente Formatierung, einen bewahrten Verlauf und farbcodierte Alarmzonen betonen, die die Trendidentifikation und projektübergreifende Analysen unterstützen (NASA-Leitlinien zur technischen Bewertung via MRV-Referenz). Dieses Muster lässt sich gut auf die Observability übertragen. Der aktuelle Zustand zeigt, was jetzt passiert. Der historische Zustand zeigt, ob das Problem eine Ausnahme, eine Wiederholung oder der Beginn eines größeren Vorfalls ist.
Für Ingenieure sollte das Dashboard genügend Kontext bieten, um schnell eine Triage durchzuführen, und dann direkt auf die fehlgeschlagene Regel, die betroffene Tabelle und den jüngsten Verlauf verweisen. Für Analysten ist der Kontext von Trends und Volatilität die nützliche Ebene, da sie wissen müssen, ob eine Bewegung statistisch ungewöhnlich oder nur saisonales Rauschen ist. Für Führungskräfte sollte die Zusammenfassung ohne operativen Fachjargon verständlich sein.
Wenn Sie einen sauberen Arbeitsbereich für diese Aufteilung einrichten, können Sie Ihren Writingmate-Arbeitsbereich einrichten und dieselbe Gewohnheit in Ihrem Reporting-Stack nutzen: eine Oberfläche für Aktionen, eine für Reviews. Der nützliche Gedanke ist nicht das Produkt, sondern die Trennung der Zuständigkeiten.
Ein Dashboard benötigt auch einen Platz für die tiefere Qualitätsbetrachtung. Das gleiche Betriebsprinzip gilt unabhängig davon, ob das Signal aus Aktualität, Validierung, Schema-Drift oder Volumenänderungen stammt, und ein dediziertes Datenqualitäts-Dashboard bietet Teams einen klareren Weg vom Status zur Untersuchung als eine überladene Allzweckgrafik.
Alarmierung funktioniert nur, wenn die Dringlichkeit real ist
Schweregradbänder reduzieren die Alarmmüdigkeit. Nicht jede Abweichung verdient eine Benachrichtigung, und nicht jedes Problem gehört in denselben Kanal. Standardisierte Alarmzonen funktionieren besser als Ad-hoc-Schwellenwerte, da Teams geringfügige Abweichungen in Review-Queues leiten und schwerwiegende Fehler sofort eskalieren können.
Ein vertrauenswürdiges Berichtssystem bewahrt zudem Nachweise auf. Die Reporting-Disziplinen des öffentlichen Sektors sind auch hier wichtig, denn die nützliche Gewohnheit ist dieselbe: Halten Sie den Bericht eigenständig, schreiben Sie objektiv, trennen Sie Fakten von der Analyse und bewahren Sie die Verknüpfung zwischen Baseline, Abweichung, Verzögerung und Behebung. Diese Disziplin ist für Incident-Reports ebenso nützlich wie für formelle Reviews.
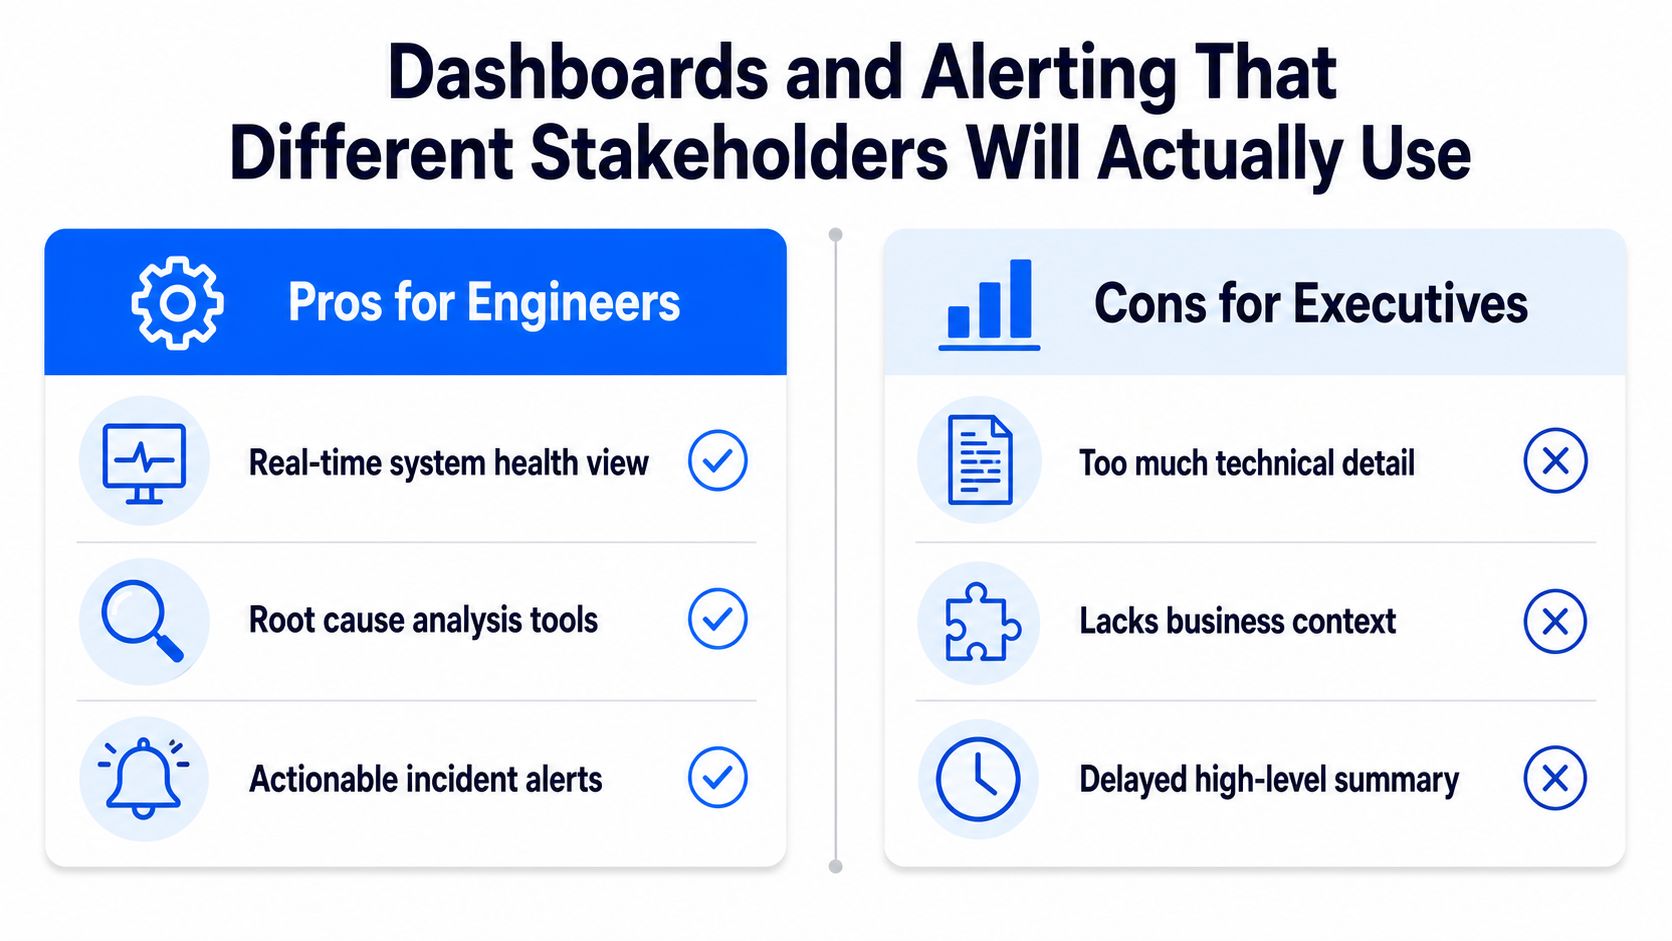
Wenn eine Reporting-Ansicht nicht beantworten kann, wer für das Problem verantwortlich ist, wie schwerwiegend es ist und ob sich der aktuelle Zustand vom letzten bekannten fehlerfreien Zeitraum unterscheidet, ist sie kein Entscheidungswerkzeug. Sie ist nur Dekoration.
Bereitstellungsoptionen, die Ihre Monitoring-Architektur prägen
Die Bereitstellung ist kein Verpackungsdetail. Sie verändert, was Sie überprüfen können, wo Metriken berechnet werden, was Ihre Umgebung verlässt und wie gut die Architektur zu den Governance-Regeln passt. Wenn Ihr Monitoring-Stack Datenbewegungen erfordert, die Sie nicht rechtfertigen können, arbeitet das Bereitstellungsmodell bereits gegen Sie.
In-Datenbank-Ausführung verändert die Sicherheitsgleichung
Für regulierte Unternehmen ist die größte architektonische Frage, wo die Metrikberechnung stattfindet. Die In-Datenbank-Ausführung hält Prüfungen nahe an den Daten, anstatt Produktionsdaten in die Cloud eines Drittanbieters zu übertragen. Dies ist ein großer Vorteil, wenn Datenschutz, Datenresidenz oder interne Kontrollgrenzen eine Rolle spielen. Zudem reduziert es die Menge an doppelter Logik, die Sie über verschiedene Systeme hinweg pflegen müssen.
Das ist wichtig, da das Monitoring oft sensible Datensätze berührt, bevor sie jemand anderes sieht. Wenn die Plattform innerhalb der eigenen Umgebung des Kunden betrieben werden kann, vereinfacht sich die Governance-Story. Der Anbieter benötigt keinen umfassenden Zugriff auf rohe Produktionsdaten, nur um Aktualität, Schema-Drift oder Validierungsergebnisse zu berechnen.
On-Premises und Private Cloud are operational choices, not footnotes
Bei On-Premises- und Private-Cloud-Bereitstellungen geht es um Kontrolle. Sie ermöglichen es einem Team, die Monitoring-Ebene innerhalb der Cloud, VPC oder des Rechenzentrums des Kunden zu betreiben, was oft die einzig akzeptable Antwort ist, wenn Richtlinien eine externe Verarbeitung einschränken. Der Kompromiss besteht darin, dass der Kunde mehr von der operativen Verantwortung übernimmt, einschließlich Upgrades, Laufzeitkapazität und interner Zugriffskontrollen.
Eine modulare Lizenzierung wird nützlich. Beginnen Sie mit einem einzigen Anwendungsfall, wie der Validierung eines kritischen Datensatzes, und erweitern Sie diesen, sobald das erste Modul seinen Wert bewiesen hat. Eine transparente Preisgestaltung pro aktiver Tabelle ist ebenfalls wichtig, da sie Fehlanreize vermeidet, die bei Modellen auf Basis von Alarmvolumen oder API-Aufrufen entstehen. Wenn die Nutzungskosten mit dem Rauschen steigen, beginnen Teams damit, genau die Prüfungen zu unterdrücken, die sie eigentlich benötigen.
Wenn die Preisgestaltung eines Anbieters Sie dafür bestraft, dass Sie zu oft hinsehen, wird sich Ihr Monitoring-Programm am Ende selbst zu wenig überwachen.
Der EU-ETS-Monitoring-Rahmen ist eine gute Erinnerung daran, dass der Plan selbst ein operatives Kontrolldokument ist, kein Narrativ. Er verlangt, dass der Monitoring-Plan die Installation und die Aktivitäten so klar aufzeigt, dass Datenlücken oder Doppelzählungen vermieden werden, und dass er die Verantwortlichkeiten und Kompetenzen der Personen definiert, die ihn ausführen (EU-ETS-Monitoring-Rahmen). Das ist derselbe Standard, den ich für die Observability-Architektur in Unternehmen anlegen würde.
Das Bereitstellungsmodell muss zum Kontrollmodell passen. Wenn dies nicht der Fall ist, wird der Reporting-Stack zu einer weiteren Stelle, an der Richtlinie und Praxis auseinanderdriften.
Operational Playbooks for Data Engineers and Stakeholders
Ein Signal ohne Playbook ist nur eine Unterbrechung. Teams, die ihr Monitoring erfolgreich betreiben, hören nicht bei der Erkennung auf. Sie definieren, was als Nächstes passiert, wer dafür verantwortlich ist und wie die Behebung in das System zurückfließt. Das ist der Punkt, an dem Observability in den Betrieb übergeht.
Geben Sie jedem Alarm einen nächsten Schritt
Beginnen Sie mit der Verantwortung. Wenn ein Schwellenwert überschritten wird, muss jemand wissen, ob er die Ursache untersucht, eskaliert oder den Alarm mit entsprechenden Nachweisen unterdrückt. Der Reaktionspfad sollte sich bei einer Pipeline-Verzögerung, einer Schemaänderung und einer Verschiebung der Geschäftsmetriken unterscheiden, da diese Probleme selten dieselbe Ursache oder dieselbe Zielgruppe haben.
Im Finanzwesen, im Gesundheitswesen, in der Telekommunikation und im öffentlichen Sektor passt ein einziges Reaktionsmodell nie für alle Fälle. Finanzdienstleistungsteams benötigen in der Regel eine strengere Kontrolle von Risiko-, regulatorischen und Transaktionssignalen. Teams im Gesundheitswesen benötigen nachprüfbare Nachweispfade. Telekommunikationsteams benötigen eine schnelle Triage für hochvolumige Kundendaten. Teams im öffentlichen Sektor benötigen Nachvollziehbarkeit und überprüfbare Entscheidungen.
Ein praktisches Playbook umfasst in der Regel vier Phasen:
Signal wird ausgelöst. Der Alarm löst ein definiertes Ereignis aus.
Untersuchung. Der zuständige Bereitschaftsmitarbeiter führt die Diagnoseschritte durch.
Behebung. Das Team wendet den Fix oder die Schadensbegrenzung an.
Review und Verbesserung. Die Nachbereitung des Vorfalls (Post-Incident Review) aktualisiert die Schwellenwerte oder die Logik.
Schließen Sie den Kreis mit Reviews, nicht mit Schuldzuweisungen
Die Reporting-Disziplin des öffentlichen Sektors ist auch hier wichtig. Baselines, Abweichung, Verzögerung und Behebung geben Teams die Möglichkeit, eine fehlerhafte Quelle, einen sich ändernden Prozess und einen nicht mehr passenden Schwellenwert voneinander zu trennen. Wenn ein Schwellenwert in diesem Monat zu oft anschlägt, liegt das Problem möglicherweise am Metrikdesign, nicht an der Pipeline. Wenn er nie anschlägt, ist der Schwellenwert vielleicht zu locker oder das Signal zu vage.
Der Review-Rhythmus ist der Punkt, an dem Reporting zu einem lebendigen System wird – und an dem das Bereitstellungsmodell ebenso wichtig ist wie die Logik der Metriken. In-Database- und On-Premises-Setups verändern, wer die Nachweise sehen kann, wo die Prüfungen laufen und wie schnell die Operatoren handeln können. Ein Playbook, das diese Einschränkung ignoriert, bleibt in der Praxis wirkungslos und existiert nur auf dem Papier.
Reporting als Entscheidungsnachweis, nicht als Compliance-Nebensache
Ein Bericht, der lediglich mehr Diagramme enthält, hilft selten weiter. Meistens sorgt er nur für mehr Rauschen, mehr Uneinigkeit und mehr Zeit, die mit der Diskussion darüber verbracht wird, welche Zahl nun als Wahrheit gelten soll. Entscheidungsreifes Reporting beginnt mit einer einfacheren Frage: Wer benötigt die Informationen und was wird die Person damit tun.
Verschiedene Zielgruppen benötigen unterschiedliche Nachweise
Operatoren benötigen Signale, die sie schnell sichten können. Manager benötigen Trendkontexte und einen klaren Blick auf die Volatilität. Regulierungsbehörden und Führungskräfte benötigen Zusammenfassungen, die sie reproduzieren und verteidigen können. Diese Gruppen benötigen weder denselben Bericht noch dasselbe Detailniveau.
Der schwierigere Teil besteht darin, zu entscheiden, welche Metriken für die jeweilige Zielgruppe entscheidungsrelevant sind. Wie bereits erwähnt, erfassen Monitoring-Systeme oft Daten, die zwar vollständig aussehen, aber dennoch die anstehende Entscheidung des Nutzers nicht unterstützen. Deshalb gehören Diversitäts- und Bias-Dimensionen in das Reporting-Design, selbst wenn das Programm als rein operatives gestartet ist. Wenn unterversorgte Gruppen im Bericht nicht auftauchen, ist der Bericht unvollständig.
Ein von der Community validiertes Monitoring geht noch einen Schritt weiter. Das Standard-Reporting übersieht oft die gelebte Erfahrung, insbesondere dort, wo Serviceverfügbarkeit, Zugänglichkeit, Akzeptanz, Gerechtigkeit und Qualität für die Nutzer eine direkte Rolle spielen (Community-basiertes Monitoring – Evidence Brief). Automatisierte Prüfungen sind notwendig, ersetzen aber nicht das Feedback der von der Dienstleistung betroffenen Menschen.
Machen Sie Reporting standardmäßig prüfbar
Das Berichtsobjekt sollte Fakten von der Analyse trennen, eigenständig sein und auf bestätigten Informationen statt auf Gerüchten basieren. Dieser Standard gilt gleichermaßen für Incident-Zusammenfassungen, monatliche Geschäftsberichte und Berichte für Regulierungsbehörden. Es bedeutet auch, dass der Bericht auf die Quelle, den Schwellenwert und die ergriffene Maßnahme zurückverweisen sollte.
Die Reporting-Disziplin des öffentlichen Sektors beweist auch hier ihren Wert. Baseline, Abweichung, Verzögerung und Behebung helfen Teams, eine fehlerhafte Quelle, einen sich ändernden Prozess und einen nicht mehr passenden Schwellenwert zu unterscheiden. Wenn ein Schwellenwert in diesem Monat zu oft anschlägt, liegt das Problem möglicherweise am Metrikdesign, nicht an der Pipeline. Wenn er nie anschlägt, ist der Schwellenwert vielleicht zu locker oder das Signal zu vage.
Der Review-Rhythmus ist der Punkt, an dem Reporting zu einem lebendigen System wird, und das Bereitstellungsmodell ist dabei ebenso wichtig wie die Logik der Metriken. In-Database- und On-Premises-Setups verändern, wer die Nachweise sehen kann, wo die Prüfungen laufen und wie schnell die Operatoren handeln können. Ein Playbook, das diese Einschränkung ignoriert, bleibt in der Praxis wirkungslos und existiert nur auf dem Papier.


