ETL-Datenpipeline-Architektur und Zuverlässigkeits-Leitfaden
|
7
min. Lesezeit

Ein Benchmark im Jahr 2026 ergab, dass 97 % der führenden Daten- und Technologieverantwortlichen angeben, dass Pipeline-Fehler Analytics- oder KI-Initiativen verlangsamt haben, bei einem durchschnittlichen monatlichen Geschäftsrisiko von rund 3 Millionen US-Dollar (StorageNewsletter-Berichterstattung über den Benchmark). Das ändert die Art und Weise, wie ich eine ETL-Datenpipeline bewerte. Die Frage ist nicht, ob ein Job abgeschlossen wurde. Es geht darum, ob die Pipeline vertrauenswürdige Daten pünktlich geliefert hat, mit genügend Nachweisen, um zu erklären, was passiert ist, als sich etwas geändert hat.
Eine ETL-Pipeline wird oft wie eine Rohrleitung behandelt. In einem Unternehmen verhält sie sich eher wie ein Produktionsdienst. Sie hat Abhängigkeiten, Serviceerwartungen, Fehlermodi, Wiederherstellungsverfahren und Konsumenten, die auf Basis ihrer Ergebnisse finanzielle, operative oder regulatorische Entscheidungen treffen. Zuverlässigkeitsarbeit ist daher keine Randwartung. Sie ist Teil des Datenprodukts.
Inhaltsverzeichnis
Warum ETL-Pipelines auch 2026 noch wichtig sind
Die geschäftlichen Kosten eines Pipeline-Vorfalls sind im Scheduler selten direkt sichtbar. Ein fehlgeschlagener Task mag wie ein einzelner roter Status aussehen, aber die Folgen können veraltete Dashboards, verzögerte Abstimmungen, unterbrochenes Modelltraining, manuelle Untersuchungen und Entscheidungen auf Basis unvollständiger Informationen sein. Der oben zitierte Benchmark ergab, dass Pipeline-Fehler bereits Analytics- und KI-Programme in Führungsteams verlangsamen, was Observability zu einer geschäftlichen Priorität statt zu einer bloßen Dashboard-Funktion macht.
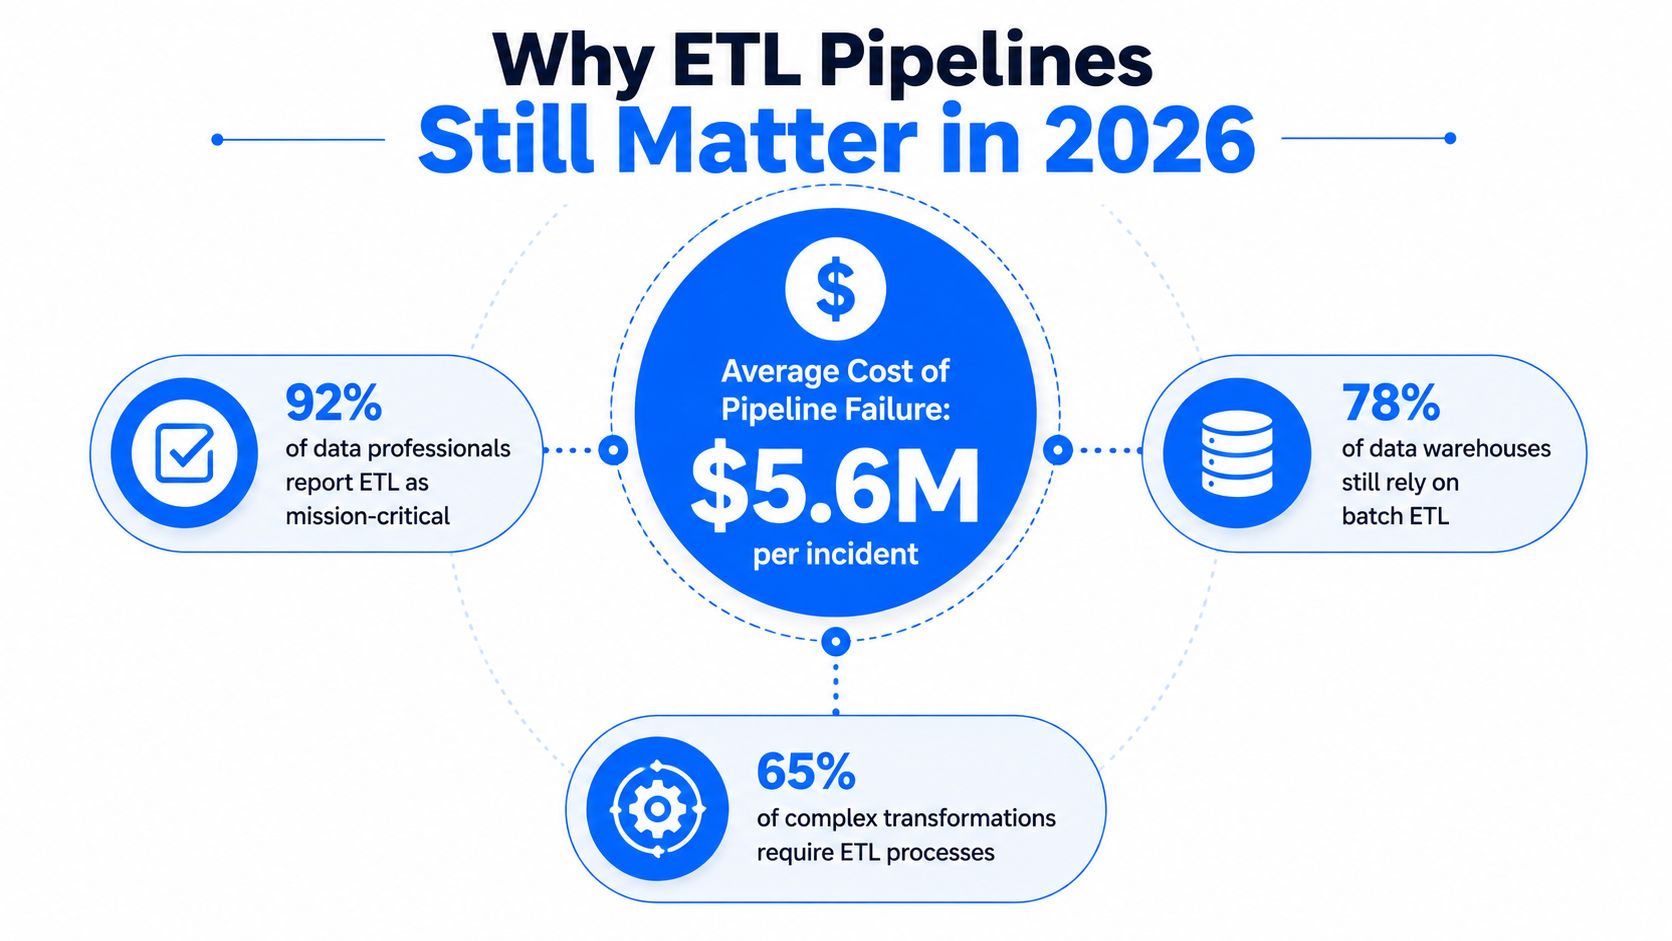
Das Bild enthält Behauptungen, die nicht Teil der verifizierten Daten für diesen Artikel sind, einschließlich der angegebenen Fehlerkosten und der Prozentsätze in den umgebenden Statistikblasen. Diese Zahlen sollten nicht als Beleg herangezogen werden. Der verifizierte Benchmark stützt eine andere, ebenso dringliche Schlussfolgerung: Pipeline-Ausfälle verursachen bei den im Bericht vertretenen Organisationen ein durchschnittliches monatliches Geschäftsrisiko von etwa 3 Millionen US-Dollar (StorageNewsletter).
ETL bleibt grundlegend
ETL etablierte sich in den frühen 1990er Jahren als zentrales Muster für Unternehmensdaten, als Data Warehouses im Mainstream-Analytics Einzug hielten. In dieser Ära entstanden dedizierte Integrationsprodukte, darunter Prism Solutions (gegründet 1988), Informatica (gegründet 1993) und DataStage im gleichen Zeitraum. Bis 1995 war das Data Warehousing Institute gegründet worden, was zeigt, wie schnell die Warehouse-gesteuerte Datenbewegung zu einer eigenständigen Kategorie von Unternehmenssoftware wurde (historischer Überblick über Data Warehouses).
Das Muster hat Bestand, weil viele Organisationen nach wie vor eine kontrollierte, reproduzierbare und prüfbare Transformation benötigen, bevor Daten analytische Systeme erreichen. In Finanz-, Gesundheits-, Telekommunikations- und öffentlichen Sektoren können rohe Quelldaten oft nicht sofort als vertrauenswürdig eingestuft werden. Sie benötigen definierte Mappings, Validierungsnachweise, Abstimmungslogik, Zugriffskontrollen und wiederholbare Durchläufe.
ELT und Streaming haben den Gestaltungsspielraum erweitert, aber ETL nicht verdrängt. Eine moderne Plattform kann Change Data Capture für eine Quelle, Batch-ETL für ein reguliertes Hauptbuch, ELT für explorative Warehouse-Modelle und Streaming für zeitsensible Ereignisse nutzen. Die sinnvolle Architektur ist diejenige, die dem Datenrisiko, den Latenzanforderungen, dem Speicherort der Verarbeitung, den governance-Verpflichtungen und den Wiederherstellungskapazitäten entspricht.
Für Implementierungsdetails können Teams die digna Best Practices für Datenpipelines zusammen mit ihren bestehenden Orchestrierungs- und governance-Standards nutzen. Das praktische Ziel ist einfach: Machen Sie das Pipeline-Verhalten auf geschäftlicher Ebene sichtbar, bevor ein ausgebliebener Ladevorgang zu einem Analytics-Vorfall wird.
Die Kernkomponenten der ETL-Architektur verstehen
Eine ETL-Datenpipeline besteht aus drei prägenden Bewegungen: Extraktion (extract), Transformation (transform) und Laden (load). In der Produktion befinden sich diese Phasen normalerweise in einer größeren Kontrollstruktur, die Staging, Checkpoints, Abhängigkeiten, Wiederholungsversuche, Data Validation und betriebliche Nachweise verwaltet.
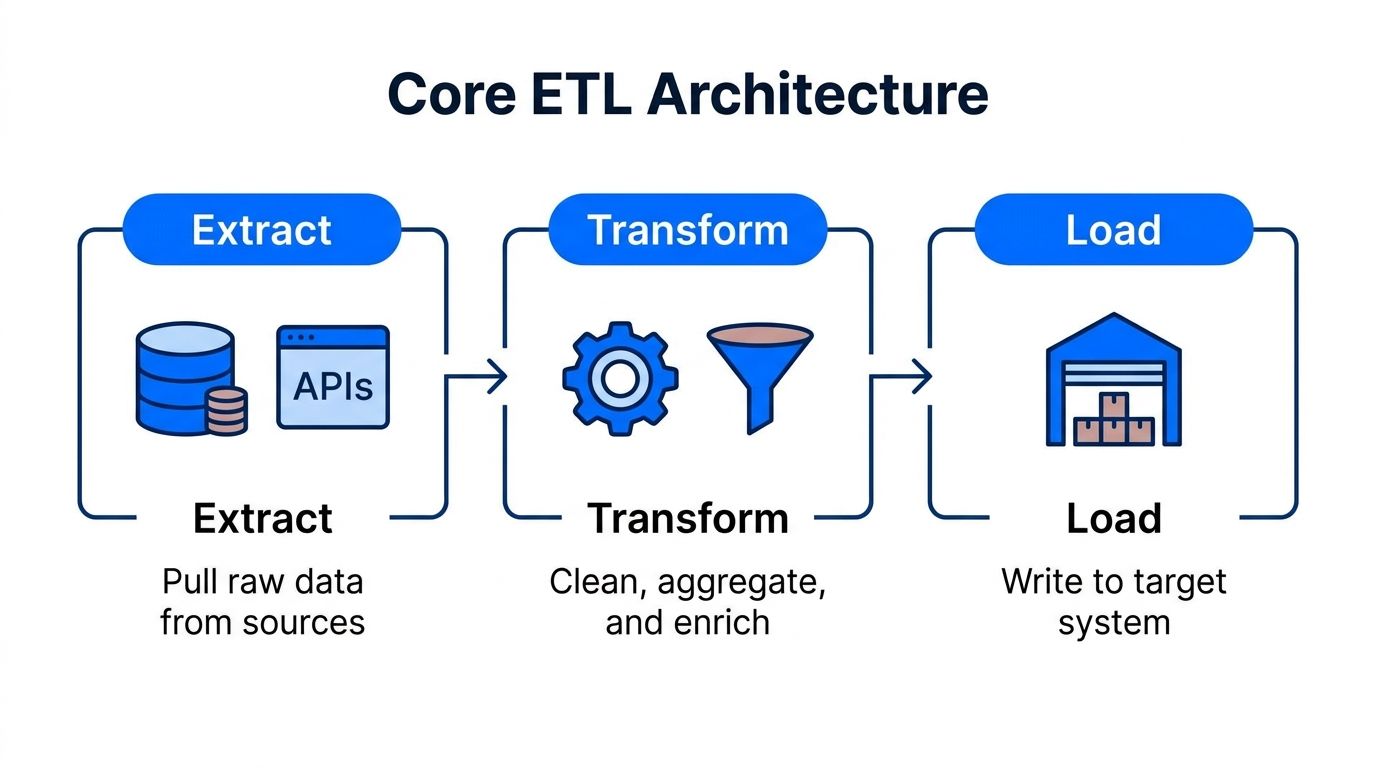
Extrahieren an der Quellgrenze
Die Extraktion ruft Daten aus operativen Datenbanken, APIs, Dateien, SaaS-Anwendungen oder anderen Systemen ab. Der schwierige Teil ist nicht bloß die Anbindung an die jeweilige Quelle. Es geht darum, genügend Kontext zu bewahren, um zu wissen, was extrahiert wurde, wann es extrahiert wurde, welche Quellversion verwendet wurde und ob die Quelle eine vollständige Antwort zurückgegeben hat.
Ein resilienter Extraktor verwaltet inkrementelle Grenzen sorgfältig. Er zeichnet einen Checkpoint auf, z. B. die letzte akzeptierte Aktualisierungsmarkierung, und rückt diesen Checkpoint erst vor, wenn der nachgelagerte Schreibvorgang erfolgreich war. Wenn der Durchlauf mittendrin stoppt, kann die Pipeline an einer bekannten Position fortgesetzt oder wiederholt werden, anstatt raten zu müssen, was verarbeitet wurde.
Ein Staging-Bereich bietet eine weitere nützliche Grenze. Rohe Extrakte können vor der Transformation aufbewahrt werden, sodass Ingenieure das Verhalten der Quelle überprüfen, Transformationen wiederholen und Probleme mit der Verfügbarkeit der Quelle von Transformationsfehlern trennen können.
Transformieren in eine vertrauenswürdige Form
Bei der Transformation standardisiert die Pipeline Formate, wendet Geschäftsregeln an, filtert unbrauchbare Datensätze heraus, gleicht Entitäten ab und erstellt analytische Strukturen. Eine Kunden-ID muss möglicherweise systemübergreifend normalisiert werden. Zeitstempel benötigen eine gemeinsame Interpretation. Transaktionsdaten erfordern eventuell eine Duplikatsbereinigung und referenzielle Prüfungen, bevor sie das Reporting unterstützen können.
Halten Sie die Transformationslogik modular. Ein einzelnes monolithisches Skript erschwert es, ein fehlerhaftes Mapping zu isolieren oder festzustellen, welche Regel das Ergebnis verändert hat. Versionskontrollierte Komponenten, explizite Ein- und Ausgaben sowie testbare Funktionen machen Überprüfungen und Rollbacks wesentlich praktischer.
Laden mit Kontrolle
Beim Laden werden validierte Ergebnisse in ein Warehouse, einen Lake, einen operativen Datenspeicher oder ein anderes Ziel geschrieben. Ein zuverlässiger Loader unterscheidet zwischen einem abgeschlossenen und einem teilweise abgeschlossenen Schreibvorgang. Er nutzt nach Möglichkeit idempotentes Verhalten, protokolliert akzeptierte und abgelehnte Zeilen und macht den finalen Veröffentlichungsschritt explizit.
Die Orchestrierung sollte Abhängigkeiten koordinieren, anstatt Aufgaben nach einem festen Zeitplan zu starten. Für Teams, die die Quellseite dieser Architektur entwerfen, bietet der digna-Leitfaden für Daten-Ingestion-Pipelines einen nützlichen Bezugspunkt. Das wichtigste Designprinzip besteht darin, jede Phase als beobachtbaren Vertrag zu behandeln, nicht als undurchsichtige Übergabe.
Die Wahl zwischen ETL- und ELT-Ansätzen
ETL und ELT unterscheiden sich hauptsächlich darin, wo die Transformation stattfindet. ETL transformiert Daten, bevor sie in das Ziel geladen werden. ELT lädt zuerst Rohdaten und nutzt dann das Ziel-Warehouse oder den Lakehouse zur Transformation.
Keiner der beiden Ansätze ist universell überlegen. ETL kann die bessere Wahl sein, wenn sensible oder ungültige Datensätze gefiltert werden müssen, bevor sie in einen gemeinsam genutzten analytischen Speicher gelangen, wenn das Ziel über begrenzte Rechenleistung verfügt oder wenn eine kontrollierte Pre-Load-Darstellung für die Compliance erforderlich ist. ELT kann flexibler sein, wenn Teams den Rohdatenverlauf aufbewahren, Modelle iterieren und skalierbare Warehouse-Rechenleistung für Transformationen nutzen möchten.
Die Entscheidung hängt auch von der Fehlerbehebung ab. ETL kann die Menge an ungeeigneten Daten reduzieren, die das Ziel erreichen, aber ein Transformationsfehler kann eine vorgelagerte Wiederaufbereitung erzwingen. ELT bewahrt Rohdaten für eine spätere Modellierung auf, verlagert jedoch mehr Verantwortung in die Warehouse-governance, die Zugriffskontrolle, das Testen und das Compute-Management.
Eine nützliche Entscheidungsmatrix sieht wie folgt aus:
Faktor | Wählen Sie ETL, wenn | Wählen Sie ELT, wenn |
|---|---|---|
Compliance | Sensible Daten vor dem Laden transformiert oder eingeschränkt werden müssen | Rohdaten unter strengen Zugriffskontrollen aufbewahrt werden können |
Datenqualität | Die Pre-Load-Validierung ungeeignete Datensätze blockieren muss | Warehouse-Tests die Modelle nach dem Ingestieren steuern können |
Speicherort der Verarbeitung | Eine externe Verarbeitung verfügbar ist oder das Ziel nur über begrenzte Rechenleistung verfügt | Das Warehouse oder der Lakehouse ausreichende Transformationskapazitäten bietet |
Wiederverarbeitung | Der Pre-Load-Vertrag stabil ist und streng kontrolliert wird | Teams mit sich ändernder Geschäftslogik auf Rohdaten zurückgreifen müssen |
governance | Ein kuratiertes Ziel vor dem breiten Zugriff erforderlich ist | Rohdaten- und modellierte Zonen getrennt und verwaltet werden können |
Team-Skills | Ingenieure ihre Stärken in Integrationstools und prozeduralen Transformationen haben | Analysten und Ingenieure mit SQL-basierter Warehouse-Modellierung vertraut sind |
Architektur | Legacy-Datenbanken oder regulierte Batch-Workflows dominieren | Cloud-native Speicherung und elastische Warehouse-Verarbeitung zentral sind |
Betriebsmodell | Die Organisation Wert auf strenge Release-Freigaben vor der Veröffentlichung legt | Die Organisation schnelles Experimentieren mit rückverfolgbaren Modellen benötigt |
Hybride Designs sind aus gutem Grund üblich. Ein Team kann ETL verwenden, um sensible Felder zu tokenisieren und Quell-Ebene-Verträge durchzusetzen, und anschließend ELT für die nachgelagerte dimensionale Modellierung nutzen. Diese Anordnung bewahrt die Kontrolle an der Grenze, ohne die analytische Flexibilität einzubüßen.
Nutzen Sie die Erläuterung von digna zum Ingestieren von Daten, um die Ingestionsgrenze zu klären, bevor Sie ein Transformationsmuster auswählen. Die wichtigste Entscheidung ist nicht das Etikett. Es ist die Frage, ob die Architektur Datenrisiken, Kosten, Datenherkunft (Lineage) und Wiederherstellung für die Personen sichtbar macht, die für das Ergebnis verantwortlich sind.
Häufige Pipeline-Fehler und Wartungsaufwand
Ein grüner Scheduler-Status verbirgt weit mehr, als er über die Korrektheit der Pipeline verrät. Ein ETL-Job kann erfolgreich abgeschlossen werden, nachdem er eine unvollständige Datei ingestiert, einen geänderten Spaltentyp akzeptiert, veraltete Datensätze geladen oder ein technisch gültiges Ergebnis erzeugt hat, das Umsätze, Bestände oder Kundenaktivitäten falsch darstellt.
Schema-Drift ist eine häufige Quelle für stille Fehler. Angenommen, eine Quelle ändert customer_id von einer Ganzzahl in einen String oder benennt order_status um, während die Extraktion weiterhin Erfolg meldet. Die Transformation weist möglicherweise jede Zeile ab, wandelt Werte falsch um oder veröffentlicht ein Ergebnis, dessen Bedeutung sich geändert hat. Vergleichen Sie eingehende Metadaten bei jedem Durchlauf mit einer versionierten Baseline, klassifizieren Sie die Änderung und stellen Sie Abweichungen unter Quarantäne, bevor das vollständige Laden ausgeführt wird. Der Leitfaden für Schema-Drift-Vorfälle bietet nützlichen Kontext für den Umgang mit diesen Ereignissen.
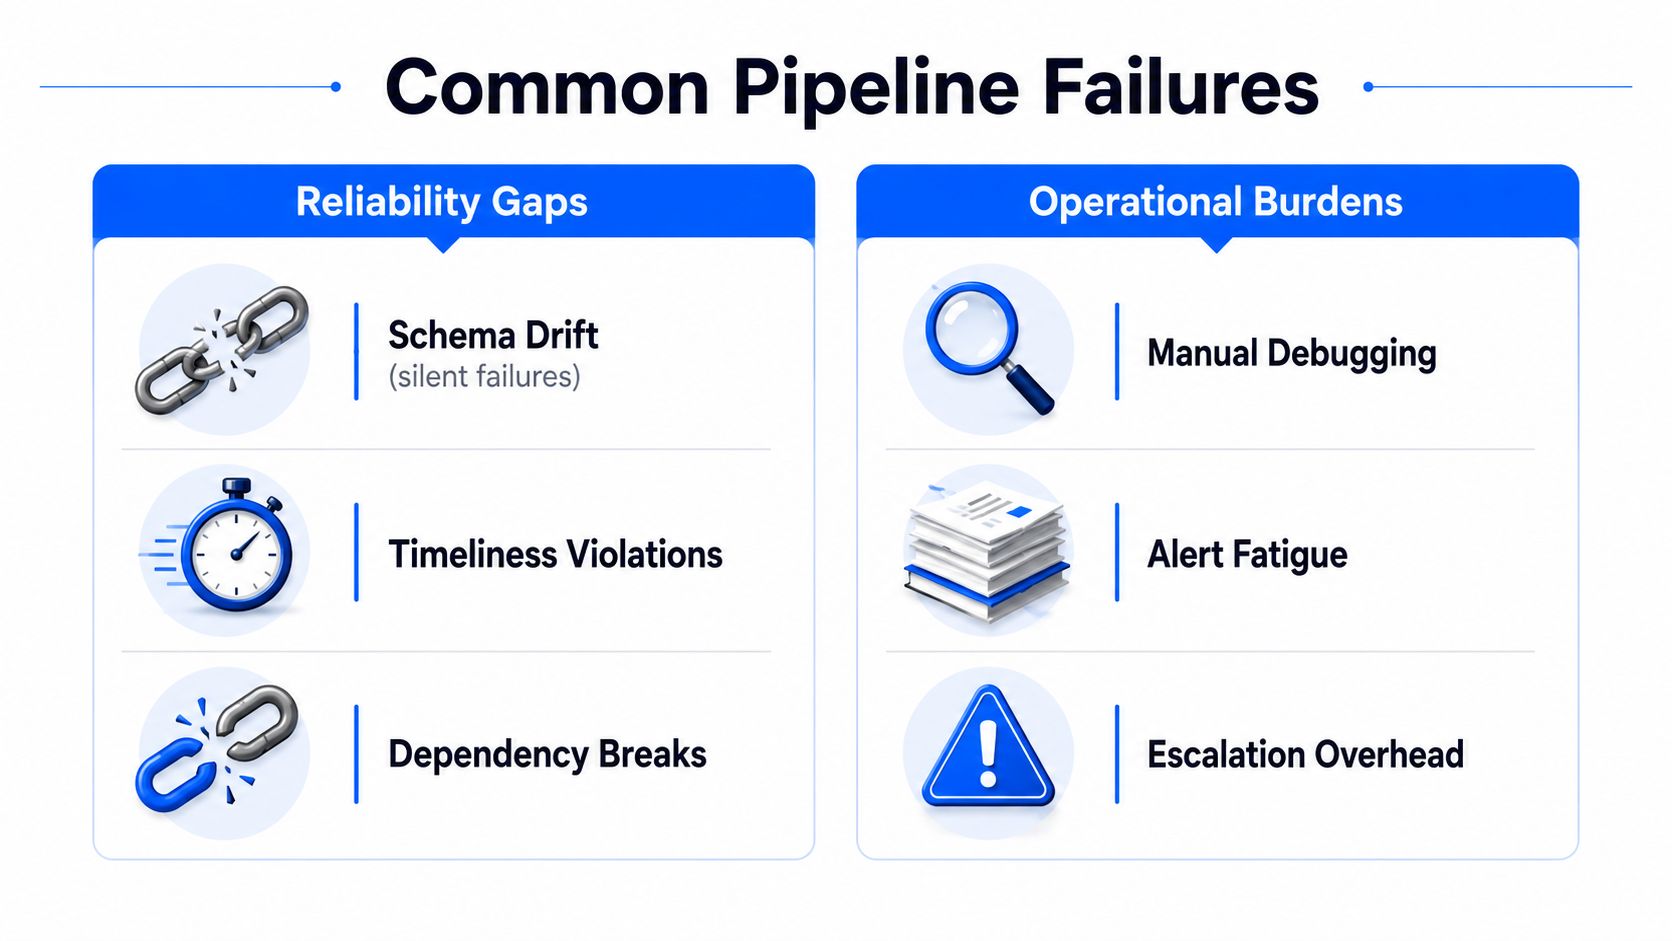
Was herkömmliches Monitoring übersieht
Das Zählen fehlgeschlagener Jobs erfasst explizite Ausführungsfehler, während ein vertrauenswürdiger Betrieb umfassendere Signale erfordert:
Durchsatz: Vergleichen Sie die erwartete Datenbewegung mit den tatsächlich verarbeiteten Zeilen oder Bytes.
Aktualität (Freshness): Bestätigen Sie, dass die neuesten Datensätze innerhalb des vereinbarten Servicefensters eingetroffen sind.
Verfügbarkeit: Verfolgen Sie, ob die Pipeline und ihre Abhängigkeiten nutzbar sind, wenn die Konsumenten sie benötigen.
Wiederherstellungszeit: Messen Sie, wie lange Teams benötigen, um eine vertrauenswürdige Bereitstellung wiederherzustellen.
Fehlerverhalten: Beobachten Sie abgelehnte Zeilen, Wiederholungsversuche, das Wachstum von Dead-Letter-Queues und wiederkehrende Teilfehler.
Timeliness-Prüfungen sollten Quell-Zeitstempel wie created_at oder updated_at mit Heartbeat-Signalen und Vergleichen zwischen Zeitplan und Verfügbarkeit kombinieren. Diese Kontrollen können verzögerte Ingestionen aufdecken, bevor ein nachgelagerter Bericht sichtbar fehlschlägt (Leitfaden zur Überwachung der Pünktlichkeit).
Wartung ist eine wirtschaftliche Einschränkung
Legacy- und Do-it-yourself-Pipelines brechen häufiger ab als vollständig verwaltete ELT-Systeme. Laut einer Umfrage von Ende 2025, die in der Berichterstattung von TechTarget thematisiert wird, verbringen Data Engineers 53 % ihrer Zeit mit der Pipeline-Wartung. Verwaltetes ELT nimmt einem die Zuverlässigkeitsarbeit nicht ab. Teams benötigen weiterhin Verträge, klare Verantwortlichkeiten, Wiederherstellungsverfahren und Tests. Die betriebliche Entscheidung sollte Arbeitsaufwand, Ausfallzeiten und die Kosten für die Untersuchung irreführender Ergebnisse berücksichtigen.
Observability verändert diese Rechnung, indem sie Symptome mit Auswirkungen und wahrscheinlichen Ursachen verknüpft. Der Captapi-Leitfaden für resiliente Systeme bietet eine umfassendere Abhandlung über Resilienztests und Fehlerverhalten. Warnungen sollten betroffene Datensätze, die Dringlichkeit und den nächsten Schritt identifizieren, anstatt nur eine weitere Warteschlange mit ungeklärtem Rauschen zu erzeugen.
Eine gezielte Diskussion über die Früherkennung finden Sie in der digna-Analyse darüber, warum Datenpipelines in der Produktion fehlschlagen. Das praktische Ziel ist ein kürzerer Weg von einer Quelländerung zu einer sicheren operativen Entscheidung, wodurch Pipeline-Sichtbarkeit von einem Wartungsaufwand zu einem echten Gewinn für eine verlässliche Datenbereitstellung wird.
Zuverlässigkeit mit Qualitätskontrollen aufbauen
Zuverlässigkeit hängt von Kontrollen ab, die in der gesamten Pipeline platziert sind. Schema-Tracking erfasst strukturelle Änderungen, Data Validation prüft die inhaltliche Bedeutung der Daten, das Timeliness-Monitoring identifiziert Bereitstellungsprobleme und betriebliche Metriken zeigen eine sinkende Ausführungsqualität auf, selbst wenn Jobs noch erfolgreich abgeschlossen werden. Zusammen begrenzen diese Kontrollen die versteckten Kosten von Fehlern, einschließlich Wiederaufbereitung, manueller Untersuchungen, verzögerter Entscheidungen und des Vertrauensverlusts in nachgelagerte Ergebnisse.
Beim Ingestieren ansetzen
Behandeln Sie Schema-Drift an der Quellgrenze, bevor eine geänderte Struktur Transformationen und nachgelagerte Leser erreicht. Erstellen Sie eine versionierte Baseline für jede wichtige Quelle, vergleichen Sie bei jedem Durchlauf die eingehenden Metadaten und klassifizieren Sie Änderungen nach Risiko.
Das Hinzufügen eines kompatiblen Feldes erfordert möglicherweise nur eine Überprüfung, ohne einen Ausfall zu verursachen. Ein entferntes Feld, eine inkompatible Typänderung oder ein umbenannter Business Key sollte den betroffenen Datenfluss in der Regel stoppen oder unter Quarantäne stellen, bis ein Verantwortlicher ihn explizit neu zertifiziert. Canary-Runs und Schema-Registries ermöglichen es Teams, die Kompatibilität zu testen, bevor das vollständige Laden gestartet wird.
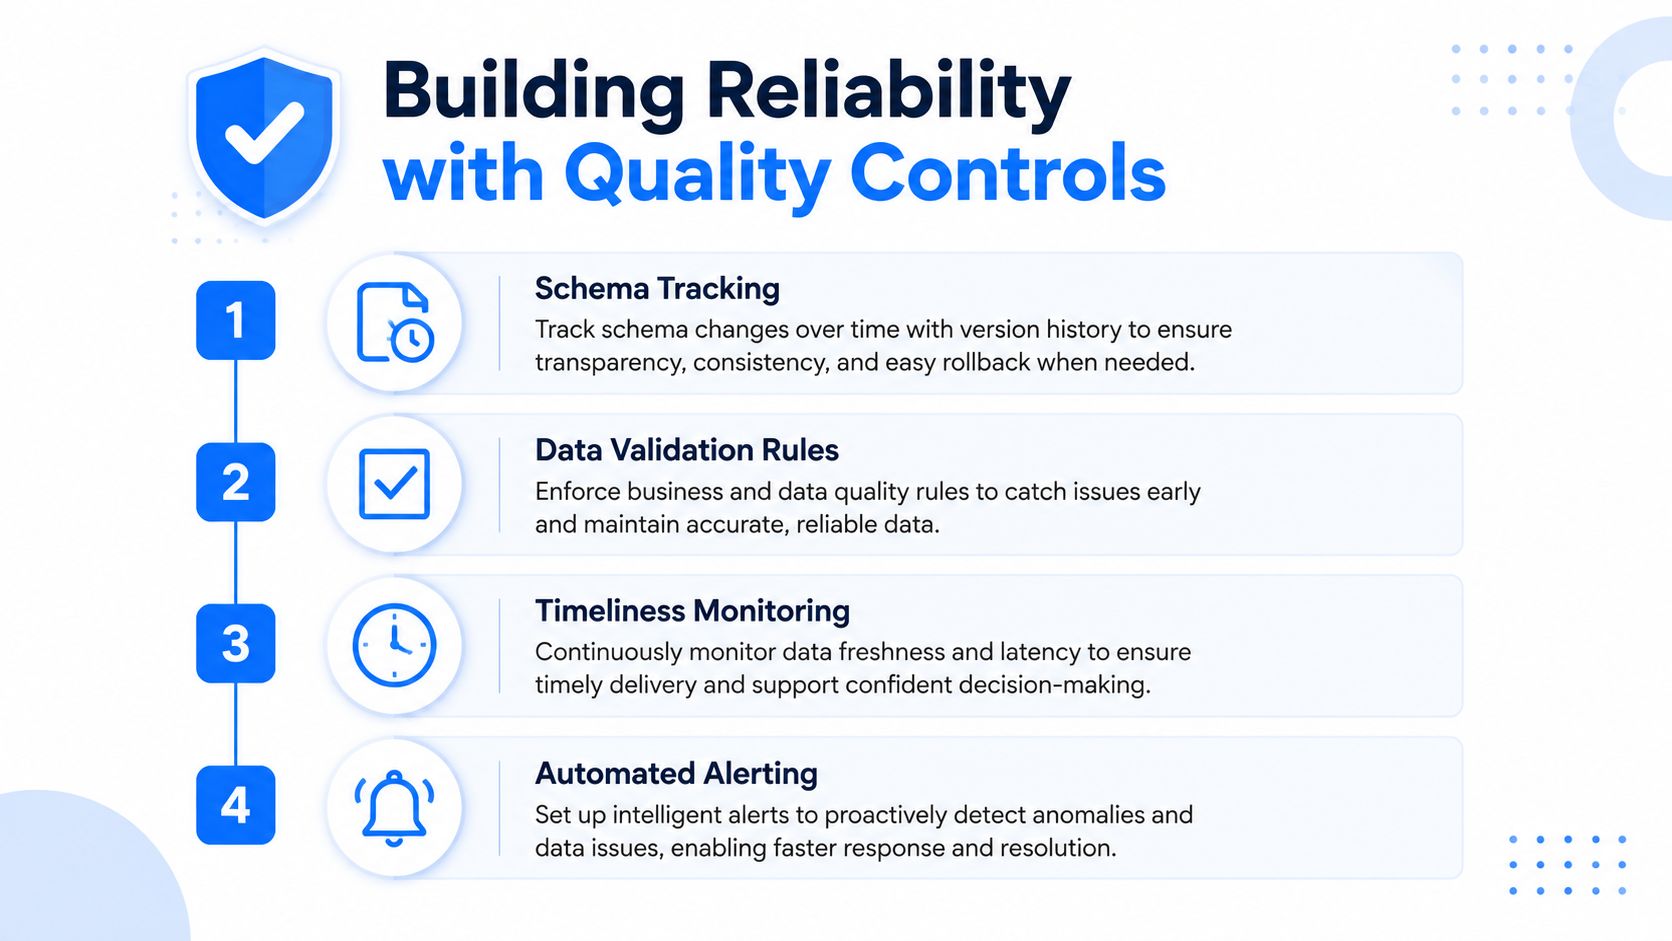
Datensätze und Beziehungen validieren
Geschäftsregeln übersetzen Qualitätserwartungen in Entscheidungen, die Systeme automatisiert testen können. Zu den Kontrollen in Unternehmen gehören beispielsweise Toleranzbänder für Zeilenabweichungen von ±30 %, eine maximale Nullwert-Rate bei E-Mails von unter 5 % und eine Regel zur referenziellen Integrität, die vorschreibt, dass jede order.customer_id in der Kundentabelle existieren muss (Beispiele für ETL-Qualitätskontrollen).
Diese Schwellenwerte sind keine universellen Standardwerte. Es handelt sich um explizite Vereinbarungen, die von den Datenverantwortlichen genehmigt, dokumentiert und überprüft werden sollten, wenn sich das Verhalten der Quelle ändert. Die Validierung auf Datensatzebene liefert zudem Audit-Nachweise, da sie zeigt, welche Regel fehlgeschlagen ist und welche Datensätze betroffen waren. Wissenschaftliche Arbeiten zur Verifizierung von Geschäftsregeln für die Datenqualität unterstützen die Bewertung der Qualität anhand definierter Regeln. Für Implementierungshinweise siehe die digna-Analyse von Datenvalidierungsregeln und kontinuierlicher Datenqualität.
Bereitstellung und Wiederherstellung überwachen
Eine Pipeline kann jeden Inhaltstest bestehen und dennoch ihre geschäftliche Deadline verpassen. Definieren Sie Aktualitätserwartungen basierend auf Quell-Zeitstempeln, erwarteten Eingangsmustern und nachgelagerten Serviceanforderungen. Melden Sie fehlende, verspätete oder verfrühte Bereitstellungen, wenn diese Ereignisse auf ein vorgelagertes Problem oder ein Scheduling-Problem hinweisen.
Verfolgen Sie eingehende und ausgehende Zeilen, abgelehnte Zeilen, Dauer, Fehleranzahl und Aktualität für jede Phase. Experten empfehlen, Fehlerraten unter 0,1 % anzustreben, Raten über 5 % als Anzeichen für einen systemischen Fehler zu behandeln, eine Verfügbarkeit von 99,9 % aufrechterzuhalten und den Dienst in unter 30 Minuten wiederherzustellen (ETL-Benchmarking-Leitfaden).
Betriebsregel: Eine Warnung sollte den Datensatz, den verletzten Vertrag, die wahrscheinliche Abhängigkeit, den geschäftlichen Verantwortlichen und die nächste sichere Maßnahme identifizieren.
Diese Kontrollen bilden einen geschlossenen Betriebskreislauf. Eine Erkennung ohne Quarantäne lässt fehlerhafte Daten durchschlüpfen. Eine Data Validation ohne Timeliness-Prüfung liefert Konsumenten veraltete Ergebnisse. Metriken ohne klare Verantwortlichkeit erzeugen zwar Diagramme, aber keine Wiederherstellung. Observability verbindet jedes Signal mit einer priorisierten Reaktion. Das senkt den Wartungsaufwand und macht eine verlässliche Datenbereitstellung zu einer steuerbaren operativen Disziplin.
Wie Data Observability den Betrieb verändert
Herkömmliches Monitoring fragt, ob ein Task gelaufen ist. Data Observability fragt, ob sich die Daten wie erwartet verhalten haben, ob Konsumenten sie pünktlich erhalten haben und welche Änderung die Abweichung erklärt.
Betrachten Sie eine Pipeline im Finanzdienstleistungsbereich, die Transaktionsdaten aus mehreren operativen Systemen empfängt. Ein Quellteam fügt ein Feld hinzu und ändert einen Typ, ohne sich mit dem Datenplattform-Team abzustimmen. Ein Scheduler meldet für die Extraktion möglicherweise Erfolg, während ein nachgelagertes Modell Werte verwirft oder seine Aggregation ohne Benachrichtigung ändert. Schema-Tracking kann die strukturelle Änderung bereits beim Ingestieren erkennen, den betroffenen Datenfluss unter Quarantäne stellen und Ingenieuren Nachweise liefern, bevor ein Berichtszyklus von den fehlerhaften Daten abhängt.
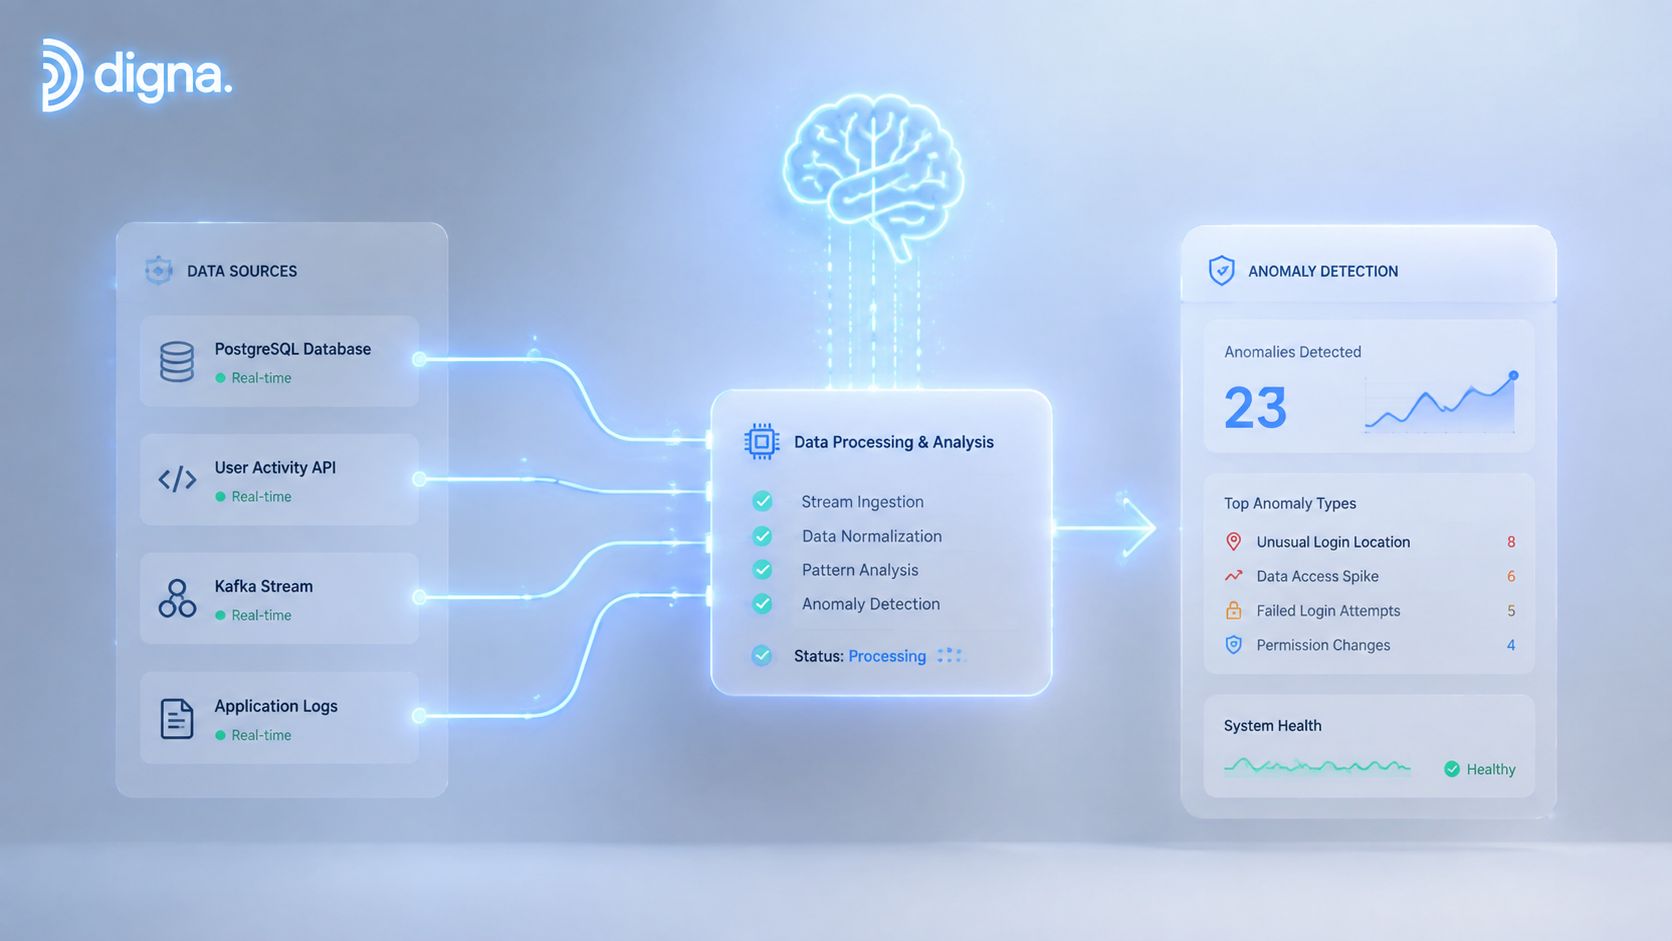
Pipelines im Gesundheitswesen erzeugen einen anderen Druck. Ein Datensatz kommt zwar mit dem gewohnten Schema an, weist aber ein ungewöhnliches Vollständigkeitsmuster auf, da ein erheblicher Teil der erwarteten Datensätze fehlt. Eine anomaliebasierte Baseline-Erkennung kann diese Verhaltensänderung markieren, während Validierungsprüfungen die erforderlichen Beziehungen und Geschäftsregeln testen können. Das Timeliness-Monitoring unterscheidet dann eine verzögerte Datenlieferung von einer Lieferung, die zwar pünktlich eintraf, aber untypische Inhalte enthält.
Telekommunikationsteams verwalten oft riesige Mengen an operativen und Kundendaten über heterogene Systeme hinweg. Eine nützliche Observability-Ebene sollte das Plattformverhalten mit dem Datenverhalten verknüpfen, damit Ingenieure zwischen einem Workload-Problem, einem Quellausfall, einer Schemaänderung und einem Qualitätsfehler unterscheiden können. Für Teams, die sowohl Datenplattformen betreiben als auch Reliability Engineering praktizieren, bieten Ressourcen zum Thema Infrastruktur-Monitoring für SREs einen relevanten Kontext für das Verständnis von Signalen, Abhängigkeiten und Incident Response.
digna kann in dieser Kategorie als eine Option dienen. Sie läuft direkt in der Kundenumgebung, führt Prüfungen in der Datenbank durch, überwacht Anomalien, Timeliness, Validierungsregeln, Schemaänderungen sowie Plattformmetriken und unterstützt die Bereitstellung in der Private Cloud oder On-Premises. Dank ihrer modularen Struktur kann ein Team mit einer einzelnen Monitoring-Funktion beginnen und diese auf kritische Tabellen und Pipelines ausweiten, während eine gemeinsame Benutzeroberfläche Ingenieuren, Analysten und Stakeholdern eine einheitliche Sicht auf Vorfälle und Trends bietet.
Dieser strategische Wandel macht sich im Workflow messbar bemerkbar, selbst wenn die Daten an Ort und Stelle bleiben. Ingenieure verbringen weniger Zeit damit, das Vorliegen eines Fehlers zu beweisen, und mehr Zeit damit, zu entscheiden, ob sie den Fehler blockieren, wiederholen, beheben oder die Auswirkungen kommunizieren sollen.
Implementierung von Observability in Ihrer Umgebung
Beginnen Sie mit den Datensätzen, die klare geschäftliche Auswirkungen haben. Kartografieren Sie deren Quellen, Verantwortliche, nachgelagerte Konsumenten, das erwartete Lieferverhalten, Schlüsselelder und Wiederherstellungsabhängigkeiten. Fangen Sie nicht damit an, sofort jede einzelne Tabelle zu instrumentieren. Ein eng gefasster erster Fokus führt zu klareren Zuständigkeiten und deckt Lücken in Verträgen auf.
Erstellen Sie als Nächstes eine Baseline für jeden ausgewählten Datensatz. Erfassen Sie das normale Datenvolumen, das Eingangsverhalten, die Schema-Struktur, Nullwert-Muster und Validierungsergebnisse. Richten Sie Warnungen für Abweichungen ein, die ein Handeln erfordern, und leiten Sie diese an das Team weiter, das die Quelle, die Pipeline oder das Ziel anpassen kann. Eine Warnung, die niemanden erreicht, der sie beheben kann, ist lediglich eine Dokumentation des Scheiterns.
Fügen Sie Kontrollen hinzu, ohne Ihren bestehenden Scheduler zu ersetzen. Airflow, dbt, Informatica, Talend und Spark können die Transformationen weiterhin orchestrieren, während eine Observability-Ebene das Verhalten drumherum bewertet. Beginnen Sie im reinen Monitoring-Modus, falls das Blockieren von Ladevorgängen unnötige Risiken birgt, und stufen Sie Prüfungen mit hoher Zuverlässigkeit später zu Quarantäne- oder Release-Freigaben auf.
Vorfälle kollaborativ lösen
Definieren Sie ein Ticket für Vorfälle, das die verletzte Erwartung, die betroffenen Daten, den Zeitpunkt der ersten Erkennung, den aktuellen Status, den Verantwortlichen, die Behebung und Folgemaßnahmen enthält. Analysieren Sie wiederkehrende Fehler nach ihren geschäftlichen Auswirkungen, nicht nach der Anzahl der Warnmeldungen. Ein verspäteter Datensatz mit geringer Priorität sollte hinter einer subtilen Schemaänderung in einem regulatorischen Feed zurückstehen, selbst wenn letztere keinen Fehler im Scheduler verursacht hat.
Messen Sie, ob die Praxis die Zeit bis zur Erkennung, den Untersuchungsaufwand, wiederkehrende Fehler, veraltete Lieferungen und abgelehnte Daten reduziert. Halten Sie die Überprüfungen an geschäftliche Ergebnisse gekoppelt, wie z. B. verlässliche Berichte und sicherere KI-Eingabedaten. Observability wird zu einem strategischen Vorteil, wenn Führungskräfte sehen können, welche Zuverlässigkeitsinvestitionen Entscheidungen schützen und welche Pipeline-Änderungen neue Risiken bergen.
digna bietet In-Environment-Data-Observability für ETL-Pipelines, einschließlich Anomalieerkennung, Schema-Tracking, Timeliness-Monitoring, Data Validation auf Datensatzebene und Plattformmetriken. Besuchen Sie digna, um zu prüfen, wie das modulare Bereitstellungsmodell Ihrem Team helfen kann, Pipeline-Risiken früher zu erkennen und Zuverlässigkeitsarbeit in eine messbare Betriebspraxis zu verwandeln.
Häufig gestellte Fragen
Was kostet ein Pipeline-Ausfall tatsächlich?
Ein Benchmark von 2026 fand, dass 97 % der leitenden Daten- und Technologieverantwortlichen sagen, Pipeline-Ausfälle hätten Analytics- oder KI-Initiativen verlangsamt, bei durchschnittlich rund 3 Millionen USD monatlicher Geschäftsexposition. Die Kosten erscheinen selten im Scheduler, weshalb sie unbudgetiert bleiben.
Warum zählt ETL neben ELT und Streaming weiterhin?
Weil viele Organisationen Transformationen weiterhin kontrolliert, reproduzierbar und prüfbar brauchen, bevor Daten analytische Systeme erreichen. ELT und Streaming haben den Entwurfsraum erweitert, diese Anforderung aber nicht beseitigt.
Wann wurde ETL zum Standardmuster?
In den frühen 1990er Jahren, als Data Warehouses in die Breite der Analytik rückten. In dieser Zeit entstanden dedizierte Integrationsprodukte, darunter Prism Solutions, gegründet 1988, Informatica, gegründet 1993, und DataStage im selben Zeitraum.
Welche Bewegungen definieren eine ETL-Pipeline?
Drei: Extrahieren an der Quellkante, Transformieren nach vereinbarter Logik und Laden ins Ziel. Sie getrennt zu benennen zählt, weil jede eigene Fehlermodi hat und jede eine andere Art von Defekt einlässt.
Was überwacht man über den Jobstatus hinaus?
Die vom Job erzeugten Daten. Ein Scheduler meldet den Abschluss, während die geschäftliche Exposition aus einer Ausgabe entsteht, die abschloss und falsch war. Verlässlichkeitsarbeit gehört deshalb auf die Datenebene und nicht nur auf die Orchestrierungsebene.


