Datenqualitätsmanagement: Ein praktischer Leitfaden
|
8
min. Lesezeit
Das Board-Paket ist bereits im Umlauf, als jemand das Problem bemerkt. Der Umsatz sieht schwächer aus als erwartet, eine Prognose verfehlt ihre Linie, und der FP&A-Analyst führt die Abfrage erneut aus, und dann noch einmal. Nichts im Dashboard deutet auf „defekt“ hin. Das Warehouse hat die Ladung akzeptiert, die Pipeline meldete Erfolg, und der Bericht wurde planmäßig aktualisiert.
Das ist die betriebliche Realität des Datenqualitätsmanagements. Schlechte Daten kommen selten mit einer eindeutigen Fehlermeldung an. Sie äußern sich als fragwürdiger Trend, fehlgeschlagene Abstimmung, regulatorische Ausnahme oder eine KI-Ausgabe, die plausibel klingt, bis jemand die zugrunde liegenden Datensätze überprüft. Ein tragfähiges DQM-Programm fängt diese Fehler dort ab, wo sie beginnen – in den Systemen und Tabellen, die die Daten erzeugen –, anstatt darauf zu warten, dass ein Verbraucher sie entdeckt.
Inhaltsverzeichnis
Wenn das Vertrauen in Daten stillschweigend bricht
Was Datenqualitätsmanagement wirklich bedeutet
Messen Sie den Fluss, nicht nur den Endpunkt
Ersetzen Sie Bereinigungsprojekte durch Betriebskontrollen
Kernkomponenten und die KPIs, die Qualität belegen
Governance und der betriebliche Workflow rund um die Qualität
Erstellen Sie einen Richtlinienkatalog
Betreiben Sie eine gemeinsame Reaktionsschleife
Eine Implementierungs-Roadmap, die Ergebnisse liefert
Starten Sie mit Kontrollen, denen die Menschen vertrauen können
Häufige Fehlermuster und die Behebungsmodelle, die funktionieren
Branchen-Anwendungsfälle für regulierte und hochvolumige Daten
Finanzen benötigen Kontrollen über Systemgrenzen hinweg
Das Gesundheitswesen benötigt Identitäts- und Eingangsdisziplin
Telekommunikation benötigt Nähe zur Ingestion
Der öffentliche Sektor benötigt belastbare Nachweise
Vom periodischen Aufräumen zu kontinuierlichen, vertrauenswürdigen Abläufen
Eine kompakte Checkliste für den Betrieb
Wenn das Vertrauen in Daten stillschweigend bricht
Das FP&A-Team hat sein Board-Paket verschickt. Die Umsatzzahl ist um 8 % zu niedrig ausgewiesen, weil eine Abrechnungstabelle nach einer Schema-Umbenennung in der Nacht vor dem Laden Zeilen verloren hat. Die Führungskraft, die das Paket prüft, bemerkt, dass sich die Trendlinie in die falsche Richtung biegt, aber die erste Reaktion ist nicht „Datenqualitätsvorfall“. Sie lautet „Das Geschäft hat den Plan verfehlt“.
Der Analyst prüft die Quellabfrage. Dann die Berichtabfrage. Dann eine Version mit einem anderen Join. Das Ergebnis sieht immer noch falsch aus. Ein Ingenieur findet schließlich eine verwaiste Spalte, die nach der Umbenennung übrig geblieben ist, während die nachgelagerte Logik immer noch das vorherige Feld erwartet. Der VP stellt die Frage, die jeder Datenverantwortliche irgendwann hört: Wie konnte das die Qualitätssicherung passieren?
Diese Frage legt die Schwäche von reinen Output-Tests offen. Ein Bericht kann eine Aktualisierungsprüfung bestehen, obwohl er unvollständige Daten enthält. Eine Pipeline kann erfolgreich abgeschlossen werden, während sie eine veraltete Partition liefert. Ein Modell kann technisch gültige Vorhersagen aus einer Feature-Tabelle generieren, deren Bedeutung sich weiter oben geändert hat. Der Fehler wird erst sichtbar, wenn die Daten mehrere Grenzen überschritten haben.
Praktische Regel: Behandeln Sie jede kritische Tabelle als Produktionsdienst mit einem Eigentümer, einem erwarteten Verhalten und einem Incident-Pfad.
Die geschäftlichen Folgen anhaltender Datenqualitätsprobleme gehen über ein ungenaues Dashboard hinaus. Führungskräfte erhalten unzuverlässige Zahlen, Analysten verlieren Zeit mit dem Beweis grundlegender Fakten, Regulierungsbehörden erhalten möglicherweise fehlerhafte Nachweise, und Kunden können auf fehlerhafte Workflows stoßen, die auf denselben Datensätzen aufbauen. Gartner schätzt, dass Unternehmen durch Datenqualitätsfehler durchschnittlich 12,9 Millionen US-Dollar pro Jahr verlieren, während Branchenberichte häufig angeben, dass schlechte Daten etwa 31 % des Geschäftsumsatzes beeinträchtigen. Diese Zahlen sind in der Marktforschung zum Datenqualitätsmanagement zusammengefasst.
Die praktische Reaktion besteht darin, die Pipeline selbst zu instrumentieren. Überprüfen Sie strukturelle Änderungen, Eingangsmuster, Datensatzverhalten, Geschäftsregeln und nachgelagerte Auswirkungen, bevor Verbraucher auf der Grundlage des Ergebnisses handeln. Jeder Bericht, jedes ML-Feature, jede regulatorische Einreichung und jeder kundenorientierte Prozess erbt das vorgelagerte Vertrauen, das Ihre Kontrollen entweder sichern oder nicht schützen können.
Was Datenqualitätsmanagement wirklich bedeutet
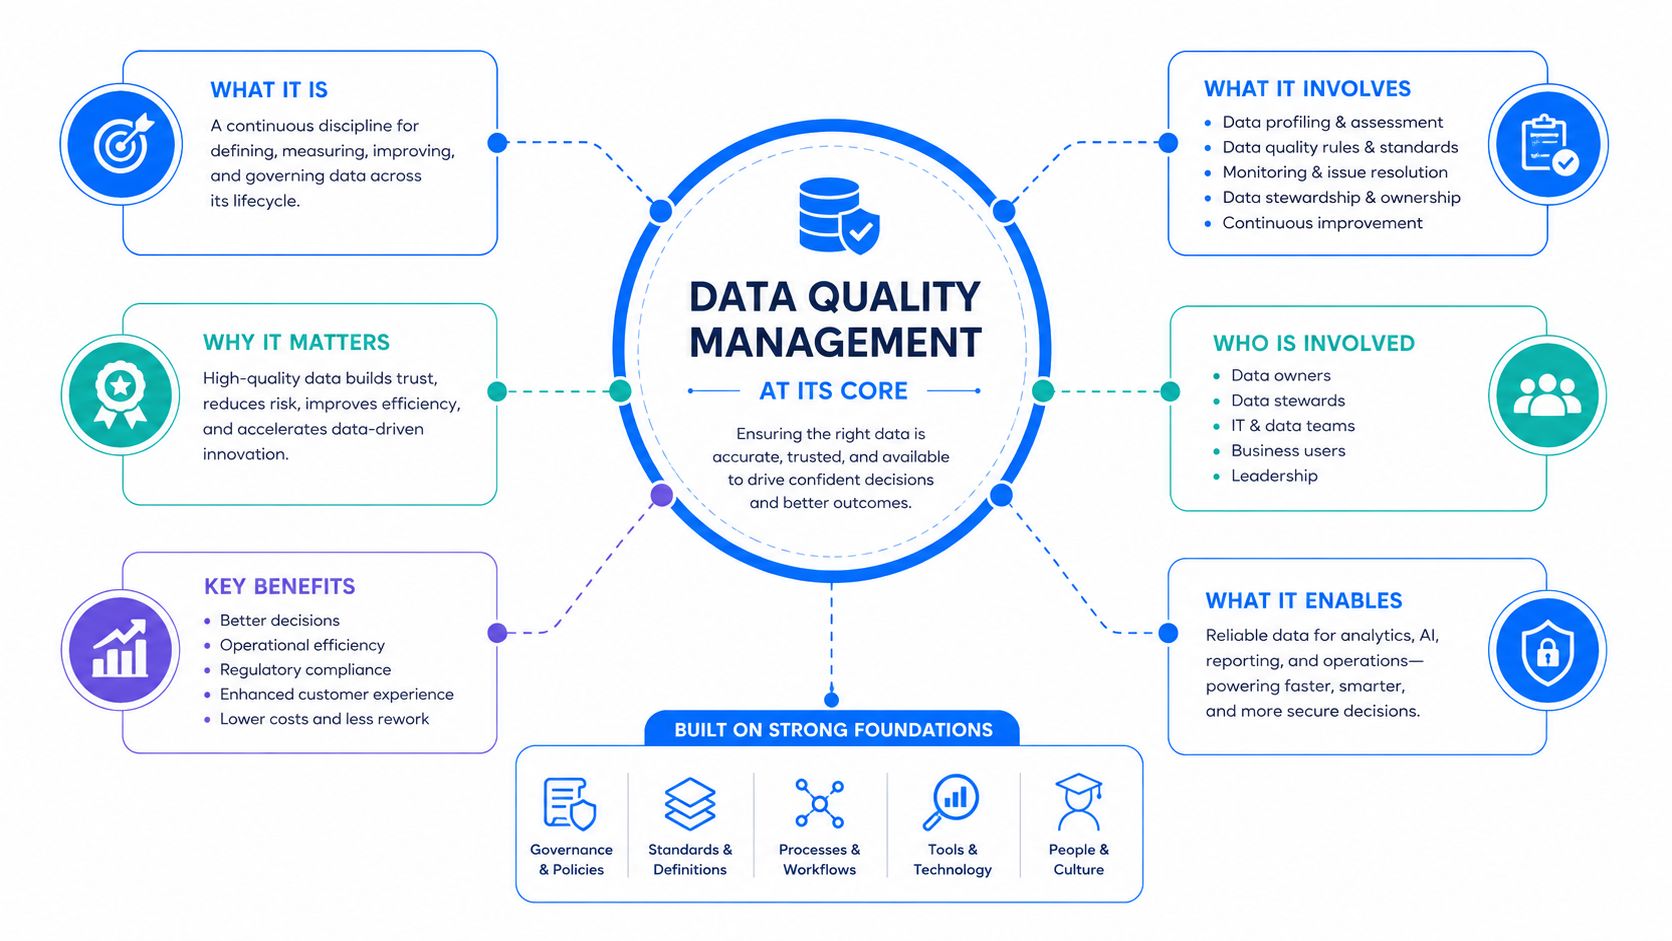
Datenqualitätsmanagement ist die kontinuierliche Praxis der Messung, Kontrolle und Behebung von Daten anhand definierter Standards während ihres gesamten Lebenszyklus. Dieser Lebenszyklus beginnt bei der Ingestion, setzt sich über die Transformation und Speicherung fort und endet, wenn ein Bericht, ein Modell, eine Anwendung oder ein betrieblicher Prozess die Daten verwendet.
Die Grenze zwischen DQM und angrenzenden Disziplinen ist wichtig:
Data Governance definiert Richtlinien, Eigentumsrechte, zulässige Nutzung und Entscheidungsrechte.
Data Observability macht Signale über Aktualität, Volumen, Schema und Verhalten sichtbar.
DQM übersetzt diese Erwartungen in ausführbare Kontrollen, die Fehler erkennen und die Behebung unterstützen.
Die Beziehung ist operativer Natur. Governance kann erfordern, dass eine Kundenkennung eindeutig und verfügbar ist, bevor die Abrechnung erfolgt. Observability kann zeigen, dass sich das Tabellenvolumen unerwartet geändert hat. DQM wendet die Regeln für Eindeutigkeit und Vollständigkeit an, erfasst die Ausnahme und leitet sie an einen verantwortlichen Eigentümer weiter. Dieser Vergleich von Datenqualität und Data Governance verdeutlicht die Abgrenzung.
Messen Sie den Fluss, nicht nur den Endpunkt
Die Qualitätskontrolle in der Fertigung bietet einen nützlichen Vergleich. Statistische Prozesslenkung in der Produktionslinie fängt Fehler ab, bevor ein Produkt das Werk verlässt. Die Inspektion fertiger Produkte an der Laderampe identifiziert zwar immer noch Probleme, kann aber Materialverschwendung, Nacharbeit oder eine bereits im Transport befindliche fehlerhafte Lieferung nicht verhindern.
Datenqualitätskontrollen gehören an die Grenzen von Ingestion, Transformation und Konsum, nicht nur in das finale Dashboard. Ein Datensatz kann das Schema erfüllen, während er zu spät ankommt, erforderliche Werte auslässt, mehrfach erscheint oder nicht mit einem verwandten System übereinstimmt. Der Kontrollpunkt sollte zum Fehlermodus und den Kosten für dessen spätere Entdeckung passen.
Ersetzen Sie Bereinigungsprojekte durch Betriebskontrollen
Eine Bereinigung liefert eine Momentaufnahme. Sie kann Werte standardisieren, Duplikate entfernen und bekannte Fehler beheben, doch diese Fehler kehren zurück, sobald sich der Quellprozess ändert. DQM bietet die permanent aktiven Kontrollen, die prüfen, ob Daten für ihren beabsichtigten Zweck geeignet bleiben.
In regulierten Umgebungen sollten Kontrollen innerhalb der Datenbank des Kunden ausgeführt werden, wann immer die Architektur dies zulässt. Regeln und Anomalieprüfungen bewerten Live-Tabellen, bewahren den lokalen Kontext und reduzieren unnötige Datenbewegungen. Der Kompromiss besteht darin, dass Teams Abfragekosten, Berechtigungen und Regeleigentum in derselben Betriebsumgebung verwalten müssen. Diese Disziplin erleichtert die Rückverfolgung von Ausnahmen, da das verantwortliche Team das Verhalten, den Verlauf und die Fehler der Tabelle dort überprüfen kann, wo sich die geschützten Daten bereits befinden.
Core Dimensions and the KPIs That Prove Quality
Ein DQM-Programm benötigt Dimensionen, die gemessen und auf die reagiert werden kann. Sechs Dimensionen bieten eine praktische Grundlage, aber der Schwellenwert muss die Nutzung des Datensatzes widerspiegeln. Ein Vollständigkeitsziel für ein optionales Marketing-Attribut sollte nicht wie ein Vollständigkeitsziel für ein regulatorisches Feld behandelt werden.
Dimension | KPI | Typischer Schwellenwert | Verantwortliche Rolle |
|---|---|---|---|
Genauigkeit | Übereinstimmungsrate mit einer vertrauenswürdigen Quelle oder erwarteten Verteilung | 99,5 % bei kritischen Feldern | Data Steward |
Vollständigkeit | Null- und Standardwertrate pro Spalte, segmentiert nach Datenebene | Nahe Null für erforderliche kritische Felder | Eigentümer des Quellsystems |
Konsistenz | Systemübergreifende Abstimmungsrate, z. B. Übereinstimmung von Kunden-IDs zwischen CRM und Abrechnung | Alle kritischen Abstimmungen vor der Berichterstattung gelöst | Integrationsteam |
Timeliness | Verzögerung zwischen Ereigniszeit und verfügbarer Zeit | Minuten für den Betrieb, bis zu 24 Stunden für Berichte | Plattformteam |
Gültigkeit | Konformität mit Schema, Regex-Mustern und Aufzählungswertlisten | Alle Pflichtregeln werden erfüllt | Entwicklung |
Eindeutigkeit | Duplikatsrate über natürliche und künstliche Schlüssel | Keine ungeklärten Duplikate auf kritischen Schlüsseln | MDM-Team |
Das Maß für die Genauigkeit benötigt einen Referenzpunkt. Vergleichen Sie kritische Werte mit einer vertrauenswürdigen Quelle, einem genehmigten Golden Record oder einer erwarteten Verteilung. Der Data Steward sollte die Definition von „vertrauenswürdig“ festlegen, da Ingenieure eine Übereinstimmungsrate berechnen können, ohne zu wissen, ob die Referenz selbst für den Zweck geeignet ist.
Vollständigkeit sollte nach Spalte und Ebene segmentiert werden. Eine Null-Rate kann sich hinter einem akzeptablen Tabellendurchschnitt verbergen, während ein einzelnes kritisches Feld in einem wesentlichen Teil der Datensätze fehlt. Quelleneigentümer müssen die Erfassung und vorgelagerte Standardwerte korrigieren, anstatt Analysten zu bitten, die Berichtsebene zu flicken.
Konsistenz deckt Konflikte zwischen Systemen auf. Der Abgleich von Kundenidentitäten zwischen einem CRM und einer Abrechnungsplattform ist ein einfaches Beispiel, aber dieselbe Logik gilt für Produkt-, Konto-, Anbieter- und Standortdaten. Integrationsteams sind Eigentümer des Mapping- und Abstimmungsvertrags.
Timeliness misst, ob Informationen rechtzeitig für die davon abhängige Entscheidung eintreffen. Ein technisches Papier aus dem globalen Datenmanagement-Benchmark des EDM Councils beschreibt Timeliness als einen normalisierten Wert im Bereich (0,1], wobei Werte näher an 1 eine bessere Aktualität darstellen. Dieser Rahmen ist nützlich, da ein Datensatz inhaltlich korrekt, aber nach Ablauf des Entscheidungsfensters unbrauchbar sein kann.
Gültigkeit und Eindeutigkeit vervollständigen das Kontrollset. Die Entwicklung ist Eigentümer der Format- und Zulässigkeitsregeln, während MDM-Teams für die Duplikatsbereinigung zuständig sind. Optimieren Sie die Gültigkeit nicht isoliert. Perfekt formatierte Daten, die zu spät ankommen, oder frische Daten mit doppelten Geschäftsschlüsseln stellen immer noch ein betriebliches Risiko dar.
Für eine breitere Auswahl an implementierungsorientierten Kennzahlen nutzen Sie diesen Leitfaden für Datenqualitätsmetriken.
Governance und der betriebliche Workflow rund um die Qualität
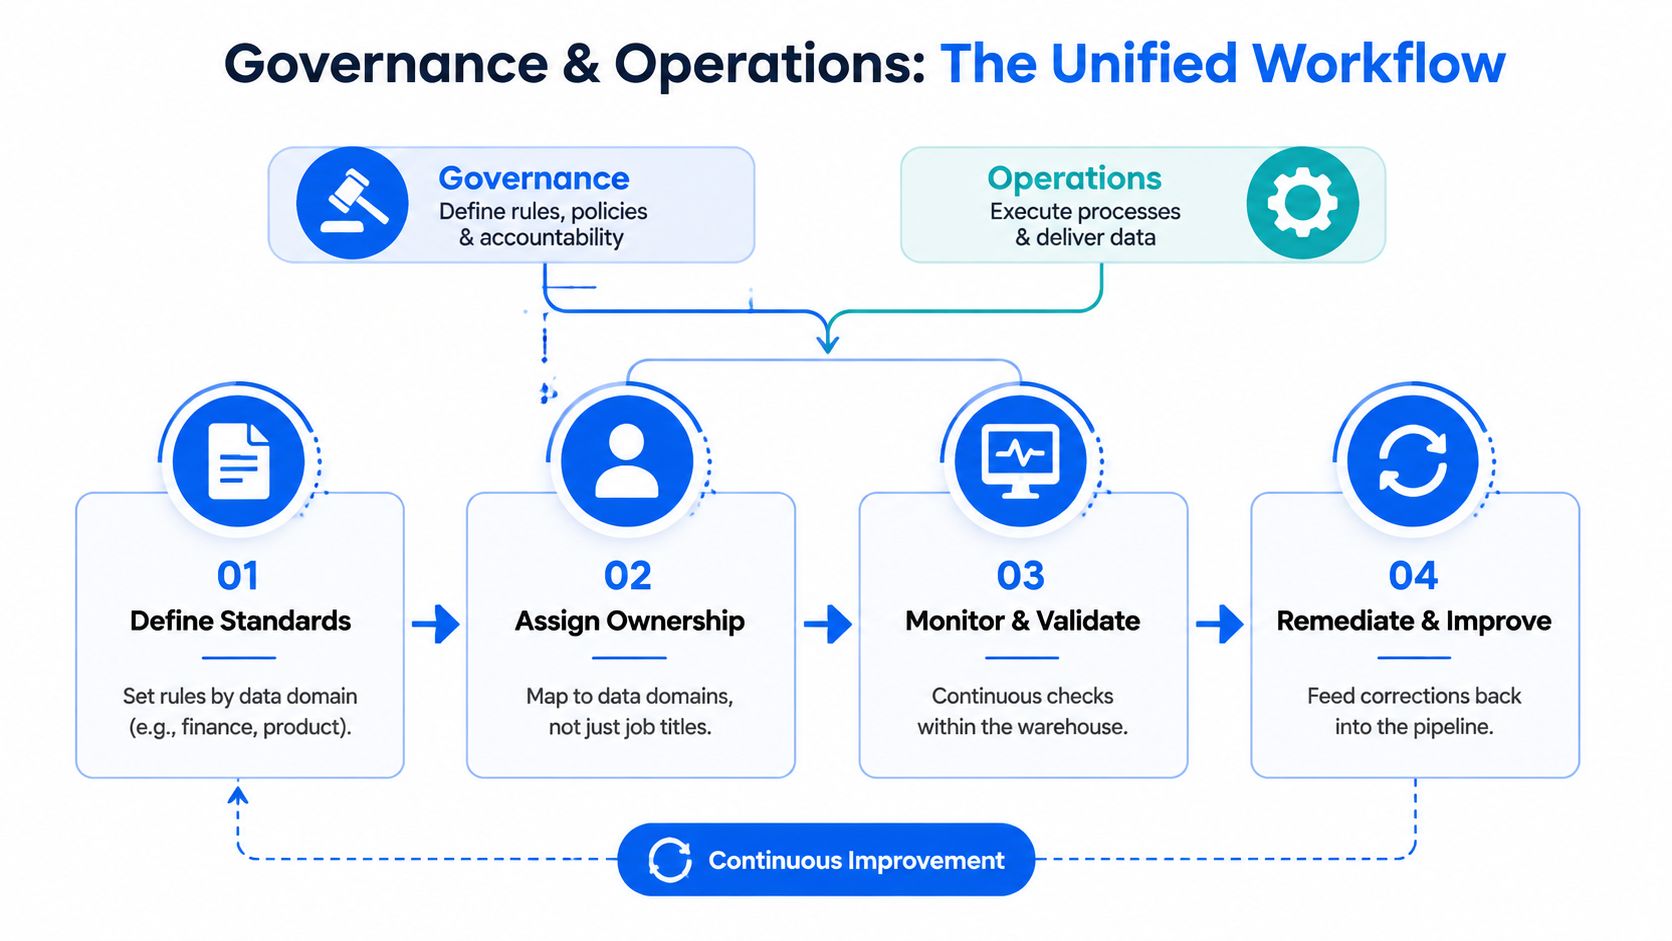
Governance und Betrieb scheitern, wenn sie in separaten Meetings stattfinden. Eine Richtlinie, die nicht zu einer Prüfung führt, ist lediglich Dokumentation. Eine Warnung ohne Eigentümer ist nur Rauschen.
Weisen Sie die Verantwortung nach Datenbereich zu, nicht nur nach Jobtitel. Ein Finanzanalyst kann Eigentümer der Umsatztabellen sein, ein medizinischer Informatiker Eigentümer der Patientendaten und ein Produktmanager Eigentümer der Verhaltensereignisse. Ihre Aufgaben unterscheiden sich, aber jeder benötigt die Befugnis, akzeptable Werte zu definieren, Schwellenwerte zu genehmigen und Änderungen am Quellsystem einzufordern.
Build a policy catalog
Jeder Domain-Eigentümer sollte einen versionierten Katalog führen, der Folgendes enthält:
Geschäftsregeln: Welche Werte, Beziehungen und Zustände zulässig sind.
Schwellenwerte: Wie viel Abweichung vor einem Eingriff akzeptabel ist.
Aktualitäts-SLAs (Timeliness): Wann Daten für jeden konsumierenden Prozess eintreffen müssen.
Nachweisanforderungen: Welche Protokolle, Ergebnisse und Genehmigungen eine Prüfung oder Incident-Review erfordert.
Das Incident-Routing sollte die geschäftlichen Auswirkungen widerspiegeln. Ein P1-Fall kann die Berichterstattung an die Geschäftsführung oder einen regulierten Prozess blockieren. Ein P2-Fall kann eine einzelne Domain beschädigen. Ein P3-Fall kann das Vertrauen mindern, ohne unmittelbaren betrieblichen Schaden anzurichten. Diese Kategorien sind wichtig, da sie verhindern, dass jede Ausnahme das gesamte Datenteam aufschreckt.
Run a shared response loop
Stewards überwachen Dashboards, prüfen Ausnahmen und passen Richtlinien an. Ingenieure platzieren Validierungs- und Anomalieprüfungen an den Ingestions- und Transformationspunkten. Governance-Komitees prüfen wiederkehrende Muster, ungeklärte Eigentumsverhältnisse und Trendmetriken, anstatt jede einzelne Warnung zu untersuchen.
Der Leitfaden zur Data Governance-Strategie ist am nützlichsten, wenn er in diese Betriebsschleife übersetzt wird. In der Praxis laufen die Anomalieerkennung und Timeliness-Monitore von digna direkt in der Datenbank auf den Quelltabellen, während die Schema-Verfolgung strukturelle Abweichungen kennzeichnet, sobald sie auftreten. Die Rolle der Plattform besteht darin, Signale und Nachweise zu liefern. Die Organisation benötigt dennoch Eigentümer, die entscheiden können, ob eine Ausnahme abgelehnt, unter Quarantäne gestellt, repariert oder akzeptiert wird.
An Implementation Roadmap That Ships
DQM-Programme geraten ins Stocken, wenn Teams alles überwachen, bevor sie bewiesen haben, dass überhaupt jemand auf eine Warnung reagiert. Eine praktikable Roadmap beginnt mit den Tabellen, bei denen schlechte Daten einen regulierten Prozess unterbrechen, die Berichterstattung an die Geschäftsführung verfälschen oder ein ML-Modell beeinträchtigen können.
Erfassen Sie zuerst die kritischen Tabellen. Bewerten Sie Genauigkeit, Vollständigkeit, Konsistenz, Timeliness, Gültigkeit und Eindeutigkeit und ordnen Sie jedes Asset nach seiner geschäftlichen Auswirkung ein. Führen Sie kontinuierliche Kontrollen nach Möglichkeit direkt in der Datenbank des Kunden aus. Dies hält die Prüfungen nah an der Quelle, vermeidet separate Datenpfade und bewahrt Nachweise für Untersuchungen auf.
Phase | Dauer | Wichtigste Ergebnisse | Genutzte digna-Module |
|---|---|---|---|
Bewertung und Priorisierung | Vom Bereitstellungsteam definiert | Inventar kritischer Tabellen, Dimensionsbewertung, Ranking nach geschäftlicher Auswirkung | Data Analytics, Data Catalog |
Schnelle Erfolge | Vom Bereitstellungsteam definiert | Null-Prüfungen, Duplikaterkennung, Timeliness-Überwachung für prioritäre Tabellen | Data Validation, Timeliness |
Erweiterung der Kontrollen | Vom Bereitstellungsteam definiert | Schema-Verfolgung, Verteilungsüberwachung, systemübergreifende Verträge, Incident-Routing | Schema Tracker, Data Anomalies, Data Validation |
Skalierung | Vom Bereitstellungsteam definiert | Wiederverwendbare Vorlagen, Onboarding von Domains, Betriebsüberprüfungen | Ausgewählte modulare Kombination |
Starten Sie mit Kontrollen, denen die Menschen vertrauen können
Der erste Release sollte auf Fehlermuster abzielen, die Teams erklären und beheben können. Aktivieren Sie Prüfungen auf Pflichtfelder, Duplikaterkennung und Timeliness-Überwachung auf den Tabellen mit dem höchsten Risiko. Priorisierung ist wichtiger als eine breite Abdeckung. Eine Kontrolle, auf die reagiert wird, ist wertvoller als ein größeres Regelwerk, das unbeachtete Ausnahmen erzeugt.
Sobald diese Prüfungen zuverlässig funktionieren, formalisieren Sie die Eigentumsverhältnisse. Veröffentlichen Sie SLAs, benennen Sie Stewards, definieren Sie Eskalationspfade und testen Sie den Prozess mit echten Ausnahmen. Eine Verletzung der Timeliness bei einer regulierten Tabelle sollte den verantwortlichen Eigentümer erreichen, anstatt in einem allgemeinen Kanal zu landen, für den sich niemand zuständig fühlt.
Fügen Sie fortgeschrittene Kontrollen hinzu, sobald die Reaktionsschleife funktioniert. Die Schema-Verfolgung kann hinzugefügte oder entfernte Spalten sowie Datentypänderungen kennzeichnen. Die Anomalieerkennung kann Verschiebungen bei Zeilenanzahlen oder Verteilungen identifizieren. Validierungsregeln können systemübergreifende Verträge durchsetzen, insbesondere wenn die Transformation einer Domain von den Daten einer anderen Domain abhängt.
Fangen Sie so eng an, dass auf jede Warnung reagiert wird. Erweitern Sie erst, wenn die Reaktionsschleife funktioniert.
Skalieren Sie über Vorlagen, nachdem sich die Kontrollen als nützlich erwiesen haben. Ein Finanzmuster für Timeliness und Schlüssel-Eindeutigkeit kann als Leitfaden für eine andere Domain dienen, aber das Kopieren ohne Prüfung führt zu Schwellenwerten, die nicht zum lokalen Prozess passen. Jeder Eigentümer sollte die geschäftliche Bedeutung der Regel bestätigen und ihren Schwellenwert auf das Entscheidungsfenster des Assets abstimmen.
Teams, die Rollout-Optionen prüfen, können diese Roadmap zur Implementierung der Datenqualität als Ausgangspunkt nutzen und die Sequenz an ihre Warehouse-, Lake- oder Pipeline-Architektur anpassen. Der praktische Test ist einfach: Priorisieren Sie die Daten mit den größten betrieblichen Konsequenzen, halten Sie die Überwachung nah an der Quelle und erweitern Sie sie nur, wenn Eigentümerschaft und Reaktionen sichtbar sind.
Häufige Fehlermuster und die Behebungsmodelle, die funktionieren
Die schädlichsten Fehler sind oft diejenigen, die eine grundlegende Pipeline-Prüfung bestehen. Ein Job kann Erfolg melden, obwohl seine Ausgabe die falsche Form, die falsche Ankunftszeit oder eine unerwartete Verteilung aufweist.
Fehlermodus | Symptom | Behebungsmodell | digna-Modul |
|---|---|---|---|
Stille Schema-Abweichung | Hinzugefügte, entfernte oder neu typisierte Felder unterbrechen Verbraucher unerwartet | Vergleichen Sie die aktuelle Struktur mit einer bekannten, fehlerfreien Baseline und warnen Sie bei Änderungen | Schema Tracker |
Veralteter Feed | Die Pipeline ist erfolgreich, aber das neueste Geschäftsereignis fehlt | Überwachen Sie geschäftliche Zeitstempel und erwartete Bereitstellungsmuster | Timeliness |
Regelmüdigkeit | Große Sammlungen statischer Prüfungen erzeugen Ausnahmen, die niemand anpasst | Kombinieren Sie deterministische Regeln mit gelernten Verhaltens-Baselines | Data Anomalies, Data Validation |
Warnungsrauschen | Teams unterdrücken oder ignorieren wiederholte, geringwertige Benachrichtigungen | Wenden Sie Schweregradstufen, Eigentümerschaft, Unterdrückungsfenster und Vorfallsgruppierung an | Benutzerzentriertes Dashboard |
Schema-Abweichungen verdienen frühzeitige Aufmerksamkeit, da Prüfungen der Zeilenanzahl nicht jeden strukturellen Bruch erkennen. Ein Quellteam kann eine Spalte hinzufügen, die Nullwerte zulässt, ein Feld entfernen oder einen Datentyp ändern, während die Anzahl der Zeilen gleich bleibt. Nachgelagerte SQL-, BI-Logik oder ML-Features können dann in einer Weise fehlschlagen, die scheinbar nichts mit der Quelländerung zu tun hat.
Die Timeliness-Überwachung muss geschäftlich relevante Zeitstempel nutzen. Eine erfolgreiche Orchestrierungsaufgabe beweist, dass Code ausgeführt wurde, nicht aber, dass nützliche Daten angekommen sind. Vergleichen Sie die Ereigniszeit mit der Verfügbarkeitszeit und dem erwarteten Bereitstellungsverhalten, sodass eine technisch grüne Pipeline dennoch einen nützlichen Vorfall melden kann.
Statische Validierung bleibt wichtig für explizite Richtlinienverstöße. Sie wird jedoch wirkungslos, wenn Teams jede mögliche Schwankung als harten Schwellenwert codieren. Die Anomalieerkennung kann Abweichungen von normalen Verteilungen und Volumina aufzeigen, benötigt aber den Kontext der Eigentümerschaft und einen Reaktionspfad. Keiner der beiden Ansätze ersetzt den anderen.
Das stärkste Design schichtet Kontrollen. Schema-Prüfungen fangen strukturelle Änderungen ab, Timeliness-Prüfungen erkennen verspätete oder fehlende Feeds, Volumen- und Verteilungsprüfungen erfassen Verhaltensänderungen, und deterministische Validierung setzt Geschäftsregeln durch. Ein gemeinsames Dashboard hilft den Zuständigen zu erkennen, ob diese Signale einen einzelnen Vorfall oder mehrere unabhängige Probleme beschreiben.
Branchen-Anwendungsfälle für regulierte und hochvolumige Daten
Die DQM-Prioritäten ändern sich mit dem Zweck der Daten. Ein Finanzteam sorgt sich vielleicht am meisten um Abstimmung und Audit-Nachweise, während ein Telekommunikationsanbieter ein regionales Ingestionsproblem identifizieren muss, bevor ein operatives Dashboard irreführend wird.
Branche | Wichtigste Qualitätsprioritäten | Beispiele für primäre KPIs | Führendes digna-Modul |
|---|---|---|---|
Finanzen | Timeliness, Eindeutigkeit, Abstimmung, Schema-Stabilität | Eindeutigkeit von Buchungsschlüsseln, Abstimmung von Transaktionen zu Risiken, Lieferverzögerung | Timeliness und Schema Tracker |
Gesundheitswesen | Identitätsintegrität, Gültigkeit von Ansprüchen, Aktualität von Feeds | Doppelte Patientenidentifikatoren, Konformität von Pflichtfeldern, Eingangsverzögerung | Data Validation und Data Anomalies |
Telekommunikation | Hochvolumige Aktualität, Volumenstabilität, regionale Konsistenz | Ereigniseingangsverhalten, Volumenverschiebungen, regionale Verteilungsänderungen | Timeliness und Data Analytics |
Öffentlicher Sektor | Prüfbarkeit, Vollständigkeit, Konsistenz, Rückverfolgbarkeit von Ausnahmen | Compliance bei Pflichtfeldern, Abstimmung, dokumentierter Ausnahmestatus | Data Validation |
Finanzen benötigen Kontrollen über Systemgrenzen hinweg
Handels- und Risikodatensätze durchlaufen oft Front-, Middle- und Backoffice-Systeme. Ein praktisches Kontrollset prüft die Eindeutigkeit von Buchungsschlüsseln, gleicht kritische Identifikatoren systemübergreifend ab und überwacht Änderungen in der Struktur des Produktstamms, bevor die GuV-Zuordnung fehlschlägt. Timeliness ist wichtig, da ein korrekter Risikodatensatz, der nach einem Berichts- oder Entscheidungsfenster eintrifft, nur begrenzten Wert hat.
Das Gesundheitswesen benötigt Identitäts- und Eingangsdisziplin
Patientenidentitätsdaten und Schadensdaten erfordern eine strenge Validierung, da Duplikate und fehlerhafte Identifikatoren nachgelagerte Messungen verfälschen können. Doppelte MRNs (Patientennummern) sollten beispielsweise einen Workflow zur Untersuchung auslösen und nicht als unsichtbare Bereinigungsaufgabe behandelt werden. Spät eintreffende HL7-Feeds erfordern ebenfalls Timeliness-Warnungen, insbesondere dort, wo betriebliche Kennzahlen von einer vollständigen Ereignisreihenfolge abhängen.
Telekommunikation benötigt Nähe zur Ingestion
Verbindungsdaten und Netzwerktelemetrie fallen in großen Mengen an und können je nach Region variieren. In-Database-Prüfungen nahe am Ingestion-Point können Aktualität und Volumen überwachen, ohne einen zusätzlichen Datenverschiebungsprozess zu erzeugen. Analytics-Ansichten helfen Teams dann zu isolieren, ob ein ungewöhnliches Muster global ist oder sich auf einen bestimmten Betriebsbereich konzentriert.
Der öffentliche Sektor benötigt belastbare Nachweise
Leistungs- und Zensusdaten werden oft erst lange nach dem ursprünglichen Laden überprüft. Validierungsregeln sollten rückverfolgbare Ergebnisse, klare Ausnahme-Eigentümer und eine Behebungshistorie erzeugen. Diese Nachweise sind Teil der Datenqualität, kein administrativer Nebengedanke. Eine Kontrolle, die ein Problem erkennt, aber nicht zeigen kann, wer es geprüft hat oder was geändert wurde, stellt bei einer Prüfung oder Aufsicht ein Risiko für die Organisation dar.
Vom periodischen Aufräumen zu kontinuierlichen, vertrauenswürdigen Abläufen
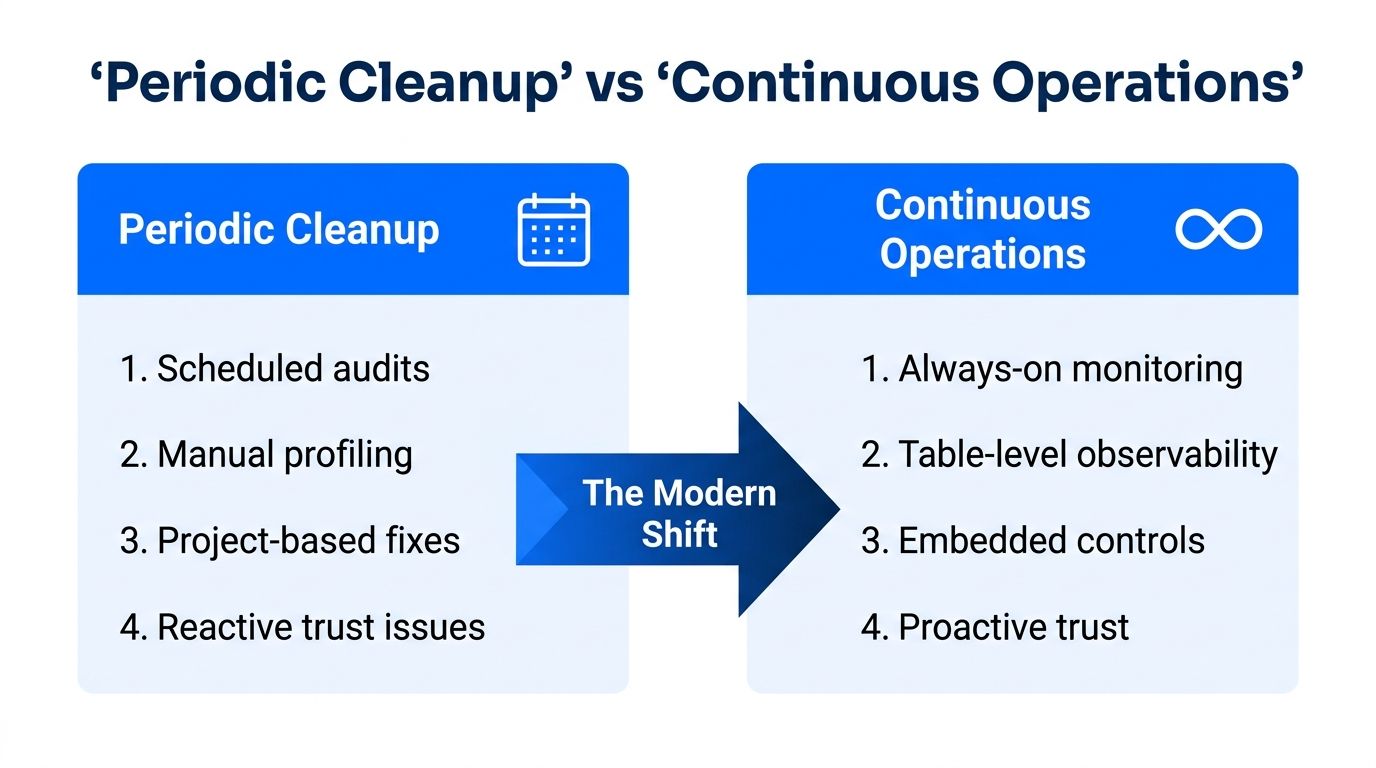
Eine periodische Bereinigung ist für die Behebung, Migration und Baseline-Erstellung immer noch nützlich. Sie ist jedoch kein Betriebsmodell. Daten können zwischen geplanten Durchläufen fehlerhaft werden, und ungeklärte Eigentumsverhältnisse führen dazu, dass sich Ausnahmen ansammeln, bis jemand die Daten dringend benötigt.
Die Umfrageergebnisse von Monte Carlo veranschaulichen den operativen Druck. Die monatlichen Datenvorfälle stiegen von 59 im Jahr 2022 auf 67 im Jahr 2023, und ein späterer Benchmark berichtete von etwa einem Datenqualitätsproblem pro 10 Tabellen und Jahr, verglichen mit etwa einem pro 15 Tabellen in früheren Messungen, wie in den Datenqualitätsstatistiken von Monte Carlo dokumentiert. Die Schlussfolgerung ist eindeutig: Die Überwachung auf Tabellenebene muss in Umgebungen, in denen sich Schemata, Aktualität und das Metrikverhalten regelmäßig ändern, kontinuierlich laufen.
Eine kompakte Checkliste für den Betrieb
Instrumentieren Sie zuerst prioritäre Tabellen: Beginnen Sie mit regulierten Assets, der Berichterstattung an die Geschäftsführung und ML-Inputs.
Weisen Sie Dataset-Eigentümerschaft zu: Benennen Sie die Person oder das Team, das für jede kritische Domain verantwortlich ist.
Einigen Sie sich auf Schwellenwerte vor der Alarmierung: Stakeholder sollten das akzeptable Verhalten definieren, bevor Ingenieure Benachrichtigungen anpassen.
Leiten Sie Ausnahmen in eine einzige Warteschlange: Geben Sie den Zuständigen einen gemeinsamen Ort zum Triagieren, Zuweisen und Dokumentieren von Vorfällen.
Verfolgen Sie Erkennung und Behebung: Überwachen Sie die mittlere Zeit bis zur Erkennung (MTTD) und die mittlere Zeit bis zur Behebung (MTTR) als operative Signale.
Überprüfen Sie die Abdeckung regelmäßig: Bewerten Sie Regeln, Baselines und Eigentumsverhältnisse bei vierteljährlichen Kontrollprüfungen neu.
Für 2026 verdienen drei Prioritäten Aufmerksamkeit. Erstens: Kodifizieren Sie Qualitäts-SLAs als explizite Verträge zwischen Produzenten und Konsumenten. Zweitens: Fügen Sie KI-gestützte Anomalie-Analysen zu den Behebungs-Playbooks hinzu, während menschliche Eigentümer für Entscheidungen verantwortlich bleiben. Drittens: Behandeln Sie Schema und Lineage als sicherheitsrelevante Assets mit einer Prüfdisziplin, die mit der von Produktionscode vergleichbar ist.
Der Wandel besteht nicht in der Umstellung von manueller Arbeit auf reine Automatisierung. Es ist der Übergang von unklarer Datenverantwortung zu sichtbarer operativer Verantwortung. Wenn Kontrollen dort laufen, wo die Daten leben, können Teams Probleme früher erkennen, Nachweise sichern und entscheiden, ob ein Datensatz für den darauf aufbauenden Prozess geeignet ist.
digna bietet In-Database-Datenqualitätsmanagement durch Anomalieerkennung, Validierung, Timeliness-Überwachung und Schema-Verfolgung, mit der Bereitstellung in Ihrer eigenen Cloud, VPC oder Ihrem Rechenzentrum. Besuchen Sie digna, um einen gezielten Überwachungsplan für Ihre wichtigsten Tabellen zu evaluieren und von dort aus aufzubauen.
Häufig gestellte Fragen
Wie unterscheidet sich Data Quality Management von Governance und Observability?
Durch das Ergebnis. Governance definiert Richtlinien, Verantwortung, zulässige Nutzung und Entscheidungsrechte; Observability liefert Signale zu Aktualität, Volumen, Schema und Verhalten; Data Quality Management übersetzt diese Erwartungen in ausführbare Kontrollen, die Defekte erkennen und die Behebung stützen.
Was übersieht reines Ergebnis-Testen?
Die Ursache. In einem Beispiel war eine Umsatzzahl um 8 % zu niedrig, weil eine Abrechnungstabelle nach einer Schemaumbenennung in der Nacht vor dem Ladevorgang Zeilen verlor. Nur die Ausgabe zu prüfen sagt, dass die Zahl seltsam wirkt, nicht welche Änderung sie erzeugt hat.
Wie sollte eine kritische Tabelle behandelt werden?
Als produktiver Dienst mit Verantwortung, erwartetem Verhalten und Eskalationspfad. Diese Rahmung holt einen Datensatz aus der Pflege nach bestem Bemühen heraus und gibt ihm eine definierte Reaktion, wenn er sich falsch verhält.
Was kostet das Versagen?
Gartner schätzt, dass Organisationen durchschnittlich 12,9 Millionen USD pro Jahr durch Datenqualitätsfehler verlieren, während Branchenzusammenfassungen häufig nennen, dass schlechte Daten rund 31 % des Geschäftsumsatzes betreffen. Diese Zahlen sprechen dafür, die Pipeline zu instrumentieren statt die Ausgabe zu inspizieren.
Wo beginnt eine Roadmap?
Bei den Datensätzen, deren Ausfall Folgen hat, und erst für diese mit Standards, ausführbaren Kontrollen, Messung und Behebung. Eine Roadmap, die mit flächendeckender Abdeckung startet, erzeugt meist einen Rückstand statt einer Kontrolle.


