Datenvalidität: Was sie bedeutet, wie man sie misst und warum sie wichtig ist
|
9
min. Lesezeit

Datenvalidität ist der Grad, in dem Daten definierten Formaten, Datentypen, zulässigen Werten, Bereichen und Geschäftsregeln entsprechen. Die Validität misst die Konformität mit definierten Anforderungen; sie beweist an sich nicht, dass die Daten die Realität widerspiegeln.
Dieser Unterschied wird leicht übersehen und ist in der Ignoranz teuer. Ein Wert kann jede strukturelle Prüfung bestehen und dennoch den falschen Kunden, die falsche Transaktion oder das falsche Ereignis beschreiben. Für Unternehmensteams ist die Validität die praktische, regelbasierte Kontrolle, die fehlerhafte Daten abfängt, bevor sie Analysen, Berichte, KI-Modelle oder regulatorische Prozesse erreichen.
Inhaltsverzeichnis
Validität vs. Genauigkeit, Vollständigkeit und Angemessenheit
Was Datenvalidität ist und warum sie wichtig ist
Datenvalidität ist eine messbare Dimension der Datenqualität, die prüft, ob Werte vordefinierte Anforderungen erfüllen. Diese Anforderungen können Syntax, Typ, Bereich, zulässige Domänen, Beziehungen oder die Geschäftslogik beschreiben. Eine E-Mail muss einem akzeptierten Muster entsprechen, ein Monat muss in seine definierte Domäne fallen und ein Referenzcode muss mit einer genehmigten Liste abgeglichen werden.
Die Validität unterscheidet sich von der Genauigkeit im Zeitpunkt der Definition. Die Genauigkeit fragt, ob ein Wert das reale Objekt oder Ereignis korrekt wiedergibt. Die Validität fragt, ob der Wert den von der Organisation festgelegten Regeln entspricht. Ein Datum wie 1800-01-01 kann strukturell gültig sein, wenn es das erwartete Datumsformat verwendet und in den konfigurierten Bereich fällt, und dennoch das falsche Geburtsdatum sein.
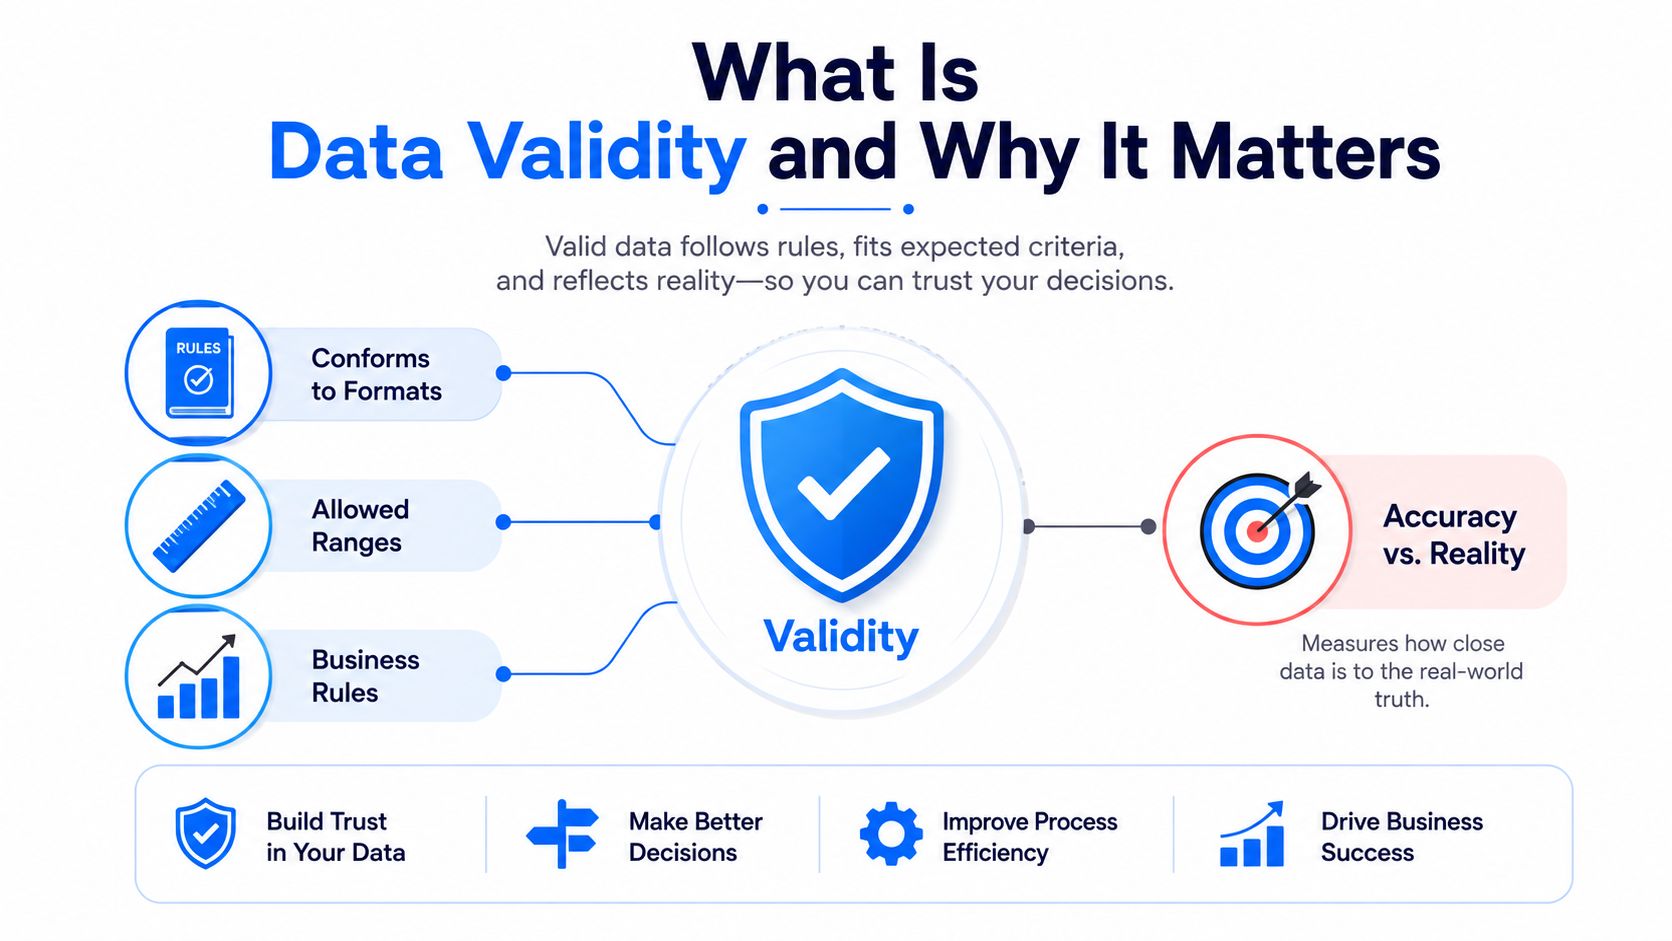
Validität als operatives Gate
Eine Validitätsregel ist deterministisch. Bei gleichem Wert und gleicher Regel sollte das Ergebnis entweder „bestanden“ oder „nicht bestanden“ lauten. Dadurch eignet sich die Validität für automatisierte Prüfungen bei der Erfassung, Transformation, dem Laden in das Data Warehouse und an den Berichterstellungsgrenzen.
Ein nützlicher Implementierungsablauf ist:
Definieren Sie die Anforderung. Dokumentieren Sie den erwarteten Typ, das Format, die Domäne, den Bereich, die Null-Richtlinie oder die Beziehung.
Wenden Sie die Regel auf der richtigen Granularitätsstufe an. Prüfen Sie kritische Felder einzeln und bewerten Sie anschließend die Ergebnisse auf Datensatz- und Datensatzgruppenebene.
Erfassen Sie Belege. Speichern Sie die fehlgeschlagene Regel, den betroffenen Datensatz, die Quelle, den Zeitstempel und den Behebungsstatus.
Legen Sie die Zuständigkeit fest. Das für die Quelle oder Transformation verantwortliche Team sollte für die Korrektur zuständig sein, nicht nur das Team, das den Fehler entdeckt.
Praktische Regel: Ein Validitätswert ist nur dann aussagekräftig, wenn jede Regel eine dokumentierte Definition, einen Eigentümer und einen geschäftlichen Zweck hat.
Organisationen, die ein umfassenderes Datenqualitätsprogramm aufbauen, können diese Kontrolle neben anderen Dimensionen in ihr Datenqualitäts-Framework einordnen. Der zentrale Punkt bleibt einfach: Die Validität verhindert, dass sich Daten, die gegen bekannte Anforderungen verstoßen, nachgelagert weiterverbreiten.
Was Does Validity Mean in Data Quality
Validität in der Datenqualität bedeutet Konformität mit expliziten Einschränkungen, die konsistent getestet werden können. Die DAMA-DMBOK® 2.0 Revised Edition identifiziert Validität als Standarddimension der Datenqualität, neben Dimensionen wie Genauigkeit, Vollständigkeit, Integrität, Eindeutigkeit oder Deduplizierung, Timeliness, Angemessenheit und Konsistenz.
Die wichtigsten Validitätsarten sind verschieden, arbeiten aber oft zusammen:
Validitätsart | Definition | Unternehmensbeispiel |
|---|---|---|
Formatvalidität | Der Wert folgt einem erwarteten Muster oder einer Syntax. | Eine Rechnungsnummer entspricht dem genehmigten Kennungsmuster der Organisation. |
Domänenvalidität | Der Wert gehört zu einer genehmigten Gruppe von Werten. | Der |
Bereichsvalidität | Der Wert liegt zwischen definierten Grenzen. | Ein Kontosaldo liegt nicht unter dem zulässigen geschäftlichen Schwellenwert. |
Datentypvalidität | Der Wert verwendet den erforderlichen Typ. | Ein Umsatzfeld enthält numerische Werte anstelle von Text. |
Nullbarkeit (Nullability) | Fehlende Werte entsprechen der für das Feld zulässigen Null-Richtlinie. | Eine Transaktionsnummer ist nach der Zahlungsautorisierung niemals null. |
Feldübergreifende Validität | Zugehörige Felder erfüllen eine logische Beziehung. | Ein Enddatum einer Richtlinie liegt nach ihrem Startdatum. |
Geschäftsregelvalidität | Der Datensatz entspricht der domänenspezifischen Richtlinie. | Der Rückzahlungsstatus eines Kredits folgt den Regeln, die mit seinem Lebenszyklusstatus verknüpft sind. |
Referenzielle Validität | Schlüssel und Codes verweisen auf gültige Datensätze in den Referenzdaten. | Eine Filialkennung ist im aktuellen Filialstamm vorhanden. |
Choosing the right rule
Formatprüfungen fangen offensichtliche Syntaxfehler ab, reichen aber allein selten aus. Ein Wert kann die richtige Form haben, während er einen veralteten Code verwendet, gegen eine Beziehung verstößt oder einer Geschäftsrichtlinie widerspricht.
Aus diesem Grund behandelt ein ausgereiftes Modell der Datenqualitätsdimensionen die Validität als mehrstufige Kontrolle. Strukturelle Prüfungen sollten zuerst durchgeführt werden, gefolgt von Domänen-, Beziehungs- und Geschäftsregelprüfungen, wo die Verwendung der Daten dies erfordert. Je folgenschwerer das Feld ist, desto wichtiger ist es, auf Feldebene zu validieren, anstatt sich auf einen einzigen datensatzweiten Wert zu verlassen.
Was Are Examples of Invalid Data
Ungültige Daten sind Daten, die ein definiertes Format, einen Typ, eine Domäne, einen Bereich, eine Nullbarkeit, eine Beziehung oder eine Geschäftsregel verfehlen. Sie gelangen oft durch nachsichtige Formulare, Änderungen in Quellsystemen, manuelle Uploads, Standard-Platzhalter oder Transformationen, die die ursprünglichen Einschränkungen nicht beibehalten, in das System.
Unterart der Validität | Beispiel für ungültige Daten | Warum es fehlschlägt |
|---|---|---|
Format | Buchstaben, die in einem nationalen Kennungsfeld gespeichert sind, das ein definiertes Muster erfordert. | Der Wert entspricht nicht der erforderlichen Syntax. |
Domäne | Ein Zahlungsdatensatz verwendet einen nicht genehmigten Währungs- oder Ländercode. | Der Wert befindet sich nicht in der gepflegten Domäne. |
Bereich | Ein IoT-Feed speichert | Der Wert verstößt gegen den physischen oder operativen Bereich des Feldes. |
Datentyp | Ein numerischer Betrag kommt als nicht analysierbare Textzeichenfolge an. | Der Wert kann nicht als der erforderliche Typ interpretiert werden. |
Nullbarkeit | Eine obligatorische Kundenkennung ist leer. | Die Definition des Feldes verbietet Nullwerte. |
Feldübergreifend | Ein Vertragsenddatum liegt vor seinem Startdatum. | Die zugehörigen Werte verstoßen gegen die zeitliche Logik. |
Geschäftsregel | Ein Kreditdatensatz überschreitet ein Richtlinienlimit für seine Risikokategorie. | Der Datensatz verfehlt eine explizite Organisationsregel. |
Referenziell | Eine Transaktion verweist auf einen Kundenschlüssel, der im Kundenstamm fehlt. | Die Beziehung kann nicht aufgelöst werden. |
Ein Wert wie 0000-00-00 verdeutlicht, warum das bloße Parsen nicht ausreicht. Ein System speichert ihn möglicherweise als Text, oder ein toleranter Parser akzeptiert ihn, aber der Wert kann dennoch gegen die Datumsdefinition der Organisation verstoßen.
Operative Teams sollten Fehler klassifizieren, anstatt sie nur zu zählen. Ein Formatfehler kann auf einen Schnittstellenfehler hinweisen, während ein plötzlicher Anstieg unbekannter Referenzcodes auf ein vorgelagertes Release oder ein Synchronisierungsproblem der Referenzdaten hindeuten kann. Eine data anomaly detection ergänzt die deterministische Validierung, indem sie ungewöhnliche Änderungen im Fehlerverhalten aufzeigt, ohne die zugrunde liegenden Regeln zu ersetzen.
Wie wird die Datenvalidität gemessen
Die Datenvalidität wird gemessen, indem die Werte oder Datensätze gezählt werden, die definierte Validierungsregeln erfüllen. Die Kernberechnung lautet:
Validitätsrate = gültige Datensätze oder Werte / bewertete Datensätze oder Werte × 100
Die umgekehrte Ansicht, die Rate ungültiger Datensätze, zeigt den Anteil, der bei mindestens einer Regel durchgefallen ist. Teams sollten auch die Anzahl der Regelfehler, die Erfolgsquote der Regeln und den Prozentsatz der Werte innerhalb einer genehmigten Domäne erfassen. Diese Metriken offenbaren unterschiedliche operative Realitäten. Ein Datensatz kann eine stabile Gesamtvaliditätsrate aufweisen, während sich eine einzelne kritische Regel drastisch verschlechtert.
Messung auf mehreren Ebenen
Messen Sie auf Feldebene, ob die Werte den Regeln des Feldes entsprechen. Stellen Sie auf Datensatzebene fest, ob ein Datensatz alle erforderlichen Prüfungen besteht. Aggregieren Sie die Ergebnisse auf Tabellen- und Pipeline-Ebene, während Sie die zugrunde liegenden Fehlerkategorien beibehalten.
Validierungsebene | Metrik | Beispielregel | Typischer Schwellenwert |
|---|---|---|---|
Format und Typ | Regelerfolgsquote | Jede Kennung entspricht dem genehmigten Muster und Typ. | Wird entsprechend der Kritikalität des Feldes festgelegt. |
Domäne und Bereich | Prozentsatz innerhalb der Domäne | Jeder | Wird entsprechend dem operativen Risiko festgelegt. |
Geschäft und feldübergreifend | Anzahl der Regelfehler | Das Enddatum liegt nach dem Startdatum. | Untersuchen Sie jeden wesentlichen Anstieg. |
Es gibt keinen allgemeingültigen, akzeptablen Schwellenwert. Ein Feld für die regulatorische Berichterstattung erfordert möglicherweise eine nahezu vollständige Konformität, während ein explorativer Datensatz mehr Ausnahmen tolerieren kann, wenn die Analysten die Einschränkungen verstehen. Der Schwellenwert sollte die geschäftliche Kritikalität, das regulatorische Risiko, die nachgelagerte Nutzung und die Kosten für das Sperren im Vergleich zum Quarantänisieren von Datensätzen widerspiegeln.
Automatisierung ist wichtig, da eine einmalige Profilerstellung nur eine Momentaufnahme und keine Kontrolle liefert. Verfolgen Sie die Ergebnisse im Zeitverlauf, bewahren Sie Proben fehlgeschlagener Datensätze auf und überprüfen Sie, ob die Regeln noch den aktuellen Geschäftsdefinitionen entsprechen. Teams, die eine breitere Messpraxis etablieren, können diesen praktischen QA-Leitfaden 2026 zusammen mit ihren Datenqualitätskontrollen verwenden. Ein umfassenderes Metriken-Framework finden Sie unter Datenqualitätsmetriken.
Validität vs. Genauigkeit, Vollständigkeit und Angemessenheit
Die Validität fragt, ob Daten definierten Regeln folgen. Die Genauigkeit fragt, ob sie die Realität widerspiegeln. Die Vollständigkeit fragt, ob die erforderlichen Daten vorhanden sind. Die Angemessenheit fragt, ob ein Wert oder ein Muster im Kontext plausibel erscheint.
Betrachten Sie einen Kundendatensatz. Eine Telefonnummer kann dem erforderlichen internationalen Format entsprechen – was sie gültig macht –, aber einer anderen Person gehören, was sie ungenau macht. Eine fehlende E-Mail-Adresse ist in erster Linie ein Vollständigkeitsfehler. Ein Gehalt, das in den zulässigen numerischen Bereich passt, kann für die Rolle des Mitarbeiters oder die Vergleichsgruppe dennoch unangemessen erscheinen.
Warum sich der Unterschied auf den Betrieb auswirkt
Die Validität ist in der Regel die am günstigsten auszuführende dieser Kontrollen, da sie auf expliziten Regeln basiert. Für die Genauigkeit wird oft eine vertrauenswürdige Quelle benötigt, beispielsweise ein maßgeblicher Kundendatensatz oder eine externe Überprüfung. Für die Vollständigkeit ist eine klare Definition erforderlich, welche Felder obligatorisch sind, und für die Angemessenheit sind möglicherweise historische Verteilungen, Peer-Vergleiche oder Anomalie-Modelle erforderlich.
Die Dimensionen überschneiden sich, sollten aber nicht ohne Erklärung in einer einzigen Bewertung zusammengefasst werden. Ein Datensatz kann vollständig ausgefüllt und strukturell gültig sein, während er dennoch ungenau ist. Umgekehrt kann ein Datensatz einen genauen Wert enthalten, der eine lokale Formatanforderung verfehlt, weil die Quellsysteme inkompatible Darstellungen verwenden.
Die Dimension der Genauigkeit in der Datenqualität gehört daher in eine mehrstufige Bewertung und ist kein Ersatz für die Validität. Nutzen Sie frühzeitig deterministische Validierungs-Gates und wenden Sie Genauigkeits- und Angemessenheitskontrollen dort an, wo eine externe Wahrheit oder eine kontextuelle Interpretation verfügbar ist.
Ein gültiger Datensatz ist gemäß den Regeln nutzbar. Er ist nicht automatisch wahr, vollständig oder sinnvoll.
Warum die Datenvalidität für Unternehmen wichtig ist
Datenvalidität ist wichtig, da ungültige Werte nachgelagerte Prozesse stören und Analysen, KI sowie Compliance-Arbeiten untergraben können. Ein fehlerhafter Referenzcode kann den Transaktionsfluss stoppen, während fehlerhafte oder außerhalb des Bereichs liegende Modellmerkmale einen Data Lake passieren und Entscheidungen ohne offensichtliche Fehler beeinflussen können.
Der Business Case ist beträchtlich. Gartner berichtete von durchschnittlichen jährlichen Kosten von 12,9 Millionen US-Dollar pro Organisation aufgrund schlechter Datenqualität, und 68 % der Befragten nannten Ungenauigkeit als Hauptursache, wie in der NISS-statistischen Perspektive auf die Datenqualität zusammengefasst. Eine separate IBM-Kostenzusammenfassung, die in Berichten aus dem Jahr 2026 zitiert wurde, besagt, dass Ungenauigkeiten bei großen Unternehmen zu einem Umsatzverlust von 25 % durch fehlerhafte Entscheidungsfindung führen können.
Validität als Kontrollpunkt
Eine Validitätsprüfung beweist nicht, dass die Adresse eines Kunden korrekt ist, aber sie kann verhindern, dass ein unmöglicher Ländercode, eine fehlerhafte Kennung oder ein ungültiges Datum in einen regulierten Bericht gelangen. Das macht sie zu einer praktischen ersten Kontrolle vor einer teureren Genauigkeitsprüfung und Kontextanalyse.
KI erhöht den Einsatz. Modelle erben strukturelle Mängel von ihren Eingaben, und ungültige Datensätze können zu stillen Fehlern führen, selbst wenn die resultierenden Vorhersagen plausibel erscheinen. Kontinuierliche Prüfungen bieten Engineering- und Governance-Teams eine prüfbare Möglichkeit, Regelverschlechterungen zu erkennen, betroffene Daten zu isolieren und zu entscheiden, ob ein Datensatz blockiert, in Quarantäne gestellt oder mit einer expliziten Ausnahme freigegeben werden soll.
Wie kann die Datenvalidität kontinuierlich überwacht werden
Die kontinuierliche Überwachung der Datenvalidität führt Validierungsregeln immer dann aus, wenn Daten eingehen oder sich ändern, anstatt auf eine periodische Überprüfung zu warten. Das richtige Betriebsmodell kombiniert automatisierte Prüfungen, Alarmierung, Eigenverantwortung und historische Belege.
Ein praktisches Muster sieht so aus:
Frühzeitig validieren: Führen Sie Format-, Typ-, Domänen- und Nullbarkeitsprüfungen nahe der Erfassung durch, wo Fehler am einfachsten zu isolieren sind.
Beziehungen validieren: Wenden Sie feldübergreifende, Geschäftsregel- und referenzielle Prüfungen an, sobald die erforderlichen Felder und Referenzdaten verfügbar sind.
Ausnahmen weiterleiten: Quarantänisieren oder kennzeichnen Sie fehlgeschlagene Datensätze, anstatt sie zu verwerfen.
Bei Änderungen alarmieren: Benachrichtigen Sie die Eigentümer, wenn die Fehleranzahl oder die Validitätsraten die genehmigten Grenzen überschreiten.
Historie bewahren: Bewahren Sie Regelergebnisse auf, damit Teams erkennen können, wann eine Verschlechterung begann, und diese mit Quell- oder Schemaänderungen verknüpfen können.
Die Echtzeit-Validierung eignet sich für die Zahlungsautorisierung, das Kunden-Onboarding und andere Abläufe, bei denen fehlerhafte Eingaben sofort abgewiesen werden sollten. Die Batch-Validierung bleibt praktisch für große analytische Lasten, geplante regulatorische Auszüge und Datensätze, bei denen eine vollständige Bewertung nützlicher ist als eine blockierende Prüfung Datensatz für Datensatz.
Die CDC unterscheidet Validität von Genauigkeit und beschreibt Validität in ihrem Arbeitsblatt zur Datenqualitätsbewertung als Konformität mit Metadaten- und Syntaxregeln. Ein externer Abgleich kann dann eine separate Genauigkeitsebene hinzufügen. Eine von PubMed indexierte Trauma-Care-Studie brachte die externe Validierung mit einer verbesserten Datengenauigkeit, Zuverlässigkeit und nachgelagerten Modellvalidität in Verbindung, was die Kombination interner Prüfungen mit periodischen, maßgeblichen Vergleichen unterstützt.
Wie kann digna die Datenvalidität unterstützen
digna Data Validation unterstützt deterministische Validitätsprüfungen auf Datensatzebene anhand definierter Regeln. Teams können es für Format-, Domänen-, Bereichs-, Nullbarkeits-, Geschäftsregel-, feldübergreifende sowie referenzielle oder geschäftliche Einschränkungen nutzen, wobei die Ergebnisse für die Qualitätsbewertung und Fehlerbehebung zur Verfügung stehen.
Stellen Sie sich einen Kundenstamm mit einer genehmigten country_code-Domäne vor. Eine Validierungsregel prüft jeden eingehenden Wert anhand dieser Referenzliste. Wenn eine Quelle beginnt, einen nicht genehmigten Code zu senden, identifiziert Data Validation die betroffenen Datensätze und protokolliert die fehlgeschlagene Regel. Die Pipeline kann diese Datensätze dann gemäß den Betriebsrichtlinien der Organisation abweisen, in Quarantäne stellen oder weiterleiten.
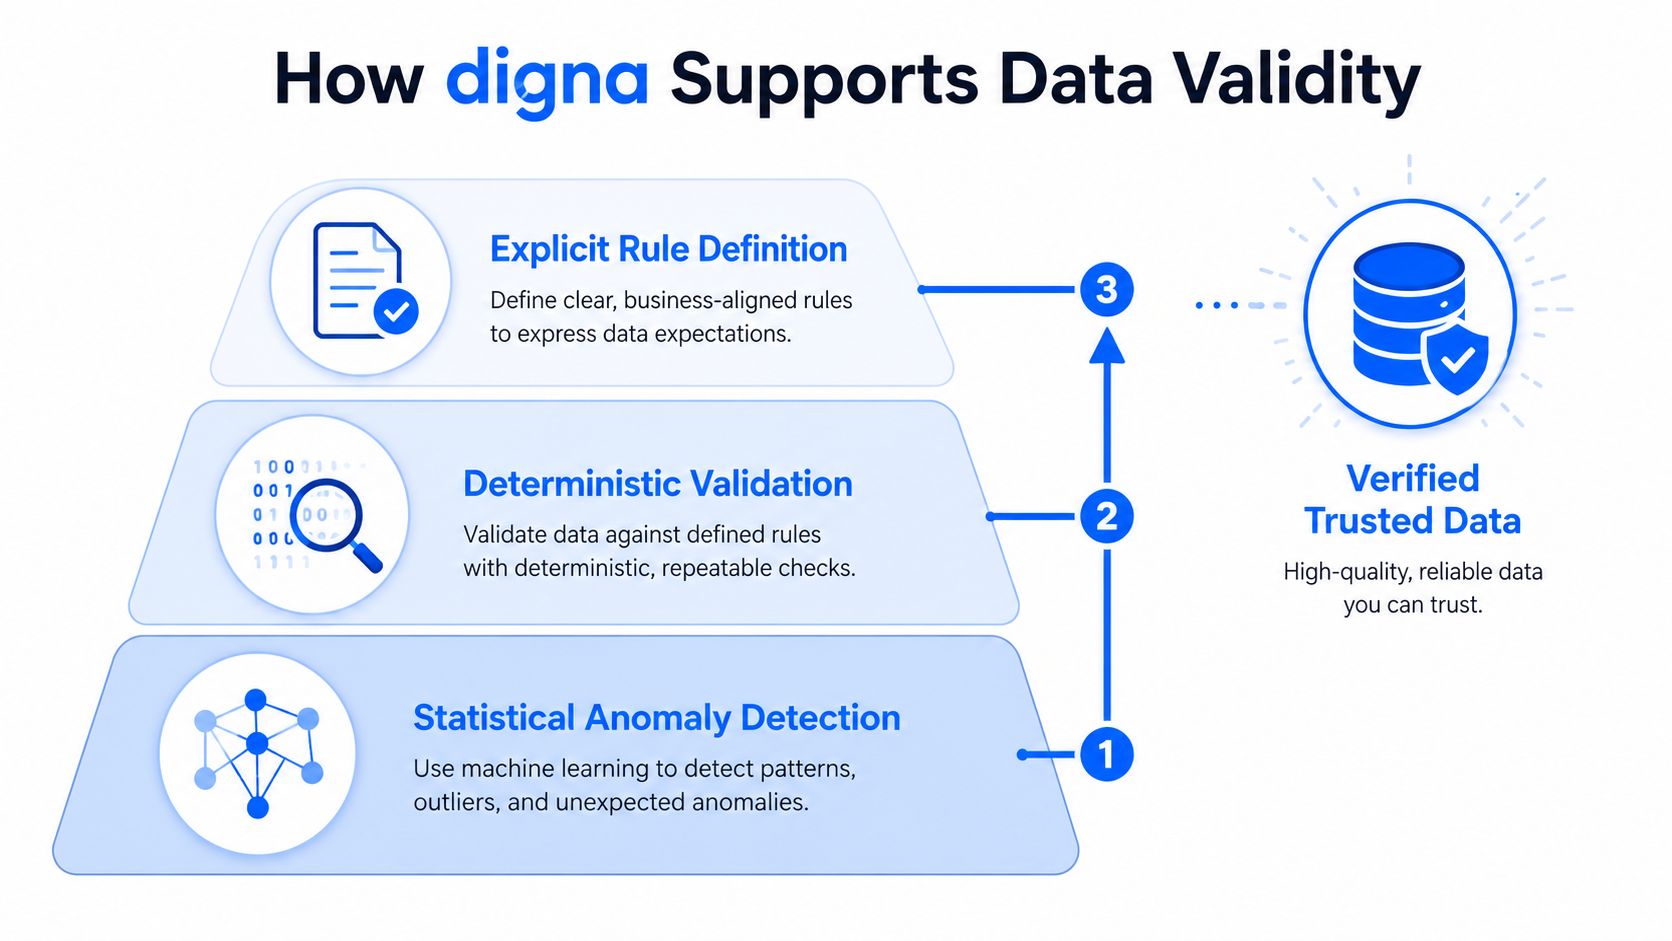
digna Data Anomalies hat eine ergänzende Rolle. Es kann einen ungewöhnlichen Anstieg von Ländercode-Fehlern im Vergleich zum etablierten Verhalten des Datensatzes identifizieren, ersetzt jedoch nicht die deterministische Regel, die definiert, welche Codes genehmigt sind.
digna Data Analytics hilft Teams, Validierungsergebnisse und Trends im Zeitverlauf zu untersuchen. Im Beispiel des Kundenstamms kann die Analytik zeigen, wann die Fehler begannen, ob sie eine oder mehrere Quellen betreffen und ob die Behebung das vorherige Muster wiederhergestellt hat. Da digna innerhalb der Umgebung des Kunden läuft und die Ausführung direkt in der Datenbank unterstützt, können Teams die Ergebnisse überwachen, während die Daten an Ort und Stelle verbleiben.
Häufig gestellte Fragen zur Datenvalidität
Was ist Datenvalidität?
Es ist der Grad, in dem Daten definierten Formaten, Typen, Domänen, Bereichen und Geschäftsregeln entsprechen.
Was ist Validität in der Datenqualität?
Validität ist eine messbare Dimension der Datenqualität, die auf die Regelkonformität ausgerichtet ist.
Wie misst man die Datenvalidität?
Nutzen Sie die Validitätsrate, die Rate ungültiger Datensätze, die Erfolgsquote der Regeln, die Fehleranzahl und die Konformität mit genehmigten Domänen.
Was sind Beispiele für ungültige Daten?
Zu den ungültigen Beispielen gehören fehlerhafte Kennungen, unbekannte Referenzcodes, unzulässige Nullwerte, unmögliche Bereiche und widersprüchliche Feldkombinationen.
Was ist eine Data Validation-Regel?
Es ist eine explizite Prüfung, die bestimmt, ob ein Wert oder Datensatz eine definierte Anforderung erfüllt.
Was ist der Unterschied zwischen Validität und Genauigkeit?
Die Validität prüft die Konformität. Die Genauigkeit prüft die Übereinstimmung mit der realen Wahrheit.
Was ist der Unterschied zwischen Validität und Vollständigkeit?
Die Vollständigkeit betrifft fehlende Daten. Die Validität betrifft vorhandene Daten, die ihre Regeln verfehlen.
Wie kann die Datenvalidität kontinuierlich überwacht werden?
Führen Sie automatisierte Prüfungen in Pipelines aus, alarmieren Sie bei Verschlechterung, bewahren Sie Belege auf und weisen Sie Verantwortlichkeiten für die Fehlerbehebung zu.
Welches digna-Modul unterstützt die Datenvalidität?
digna Data Validation ist das primäre Modul für deterministische Validitätskontrollen.
Nutzen Sie digna, um Validierungsregeln auf Datensatzebene zu definieren, Fehler in kritischen Datensätzen zu überwachen und Änderungen zu untersuchen, bevor ungültige Daten Berichte oder KI-Workflows erreichen. Besuchen Sie digna, um zu beurteilen, wie die Funktionen für Data Validation, Data Anomalies und Data Analytics in den Datenqualitätsprozess Ihres Unternehmens passen können.
Häufig gestellte Fragen
Was ist Datenvalidität?
Der Grad, in dem Daten definierten Formaten, Datentypen, zulässigen Werten, Wertebereichen und Geschäftsregeln entsprechen. Sie ist eine messbare Dimension, die prüft, ob Werte vorgegebene Anforderungen erfüllen, und nicht, ob sie wahr sind.
Wie unterscheidet sich Validität von Genauigkeit?
Am Punkt der Definition. Ein Datum wie 1800-01-01 kann strukturell valide sein, wenn es das erwartete Format nutzt und im konfigurierten Bereich liegt, und dennoch das falsche Geburtsdatum sein. Validität prüft die Regel, Genauigkeit die Wirklichkeit.
Warum taugt eine Validitätsregel als Gate?
Weil sie deterministisch ist. Eine Validitätsregel besteht oder scheitert ohne Auslegung, was sie sicher im Lieferpfad platzierbar macht, wo ein probabilistisches Signal Diskussionen statt Entscheidungen erzeugen würde.
Was sollte eine Validitätsregel abdecken?
Formate, Datentypen, zulässige Werte, Wertebereiche und Geschäftsregeln, in dieser Reihenfolge zunehmender Spezifität. Die ersten drei sind meist systemweit generisch, während Bereiche und Geschäftsregeln kodieren, was dieser konkrete Datensatz bedeutet.
Warum ist die Unterscheidung teuer zu übersehen?
Weil ein vollständig valider Datensatz in jeder Zeile falsch sein kann. Teams, die eine bestandene Validitätsprüfung als Beleg für Korrektheit werten, hören genau dort auf zu untersuchen, wo die schwereren und kostspieligeren Fehler leben.



