Data Validation: Regeln, Prüfungen und kontinuierliche Überwachung der Datenqualität
|
9
min. Lesezeit

Was passiert, wenn ein Datensatz eine Gültigkeitsdefinition auf dem Papier erfüllt, aber niemand die Regel überprüft, bevor die Daten ein Dashboard, ein Modell oder einen aufsichtsrechtlichen Bericht erreichen? Data Validation ist der operative Prozess der Anwendung definierter Regeln, Einschränkungen, Formate, Domänen und Geschäftsbedingungen, um zu bestimmen, ob Daten bestimmte Anforderungen erfüllen. Sie verwandelt eine abstrakte Qualitätserwartung in einen expliziten Test, der einen Datensatz bestehen lassen, fehlschlagen lassen, warnen, ablehnen oder unter Quarantäne stellen kann.
Daten-Gültigkeit ist eine Datenqualitätsdimension. Data Validation ist der Prozess, mit dem diese Dimension auf definierte Anforderungen hin überprüft wird.
Dieser Unterschied ist wichtig. Datenqualität beschreibt, ob Daten für ihre beabsichtigte Verwendung geeignet sind, während die Validierung den ausführbaren Mechanismus liefert, der Datensätze auf vereinbarte Bedingungen hin überprüft. Dieser Leitfaden erklärt, wie Data-Validation-Regeln, Data-Validation-Prüfungen, Messung, Automatisierung und kontinuierliche Überwachung zusammenwirken.
Inhaltsverzeichnis
Data Validation im Vergleich zu Datenqualität und Observability
Was Data Validation ist und warum es sie gibt
Data Validation prüft, ob Datensätze vordefinierten Erwartungen an Struktur, Inhalt, Beziehungen und geschäftliche Bedeutung entsprechen. Eine Regel kann beispielsweise eine Kundenkennung vorschreiben, einen Ländercode auf eine genehmigte Domäne beschränken, bestätigen, dass ein Datum das erwartete Format hat, oder sicherstellen, dass ein Bestellwert eine Geschäftsbedingung erfüllt.
Eine Validierung ist wichtig, da sich Fehler immer schwerer isolieren lassen, nachdem sie mehrere Systeme durchlaufen haben. Ein fehlerhafter Datensatz kann sich auf Data Analytics, Machine-Learning-Pipelines, betriebliche Abläufe oder das aufsichtsrechtliche Berichtswesen auswirken, bevor das Problem auf der Dashboard-Ebene bemerkt wird. Prüfungen bei der Erfassung oder während der Transformation geben Teams die Möglichkeit, den Datensatz zu stoppen, zu kennzeichnen oder zu isolieren, solange sein Ursprung noch erkennbar ist.
Der Unterschied zwischen einer Qualitätsdimension und ihrer operativen Prüfung spiegelt sich auch in der DAMA-DMBOK® 2.0 Revised Edition wider, die häufig als Referenzpunkt für Datenmanagement-Praktiken herangezogen wird. Gültigkeit beschreibt die Übereinstimmung mit definierten Formaten, Domänen und Regeln. Data Validation ist die Aktivität, die diese Übereinstimmung in einem bestimmten Datensatz und an einem bestimmten Punkt in einer Pipeline misst.
Warum eine einmalige Bereinigung nicht ausreicht
Ein Bereinigungsprojekt kann bekannte Mängel beheben, schützt jedoch nicht die nächste Datenladung. Die kontinuierliche Überwachung der Datenqualität misst die Qualität im Zeitverlauf und wendet Kontrollen an, damit die Daten weiterhin den geschäftlichen Erwartungen entsprechen. Die dauerhafte Feedbackschleife hilft Teams, Abweichungen, Verschlechterungen und Prozessunterbrechungen zu erkennen, bevor nachgelagerte Verbraucher unzuverlässige Werte verwenden, wie in der Forschung zur kontinuierlichen Überwachung der Datenqualität beschrieben.
Die Datenqualitäts-Leitlinien von Gartner weisen auf durchschnittliche jährliche Kosten von 12,9 Millionen US-Dollar hin, die mit schlechter Datenqualität verbunden sind. Dies macht die systematische Validierung und Überwachung sowohl zu einer geschäftlichen Kontrolle als auch zu einer technischen Praxis (Gartner-Leitfaden zur Datenqualität). Die praktische Antwort darauf ist kein unbegrenztes Testen. Es geht darum, die Regeln auszuwählen, die die wichtigsten Daten schützen, und jeden Fehler mit einem Verantwortlichen und einer Maßnahme zu verknüpfen.
Wie Data-Validation-Regeln funktionieren
Eine Data-Validation-Regel besteht aus drei wesentlichen Teilen: Bedingung, Umfang und Aktion. Die Bedingung definiert den logischen Test, der Umfang bestimmt, wo der Test angewendet wird, und die Aktion legt fest, was die Pipeline tun soll, wenn der Test fehlschlägt.
Betrachten Sie eine Tabelle customer_orders:
order_total > 0customer_emailentspricht dem genehmigten E-Mail-Mustercountry_codegehört zu einer zulässigen Auswahl
Dieselbe Bedingung kann je nach Schweregrad zu unterschiedlichen Ergebnissen führen. Eine fehlende regulatorische Kennung blockiert möglicherweise einen Ladevorgang, während ein ungewöhnlicher, aber überprüfbarer Wert eine Warnung erzeugen kann. Ein fehlerhafter Datensatz kann in die Quarantäne verschoben werden, anstatt gelöscht zu werden, wodurch Beweise für eine Korrektur und einen erneuten Versuch erhalten bleiben.
Komponente | Rolle | Beispiel ( |
|---|---|---|
Bedingung | Definiert den logischen Test |
|
Umfang | Identifiziert das Objekt und die Phase, die überprüft werden |
|
Aktion | Spezifiziert die Reaktion auf einen Fehler | Datensatz unter Quarantäne stellen und den Datenverantwortlichen benachrichtigen |
Regeln können deklarativ sein, wie z. B. SQL-Constraints oder YAML-Konfigurationen, oder prozedural, wie z. B. mit dbt oder Great Expectations implementierte Tests. Enterprise-Integrationen können Prüfungen auch über eine API bereitstellen, einschließlich dignas REST-API für Data Validation.
Eine nützliche Regel sollte wiederverwendbar und parametrisierbar sein. Beispielsweise kann eine einzige Vorlage für eine Bereichsprüfung unterschiedliche Mindest- und Höchstwerte für verschiedene Geldbetragsfelder akzeptieren. Speichern Sie die Regeldefinition, den Schweregrad, den Verantwortlichen und die Version direkt neben dem Datenmodell, das sie schützt. Dadurch werden Änderungen überprüfbar, wenn sich ein Schema oder eine Geschäftsrichtlinie ändert.
Arten von Data-Validation-Prüfungen
Keine einzelne Prüfungsart fängt jeden Fehler ab. Ein ausgereiftes Data-Validation-Framework kombiniert strukturelle Tests mit Inhalts-, Beziehungs- und Verhaltensprüfungen.
Prüfungsart | Zweck | Beispiel für Kundendatensatz |
|---|---|---|
Schema | Bestätigt Spalten, Datentypen und Nullbarkeit |
|
Domäne | Beschränkt Werte auf eine genehmigte Auswahl |
|
Format | Prüft ein erforderliches Muster | E-Mail folgt der akzeptierten Struktur |
Bereich | Wendet numerische Grenzen oder Datumsbereiche an | Menge ist nicht negativ |
Eindeutigkeit | Erkennt doppelte Kennungen |
|
Referenzielle Integrität | Bestätigt Beziehungen über Datensätze hinweg | Jede Bestellung verweist auf einen existierenden Kunden |
Statistik oder Verteilung | Findet ungewöhnliches aggregiertes Verhalten | Null-Raten oder Zeilenanzahlen verschieben sich unerwartet |
Struktur- und Inhaltsprüfungen
Schemaprüfungen fangen eine fehlende Spalte, einen unerwarteten Typ oder ein geändertes Nullable-Flag ab, bevor nachgelagerte Transformationen fehlschlagen. Domänenprüfungen erkennen Werte, die syntaktisch akzeptabel, aber nicht genehmigt sind, wie z. B. einen unbekannten Ländercode oder einen nicht unterstützten Kundenstatus.
Formatvalidierung prüft Muster für E-Mail-Adressen, Daten, Postleitzahlen und Kontonummern. Bereichsvalidierung überprüft Werte wie Alter, Menge, Prozentsätze und Geldbeträge anhand definierter Grenzen.
Nullbarkeitsvalidierung trennt Pflichtfelder von optionalen Attributen. Eine Kunden-ID kann obligatorisch sein, während eine sekundäre Telefonnummer optional sein kann. Jeden Nullwert als Fehler zu behandeln, erzeugt unnötiges Rauschen, daher muss die Anforderung von der beabsichtigten Verwendung hergeleitet werden.
Beziehungs- und Verhaltensprüfungen
Feldübergreifende Validierung testet die Logik zwischen Attributen. Ein Enddatum darf nicht vor einem Startdatum liegen, und ein Währungswert muss seine definierte Geschäftsbedingung erfüllen. Referenzielle Validierung prüft, ob eine Kunden-ID in den Kundenstammdaten existiert und ob eine Produkt-ID in einem genehmigten Referenzdatensatz vorhanden ist.
Statistische Prüfungen fügen eine weitere Ebene hinzu. Sie können Zeilenanzahlen, Null-Raten, Mittelwerte, Standardabweichungen und Verteilungen überwachen und helfen Teams, schleichende Veränderungen zu finden, die statische Regeln möglicherweise übersehen. Hinweise zu Konsistenzprüfungen für Daten sind nützlich, wenn mehrere Quellen dieselbe Entität oder dasselbe Ereignis beschreiben sollen.
Kombinieren Sie für kritische Elemente Schema-, Domänen-, Format-, Beziehungs- und Verteilungsprüfungen, anstatt sich auf eine einzige Kategorie zu verlassen.
Entwurf von Regeln, die in der Produktion Bestand haben
Effektive Datenqualitätsregeln sollten explizit, messbar, relevant, testbar, wartbar und auf eine geschäftliche Anforderung rückführbar sein. Eine Regel wie „Kundendaten sollten vollständig sein“ ist nicht ausführbar. „Die Kunden-ID darf bei keinem Abrechnungsdatensatz null sein“ ist spezifisch genug, um sie zu testen und zuzuweisen.
Regeln können auf verschiedene Qualitätsdimensionen abzielen:
Vollständigkeit: Pflichtfelder enthalten Werte.
Gültigkeit: Werte entsprechen einem genehmigten Format oder einer genehmigten Domäne.
Eindeutigkeit: Kennungen wiederholen sich nicht, wo Eindeutigkeit erforderlich ist.
Konsistenz: Verwandte Systeme stimmen bei gemeinsamen Attributen überein.
Timeliness: Daten kommen innerhalb des vereinbarten Betriebsfensters an.
Genauigkeit: Werte stimmen mit einer vertrauenswürdigen Quelle oder einer verifizierten Bedingung überein.
Konformität: Datensätze entsprechen dem relevanten strukturellen und geschäftlichen Standard.
Wenden Sie nicht auf jede Spalte die gleiche Strenge an. Priorisieren Sie kritische Datenelemente und geschäftskritische Regeln, insbesondere Felder, die in der Finanzabwicklung, der Kundenkommunikation, dem regulierten Berichtswesen, bei operativen Entscheidungen oder in hochwirksamen Analysen verwendet werden. Ein Regel-Backlog kann nach Implementierungskosten, potenziellem Schadensausmaß, Erkennbarkeit eines Fehlers und der Reversibilität des resultierenden Fehlers priorisiert werden.
Kritikalitätsstufe | Beispiele | Erforderliche Prüfungsarten | Rhythmus | Eskalationspfad |
|---|---|---|---|---|
Hoch | Regulatorische oder finanzielle Felder | Mehrschichtige Struktur-, Domänen-, Beziehungs- und Trendprüfungen | Bei jedem relevanten Ladevorgang | Datenverantwortlicher und Incident-Prozess |
Mittel | Kundenorientierte operative Felder | Format-, Vollständigkeits-, Bereichs- und Konsistenzprüfungen | Ladebasiert oder geplant | Team-Warteschlange mit klarer Zuständigkeit |
Niedriger | Explorative analytische Attribute | Grundlegende Schema- und Anomalieprüfungen | Je nach Nutzung | Überprüfung während der Pflege des Datensatzes |
Parametrisierte Vorlagen reduzieren duplizierte Logik. Versionieren Sie Regeln bei Schemaänderungen, erfassen Sie den geschäftlichen Verantwortlichen und verwerfen Sie Prüfungen, wenn sich die zugrunde liegende Anforderung ändert. Die Forschung zu manuell gepflegten technischen Datenqualitätsregeln verdeutlicht, warum Wartbarkeit als Teil des Kontrolldesigns und nicht als nachträglicher Gedanke behandelt werden muss.
Messung von Validierungsergebnissen
Die Validierung wird operativ nützlich, wenn Teams mehr als nur ein einfaches Erfolgs- oder Fehlersignal messen. Zu den Kernindikatoren gehören Validierungs-Erfolgsquote, Validierungs-Fehlerquote, Anzahl fehlerhafter Datensätze, Anzahl fehlerhafter Regeln, Fehlertrends und die Fehlerquote kritischer Regeln.
Die Standardberechnung lautet:
Validierungs-Erfolgsquote = Datensätze, die eine Regel bestehen / ausgewertete Datensätze × 100
Die entsprechende Fehleransicht kann die Anzahl der Datensätze, die die Regel nicht bestanden haben, geteilt durch die ausgewerteten Datensätze und multipliziert mit 100, verwenden. Teams können auch die mittlere Zeit bis zur Erkennung, die mittlere Zeit bis zur Behebung, die Regelabdeckung und einen zusammengesetzten Datenqualitäts-Score-Index verfolgen, sofern diese Maße konsistent definiert sind.
Eine Erfolgsquote von 99 % ist nicht automatisch gut oder schlecht. Wenn die fehlerhaften Datensätze ein analytisches Attribut mit geringem Risiko betreffen, ist der Schwellenwert tolerierbar. Wenn sie eine erforderliche Abrechnungskennung betreffen, kann dieselbe Quote ein sofortiges Eingreifen erfordern. Schwellenwerte müssen die geschäftliche Kritikalität, die nachgelagerten Auswirkungen und die mit der Regel verknüpfte Aktion widerspiegeln.
Trends lesen, keine isolierten Momentaufnahmen
Die Trendverfolgung zeigt, ob sich Fehler stabilisieren, verbessern oder verschlimmern. Eine Regel, die heute bestanden wird, kann sich über aufeinanderfolgende Ladevorgänge hinweg dennoch allmählich verschlechtern. SAP-Stammdaten-Tools veranschaulichen diesen Ansatz durch geplante Auswertungen, Trendverfolgung, Überwachung des aktuellen Zustands und Vergleich mit definierten Schwellenwerten (SAP-Dokumentation zu Validierung und Überwachung).
Zusammengesetzte Scores sollten nach der Kritikalität der Datenelemente gewichtet und nicht gleichmäßig gemittelt werden. Ein Dashboard, das Regeln mit geringer und hoher Auswirkung in einem ungewichteten Score kombiniert, kann schwerwiegende Fehler unbedeutend erscheinen lassen. Detaillierte Anleitungen zu Datenqualitätsmetriken können Teams dabei helfen, ein Messmodell zu definieren, das Regelergebnisse mit Zuständigkeiten und der geschäftlichen Nutzung verknüpft.
Data Validation im Vergleich zu Datenqualität und Observability
Datenqualität ist das übergeordnete Konzept, ob Daten für die Verwendung geeignet sind. Sie umfasst Dimensionen wie Vollständigkeit, Genauigkeit, Konsistenz, Timeliness, Eindeutigkeit und Gültigkeit. Data Validation ist ein Mechanismus zur Überprüfung definierter Datenqualitätsanforderungen.
Eine Validierungsprüfung fragt: „Erfüllt dieser Datensatz diese Regel?“ Eine Qualitätsbewertung fragt, ob dem Attribut oder Datensatz für seinen beabsichtigten Zweck vertraut werden kann. Ein umfassenderes Datenqualitätsmanagement kann auch Profiling, Anomalieerkennung, Abgleich, Timeliness-Überwachung, historische Analysen und Fehlerbehebung umfassen.
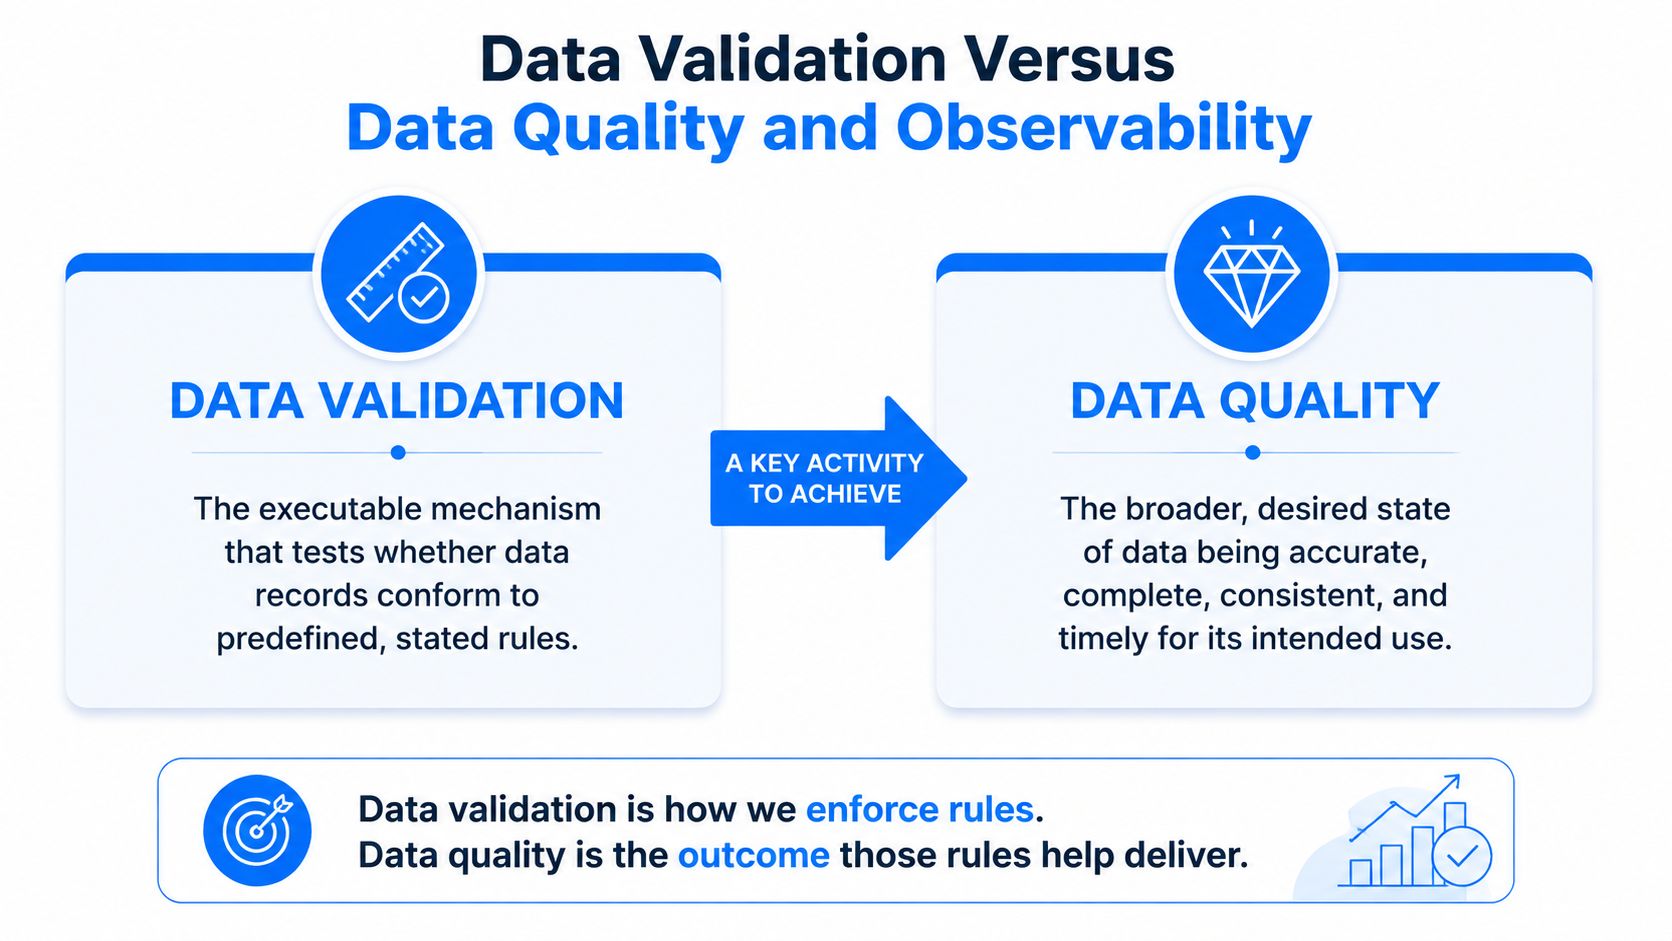
Validierung und Observability beantworten unterschiedliche Fragen
Data Validation fragt:
Erfüllen diese Daten diese definierte Regel?
Data Observability fragt:
Was passiert mit den Daten und wie hat sich ihr Verhalten verändert?
Die Validierung ist in der Regel deterministisch und regelbasiert. Observability fügt Verhaltenssignale wie Trends, Anomalien, Lineage-Kontext, Aktualität und die Erkennung von Strukturänderungen hinzu. Sie ergänzen einander. Eine Validierungsregel kann eine ungültige Postleitzahl identifizieren, während die Anomalieüberwachung einen plötzlichen Anstieg von Postleitzahlenfehlern erkennen kann.
Betrachten Sie eine Pipeline für Kundenadressen. Die Validierung kann fehlerhafte Postleitzahlen ablehnen. Die Qualitätsbewertung kann eine abnehmende Vollständigkeit bei Adressfeldern zeigen. Observability kann erkennen, dass eine vorgelagerte Schemaänderung ein ungemapptes Feld eingeführt hat. Jede Ebene beantwortet eine andere operative Frage, und zusammen bieten sie eine stärkere Diagnose als jede Ebene für sich allein.
Automatisierung und Überwachung der Data Validation
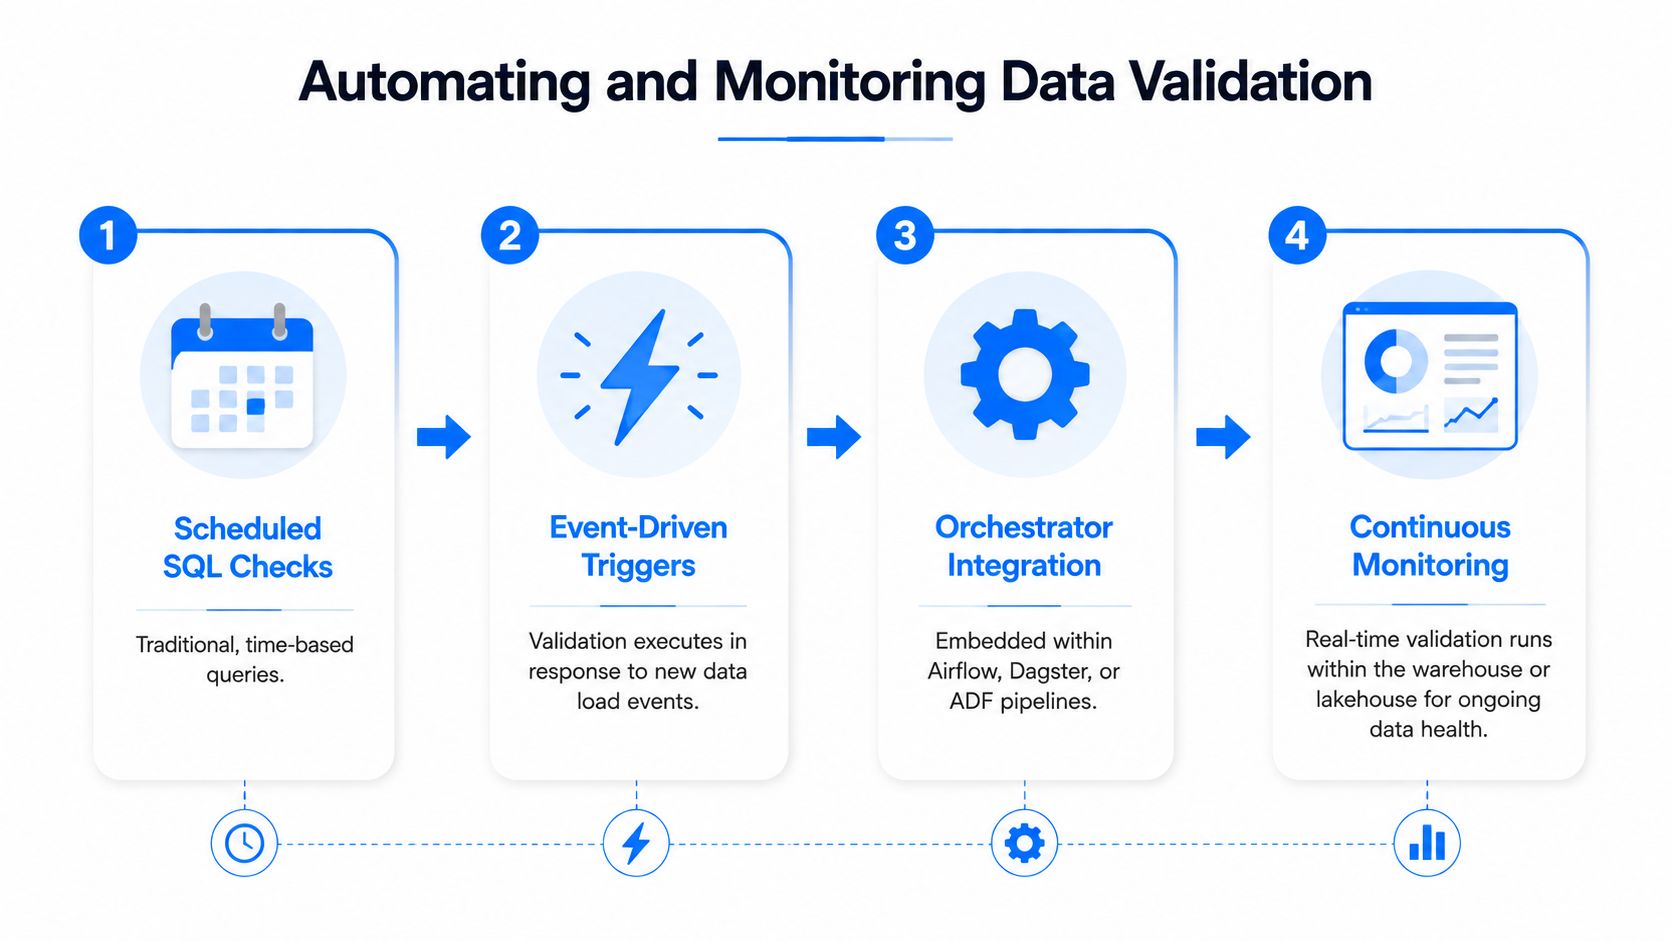
Automatisierte Data Validation sollte als Teil des Datenlebenszyklus ausgeführt werden und nicht als isoliertes Skript, an dessen Ausführung man sich erinnern muss. Teams können Prüfungen nach Ladeereignissen über Airflow, Dagster oder Azure Data Factory auslösen oder sie für Datensätze planen, die keine zuverlässigen Ereignissignale haben.
Führen Sie Prüfungen nach Möglichkeit direkt im Data Warehouse oder Lakehouse durch. Die In-Database-Ausführung belässt die Daten an Ort und Stelle, unterstützt die Lineage und vermeidet unnötige Datenbewegungen. Speichern Sie die Ergebnisse in einem Kontrollschema mit der Regelkennung, dem Ausführungszeitstempel, dem Umfang, dem Status, der Anzahl der fehlerhaften Datensätze, dem Schweregrad und dem Verantwortlichen.
Aufbau des Reaktionspfads
Nutzen Sie eine abgestufte Alarmierung, anstatt jeden Fehler als Systemausfall zu behandeln:
Warnungen: Erfassen Sie ein nicht blockierendes Problem zur Überprüfung.
Blockierungen: Stoppen Sie die Veröffentlichung, wenn eine kritische Regel fehlschlägt.
Quarantäne: Isolieren Sie ungültige Datensätze für Untersuchungen oder erneute Versuche.
Eskalation: Leiten Sie dringende Fehler an Slack, PagerDuty oder Ticket-Workflows weiter.
Eine Triage-Warteschlange sollte einen Verantwortlichen zuweisen, auf ein Runbook verweisen, die fehlerhafte Regel identifizieren und eine Ursachenkategorie erfassen. Die Lösung sollte wieder in das Kontrolldesign einfließen. Manchmal muss die Regel verfeinert werden. Manchmal muss der vorgelagerte Vertrag oder die Transformation geändert werden.
dbt-Tests und Great Expectations bieten weithin anerkannte Muster für die Darstellung von Prüfungen im Code. Operative Teams benötigen außerdem idempotente Ausführungen, sichere Wiederholungen, den Umgang mit Schema-Drift und klare Serviceerwartungen für Aktualität versus Validierungsverzögerung. Teams, die ein Betriebsmodell aufbauen, können auch Hire-a.dev zum Thema Überwachung für allgemeinere Überlegungen zum Überwachungs-Workflow konsultieren. Kontinuierliche Überwachung der Datenqualität funktioniert am besten, wenn technische Signale direkt mit menschlicher Verantwortung verknüpft sind.
End-to-End-Validierungs-Workflow mit einem Kundendatensatz
Nehmen wir einen Kundendatensatz mit einem Feld country_code. Der Data Contract deklariert das erwartete Format ISO-3166-alpha-2 und eine freigegebene Whitelist von 30 verwalteten Regionen. Das Feld darf nicht null sein, muss zu dieser Domäne gehören und der erwarteten Struktur entsprechen.
Nach jedem Batch identifizieren SQL-Prüfungen Nullwerte, unbekannte Codes und Verteilungsänderungen. Ein Anomalie-Monitor vergleicht die heutigen Länderzahlen mit der Baseline der letzten 30 Tage und zeigt einen plötzlichen Anstieg von XX-Platzhaltern auf. Die Analyse zeigt dann, wann die Verschlechterung begann, anstatt nur zu melden, dass der jüngste Batch fehlgeschlagen ist.
Schritt | Aktion | Tool oder Ebene | Ausgabe |
|---|---|---|---|
1 | Feldvertrag deklarieren | Schema und Geschäftsmetadaten | Erwartetes Format und genehmigte Domäne |
2 | Prüfungen auf Datensatzebene ausführen | SQL-Validierungsebene | Null-, Domänen- und Formatfehler |
3 | Verhalten im Zeitverlauf vergleichen | Anomalieerkennung | Ungewöhnlicher Anstieg von |
4 | Incident weiterleiten | Alarmierungs- und Verantwortungs-Workflow | Erfassungsteam untersucht |
5 | Korrigieren und abgleichen | ETL-Fix und Backfill | Betroffene Datensätze repariert |
6 | Nachgelagerte Nutzung neu berechnen | Analytics und Reporting | Regionale Umsatzansichten aktualisiert |
Das Erfassungsteam stellt fest, dass ein vorgelagerter ETL-Prozess standardmäßig auf XX setzt, wenn die Geokodierung fehlschlägt. Sie korrigieren die Transformation, füllen die betroffenen Datensätze nachträglich auf und führen die nachgelagerten Umsatzanalysen nach Regionen erneut aus. Die Validierung identifiziert die fehlerhaften Werte, die Anomalieüberwachung deckt die ungewöhnliche Änderung auf und Data Analytics etabliert den Zeitverlauf. Die drei Ebenen bilden eine geschlossene Feedbackschleife statt einer unzusammenhängenden Sammlung von Prüfungen.
digna bietet eine Data Validation auf Datensatzebene für explizite Regeln, die Pflichtfelder, Formate, Domänen, Bereiche, feldübergreifende Bedingungen sowie referenzielle oder geschäftliche Einschränkungen abdecken. Die ergänzende Funktion für Data Anomalies kann ungewöhnliche Änderungen in den Validierungsergebnissen oder im Datenverhalten identifizieren, während Data Analytics die historische Analyse von Validierungsmetriken und -trends unterstützt. Besuchen Sie digna, um zu prüfen, wie diese Funktionen in Ihren Workflow zur Überwachung der Datenqualität passen könnten.
Häufig gestellte Fragen
Was ist Data Validation?
Data Validation ist der Prozess der Anwendung definierter Regeln, Einschränkungen, Formate, Domänen und Geschäftsbedingungen, um zu bestimmen, ob Daten bestimmte Anforderungen erfüllen. Sie verwandelt Datenqualitätserwartungen in explizite, testbare Kontrollen.
Was sind Data-Validation-Regeln?
Data-Validation-Regeln sind logische Bedingungen, die auf einen definierten Bereich angewendet werden, wie z. B. ein Feld, einen Datensatz, eine Tabelle oder eine Pipeline-Phase. Sie können Aktionen wie Warnungen, Ablehnungen, Quarantäne oder Korrekturen auslösen, wenn Daten fehlschlagen.
Was sind die Hauptarten der Data Validation?
Zu den gängigen Arten gehören Format-, Datentyp-, Domänen-, Bereichs-, Nullbarkeits-, feldübergreifende, referenzielle, Eindeutigkeits-, Schema-, Geschäftsregel- sowie statistische oder Verteilungsprüfungen. Die richtige Kombination hängt davon ab, wie die Daten verwendet werden sollen.
Wie misst man die Data Validation?
Messen Sie die Erfolgsquote, die Fehlerquote, die Anzahl fehlerhafter Datensätze, die Anzahl fehlerhafter Regeln, Fehlertrends und die Fehlerquote kritischer Regeln. Schwellenwerte sollten die Bedeutung des Datenelements und die Folgen eines Fehlers widerspiegeln.
Ist Data Validation dasselbe wie Datenqualität?
Nein. Datenqualität ist die umfassendere Bewertung, ob Daten für die Verwendung geeignet sind. Data Validation ist ein praktischer Mechanismus zur Überprüfung spezifischer Datenqualitätsanforderungen.
Was ist der Unterschied zwischen Data Validation und Datenverifizierung?
Data Validation prüft, ob Daten den definierten Anforderungen entsprechen. Die Datenverifizierung bestätigt im Allgemeinen, dass ein Wert oder Prozess mit einer erwarteten Quelle oder einem erwarteten Ergebnis übereinstimmt. Die Verifizierung kann die Validierung unterstützen, aber die Begriffe beschreiben unterschiedliche Kontrollaktivitäten.
Kann Data Validation ungenaue Daten erkennen?
Sie kann Ungenauigkeiten erkennen, wenn die Organisation über eine zuverlässige Referenz, Abgleichregel oder Geschäftsbedingung verfügt, gegen die getestet werden kann. Ein Wert kann Format- und Domänenprüfungen bestehen, obwohl er sachlich falsch ist. Daher sollte die Validierung mit Profiling, Abgleich und Anomalieerkennung kombiniert werden.
Wie kann Data Validation automatisiert werden?
Führen Sie Regeln innerhalb von Erfassungs- und Transformationspipelines aus, verknüpfen Sie sie mit Orchestratoren wie Airflow, Dagster oder Azure Data Factory, speichern Sie die Ergebnisse in einem Kontrollschema und leiten Sie Fehler über Alarmierungs- und Triage-Workflows weiter. dbt-Tests und Great Expectations sind gängige Implementierungsmuster.
Wie unterstützt digna Data Validation die Datenqualität?
digna Data Validation wendet explizite Regeln auf Datensatzebene an und protokolliert Ergebnisse für gezielte Qualitätskontrollen. In Kombination mit Anomalieerkennung und historischer Analyse hilft sie Teams, einzelne Fehler mit sich änderndem Datenverhalten und längerfristigen Qualitätstrends zu verknüpfen.


