Datenbereinigung in SQL: Praktische Muster
|
9
min. Lesezeit
Ein Dashboard weist über Nacht Spitzenwerte auf, und die erste Erklärung ist meist die Geschäftsaktivität. Dann prüft jemand das Data Warehouse und stellt doppelte Bestellungen, fehlende Fremdschlüssel oder in zwei verschiedenen Formaten geparste Daten fest. Der Bericht war nicht „fast richtig“. Seine Inputs waren inkonsistent, und jede nachgelagerte Berechnung hat das Problem übernommen.
Das ist die operative Realität der Datenbereinigung in SQL. Bei der Arbeit geht es weniger um clevere Syntax als vielmehr darum, Fehler zu messen, riskante Datensätze zu isolieren, deterministische Reparaturen anzuwenden und zu verhindern, dass dieselben Fehler erneut auftreten. Auf Warehouse-Ebene kann ein unvorsichtiges UPDATE mehr Daten beschädigen, als es repariert, während ein gut strukturierter SQL-Workflow eine Qualitätslogik wiederholbar, überprüfbar und effizient machen kann.
Inhaltsverzeichnis
Warum SQL weiterhin das Rückgrat der Datenbereinigung bleibt
Profilierung Ihrer Daten, bevor Sie eine einzige Korrektur schreiben
Einen Defekt-Baseline etablieren
Duplikate finden, ohne die Produktion zu berühren
Umgang mit Nullwerten und Entfernen von Duplikaten im großen Stil
Deduplizieren mit einer expliziten Survivor-Regel
Wissen, wie Eindeutigkeit mit Nullwerten umgeht
Standardisierung von Textformaten und Beheben von Datentypen
Konvertierungen explizit machen
Vor der Deduplizierung standardisieren
Qualität sichern mit Constraints und Validierungsregeln
Harte Ablehnung oder weiche Quarantäne wählen
Der Schritt über einmalige Skripte hinaus zur kontinuierlichen Überwachung
Warum SQL weiterhin das Rückgrat der Datenbereinigung bleibt
Ein großer Analytics-Workload kann mehr Zeit mit der Vorbereitung von Daten verbringen als mit deren Analyse. Ein vielzitierter Benchmark besagt, dass Analysten und Data Scientists bis zu 80 % ihrer Zeit mit der Bereinigung und Vorbereitung von Daten verbringen, eine Erkenntnis, die in dieser Übersicht zur SQL-Datenbereinigung von Domo diskutiert wird. Diese Aufteilung erklärt, warum Operationen wie das Filtern von Nullwerten, das Entfernen von Duplikaten, das Standardisieren von Formaten und das Validieren von Bereichen zu den Grundfertigkeiten für Data Engineers und Analytics Engineers wurden.
SQL ist nah an den Daten angesiedelt, was in modernen ELT-Architekturen eine wichtige Rolle spielt. Rohdatensätze können in ein Warehouse geladen und dort transformiert werden, wo sie bereits liegen, anstatt wiederholt extrahiert, verschoben und in einem anderen System verarbeitet zu werden. Die Datenbank wird zur Ausführungsebene für die Qualitätslogik, während SQL-Anweisungen eine deterministische Aufzeichnung darüber liefern, was sich warum geändert hat.
Ein typischer Vorfall beginnt mit einem kleinen Fehler, der sich zu einem großen Berichtsproblem auswächst:
Doppelte Geschäftsereignisse: Ein Wiederholungsversuch bei einem Ingestions-Job erstellt zwei Zeilen für eine Transaktion, was den Umsatz oder das Volumen künstlich aufbläht.
Fehlende Beziehungsschlüssel: Ein fehlender Kunden- oder Produktschlüssel (Nullwert) verhindert das Match bei einem Join, sodass das Dashboard die Aktivität zu niedrig ausweist.
Format-Drift: Eine Quelle sendet ein Datum als Text in einer anderen Konvention, was Datensätze in den falschen Berichtszeitraum verschiebt.
Sentinel-Werte: Leere Zeichenfolgen, Platzhalterdaten oder Nullen stehen für fehlende Informationen und bestehen oberflächliche Nullprüfungen.
Produktionsregel: Behandeln Sie die Bereinigung als kontrollierte Datenoperation, nicht als improvisierte Reihe von Korrekturen innerhalb einer Dashboard-Abfrage.
Die Unterscheidung ist wichtig, da SQL Fehler sowohl beheben als auch verbergen kann. Ein COALESCE kann zwar dafür sorgen, dass ein Bericht gerendert wird, blendet aber einen fehlenden Wert aus, der eigentlich einen vorgelagerten Vorfall auslösen sollte. Ein weit gefasstes DELETE kann Duplikate entfernen, löscht aber möglicherweise auch den gültigen Datensatz, der hätte behalten werden sollen. Eine gute Bereinigungslogik klassifiziert Fehler zuerst, isoliert betroffene Zeilen und bewahrt genügend Belege auf, um die Entscheidung zu prüfen.
Für Leser, die breitere SQL-Beispiele und praktische Perspektiven suchen, bieten die SQL-Ressourcen von Wonderment Apps nützlichen Kontext rund um die Sprache und ihre Anwendungen. Für Teams, die eine Warehouse-native Qualitätsausführung evaluieren, ist dignas datenbankinterne Anleitung zur Datenqualität relevant, da Prüfungen nahe an den Daten unnötige Bewegungen reduzieren und die Validierungslogik von fragilen externen Skripten trennen.
Profilierung Ihrer Daten, bevor Sie eine einzige Korrektur schreiben
Der teuerste Bereinigungsfehler ist oft der erste: das Schreiben eines UPDATE, bevor das Problem gemessen wurde. Ein Profil liefert Ihnen eine Baseline, zeigt, ob das Problem isoliert oder systemisch ist, und ermöglicht es Ihnen, den Datensatz vor und nach der Behebung zu vergleichen.
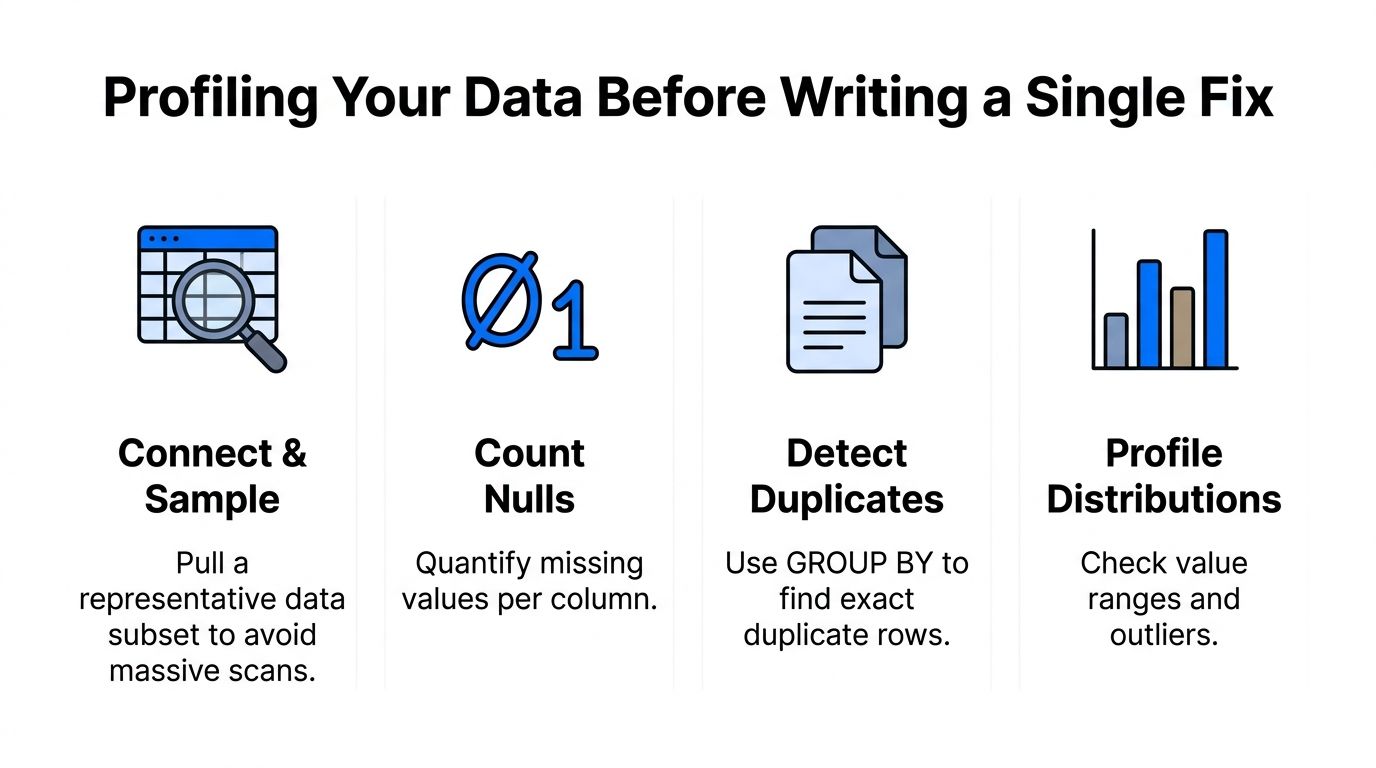
Beginnen Sie mit einer repräsentativen Stichprobe, wenn die Tabelle groß ist. Eine Stichprobe ersetzt keine vollständige Validierung, hilft Ihnen jedoch, Formate und Geschäftswerte zu prüfen, ohne sofort einen massiven Scan zu erzwingen. Führen Sie gezielte Aggregate auf der gesamten Tabelle aus, wenn die Warehouse-Engine und Partitionierung diese Prüfungen praktikabel machen.
Einen Defekt-Baseline etablieren
Zählen Sie bei Spalten, die Nullwerte zulassen, die fehlenden Werte direkt, anstatt sich auf eine visuelle Stichprobe zu verlassen:
Eine Null-Rate ist nützlich, weil sie den Defekt messbar und über Pipeline-Läufe hinweg vergleichbar macht. Sie können die Fehlmengen auch nach Quellsystem, Partition oder Ingestions-Datum gruppieren, um eine langjährige Dateneigenschaft von einem kürzlichen Systembruch zu unterscheiden.
Prüfungen auf eindeutige Werte decken unerwartete Kategorien auf:
Suchen Sie nach Schreibweisenvarianten, inkonsistenter Groß-/Kleinschreibung, leeren Zeichenfolgen und Werten, die gegen das Geschäftsvokabular verstoßen. Eine Spalte, die anscheinend nur wenige Status enthält, kann tatsächlich mehrere Darstellungen desselben Zustands aufweisen.
Duplikate finden, ohne die Produktion zu berühren
Die Erkennung exakter Duplikate beginnt mit der Gruppierung der Spalten, die den Datensatz definieren:
Diese Abfrage sagt Ihnen, wo Duplikate existieren, aber nicht, welche Zeile erhalten bleiben soll. Erfassen Sie verdächtige Datensätze in einer separaten Staging-Tabelle und schließen Sie Ingestions-Metadaten, Quellpriorität, Aktualisierungszeitstempel und, falls verfügbar, einen stabilen Surrogatschlüssel ein.
Die genaue Syntax variiert je nach Warehouse, aber das Arbeitsprinzip bleibt gleich: Experimentieren Sie niemals direkt auf der Produktionsrelation, wenn Sie Kandidaten zuerst isolieren können. Praktische Anleitungen zur SQL-Bereinigung empfehlen außerdem, Transformationen an kleinen Teilmengen zu validieren, bevor sie im großen Stil angewendet werden, was den Schadensradius eines fehlerhaften Prädikats verringert. Die bei der Warehouse-Bereinigung verwendeten Datenprofilierungstechniken ergänzen diesen Ansatz, indem sie die Inspektionsphase explizit machen, anstatt sie als optionale Vorbereitung zu behandeln.
Zuerst messen, danach reparieren. Wenn Sie nicht angeben können, wie viele Zeilen betroffen sind, können Sie die Änderung nicht sicher überprüfen.
Umgang mit Nullwerten und Entfernen von Duplikaten im großen Stil
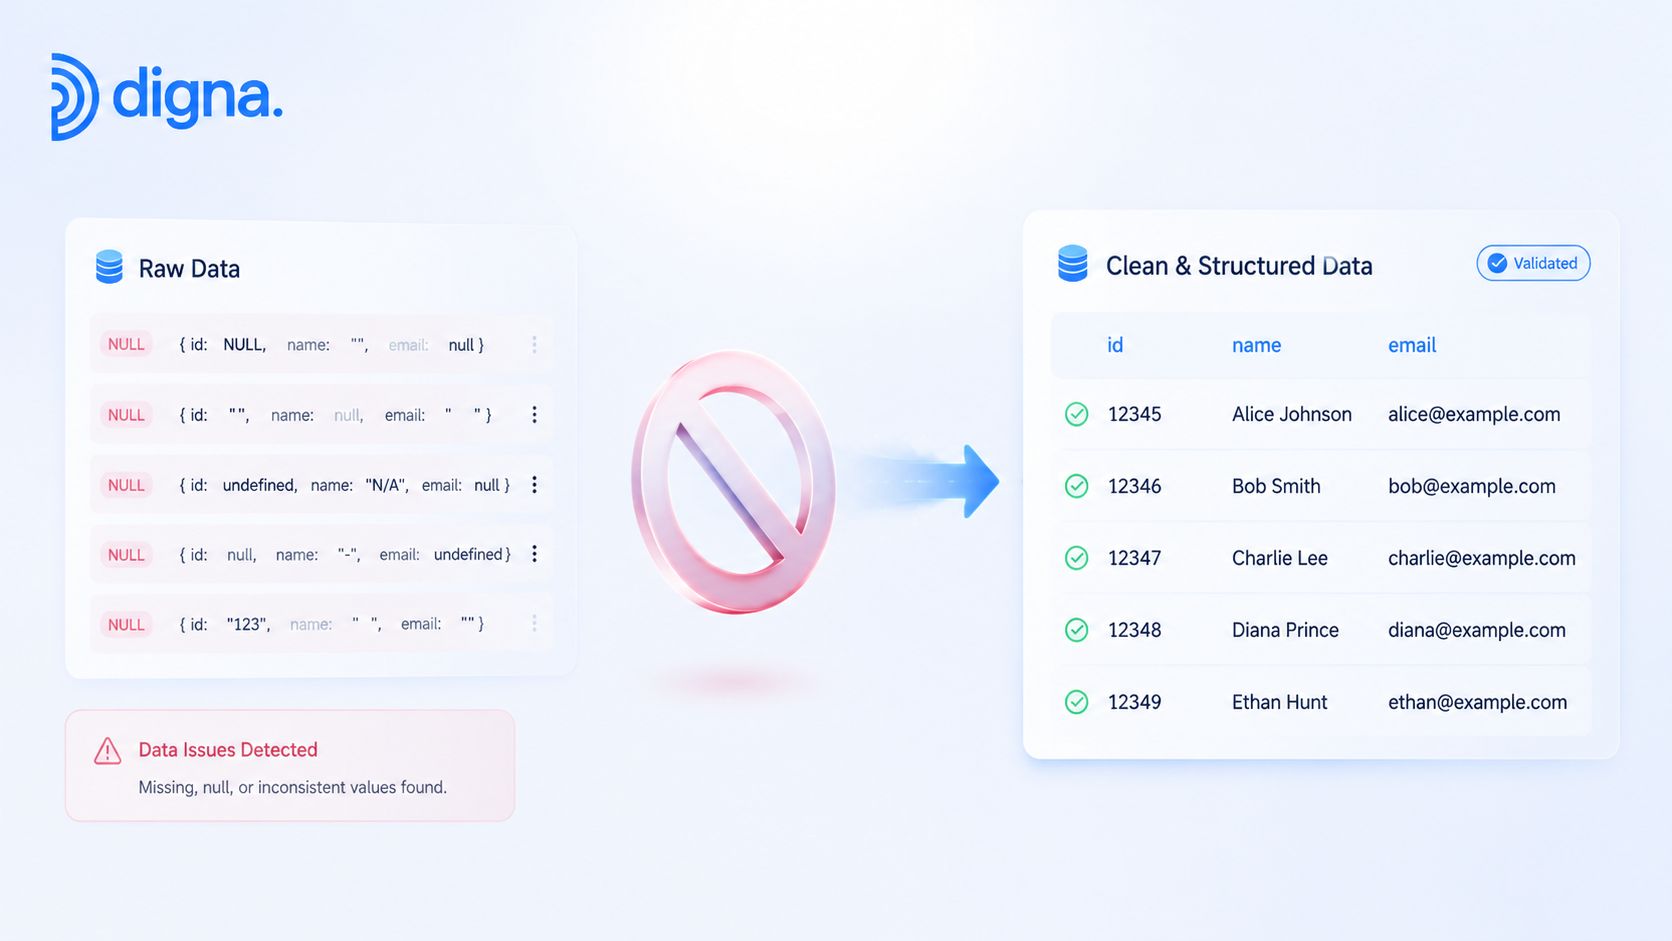
Der Umgang mit Nullwerten ist eine geschäftliche Entscheidung, die als SQL-Ausdruck getarnt ist. Das Ersetzen jedes fehlenden Wertes durch einen Standardwert vereinfacht zwar nachgelagerte Abfragen, kann jedoch auch ein „Unbekannt“ in eine falsche Behauptung verwandeln. Halten Sie den Originalwert verfügbar, wenn die Unterscheidung wichtig ist.
COALESCE ist angemessen, wenn ein Fallback eine klare Bedeutung hat:
Dieses Muster ist für die Präsentation sicherer als für die irreversible Speicherung. Wenn eine fehlende Währung bedeutet, dass die Quelle die erforderlichen Informationen nicht bereitgestellt hat, ist ein Validierungs-Flag ehrlicher:
NULLIF hilft dabei, bekannte Platzhalter vor der Profilierung in echte Nullwerte umzuwandeln:
Sie können auch bedingte Logik verwenden, wenn der korrekte Ersatz von einer dokumentierten Regel abhängt. Leiten Sie ein Kundenattribut nicht von einem unbeteiligten Feld ab, nur weil die Abfrage einen Nicht-Null-Wert benötigt.
Deduplizieren mit einer expliziten Survivor-Regel
ROW_NUMBER() ist das bewährte Muster zur Identifizierung eines einzigen verbleibenden Datensatzes innerhalb jeder Duplikatgruppe:
Die ORDER BY-Klausel ist der entscheidende Teil. „Den neuesten behalten“ funktioniert nur, wenn der Zeitstempel vertrauenswürdig ist und es bei Gleichstand einen deterministischen Fallback gibt. Wenn sich Datensätze in ihrer Vollständigkeit unterscheiden, ordnen Sie sie nach einer dokumentierten Vollständigkeitsregel, anstatt davon auszugehen, dass die zuletzt eingetroffene Zeile die beste ist.
Materialisieren Sie bei Tabellen auf Warehouse-Ebene das bewertete Ergebnis nach Möglichkeit in eine neue Relation oder eine Ersatzpartition. Das Neuerstellen einer sauberen Partition kann sicherer sein, als ein massives, zeilenweises Löschen durchzuführen, insbesondere wenn die Tabelle geclustert oder partitioniert ist. Bewahren Sie abgelehnte Zeilen in einer Audit-Tabelle auf, falls die Duplikate eine Korrektur im Quellsystem erfordern.
Wissen, wie Eindeutigkeit mit Nullwerten umgeht
SQL Server weist ein besonders wichtiges Verhalten auf: Ein UNIQUE-Constraint erlaubt NULL, aber es ist nur ein einziger NULL-Wert pro eingeschränkter Spalte zulässig, wie in Microsofts Referenz für Unique- und Check-Constraints dokumentiert. Dieses Verhalten kann Teams überraschen, die optionale Felder bereinigen, da die Handhabung von Nullwerten beeinflusst, ob spätere Datensätze akzeptiert oder abgelehnt werden.
Nutzen Sie Datenvollständigkeitsprüfungen, um zwischen „fehlend, aber zulässig“ und „fehlend und ungültig“ zu unterscheiden. Löschen Sie Duplikate nur, wenn die Identitätsregel eindeutig ist. Andernfalls markieren Sie die Gruppe zur Überprüfung und bewahren Sie die Belege auf, die erklären, warum ein bestimmter Datensatz ausgewählt wurde.
Standardisierung von Textformaten und Beheben von Datentypen
Textinkonsistenzen überstehen oft grundlegende Tests, da sie für einen Menschen korrekt aussehen. Ein nachgestelltes Leerzeichen in einem Join-Schlüssel, unterschiedliche Groß-/Kleinschreibung in einem Status oder ein Unicode-Zeichen, das einem ASCII-Zeichen ähnelt, können zu nicht übereinstimmenden Joins und fragmentierten Aggregaten führen.
Normalisieren Sie Werte zuerst in einer kontrollierten Projektion:
TRIM entfernt umschließende Leerzeichen, während UPPER und LOWER eine konsistente Vergleichsform etablieren. REPLACE kann bekannte Formatierungszeichen entfernen, aber pauschale Ersetzungen sind riskant, wenn Satzzeichen eine Bedeutung tragen. Reguläre Ausdrücke sind nützlich für die Mustervalidierung und gezielte Korrekturen, sofern das Warehouse sie unterstützt. Sie sollten jedoch an echten Quellvarianten getestet und nicht als universeller Reiniger angewendet werden.
Konvertierungen explizit machen
Implizite Typumwandlungen (Casts) sind beim Erkunden praktisch, in der Produktion jedoch gefährlich. Ein Textwert kann je nach Engine, Sitzungseinstellungen, Region oder Zieltyp unterschiedlich konvertiert werden. Explizite CAST- oder CONVERT-Anweisungen machen die beabsichtigte Darstellung sichtbar:
Profilieren Sie vor dem Konvertieren Werte, die das erwartete Format verfehlen. Ein fehlgeschlagener Cast sollte als Qualitätsausnahme erfasst und nicht einfach verworfen werden. Überprüfen Sie auch die Genauigkeit (Precision) und Skalierung (Scale), da ein numerischer Zieltyp an Aussagekraft verlieren kann, wenn er enger ist als die Quelle.
Temporale Daten erfordern noch mehr Sorgfalt. Ein Zeitstempel ohne Zeitzonenkontext kann sich verschieben, wenn Systeme ihn unter unterschiedlichen Sitzungseinstellungen interpretieren. Standardisieren Sie die Quellkonvention, konvertieren Sie mit einer expliziten Zeitzonenrichtlinie und behalten Sie den ursprünglichen Rohwert bei, bis das Ergebnis die Validierung besteht.
Standardisieren vor der Deduplizierung
Die Reihenfolge ist wichtig. Eine praktische Bereinigungssequenz besteht darin, Nullwerte, Duplikate und ungewöhnliche Formate zu untersuchen, dann den Text zu standardisieren, Typen zu korrigieren und schließlich zu deduplizieren, nachdem äquivalente Werte in eine gemeinsame Form gebracht wurden. Diese Reihenfolge wird im Leitfaden zur SQL-Datenbereinigung bezüglich Inspektion und Standardisierung beschrieben.
Wenn Sie vor dem Trimmen und Normalisieren deduplizieren, bleiben Datensätze wie ACME und ACME getrennt, obwohl das Geschäft sie als denselben Schlüssel behandelt. Wenn Sie Constraints vor der Typkonvertierung hinzufügen, weist die Datenbank möglicherweise gültige eingehende Datensätze ab oder behält eine ungeeignete Darstellung bei. Halten Sie rohe, normalisierte und validierte Spalten während der Entwicklung getrennt, damit Reviewer jede Transformation vergleichen können.
Qualität sichern mit Constraints und Validierungsregeln
Ein Bereinigungsskript repariert den aktuellen Batch. Ein Constraint schützt den nächsten Batch. Nutzen Sie Datenbank-Leitplanken dort, wo die Regel stabil und lokal für den Datensatz ist und wichtig genug, um ungültige Daten beim Einlesen abzuweisen.
Constraint | Geltungsbereich | Bester Anwendungsfall |
|---|---|---|
| Vorhandensein der Spalte | Erforderliche Identifikatoren, Daten und Schlüssel |
| Einzelne Spalte oder Kombination | Identitätskontrolle und Duplikatvermeidung |
| Boolesche Regel auf Zeilenebene | Zulässige Bereiche, Status und Datumsreihenfolge |
NOT NULL ist unkompliziert, sollte jedoch eine tatsächliche Anforderung widerspiegeln. Die Anwendung auf ein optionales Attribut führt zu operativer Reibung, ohne die Korrektheit zu verbessern. UNIQUE funktioniert gut für natürliche Identifikatoren oder zusammengesetzte Geschäftsschlüssel, vorausgesetzt, Sie haben definiert, wie sich Nullwerte und verspätet eintreffende Aktualisierungen verhalten sollen.
CHECK-Constraints drücken Regeln aus wie:
ANSI-SQL-CHECK-Ausdrücke können als TRUE, FALSE, oder UNKNOWN ausgewertet werden und sind auf die Domänenintegrität beschränkt. Sie können die Werte einer Zeile validieren, aber sie können keine anderen Zeilen auf zeilenübergreifende Konsistenz prüfen, wie in dieser Referenz zur Migration von SQL-Constraints erklärt wird. Ein CHECK kann einen negativen Betrag oder eine ungültige Datumsreihenfolge ablehnen. Es kann jedoch nicht bestätigen, ob ein Kontosaldo mit einer separaten Tabelle übereinstimmt.
Harte Ablehnung oder weiche Quarantäne wählen
Harte Constraints sind angemessen, wenn das Akzeptieren einer fehlerhaften Zeile eine kritische Tabelle beschädigen würde und die Quelle Fehler schnell korrigieren kann. Sie sind weniger geeignet, wenn vorgelagerte Systeme regelmäßig unvollständige Datensätze senden, die vor dem Abschluss untersucht werden müssen.
Ein weiches Muster speichert den Datensatz und fügt Validierungsspalten wie is_valid, failure_reason oder rule_name hinzu. Nachgelagerte Modelle können fehlerhafte Zeilen ausschließen, während die Betriebsteams die Sichtbarkeit des Quellfehlers behalten. Dieser Ansatz erfordert mehr Designaufwand, verhindert jedoch, dass ein vorübergehendes Quellproblem zu einem fehlgeschlagenen Ladevorgang ohne Diagnosekontext führt.
Die Richtlinien zu SQL-Datenvalidierungsregeln und kontinuierlicher Qualität bieten einen nützlichen Rahmen für die Trennung von erforderlichen Werten, Format, Vollständigkeit, Eindeutigkeit und referenzieller Integrität. Kombinieren Sie in der Praxis Constraints mit einer Staging-Validierung. Constraints sind die letzte Instanz, kein Ersatz für Profilierung, Fehlerklassifizierung oder einen Audit-Trail.
Der Schritt über einmalige Skripte hinaus zur kontinuierlichen Überwachung
Die SQL-Bereinigung ist reaktiv. Sie repariert Datensätze, nachdem ein Fehler in die Pipeline gelangt ist, während die kontinuierliche Überwachung nach den Bedingungen sucht, die auf eine Regression hinweisen.
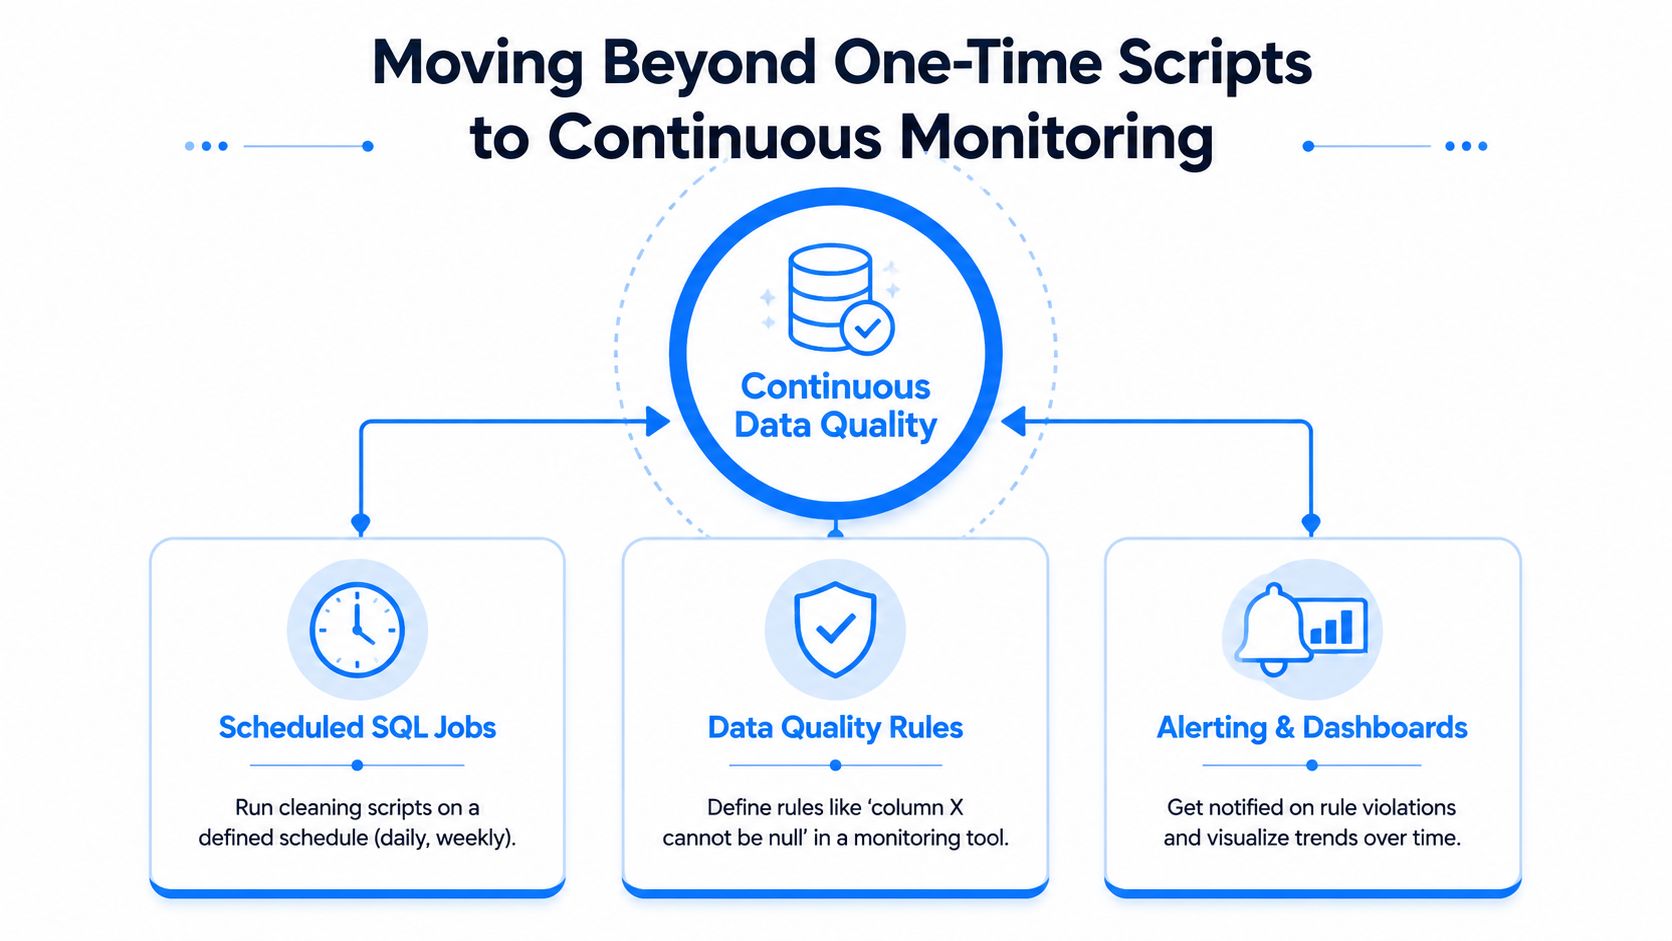
Ein ausgereifter Workflow legt mehrere Signale über den bereinigten Datensatz:
Geplante SQL-Jobs: Führen Sie deterministische Transformationen nach einem festgelegten Zeitplan aus und zeichnen Sie die Anzahl der betroffenen Zeilen auf.
Qualitätsregeln: Überprüfen Sie erforderliche Werte, gültige Formate, Eindeutigkeit, referenzielle Integrität und Geschäftsbedingungen.
Anomalieerkennung: Vergleichen Sie aktuelle Verteilungen und Volumina mit etabliertem Verhalten, um ungewöhnliche Änderungen aufzudecken.
Timeliness-Prüfungen: Erkennen Sie fehlende, verspätete oder unerwartet frühe Lieferungen.
Schema-Tracking: Identifizieren Sie hinzugefügte oder entfernte Spalten und Datentypänderungen, bevor nachgelagerte Abfragen fehlschlagen.
Die richtige Investition hängt von der Fehlerart ab. Schreiben Sie ein SQL-Skript, wenn die Regel deterministisch, die Transformation wiederholbar und der betroffene Datensatz klar eingegrenzt ist. Fügen Sie eine automatisierte Observability hinzu, wenn Fehler wiederholt auftreten, sich das Quellverhalten ändert, das Timing der Bereitstellung eine Rolle spielt oder ein Dashboard-Ausfall durch eine manuelle Überprüfung erst zu spät entdeckt werden würde.
Plattformen wie digna führen Qualitäts- und Anomalieprüfungen direkt in der Datenbankumgebung des Kunden aus. Dies ermöglicht es Teams, das Datenverhalten zu überwachen, ohne Produktionsdaten in eine externe Verarbeitungsebene verschieben zu müssen. Die Funktionen zur Datenqualitätsüberwachung schließen die Lücke zwischen geplanter Bereinigung und laufender Erkennung, indem sie Validierung, Anomalie-, Timeliness- und strukturelle Überwachung kombinieren.
Nutzen Sie digna, um datenbankinterne Validierungen, Anomalieerkennung, Timeliness-Prüfungen und Schema-Tracking für die Datensätze auszuführen, von denen Ihre SQL-Pipelines abhängen. Besuchen Sie digna, um zu sehen, wie kontinuierliche Überwachung eine einmalige Bereinigungslogik in ein operatives Datenqualitätssystem verwandeln kann.
Häufig gestellte Fragen
Warum bleibt SQL das Rückgrat der Datenbereinigung?
Weil es nah an den Daten sitzt, was in modernen ELT-Architekturen zählt, in denen die Transformation nach dem Laden erfolgt. Ein vielzitierter Maßstab nennt bis zu 80 % der Zeit von Analystinnen und Data Scientists für Bereinigung und Aufbereitung, also ist der Ort dieser Arbeit keine Kleinigkeit.
Welche Defekte richten im Reporting den größten Schaden an?
Vier wiederholen sich: doppelte Geschäftsereignisse, wenn ein Ingestion-Retry zwei Zeilen erzeugt und den Umsatz aufbläht; fehlende Beziehungsschlüssel, wenn ein Nullwert den Join verhindert und das Dashboard unterzählt; Formatdrift, wenn ein Datum in anderer Konvention eintrifft und Datensätze in die falsche Periode verschiebt; und Platzhalterwerte, die oberflächliche Nullprüfungen bestehen.
Warum sind Platzhalterwerte besonders gefährlich?
Weil sie wie Daten aussehen. Leere Zeichenketten, Platzhalterdaten und Nullen stehen für fehlende Information und bestehen eine Nullprüfung sauber, sodass der Datensatz als vollständig zählt und im entscheidenden Feld dennoch nichts Nutzbares trägt.
Kann SQL Defekte ebenso verbergen wie beheben?
Ja, und deshalb sollte Bereinigung eine kontrollierte Datenoperation sein und keine improvisierte Reihe von Korrekturen in einer Dashboard-Abfrage. Ein COALESCE in der Reporting-Schicht entfernt Symptom und Beweis zugleich.
Was tut man vor der ersten Korrektur?
Die Daten profilieren. Wer aktuelles Volumen, Verteilung, Nullwertquoten und Wertemuster kennt, weiß, welche Defekte tatsächlich vorliegen, statt jener, an die der letzte Vorfall alle denken lässt.



