Datenbank-Anomalie-Erkennung: Ein praktischer Leitfaden
|
9
min. Lesezeit

Das erste Anzeichen ist selten ein dramatischer Ausfall. Ein Umsatz-Dashboard bleibt grün, die Zeilenanzahlen sehen normal aus, und niemand alarmiert das Warehouse-Team, aber eine unbemerkte Änderung im Upstream hat bereits einen Teil der Daten in einen Fallback-Pfad verschoben oder die Struktur eines Feeds verändert. Bis die Finanzabteilung bemerkt, dass die Prognose nicht stimmt, haben die fehlerhaften Zeilen bereits ihren Weg in Modelle, Berichte und Präsentationen für die Geschäftsführung gefunden.
Aus diesem Grund funktioniert die Anomalieerkennung in Datenbanken besser, wenn man das Warehouse selbst als überwachte Oberfläche betrachtet. Die nützliche Frage ist nicht nur, ob ein Diagramm seltsam aussieht, sondern ob Timeliness, Struktur und Verteilung der Daten noch mit der Baseline übereinstimmen, auf die sich Ihre Endnutzer verlassen. In der Praxis bedeutet dies SQL-native Feature-Extraktion, Baseline-Vergleich nahe an der Quelle und eine Alarmierung, die den Kontext versteht, anstatt bei jedem erwarteten Peak loszuschreien.
Inhaltsverzeichnis
Wenn schleichender Daten-Drift Ihre Berichte unbrauchbar macht
Extraktion von Erkennungsmerkmalen mit datenbankinternem SQL
Wahl zwischen statistischen Baselines und KI-gestütztem Lernen
Erstellung von Segment-Ähnlichkeits-Baselines für wiederkehrende Workloads
Erkennung von Schema-Drift und Lieferverzögerungen als ein Signal
Kontextbewusste Alarme entwickeln, denen die Menschen tatsächlich vertrauen
Einbindung der Datenbank-Anomalieerkennung in Ihren Observability-Stack
Wenn schleichender Daten-Drift Ihre Berichte unbrauchbar macht
Ein Finanzteam kann wochenlang demselben täglichen Umsatz-Dashboard vertrauen und dennoch falsch liegen. Eine einzige Schema-Umbenennung im Upstream, ein Zweig in einer Transformation oder eine Typänderung in einer Quelltabelle kann Zeilen in einen Standardpfad verschieben, sodass das Dashboard weiterhin geladen wird und die Zahlen ordentlich aussehen. Das Problem ist, dass der Nenner nun unvollständig ist und das Unternehmen Prognosen auf der Grundlage eines gefilterten Ausschnitts der Realität erstellt.
Dashboard-Prüfungen und dbt-ähnliche Assertions greifen zu kurz. Die Zeilenanzahlen können in einem normalen Bereich bleiben, während die aktiven Kunden-IDs nach unten driften, eine Pipeline kann zu spät ankommen, ohne komplett abzubrechen, oder eine zuvor gefüllte Spalte kann plötzlich an der falschen Stelle NULL-Werte aufweisen. Keines dieser Muster löst zwingend eine einfache Regel aus, aber alle können Entscheidungen verfälschen.
Ein Warehouse-nativer Ansatz fängt das Problem an der Quelle ab. Anstatt darauf zu warten, dass nachgelagerte Verbraucher bemerken, dass sich etwas seltsam anfühlt, vergleicht die Anomalieerkennung in Datenbanken den aktuellen Zustand der Daten mit dem normalen Verhalten dieser Tabelle, Metrik oder Pipeline. Das umfasst Struktur, Aktualität und Werteverteilung, nicht nur den Erfolg des Jobs.
Praxisregel: Wenn sich die Daten so geändert haben, dass ein Dashboard dies nicht von sich aus erklären kann, sollte Ihre Erkennungsebene dort angesiedelt sein, wo die Daten erzeugt werden, und nicht drei Tools weiter nachgelagert.
Die historische Lehre ist klar. Frühes Benchmarking zeigte bereits, dass die Qualität der Anomalieerkennung stark datenabhängig ist, und ein späterer Benchmark in weitaus größerem Maßstab bestätigte dies mit einer viel breiteren Abdeckung: Es wurden 30 Algorithmen über 57 Benchmark-Datensätze und 98.436 Experimente hinweg getestet, um Überwachungsgrad, Anomalietyp und Rauschbedingungen zu untersuchen (ADBench-Benchmark). Warum das in Warehouses wichtig ist, ist einfach: Workloads unterscheiden sich, Schemata driften ab und Baselines, die auf einem Datensatz funktionieren, können in produktionsnahen Umgebungen scheitern.
Extraktion von Erkennungsmerkmalen mit datenbankinternem SQL
Der schnellste Weg, die Anomalieerkennung nützlich zu machen, besteht darin, das Feature-Engineering innerhalb des Warehouses zu belassen. Wenn Sie Rohdatentabellen zuerst in einen separaten Feature Store exportieren, entstehen Latenzen, Redundanzen und ein weiterer Ort, an dem die Aktualität verloren gehen kann, noch bevor der Detektor überhaupt läuft. SQL kann die benötigten Signale bereits berechnen, also nutzen Sie es.
Beginnen Sie mit gleitenden Fenstern und Deltas
Für die meisten Warehouse-Prüfungen beginne ich mit gleitenden Aggregaten über 7-Tage- und 28-Tage-Fenster. Fensterfunktionen wie AVG, STDDEV und COUNT liefern Ihnen eine lokale Baseline, ohne die Datenbank zu verlassen, und LAG plus einfache Differenzen zeigen Änderungen im Periodenvergleich direkt in der Abfrage. Diese Kombination erfasst schleichenden Verfall, plötzliche Sprünge und Änderungen, die nur sichtbar werden, wenn Sie das heutige Ergebnis mit demselben Zeitpunkt des vorherigen Zyklus vergleichen.
Auch Perzentile sind wichtig. Ein Mittelwert kann flach bleiben, während sich der Median verschiebt, insbesondere bei ungleichmäßig verteilten Geschäftsdaten. Daher hilft PERCENTILE_CONT dabei, Drift zu erkennen, den auf Durchschnittswerten basierende Prüfungen übersehen. Klassische Methoden wie Standardabweichung, mittlere absolute Abweichung, Interquartilsabstand, Z-Score und modifizierter Z-Score sind nach wie vor nützlich, da sie transparent und kostengünstig auf einer Live-Tabelle berechnet werden können (klassische statistische Methoden).
Wenn eine Metrik wichtig genug ist, um einen Alarm auszulösen, ist sie auch wichtig genug, um direkt bei den Daten berechnet zu werden, nicht erst nach einem Batch-Export.
Ein praktisches Muster auf einer Faktentabelle mit zusammengesetztem Grain sieht beispielsweise so aus:
Partitionierung nach Tag und Metrik, sodass jedes Signal seinen eigenen Verlauf hat.
Berechnung gleitender Baselines für Mittelwert, Streuung und Anzahl.
Hinzufügen von verzögerten Deltas für Änderungen von Tag zu Tag und Woche zu Woche.
Persistierung des Ergebnisses in einer Feature-Tabelle, die von nachgelagerten Jobs gelesen werden kann, ohne alles neu berechnen zu müssen.
SQL-Muster | Verwendete Funktion | Aufgedecktes Signal |
|---|---|---|
Gleitende Baseline | AVG, STDDEV, COUNT | Lokaler Trend, Volatilität und fehlendes Volumen |
Perioden-Delta | LAG, Subtraktion | Stufenweise Änderungen und plötzliche Regression |
Median-Drift | PERCENTILE_CONT | Durch Durchschnittswerte maskierte Verteilungsverschiebung |
Hier zahlt sich die datenbankinterne Ausführung auch operativ aus. Sie vermeiden das Kopieren von Terabytes in ein anderes System und halten die Erkennungslogik nahe am Aktualitätssignal. Für einen architektonischen Vergleich dieses Musters siehe die interne Notiz über datenbankinterne Datenqualitätsausführung und sicherere externe Pipelines.
Wahl zwischen statistischen Baselines und KI-gestütztem Lernen
Statistische Baselines sind nach wie vor der richtige Ausgangspunkt für viele Produktionstabellen. Ein gleitender Mittelwert plus Standardabweichung, mittlere absolute Abweichung, Interquartilsabstand und Z-Scores sind leicht zu erklären, leicht zu prüfen und in SQL einfach auszuführen. Sie funktionieren besonders gut, wenn eine Metrik stabil ist, die Saisonalität schwach ausgeprägt ist und das Business einen klaren Schwellenwert anstelle einer Blackbox wünscht.
Die Schwachstelle zeigt sich, sobald die Datenreihen unruhig werden. Wöchentliche Zyklen, Feiertagseffekte und multivariate Interaktionen machen feste Schwellenwerte fehleranfällig, und die manuelle Abstimmung wird zur Wartungsaufgabe. Aus diesem Grund gibt es gelernte Baselines. Sie können mehr Kontext aufnehmen, Saisonalitäten besser verarbeiten und Beziehungen über Spalten oder Tabellen hinweg modellieren, die eine einzelne univariate Regel nicht erkennen würde.
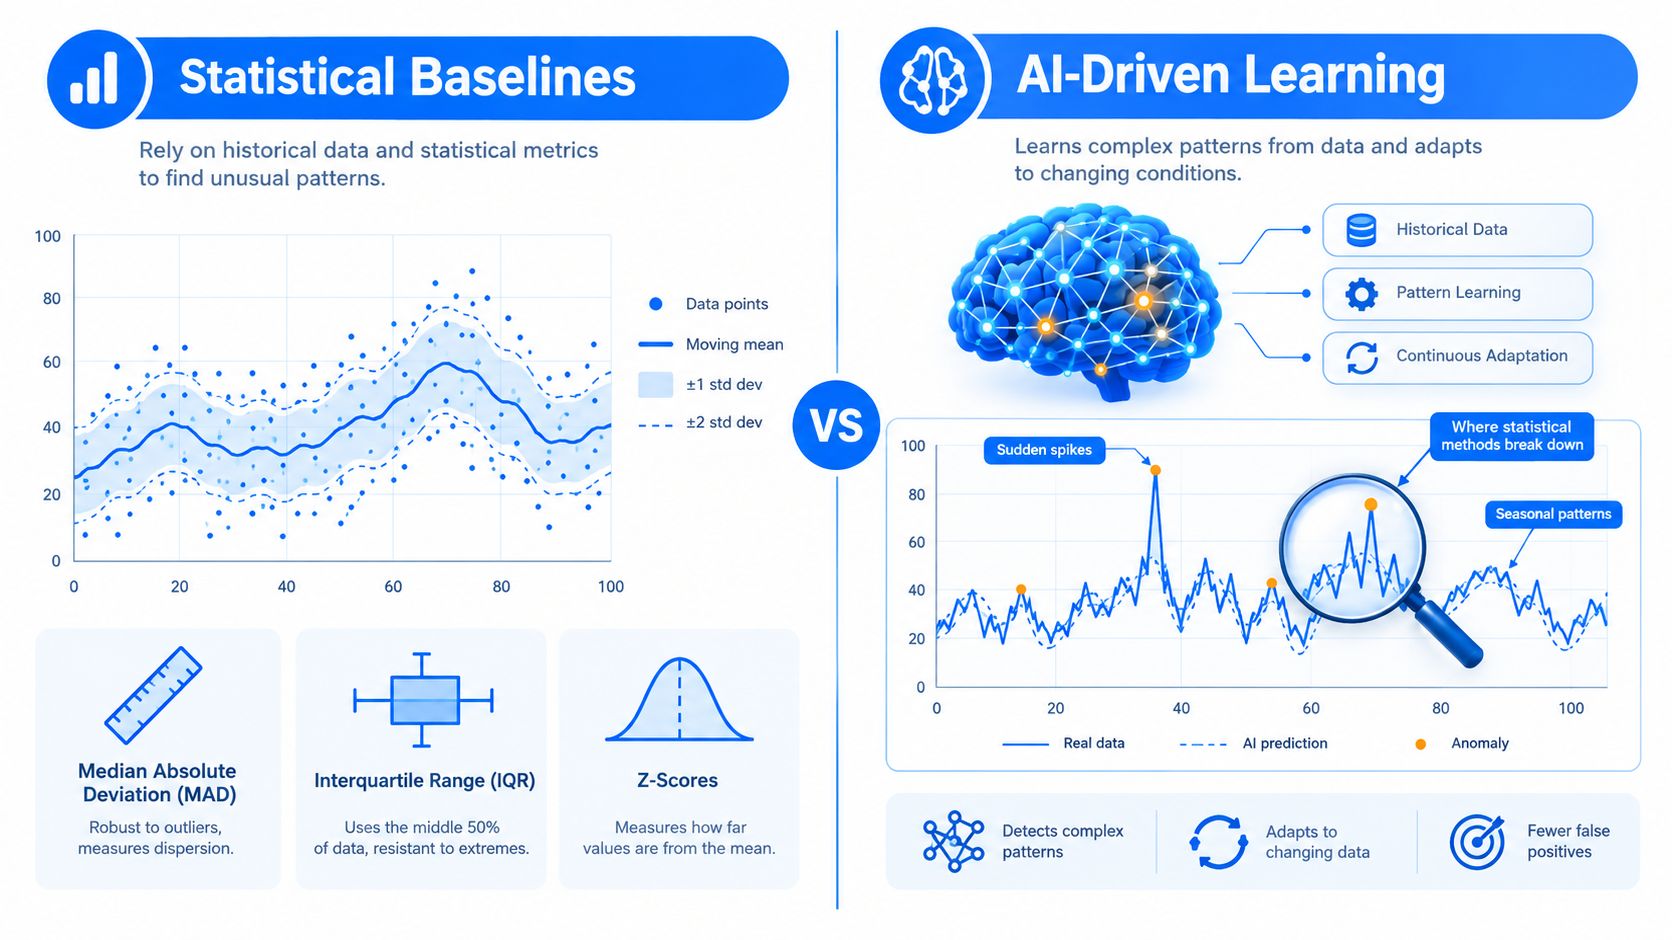
Der Kompromiss ist nicht nur mathematischer, sondern auch operativer Natur. Gelernte Modelle erfordern eine Trainings-Pipeline, Versionierung und die Berücksichtigung von Drift im Modell selbst. Zudem erschweren sie die Erklärbarkeit, wenn jemand fragt, warum ein Alarm auf Zeilen- oder Metrikebene ausgelöst wurde – ein echtes Problem in regulierten Umgebungen, in denen Teams nachvollziehbare Beweise und nicht nur einen Score benötigen.
Ein nützlicher Benchmark-Rahmen ist folgender: Statistische Methoden erfassen bei stabilen Metriken oft etwa 60-70 % der univariaten Anomalien bei nahezu null Fehlalarmen, während gelernte Baselines eine Trefferquote (Recall) von bis zu 85 % erreichen können, jedoch mehr Feinabstimmung erfordern. Dies sind interne Richtwerte und keine universellen Versprechen, aber sie decken sich mit dem, was die meisten Praktiker erleben, wenn sie von manuell konfigurierten Schwellenwerten zu modellbasierter Erkennung übergehen.
Wenn Sie einen praktischen Ausgangspunkt suchen, verwenden Sie statistische Baselines für Schwellenwerte pro Metrik und mehrschichtige gelernte Modelle für hochwertige Datenreihen mit hoher Varianz. Dieser Ansatz deckt sich mit der allgemeinen Branchenaufteilung zwischen erklärbaren Regeln und adaptiven Modellen. Deswegen sind Ressourcen wie KI-Anomalieerkennung im Social-Ops-Bereich eine nützliche Lektüre, selbst wenn Ihr Anwendungsfall ein Warehouse und keine Warteschlange für Kundenereignisse ist. Für einen tieferen statistischen Rahmen ist das interne Material zur statistischen Mustererkennung eine gute Ergänzung.
Erstellung von Segment-Ähnlichkeits-Baselines für wiederkehrende Workloads
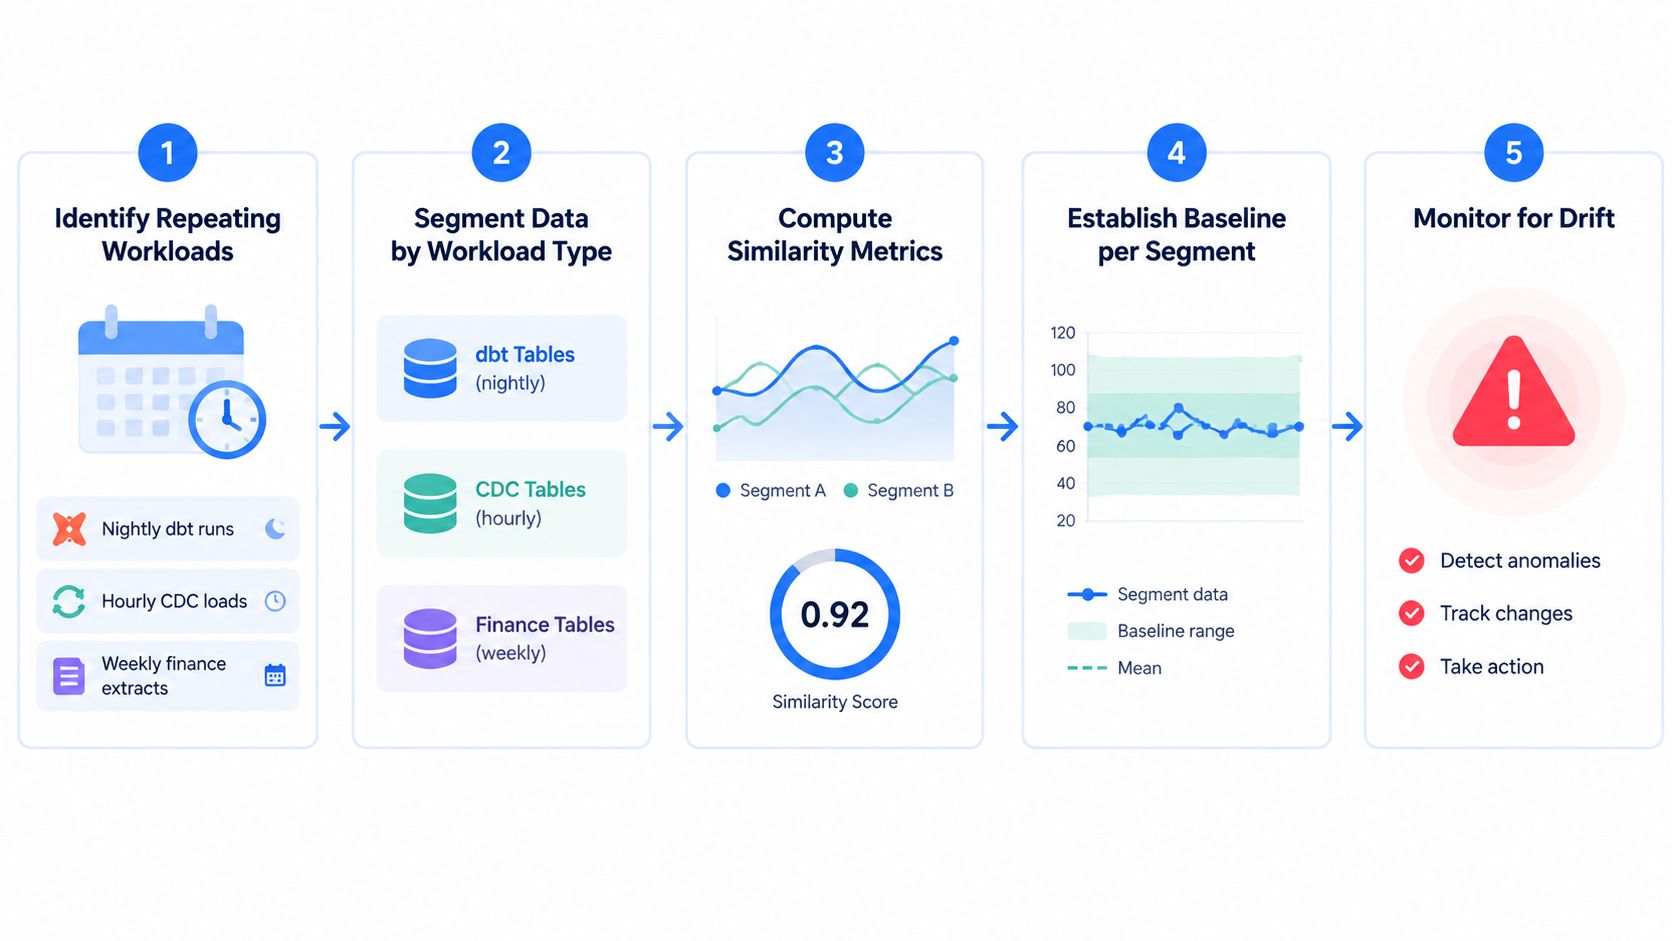
Wiederkehrende Workloads erfordern eine andere Baseline als dauerhaft laufende Metriken. Nächtliche dbt-Runs, stündliche CDC-Loads und wöchentliche Finanz-Exporte haben alle einen eigenen Rhythmus. Der richtige Vergleich lautet daher meist nicht „heute im Vergleich zu einem generischen Mittelwert“, sondern „heute im Vergleich zum ähnlichsten historischen Segment“. So trennen Sie tatsächlichen Drift von einem montäglichen Backfill oder einem Black-Friday-Peak.
Fingerabdruck für jeden Run in SQL erstellen
Beginnen Sie damit, für jeden abgeschlossenen Run im Warehouse einen Fingerabdruck zu erstellen. Typischerweise erfasse ich hierbei Zeilenanzahlen, einen Hash von Schlüsselspaltenverteilungen, Null-Raten sowie einige numerische Zusammenfassungen aus PERCENTILE_CONT oder einer entsprechenden Warehouse-Funktion. Diese Werte liefern Ihnen eine kompakte Darstellung des Workloads, ohne dass die gesamte Tabelle durch den Detektor geschleust werden muss.
Speichern Sie diese Fingerabdrücke in einer Tabelle baseline_segments, die nach job_id, day_of_week und hour_of_week indiziert ist. Vergleichen Sie dann das aktuelle Zeitfenster mit den K ähnlichsten vorherigen Segmenten unter Verwendung eines Ähnlichkeitsmaßes auf dem Fingerabdruck-Vektor. Fällt die Ähnlichkeit unter einen Prüfschwellenwert wie beispielsweise 0.85, sollte sich ein Mensch den Run ansehen, bevor er nachgelagerte Verbraucher beeinträchtigt.
Die Logik ist einfach, aber der Nutzen ist enorm: Sie fragen nicht, ob der Workload abstrakt gesehen „normal“ ist. Sie fragen, ob er sich wie seine eigene historische Vergleichsgruppe verhält, was weitaus besser zu Warehouses passt, in denen Saisonalität zum normalen Betrieb gehört.
Eine Baseline, die den Rhythmus ignoriert, wird bei gesundem periodischem Verhalten immer zu viele Fehlalarme auslösen.
Die Schwierigkeit liegt in veraltenden Baselines. Wenn sich ein Workload legitim weiterentwickelt, muss die Fingerabdruck-Bibliothek für ungültig erklärt und neu aufgebaut werden, da Sie sonst das neue Verhalten für immer mit einer veralteten Historie vergleichen. Das ist ebenso ein governance-Problem wie ein Modellierungsproblem und gehört in dieselbe Observability-Pipeline wie der Job selbst.
Für eine praktische Referenz zur Segmentierung wiederkehrenden Datenverhaltens ist der interne Leitfaden zu Datenprofilierungs-Techniken hier relevant.
Erkennung von Schema-Drift und Lieferverzögerungen als ein Signal
Die meisten Monitoring-Stacks trennen strukturelle Änderungen von der Aktualität. Diese Trennung ist zwar bequem, maskiert jedoch Fehler. Eine Schemaänderung kann pünktlich eintreffen und dennoch nachgelagerte Typkonvertierungen beschädigen, während eine verspätete Datei harmlos aussehen kann, bis sie zu einem veralteten Bericht und einer verletzten Service-Level-Vereinbarung (SLA) führt.
Struktur und Aktualität zusammen betrachten
Vergleichen Sie für den Schema-Drift das heute eingehende Schema mit einem Baseline-Schema und klassifizieren Sie die Unterschiede. Die konkreten Mengen sind fehlende Spalten (Β\I), neue Spalten (I\B) und Typenkonflikte in gemeinsamen Feldern (Muster zur Erkennung von Schema-Drift). Wenn fehlende Spalten oder Typenkonflikte auftreten, handelt es sich um eine zerstörende Änderung (Breaking Change). Wenn nur neue Spalten hinzukommen, ist die Änderung additiv.
Die Aktualität sollte direkt neben dieser Prüfung angesiedelt sein, nicht darunter. Ein Aktualitäts-Monitor kann jede Lieferung als pünktlich, verpätet, fehlend oder unvollständig klassifizieren, wobei der Zeitplan explizit definiert sein kann, beispielsweise an jedem Wochentag vor 7:30 Uhr (Überwachung der Datenaktualität). Wenn die tatsächliche Ankunftszeit zu stark von der Erwartung abweicht, wird der Lieferstatus Teil des Alarms – und nicht eines separaten Dashboards, das ohnehin niemand öffnet.
Signaltyp | Was es erfasst | Primäre SQL-Quelle | Typische Alarmlatenz |
|---|---|---|---|
Schema-Drift | Hinzugefügte, gelöschte oder typveränderte Spalten | INFORMATION_SCHEMA-Deltas | Sofort beim Ingest |
Lieferverzögerung | Verspätete, fehlende, verfrühte oder unvollständige Ladevorgänge | Ankunfts-Zeitstempel und Aktualitätstabellen | Bei Zeitplanüberschreitung |
Kombinierte Fehler | Strukturelle Änderung plus Verschlechterung der Aktualität | Verknüpfte Schema- und Aktualitätsprüfungen | Nahezu in Echtzeit |
Ein Praxisbeispiel verdeutlicht den Nutzen: Wenn ein Drittanbieter eine String-Spalte auf VARCHAR(500) erweitert und eine nachgelagerte numerische Konvertierung bei einem Teil der Zeilen fehlschlägt, sollte die Schemaprüfung anschlagen, bevor der Bericht erstellt wird. Eine reine Volumenprüfung würde wahrscheinlich erst am nächsten Tag reagieren – viel zu spät für eine operative Fehlerbehebung.
Dies ist ein typischer Fall, in dem eine Plattform wie digna als eine Option unter anderen eingesetzt werden kann, da sie Aktualität, Schema-Tracking und datenbankinterne Prüfungen in einem einzigen Betriebsmodell vereint. Der interne Erklärungsbeitrag zu Schema-Drift und strukturellen Änderungen, die Datenpipelines beschädigen, passt gut zu diesem Muster.
Kontextbewusste Alarme entwickeln, denen die Menschen tatsächlich vertrauen
Mehr Alarme bedeuten nicht automatisch eine bessere Erkennung. Sie führen meist zu Alarmmüdigkeit (Alert Fatigue). Sobald ein Team mit irrelevanten Benachrichtigungen bombardiert wird, wird die wirklich wichtige Meldung zusammen mit dem Spam ignoriert. Ein Team, das täglich 40 Slack-Benachrichtigungen erhält, wird die Kanäle stumm schalten – und so maskieren sich echte Ausfälle direkt vor unseren Augen.
Die Lösung ist eine kontextbewusste Alarmierung. Unterdrücken Sie bekannte Bereitstellungsfenster mithilfe einer deploy_event-Tabelle, stufen Sie die Priorität herab, wenn eine Abweichung mit einer geplanten Batch-Änderung übereinstimmt, und verlangen Sie ein zweites, bestätigendes Signal, bevor der Bereitschaftsdienst alarmiert wird. Diese Bestätigung kann je nach Workload eine weitere Metrik, eine Schemaänderung oder eine Verschlechterung der Aktualität sein.
Die Benachrichtigung selbst sollte den Alarm erklären. Liefern Sie das verwendete Baseline-Segment, den Z-Score oder den Ähnlichkeitswert sowie die wichtigsten Einflussfaktoren mit, damit der Entwickler die Ursache schnell eingrenzen kann. Wenn die Person im Bereitschaftsdienst den Kontext erst aus drei verschiedenen Dashboards zusammensuchen muss, ist der Alarm nicht reif für die Produktion.
Praxisregel: Wenn ein Entwickler den Alarm nicht in weniger als einer Minute versteht, liefert er zu wenig Kontext.
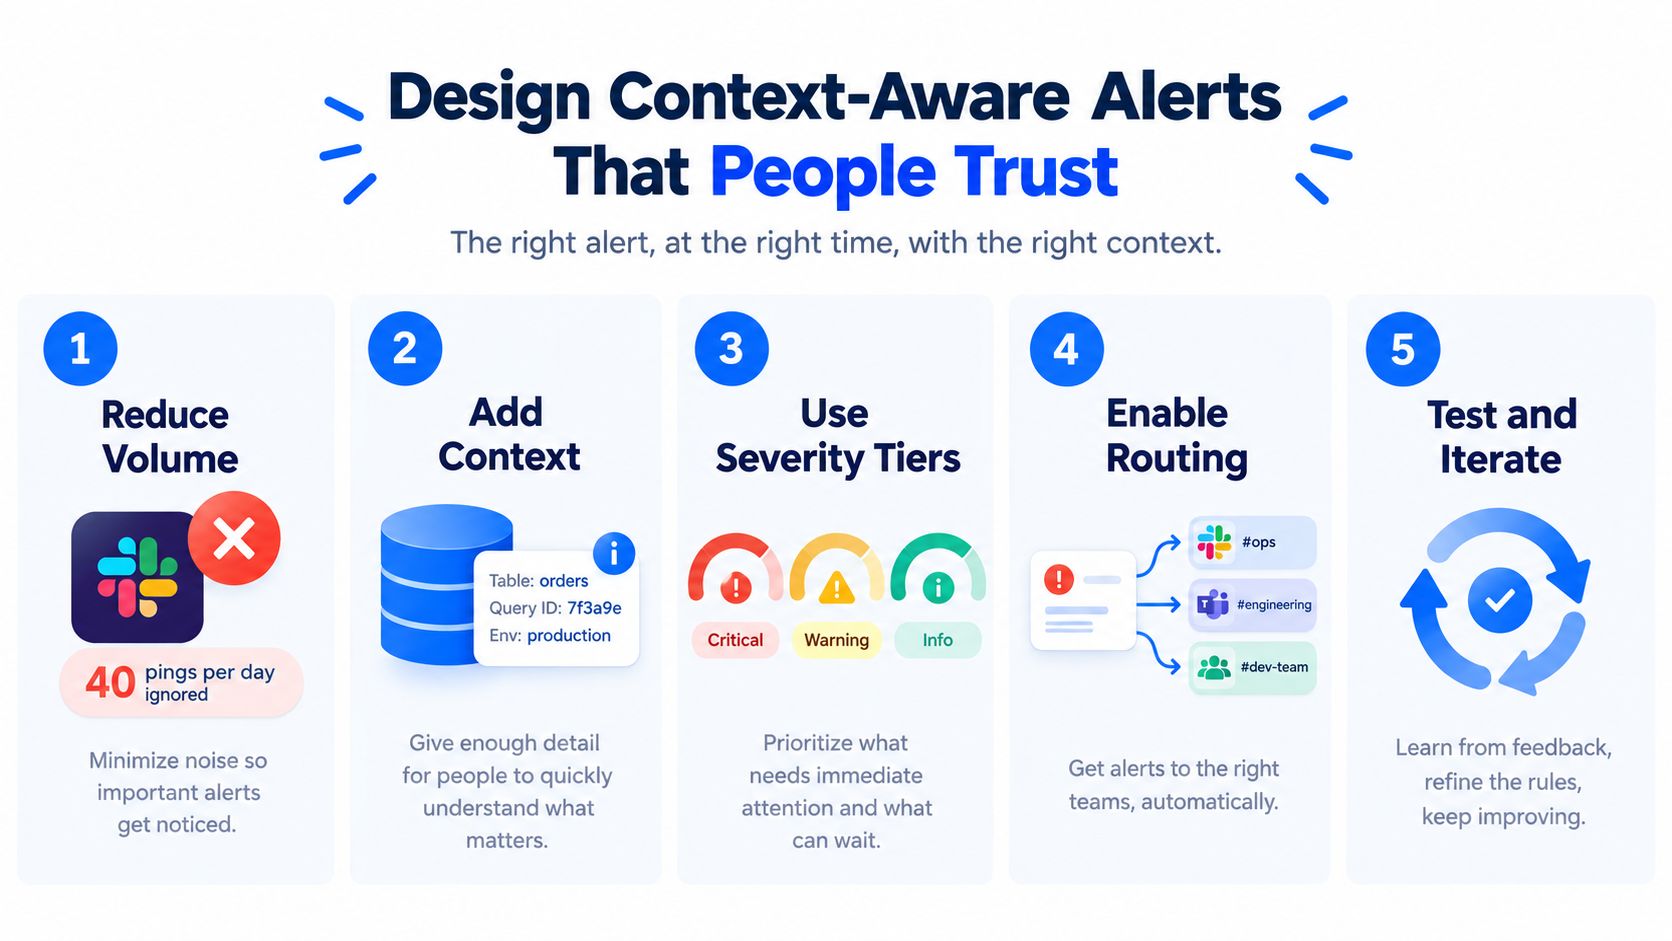
Das operative Ziel sollte bei weniger als 5 hochgradig relevanten Alarmen pro Woche und kritischer Tabelle liegen. Vertrauen wird dabei an der Rate der ignorierten Alarme gemessen und nicht an der Gesamtzahl der Alarme. Dieser Ansatz verlagert den Schwerpunkt der Diskussion von „Wie viele Alarme haben wir ausgelöst?“ hin zu „Für welche Alarme hat es sich gelohnt, jemanden aufzuwecken?“. Für weitere Informationen darüber, wie operative Teams diese Signale weiterleiten und interpretieren, bietet der Sift-AI-Artikel über Anomalieerkennung in Social Ops einen guten Vergleichspunkt, auch wenn der Bereich ein anderer ist.
Einbindung der Datenbank-Anomalieerkennung in Ihren Observability-Stack
Anomaliesignale sollten nicht auf einem isolierten Dashboard verstauben. Behandeln Sie sie als Telemetriedaten, versehen Sie sie mit Tags für Tabelle, Schema und run_id und leiten Sie sie in denselben Observability-Pfad wie Anwendungs- und Infrastrukturmetriken. Auf diese Weise werden ein fehlerhafter Ladevorgang, ein Deployment und ein Anstieg der Infrastrukturfehler in derselben Incident-Timeline dargestellt – anstatt in drei verschiedenen Tools.
Verbinden Sie das Warehouse mit dem Incident-Feed
Warehouse-native Scheduler sind meist der sauberste Ort, um die Feature-Abfragen auszuführen. Snowflake Tasks, geplante BigQuery-Abfragen, dbt-Tests und Airflow-Sensoren passen alle in dieses Schema, solange der Rhythmus mit den Aktualitätserwartungen der Daten übereinstimmt. Das Anomalieereignis kann dann über OpenTelemetry oder einen nativen Exporter in PagerDuty, Slack oder das jeweilige Standard-Alarmierungssystem fließen, dem das Bereitschaftsteam bereits vertraut.
Der Kompromiss liegt auf der Hand: Pull-basierte REST-Abfragen sind einfach zu implementieren, weisen jedoch eine hohe Latenz auf. Ereignisbasierte Emitter, die direkt nach Abschluss eines Schreibvorgangs reagieren, fangen Probleme schneller ab, erzeugen jedoch eine Kopplung zwischen dem Datenproduzenten und dem Monitoring-Pfad. Das erfordert mehr Disziplin bei Retries, Deduplizierung und Ownership.
Eine praktische Reihenfolge bei der Einführung hilft, den Überblick zu behalten:
Erstens: Features in SQL berechnen und persistieren.
Zweitens: Jedes Ereignis mit dem Daten-Asset und den Run-Metadaten taggen.
Drittens: Alarme in einem zentralen Incident-Stream zusammenführen.
Viertens: Anomalien mit Deployments, Feature Flags und vorgelagerten ETL-Jobs korrelieren.
Fünftens: Das Routing verfeinern, sodass nur noch die relevantesten Alarme an Menschen weitergeleitet werden.

Die interne Übersicht zu Data Observability ist hier relevant, da sie die Anomalieerkennung als Teil eines größeren Betriebssystems und nicht als isolierten Alarmgenerator begreift. Das ist das richtige mentale Modell für Produktions-Warehouses und verhindert, dass ein weiteres ungenutztes Dashboard entsteht, für das sich niemand verantwortlich fühlt.
Wenn Sie die Anomalieerkennung in Datenbanken in der Produktion etablieren, beginnen Sie mit den Prüfungen, die am dichtesten an den Daten liegen, und bauen Sie anschließend Kontext, Erklärbarkeit und Routing darauf auf. digna unterstützt die datenbankinterne Anomalieerkennung, die Aktualitätsüberwachung, das Schema-Tracking sowie Observability-Workflows direkt in der Umgebung des Kunden. Es eignet sich daher ideal für Teams, die die Erkennungslogik dort haben möchten, wo die Daten bereits liegen. Besuchen Sie digna, um zu sehen, wie sich dieser Ansatz auf Ihr Warehouse, Ihre Pipelines und Ihren Alarmierungs-Stack übertragen lässt.
Häufig gestellte Fragen
Was ist Database Anomaly Detection?
Das Warehouse selbst als überwachte Fläche zu behandeln, statt Dashboards drei Werkzeuge weiter unten zu prüfen. Wenn sich Daten so verändert haben, dass ein Dashboard es allein nicht erklären kann, sollte die Erkennungsschicht dort liegen, wo die Daten entstehen.
Welche SQL-Merkmale extrahiert man zuerst?
Rollierende Aggregate über 7- und 28-Tage-Fenster, berechnet je Tag und je Kennzahl, damit jedes Signal seine eigene Historie behält. Ergänzen Sie verzögerte Deltas für Tages- und Wochenvergleiche, nutzen Sie Perzentile für Verteilungsverschiebungen, die Mittelwerte verbergen, und speichern Sie das Ergebnis in einer Features-Tabelle.
Welche SQL-Funktion erfasst welchen Fehler?
Drei Paarungen decken das meiste ab. AVG, STDDEV und COUNT liefern eine rollierende Baseline für lokalen Trend, Volatilität und fehlendes Volumen. LAG mit Subtraktion liefert Periodendeltas für Sprünge. PERCENTILE_CONT liefert Median-Drift und erfasst damit Verteilungsverschiebungen, die Mittelwerte verstecken.
Wann weichen statistische Baselines gelernten Modellen?
Statistische Baselines bleiben für viele produktive Tabellen der richtige Einstieg, und ihre Schwäche zeigt sich, sobald die Reihe unruhig wird, mit Saisonalität, Release-Zyklen oder Segmenteffekten. Benchmarks bestätigen, dass die Erkennungsqualität stark datenabhängig ist, die Wahl gehört also zur Reihe.
Gibt es Belege dafür, dass die Algorithmuswahl zählt?
Ja, und sie zählt weniger als die Daten. Der ADBench-Benchmark testete 30 Algorithmen über 57 Benchmark-Datensätze in 98.436 Experimenten und untersuchte Überwachungsgrad, Anomalietyp und Rauschbedingungen. Er bestätigte, dass die Qualität stark datenabhängig ist, statt von einem Sieger entschieden zu werden.



