10 Beispiele für Data-Governance-Richtlinien
|
12
min. Lesezeit

Ein Richtliniendokument kann existieren, während seine Daten faktisch ungesteuert bleiben. Branchenumfragen berichten, dass nur 23 % der Organisationen formale Frameworks für Data Governance oder Datenqualität einsetzen, während 55 % kein laufend gepflegtes Inventar sensibler Daten führen, 70 % keine einheitliche Strategie haben, die Daten- und Identitätssichtbarkeit verbindet, und nur 39 % ihre gesamten Daten klassifizieren können. Diese Befunde zeigen, warum eine Liste von Richtlinientiteln nicht genügt. Eine brauchbare Richtlinie übersetzt ein Prinzip in eine beobachtbare Kontrolle, benennt eine Person für deren Betrieb, hält Nachweise fest und legt fest, was bei Versagen der Kontrolle geschieht. Umfrageergebnisse zur Verbreitung von Data Governance
Die zehn Beispiele für Data-Governance-Richtlinien unten sind als operative Vorlagen geschrieben, nicht als statische Definitionen. Jedes verbindet ein Kontrollziel mit Verantwortung, Auslöser, Nachweis, Eskalationspfad und messbarem Ergebnis. Die Beispiele gelten für Finanzdienstleistungen, Gesundheitswesen, Telekommunikation und öffentliche Verwaltung, doch dieselbe Logik funktioniert für kritische Datensätze, regulierte Berichterstattung, Analytics-Pipelines und KI-Systeme.
Eine Richtlinie sollte auch den rechtlichen Kontext der Organisation abbilden. Der EU Data Governance Act wurde am 6. April 2022 vom Europäischen Parlament angenommen, trat am 23. Juni 2022 in Kraft und gilt seit dem 24. September 2023 nach einer 15-monatigen Übergangsfrist. Er schafft einen Rechtsrahmen für Datennutzung, Intermediäre und Datenaltruismus in den EU-Märkten. Zeitplan und Auswirkungen des EU Data Governance Act Dieser Verlauf zeigt den praktischen Druck auf Unternehmen, vom Richtlinienentwurf zu durchsetzbaren Kontrollen zu kommen, besonders wenn Daten Jurisdiktionen überschreiten.
Inhaltsverzeichnis
4. Richtlinie zu Schemaänderungserkennung und struktureller Governance
5. Richtlinie zu Dateneigentum und Stewardship-Verantwortung
6. Richtlinie zu Geschäftskennzahlen-Monitoring und KPI-Verlässlichkeit
10. Richtlinie zu kontinuierlicher Verbesserung und Governance-Kennzahlen
1. Richtlinie zu Datenqualitätsstandards und Validierung
Eine Datenqualitätsrichtlinie definiert die Mindestbedingung, die ein Datensatz erfüllen muss, bevor nachgelagerte Systeme ihn als nutzbar behandeln. Ihr Kontrollziel ist die Zweckeignung, nicht abstrakte Perfektion. Ein Transaktionsdatensatz braucht vielleicht einen gültigen Betrag, eine identifizierbare Partei und erforderliche regulatorische Felder. Ein klinischer Datensatz verlangt womöglich in sich stimmige Messwerte und Identifikatoren. Ein Telekommunikationskonto braucht kohärente Abrechnungs- und Kundenattribute, bevor das Umsatzreporting läuft.
Der Data Owner genehmigt die fachliche Bedeutung jeder Regel. Ein Data Steward pflegt das Regelregister, während Data Engineers die Prüfungen in der jeweiligen Pipeline oder Datenbank umsetzen. Auslöser ist ein geplanter Ladevorgang, ein Ingestion-Ereignis oder eine Übergabe im Geschäftsprozess. Nachweise sollten Regeldefinition, fachliche Begründung, Ausführungszeitstempel, betroffene Datensätze, Pass- und Fail-Ergebnisse, Behebungsstand und Genehmigungshistorie umfassen.
Praxisregel: Eine Validierungsregel ist erst dann steuerbar, wenn jemand erklären kann, warum es sie gibt, was sie prüft und wer handelt, wenn sie fehlschlägt.
Deterministische Validierung unterscheidet sich von Verhaltensüberwachung. Eine Regel wie „Transaktionsbetrag muss vorhanden und numerisch sein“ liefert ein wiederholbares Ergebnis. Ein Anomaliemonitor bewertet dagegen, ob das Verhalten von einem erwarteten Muster abgewichen ist. Beides gehört in ein Qualitätsprogramm, doch sie beantworten verschiedene Fragen.
So setzen Sie sie um
Beginnen Sie mit den Datensätzen, die das größte geschäftliche, regulatorische oder operative Risiko tragen. Bitten Sie Data Engineers, Analysten und Fachverantwortliche, die Regeln gemeinsam zu definieren, und dokumentieren Sie die Begründung, damit spätere Verantwortliche die beabsichtigte Kontrolle verstehen.
Verantwortung: Ein fachlicher Data Owner genehmigt Schwellenwerte und Ausnahmen.
Auslöser: Jeder relevante Ladevorgang oder jedes Verarbeitungsereignis auf Datensatzebene.
Nachweis: Regelversionen, Ausführungsprotokolle, fehlgeschlagene Datensätze, Behebungsnotizen und Freigabe.
Eskalation: Der Steward untersucht zuerst und leitet ungelöste Fälle an den Owner und betroffene Konsumenten weiter.
Ergebnis: Kritische Datensätze haben sichtbare Validierungsabdeckung und eine dokumentierte Reaktion auf Fehler.
Teams können dignas Datenqualitätsstandards und das Validierungsmodul auf Datensatzebene nutzen, um deterministische fachliche Prüfungen ohne manuelle Durchsicht durchzusetzen. Regeln sollten vierteljährlich oder halbjährlich überprüft werden, besonders nach Änderungen an Produkten, Berichtspflichten oder Quellsystemen. Weiteren Kontext bietet der Leitfaden zu Datenqualitätsstandards von AutoProv.
2. Richtlinie zu Anomalieerkennung und Baseline-Lernen
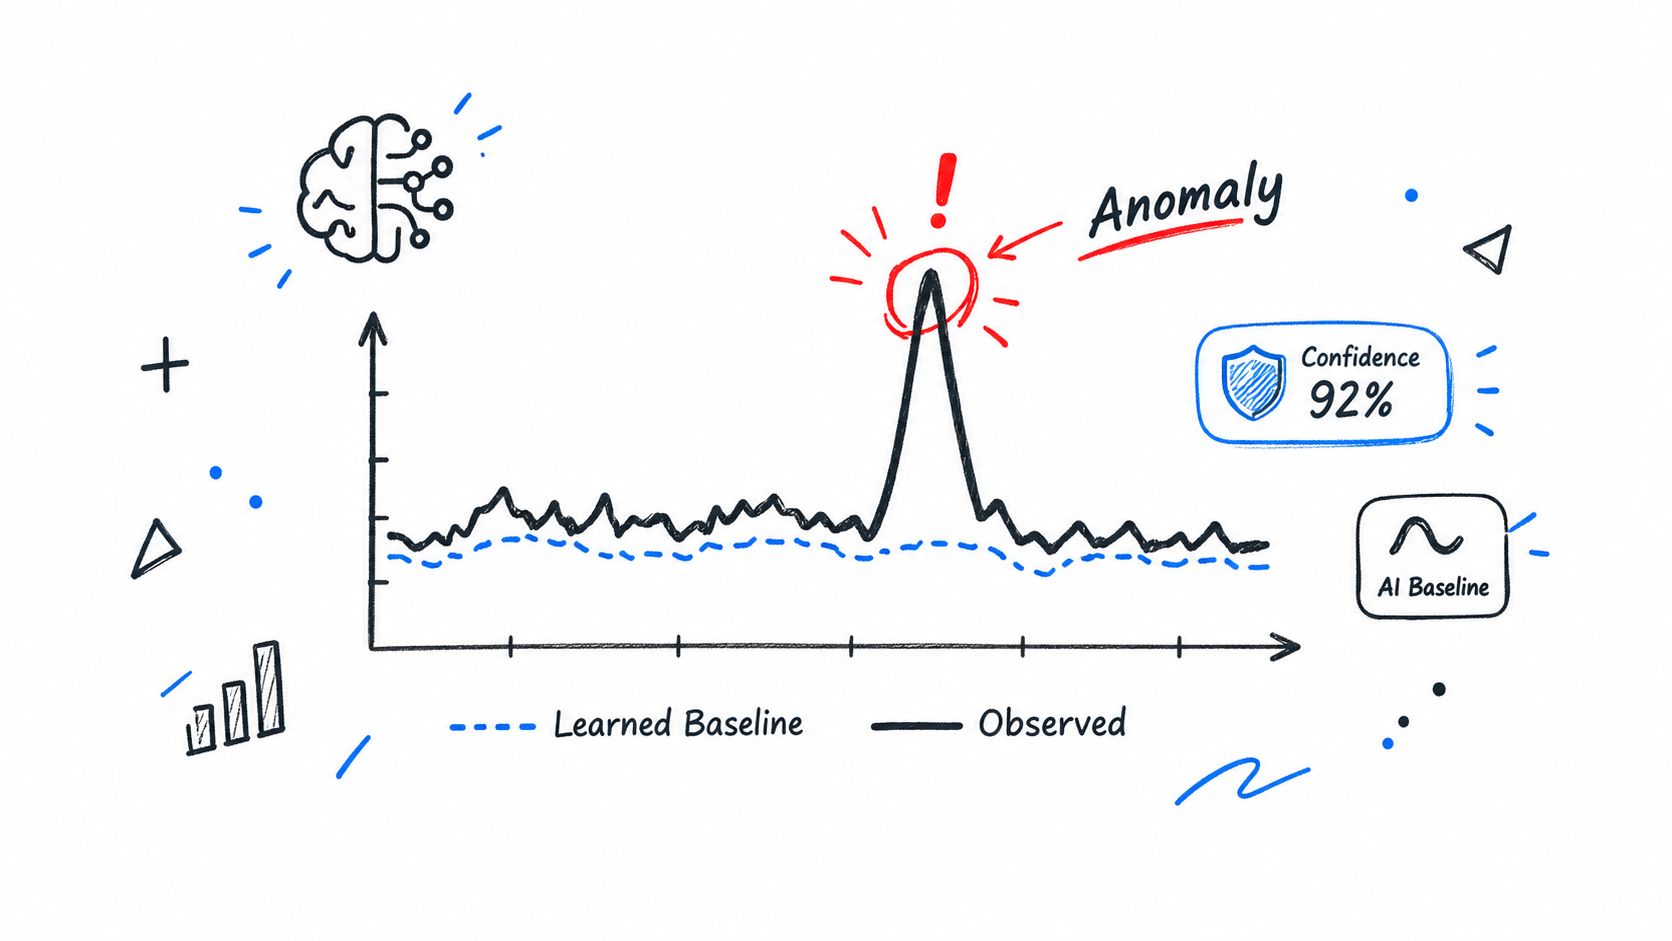
Ein Datensatz kann jede statische Validierungsregel erfüllen und dennoch unzuverlässig werden, wenn sich sein Verhalten verschiebt. Eine Richtlinie zur Anomalieerkennung schließt diese Lücke, indem sie festlegt, welche Muster überwacht werden, wie normales Verhalten gelernt wird, wer Abweichungen untersucht und welche Nachweise die Entscheidung tragen.
Der Monitoring-Verantwortliche wählt Datensatz, Geschäftskontext und überwachte Dimensionen. Ein Data Scientist oder Platform Engineer konfiguriert das Baseline-Lernen. Der Data Steward hält bestätigte Anomalien, Ursachen und Entscheidungen fest. Auslöser können Änderungen bei Volumen, Verteilung, Häufigkeit oder einem anderen definierten Verhalten sein.
Die Kontrolle muss ein statistisches Signal von einem bestätigten Vorfall trennen. Teams in Finanzdienstleistungen untersuchen womöglich ungewöhnliche Handelsvolumina oder betrugsnahe Muster. Teams im Gesundheitswesen prüfen vielleicht unerwartete Änderungen bei Aufnahmen oder Verteilungen klinischer Messwerte. Behörden sehen sich eventuell auffällige Leistungsverteilungen oder Antragsaktivitäten an. Diese Fälle brauchen Kontext, bevor ein Alert zum operativen Vorfall wird.
Verhaltensüberwachung erkennt Abweichung. Die menschliche Prüfung entscheidet, ob die Abweichung ein Defekt, ein legitimes Geschäftsereignis oder ein aufkommendes Risiko ist.
Kontrollen für Verhaltensüberwachung
Lassen Sie das Modell historisches Verhalten lernen, bevor Alerts operativ werden. Das Umsetzungsdesign sieht eine Lernphase von 2 bis 4 Wochen vor, damit gewöhnliche Zyklen und wiederkehrende Muster die Baseline prägen. Diese Dauer gehört zum Umsetzungsdesign dieser Richtlinie und ist kein allgemeiner Branchenbenchmark.
Verantwortung: Der Monitoring-Verantwortliche verteilt die Triage-Zuständigkeit und das Reaktions-SLA.
Auslöser: Eine definierte Abweichung bei Volumen, Verteilung, Häufigkeit oder einer anderen überwachten Dimension.
Nachweis: Baseline-Zeitraum, Vergleichsfenster, Alert-Details, Schweregrad, Untersuchungsnotizen, Ursache, Entscheidung und Behebung aufbewahren.
Lernschleife: Bestätigte Anomalien und Fehlalarme festhalten, damit Modell und Schwellenwerte justiert werden können.
Eskalation: Anomalien mit hoher Auswirkung oder ohne Lösung an den Data Owner und den Incident-Response-Prozess leiten.
Ergebnis: Analysten können erwartete Schwankung von Datendefekten unterscheiden, was das Vertrauen in Reporting und KI-Eingaben erhöht.
Teams können dignas Anomalieerkennung für Python-Workflows nutzen, um Baseline-Lernen und kontinuierliche Überwachung zu unterstützen. Die Analytics-Funktion hilft zudem, historische Anomaliemuster zu untersuchen, statt jeden Alert als isoliertes Ereignis zu behandeln.
Die Umsetzung sollte in dieser Reihenfolge erfolgen: Datensätze mit hohem Risiko auswählen, überwachtes Verhalten definieren, Lernphase festlegen, Alert-Schweregrade testen, Triage-Verantwortung zuweisen und dann bestätigte Fälle prüfen. Die Richtlinie sollte überarbeitet werden, wenn sich Geschäftsprozesse oder Datenverhalten ändern.
3. Richtlinie zu Timeliness und Lieferüberwachung
Ein rechtzeitiger Datensatz ist eine operative Abhängigkeit, nicht bloß ein Qualitätsattribut. Ein Feed kann korrekte Werte enthalten und dennoch das Entscheidungsfenster für Tagesendabwicklung, Rechnungsstellung, taggleiche klinische Abläufe oder regulatorisches Reporting verpassen. Die Richtlinie sollte „frisch genug“ in eine vereinbarte Liefererwartung, einen beobachtbaren Auslöser und eine definierte Reaktion überführen.
Beginnen Sie beim Bedarf des Konsumenten. Finanzen, Betrieb, Reporting und klinische Stakeholder nutzen dieselbe Tabelle womöglich zu unterschiedlichen Tageszeiten, deshalb verantwortet der Datenproduzent die Lieferausführung, während der Konsument das benötigte Fenster definiert. Das Plattformteam untersucht Fehler in Orchestrierung, Infrastruktur und Abhängigkeiten.
Halten Sie Konsument, Anwendungsfall, akzeptiertes Lieferfenster und Folge einer Verzögerung fest. Ein gültiger Auslöser kann eine verpasste Ankunft sein, ein früher Ladevorgang, der nachgelagerte Annahmen verletzt, oder eine Lieferung außerhalb des vereinbarten Servicefensters. Das Nachweispaket sollte erwartete und tatsächliche Ankunftszeiten, Lieferhistorie, Pipeline-Status, Abhängigkeitsinformationen, Vorfallsdaten und die Entscheidung über einen SLA-Verstoß bewahren.
Liefererwartungen beobachtbar machen
KI-gelernte Zeitpläne können normales Lieferverhalten erkennen, ohne dass Engineers spröde manuelle Zeitfenster pflegen müssen. dignas Leitfaden zu Timeliness-Definitionen und -Kennzahlen erklärt, wie fehlende, verspätete und frühe Ankünfte überwacht und die erwartete Lieferzeit berechnet werden.
Setzen Sie die Kontrolle in dieser Reihenfolge um:
Die Deadline des Konsumenten und die Folge einer Verzögerung definieren.
Erwartetes Lieferverhalten aus der beobachteten Historie ableiten.
Einen Alert setzen, wenn die vorhergesagte Ankunft ohne die erwarteten Daten verstreicht oder sich das Lieferverhalten ändert.
Den Produzenten als ersten Eskalationspunkt festlegen.
Gefährdete Deadlines an den Plattformverantwortlichen und den fachlichen Konsumenten leiten.
Erwartete Zeit, tatsächliche Zeit, Verzögerungsdauer, Abhängigkeitsstatus und Reaktion des Owners bewahren.
Das Ergebnis ist diagnostische Klarheit. Teams können eine späte Quelle von einer fehlgeschlagenen Pipeline oder einem nachgelagerten Infrastrukturproblem trennen, statt jede verpasste Lieferung als denselben Vorfall zu behandeln.
Prüfen Sie Timeliness-Trends monatlich. Eine wiederkehrende Verzögerung kann auf ein Prozessproblem hinweisen, während ein verlässlicher Feed den Anforderungen eines neu hinzugekommenen Konsumenten womöglich nicht mehr genügt. Diese Erkenntnisse sollten Lieferfenster, Verantwortung oder Eskalationsregel aktualisieren.
4. Richtlinie zu Schemaänderungserkennung und struktureller Governance
Eine Schemaänderung kann vertrauenswürdige Ergebnisse entwerten, bevor eine Prüfung auf Wertebene überhaupt etwas bemerkt. Das Entfernen einer Spalte, das Ändern eines Datentyps oder das Anpassen einer Einschränkung kann einen Bericht, ein Modell oder eine Transformation bereits bei der Ingestion brechen. Diese Richtlinie steuert daher Sichtbarkeit und Auswirkung struktureller Änderungen, mit deterministischem Vergleich gegen eine genehmigte Schema-Baseline.
Die Kontrolle beginnt mit einem registrierten Schema und einem benannten Schema Owner. Die automatische Erkennung vergleicht jede ausgelieferte Version mit dieser Baseline und hält Hinzufügungen, Entfernungen, Typänderungen und Änderungen an Einschränkungen fest. Auslöser ist jede nicht genehmigte strukturelle Abweichung. Ein Change Reviewer bewertet betroffene Konsumenten, während Platform Engineers Deployment, Benachrichtigung und Rollback steuern.
Nachweise müssen die Entscheidung prüfbar machen:
Schema vor und nach der Änderung sowie Erkennungszeitstempel.
Änderungsantrag, Begründung und Risikostufe.
Auswirkungsbewertung und betroffene Lineage.
Genehmigung, Deployment-Ergebnis und Rollback-Entscheidung.
Ein Finanzinstitut könnte ein entferntes Feld erkennen, das in regulatorischen Berechnungen verwendet wird. Eine Gesundheitsorganisation könnte eine Typänderung bei einem klinischen Messwert abfangen, bevor sie die Entscheidungsunterstützung erreicht. Eine Behörde muss womöglich Auditsysteme angleichen, wenn sich die Struktur eines staatlichen Datensatzes ändert. In jedem Fall ist das messbare Ergebnis eine frühere Erkennung und weniger stille Fehler in Reporting, Analytics oder KI-Pipelines.
Erkennung in eine verhältnismäßige Prüfung überführen
Bekannte nachgelagerte Konsumenten sollten vor der Produktionswirkung benachrichtigt werden. Diese Anforderung hängt von aktueller Lineage ab, deshalb sollte die Richtlinie vor der Genehmigung prüfen, ob die Impact-Karte vollständig ist. Ein Review Board kann eine Änderung genehmigen, ablehnen oder zurückstellen, während Risikostufen verhindern, dass Weiterentwicklung mit geringer Auswirkung zum manuellen Engpass wird.
Verantwortung: Datensatz- oder Domänenverantwortlicher.
Auslöser: Strukturelle Abweichung vom registrierten Schema.
Nachweis: Schema-Diff, Begründung, Genehmigungen, Impact-Karte und Deployment-Protokoll.
Eskalation: Nicht genehmigte oder stark wirksame Änderungen an das Review Board und den Incident-Prozess geben.
Ergebnis: Konsumenten erhalten handlungsfähige Vorwarnung, bevor struktureller Drift zum stillen Fehler wird.
dignas Erläuterung zu Schema Drift und struktureller Änderung beschreibt kontinuierliche strukturelle Überwachung für diese Kontrolle. Ihr Schema Tracker legt eine Baseline für Hinzufügungen, Entfernungen und Datentypänderungen fest und hilft Teams, Änderungen zu blockieren oder zu prüfen, bevor sie Konsumenten erreichen.

5. Richtlinie zu Dateneigentum und Stewardship-Verantwortung
Ownership ist eine Betriebskontrolle, kein Etikett im Katalog. Die Richtlinie weist Verantwortung für Datenqualität, Aktualität, Zugriffserwartungen, Definitionen und Problemlösung über kritische Datensätze hinweg zu. Sie muss außerdem zeigen, wer entscheiden darf, wer die Arbeit ausführt und welche Nachweise belegen, dass die Verantwortung aktiv ist.
Der Data Owner akzeptiert das Geschäftsrisiko und genehmigt Definitionen, Qualitätserwartungen und Ausnahmen. Der Data Steward überführt diese Entscheidungen in Metadaten, Regeln, Überwachung und Problembearbeitung. Produzenten bleiben für Erzeugung und Lieferung der Daten verantwortlich. Platform Engineers pflegen die technischen Kontrollen, während Konsumenten Defekte melden, die Analytics, Reporting oder KI-Nutzung betreffen.
Ein neuer kritischer Datensatz, ein wesentlicher Ownership-Wechsel oder ein ungelöstes Governance-Problem löst eine Prüfung aus. Der Owner bestätigt Umfang und Risiko, der Steward hält die Betriebsregeln fest, und betroffene Teams erhalten einen Eskalationsweg. Domänenübergreifende Konflikte gehen an den benannten Entscheider, statt in einer nicht zugewiesenen Warteschlange zu verbleiben.
Verantwortung prüfbar machen
Ein Ownership-Register sollte jeden kritischen Datensatz mit Owner, Steward, Produzent, Konsumenten, Sensibilität, Entscheidungsrechten und Eskalationspfad verbinden. Halten Sie es dort, wo Ermittelnde bei Vorfällen, Engineering, Analytics und Fachbereiche denselben Eintrag einsehen können.
Kontrollnachweis: Genehmigte Definitionen, Qualitätserwartungen, Zugriffsregeln, Ausnahmeentscheidungen und Ownership-Wechsel.
Betriebsnachweis: Steward-Aktionen, zugewiesene Probleme, Behebungsnotizen, Prüfprotokolle und aktuelle Registereinträge.
Eskalationsnachweis: Verfehlte Reaktionszusagen, ungelöste Konflikte, Risikoakzeptanz und Entscheidungen der Leitung.
Ergebnismaß: Jeder wichtige Datensatz hat eine verantwortliche Person, die seine Bedeutung, zulässige Nutzung und die Reaktion bei Kontrollversagen erklären kann.
Diese Definition des Data Steward unterscheidet fachliche Verantwortung von operativer Koordination. Stewardship-Treffen, wo sinnvoll wöchentlich oder zweiwöchentlich, können Vorfälle, überfällige Maßnahmen und wiederkehrende Qualitätsmuster durchgehen. Das Treffen nützt nur, wenn die Teilnehmenden von gemeinsamen Nachweisen ausgehen und Entscheidungen, Verantwortliche und Fälligkeiten festhalten. Dieses Protokoll verbindet Governance-Arbeit mit verlässlicherem Reporting, Analytics und KI-Ergebnissen.
6. Richtlinie zu Geschäftskennzahlen-Monitoring und KPI-Verlässlichkeit
KPI-Verlässlichkeit ist eine Betriebskontrolle, kein Dashboard-Feature. Sie schützt Planung, Reporting und Aktionärskommunikation, indem sie erkennt, wenn sich eine Geschäftskennzahl unerwartet bewegt, und prüft, ob die Ursache Geschäftstätigkeit oder ein Datenfehler ist.
Der Kennzahlenverantwortliche, meist eine Führungskraft aus dem Fachbereich, genehmigt Definition, Interpretation und zulässige Nutzung jedes KPI. Analytics Engineering pflegt Berechnung und Abhängigkeiten. Ein Data Steward koordiniert die Untersuchung, wenn sich Quelldaten oder Geschäftsregeln ändern. Auslöser kann eine ungewöhnliche Bewegung bei Umsatz, Kundenaktivität, Volumina, Portfoliorisiko, Abwanderung, Behandlungsergebnissen oder operativer Leistung sein.
Jeder KPI-Eintrag sollte genehmigte Definition, Quelldaten, Berechnungslogik, Verantwortung, Prüfkontext sowie bekannte saisonale oder operative Faktoren enthalten. Teams in Finanzdienstleistungen überwachen womöglich Nettoumsatz, Akquisitionskosten und Portfoliorisiko. Teams im Gesundheitswesen verfolgen vielleicht Aufnahmen, Ergebnisse und operative Effizienz. Telekommunikationsteams beobachten eventuell Abwanderung, durchschnittlichen Umsatz je Nutzer und Netzverfügbarkeit.
Ein KPI-Alert verlangt Nachweise vor der Eskalation. Eine große Veränderung kann von einem späten Ladevorgang, einer Schemaänderung, einem geänderten Filter, einer Definitionsanpassung oder einem echten Geschäftsereignis herrühren. Verbinden Sie das Monitoring mit den Kontrollen für Qualität, Timeliness, Anomalien und Schema, die an anderer Stelle des Governance-Programms beschrieben sind.
Beginnen Sie mit den 3 bis 5 wichtigsten Geschäftskennzahlen, wie im Umsetzungsansatz vorgesehen. Weiten Sie die Abdeckung erst aus, wenn Verantwortliche konsistent untersuchen und reagieren können. Die Betriebsreihenfolge lautet:
Definitionsprüfung: Bestätigen, dass genehmigte Definition und Berechnung unverändert sind.
Datenprüfung: Aktualität, Volumen, Vollständigkeit und strukturelle Nachweise durchsehen.
Geschäftsprüfung: Ein Ereignis oder eine Betriebsbedingung festhalten, die die Bewegung erklärt.
Eskalationsprüfung: Bestimmen, ob der KPI einen formalen Bericht, eine Geschäftsentscheidung oder eine externe Kommunikation betrifft.
Der Verantwortliche hält Alert, geprüfte Nachweise, Schlussfolgerung, Maßnahme und Fälligkeit fest. Ungelöste Fälle gehen je nach Auswirkung an den Steward, den fachlichen Entscheider oder die Berichtsinstanz. Das messbare Ergebnis ist ein KPI, der von Analysten, Führungskräften und KI-Systemen reproduziert, erklärt und vertraut werden kann.
dignas Business-Monitoring-Lösung kann ungewöhnliche Veränderungen bei Umsatz, Volumina, Kundenaktivität und operativen Kennzahlen untersuchen. Monatliche Reviews mit der Fachleitung prüfen, ob Alerts noch ein bedeutsames Geschäftsrisiko abbilden und ob Schwellenwerte angepasst werden müssen.
7. Richtlinie zu Data Lineage und Impact-Analyse
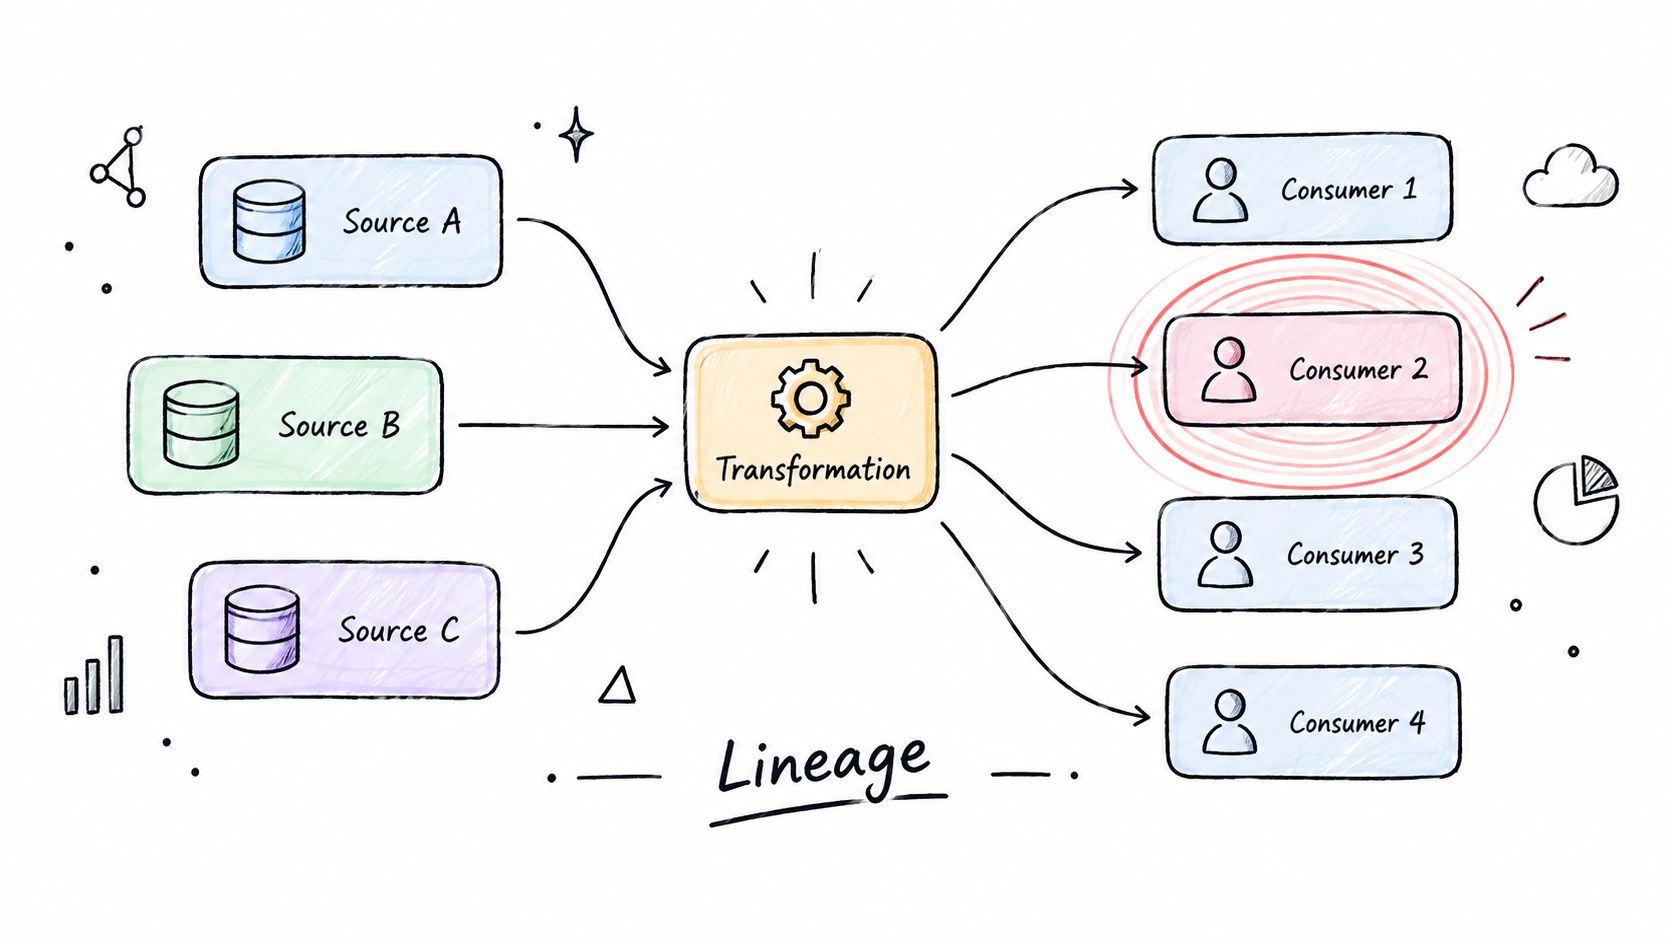
Lineage macht aus einer Datenabhängigkeit eine Betriebskontrolle. Sie verbindet eine berichtete Zahl oder eine Modelleingabe mit Quelle, Transformationen, Zielen und Konsumenten. Ziel der Richtlinie ist, den betroffenen Umfang zu bestimmen, bevor ein Defekt, eine strukturelle Änderung oder ein Auditbefund eine Behebung auslöst.
Der Data Owner klassifiziert kritische Assets und genehmigt deren fachliche Nutzung. Data Engineers erfassen Pipeline- und Transformationsabhängigkeiten, während Stewards prüfen, ob technische Beziehungen die fachliche Bedeutung abbilden. Ein neuer kritischer Fluss, eine wesentliche Pipeline-Änderung, ein Qualitätsvorfall, ein Modell-Deployment oder eine Auditanfrage startet die Kontrolle.
Nachweise sollten Quell- und Ziel-Assets, Transformationslogik, Abhängigkeitsbeziehungen, eine versionierte Lineage-Karte, das Prüfdatum und betroffene Konsumenten enthalten. Die Betriebsreihenfolge lautet:
Den Fluss und seinen Verantwortlichen registrieren.
Technische Abhängigkeiten und Transformationsversionen erfassen.
Fachliche Definitionen und kritische Konsumenten bestätigen.
Auswirkungen bewerten, wenn sich Quelle, Regel oder Ziel ändert.
Fehlende oder unklare Beziehungen an den Data Owner und den Plattformarchitekten eskalieren.
Eine Bank kann anhand dieses Protokolls Risikomodelle identifizieren, die von einem gestörten Feed betroffen sind. Eine Gesundheitsorganisation kann klinische Datenflüsse für Audit und Compliance abbilden, während eine Behörde zeigen kann, wie Quelldaten in Berichtssysteme gelangen. Für KI-Systeme liefert Lineage den Nachweis, welche Eingaben ein Modell verwendet hat und wie sich diese Eingaben verändert haben.
Lineage ist eine strukturelle Kontrolle, kein statisches Diagramm.
Manuelle Diagramme veralten mit der Systementwicklung. Automatische Erfassung aus Pipeline-Werkzeugen schafft eine stärkere Betriebsbasis, doch ein Steward muss weiterhin prüfen, ob Abhängigkeiten vollständig sind und ob Konsumenten mit hoher Auswirkung abgebildet werden. Das messbare Ergebnis ist eine schnellere, nachweisgestützte Impact-Analyse, bei der Behebung nach betroffenen Berichten, Modellen und Entscheidungen priorisiert wird statt nach manueller Suche.
digna enthält einen Datenkatalog, der Lineage-Dokumentation und gemeinsames Verständnis unterstützen kann. Ein visueller Audit-Trail kann außerdem zeigen, was wann geschah, eine Nachweisanforderung, die auch für Audit-Trail-Software für die britische Fuhrpark-Compliance relevant ist.
8. Richtlinie zu Datenzugriff und Sicherheits-Governance
Zugriffs-Governance ist eine Betriebskontrolle, keine Berechtigungsliste. Sie legt fest, wer jede Datendomäne einsehen oder ändern darf, welcher Geschäftszweck diesen Zugriff rechtfertigt, wie Berechtigungen erteilt oder entzogen werden und welche Nachweise die Entscheidung stützen. Kontrollziel ist die autorisierte Nutzung sensibler und kritischer Daten. Zu restriktive Regeln können legitime Analysen verzögern, während schwache Prüfung die Exposition erhöht und Verantwortung schwer feststellbar macht.
Der Data Owner definiert die Zugriffsregeln der Domäne und genehmigt Ausnahmen. Identity- und Access-Management-Teams vergeben Berechtigungen, Sicherheitsteams pflegen Authentifizierung und Protokollierung, und Stewards prüfen, ob der Zugriff noch den aktuellen Aufgaben entspricht. Ein Antrag, Rollenwechsel, Versetzung, Austritt, eine Rechteausweitung oder eine geplante Rezertifizierung löst den Workflow aus.
Ein belastbares Protokoll verbindet den Antrag mit Genehmigendem, Rollenzuordnung, Berechtigungsstand, Zeitstempeln von Erteilung und Entzug, Zugriffsereignissen, Ausnahmebegründung und Prüfergebnis. Ungelöste Konflikte gehen an Security und den verantwortlichen Owner, wobei der Zugriff ausgesetzt oder eingeschränkt wird, wo die Richtlinie es verlangt.
Auch die Zweckbindung prägt die Kontrolle. Die DSGVO-Leitlinien der EU besagen, dass personenbezogene Daten für festgelegte, eindeutige und legitime Zwecke erhoben und nicht in unvereinbarer Weise weiterverwendet werden dürfen. Leitlinien der Europäischen Kommission zu den DSGVO-Grundsätzen Ein Nutzer kann daher Zugriff für eine definierte operative Aufgabe erhalten, ohne dieselben Daten für unabhängige Analysen, Reporting oder KI-Entwicklung zweckentfremden zu dürfen.
Den Prüfpfad in die Umsetzung einbauen
Nutzen Sie rollenbasierten Zugriff, der an Arbeitsaufgaben geknüpft ist, statt an informelle Teamzugehörigkeit. Verbinden Sie die Richtlinie wo möglich mit Identitätssystemen und führen Sie dann vierteljährliche Zugriffsprüfungen durch, damit Owner Berechtigungen ohne dokumentierten Zweck entziehen können.
Verantwortung: Fachlicher Data Owner.
Auslöser: Antrag, Rollenwechsel, Austritt, Rechteänderung oder Quartalsprüfung.
Nachweis: Genehmigungs-Workflow, Berechtigungsstand, Zugriffsereignis, Entzug und Ausnahme.
Eskalation: Sicherheitsteam und verantwortlicher Owner bei ungelösten Konflikten.
Ergebnis: Zugriff bleibt autorisiert, erklärbar, prüfbar und rücknehmbar.
dignas Ausführung in der Datenbank und die Deployment-Optionen für Private Cloud oder On-Premises können Kontrollen unterstützen, während die Daten in der Umgebung des Kunden bleiben. Die Technologie hält Entscheidungen fest und setzt sie durch, doch die Organisation muss bestimmen, wer Zugriff braucht, warum er nötig ist und wann er enden soll.
9. Richtlinie zu Incident Response und Eskalation
Datenvorfälle brauchen eine Betriebskontrolle, nicht nur ein Ticket. Die Richtlinie sollte Qualitätsfehler, späte oder ausbleibende Lieferungen, Schemaänderungen, unzuverlässige KPIs und Zugriffsbedenken abdecken. Ihr Ziel ist, das Problem zu erkennen, seine Wirkung auf Analytics, Reporting oder KI-Workflows zu begrenzen, Entscheidungen zu dokumentieren und Wiederholung zu verhindern.
Der Incident Owner leitet die Reaktion. Der Datensatzverantwortliche bewertet die Geschäftsauswirkung und genehmigt eine akzeptable Behebung. Platform Engineers untersuchen technische Ursachen, Stewards führen das Protokoll, und betroffene Konsumenten erhalten Updates. Auslöser sind fehlgeschlagene Validierung, Anomalie-Alerts, verpasste Lieferung, nicht genehmigte strukturelle Änderung oder eine unerklärte Geschäftskennzahl.
Der Schweregrad bestimmt den Reaktionspfad. Ein Vorfall, der regulatorisches Reporting, Handelsabläufe oder Patientensicherheit betrifft, rechtfertigt schnellere Eskalation und klarere Stakeholder-Kommunikation als ein internes Datensatzproblem mit geringer Wirkung.
Die Lösung prüfbar machen
Das Protokoll sollte Alert, Benachrichtigung, Untersuchung, Ursache, Korrekturmaßnahme, Freigabe zur Wiederherstellung und Nachbetrachtung bewahren. Diese Nachweise unterscheiden einen behobenen Quellfehler von einem vorübergehenden Workaround.
Erkennung: Signal, Zeitstempel, betroffenen Datensatz und anfänglichen Umfang erfassen.
Benachrichtigung: Owner, Steward, Konsumenten und Bereitschaftsdienst kontaktieren.
Untersuchung: Auswirkung, Ursache, Abhängigkeiten und Eindämmung feststellen.
Lösung: Korrigieren, zurückrollen, in Quarantäne stellen oder die Datenbeschränkung kommunizieren.
Prävention: Folgearbeiten zuweisen und prüfen, ob sich die Kontrolle geändert hat.
Eskalation sollte durch Geschäftsauswirkung ausgelöst werden, nicht durch Alert-Volumen allein.
Der Owner schließt den Vorfall erst, wenn Nachweise die wiederhergestellte Nutzung oder eine ausdrückliche Einschränkung stützen. Eine durchsuchbare Wissensbasis sollte Ursachen, Entscheidungen und Ausnahmen bewahren. Monatliche Nachbetrachtungen können wiederkehrende Prozess- oder Plattformschwächen aufdecken, die einzelne Tickets verbergen.
dignas Alerting und nutzerzentriertes Dashboard können Engineers, Analysten und Stakeholdern einen gemeinsamen Blick auf Vorfälle und Trends geben. Die Umsetzungsreihenfolge ist: Schweregradkriterien definieren, Erkennungssignale anbinden, Reaktionsrollen zuweisen, Nachweise beim Abschluss verlangen und dann wiederkehrende Ursachen prüfen. Das messbare Ergebnis ist eine Reaktionshistorie, die verlässliches Reporting und sicherere nachgelagerte KI-Nutzung stützt.

10. Richtlinie zu kontinuierlicher Verbesserung und Governance-Kennzahlen
Governance braucht eigene Betriebskennzahlen. Eine Richtlinie zur kontinuierlichen Verbesserung legt fest, wie die Organisation Kontrollabdeckung misst, Leistung prüft, Lücken priorisiert und Richtlinien ändert, wenn sich geschäftliche oder regulatorische Bedingungen verschieben. Sie verhindert, dass Governance zu einer von den tatsächlichen Datenvorgängen losgelösten Dokumentenprüfung wird.
Der Governance Council legt das Messrahmenwerk fest. Domänenverantwortliche interpretieren Ergebnisse, Stewards koordinieren die Behebung, und Plattformteams liefern Ausführungsnachweise. Auslöser ist eine geplante Governance-Prüfung, ein wesentlicher Vorfall, ein neuer regulierter Workflow oder eine erhebliche Veränderung der Datenlandschaft.
Nützliche Messgrößen sind:
Klassifizierungsabdeckung: Der Anteil der Daten-Assets mit zugewiesener Klassifizierung.
Ownership-Abdeckung: Der Anteil kritischer Datensätze mit benannten Verantwortlichen.
Lineage-Abdeckung: Der Anteil kritischer Datenelemente mit dokumentierter Lineage.
Reaktionsfähigkeit bei Zugriffen: Der Anteil der Zugriffsanträge, die innerhalb des vereinbarten SLA genehmigt wurden.
Abschluss der Rezertifizierung: Der Anteil der fristgerecht abgeschlossenen vierteljährlichen Zugriffsprüfungen.
Diese Messgrößen stammen aus einem Umsetzungsleitfaden, der empfiehlt, operative Abdeckung zu verfolgen, statt sich allein auf Richtliniendokumente zu verlassen. Derselbe Leitfaden berichtet, dass die durchschnittliche Genehmigungszeit für Zugriffe auf 1,3 Tage von zuvor 5,2 Tagen gefallen ist, während geplante Qualitätsprüfungen 97 % Ausführung und die Aufbewahrungs-Compliance 88 % erreichten. Umsetzungskennzahlen für Kontrollen aus Data-Governance-Richtlinien
Benchmarks nutzen, ohne das Urteil auszulagern
Die Arbeit von UNSC und Global Data Governance Mapping schuf ein Rahmenwerk mit 26 Indikatoren über sechs Governance-Attribute, um die Governance-Umsetzung über Organisationen und Jurisdiktionen hinweg zu vergleichen. Rahmenwerk des Global Data Governance Mapping Ein Benchmark kann fehlende Kontrollen bei Ownership, Metadaten, Zugriff, Lineage oder Issue-Management aufdecken, aber er kann nicht entscheiden, welches Risiko für ein bestimmtes Unternehmen am wichtigsten ist.
Wählen Sie 5 bis 7 Schlüsselkennzahlen, die mit Geschäftsnutzen verbunden sind, prüfen Sie sie vierteljährlich und veröffentlichen Sie Verbesserungsarbeit transparent. dignas Data-Analytics-Modul kann die historische Analyse von Observability-Kennzahlen unterstützen, während Materialien zu Werkzeugen für sicheres, prüfbares KI-Deployment eine passende Perspektive auf Nachweisanforderungen in KI-lastigen Umgebungen bieten.
Vergleich von 10 Data-Governance-Richtlinien
Richtlinie | 🔄 Umsetzungskomplexität | ⚡ Ressourcenbedarf | 📊 Erwartete Ergebnisse | Ideale Anwendungsfälle | ⭐ Wesentliche Vorteile |
|---|---|---|---|---|---|
Richtlinie zu Datenqualitätsstandards und Validierung | Hoch, umfangreiche Regeldefinition und Governance | Mittel–Hoch, Data Engineers, Fachexperten, Validierungswerkzeuge | Konsistente Datentauglichkeit, Audit-Trails, weniger nachgelagerte Fehler | Regulierte Branchen, ML-Pipelines, Unternehmensreporting | Verhindert schlechte Daten, erzwingt Konsistenz, stützt Compliance |
Richtlinie zu Anomalieerkennung und Baseline-Lernen | Mittel, Modellaufbau und Monitoring-Pipelines | Mittel, historische Daten, ML- und Observability-Ressourcen | Frühe Erkennung von Datenverschiebungen, adaptive Alerts, skalierbares Monitoring | Betrugserkennung, Zeitreihen mit hohem Volumen, operative Kennzahlen | Erkennt neuartige Probleme automatisch, senkt manuelles Tuning, skaliert leicht |
Richtlinie zu Timeliness und Lieferüberwachung | Mittel, SLA-Definition und Zeitplanlernen | Mittel, Pipeline-Instrumentierung, Observability | Bessere Termintreue, SLA-Einhaltung, weniger nachgelagerte Verzögerungen | Abrechnung, regulatorische Stichtage, zeitkritische Pipelines | Proaktive Verzögerungsalerts, SLA-Nachweise, Einblicke in Pipeline-Zuverlässigkeit |
Richtlinie zu Schemaänderungserkennung und struktureller Governance | Mittel–Hoch, kontinuierliche Strukturverfolgung und Impact-Analyse | Mittel, Lineage-Mapping, Abbildung nachgelagerter Konsumenten | Schnelle Erkennung brechender Änderungen, weniger nachgelagerte Ausfälle | Sich entwickelnde Schemata, teamübergreifende Datenplattformen, Vertragsvalidierung | Verhindert stille Fehler, ermöglicht abgestimmte Rollbacks, Audit-Trails |
Richtlinie zu Dateneigentum und Stewardship-Verantwortung | Mittel, Rollendefinitionen und Organisationsprozesse | Mittel, benannte Stewards, Governance-Rhythmus, Dashboards | Klare Verantwortung, schnellere Untersuchungen, dauerhafte Ownership | Große Organisationen, regulierte Umgebungen, verteilte Datenteams | Erhöht Lösungsgeschwindigkeit, klärt Zuständigkeiten, bewahrt Wissen |
Richtlinie zu Geschäftskennzahlen-Monitoring und KPI-Verlässlichkeit | Mittel, Kennzahlendefinitionen und BI-Integration | Mittel, Fachverantwortliche, Analysten, BI-Werkzeuge | Verlässliche KPIs, frühe Alerts zu Geschäftsauswirkungen, Entscheidungssicherheit | Executive-Reporting, Produkt- und Finanzkennzahlen, investorenrelevante KPIs | Verhindert Fehlentscheidungen, verknüpft Kennzahlen mit Ursachen, stützt die Strategie |
Richtlinie zu Data Lineage und Impact-Analyse | Hoch, durchgängige Lineage-Erfassung und -Pflege | Hoch, Katalogwerkzeuge, Automatisierung, Integrationsaufwand | Schnelle Einschätzung des Wirkungsradius, kürzere Untersuchungen, Governance-Nachweise | Komplexe Pipelines, Audits, systemübergreifende Abhängigkeiten | Ermöglicht schnelle Impact-Analyse, senkt Triage-Zeit, stützt Compliance |
Richtlinie zu Datenzugriff und Sicherheits-Governance | Mittel, RBAC- und IAM-Integration | Mittel, IAM, Protokollierung, Zugriffsprüfprozesse | Kontrollierter Zugriff, auditfähige Protokolle, geringeres Insider-Risiko | Sensible/regulierte Daten (PII, PHI, Finanzdaten) | Schützt sensible Daten, sichert Prüfbarkeit, erzwingt minimale Rechte |
Richtlinie zu Incident Response und Eskalation | Mittel, Incident-Playbooks, SLAs und Bereitschaftsdienst | Mittel–Hoch, Bereitschaftsteams, Incident-Werkzeuge, Postmortem-Prozesse | Geringere MTTD/MTTR, dokumentierte Behebung, kontinuierliches Lernen | Geschäftskritische Datendienste, regulatorische Reporting-Pipelines | Strukturierte Reaktion, schnellere Lösung, organisationales Lernen |
Richtlinie zu kontinuierlicher Verbesserung und Governance-Kennzahlen | Mittel, Kennzahlenauswahl und Reifeprozesse | Mittel, Analytics, Stakeholder-Reviews, historische Kennzahlen | Gemessener Governance-Fortschritt, priorisierte Verbesserungs-Roadmap | Organisationen, die Governance reifen lassen, ROI-Begründungsbedarf | Liefert Wirkungsnachweise, treibt kontinuierliche Optimierung, richtet Stakeholder aus |
Richtlinientext in Betriebskontrollen überführen
Die stärksten Governance-Programme beginnen nicht damit, jede denkbare Richtlinie zu schreiben. Sie beginnen mit einer kleinen Auswahl risikoreicher Datensätze und machen Verantwortung sichtbar. Dieser Ansatz adressiert auch ein zentrales Umsetzungsproblem: Formale Governance bleibt in vielen Organisationen unvollständig, sodass breite Dokumentation den Anschein von Reife erzeugen kann, ohne Kontrollabdeckung zu liefern.
Wählen Sie zuerst Datensätze aus, die reguliertes Reporting, wesentliche Finanzentscheidungen, klinische Abläufe, Kundenabrechnung oder KI- und Analytics-Workflows tragen. Weisen Sie einen fachlichen Owner und einen operativen Steward zu, bevor Sie detaillierte Kontrollen definieren. Der Owner sollte entscheiden, was „zweckgeeignet“ bedeutet, welche Konsumenten zählen und welches Risikoniveau die Organisation akzeptiert. Der Steward sollte Regeln, Nachweise, Problemprotokolle und Eskalationsaktivität pflegen.
Definieren Sie dann Qualitäts- und Liefernachweise. Eine Qualitätsrichtlinie sollte Validierungsergebnisse, Details zu fehlgeschlagenen Datensätzen und Behebungshistorie erzeugen. Eine Timeliness-Richtlinie sollte erwartetes und tatsächliches Lieferverhalten zeigen, nicht nur, ob eine Pipeline durchgelaufen ist. Diese Kontrollen wirken zusammen, denn eine erfolgreiche Pipeline kann dennoch unvollständige oder späte Daten liefern, während ein pünktlicher Ladevorgang ungültige Datensätze enthalten kann.
Fügen Sie als Nächstes Zugriffs- und Strukturkontrollen hinzu. Zugriffs-Governance sollte Zweck, Rolle, Genehmigung, Bereitstellung, Entzug und Prüfnachweise verbinden. Der DSGVO-Grundsatz der Datenminimierung verlangt, dass personenbezogene Daten dem Zweck angemessen, erheblich und auf das Notwendige beschränkt sind. Leitlinien der UK ICO zur Datenminimierung Dieser Grundsatz gibt Zugriffs- und Erhebungsentscheidungen eine praktische Grenze. Auch Aufbewahrungsrichtlinien brauchen eine belastbare Grundlage. NIST SP 800-63B besagt, dass Cloud-Dienstleister geltende Aufbewahrungspflichten befolgen müssen und, wo keine Aufbewahrung vorgeschrieben ist, einen Risikomanagementprozess nutzen, der Datenschutz- und Sicherheitsrisiken berücksichtigt und den Teilnehmer über die Aufbewahrungsrichtlinie informiert. NIST SP 800-63B zu Aufbewahrungsfristen
Governance wird glaubwürdig, wenn jede wichtige Anforderung Nachweise erzeugt, die eine benannte Person interpretieren und auf die sie handeln kann.
Verbinden Sie Vorfälle mit Eskalationspfaden, statt Alerts in eine Warteschlange ohne Verantwortung zu schicken. Definieren Sie Schweregrad, Bereitschaftszuständigkeiten, Kommunikationsempfänger, Eindämmungsoptionen, Erwartungen an die Ursachenanalyse und die Nachbetrachtung. Der Owner sollte eine fachliche Reaktion genehmigen können, während Engineers und Stewards die dafür nötigen technischen und operativen Nachweise liefern.
Prüfen Sie schließlich regelmäßig Trends. Messen Sie Klassifizierungs- und Ownership-Abdeckung, Lineage für kritische Elemente, SLA-Leistung bei Zugriffen, Abschluss der Rezertifizierung, Qualitätsausführung, Timeliness, Anomaliemuster und Wiederholung von Vorfällen. Der über das Global Data Governance Mapping entwickelte Benchmark-Ansatz zeigt, warum strukturierte Indikatoren für Vergleiche nützlicher sind als erzählerische Reifeaussagen. Governance-Teams können diese Logik übernehmen, ohne ein externes Rahmenwerk als Ersatz für eigene Risikoentscheidungen zu behandeln.
ISO/IEC 38505-1 fasst Data Governance als Aufgabe des Leitungsorgans, den Umgang mit Daten und deren Nutzung zu bewerten, zu lenken und zu überwachen. Sie erkennt zudem die Verantwortlichkeit für Datenschutzverletzungen, Aufbewahrungsgesetzgebung und Verstöße gegen verbindliche Standards an. ISO/IEC 38505-1 zu Verantwortlichkeiten in der Data Governance Diese Sicht verändert die Rolle der Governance-Technologie. Werkzeuge können Prüfungen ausführen, Nachweise bewahren und Vorfälle sichtbar machen, doch die Leitung bleibt für Entscheidungen, Interpretation, Ausnahmen und Verantwortung zuständig.
digna kann dieses Betriebsmodell durch Validierung in der Datenbank, KI-gestützte Anomalieerkennung, Timeliness-Monitoring, Schema-Tracking, gemeinsame Vorfallssicht, einen Datenkatalog und historische Analysen unterstützen. Die Deployment-Optionen für Private Cloud und On-Premises erlauben den Betrieb der Plattform in der Umgebung des Kunden, während die Organisation für Richtliniendesign und Kontrollverantwortung zuständig bleibt.
Führen Sie die Richtlinien der Reihe nach ein, messen Sie, ob sie wirken, und überarbeiten Sie sie, wenn sich das Geschäft ändert. Eine Vorlage ist ein Ausgangspunkt. Ein funktionierendes Governance-Programm ist die Kombination aus Entscheidungsrechten, ausführbaren Kontrollen, Nachweisen, menschlicher Reaktion und wiederkehrender Prüfung.
digna vereint Validierung auf Datensatzebene, Anomalieerkennung, Timeliness-Monitoring, Schema-Tracking, Business Monitoring und historische Analytics in einer Plattform, die in der Umgebung des Kunden läuft. Besuchen Sie digna, um zu sehen, wie die Module helfen, Data-Governance-Richtlinien in beobachtbare Kontrollen für Analytics und KI zu überführen.
Richtlinie 4 beschreibt die Kontrolle; die Erkennung dahinter ist eine Produktfunktion. Schema Tracker vergleicht jedes ausgelieferte Schema mit einer genehmigten Baseline und hält Hinzufügungen, Entfernungen, Umbenennungen und Typänderungen fest, sobald sie auftreten.
Häufig gestellte Fragen
Was macht eine Data-Governance-Richtlinie operativ statt dekorativ?
Jede Richtlinie benennt ein Kontrollziel, eine Verantwortung, einen Auslöser, ein Nachweispaket, einen Eskalationspfad und ein messbares Ergebnis. Die im Artikel zitierten Umfragedaten zeigen, dass nur 23 % der Organisationen formale Governance-Frameworks nutzen, weshalb Dokumentation allein regelmäßig den Anschein von Reife erzeugt, ohne Kontrollabdeckung zu liefern.
Welche Richtlinien sollte ein Team zuerst schreiben?
Beginnen Sie mit einer kleinen Auswahl risikoreicher Datensätze: reguliertes Reporting, wesentliche Finanzentscheidungen, klinische Abläufe, Kundenabrechnung sowie KI- oder Analytics-Workflows. Weisen Sie einen fachlichen Owner und einen operativen Steward zu, bevor Sie detaillierte Kontrollen definieren, denn zuerst geschriebene breite Dokumentation überholt die Kontrollen, die sie durchsetzen soll.
Wie unterscheidet sich eine Timeliness-Richtlinie von einer Qualitätsrichtlinie?
Eine Qualitätsrichtlinie entscheidet, ob ein Datensatz zweckgeeignet ist. Eine Lieferrichtlinie überführt „frisch genug“ in ein vereinbartes Fenster, einen beobachtbaren Auslöser und eine definierte Reaktion, wobei der Produzent die Ausführung verantwortet und der Konsument das Fenster definiert. Eine Pipeline kann erfolgreich laufen und dennoch die Tagesendabwicklung verpassen.
Welche Nachweise sollte eine Schemaänderungsrichtlinie bewahren?
Das Schema vor und nach der Änderung mit Erkennungszeitstempel, den Änderungsantrag samt Begründung, eine Risikostufe, eine Auswirkungsbewertung mit betroffener Lineage sowie Genehmigung, Deployment-Ergebnis und Rollback-Entscheidung. Die Erkennung vergleicht jede ausgelieferte Version mit einer registrierten Baseline, die ein benannter Schema Owner hält.
Wer verantwortet eine Governance-Richtlinie im Alltag?
Drei Rollen teilen sich das. Der Data Owner genehmigt die fachliche Bedeutung jeder Regel und akzeptiert das Restrisiko, der Steward pflegt Regelregister, Nachweise und Eskalationsaktivität, und Engineers setzen die Prüfungen in Pipeline oder Datenbank um. Diese Aufteilung zuerst festzuhalten, ist das, was die Richtlinie prüfbar hält.



