Automatische Qualitätskontrolle für verlässliche Daten
|
7
min. Lesezeit

Ihr Morgendashboard ist grün, doch der Umsatztrend sieht falsch aus. Ein geplanter Feed kam zu spät, eine Spalte änderte ihren Typ, oder ein Quellsystem veränderte die Verteilung eines Feldes. Die Pipeline lief erfolgreich durch, also bestand die übliche Statusprüfung. Bis jemand die geschäftliche Auswirkung bemerkt, haben Analysten bereits unzuverlässige Zahlen geteilt und Engineers verfolgen das Problem rückwärts.
Manuelle Prüfung kann mit Volumen und Vielfalt moderner Datenpipelines nicht Schritt halten. Automatische Qualitätskontrolle ändert das Betriebsmodell: Sie beobachtet Daten kontinuierlich, erkennt relevante Abweichungen, setzt wesentliche Regeln durch und liefert den richtigen Personen belastbare Hinweise. Welche Folgen unentdeckte Fehler haben, beschreibt dieser Überblick zu den Folgen schlechter Datenqualität.
Inhaltsverzeichnis
Einleitung: Warum Datenqualität ohne Automatisierung bricht
Von der Inspektion zum kontinuierlichen Betrieb
Die zentrale Designentscheidung
Was automatische Qualitätskontrolle wirklich bedeutet
Die statistische Grundlage
Was das System beobachtet
Wie automatisierte Prüfungen funktionieren — von Regeln bis KI-Erkennung
Regelbasierte Validierung
Statistische Schwellenwerte
KI- und Machine-Learning-Erkennung
Die passende Prüfungsart für jedes Signal wählen
Automatisierung in den laufenden Betrieb bringen
Die Berechnung nah an den Daten halten
Zeit, Struktur und Bedeutung verbinden
Nutzen, den Sie messen und im Alltag spüren
Was sich für das Team ändert
Wo automatische Qualitätskontrolle in der Praxis Wirkung zeigt
Finanzwesen
Gesundheitswesen
Telekommunikation
Öffentlicher Sektor
Wann automatisiert werden sollte und wie Sie mit digna starten
Checkliste für die Einführung
Einleitung: Warum Datenqualität ohne Automatisierung bricht
Ein Datenteam prüft nach einem Release vielleicht ein paar kritische Tabellen, bestätigt, dass eine Transformation gelaufen ist, und geht zur nächsten Aufgabe über. Dieses Vorgehen erkennt offensichtliche Fehler wie eine leere Tabelle oder einen abgebrochenen Job. Eine allmähliche Verschiebung im Kundenverhalten, eine verspätete Quelle oder einen plausibel aussehenden Wert, der fachlich keinen Sinn mehr ergibt, erkennt es nicht zuverlässig.
Das Problem ist nicht fehlende Tests. Moderne Umgebungen kombinieren Warehouses, Lakes, Streaming-Systeme, Lieferanten-Feeds, Transformationswerkzeuge und Dashboards. Jede Schicht kann gesund wirken, während das Ergebnis weniger vertrauenswürdig wird. Ein erfolgreicher Pipeline-Lauf beweist, dass Code ausgeführt wurde. Er beweist nicht, dass die Daten das Geschäft noch abbilden.
Von der Inspektion zum kontinuierlichen Betrieb
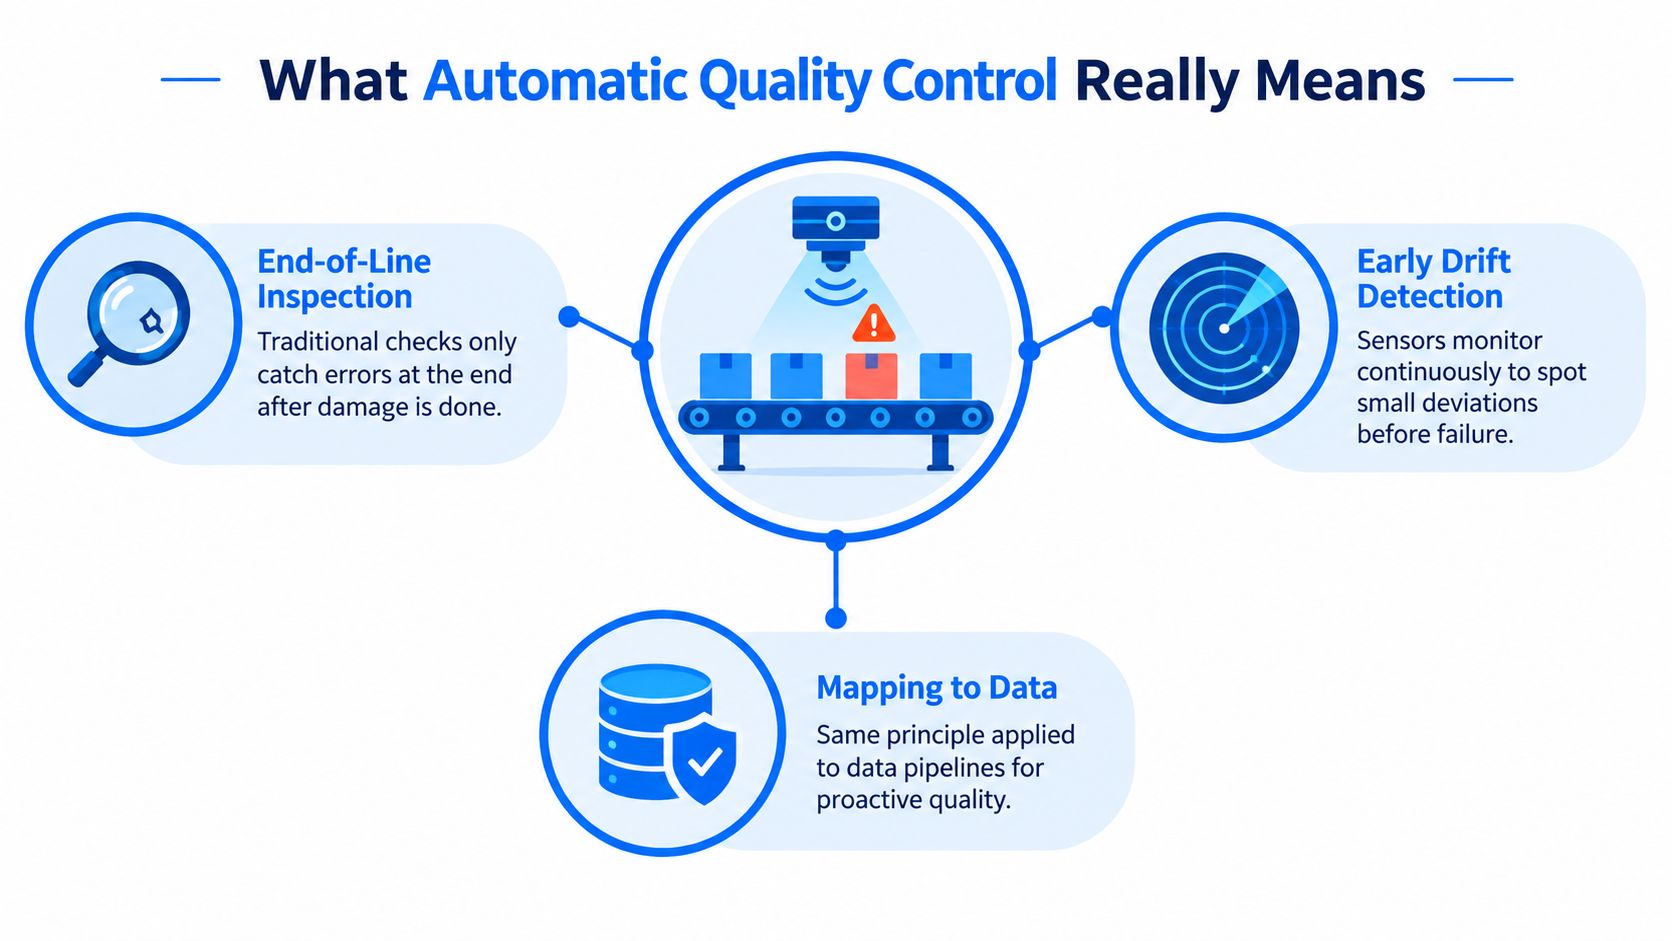
Die Fertigung liefert eine passende Analogie. Eine Endkontrolle kann defekte Produkte aussortieren, aber Sensoren entlang der Produktionslinie erkennen Prozessdrift, bevor sich Fehler häufen. Datenteams brauchen denselben Regelkreis. Statt Qualität als Tor am Ende einer Pipeline zu behandeln, können sie Datensätze, Lieferverhalten, Struktur, Geschäftskennzahlen und Plattformaktivität als Teil des Tagesbetriebs überwachen.
Diese Verschiebung klärt auch die Verantwortung. Ein Data Engineer muss womöglich eine Schemaänderung untersuchen, ein Analyst eine ungewöhnliche KPI-Bewegung erklären und eine Governance-Verantwortliche belegen, dass eine Kontrolle gelaufen ist. Automatische Qualitätskontrolle sollte diese Aufgaben verbinden, statt einen weiteren isolierten Report zu erzeugen.
Die zentrale Designentscheidung
Automatisierung heißt nicht, jede Regel durch ein Modell zu ersetzen. Manche Signale sollten aus historischem Verhalten gelernt werden, etwa normales Volumen oder erwartete Lieferzeit. Andere Signale müssen deterministisch bleiben, etwa ein Pflichtfeld, ein zulässiger Status oder eine regulatorische Vorgabe.
Die praktische Frage ist deshalb präzise: Welche Bedingungen soll das System statistisch lernen, und welche muss es exakt durchsetzen? Die Antwort entscheidet, ob Automatisierung Rauschen reduziert oder mehr Alarme erzeugt.
Was automatische Qualitätskontrolle wirklich bedeutet
Stellen Sie sich ein Förderband mit identischen Teilen vor. Ein Sensor verfolgt Temperatur, Gewicht und Position, während eine Kamera die Oberfläche prüft. Das System wartet nicht bis zur letzten verpackten Kiste, um ein Problem zu entdecken. Es vergleicht aktuelle Messwerte mit dem erwarteten Verhalten, meldet Auffälligkeiten und kann den Prozess stoppen oder umleiten, bevor weitere fehlerhafte Teile durchlaufen.
Datenqualität funktioniert genauso. Ein Monitoring-System beobachtet Tabellen und Pipelines, ermittelt, wie normales Verhalten aussieht, und prüft eingehende Daten gegen diese Baseline. Zusätzlich kann es explizite Validierungen anwenden, wenn im Unternehmen eine Regel immer gelten muss.
Automatische Qualitätskontrolle ist der kontinuierliche Einsatz von Software, um Datenverhalten zu beobachten, definierte Qualitätsanforderungen durchzusetzen, relevante Abweichungen zu erkennen und Belege an die Personen oder Systeme weiterzuleiten, die handeln müssen.
Die statistische Grundlage
Statistische Prozesslenkung (SPC) bietet eine nützliche Grundlage. Sie unterscheidet mithilfe von Regelkarten und Messdaten normale Variation von besonderer Variation — also einer Veränderung, die nahelegt, dass etwas Ungewöhnliches in den Prozess gelangt ist. In einem normalverteilten Prozess liegt die Wahrscheinlichkeit, dass ein gutes Teil außerhalb einer häufig genannten 3-Sigma-Grenze fällt, bei etwa 1 zu 1.000, während eine 6-Sigma-Grenze diese Wahrscheinlichkeit auf etwa 1 zu 1.000.000 senkt (SPC-Forschung zur automatisierten Erkennung).
Die Lehre ist nicht, dass jede Datentabelle eine Six-Sigma-Regel braucht. Die Lehre ist, dass Qualitätssysteme Drift früh erkennen sollten, statt sich allein auf die Endkontrolle zu verlassen. Eine Baseline gibt dem System Kontext. Ohne Kontext meldet ein Schwellenwert womöglich gewöhnliche Saisonalität oder übersieht eine relevante Veränderung.
Was das System beobachtet
Automatische Qualitätskontrolle deckt mehrere Verhaltensebenen ab:
Datensatzqualität: Pflichtwerte, gültige Formate, Wertebereiche, Referenzwerte, Duplikate und fachliche Beziehungen.
Pünktlichkeit der Pipeline: Ob Daten dann eintreffen, wenn Nutzer und nachgelagerte Jobs es erwarten.
Schemastabilität: Ob Spalten hinzugefügt, entfernt, umbenannt oder im Typ geändert werden.
Geschäftsverhalten: Ob Umsatz, Transaktionen, Kundenaktivität oder eine andere KPI außerhalb der erwarteten Muster verläuft.
Plattformverhalten: Ob Workloads, Verfügbarkeit, Verbrauch oder performancebezogene Metriken sich unerwartet verändern.
Ein einzelner Test kann all das nicht abdecken. Das operative System kombiniert Messungen, Regeln, Historie, Verantwortlichkeiten, Alerts und Kontext zur Behebung. Diese Kombination macht aus Testen eine kontinuierliche Kontrolle.
Wie automatisierte Prüfungen funktionieren — von Regeln bis KI-Erkennung
Drei Familien von Prüfungen decken die meisten Designs automatischer Qualitätskontrolle ab. Sie stehen nicht in jeder Situation in Konkurrenz. Jede beantwortet eine andere Frage, und die stärksten Implementierungen ordnen jedes Signal der Methode zu, die zu seinem Risiko passt.
Regelbasierte Validierung
Deterministische Prüfungen sind explizit und wiederholbar. Eine Regel kann einen Kundenidentifikator verlangen, eine negative Menge ablehnen, einen Status auf eine genehmigte Referenzliste beschränken oder prüfen, ob ein Timestamp einem geforderten Format folgt. Schlägt die Bedingung fehl, ist das Ergebnis eindeutig: Der Datensatz oder Datenbestand verletzt eine festgelegte Anforderung.
Regeln sind besonders wertvoll für Geschäftslogik, Audit-Kontrollen und vertragliche Zusagen. Sie liefern außerdem gute Nachweise, weil eine verantwortliche Person genau erklären kann, was bestanden wurde, was fehlschlug und warum. Ihre Grenze ist die Pflege. Eine Regel kann eine sich verändernde Baseline nicht ableiten, solange niemand sie aktualisiert, und eine zu weit gefasste Regel erzeugt unnötige operative Arbeit.
Statistische Schwellenwerte
Statistische Prüfungen fragen, ob sich eine Messgröße ungewöhnlich weit von ihrem etablierten Verhalten entfernt hat. Die Messgröße kann Zeilenvolumen, Null-Dichte, Wertverteilung oder Lieferzeit sein. Kontrollbänder passen sich Mustern an, die ein fixer Schwellenwert falsch behandeln würde.
Das System braucht trotzdem eine durchdachte Konfiguration. Eine Geschäftskennzahl kann nach Wochentag, Release-Zyklus oder Berichtsperiode schwanken. Eine Baseline, die diese Muster ignoriert, alarmiert zu oft. Eine zu großzügige Baseline übersieht ein echtes Problem.
KI- und Machine-Learning-Erkennung
KI-gestützte Erkennung hilft, wenn Daten komplexe Zusammenhänge aufweisen oder das manuelle Schreiben von Regeln unpraktikabel wäre. Ein Modell kann Muster eines Datensatzes lernen und Abweichungen in Volumen, Verteilung oder Werten melden. Das macht das Ergebnis nicht automatisch richtig. Das Modell braucht ausreichende Historie, geeignetes Monitoring und einen Prüfprozess für Fehlalarme.
Eine Benchmark-Studie zu Ozeanprofilen zeigt, warum die Auswahl der Tests zählt. Forschende bewerteten 60 verschiedene automatisierte Prüfungen und stellten fest, dass die Auswahl einer optimalen Teilmenge nötig war, weil unterschiedliche Qualitätsregeln Sensitivität gegen Überalarmierung abwägen (Benchmarking automatisierter Qualitätsprüfungen). Mehr Tests erzeugen nicht automatisch bessere Qualität. Sie können Alarmmüdigkeit erzeugen, wenn das Team ein relevantes Signal nicht von gewöhnlicher Variation unterscheiden kann.
Die passende Prüfungsart für jedes Signal wählen
Prüfungsfamilie | Am besten geeignet für | Stärken | Worauf zu achten ist |
|---|---|---|---|
Regelbasierte Validierung | Pflichtfelder, Formate, Wertebereiche, Referenzlisten und fachliche Vorgaben | Eindeutiges Bestanden/Nicht bestanden, nachvollziehbare Logik, starke Audit-Nachweise | Erfordert Pflege, wenn sich fachliche Anforderungen ändern |
Statistische Schwellenwerte | Volumen, Verteilungen, Null-Verhalten und Liefermuster | Passt sich beobachtetem Verhalten an und macht Drift sichtbar | Kann überalarmieren, wenn Saisonalität oder Baseline-Qualität schlecht verstanden sind |
KI-Erkennung | Subtile, multivariate oder sich verändernde Muster über Datensätze hinweg | Findet Verhalten, das sich schwer als einzelne Regeln formulieren lässt | Braucht Governance, Review und Kontrollen gegen intransparente Entscheidungen |
Die richtige Strategie besteht nicht darin, weniger Regeln zu schreiben. Sie besteht darin zu entscheiden, welche Signale exakte Durchsetzung verdienen, welche adaptive Schwellenwerte brauchen und welche von gelernter Erkennung profitieren. Eine praxisnahe Erklärung der Anomalieerkennung in Pipelines finden Sie unter wie KI Datenanomalien erkennt.
Automatisierung in den laufenden Betrieb bringen
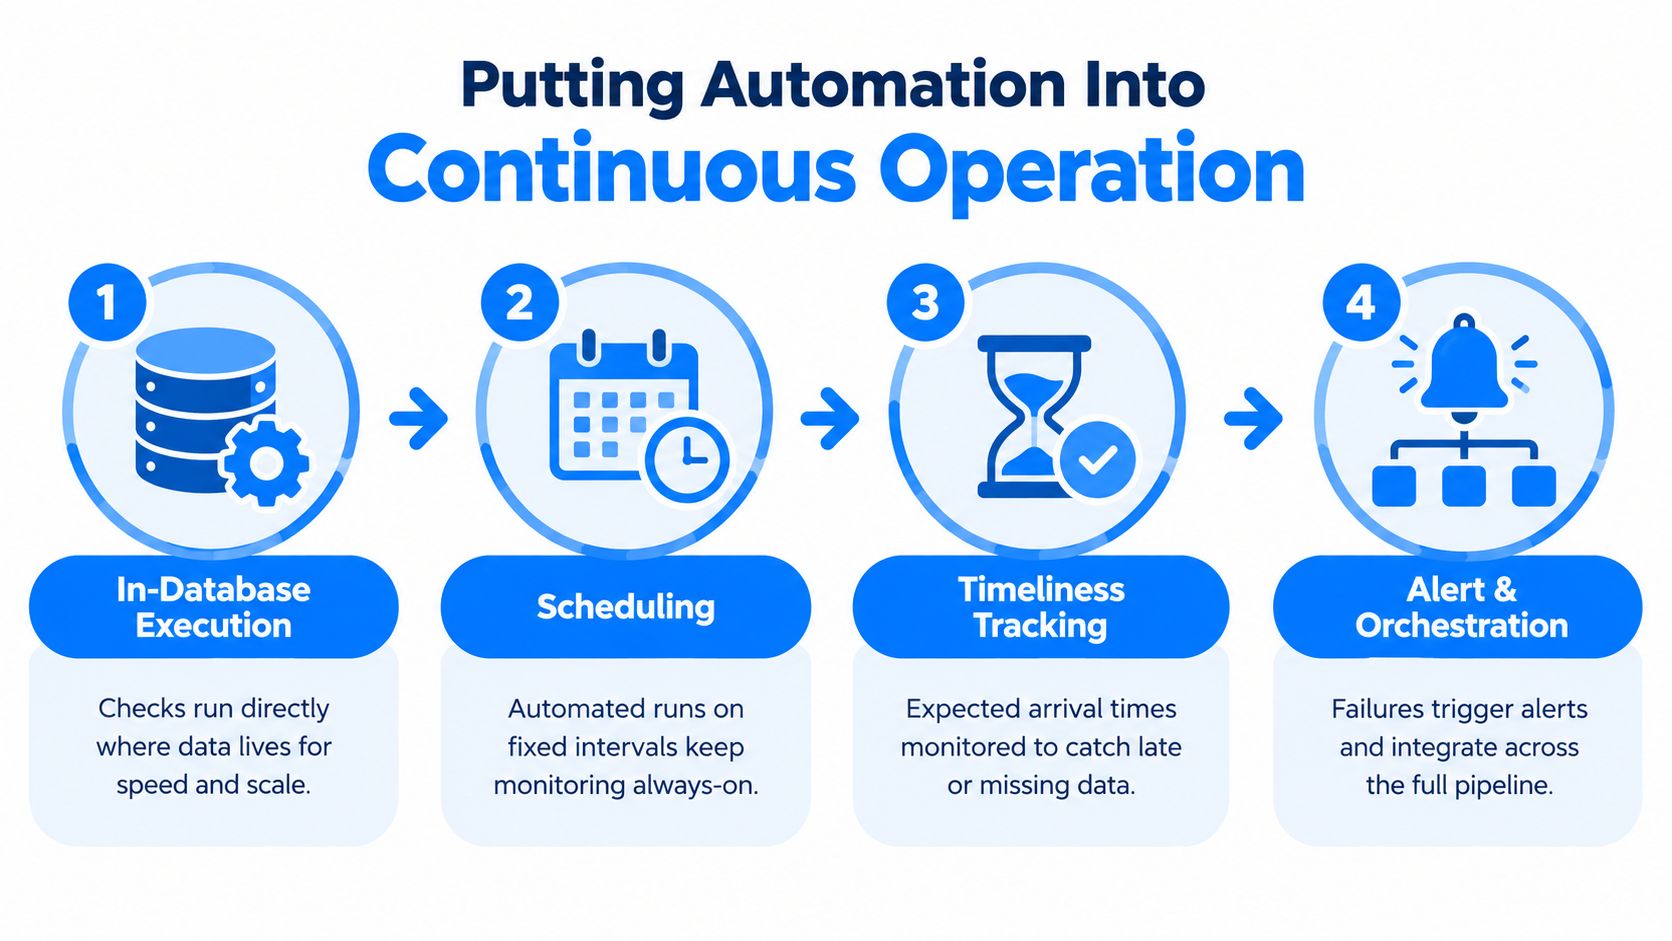
Eine Sammlung von Prüfungen wird erst nützlich, wenn sie als operativer Regelkreis läuft. Der Kreis sollte die Daten dort beobachten, wo sie ohnehin liegen, verlässlich nach Zeitplan laufen, tatsächliches mit erwartetem Verhalten vergleichen und Fehler mit genug Kontext an eine verantwortliche Person weiterleiten.
Die Berechnung nah an den Daten halten
In-Database-Ausführung erlaubt Teams, Metriken zu berechnen und Analysen innerhalb der Datenbank des Kunden durchzuführen. Die Daten bleiben an Ort und Stelle, was unnötige Bewegung reduziert und Datenschutz- sowie Governance-Anforderungen unterstützt. Besonders relevant ist das, wenn Produktionsdaten nicht in einen externen Monitoring-Dienst kopiert werden dürfen.
Das Design braucht weiterhin Zugriffskontrollen, Protokollierung und eine klare Trennung zwischen Monitoring-Metadaten und sensiblen Datensätzen. Lokale Ausführung ersetzt keine Governance. Sie gibt ihr ein stärkeres Fundament, weil das Unternehmen festlegen kann, wo gerechnet wird und welche Nachweise die Umgebung verlassen.
Zeit, Struktur und Bedeutung verbinden
Ein verlässlicher Monitoring-Kreis kombiniert verschiedene Formen von Nachweisen:
Beobachtung planen. Feste Intervalle oder Pipeline-Ereignisse stellen sicher, dass Prüfungen laufen, ohne dass jemand daran denken muss.
Erwartete Lieferung verfolgen. Timeliness-Monitoring kann erwartetes Ankunftsverhalten lernen und späte, fehlende oder zu frühe Daten melden.
Strukturelle Änderungen erkennen. Schema-Tracking identifiziert hinzugefügte oder entfernte Spalten und Typänderungen, bevor nachgelagerte Konsumenten scheitern.
Geschäftskennzahlen beobachten. KPI-Monitoring verknüpft technisches Datenverhalten mit Ergebnissen, die Fachverantwortliche wiedererkennen.
Vorfall weiterleiten. Alerts sollten das betroffene Asset, die fehlgeschlagene Bedingung, die beobachtete Änderung sowie die verantwortliche Person oder das Team enthalten.
Umfragedaten zeigen eine Strategielücke. SYNQ fand „unzureichendes Wissen darüber, wie man gut testet“ als größte Herausforderung der Datenqualität, während die große Mehrheit der Teams vor allem auf eingebaute Tests ihres Transformationswerkzeugs setzte und nur rund 10 % KI häufig in Datenqualitäts-Workflows nutzten (SYNQ Data Quality Benchmark Survey). Das deutet darauf hin, dass Teams operative Anleitung brauchen, nicht noch eine Testbibliothek.
Ein gemeinsames Dashboard, ein Datenkatalog, ein Scheduler und ein Kollaborationsprozess machen aus einem Alert einen gesteuerten Vorfall. Engineers können technische Nachweise prüfen, Analysten die geschäftliche Auswirkung sehen und Stakeholder den Status verfolgen, ohne Produktionsdaten aus der Kundenumgebung zu bewegen. Weitere praktische Hinweise zu Validierung und laufenden Kontrollen finden Sie unter Datenvalidierungsregeln und kontinuierliche Datenqualität.
Nutzen, den Sie messen und im Alltag spüren
Der größte Nutzen automatischer Qualitätskontrolle ist nicht die Zahl konfigurierter Prüfungen. Es ist die geringere Unsicherheit im normalen Arbeitsalltag. Teams erkennen Drift, bevor eine Dashboard-Aktualisierung sie offenlegt, sehen, ob ein verspäteter Feed eine Berichtslücke verursacht hat, und unterscheiden eine defekte Pipeline von einer echten Geschäftsveränderung.
Industrielle Bildverarbeitung zeigt den Wert kontinuierlicher Prüfung gegenüber reiner Endstichprobe. Übersichten zu SPS-integrierter, bildbasierter Qualitätskontrolle beschreiben Systeme, die jedes Produktbild erfassen, Fehler in Echtzeit klassifizieren und 100 % Inspektion bei Linien-Geschwindigkeit unterstützen. Eine berichtete Integration erreichte rund 96,2 % Genauigkeit, bei 95,4 % Precision, 96,8 % Recall und einem F1-Wert von 96,1 % (Übersicht zu industrieller bildbasierter Qualitätskontrolle).
Was sich für das Team ändert
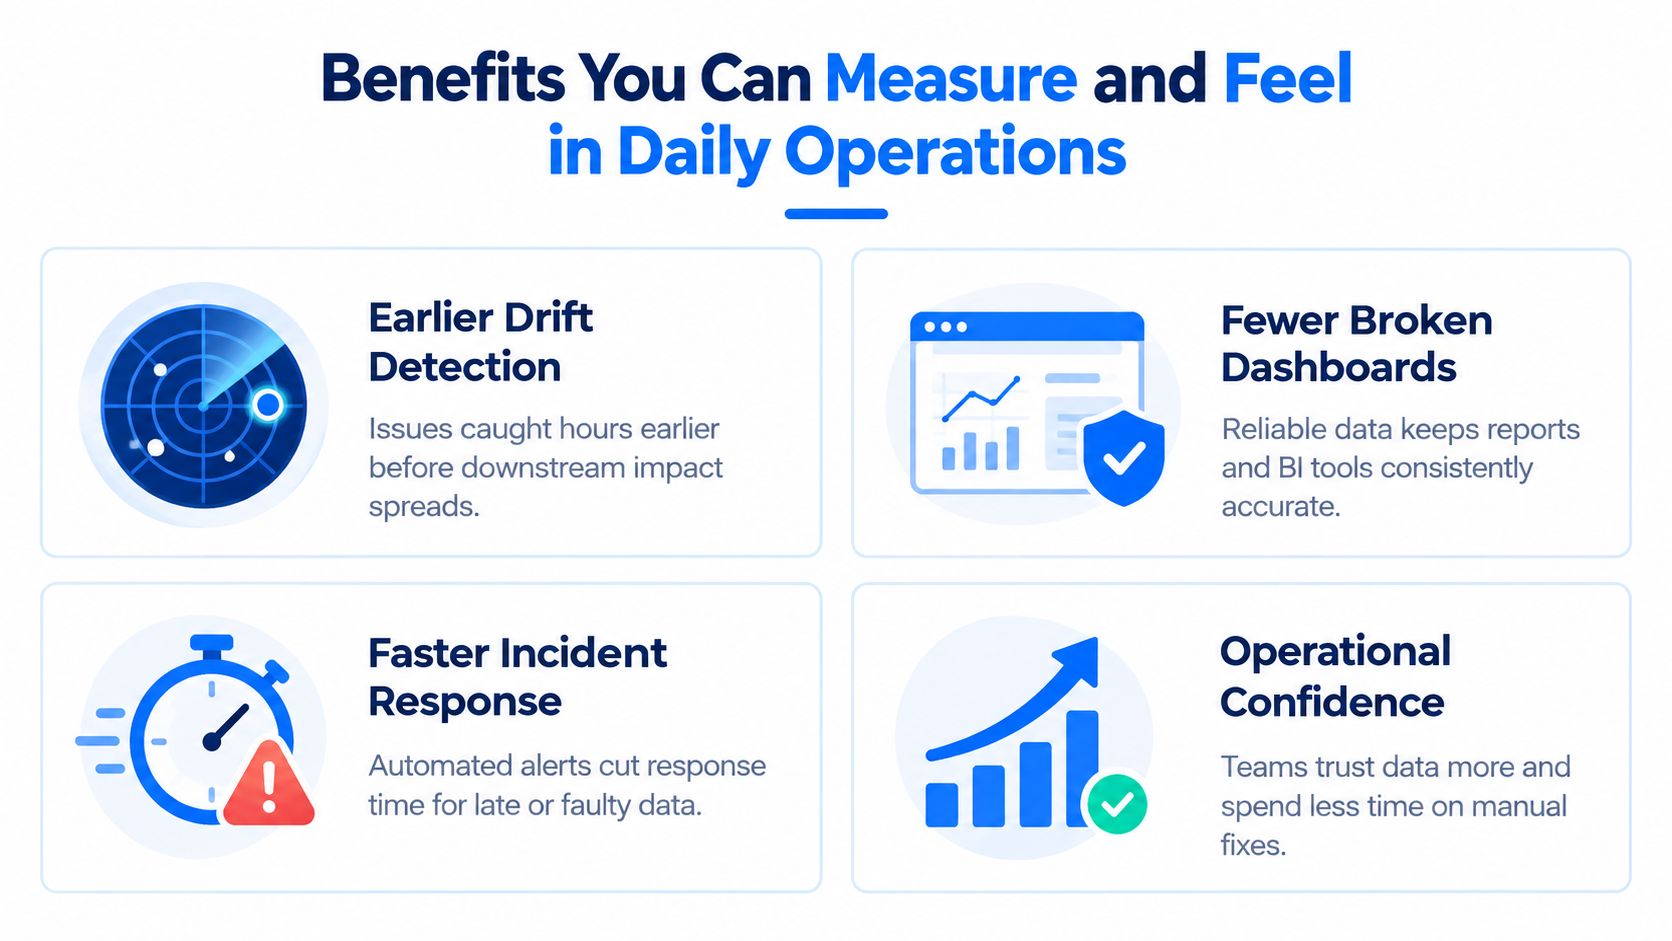
Frühere Drift-Erkennung gibt Engineers Zeit, eine Quelle oder Transformation zu untersuchen, bevor nachgelagerte Konsumenten den Effekt vervielfachen. Eine kleine Abweichung wird zum sichtbaren Ereignis statt zur verborgenen Annahme.
Weniger kaputte Dashboards ergeben sich daraus, dass sowohl Daten als auch Struktur überwacht werden. Ein Dashboard kann technisch verfügbar bleiben und trotzdem veraltete oder verzerrte Informationen zeigen. Qualitätssignale helfen, diesen Unterschied zu erkennen.
Schnellere Reaktion auf ausbleibende Ladevorgänge entsteht durch die Verfolgung erwarteter Lieferungen. Statt darauf zu warten, dass eine Analystin einen leeren Report bemerkt, kann das System feststellen, dass ein Datensatz nicht im normalen Betriebsmuster eingetroffen ist.
Stärkere Compliance-Nachweise entstehen aus deterministischen Kontrollen, Ausführungshistorie, Verantwortlichkeiten und dokumentierten Ergebnissen. Prüfer und Fachverantwortliche brauchen mehr als einen grünen Status. Sie müssen wissen, was gelaufen ist und was passiert ist.
Für Leserinnen und Leser, die sich mit der Rolle prädiktiver Daten in der QA befassen, gilt ein ähnliches Prinzip: Historisches Verhalten hilft, Qualitätsrisiken vorwegzunehmen, aber prädiktive Signale brauchen klare Handlungswege. Automatisierung unterstützt Kostenkontrolle, Modellzuverlässigkeit und Vertrauen in Analytik nur dann, wenn Alerts verständlich sind und jemand die Reaktion verantwortet.
Das praktische Ergebnis ist Vertrauen. Teams verbringen weniger Zeit damit zu prüfen, ob Daten existieren, und mehr Zeit damit zu entscheiden, was die Daten bedeuten. Dieser Nutzen verschwindet, wenn jeder Alert laut, doppelt oder ohne verantwortliches Team ist — deshalb bleiben Tuning und Ownership Teil des Qualitätssystems. Mehr Kontext zu diesen operativen Ergebnissen bietet der Überblick zum Nutzen von Datenqualität.
Wo automatische Qualitätskontrolle in der Praxis Wirkung zeigt
Dieselbe Kontrollarchitektur wirkt in verschiedenen Branchen unterschiedlich, weil die Risiken unterschiedlich sind. Ein Finanzteam achtet vielleicht auf regulatorisches Reporting und Transaktionsvollständigkeit. Eine Gesundheitsorganisation priorisiert klinische Datenzuverlässigkeit und Datenschutz. Ein Telekommunikationsanbieter beobachtet Kundenereignisse in hohem Volumen, während eine Behörde konsistente, nachvollziehbare Datensätze für Prüfungen braucht.
Finanzwesen
Ein Risiko-Feed trifft jeden Morgen ein und speist Berichte für Finanz- und Compliance-Teams. Ein abgeschlossener Job garantiert nicht, dass der Feed die erwarteten Datensätze enthält oder dass eine Quelländerung kein kritisches Feld verändert hat. Timeliness-Monitoring erkennt eine späte Ankunft, deterministische Validierung setzt Transaktionsregeln durch, und Schema-Tracking macht eine strukturelle Änderung sichtbar, bevor das Reporting bricht.
Praktische Erkenntnis: Beginnen Sie mit den Datenbeständen, die regulatorische, Risiko- oder Finanzentscheidungen stützen, und weisen Sie jeder Kontrolle explizite Verantwortliche zu.
Gesundheitswesen
Ein klinisches Betriebsteam kombiniert Informationen aus mehreren Systemen. Ein fehlendes Feld kann die Interpretation beeinflussen, während eine strukturelle Änderung eine nachgelagerte Anwendung stören kann, ohne einen offensichtlichen Pipeline-Fehler zu erzeugen. Kontinuierliche Validierung und Schema-Monitoring erkennen solche Zustände und halten die Berechnung dabei in der kontrollierten Umgebung der Organisation.
Praktische Erkenntnis: Trennen Sie den Umgang mit datenschutzsensiblen Daten von den Monitoring-Nachweisen und legen Sie fest, welche Kontrollen deterministischen Beleg erfordern.
Telekommunikation
Eine Telekommunikationsplattform verarbeitet Kunden- und Betriebsereignisse in hohem Volumen. Fachverantwortliche müssen wissen, ob eine unerwartete Bewegung tatsächliches Kundenverhalten oder ein Pipeline-Problem widerspiegelt. Das Monitoring zugrunde liegender Geschäftskennzahlen neben Datenverfügbarkeit und Plattformlast hilft Teams, die richtige Ebene zu untersuchen.
Praktische Erkenntnis: Kombinieren Sie KPI-Monitoring mit Plattform-Observability, damit ungewöhnliche Geschäftsbewegungen gegen operative Nachweise geprüft werden können.
Öffentlicher Sektor
Behördliche Daten wandern oft zwischen Ressorts und Systemen mit unterschiedlichen Eigentümermodellen. Ein Kontrollprogramm muss Konsistenz, Nachvollziehbarkeit und auditfähige Nachweise unterstützen, statt sich auf informelle Prüfungen einzelner Teams zu verlassen.
Praktische Erkenntnis: Dokumentieren Sie für jeden kritischen Datenbestand Regel, Ausführung, Ergebnis und verantwortliche Person.
In regulierten Umgebungen zählt die Deployment-Architektur ebenso wie die Erkennung. digna kann in der Private Cloud, der VPC oder dem Rechenzentrum des Kunden laufen, wobei die Berechnung in-database erfolgt — so lassen sich Datenbewegungen begrenzen und zugleich eine gemeinsame Sicht auf Vorfälle, Trends und Status erhalten.
Wann automatisiert werden sollte und wie Sie mit digna starten
Beginnen Sie beim Risiko, nicht beim größten Funktionskatalog. Ein kritischer Datenbestand mit häufigen Liefererwartungen und mehreren nachgelagerten Konsumenten verdient Aufmerksamkeit vor einer Tabelle mit geringer Wirkung, die kaum jemand nutzt.
Vier Fragen helfen, den ersten Umfang festzulegen:
Entscheidungswirkung: Welche geschäftliche, klinische, finanzielle oder öffentliche Entscheidung hängt von diesen Daten ab?
Sichtbarkeit von Fehlern: Würden Nutzer einen Fehler sofort bemerken, oder könnte er verborgen bleiben?
Operative Komplexität: Durchlaufen die Daten mehrere Pipelines, Verantwortliche oder Plattformen?
Governance-Druck: Verlangen Datenschutz, Compliance oder Audit Nachweise?
Ein sinnvolles erstes Projekt adressiert ein Problem mit hoher Wirkung, etwa Anomalieerkennung oder Pünktlichkeit. Erweitern Sie, sobald das Team Alarmqualität, Verantwortlichkeiten und Behebung versteht. Halten Sie den Rollout modular und ergänzen Sie deterministische Validierung, Schema-Tracking, Business-Monitoring oder Plattform-Observability dort, wo das Risiko es rechtfertigt.
Checkliste für die Einführung
Lokal ausführen: Halten Sie die Berechnung in Cloud, VPC oder Rechenzentrum der Organisation, wenn Datenbewegung Risiko erzeugt.
Die Datenbank nutzen: Bevorzugen Sie In-Database-Berechnung von Metriken, wo Sicherheit und Skalierung es erfordern.
Gelernte und feste Signale trennen: Lassen Sie Baselines ungewöhnliches Verhalten erkennen, während deterministische Regeln Pflichten durchsetzen.
Nachweise festhalten: Speichern Sie Kontrolle, Ausführungskontext, Ergebnis, Verantwortliche und Historie der Behebung.
Den Workflow verbinden: Integrieren Sie Alerts mit Scheduler, Katalog, Dashboards und Kollaborationsprozess.
Fehlalarme prüfen: Behandeln Sie Alert-Tuning als dauerhafte Engineering-Aufgabe.
Ein fokussierter Ansatz zur Umsetzung von Datenqualität hilft Teams, diese Entscheidungen in ein Betriebsmodell zu überführen. Ziel ist nicht, Tests um ihrer selbst willen zu automatisieren. Ziel ist, Qualität zu einem kontinuierlichen, transparenten Prozess zu machen, dem Engineers und Fachverantwortliche vertrauen können.
digna bietet modulares Monitoring für Anomalien, Validierung, Pünktlichkeit, Schemaänderungen, Geschäftskennzahlen und Verhalten der Datenplattform — innerhalb der Kundenumgebung. Besuchen Sie digna, um einen fokussierten Startpunkt zu bewerten und zu sehen, wie kontinuierliche automatische Qualitätskontrolle zu Ihrer Datenlandschaft passt.
So sieht das bei digna in der Praxis aus: automatisiertes Datenqualitäts-Monitoring dort, wo Ihre Daten liegen.
Häufig gestellte Fragen
Was ist automatische Qualitätskontrolle für Daten?
Automatische Qualitätskontrolle ist die kontinuierliche Prüfung von Datenbeständen, ohne dass jemand sie auslöst. Sie kombiniert regelbasierte Validierung für exakt formulierbare Anforderungen, statistische Schwellenwerte für messbare Toleranzen und maschinelles Lernen, das Abweichungen vom gelernten Verhalten jedes Datensatzes meldet.
Wie unterscheidet sich automatisierte Qualitätskontrolle von manuellen Prüfungen?
Manuelle Prüfung nimmt Stichproben in Abständen und hängt davon ab, wer gerade hinschaut. Automatisierung beobachtet jeden Ladevorgang gegen eine Baseline, sodass die Abdeckung nicht von der Schicht abhängt und die Erkennungszeit von Tagen auf Minuten sinkt — und genau diese Zeit bestimmt, wie viel Schaden ein Problem nachgelagert anrichtet.
Wann sollte man Regeln und wann KI-Erkennung einsetzen?
Nutzen Sie Regeln, wenn sich die Anforderung aufschreiben lässt: Eine Spalte darf nicht NULL sein, ein Wert muss einem Format entsprechen, eine Tabelle muss bis zu einer Frist eintreffen. Nutzen Sie statistische und KI-Erkennung für alles, was sich nicht vorab aufzählen lässt — etwa einen Volumeneinbruch, eine Verteilungsverschiebung oder einen Ladevorgang, der jede Nacht später wird.
Erfordert automatische Qualitätskontrolle das Kopieren von Daten auf eine andere Plattform?
Sollte sie nicht. Wenn die Berechnung nah an den Daten bleibt, verlassen nur Metriken und Metadaten die Umgebung — wichtig überall dort, wo Datenresidenz, Datenschutz oder Branchenregulierung einschränken, wo Produktionsdaten verarbeitet werden dürfen.
Wie startet man mit der Automatisierung der Datenqualitätskontrolle?
Beginnen Sie mit den Datenbeständen, deren Ausfall echte Folgen hat, lassen Sie das System ihr normales Verhalten lernen und automatisieren Sie die Prüfungen, die Ihr Team bereits von Hand durchführt. Erweitern Sie die Abdeckung, sobald den Alerts vertraut wird — Einführungen scheitern häufiger an Alarmrauschen als an fehlenden Funktionen.


