Wykrywanie anomalii z wykorzystaniem uczenia maszynowego: praktyczny przewodnik
|
10
min. czyt.

O 9:00 dashboard przychodów wygląda dobrze. O 11:30 dział finansowy kwestionuje prognozę tygodniową, szefowie sprzedaży podważają dane o lejku sprzedażowym, a nikt nie potrafi wskazać awarii systemu. Problemem nie jest wadliwe zadanie w hurtowni. To cicha zmiana na wcześniejszym etapie. Tabela źródłowa zaczęła duplikować rekordy, znacznik czasu dotarł z opóźnieniem albo rozkład wartości w kolumnie przesunął się na tyle, by zatruć logikę w dalszej części procesu, nie uruchamiając żadnego zakodowanego na sztywno alertu.
Właśnie do wykrywania takich awarii służy wykrywanie anomalii z wykorzystaniem uczenia maszynowego. Nie głośnych incydentów, lecz cichych. Takich, które przechodzą podstawową walidację, trafiają do zaufanych tabel i stopniowo podkopują zaufanie do każdego raportu i modelu, który od nich zależy.
Wiele zespołów ma trudności nie dlatego, że brakuje im alertów. Mają trudności, ponieważ tradycyjne monitorowanie oparte na progach nie nadąża za danymi wielowymiarowymi, zmienną sezonowością, ewoluującymi potokami i korporacyjnymi ograniczeniami dotyczącymi prywatności i wdrożeń. Nowoczesne wykrywanie anomalii działa, gdy stale uczy się normalnego zachowania, działa blisko danych i wpisuje się w procesy obserwowalności, które zespoły operacyjne są w stanie utrzymać.
Spis treści
Gdy ciche błędy danych powodują głośne problemy
Typowy scenariusz awarii zaczyna się od tego, że użytkownik biznesowy ufa danym, które technicznie są obecne, ale zachowują się nieprawidłowo. Prognozy sprzedaży gwałtownie rosną. Odpływ klientów z dnia na dzień wydaje się maleć. Magazyn cech ML pobiera zniekształcone wartości i zmienia wyniki modelu. Nikt nie widzi awarii, bo nic nie uległo awarii.
Kontrole oparte na regułach zwykle wychwytują oczywiste błędy: skoki wartości null, brakujące pliki, liczby wierszy spadające do zera. Mają trudności, gdy problem jest subtelniejszy, na przykład gdy źródło wysyła zduplikowane rekordy, rozkład przesuwa się w akceptowalnym zakresie albo skorelowane pola dryfują razem w sposób, którego żadna statyczna reguła nie przewidziała.
Ta luka ma znaczenie w rzeczywistych operacjach. Metody wykrywania anomalii oparte na uczeniu maszynowym przewyższają tradycyjne podejścia statystyczne o 8–12% pod względem dokładności, a niektóre implementacje osiągają nawet o 15% wyższą precyzję w wykrywaniu złożonych, wielowymiarowych anomalii, zwłaszcza w środowiskach o dużej liczbie wymiarów, takich jak monitorowanie transakcji finansowych i przewidywanie awarii urządzeń przemysłowych – wynika z tego podsumowania badań nad wykrywaniem anomalii.
Dlaczego starsze metody monitorowania zawodzą
Tradycyjne monitorowanie zakłada, że zespoły potrafią z góry zdefiniować awarię. W praktyce nie potrafią.
Zmienia się logika biznesowa: Nowe kampanie, zmiany cen, reorganizacje regionów sprzedaży i premiery produktów zmieniają zachowanie danych szybciej, niż aktualizowane są reguły alertów.
Potoki nakładają się warstwami: Pojedynczy KPI może zależeć od zadań pozyskiwania danych, modeli dbt, synchronizacji reverse ETL i zewnętrznych API.
Anomalie kryją się w relacjach: Każda kolumna z osobna może wyglądać normalnie, podczas gdy łączny wzorzec jest wyraźnie błędny.
Praktyczna zasada: Jeśli Twój zespół dowiaduje się o problemach z danymi od użytkownika dashboardu, a nie z monitoringu, Twoja logika wykrywania jest zbyt krucha.
Zespoły modernizujące te procesy często zaczynają od naprawy warstwy pozyskiwania i transformacji danych. Dlatego materiały takie jak rozwiązania do przetwarzania danych od Osher Digital stanowią przydatny kontekst. Niezawodne przetwarzanie ogranicza awarie, którym można zapobiec, ale nie zastępuje wykrywania anomalii. Nadal potrzebujesz systemu, który po rozpoczęciu przepływu danych wychwyci nieznane niewiadome.
Co zmienia uczenie maszynowe
Wykrywanie anomalii z wykorzystaniem uczenia maszynowego zmienia zadanie z pisania reguł na uczenie się punktów odniesienia. Zamiast wymagać od inżyniera zdefiniowania z góry każdego złego stanu, system modeluje oczekiwane zachowanie i sygnalizuje istotne odchylenia.
Ta zmiana ma charakter operacyjny, a nie akademicki. Chroni prognozowanie, raportowanie finansowe, procesy zgodności, monitorowanie nadużyć i dane wejściowe modeli przed cichym dryfem, który wywołuje najkosztowniejsze spory w korporacyjnych zespołach danych.
Anatomia anomalii
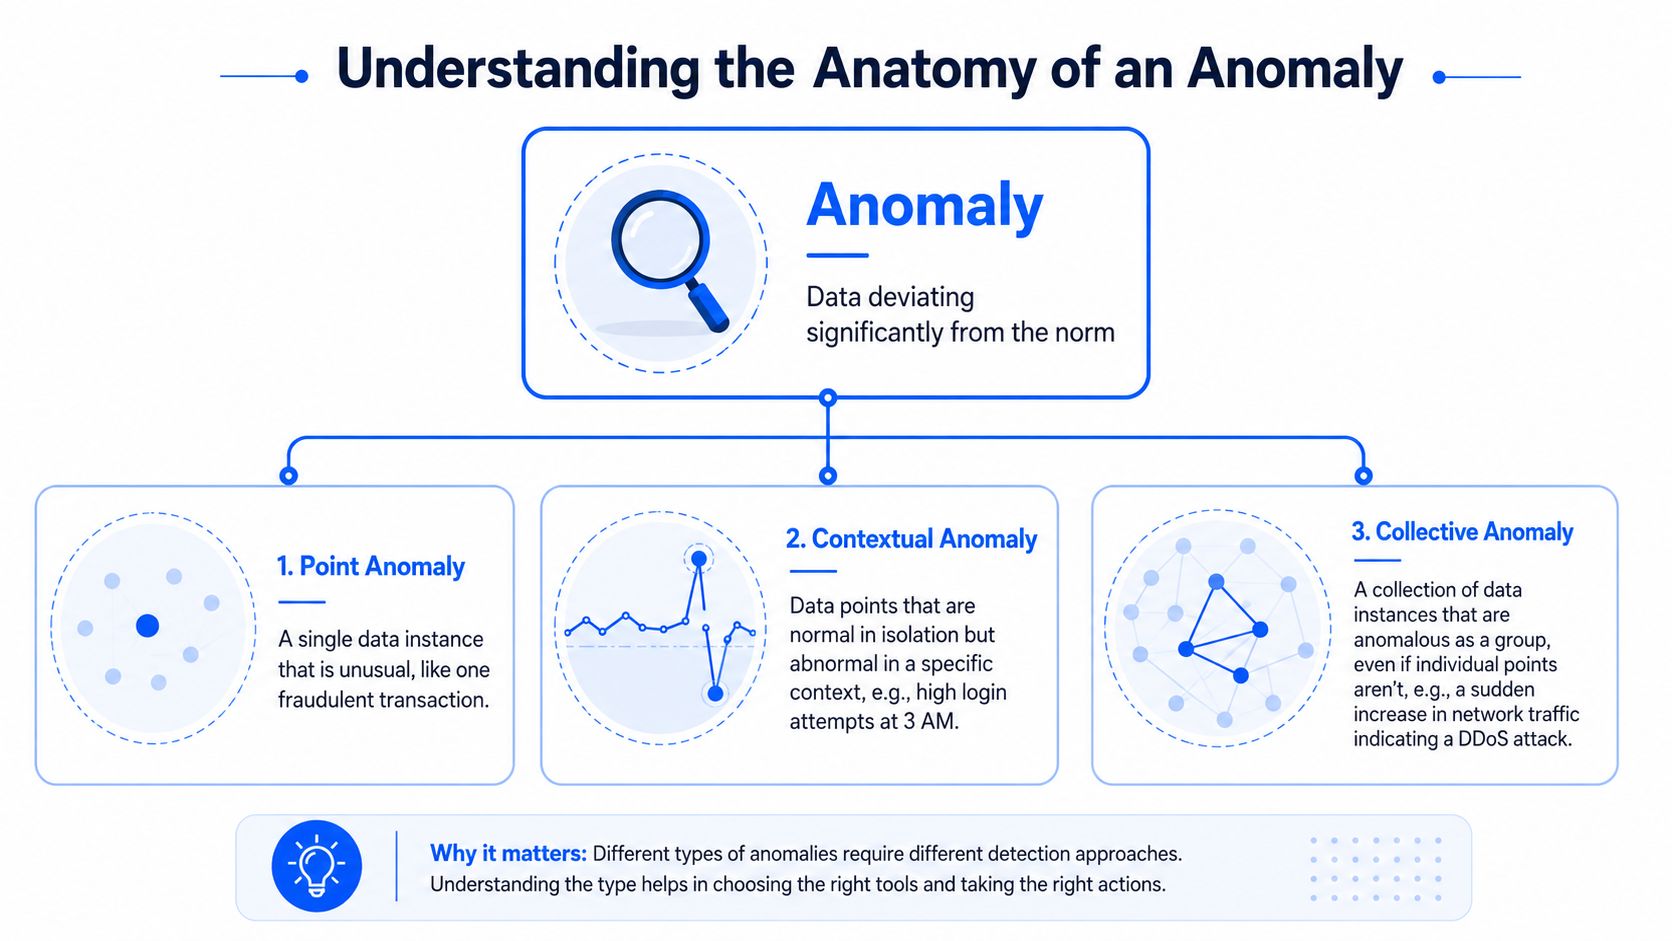
Anomalia to dane odbiegające od oczekiwanego zachowania. Przydatna nie jest sama definicja. Przydatna jest wiedza, z jakim rodzajem odchylenia masz do czynienia, ponieważ metody wykrywania zawodzą, gdy zespoły traktują każdą anomalię jako ten sam problem.
Anomalie punktowe
Anomalię punktową najłatwiej sobie wyobrazić. Jedno zdarzenie, jedna wartość, jeden wiersz wygląda nieprawidłowo. Pomyśl o pojedynczej transakcji kartą, która znacznie odbiega od normalnego wzorca klienta, albo o jednym ładowaniu hurtowni z niemożliwą liczbą rekordów.
To przypadki, z myślą o których zwykle projektuje się rozwiązania w pierwszej kolejności, bo łatwo przekładają się na alerty. Wartość jest za wysoka, za niska, za wczesna, za późna lub zbyt odległa od normy.
Anomalie kontekstowe
Anomalia kontekstowa wygląda w porządku, dopóki nie weźmiesz pod uwagę czasu, sezonowości lub okoliczności. Duża liczba logowań w południe może być normalna. Ta sama liczba o 3:00 w nocy w przypadku wrażliwego systemu wewnętrznego może być poważnym sygnałem.
Platformy danych często się z tym spotykają. Spóźniony plik może być normalny w harmonogramie świątecznym, ale niepokojący w dniu sesji giełdowej. Skok ruchu może być oczekiwany podczas startu kampanii, ale podejrzany w spokojny weekend.
Anomalie zbiorowe
Anomalia zbiorowa to obszar, w którym monitorowanie w przedsiębiorstwach często zawodzi. Poszczególne rekordy wydają się nieszkodliwe, ale razem tworzą wzorzec, który nie powinien istnieć. Do tej kategorii mogą należeć skoordynowany atak botów, subtelny dryf schematu obejmujący wiele pól czy sekwencja zdarzeń zmieniających się jednocześnie.
Proste progi nie uwzględniają kontekstu. Zespoły potrzebują metod wykrywających relacje między kolumnami, oknami czasowymi i encjami.
Zły wiersz łatwo wychwycić. Zaufanie na produkcji podkopuje zły wzorzec rozproszony w zbiorze danych, który wygląda na zdrowy.
Dlaczego statyczne progi tu zawodzą
Statyczne progi są atrakcyjne, bo łatwo je wyjaśnić. Są jednak kosztowne w utrzymaniu. Każde nowe źródło, wzorzec sezonowości i wyjątek biznesowy dokładają kolejne reguły. W końcu system generuje tyle szumu, że ludzie zaczynają go ignorować.
Nowoczesne platformy zastępują to adaptacyjnym uczeniem się punktów odniesienia. Jak opisano w przeglądzie technik wykrywania anomalii z użyciem AI od digna, systemy wykrywania anomalii oparte na uczeniu maszynowym stale profilują wolumen rekordów, brakujące wartości i rozkłady wartości, aby dynamicznie wyznaczać oczekiwane granice, co pomaga wykrywać w czasie rzeczywistym ciche błędy, takie jak brakujące lub zduplikowane rekordy.
Taki model działania zmienia codzienną pracę zespołów danych:
Mniej utrzymywania reguł: Inżynierowie nie muszą ręcznie dostrajać progów dla każdej tabeli i metryki.
Lepsze pokrycie: System może obserwować zmiany zachowania, które nie są na tyle oczywiste, by zakodować je ręcznie.
Bardziej przejrzysta analiza: Zespoły mogą porównywać bieżące zachowanie z wyuczonymi punktami odniesienia, zamiast spierać się, czy próg został ustawiony prawidłowo.
Co to oznacza w praktyce obserwowalności
W obserwowalności wykrywanie anomalii nie jest odizolowane od reszty stosu. Działa obok monitorowania terminowości, śledzenia schematów i walidacji. Jeden mechanizm wychwytuje nieoczekiwany wzorzec metryki. Inny potwierdza opóźnienie. Jeszcze inny ujawnia nową kolumnę lub zmianę typu danych. Razem wyjaśniają, dlaczego zaufanie zostało naruszone.
Na tym polega praktyczna wartość. Nie tylko wykrywasz wartości odstające. Chronisz decyzje biznesowe przed danymi, które na pierwszy rzut oka nadal wydają się dostępne, aktualne i możliwe do odpytania.
Cztery kluczowe podejścia uczenia maszynowego
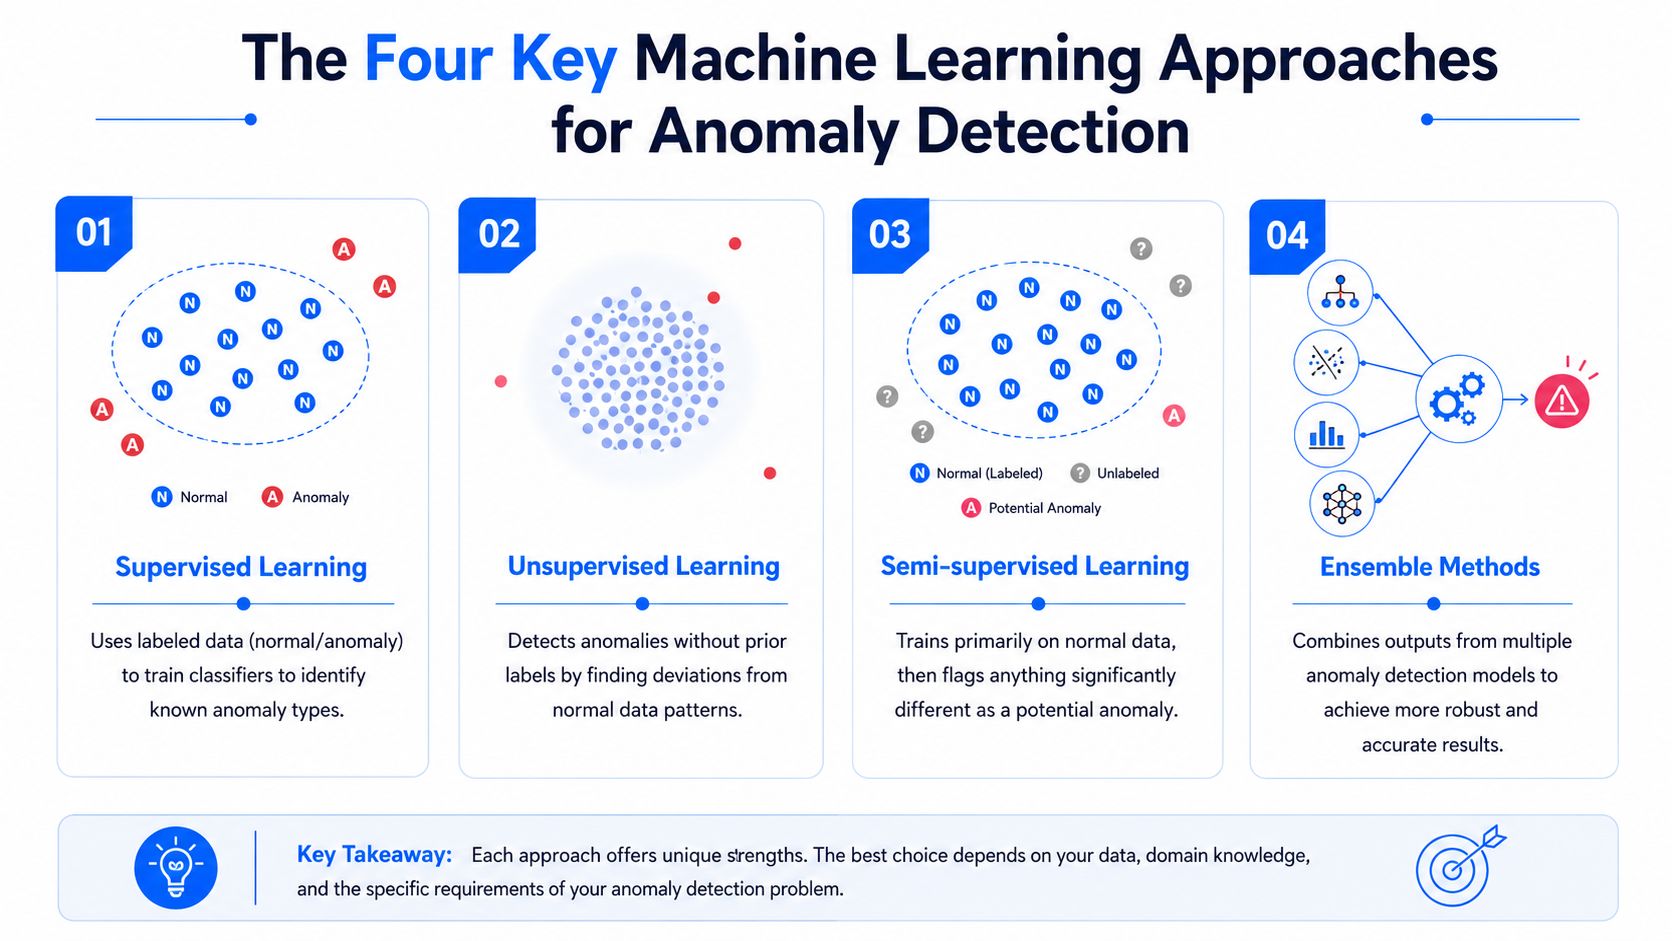
Właściwe podejście zależy nie tyle od popularności algorytmu, ile od tego, czym dysponuje Twój zespół danych. Etykiety, stabilne historyczne punkty odniesienia, struktura sekwencji, budżet obliczeniowy, wymagania dotyczące opóźnień i możliwości weryfikacji alertów mają większe znaczenie niż nowość rozwiązania.
Uczenie nadzorowane
Wykrywanie nadzorowane działa, gdy już wiesz, jak wyglądają nieprawidłowości, i masz etykiety, które to potwierdzają. Systemy wykrywania nadużyć, potoki weryfikacji roszczeń i niektóre procesy bezpieczeństwa mogą to uzasadnić, ponieważ z czasem gromadzą zweryfikowane incydenty.
Zaletą jest precyzja w przypadku znanych rodzajów awarii. Jeśli oznaczone anomalie są reprezentatywne, klasyfikator może nauczyć się tych wzorców bezpośrednio.
Wada ma charakter operacyjny. Etykiet jest mało, są kosztowne i często nieaktualne. Problemy z danymi w przedsiębiorstwach również zmieniają swój charakter. Klasa anomalii z zeszłego kwartału może nie obejmować błędu integracji z bieżącego kwartału.
Stosuj podejścia nadzorowane, gdy:
Istnieją zweryfikowane anomalie: Twój zespół dysponuje wysokiej jakości etykietami od analityków, specjalistów ds. nadużyć lub zespołów bezpieczeństwa.
Rodzaje awarii się powtarzają: Masz do czynienia z powtarzalnymi, dobrze zrozumiałymi klasami anomalii.
Ścieżki działania są zdefiniowane: Biznes już wie, co robić, gdy system zasygnalizuje problem.
Uczenie nienadzorowane
Metody nienadzorowane są domyślnym wyborem na wielu platformach danych, ponieważ etykiety często są niedostępne. System szuka odchyleń w samych danych, a nie przykładów znanych złych zdarzeń.
Często jest to najbardziej praktyczna ścieżka dla obserwowalności w przedsiębiorstwie. Można ją wdrożyć dla wielu tabel i metryk bez wcześniejszego budowania procesu etykietowania. Należą tu metody takie jak klasteryzacja, modele oparte na izolacji i ocena oparta na odległości.
Jeden z solidnych rzeczywistych projektów opisano w dokumentacji wykrywania anomalii Netdata: nienadzorowana klasteryzacja k-średnich z k=2 na kroczących oknach, z wieloma modelami na metrykę, która według dokumentacji przynosi 99% redukcji fałszywych alarmów dzięki wymogowi jednomyślnej zgody modeli przed oznaczeniem anomalii. To dobre przypomnienie, że decyzje architektoniczne mogą mieć równie duże znaczenie jak bazowy algorytm.
Pierwsze pytanie produkcyjne nie brzmi „Który model jest najmądrzejszy?”. Brzmi: „Które podejście poradzi sobie z danymi bez etykiet, zaszumionymi danymi wejściowymi i realiami dyżurów?”.
Uczenie częściowo nadzorowane
Wykrywanie częściowo nadzorowane wychodzi z praktycznego założenia: możesz nie znać każdej anomalii, ale zwykle znasz zbiór zaufanych, normalnych danych. Model uczy się tego punktu odniesienia i traktuje istotne odchylenia jako podejrzane.
Jest to szczególnie przydatne w potokach korporacyjnych, w których okresy prawidłowego działania łatwiej zidentyfikować niż okresy problemów. Możesz trenować model na zaakceptowanych oknach historycznych, a następnie oceniać nowe dane względem wyuczonej reprezentacji.
Metody częściowo nadzorowane zwykle dobrze sprawdzają się w następujących sytuacjach:
Sytuacja | Dlaczego pomaga podejście częściowo nadzorowane |
|---|---|
Stabilne systemy z okazjonalnym dryfem | Model uczy się jasnego zakresu normalnego działania |
Wrażliwe procesy | Zespoły preferują ostrożne wykrywanie zakotwiczone w zaufanych danych |
Niska częstotliwość anomalii | Brakuje pozytywnych przykładów, by stosować uczenie nadzorowane |
Uczenie głębokie
Uczenie głębokie staje się istotne, gdy struktura jest na tyle złożona, że prostsze modele ją przeoczają. Do tej kategorii często należą sygnały szeregów czasowych, wielowymiarowa telemetria i zachowania o dużej liczbie wymiarów.
W przypadku szeregów czasowych w środowiskach przemysłowych i potokach ten przegląd metod wykrywania anomalii zauważa, że prognozowanie za pomocą LSTM w połączeniu z dekompozycją Variational Mode Decomposition pozwala wyodrębnić składowe okresowe przed wykrywaniem anomalii w resztowych szeregach czasowych. Mówiąc prościej: model najpierw oddziela normalne, powtarzalne zachowanie od pozostałej części sygnału, a następnie sprawdza, czy ta pozostałość wygląda podejrzanie.
Uczenie głębokie przydaje się, gdy:
sekwencje mają większe znaczenie niż pojedyncze rekordy
okresowość i dryf występują jednocześnie
sygnał obejmuje wiele skorelowanych zmiennych
Wiąże się też z większym zapotrzebowaniem na moc obliczeniową, większą liczbą dostrajań i większym obciążeniem monitorowaniem. Jeśli prostsza metoda wychwytuje problem przy akceptowalnej jakości sygnału, zwykle jest lepszym wyborem produkcyjnym.
Zespoły modeli w praktyce
Wiele systemów korporacyjnych ostatecznie korzysta z metod zespołowych, nawet jeśli zespoły tak ich nie nazywają. Łączą one wiele detektorów lub etapów oceny, aby ograniczyć szum i zwiększyć niezawodność.
Praktyczny zespół modeli może obejmować podstawowy filtr statystyczny, wyuczoną ocenę anomalii i regułę walidacyjną. Inny może łączyć autoenkoder z progowaniem opartym na izolacji. Na produkcji zespoły modeli często wygrywają, ponieważ uwzględniają nieuporządkowaną rzeczywistość: jeden detektor rzadko dobrze radzi sobie z każdą tabelą, częstotliwością i rodzajem awarii.
Wybór właściwego algorytmu do zadania
Nie istnieje uniwersalnie najlepszy algorytm wykrywania anomalii. Istnieje tylko algorytm dopasowany do struktury Twoich danych, kształtu anomalii, wymagań dotyczących opóźnień i procesu weryfikacji. Zespoły wpadają w kłopoty, gdy standaryzują się na jednej metodzie, bo raz zadziałała.
Najważniejsze rozróżnienie dotyczy tego, czy musisz wychwytywać anomalie globalne, czy anomalie lokalne. Brzmi to akademicko, dopóki nie wdrożysz rozwiązania na dużą skalę. Wtedy staje się to różnicą między wychwyceniem rzeczywistego dryfu a przeoczeniem go przez wiele miesięcy.
Lokalne czy globalne – to ma znaczenie
Niektóre anomalie leżą daleko poza całym zbiorem danych. To globalne wartości odstające. Inne są nietypowe tylko w obrębie lokalnego sąsiedztwa lub klastra. To lokalne wartości odstające.
To rozróżnienie wpływa na wybór modelu. Według badań opublikowanych w Journal of Machine Learning Research wybór algorytmu musi zależeć od tego, czy anomalie są lokalne, czy globalne. Gdy dane zawierają wiele klastrów o różnej gęstości, metoda k najbliższych sąsiadów przewyższa isolation forest, natomiast isolation forest lepiej nadaje się do czysto globalnych anomalii.
Ma to bezpośrednie znaczenie dla danych w przedsiębiorstwie. Zachowania klientów często grupują się według regionu, produktu lub kanału. Metryki urządzeń grupują się według trybu pracy. Aktywność użytkowników grupuje się według roli. Punkt może wyglądać normalnie globalnie, a jednocześnie być wysoce nietypowy w obrębie własnego segmentu.
Ściągawka z algorytmów wykrywania anomalii
Algorytm | Typ | Najlepszy do | Kluczowa uwaga |
|---|---|---|---|
Isolation Forest | Wykrywanie globalnych wartości odstających | Wyraźne, odizolowane anomalie w danych tabelarycznych | Może przeoczyć lokalne anomalie w gęstych klastrach |
k-Nearest Neighbors | Oparty na lokalnej gęstości i odległości | Zbiory danych z klastrami, w których liczy się zachowanie sąsiedztwa | Wrażliwy na skalowanie i definicję odległości |
Local Outlier Factor | Oparty na lokalnej gęstości | Wykrywanie rekordów o znacznie niższej lokalnej gęstości niż pobliskie punkty | Trudniejszy do wyjaśnienia nietechnicznym recenzentom |
Z-score | Jednowymiarowy statystyczny punkt odniesienia | Szybkie kontrole pojedynczych metryk o względnie stabilnych rozkładach | Słaby w przypadku relacji wielowymiarowych |
ECOD | Punkt odniesienia dla wartości odstających w danych tabelarycznych | Lekki punkt odniesienia dla procesów jakości danych | Najlepiej stosować jako benchmark, a nie uniwersalne rozwiązanie |
LSTM | Model sekwencyjny | Szeregi czasowe z zależnościami czasowymi i powtarzającymi się wzorcami | Wyższy koszt operacyjny i większy nakład na dostrajanie |
Autoenkoder | Oparty na rekonstrukcji | Uczenie się normalnych wzorców w danych o dużej liczbie wymiarów | Progowanie i obsługa dryfu wymagają ostrożności |
Co sprawdza się w typowych przypadkach korporacyjnych
W monitorowaniu jakości danych tabelarycznych proste punkty odniesienia wciąż mają swoje miejsce. Isolation Forest i ECOD to praktyczne punkty wyjścia dla kolumn, metryk na poziomie wierszy i kontroli kondycji zbiorów danych.
W przypadku danych klientów lub produktów tworzących klastry metody oparte na sąsiedztwie zwykle warto przetestować na wczesnym etapie. Jeśli Twój zbiór danych ma wiele reżimów działania, podejścia oparte na lokalnej gęstości mogą ujawnić anomalie, które metody globalne wygładzają.
W przypadku szeregów czasowych wybieraj w zależności od tego, jak długiej pamięci wymaga wzorzec. Kontrole krótkoterminowych odchyleń mogą działać z prostszymi metodami statystycznymi. Dłuższe zależności, okresowość i zachowanie reszt mogą uzasadniać modele rekurencyjne lub oparte na rekonstrukcji. Jeśli Twój zespół ocenia rozwiązania przeznaczone dla sekwencji, ten przewodnik po wykrywaniu anomalii w szeregach czasowych jest przydatnym materiałem operacyjnym.
Nie wybieraj algorytmu dlatego, że jest popularny. Wybierz go dlatego, że jego sposób zawodzenia jest akceptowalny dla Twoich danych.
Kompromisy, których zespoły nie doceniają
Algorytm to nie cały system. Sukces na produkcji zależy od kilku mniej efektownych szczegółów:
Skalowanie i przetwarzanie wstępne: Modele oparte na odległości zawodzą, gdy cechy nie są znormalizowane.
Interpretowalność: Zespoły bezpieczeństwa i opiekunowie danych często potrzebują uzasadnienia, a nie tylko wyniku liczbowego.
Częstotliwość ponownego trenowania: Nawet dobry detektor traci skuteczność, jeśli zmienia się zachowanie bazowe, a nikt go nie aktualizuje.
Proces weryfikacji: Nieco słabszy model z przejrzystszą selekcją alertów często wygrywa z mocniejszym modelem, który zalewa Slacka powiadomieniami.
Dlatego wybór algorytmu powinien odbywać się równolegle z projektowaniem operacyjnym, a nie przed nim.
Jak mierzyć skuteczność i unikać fałszywych alarmów
Poniedziałkowy poranek: detektor zgłasza 600 rekordów. Dwanaście wymaga działania. Reszta to normalne opóźnione dostawy danych, planowane zmiany w katalogu i jednorazowe zdarzenia biznesowe. Jeśli zespół musi codziennie przekopywać się przez taki stos, model zawodzi, nawet jeśli jego wynik offline wyglądał dobrze.

Dlaczego dokładność wprowadza w błąd
Dokładność ukrywa strukturę kosztów wykrywania anomalii. W niezrównoważonych zbiorach danych model może klasyfikować niemal wszystko jako normalne i nadal wyglądać dobrze na papierze. Nie pomaga to analitykowi ds. nadużyć, opiekunowi danych ani inżynierowi platformy, którzy potrzebują systemu wychwytującego rzadkie awarie bez generowania ciągłego szumu.
Przy takim niezrównoważeniu klas typowymi metrykami wyjściowymi są precyzja, czułość (recall) i F1. Wytyczne Google dotyczące uczenia maszynowego w zakresie metryk klasyfikacji dla niezrównoważonych zbiorów danych to praktyczny materiał, jeśli Twój zespół potrzebuje wspólnego punktu odniesienia do oceny.
Metryki, które mają znaczenie na produkcji
Każda metryka odpowiada na inne pytanie operacyjne.
Precyzja: Ile spośród alertów wysłanych do osoby lub systemu w dalszej części procesu było wartych podjęcia działania?
Czułość (recall): Ile spośród wszystkich anomalii wychwycił detektor?
Miara F1: Jak zrównoważone są precyzja i czułość, gdy potrzebujesz jednej liczby do porównania modeli?
Te liczby powinny przekładać się na koszty biznesowe. W płatnościach niska czułość oznacza przeoczone nadużycia. W operacjach na danych niska precyzja oznacza, że kolejki alertów się zapełniają, zespoły dyżurne przestają ufać detektorowi, a prawdziwe incydenty dłużej czekają na weryfikację.
Ustawienie progu ma równie duże znaczenie jak wybór modelu. Zespoły często spędzają tygodnie na porównywaniu algorytmów, a potem stosują domyślny próg, który nigdy nie został dostrojony do ich możliwości weryfikacji ani wagi incydentów.
Oceniaj proces alertowania, nie tylko model
Zbiory testowe offline są przydatne, ale pomijają powszechną w przedsiębiorstwach rzeczywistość. Wiele anomalii jest anomaliami tylko w określonym kontekście.
Zmiana schematu może być prawidłowym wydaniem. Skok liczby zamówień może wynikać z zaplanowanej promocji. Opóźniona partia może odpowiadać SLA dostawcy, które zmieniło się w zeszłym kwartale. Detektor może prawidłowo oznaczyć wzorzec, a mimo to wygenerować zły alert, jeśli system nie ma kontekstu biznesowego.
Lepszy proces oceny obejmuje:
Weryfikację próbek alertów przez osoby odpowiedzialne za decyzje w dalszej części procesu.
Ocenę na poziomie segmentów, aby jedna średnia nie ukrywała awarii w regionie wysokiego ryzyka, segmencie klientów czy systemie źródłowym.
Testy progów względem możliwości weryfikacji, aby potwierdzić, że dzienna liczba alertów jest możliwa do obsłużenia.
Zbieranie informacji zwrotnych, aby potwierdzone fałszywe i prawdziwe alarmy usprawniały przyszłe dostrajanie.
Zespołom budującym tę warstwę weryfikacji przyda się ten przewodnik po metodach identyfikacji wartości odstających, gdy podczas walidacji porównują proste kontrole statystyczne z detektorami opartymi na ML.
Wysoka czułość przy niskiej precyzji powoduje zmęczenie operatorów. Wysoka precyzja przy niskiej czułości tworzy martwe pola. Przydatny detektor pasuje do modelu reagowania przyjętego w biznesie.
Stosuj punkty odniesienia, które przejdą audyt
Zacznij od punktu odniesienia, który zespół potrafi wyjaśnić audytorom, działowi bezpieczeństwa i operacjom. Może to być reguła percentylowa, próg sezonowy lub prosty model nienadzorowany z przejrzystą logiką progów. Jeśli bardziej złożony detektor poprawia jedynie benchmark offline, ale utrudnia selekcję alertów, nie powinien jeszcze trafić na produkcyjną ścieżkę alertowania.
Ma to jeszcze większe znaczenie w środowiskach korporacyjnych, w których modele działają wewnątrz hurtowni lub lakehouse, aby uniknąć kopiowania wrażliwych danych do osobnych systemów. Wykonywanie w bazie danych może uprościć kontrolę prywatności i ograniczyć przenoszenie regulowanych rekordów, ale wywiera też na zespoły presję, by dobierały metryki, progi i procesy weryfikacji współpracujące z istniejącymi narzędziami obserwowalności. Sukces to nie tylko wychwytywanie anomalii. Sukces to wychwytywanie właściwych anomalii przy takiej liczbie alertów do weryfikacji, jaką organizacja jest w stanie obsłużyć na dłuższą metę.
Wdrożenie i monitorowanie w przedsiębiorstwie
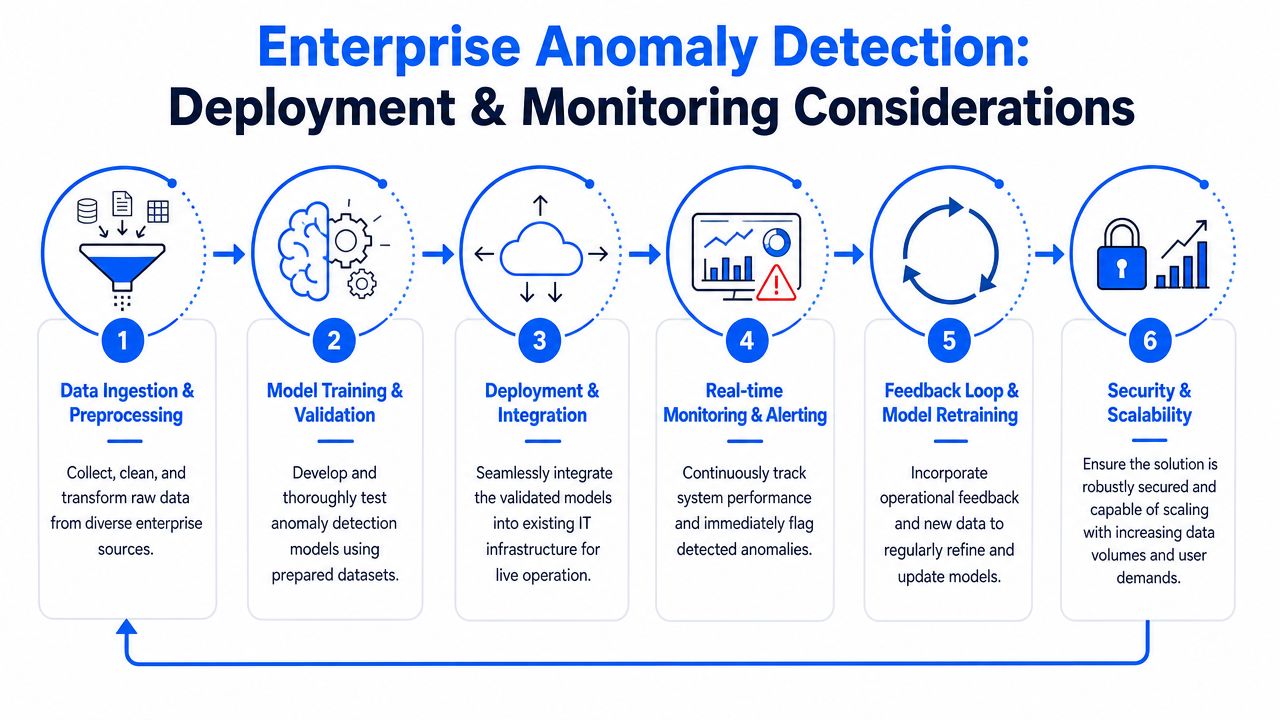
Większość publikacji o wykrywaniu anomalii z wykorzystaniem uczenia maszynowego kończy się na wyborze modelu. Zespoły w przedsiębiorstwach zwykle napotykają problemy później, podczas wdrożenia. Odkrywają, że model wymaga zbyt dużego przenoszenia danych, narusza oczekiwania dotyczące prywatności, zwiększa obciążenie operacyjne lub generuje progi, które z czasem tracą aktualność.
To nie są problemy marginalne. To właściwa praca wdrożeniowa.
Czas rzeczywisty czy przetwarzanie wsadowe
Nie każda anomalia wymaga natychmiastowej oceny. Niektóre procesy biznesowe tolerują wykrywanie wsadowe, w którym system analizuje okna godzinowe lub dzienne. Inne nie. Weryfikacja nadużyć, telemetria operacyjna, strumienie danych objęte SLA i dashboardy dla zarządu często wymagają znacznie krótszych pętli informacji zwrotnej.
Kompromis jest prosty:
Tryb wdrożenia | Sprawdza się, gdy | Kompromis |
|---|---|---|
Ocena w czasie rzeczywistym | Opóźnienie jest kosztowne lub wrażliwe pod względem ryzyka | Większa złożoność infrastruktury i eksploatacji |
Wykrywanie wsadowe | Trendy są ważniejsze niż natychmiastowa reakcja | Problemy mogą zostać wykryte już po wystąpieniu skutków w dalszej części procesu |
Zespoły często przeceniają swoją potrzebę działania w czasie rzeczywistym i nie doceniają kosztów jego utrzymania. Jeśli działanie biznesowe i tak następuje następnego ranka, ocena nocna może wystarczyć.
Wykonywanie w bazie danych zmienia rachunek ekonomiczny
W środowiskach korporacyjnych miejsce działania modelu może mieć równie duże znaczenie jak to, co model robi. Pobieranie danych produkcyjnych do zewnętrznego stosu monitorowania powoduje dodatkowe opóźnienia, przeglądy w zakresie ładu danych, koszty i ekspozycję danych. Powoduje też powielanie logiki w różnych systemach.
Przeprowadzanie analiz wewnątrz bazy danych lub hurtowni klienta rozwiązuje jednocześnie kilka praktycznych problemów:
Lepsza ochrona prywatności: Wrażliwe rekordy pozostają w kontrolowanym środowisku.
Wyższa wydajność: Mniej przenoszenia danych oznacza mniej wąskich gardeł.
Prostsza eksploatacja: Zespoły nie muszą eksportować dużych zbiorów metryk tylko po to, by ocenić je gdzie indziej.
Łatwiejszy ład danych: Zespoły ds. bezpieczeństwa i zgodności zwykle preferują architektury z mniejszą liczbą kopii danych.
To jeden z obszarów, w których architektura produktu ma znaczenie. Na przykład digna opiera się na obliczaniu metryk i uczeniu się punktów odniesienia wewnątrz bazy danych, działając w chmurze prywatnej lub środowiskach on-premises, co czyni ją istotną dla zespołów potrzebujących wykrywania anomalii, monitorowania terminowości, śledzenia schematów i walidacji bez dostępu dostawcy do produkcyjnych zbiorów danych.
Dynamiczne progi nie są opcjonalne
Statyczne progi zawodzą przy zmieniających się rozkładach. W skali przedsiębiorstwa problem staje się poważny, ponieważ każdy zbiór danych ewoluuje inaczej. Nowe rynki geograficzne, nowe kanały, nowe kalendarze biznesowe i zmieniające się wzorce użytkowania unieważniają ręcznie dostrajane limity.
Najnowsze prace podsumowane w tych badaniach nad dynamicznym progowaniem anomalii wskazują praktyczne rozwiązanie: systemy oparte na autoenkoderach w połączeniu z isolation forest mogą stosować progowanie uwzględniające wartości odstające, aby dynamicznie dostosowywać progi na podstawie wyuczonego normalnego zachowania. Ma to znaczenie, ponieważ ręczne dostrajanie progów nie skaluje się w dużych środowiskach obserwowalności.
Monitorowanie samego detektora
Detektor anomalii to kolejny system produkcyjny. Wymaga własnego monitorowania.
Obserwuj dryf danych wejściowych: Jeśli schematy lub rozkłady na wcześniejszych etapach się zmieniają, wyniki anomalii mogą stracić sens.
Śledź liczbę alertów: Nagłe wzrosty mogą wskazywać na rzeczywiste incydenty lub pogorszenie działania detektora.
Mierz wyniki weryfikacji: Jeśli analitycy wielokrotnie odrzucają alerty z jednego detektora, wytrenuj go ponownie lub go zastąp.
Starannie wersjonuj logikę modelu: Zmiany w inżynierii cech lub oknach czasowych mogą wpłynąć na zachowanie alertów w takim samym stopniu jak zmiana algorytmu.
Niemonitorowany detektor staje się kolejną cichą awarią, która tylko czeka, by się wydarzyć.
Obserwowalność to więcej niż anomalie
Najbardziej przydatne konfiguracje w przedsiębiorstwach nie traktują wykrywania anomalii jako samodzielnej funkcji. Łączą je z monitorowaniem terminowości, walidacją i monitorowaniem schematów. Anomalia wolumenu zyskuje kontekst, gdy ten sam system pokazuje również opóźnione ładowanie źródła lub zmianę typu kolumny. Analiza przyczyn źródłowych przebiega szybciej, ponieważ operatorzy nie muszą przeskakiwać między niepowiązanymi narzędziami.
To właśnie ta szersza perspektywa sprawia, że wykrywanie anomalii prowadzi do działań, a nie jest jedynie ciekawostką.
Dobre praktyki i typowe pułapki
Zespoły osiągają lepsze wyniki, gdy traktują wykrywanie anomalii z wykorzystaniem uczenia maszynowego jako dyscyplinę operacyjną, a nie eksperyment z modelami. Najlepsze wdrożenia są zwykle nudne we właściwy sposób: jasny cel, czyste dane wejściowe, zdefiniowana odpowiedzialność, mierzalna informacja zwrotna.
Dobre praktyki, które sprawdzają się na produkcji
Zacznij od konsekwencji biznesowych: Powiąż wykrywanie z rzeczywistą awarią, taką jak błędne prognozowanie, opóźnione raportowanie, weryfikacja nadużyć czy uszkodzone dane wejściowe modeli.
Sprofiluj dane przed wyborem modelu: W razie potrzeby stosuj skalowanie cech, obsługę brakujących wartości i odpowiednią inżynierię cech. Jak podsumowano w tym przeglądzie metod wykrywania anomalii i przetwarzania wstępnego, normalizacja, imputacja, inżynieria cech i dostrajanie hiperparametrów są kluczowymi elementami skutecznych procesów wykrywania anomalii.
Zacznij od prostych punktów odniesienia: Podstawowa metoda statystyczna lub oparta na drzewach pozwala sprawdzić, czy sygnał w ogóle istnieje, zanim zainwestujesz w cięższe architektury.
Określ odpowiedzialność za weryfikację alertów: Ktoś musi potwierdzić, czy oznaczona anomalia jest rzeczywista i czy ścieżka reakcji zadziałała.
Trenuj ponownie celowo: Punkty odniesienia się starzeją. Zaplanuj ponowne trenowanie i przegląd progów według jasnego harmonogramu powiązanego ze zmianami danych, a nie z pobożnymi życzeniami.
Pułapki, które generują szum i nieufność
Niektóre błędy powtarzają się regularnie.
Jeden algorytm wszędzie: Zdarzenia klientów, transakcje finansowe, strumienie z czujników i metryki jakości na poziomie tabel rzadko zachowują się tak samo.
Ignorowanie kontekstu: Skok bez informacji o czasie biznesowym, harmonogramie lub segmencie często prowadzi do fałszywych alarmów.
Pomijanie przetwarzania wstępnego: Metody oparte na odległości i gęstości szybko tracą skuteczność na nieskalowanych lub zanieczyszczonych danych wejściowych.
Traktowanie alertów jako ostatecznej prawdy: Wynik anomalii to narzędzie wspierające decyzje, a nie dowód wagi incydentu.
Zapominanie o odbiorcach w dalszej części procesu: Jeśli wyniki nie są zrozumiałe dla analityków, operatorów czy opiekunów danych, system nie wpłynie na decyzje.
Praktyczna lista kontrolna
Zanim wdrożysz detektor na produkcję, upewnij się, że na poniższe pytania istnieją jasne odpowiedzi:
Kontrola | Dlaczego to ważne |
|---|---|
Jakie działanie biznesowe następuje po alercie? | Wykrywanie bez reakcji generuje szum |
Jaki rodzaj anomalii chcemy wykrywać? | Przypadki punktowe, kontekstowe i zbiorowe wymagają różnej logiki |
Czy potrzebujemy wrażliwości lokalnej, czy globalnej? | To istotnie zmienia wybór algorytmu |
Jak będziemy oceniać jakość? | Precyzja, czułość i F1 są bardziej przydatne niż dokładność |
Gdzie będzie wykonywana ocena? | Architektura wdrożenia wpływa na prywatność, koszty i opóźnienia |
Kto weryfikuje i etykietuje przypadki brzegowe? | Informacja zwrotna sprawia, że system pozostaje przydatny w czasie |
Wykrywanie anomalii z wykorzystaniem uczenia maszynowego zyskuje zaufanie, gdy wcześnie wychwytuje problemy, wyjaśnia wystarczająco dużo, by umożliwić działanie, i pasuje do realiów operacji na danych w przedsiębiorstwie. Zwykle oznacza to mniej obsesji na punkcie nowinek modelowych, a więcej dyscypliny w zakresie architektury, pętli weryfikacji i integracji z obserwowalnością.
Jeśli Twój zespół potrzebuje wykrywania anomalii dopasowanego do ograniczeń przedsiębiorstwa, digna to jedna z opcji wartych rozważenia. Koncentruje się na anomaliach danych, walidacji, terminowości i śledzeniu schematów, z wykonywaniem w bazie danych w środowiskach kontrolowanych przez klienta, co jest przydatne, gdy prywatność, prostota operacyjna i integracja z obserwowalnością mają równie duże znaczenie jak sam model wykrywania.
Jeśli potrzebujesz wyuczonych punktów odniesienia dla wolumenów tabel, brakujących wartości i rozkładów wartości bez ręcznie dostrajanych progów, zobacz, jak digna Data Anomalies wykrywa anomalie wewnątrz Twojej bazy danych.
Najczęściej zadawane pytania
Czym jest wykrywanie anomalii z wykorzystaniem uczenia maszynowego?
Zastępuje ręcznie pisane reguły wyuczonymi punktami odniesienia: system modeluje oczekiwane zachowanie i sygnalizuje istotne odchylenia, wychwytując ciche błędy, takie jak zduplikowane rekordy, spóźnione znaczniki czasu czy dryfujące rozkłady. Artykuł przytacza badania, z których wynika, że metody ML przewyższają tradycyjne podejścia statystyczne o 8–12% pod względem dokładności, zwłaszcza w przypadku danych wielowymiarowych o dużej liczbie wymiarów.
Czym są anomalie punktowe, kontekstowe i zbiorowe?
Anomalie punktowe to pojedyncze wartości, które wyglądają nieprawidłowo, np. jedno ładowanie hurtowni z niemożliwą liczbą rekordów. Anomalie kontekstowe zależą od czasu lub okoliczności, np. duża liczba logowań o 3:00 w nocy. Anomalie zbiorowe to grupy pozornie nieszkodliwych rekordów tworzących zły wzorzec, np. skoordynowany atak botów lub dryf schematu obejmujący wiele pól.
Czy stosować nadzorowane, czy nienadzorowane wykrywanie anomalii?
Podejście nienadzorowane jest zwykle praktycznym wyborem domyślnym, ponieważ oznaczonych anomalii jest mało i są kosztowne. Metody nadzorowane sprawdzają się, gdy istnieją zweryfikowane incydenty, a rodzaje awarii się powtarzają, jak w przypadku wykrywania nadużyć czy weryfikacji roszczeń. Nienadzorowana konfiguracja k-średnich z k=2 w Netdata przyniosła 99% redukcji fałszywych alarmów dzięki wymogowi zgody kilku modeli.
Co jest lepsze do wykrywania anomalii: isolation forest czy k najbliższych sąsiadów?
To zależy od tego, czy anomalie są globalne, czy lokalne. Badania opublikowane w Journal of Machine Learning Research wykazały, że metoda k najbliższych sąsiadów przewyższa isolation forest, gdy dane zawierają wiele klastrów o różnej gęstości, natomiast isolation forest sprawdza się przy czysto globalnych wartościach odstających. Dane klientów pogrupowane według regionu lub kanału często wymagają lokalnego podejścia opartego na sąsiedztwie.
Jak mierzyć skuteczność detektora anomalii?
Pomiń dokładność, która na niezrównoważonych danych wygląda dobrze nawet wtedy, gdy model uznaje niemal wszystko za normalne. Stosuj precyzję, czułość i F1, a następnie testuj progi względem rzeczywistych możliwości weryfikacji: detektor, który zgłasza 600 rekordów, gdy tylko dwanaście wymaga działania, zawodzi, niezależnie od tego, jak dobrze wyglądał jego wynik offline.



