8 kluczowych wskaźników efektywności (KPI) dla Data Governance, które należy mierzyć w 2026 roku
|
8
min. czyt.

Większość programów governance nie kończy się niepowodzeniem dlatego, że nikt nie spisał zasad. Upadają, ponieważ zespoły nie potrafią udowodnić, że te zasady zmieniają to, co dzieje się na produkcji. Badanie 2025 enterprise governance benchmark wykazało, że 71% organizacji prowadzi formalny program Data Governance, co stanowi wzrost z poziomu 60% dwa lata wcześniej (2025 enterprise governance benchmark). Formalne wdrożenie rośnie, ale to samo badanie wskazało jakość danych jako główny problem biznesowy na poziomie 56%, a governance tuż za nim na poziomie 54%. Wniosek jest jasny: dokumentowanie własności i publikowanie standardów nie wystarczy. Liderzy potrzebują dowodów na to, że mechanizmy kontrolne działają, dane docierają niezawodnie, incydenty są opanowywane, a decyzje stają się bezpieczniejsze.
Poniższe osiem KPI dla Data Governance tworzy połączony system pomiarowy. Pokrycie pokazuje, gdzie governance istnieje, wdrażanie pokazuje, czy kontrole działają, jakość i Timeliness pokazują stan danych, a metryki incydentów, schematów i biznesowe pokazują, czy governance chroni decyzje. Każdy wskaźnik KPI zawiera logikę obliczeń, opcje wdrożenia i kompromisy.
Przed obliczeniem czegokolwiek zdefiniuj populację zasobów, właściciela, okno pomiarowe, poziom krytyczności, docelowy próg i oczekiwaną reakcję na alert. Wynik bez przypisanego właściciela to tylko raport. Wynik powiązany ze ścieżką naprawczą to kontrola.
Spis treści
1. Wskaźnik jakości danych
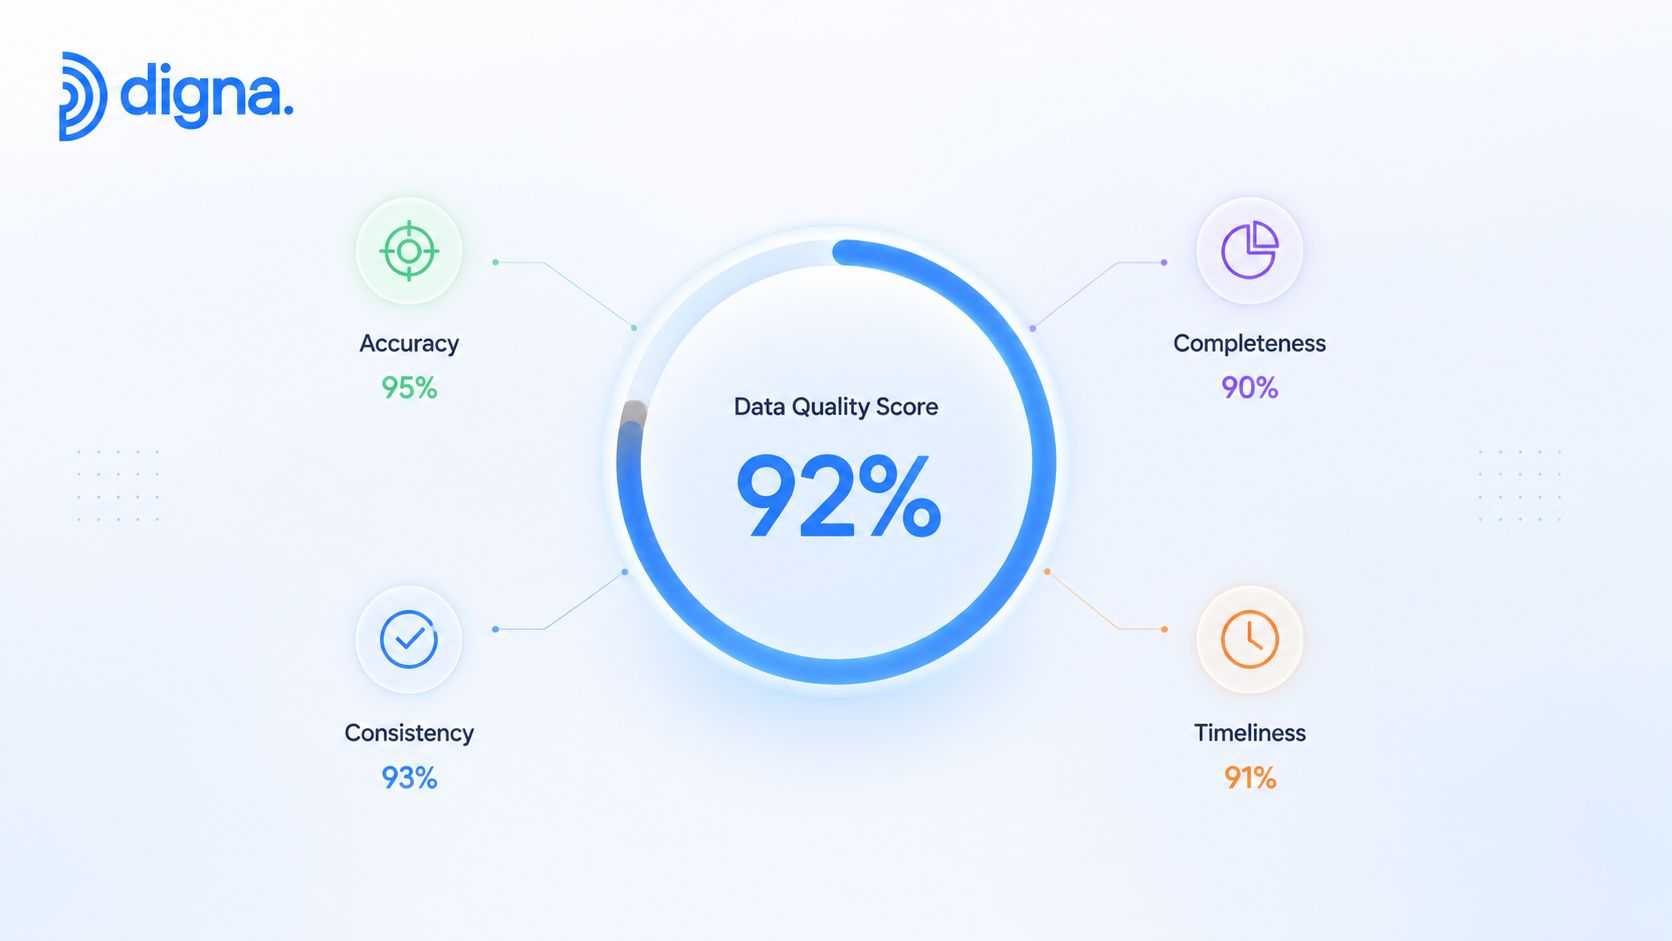
Wskaźnik Data Quality Score jest sygnałem o stanie danych w ośmioskładnikowym systemie pomiarowym KPI. Pokrycie pokazuje, gdzie governance istnieje, wdrażanie pokazuje, czy kontrole działają, podczas gdy ten wskaźnik pokazuje, czy krytyczne dane nadają się do raportowania, operacji, zgodności lub przepływów pracy AI. Typowe wymiary obejmują dokładność, kompletność, spójność, terminowość i unikalność. Zespoły mogą skorzystać ze wskazówek dotyczących metryk jakości danych, aby zdefiniować i połączyć te wymiary bez traktowania zbiorczego wyniku jako ostatecznej diagnozy.
Proste obliczenie to:
Wskaźnik jakości danych = suma wyników poszczególnych wymiarów pomnożona przez przypisane im wagi
Wagi powinny odpowiadać sposobowi wykorzystania każdego zbioru danych. Raport regulacyjny może przypisywać większą wagę poprawności i kompletności, podczas gdy operacyjny pulpit nawigacyjny działający w czasie zbliżonym do rzeczywistego może priorytetowo traktować świeżość. Wspólny wynik dla całego przedsiębiorstwa ułatwia porównania, ale wyniki specyficzne dla poszczególnych zbiorów danych zachowują kontekst niezbędny do zidentyfikowania właścicieli i działań naprawczych.
Buduj wskaźnik wokół kluczowych zasobów
Zacznij od zdefiniowanej grupy krytycznych zbiorów danych, zamiast oceniać cały obszar. Dla każdego zasobu udokumentuj mierzone wymiary, reguły walidacji, linię bazową anomalii, oczekiwania dotyczące terminowości, właściciela i ścieżkę eskalacji. Nadaj priorytet danym powiązanym z raportowaniem, zgodnością, operacjami klientów lub przepływami pracy AI, a następnie rozszerzaj pokrycie po ustabilizowaniu procesu pomiarowego.
Wskaźnik powinien ujawniać ryzyko operacyjne, a nie je ukrywać. Niższy wynik kompletności może wynikać z planowanej zmiany systemu źródłowego, awarii potoku danych pozbawionego właściciela lub powtarzającego się błędu na wcześniejszym etapie. Przyczyny te wymagają różnych reakcji, dlatego do widoku kadry zarządzającej należy dołączyć kontekst incydentu i wyniki na poziomie poszczególnych wymiarów.
Zasada praktyczna: Wynik złożony powinien wywołać dochodzenie, a nie je zastępować.
Wskazówki digna są istotne, gdy zespoły łączą wyniki walidacji, sygnały o anomaliach i obserwacje dotyczące terminowości, jednocześnie przechowując obliczenia we własnym środowisku. Wykonywanie obliczeń wewnątrz bazy danych może również zmniejszyć potrzebę przenoszenia wrażliwych danych poza zatwierdzoną infrastrukturę.
2. Wskaźnik pomyślności walidacji danych
Wskaźnik Data Validation Pass Rate pokazuje, czy reguły objęte governance działają na rzeczywistych rekordach. Mierzy on udział rekordów, które pomyślnie przeszły zdefiniowane kontrole biznesowe i strukturalne w określonym czasie, łącząc wymagania polityki z wydajnością kontroli.
Wskaźnik pomyślności walidacji = rekordy spełniające wszystkie obowiązujące kontrole podzielone przez łączną liczbę ocenionych rekordów, pomnożone przez 100
Obliczaj KPI na poziomie reguły, zbioru danych i domeny. Zagregowany wskaźnik wskazuje na ogólne wdrożenie, podczas gdy wyniki na poziomie reguł pozwalają zidentyfikować błędy dotyczące adresów, identyfikatorów, dat, powiązań finansowych lub innych pól. Ponieważ jeden rekord może nie przejść kilku kontroli, raportuj rekordy, których to dotyczy niezależnie od łącznej liczby błędów reguł. Rozróżnienie to zapobiega sytuacji, w której powtarzające się błędy w małej grupie rekordów zniekształcają obraz operacyjny.
Spraw, aby błędy były zrozumiałe
Nadaj priorytet regułom powiązanym z raportowaniem, zgodnością, danymi wejściowymi AI lub świadczeniem usług. Kontrole deterministyczne wspierają spójne porównania, ale zagregowane liczby nie są wystarczające. Przejrzyj próbki rekordów, które nie przeszły kontroli, i sklasyfikuj przyczynę, taką jak błąd konfiguracji na wcześniejszym etapie, zmiana definicji źródła lub proces dopuszczający nieprawidłowe wartości.
Tolerancja powinna zależeć od ryzyka związanego z danym przypadkiem użycia. Kontrole raportowania finansowego zazwyczaj wymagają rygorystycznych limitów niż analiza eksploracyjna. Walidację schematu można obliczyć jako rekordy pomyślnie przechodzące kontrole schematu podzielone przez łączną liczbę rekordów. Opublikowane benchmarki KPI dla Data Governance opisują cele powyżej 99,5% i traktują wyniki poniżej 98% jako ostrzeżenie, ale progi te wymagają dostosowania do krytyczności danych i zakresu reguł.
Oferowane przez digna reguły i kontrole walidacji danych wspierają testowanie na poziomie rekordów pod kątem logiki biznesowej i wymagań audytowych. Połącz wskaźnik pomyślności z własnością reguł, liczbą błędnych rekordów i czasem rozwiązania problemu. Wysoki wskaźnik bez przeglądu błędów może świadczyć o słabych kontrolach, a nie o dobrej kondycji danych.
3. Zgodność SLA w zakresie terminowości danych
Opóźnione dane mogą unieważnić skądinąd trafną decyzję. Data Timeliness SLA Compliance mierzy, czy oczekiwane dostawy docierają w uzgodnionym oknie czasowym, łącząc niezawodność potoku danych ze świeżością pulpitów nawigacyjnych, operacyjnymi przepływami pracy i opóźnieniem decyzji. Tworzy warstwę stanu systemu KPI: pokrycie pokazuje, gdzie governance istnieje, wdrażanie pokazuje, czy kontrole działają, a Timeliness pokazuje, czy kontrolowane dane są gotowe do użycia, gdy wymagają tego decyzje.
Zgodność SLA w zakresie terminowości = dostawy danych dostępne na czas podzielone przez całkowitą liczbę oczekiwanych dostaw, pomnożone przez 100
Oblicz licznik na podstawie oznaczonych czasem rekordów dostaw. Uwzględnij każdą oczekiwaną dostawę w mianowniku, w tym brakujące załadunki. Wykluczenie brakujących danych sprawia, że wydajność wydaje się wyższa właśnie wtedy, gdy potok danych zawodzi.
Ustaw zegar wokół potrzeb biznesowych
Ustaw SLA w oparciu o wymagania na dalszych etapach, a nie na podstawie bieżącej wydajności potoku danych. Wynik kliniczny potrzebny do wypisu pacjenta ma inną pilność niż miesięczny wyciąg planistyczny. Uwzględnij zamknięcie miesiąca, zamknięcie kwartału, dni świąteczne, okna konserwacyjne i inne zmienne kalendarzowe przed eskalacją opóźnienia.
Jeden z opublikowanych benchmarków zaleca co najmniej 98% terminowości dla krytycznych danych operacyjnych (definicja i formuła KPI terminowości). Inne źródło dotyczące governance umieszcza zgodność ze świeżością SLA powyżej 99%, a wyniki poniżej 95% traktuje jako ostrzeżenie. Liczby te są punktami odniesienia, a nie uniwersalnymi celami. Odpowiedni próg zależy od konsekwencji biznesowych, częstotliwości dostaw i kosztów opóźnienia danych.
Zastosowane przez digna podejście do monitorowania Timeliness danych wykorzystuje oczekiwane wzorce dostaw do identyfikacji opóźnień, brakujących załadunków i wczesnych dostaw. Powiąż niedotrzymanie umów SLA z czasem wykonania zadań, głębokością kolejki, dostępnością źródeł i zdarzeniami infrastrukturalnymi. Taka analiza pozwala odróżnić błąd potoku danych od ograniczeń środowiska operacyjnego, dając właścicielom wyraźniejszą ścieżkę naprawczą.
4. Wskaźnik wykrywania krytycznych incydentów danych
Program governance nie może ograniczyć incydentów, których nigdy nie wykryje. Wskaźnik wykrywania krytycznych incydentów danych mierzy, ile istotnych anomalii, błędów jakości i zmian schematu wykrywa monitoring w określonym oknie reakcji.
Podstawowy wzór to:
Wskaźnik wykrywania = krytyczne incydenty wykryte w oknie docelowym podzielone przez krytyczne incydenty zidentyfikowane na podstawie wszystkich dostępnych dowodów, pomnożone przez 100
Najtrudniejszą częścią jest mianownik. Zespoły mogą odkrywać incydenty poprzez monitoring, skargi użytkowników, błędne raporty, audyty lub uzgadnianie danych na dalszych etapach. Te kanały wykrywania powinny być ze sobą powiązane, aby KPI nie nagradzał systemu monitorowania za raportowanie wyłącznie własnych alertów.
Mierz sygnał, a nie liczbę alertów
Zacznij od zbiorów danych o wysokim wpływie i zdefiniuj, co kwalifikuje się jako krytyczne. Nagła zmiana rozkładu w zbiorze danych regulacyjnych może wymagać natychmiastowej eskalacji, podczas gdy sezonowe wahania w tabeli eksploracyjnej mogą tego nie wymagać. Śledź opóźnienie wykrywania, fałszywe alarmy i drogę od alertu do zgłoszenia. Wykrywanie bez dowodów reakcji to tylko częściowa ochrona.
Dostępne w digna funkcje wykrywania anomalii łączą naukę linii bazowej z walidacją i śledzeniem schematów. To połączenie ma znaczenie, ponieważ widoczny dla biznesu incydent może mieć swoje źródło w rozkładzie wartości, naruszeniu reguły lub zmianie struktury.
Zespół monitorujący powinien zadać sobie dwa pytania przy każdym incydencie: „Czy wykryliśmy go wystarczająco wcześnie?” oraz „Czy właściwy właściciel podjął działania?”
Regularnie analizuj wzorce fałszywych alarmów. Znane zdarzenia sezonowe, planowane migracje i powtarzające się zachowania procesów wsadowych powinny pomóc w dostrojeniu linii bazowej. Celem nie jest maksymalizacja liczby alertów. Jest nim wczesne wykrywanie istotnych awarii, aby zapobiegać uszkodzonym raportom, wadliwym modelom lub niewiarygodnym wynikom regulacyjnym.
5. Czas wykrywania i rozwiązywania zmian w schemacie
Zmiany w schemacie mogą powodować awarie, których zwykłe kontrole jakości nie wykryją. Usunięta kolumna lub niekompatybilny typ danych może zatrzymać potok danych, podczas gdy zmiana pola opcjonalnego może przejść dalej i zmienić logikę downstream bez natychmiastowego powiadomienia. Czas wykrywania i rozwiązywania zmian w schemacie mierzy czas, jaki upłynął od wykrycia zmiany strukturalnej do potwierdzenia jej dostosowania przez odbiorców końcowych.
Czas rozwiązania = znacznik czasu potwierdzenia dostosowania na dalszych etapach minus znacznik czasu wykrycia zmiany
Śledź średni, medianowy i najgorszy czas rozwiązania osobno. Średnia podsumowuje ogólną wydajność, mediana pokazuje typową prędkość działania, a wartość maksymalna ujawnia ryzyko eskalacji. Zatrzymaj zegar dopiero po potwierdzeniu dostosowania na dalszych etapach, a nie wtedy, gdy ktoś potwierdzi alert lub utworzy zgłoszenie.
Klasyfikuj zmiany, zanim się pojawią
Scenariusz procedur (runbook) powinien oddzielać pilne zmiany od tych nadających się do planowanego przeglądu. Usunięcie kolumny, niekompatybilne zmiany typów i zmieniona semantyka klucza zazwyczaj wymagają szybkiej eskalacji. Nowe opcjonalne kolumny mogą trafić do kolejki przeglądu, jeśli nie wpływają na umowy na dalszych etapach.
Własność i pochodzenie danych (lineage) skracają czas dochodzenia, ponieważ inżynierowie mogą zidentyfikować dotkniętych odbiorców bez odtwarzania zależności podczas incydentu. Rejestruj znaczenie kolumn, własność źródła, logikę transformacji i użycie na dalszych etapach. Koordynuj planowane zmiany z kontrolą wersji dla transformacji SQL, dbt i Python.
Oferowane przez digna wyjaśnienie zjawiska schema drift oraz wskazówki dotyczące monitorowania obejmują śledzenie dodanych lub usuniętych kolumn oraz modyfikacji typów danych. Wskaźnik KPI powinien zatem testować coś więcej niż tylko pokrycie wykrywania. Powinien pokazywać, czy każda istotna zmiana dotarła do właściwego właściciela i została bezpiecznie uwzględniona, łącząc wdrażanie zasad governance z niezawodnością potoku danych i ryzykiem decyzyjnym.

6. Efektywność wykrywania anomalii w biznesowych KPI
Techniczne wskaźniki jakości chronią decyzje tylko wtedy, gdy ujawniają, czy metryki biznesowe pozostają wiarygodne. Efektywność wykrywania anomalii w biznesowych KPI mierzy udział istotnych zmian w ważnych metrykach, które zostały wykryte, wyjaśnione i eskalowane w akceptowalnym czasie.
Efektywność = istotne zmiany biznesowe wykryte i prawidłowo eskalowane podzielone przez istotne zmiany potwierdzone w drodze przeglądu, pomnożone przez 100
Mianownik wymaga udokumentowanego procesu przeglądu. Sklasyfikuj każdy przeanalizowany alert jako rzeczywisty ruch biznesowy, problem z jakością danych, problem z potokiem danych lub fałszywy alarm. Etykiety te łączą wyniki biznesowe z podstawowymi metrykami jakości danych, dostarczając jednocześnie analitykom dowodów na potrzeby dostrajania progów i ograniczania niepotrzebnych dochodzeń.
Zdefiniuj „istotne” wraz z decydentami
Kadra kierownicza może traktować priorytetowo przychody, aktywność klientów, wolumen transakcji lub efektywność operacyjną. Zespoły ds. danych mogą monitorować tabele źródłowe i transformacje, które generują te miary. Kontrola jest skuteczna tylko wtedy, gdy oba widoki się łączą: alert powinien identyfikować metrykę, kontekst historyczny, powiązane zmiany danych i właściciela dochodzenia.
Funkcja Business Monitoring systemu digna wspiera analizę metryk biznesowych i operacyjnych. Moduł Data Analytics może pomóc zespołom zbadać historyczną zmienność i sezonowość przed ustawieniem poziomów czułości. Ma to znaczenie w przypadku metryk, na które wpływają wzorce kalendarzowe, cykle promocyjne lub terminy raportowania, gdzie stały próg może generować powtarzające się fałszywe alarmy.
Najlepszy alert o anomalii biznesowej pomaga decydentowi ustalić, czy zmienił się biznes, czy też zmieniły się dane.
Regularnie analizuj wyniki. Porównuj wyniki wykrywania i eskalacji według metryk, domen biznesowych i kategorii przyczyn. Spadek wyniku może wskazywać na słabe pokrycie monitoringiem, podczas gdy duża liczba alertów przy niewielu potwierdzonych anomaliach może wskazywać na źle dobrane progi. Powiązanie etykiet z incydentami źródłowymi, zdarzeniami schematów i błędami walidacji zmienia ten wskaźnik KPI z liczby alertów w dowód na to, że governance chroni decyzje operacyjne.
7. Wskaźnik adopcji i wdrażania polityki Data Governance
Udokumentowana polityka ma ograniczoną wartość, dopóki mechanizm kontrolny jej nie przetestuje, a ktoś nie zareaguje na wyjątki. Ten wskaźnik KPI mierzy, jak szeroko zatwierdzone zasady są wdrażane poprzez monitoring, walidację, kontrolę dostępu, kontrole terminowości, kontrole schematów lub inne mechanizmy.
Wskaźnik wdrażania = polityki z aktywnymi, przetestowanymi kontrolami podzielone przez całkowitą liczbę zdefiniowanych polityk, pomnożone przez 100
Zdefiniuj mianownik przed pomiarem postępów. Uwzględnij formalne standardy i udokumentowane zasady operacyjne, oddzielając jednocześnie zatwierdzone polityki od dążeń i aspiracji. W przeciwnym razie dodawanie nowych polityk może obniżyć wskaźnik, nawet jeśli pokrycie kontrolami rośnie.
Mierz dojrzałość automatyzacji
Badanie wykazało, że 61% organizacji miało wdrożone polityki, ale tylko 38% korzystało z automatycznego wdrażania (benchmark dojrzałości governance). Ta luka sprawia, że sama liczba polityk jest słabym dowodem. Polityka może istnieć w dokumencie bez kontroli systemowej, odpowiedzialnego właściciela lub wykonalnej ścieżki postępowania w przypadku wyjątków.
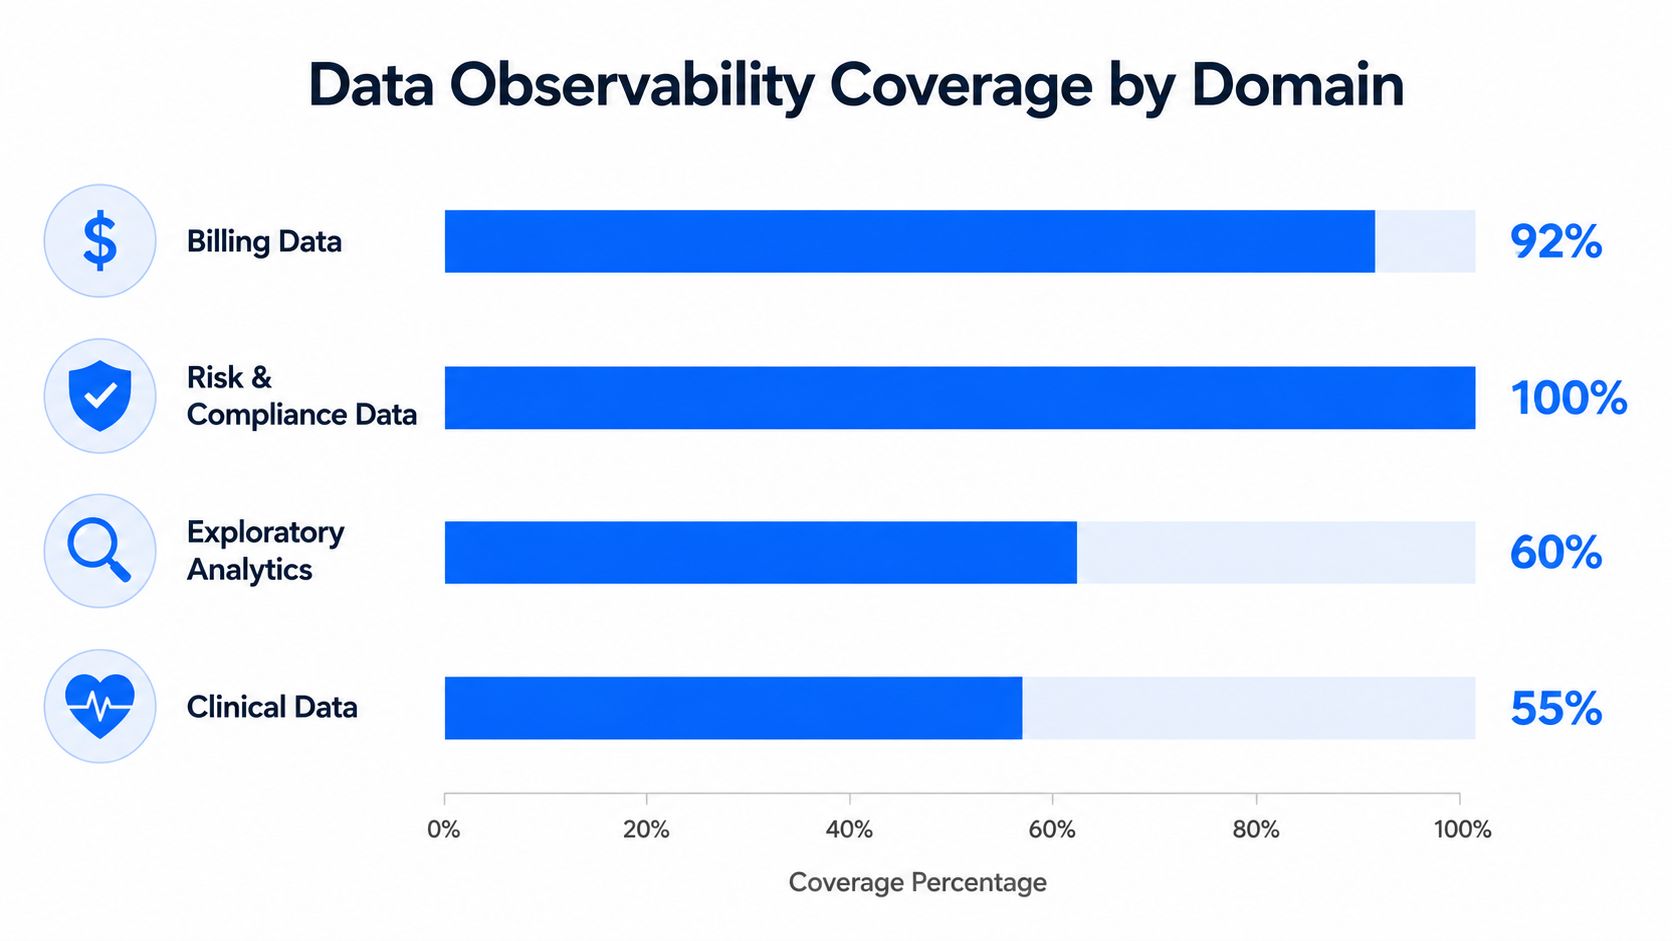
Przypisz każdą politykę do jej mechanizmu kontrolnego, zakresu zbioru danych, właściciela, częstotliwości testów, procesu obsługi wyjątków i lokalizacji dowodów. Raportuj wyniki według domen i poziomu ryzyka, a nie tylko jako średnią dla przedsiębiorstwa. Na przykład organizacja opieki zdrowotnej może zauważyć, że kontrole fakturowania działają automatycznie, podczas gdy kontrole kliniczne pozostają ręczne.
Monitorowanie terminowości dostarcza również dowodów na wdrożenie zasad. Śledzenie, czy dane spełniają uzgodnione poziomy usług, pomaga zweryfikować, czy polityka działa w środowisku produkcyjnym, a nie tylko istnieje w dokumentacji. Zobacz wskazówki dotyczące definicji, metryk i monitorowania Timeliness danych.
Adopcja obejmuje zachowanie po wykryciu problemu. Śledź potwierdzanie alertów, rozwiązywanie wyjątków i zgodność z przepływem pracy. Zautomatyzowana kontrola, której wyniki są rutynowo ignorowane, jest wdrożona tylko częściowo, dlatego połącz ten wskaźnik KPI z wynikami incydentów i miarami wpływu na biznes.
8. Pokrycie Observability i głębokość monitorowania danych
Pokrycie pokazuje, gdzie governance istnieje, podczas gdy głębokość monitorowania pokazuje, czy może ono chronić decyzje. Mierz udział krytycznych tabel, potoków danych i metryk biznesowych objętych aktywnym monitoringiem.
Pokrycie Observability = monitorowane krytyczne zasoby podzielone przez całkowitą liczbę krytycznych zasobów, pomnożone przez 100
Procent pokrycia może ukrywać słabą ochronę. Monitorowanie jednej tabeli pod kątem kompletności zapewnia mniejszą kontrolę niż monitorowanie innej pod kątem kompletności, terminowości, anomalii i zmian schematu. Raportuj zarówno udział monitorowanych zasobów, jak i liczbę oraz typ aktywnych kontroli na zasób.
Oddziel szerokość od ochrony
Stwórz inwentarz hurtowni danych, jeziora danych, potoków danych i metryk biznesowych. Sklasyfikuj każdy zasób pod kątem jego powiązania z decyzjami, obowiązkami regulacyjnymi, umowami SLA i ryzykiem operacyjnym. Nadaj priorytet lukom, w których awaria mogłaby zakłócić raportowanie, działania regulacyjne lub operacje.
Cele referencyjne dla dojrzałego programu mogą obejmować około 90% pokrycia katalogu i 95% pokrycia pochodzenia danych (lineage) lub polityk, przy 100% realizacji przeglądu dostępu. Liczby te pomagają w planowaniu, a nie definiują uniwersalne wymagania. Regulowany zbiór danych o ryzyku może uzasadniać pełny monitoring, podczas gdy zasób badawczy o niskim ryzyku może wymagać mniejszej głębokości.
Użyj historii incydentów, obowiązków regulacyjnych i priorytetów biznesowych, aby określić głębokość monitorowania. Wysoki wynik pokrycia przy powierzchownych kontrolach może budować złudne poczucie bezpieczeństwa, podczas gdy głębsze kontrole najważniejszych zasobów mogą skuteczniej ograniczać ryzyko decyzyjne niż jednolity monitoring.
Oferowane przez digna rozwiązanie Data Platform Observability monitoruje obciążenia danych, zużycie, dostępność, miary związane z wydajnością oraz zmiany. Jego model wykonywania obliczeń wewnątrz bazy danych pomaga zespołom rozszerzyć monitoring bez przenoszenia danych produkcyjnych poza ich środowisko.
Porównanie 8 punktów KPI Data Governance
Metryka | Złożoność wdrożenia 🔄 | Wymagania zasobowe ⚡ | Oczekiwane rezultaty 📊 | Idealne przypadki użycia 💡 | Główne zalety ⭐ |
|---|---|---|---|---|---|
Wskaźnik jakości danych | 🔄 Średnia, wymaga logiki ważenia i agregacji w różnych wymiarach | ⚡ Umiarkowane, reguły walidacji, wykrywanie anomalii, przechowywanie historii | 📊 Jednolity wskaźnik kondycji danych do analizy porównawczej i śledzenia trendów | 💡 Raportowanie dla kadry kierowniczej, śledzenie SLA, porównania między jednostkami | ⭐ Upraszcza raportowanie; ustala priorytety działań naprawczych |
Wskaźnik pomyślności walidacji danych | 🔄 Średnia, wymaga starannego zaprojektowania i dostrojenia reguł | ⚡ Wysokie, kontrole na poziomie rekordów i bieżące utrzymanie reguł | 📊 Precyzyjna metryka wdrożenia ze szczegółowymi raportami o błędach | 💡 Audyty zgodności, walidacja na wcześniejszych etapach, ukierunkowane poprawki | ⭐ Gotowe do audytu, dające podstawę do działania dowody błędów |
Zgodność SLA w zakresie terminowości danych | 🔄 Niska–Średnia, wymaga nauki linii bazowej i integracji z harmonogramem | ⚡ Umiarkowane, monitorowanie potoków i systemów alarmowych | 📊 % dostaw na czas; wczesne ostrzeganie o spóźnionych/brakujących załadunkach | 💡 Monitorowanie SLA potoków danych, świeżość pulpitów nawigacyjnych, operacyjne SLA | ⭐ Automatyzuje śledzenie SLA; mierzy niezawodność potoku danych |
Wskaźnik wykrywania krytycznych incydentów danych | 🔄 Wysoka, wyznaczanie linii bazowej AI + integracja z systemami incydentów | ⚡ Wysokie, ciągłe wykrywanie anomalii i alertowanie | 📊 Szybsze wykrywanie (niższe MTTD); ujawnia znane i nieznane problemy | 💡 Analityka produkcyjna, monitorowanie modeli, domeny danych wysokiego ryzyka | ⭐ Wczesne wykrywanie anomalii; ogranicza wpływ przestojów |
Czas wykrywania i rozwiązywania zmian w schemacie | 🔄 Niska–Średnia, ciągłe śledzenie + runbooki dla reakcji | ⚡ Niskie–Umiarkowane, narzędzia do monitorowania schematów i analizy wpływu | 📊 Metryka czasu do rozwiązania problemu; zapobiega cichym awariom na dalszych etapach | 💡 Środowiska z częstym dryftem schematu lub wieloma integracjami | ⭐ Natychmiastowe wykrywanie; widoczność wpływu i ścieżka audytu |
Efektywność wykrywania anomalii w biznesowych KPI | 🔄 Wysoka, wymaga dokładnych definicji KPI i ich dostrojenia | ⚡ Wysokie, linie bazowe AI, analiza wielowymiarowa, wskazówki dotyczące przyczyn źródłowych | 📊 % istotnych zmian biznesowych wykrytych i umieszczonych w kontekście | 💡 Pulpity nawigacyjne kadry zarządzającej, monitorowanie przychodów/wolumenu, alerty operacyjne | ⭐ Alerty skoncentrowane na biznesie z kontekstowymi wskazówkami o przyczynach |
Wskaźnik adopcji i wdrażania polityki | 🔄 Średnia, mapowanie polityk do monitorowania i przepływy pracy dla wyjątków | ⚡ Umiarkowane, zarządzanie politykami, logowanie audytów, zatwierdzenia | 📊 % wdrożonych polityk; wskaźnik dojrzałości governance | 💡 Programy governance, raportowanie zgodności, zarządzanie ryzykiem | ⭐ Pokazuje kontrolę operacyjną; nadaje priorytet lukom we wdrażaniu |
Pokrycie Observability & głębokość monitorowania | 🔄 Wysoka, zautomatyzowane wykrywanie i konfiguracja wielowarstwowego monitoringu | ⚡ Wysokie, inwentaryzacja, wyznaczanie linii bazowych, pulpity nawigacyjne w różnych warstwach | 📊 Wskaźnik pokrycia i metryki głębokości do identyfikacji martwych punktów | 💡 Duże platformy danych, planowanie dojrzałości observability | ⭐ Kwantyfikuje dojrzałość monitoringu; kieruje inwestycjami w pokrycie |
Zmień osiem metryk w rytm operacyjny Governance
Te osiem wskaźników KPI działa najlepiej jako spójny system, a nie zbiór niepowiązanych liczb. Pokrycie informuje o tym, czy krytyczne zasoby są widoczne. Wdrażanie polityk pokazuje, czy spisane standardy działają w rzeczywistych przepływach pracy. Jakość i walidacja pokazują, czy rekordy nadają się do użytku. Timeliness pokazuje, czy dane docierają wtedy, gdy wymagają tego decyzje. Wykrywanie incydentów i rozwiązywanie problemów ze schematami ujawniają, jak szybko organizacja reaguje na zmiany. Efektywność anomalii biznesowych łączy monitoring techniczny z efektami, którymi zarządza kadra kierownicza.
Zacznij od ustalenia linii bazowej dla krytycznych zasobów. Zapisz bieżące wymiary jakości, wyniki walidacji, wydajność dostaw, pokrycie monitoringu, kontrole polityk, ścieżki incydentów i wyniki alertów dotyczących metryk biznesowych. Unikaj zmiany celu podczas zmiany metody pomiaru. Trend jest użyteczny tylko wtedy, gdy populacja, formuła i okno obserwacji pozostają zrozumiałe.
Przypisz właściciela do każdego wskaźnika KPI i każdego krytycznego zasobu. Właściciel powinien mieć uprawnienia do badania spraw, zatwierdzania wyjątków, koordynowania działań naprawczych i potwierdzania zamknięcia problemów. Rozwiązuje to kluczowy problem governance zidentyfikowany w badaniu z 2025 r., w którym 47% respondentów wskazało niejasną własność i odpowiedzialność jako główną przeszkodę w skalowaniu governance (badanie data governance z 2025 r.). Pulpit nawigacyjny może ujawnić problem, ale tylko odpowiedzialni ludzie mogą go rozwiązać.
Ustaw progi na podstawie wpływu na biznes. Stosuj bardziej rygorystyczne kontrole w przypadku danych, które wspierają raportowanie regulacyjne, operacje pacjentów, ryzyko finansowe lub decyzje konsumenckie o wysokich konsekwencjach. Jako punkt odniesienia, opublikowane ramy obejmują cele takie jak co najmniej 90% pokrycia katalogu, co najmniej 95% pokrycia zasad, MTTR poniżej czterech godzin oraz 100% realizacji kwartalnych przeglądów dostępu (ramy metryk data governance). Potraktuj je jako dane wejściowe do projektu, a następnie zweryfikuj je pod kątem rzeczywistych potrzeb usług i możliwości reagowania.
Przeglądaj różne sygnały z różną częstotliwością. Inżynierowie i stewardzi danych potrzebują częstych widoków nieudanych walidacji, pominiętych dostaw, otwartych incydentów, fałszywych alarmów i zmian schematu. Liderzy governance potrzebują trendów w pokryciu, wdrażaniu, jakości i naprawianiu błędów. Kadra zarządzająca potrzebuje zwięzłego powiązania między kontrolą danych a wynikami biznesowymi. To rozróżnienie ma znaczenie, ponieważ 39% liderów danych zgłosiło trudności w wykazaniu wpływu governance na kierownictwo, podczas gdy 85% wyższej kadry kierowniczej ds. danych i analiz potraktowało priorytetowo ulepszenia governance w celu przygotowania się na AI (raport o stanie enterprise data governance z 2025 r.).
Żaden pojedynczy wskaźnik KPI nie dowodzi kondycji governance. Wysoki wskaźnik jakości może współistnieć z martwymi punktami. Szerokie pokrycie może współistnieć ze słabym wdrażaniem. Szybkie wykrywanie może współistnieć z powolnym usuwaniem problemów. Zbuduj kartę wyników tak, aby każda miara odpowiadała na inne pytanie operacyjne, i połącz każdy alert z dowodami własności, działania i potwierdzonego rozwiązania.
Rozwiązanie digna jest jedną z opcji dla zespołów, które potrzebują monitorowania w obszarach jakości, terminowości, anomalii, walidacji, zmian schematów, metryk biznesowych i platform observability. Jego modułowa platforma działa w środowisku klienta i obsługuje wykonywanie zadań wewnątrz bazy danych, dzięki czemu zespoły mogą zachować dane na miejscu, jednocześnie rozbudowując system pomiarowy governance.
Użyj digna do monitorowania krytycznych sygnałów jakości danych, terminowości, walidacji, anomalii, schematów i observability we własnym środowisku. Odwiedź digna, aby połączyć te kontrole z odpowiedzialnymi właścicielami, alertami operacyjnymi i dowodami na to, że governance działa na produkcji.
Najczęściej zadawane pytania
Co zdefiniować przed obliczeniem wskaźnika governance?
Sześć rzeczy: populację zasobów, właściciela, okno pomiaru, poziom krytyczności, próg docelowy i oczekiwaną reakcję na alert. Bez nich ta sama formuła daje inną liczbę przy każdym uruchomieniu.
Jak liczy się Data Quality Score?
Jako sumę ocen poszczególnych wymiarów pomnożonych przez przypisane wagi, przy czym wagi mają odpowiadać temu, jak faktycznie używa się danego zbioru. Zacznij od określonej grupy zbiorów krytycznych zamiast oceniać całe środowisko, aby ocena ujawniała ryzyko operacyjne, a nie je uśredniała.
Czy ocena złożona zastępuje dochodzenie?
Nie. Ocena złożona ma uruchamiać dochodzenie, a nie je zastępować. Jej zadaniem jest zasygnalizować, że coś poruszyło się w ważonym zbiorze wymiarów, a dopiero szczegół na poziomie wymiaru wskazuje, gdzie patrzeć.
Jak powszechne jest naprawdę formalne governance?
Benchmark governance w przedsiębiorstwach z 2025 r. wykazał, że 71 % organizacji prowadzi formalny program governance danych, wobec 60 % dwa lata wcześniej. Ten wzrost tłumaczy, dlaczego pomiar stał się trudniejszym pytaniem niż samo wdrożenie.
Po co mierzyć osiem wskaźników zamiast jednego?
Bo tworzą powiązany system pomiaru obejmujący jakość, Timeliness, pokrycie i kontrolę. Jedna nagłówkowa liczba nie odróżni luki w pokryciu od problemu ze stanem danych, a oba przypadki wymagają zupełnie innych reakcji.


