Utwórz zestaw danych
|
8
min. czyt.

Możesz wdrożyć zestaw danych, który w środowisku stagingowym wygląda na czysty i przechodzi każdy test jednostkowy, a mimo to dwa tygodnie później zepsuć biznes. Widziałem taką sytuację, gdy cicha normalizacja strefy czasowej zmieniła sumy przychodów w jednym z pulpitów nawigacyjnych, a zadanie marketingowe wciąż pobierało puste identyfikatory użytkowników, ponieważ na etapie budowy nic nie traktowało tego pola jako krytycznego. Najbardziej bolesne było to, że zespół uznał już ten zestaw danych za „gotowy”.
To błąd, którego większość poradników nie porusza. Praca nad Create data set nie jest kamieniem milowym dostawy, to pierwszy krok w ciągłym procesie kontroli, tak samo jak Narodowy Instytut Standardów i Technologii (NIST) przedstawia jakość danych jako zdolność kształtowaną przez dostępność, adekwatność, terminowość (Timeliness), metadane, dokumentację, możliwości użytkowników, kontekst i koszty, gdzie generowanie, ocena i ulepszanie tworzą cykl, a nie linię mety (artykuł perspektywiczny NIST). W środowisku produkcyjnym zestaw danych nie istnieje naprawdę, dopóki ktoś nie jest jego właścicielem, nie monitoruje go, nie wersjonuje i nie wie, co powinno się stać, gdy jego parametry zaczną dryfować.
Spis treści
Kiedy gotowy zestaw danych to dopiero początek
Zespół uważał, że zestaw danych o zdarzeniach klientów jest solidny. Zawierał typowane kolumny, czystą strukturę i zwykłe kontrole wartości null, więc opublikowali go i przeszli do kolejnych zadań. Dwa tygodnie później dział finansów zauważył rozbieżności w sumach przychodów, a marketing odkrył, że proces segmentacji zaakceptował rekordy z brakującymi identyfikatorami użytkowników.
Główna przyczyna nie była spektakularna. Reguła normalizacji strefy czasowej zmieniła się na wcześniejszym etapie, a nikt nie potraktował tego jako zmiany krytycznej, ponieważ schemat się nie zmienił. Jednocześnie zestaw danych dopuszczał wartości null w polu, które kolejni odbiorcy uznawali za obowiązkowe, więc błędne rekordy przechodziły dalej, aż segment kampanii wydał się większy niż powinien. To jest właśnie pułapka – zestaw danych może być poprawny syntaktycznie, a jednocześnie błędny operacyjnie.
Prawdziwym problemem była kontrola, a nie budowa
Produkcyjny zestaw danych potrzebuje czegoś więcej niż tylko udanego wdrożenia. Wymaga progów akceptacji, wykrywania dryfu, przypisania własności i ścieżki wycofania zmian, ponieważ definicja „dobrej jakości” zmienia się, gdy zaczynają od niej zależeć prawdziwi odbiorcy. Idea ta pokrywa się z korporacyjną rzeczywistością, w której niska jakość danych jest kosztowna, a tylko niewielka część danych firmy jest uznawana za spełniającą podstawowe standardy jakości w szeroko cytowanych badaniach branżowych (wykres firmy Gartner i powiązane podsumowanie).
Praktyczna zasada: jeśli podrzędny pulpit nawigacyjny, model lub przepływ pracy może ulec awarii w sposób niezauważalny, zestaw danych nie jest jeszcze gotowy.
Reszta pracy polega na zapobieganiu dokładnie takim awariom, które pojawiają się po wdrożeniu. Odpowiednie zabezpieczenie wykryłoby zmianę strefy czasowej. Inne oznaczyłoby flagą puste identyfikatory użytkowników, zanim zespół marketingowy zdążyłby na nich polegać. Pozostała część tego artykułu to podręcznik zapobiegania takim sytuacjom.
Projektowanie schematu przed napisaniem pojedynczego zapytania
Błędy w schemacie są kosztowne, ponieważ szybko się utrwalają. Gdy zespoły zaczną ładować i modelować dane wokół tabeli, zmiana poziomu szczegółowości lub ponowna interpretacja kolumny staje się projektem migracyjnym, a nie szybką poprawką kodu. Najbezpieczniejszym krokiem jest ustalenie struktury przed pierwszym pobraniem danych, a następnie udokumentowanie tych wyborów, aby nikt nie musiał później domyślać się intencji autorów.
Zacznij od ziarnistości, kluczy i semantyki czasu
Wybierz jawnie ziarnistość (grain). Jeśli jeden wiersz reprezentuje zdarzenie użytkownika, zapisz to w dokumentacji projektowej i w opisie tabeli, ponieważ ta decyzja wpływa na deduplikację, agregację i podrzędne złączenia. Używaj kluczy zastępczych tam, gdzie stabilne naturalne identyfikatory nie są gwarantowane, i ujednolić znaczniki czasu do formatu UTC z udokumentowanym przesunięciem źródłowym, aby późniejsi odbiorcy mogli odtworzyć czas lokalny bez zgadywania.
Nieuporządkowana tabela user_events zazwyczaj ujawnia swoje problemy w nazwach kolumn. Widać w niej mieszaną wielkość liter, niejednoznaczne wartości logiczne typu is_active, wartości event_type w formie wolnego tekstu, które dryfują w stronę niemal identycznych duplikatów, oraz znaczniki czasu, których znaczenie zmienia się w zależności od tego, kto je załadował. Zdyscyplinowana wersja wygląda wręcz nudno w najlepszym tego słowa znaczeniu – zawiera typy wyliczeniowe (enum) lub kontrolowane kategorie dla typów zdarzeń, flagi dopuszczające wartości null o jasnym znaczeniu oraz stabilne identyfikatory, które nie zależą od tego, co akurat aplikacja źródłowa wygenerowała w danym tygodniu.
Używaj nazw, które przetrwają rzeczywiste operacje
Nazewnictwo w hurtowniach danych i jeziorach danych powinno informować użytkowników, w którym miejscu potoku znajduje się dana tabela. Przedrostki takie jak raw_, stg_ oraz dim_ czynią to widocznym, co ma kluczowe znaczenie, gdy ktoś próbuje zrozumieć, czy tabela jest gotowa do pobrania, transformacji czy do bezpośredniego użycia. Jeśli potrzebujesz głębszej taksonomii opcji strukturalnych, przydatnym punktem odniesienia jest wewnętrzny przewodnik po typach schematów.
Udokumentuj każdą kolumnę, zanim trafi do niej pierwszy wiersz. Plik schema.yml lub komentarze w information_schema zmuszają zespół do określenia typu, znaczenia, dozwolonych wartości i własności, dopóki projekt jest jeszcze łatwy do zmodyfikowania.
Obszar decyzyjny | Antywzorzec | Gotowe do produkcji |
|---|---|---|
Ziarnistość | Niejawna, wnioskowana później | Jawnie zadeklarowana przed budową |
Główny identyfikator | Złożony klucz naturalny z niestabilnych źródeł | Klucz zastępczy lub stabilny, trwały identyfikator |
Znaczniki czasu | Mieszane czasy lokalne, brak informacji o przesunięciu | UTC z udokumentowanym przesunięciem źródłowym |
Wartości logiczne |
| Flaga dopuszczająca wartości null z opisaną semantyką |
Typy zdarzeń | Ciągi tekstowe wpisywane ręcznie | Kontrolowane kategorie lub wartości typu enum |
Dokumentacja | Dodawana po wdrożeniu | Tworzona przed pierwszym załadowaniem |
Pozyskiwanie danych bez utraty pochodzenia
Źródło ma takie samo znaczenie jak struktura. Pobieranie danych przez wsadowe API, przesyłanie plików, CDC oraz dane syntetyczne – każde z nich rozwiązuje inny problem i ulega awarii w inny sposób. Wybór niewłaściwego schematu źródłowego sprawi, że spędzisz miesiące na rekompensowaniu braku informacji o pochodzeniu zamiast na ulepszaniu zestawu danych.
Dopasuj metodę pobierania do przypadku użycia
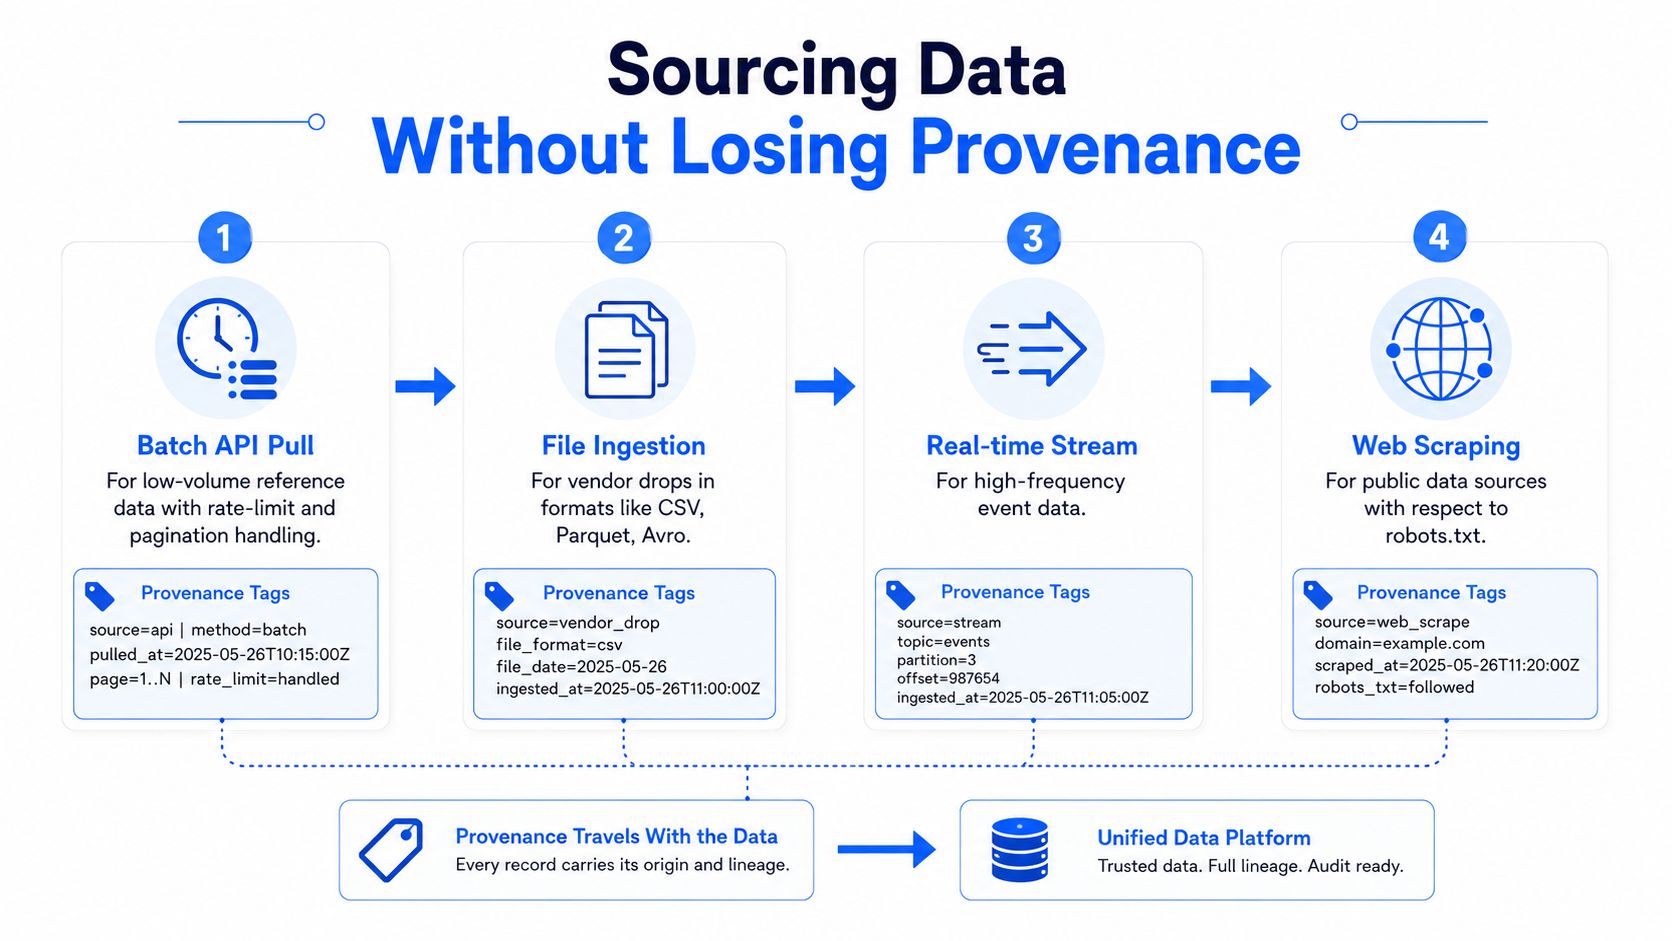
Używaj wsadowego pobierania przez API dla danych referencyjnych o małej objętości, gdzie głównymi ograniczeniami są stronicowanie i limity zapytań. Używaj pozyskiwania plików w przypadku dostaw od zewnętrznych dostawców w formatach CSV, Parquet lub Avro, gdy najważniejsze są kontrakty schematów, ponieważ pliki ułatwiają wersjonowanie i odtwarzanie danych. Używaj rejestrowania zmian danych (CDC), gdy potrzebujesz ładowania danych w czasie zbliżonym do rzeczywistego z operacyjnych baz danych do hurtowni, a danych syntetycznych używaj do testowania potoków, zanim pojawią się produkcyjne źródła danych.
Kluczowym elementem jest pochodzenie danych (provenance). Rejestruj parametry source_system, source_loaded_at, source_record_hash oraz ingestion_run_id na etapie odczytu, a nie później na poziomie warstwy transformacji. Pochodzenie danych dodane na dalszych etapach jest zawsze próbą rekonstrukcji, a rekonstrukcja to moment, w którym zespoły zaczynają zakładać pewność, której nigdy nie miały.
Zapisuj pochodzenie danych w punkcie odczytu. Każda inna metoda staje się zgadywaniem pod presją czasu.
W przypadku publicznych źródeł internetowych lub procesów scrapingu obowiązuje ta sama zasada – metodę pobierania należy wybrać dopiero po sprawdzeniu ograniczeń i możliwych błędów po stronie źródła. Praktyczny poradnik o tym, na co zwracać uwagę w interfejsach API, przypomina, że dostępność, stronicowanie i zachowanie kontraktu kształtują zestaw danych w równym stopniu, co same wiersze. Jeśli chcesz poznać koncepcyjną różnicę między pochodzeniem danych a historią ich przepływu, warto zapoznać się z wewnętrznym wyjaśnieniem dotyczącym data provenance vs data lineage.
Wersjonuj kontrakt, a nie tylko dane
Zewnętrzne interfejsy API i strumienie danych od dostawców powinny być traktowane jak zależności. Przypisz na stałe wersję kontraktu, udokumentuj, które pola są wymagane, i spraw, aby każda zmiana schematu była widoczna jako żądanie zmiany kodu (pull request), a nie cicha awaria. Dzięki temu, gdy dostawca zmieni nazwę lub typ pola, zespół zauważy różnicę, zanim potok przetworzy te dane.
Weryfikacje kontrolne, które wyłapują rzeczywiste problemy
Zestaw danych może wydawać się kompletny, a i tak ulec awarii w momencie, gdy ktoś go użyje. Kontrole wartości null wykrywają tylko jedną klasę problemów. Uszkodzone powiązania, wartości spoza zakresu, opóźnione wiersze i niespójne klucze mogą sprawić, że tabela będzie technicznie zapełniona, ale bezużyteczna operacyjnie.
Waliduj na poziomie rekordów najpierw
Zacznij od kontroli, które chronią założenia kolejnych etapów przetwarzania. Stosuj sprawdzenie unikalności na naturalnych identyfikatorach, gdzie duplikaty mogłyby doprowadzić do podwójnego zliczenia rekordów, kontroluj integralność referencyjną między kluczami wymiarów i faktów, zatwierdzone listy wartości dla pól kategorialnych oraz reguły precyzji dla kolumn finansowych. Jeśli pole przychodów musi zawsze zawierać dwa miejsca po przecinku, zapisz to w regule, zamiast ufać, że każdy system źródłowy się do tego dostosuje.
Pomocne są tutaj zestawy dozwolonych wartości wielokrotnego użytku, zwłaszcza w przypadku krajów, województw i kodów statusu. Jeśli budujesz bibliotekę reguł, moduł Data Validation w narzędziu digna opiera się na tym schemacie, oferując kontrole dostosowane do tabeli lub do przefiltrowanego podzbioru danych, zależnie od potrzeb. Kluczem nie jest samo narzędzie, ale uczynienie powszechnych reguł jawnymi, zamiast ukrywania ich w jednorazowych skryptach.
Elementem, którego nie można pominąć, jest pochodzenie danych. Rejestruj source_system, source_loaded_at, source_record_hash oraz ingestion_run_id na etapie odczytu, a nie później na poziomie warstwy transformacji. Jeśli te pola zostaną dodane po pozyskaniu danych, przestają być faktami, a stają się domysłami tworzonymi pod presją.
Dodaj kontrole dystrybucji i terminowości (Timeliness)
Gdy reguły na poziomie wierszy będą już stabilne, obserwuj tabelę jako całość. Liczba wierszy, która zbytnio odbiega od ostatniej linii bazowej, wskaźniki wartości null rosnące w kluczowych polach oraz dryf kardynalności kategorii – wszystko to wskazuje na problemy, których pojedyncza reguła dla wiersza nie wykryje. W przypadku terminowości (Timeliness) ustal jasny cel poziomu usług powiązany z przeznaczeniem tabeli, np. krótkie okno opóźnienia dla strumieni w czasie zbliżonym do rzeczywistego i dłuższe dla procesów wsadowych.
Najtrudniejsza część to dostrajanie. Linie bazowe anomalii potrzebują okresu próbnego, zanim zaczną mieć jakiekolwiek znaczenie, ponieważ zupełnie nowy zestaw danych nie ma jeszcze stabilnej struktury. Oddziel krytyczne błędy od łagodnych ostrzeżeń, kieruj ostrzeżenia do weryfikacji i upewnij się, że każda kontrola ma przypisanego właściciela, procedurę postępowania oraz ścieżkę obejścia. Kontrole bez przypisanego właściciela z czasem stają się szumem, a ignorowane ostrzeżenia przestają być w ogóle czytane.
Traktuj progi akceptacji jako decyzję z zakresu governance, a nie jako szczegół techniczny. Jeśli dany strumień danych może tolerować niewielką ilość brakujących danych opcjonalnych, ale nie może tolerować uszkodzonych kluczy, określ to wyraźnie w regułach kontrolnych i w procesie zatwierdzania. Dzięki temu zespół uniknie sporów o każdy alert, traktując wszystkie awarie z taką samą powagą.
Warstwa walidacji | Przykładowa kontrola | Sugerowany próg | Właściciel i ścieżka eskalacji |
|---|---|---|---|
Integralność rekordu | Unikalność klucza naturalnego | Duplikaty niedozwolone | Inżynieria danych, alert w przypadku naruszenia |
Integralność relacji | Klucze faktów pasują do kluczy wymiarów | Brak osieroconych wierszy | Właściciel potoku, kwarantanna błędnej partii |
Obszar wartości | Kraj, status lub lista typu enum | Tylko zatwierdzone wartości | Właściciel obszaru biznesowego, kolejka weryfikacji |
Precyzja liczbowa | Skala wartości pieniężnych | Wymagana precyzja dziesiętna | Analityk danych, blokada publikacji |
Trend wolumenu | Dryf liczby wierszy | W granicach normalnej linii bazowej | Dyżurny inżynier danych, analiza problemu |
Stabilność wartości null | Wskaźnik null w kluczowych kolumnach | Niski i stabilny dla danej tabeli | Właściciel zestawu danych, najpierw łagodny alert |
Terminowość (Timeliness) | Opóźnienie między zdarzeniem a załadowaniem | Zgodność z umową SLA dla strumienia | Właściciel platformy, alert w przypadku opóźnienia |
Aby uzyskać dokładniejszy obraz tego, jak poszczególne kontrole łączą się ze sobą w cyklu życia zestawu danych, zobacz data validation rules, checks, and continuous data quality.
Partycjonowanie, wersjonowanie i dryf schematu
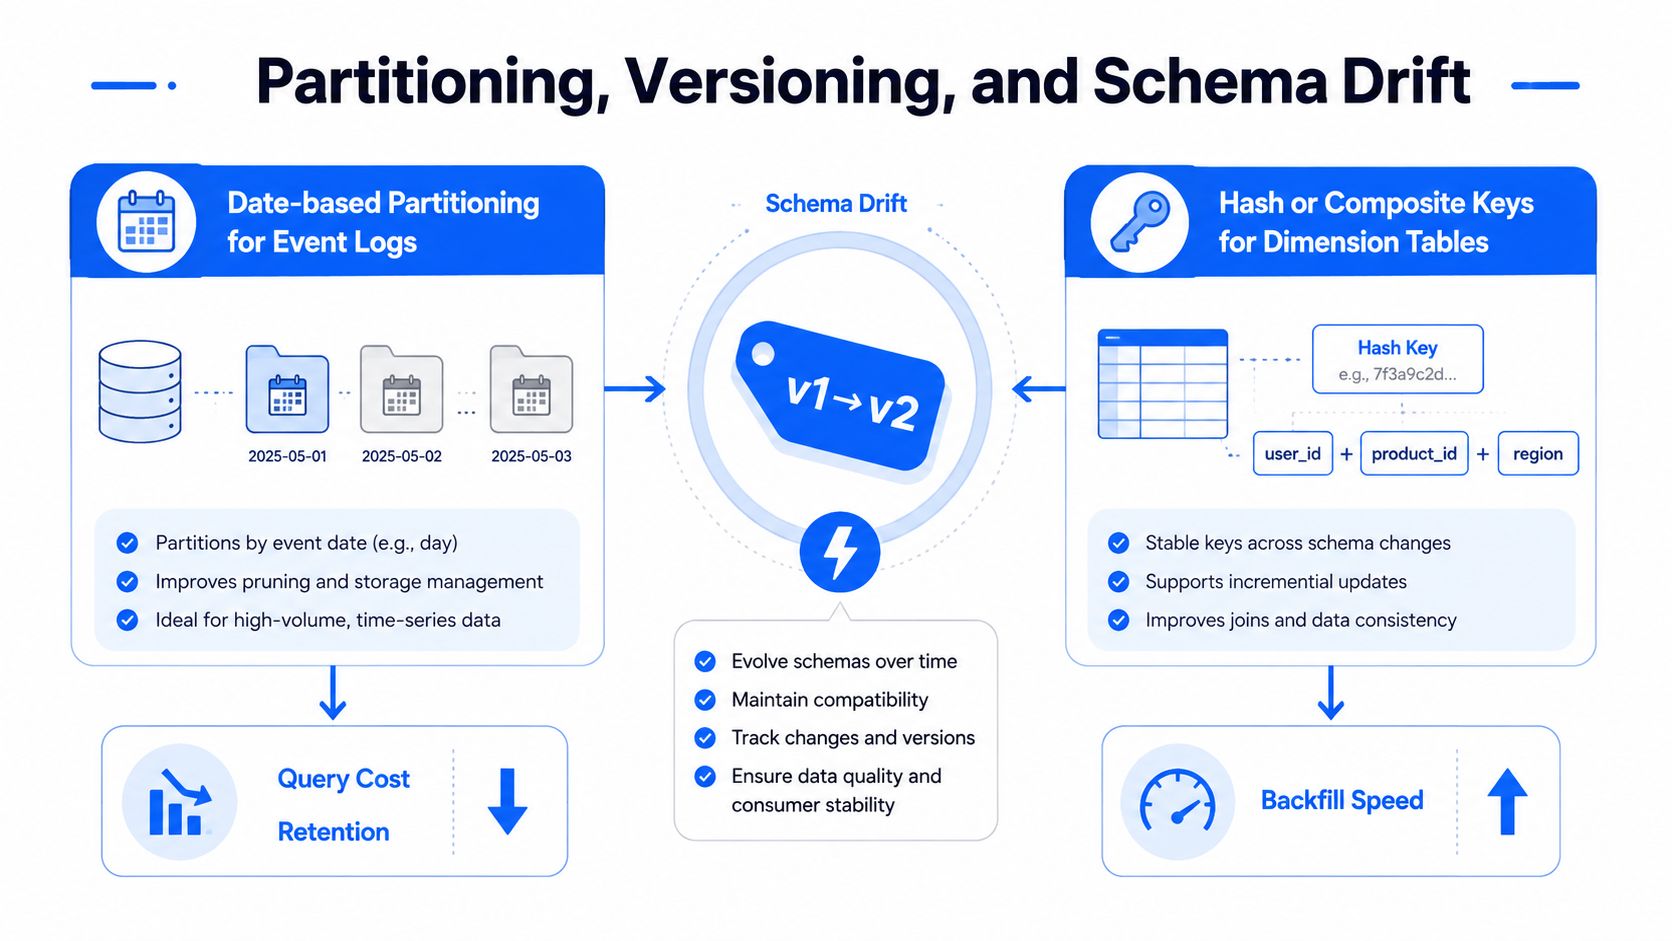
Partycjonowanie decyduje o czymś więcej niż tylko o układzie przechowywania danych. Wpływa na koszt zapytań, szybkość uzupełniania danych wstecznych (backfill) oraz łatwość egzekwowania reguł przechowywania danych. Zespoły często wybierają schemat partycjonowania, aby przyspieszyć działanie jednego pulpitu nawigacyjnego, a później odkrywają, że komplikuje to ponowne przetwarzanie lub ukrywa dane historyczne, które wciąż są potrzebne.
Wybierz układ na podstawie sposobu użycia tabeli
Używaj partycjonowania opartego na datach w przypadku logów zdarzeń i tabel faktów, do których dane są głównie dopisywane. Daje to jasną jednostkę dla retencji danych, przyrostowych aktualizacji oraz zapytań ograniczonych czasowo. W przypadku migawek wymiarów lub wolno zmieniających się struktur, klucze skrótu (hash) lub klucze złożone mogą sprawić, że wyszukiwanie i przebudowa tabel będą bardziej przewidywalne, zwłaszcza gdy tabela nie jest naturalnie uporządkowana według czasu. W systemach takich jak BigQuery, Snowflake i Apache Iceberg dokładna składnia się różni, ale zasada operacyjna pozostaje taka sama.
Traktuj zestaw danych jako wersjonowany od pierwszego dnia. Wersjonowanie semantyczne w metadanych, niezmienne tagi dla każdego wydania (Release) oraz okres przejściowy dla dotychczasowych odbiorców zapobiegają sytuacji, w której zespół udaje, że każde wydanie (Release) jest identyczne. Gdy zmienia się wersja, stara powinna pozostać dostępna, dopóki użytkownicy nie przejdą migracji, ponieważ najgorszy moment na usunięcie tabeli to ten, w którym jakiś raport jest wciąż do niej przypięty.
Make drift a pipeline failure, not a surprise
Dryf schematu to cichy zabójca. Pojawiają się nowe kolumny, znikają kolumny wymagane, a typy danych ulegają zwężeniu w stopniu wystarczającym, by zepsuć podrzędne złączenie lub rzutowanie typów. Najczystszym wzorcem jest elastyczne pozyskiwanie danych w strefie lądowania (landing zone), a następnie profilowanie, rygorystyczna walidacja (Data Validation) na kolejnej granicy oraz testy stagingowe, które zatrzymają potok, jeśli schemat zmienił się w niekompatybilny sposób.
Ta logika powinna znajdować się w kodzie, a nie w komentarzu do przeglądu skryptu. Jeśli warstwa transformacji wykryje różnicę w schemacie, może zatrzymać wdrożenie, zanim użytkownicy zostaną zaskoczeni awarią. Wersjonowana dokumentacja i dziennik zmian zamykają ten proces, informując kolejnego analityka, dlaczego obecna tabela wygląda tak, a nie inaczej.
Praktyczny przewodnik po kontroli wersji dla zespołów ds. zgodności (Compliance) od DPP Grid jest tutaj pomocny, ponieważ przedstawia wersjonowanie jako problem z zakresu governance, a nie tylko nawyk związany z zapisywaniem danych. Jeśli już borykasz się z dryfem schematu w środowisku produkcyjnym, wewnętrzne wyjaśnienie na temat schema drift and structural changes that break data pipelines pomoże Ci zrozumieć te mechanizmy awarii.
Zarządzanie (governance) i wykrywalność od pierwszego dnia
Zarządzanie (governance) jest zazwyczaj traktowane jako etap weryfikacji na samym końcu, ale w rzeczywistości jest to problem związany z łatwością wyszukiwania informacji oraz kwestiami zgodności (Compliance). Jeśli użytkownicy nie potrafią określić, do czego służy dany zestaw danych, kto jest jego właścicielem i jakie dane zawiera, będą go używać nieprawidłowo lub unikać go całkowicie. Oba te scenariusze są kosztowne.
Napisz minimalne metadane przed publikacją
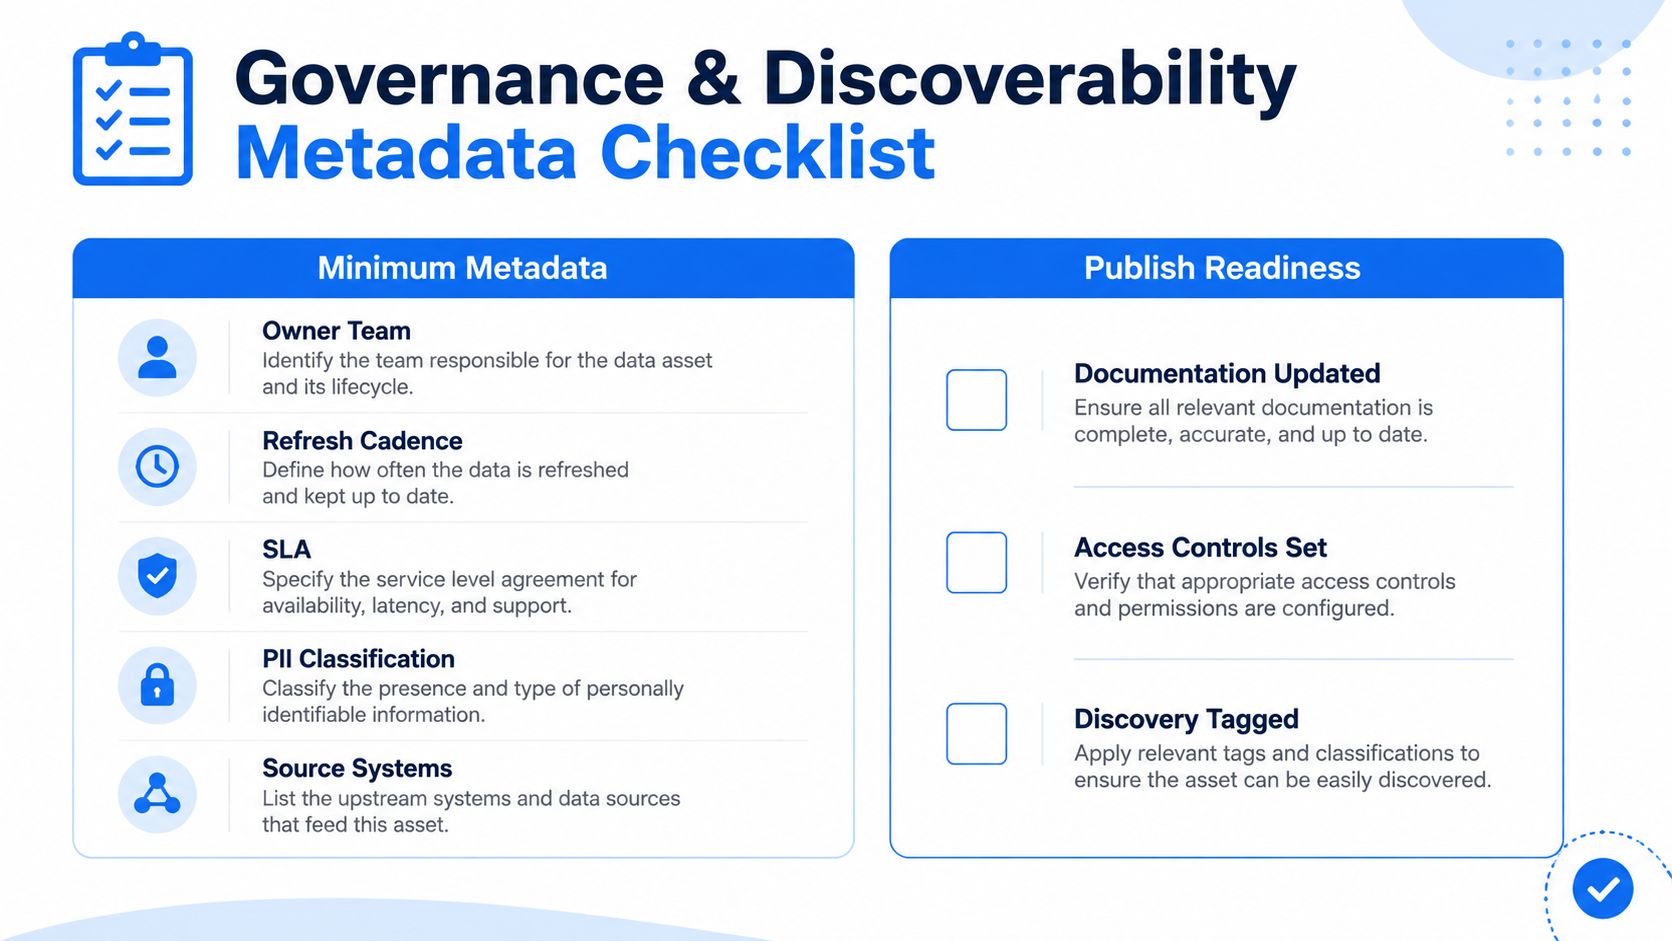
Każdy zestaw danych powinien zostać wdrożony z określeniem zespołu właścicielskiego, częstotliwości odświeżania, umowy SLA, klasyfikacji danych osobowych (PII), systemów źródłowych oraz krótkiego opisu planowanego zastosowania, który określa również, do czego ten zestaw danych się nie nadaje. Te sześć pól brzmi bardzo prosto, ponieważ takie są – i to właśnie ta prostota pozwala na bezproblemowe korzystanie z tabeli podczas audytów, przekazywania zadań oraz pojawiania się nowych użytkowników.
Powiąż uprawnienia dostępu z klasyfikacją danych. Maskuj zastrzeżone dane osobowe (PII), stosuj reguły dostępu na poziomie wierszy tam, gdzie znaczenie mają przepisy regionalne, i oddzielaj role produkcyjne od testowych (sandbox), aby dostęp badawczy nie wpływał na operacyjne wykorzystanie danych. Jeśli zestaw danych zawiera dane osobowe, zachowaj informację o ścieżce zgody użytkownika, łącząc ją z podstawą prawną i harmonogramem retencji, który ją reguluje.
Katalog danych to miejsce, w którym wszystkie te informacje stają się widoczne. Wewnętrzne omówienie tematu what is a data catalog przypomina, że wyszukiwanie danych działa tylko wtedy, gdy metadane i polityka dostępu są ze sobą spójne.
Uczyń ponowne użycie bezpiecznym, a nie przypadkowym
Zestaw danych, który łatwo znaleźć, ale trudno mu zaufać, generuje więcej pracy, a nie mniej. Celem jest sprawienie, aby krok publikacji był uznawany za kompletny tylko wtedy, gdy zestaw danych jest otagowany, udokumentowany i zmapowany w systemie zarządzania dostępem. Dzięki temu klasyfikacja nie rozjedzie się z uprawnieniami wraz z upływem czasu.
Jeśli wpis w katalogu jest niejasny, zestaw danych zostanie wykorzystany w nieprawidłowy sposób.
Właśnie dlatego praktyczna lista kontrolna jest krótka: właściciel, klasyfikacja, SLA, przeznaczenie, odświeżanie i kontakt. Uzupełnij te informacje w momencie tworzenia, a zaoszczędzisz tygodnie późniejszych dyskusji podczas audytów.
Jak ocenić, kiedy zestaw danych jest wystarczająco dobry
„Wystarczająco dobry” to nie kwestia wyczucia, to kontrakt. Błędem jest czekanie na idealne pokrycie danych przed wdrożeniem zestawu na produkcję, ponieważ taki odruch zazwyczaj prowadzi do niekończących się opóźnień. Lepiej określić warunki przejścia, a następnie pozwolić, aby dane same potwierdziły swoją wartość.
Używaj bramek akceptacyjnych powiązanych z decyzją
Użyteczną pierwszą bramką jest kompletność. Jeśli wymagane pole ma wysoki odsetek wartości null, zestaw danych nie nadaje się do podjęcia decyzji, którą miał wspierać. Drugą bramką jest aktualność, ponieważ nieaktualne dane mogą być czyste, ale wciąż bezużyteczne w celach operacyjnych. Trzecią bramką jest reprezentatywność, która sprawdza, czy kluczowe segmenty nie są zbyt zniekształcone, co mogłoby wpłynąć negatywnie na podrzędny model lub raport.
Kontrole pod kątem błędów systematycznych (bias checks) powinny znaleźć się w tej trzeciej bramce. Szukaj nierównowagi klas, luk geograficznych, luk demograficznych oraz błędów przeżywalności (survivorship bias) w połączonych źródłach, a następnie zdecyduj, co zrobić z wynikiem. Niektóre zestawy danych należy zaakceptować w stanie, w jakim się znajdują, inne należy nadpróbkować lub uzupełnić, z niektórych należy wykluczyć określone zastosowania, a jeszcze inne należy udokumentować jako celowo częściowe.
Bramka akceptacyjna | Metryka | Przykładowy próg | Decyzja w przypadku niepowodzenia |
|---|---|---|---|
Kompletność | Wskaźnik wartości null w wymaganych polach | Wystarczająco niski dla danego przypadku użycia | Zablokowanie publikacji lub uzupełnienie danych (backfill) |
Aktualność | Czas opóźnienia w stosunku do potrzeb decyzyjnych | W granicach dozwolonego okna czasowego | Wstrzymanie do czasu aktualizacji |
Reprezentatywność | Pokrycie segmentów w kluczowych grupach | Brak krytycznych zniekształceń | Nadpróbkowanie, wykluczenie lub dokumentacja |
Stabilność | Powtarzalne wyniki jakości w czasie | Pozytywne testy w wielu cyklach | Utrzymanie w trybie testowym (shadow mode) |
Promuj etapami, a nie jednym skokiem
Najbardziej bezproblemowe wdrożenie odbywa się stopniowo. Najpierw zaimplementuj metryki jakości, następnie porównaj je z zestawem kontrolnym i ustaw nowy zestaw danych jako domyślny dopiero wtedy, gdy sprawdzi się on w kilku kolejnych cyklach. To pozwala zespołowi uczciwie ocenić, czy dane są naprawdę gotowe, czy po prostu zostały niedawno wygenerowane.
„Wystarczająco dobry” oznacza, że zestaw danych pozwala na podjęcie decyzji bez zmuszania do szukania ukrytych rozwiązań zastępczych w innych miejscach.
Rozmowa o procesie tworzenia zestawu danych (create-data-set) tak naprawdę dotyczy kontroli, a nie samego gromadzenia danych. Jeśli szukasz platformy, która monitoruje walidację (Data Validation), terminowość (Timeliness), zmiany schematu i anomalie w Twoim środowisku, digna robi to na poziomie hurtowni danych i potoków przetwarzania bez konieczności przenoszenia danych poza ich miejsce przechowywania. Odwiedź digna, aby zobaczyć, jak to rozwiązanie wpisuje się w cykl życia zestawu danych, który wymaga jasnej własności, zdefiniowanych progów i ciągłych kontroli, a nie tylko kolejnego jednorazowego procesu budowy.
Najczęściej zadawane pytania
Kiedy zbiór danych jest naprawdę gotowy?
Nie wtedy, gdy poprawnie się zbudował. Jeśli pulpit, model albo przepływ niżej w łańcuchu może zawieść po cichu, zbiór nie jest jeszcze gotowy. Zbiór produkcyjny potrzebuje kontroli po starcie, a nie tylko budowy przed nim.
Co trzeba rozstrzygnąć przed napisaniem pierwszego zapytania?
Ziarno, klucze i semantykę czasu, bo błędy schematu szybko twardnieją i drogo kosztują. Wybierz ziarno świadomie, zamiast pozwolić mu się wyłonić, i dobierz nazwy, które przetrwają realną eksploatację, bo niechlujna tabela zdarzeń najpierw pokazuje kłopoty w nazwach kolumn.
Dlaczego zbiory psują się tygodnie po uruchomieniu?
Bo przyczyną zwykle jest kontrola, a nie konstrukcja. Budowa przeszła wszystkie testy i wyglądała czysto na środowisku testowym, a potem nie stało się nic spektakularnego; zabrakło jedynie sposobu, by zauważyć, że dane przestały zachowywać się tak, jak sugerował schemat.
Jakie kontrole powinny towarzyszyć nowemu zbiorowi od pierwszego dnia?
Walidacja, dyscyplina partycjonowania i kontekst governance, a do tego monitoring trybów awarii, które przebiegają cicho. Dokładanie ich po incydencie zawsze kosztuje więcej niż zaprojektowanie od razu, bo wtedy na danych opierają już decyzje ich odbiorcy.
Ile danych firmowych faktycznie spełnia standardy jakości?
Tylko niewielka część, jak wskazują szeroko cytowane badania branżowe obok szacunków Gartnera dotyczących kosztu słabej jakości. Praktyczny wniosek nie brzmi, że większość danych jest bezużyteczna, lecz że większości nigdy nie zmierzono względem wypowiedzianego standardu.



