Dane historyczne Snowflake: Time Travel (podróż w czasie), Fail-Safe (ochrona przed awarią)
|
9
min. czyt.

O godzinie 3 rano automatyczne zadanie czyści tabelę klientów zamiast ładować jej kolejną partycję. Zanim zespół pojawia się na miejscu, pulpity nawigacyjne są puste, modele podrzędne (downstream) ulegają awarii i nikt nie jest w stanie ustalić, czy uszkodzenie zaczęło się od ładowania, transformacji czy skryptu czyszczącego. Dane historyczne Snowflake mogą zmienić ten incydent w kontrolowane przywracanie, ale tylko wtedy, gdy zespół wie, która historia nadal istnieje, które obiekty są chronione i czy dostępna kopia nadaje się do odpytywania, czy też służy wyłącznie do odzyskiwania.
Najbardziej niebezpiecznym założeniem jest to, że każda tabela Snowflake automatycznie posiada reklamowane 90-dniowe okno Time Travel. Obiekty trwałe (permanent) mogą być skonfigurowane na taki czas trwania w odpowiedniej edycji, ale obiekty tymczasowe (temporary) i przejściowe (transient) mają znacznie węższe limity. Dane historyczne to zatem coś więcej niż funkcja SQL. To decyzja projektowa obejmująca odzyskiwanie, Observability, dowody audytowe, przechowywanie i cykl życia obiektów.
Spis treści
Odzyskiwanie usuniętych obiektów za pomocą klonowania i UNDROP
Wykorzystanie danych historycznych do Observability i audytów
Kiedy używać Time Travel, a kiedy zewnętrznych kopii zapasowych
Kiedy dane historyczne ratują środowisko produkcyjne
O 2 w nocy nieudane ładowanie zastępuje prawidłowe rekordy klientów wartościami null. Inżynier dyżurny zatrzymuje proces zapisu, sprawdza, czy tabela nadal posiada użyteczną historię, i rejestruje incydent, zanim kolejna próba zmieni dowody. Zapytanie historyczne może pokazać ostatni znany dobry stan, podczas gdy klon daje zespołowi osobną przestrzeń do odzyskiwania danych. Środowisko produkcyjne pozostaje dostępne podczas badania awarii.
Ten rezultat zależy od przygotowania. Funkcja Snowflake Time Travel zachowuje wcześniejsze stany tabel i obsługuje historyczne operacje SELECT, klonowanie oraz UNDROP w ramach skonfigurowanego okna przechowywania (retention window). Standardowy okres to 1 dzień, natomiast trwałe bazy danych, schematy i tabele mogą być skonfigurowane na okres od 0 do 90 dni, zgodnie z dokumentacją Time Travel Snowflake. Reklamowany 90-dniowy okres ma zastosowanie tylko tam, gdzie pozwalają na to typ obiektu, edycja i ustawienia.
Wzór incydentu niedoceniany przez zespoły
Trwała tabela produkcyjna może zachować potrzebny stan, podczas gdy przejściowa tabela tymczasowa (staging), która ją zasiliła, mogła już utracić swoją użyteczną historię. Ta luka ogranicza dochodzenie. Zespół może odzyskać wygląd tabeli docelowej, nie będąc w stanie udowodnić, która zmiana na wcześniejszym etapie wprowadziła błędne wartości.
Zarejestruj oś czasu incydentu za pomocą zapytania przed przywróceniem czegokolwiek:
Widok użycia konta (account usage view) ma opóźnienia, więc połącz go z logami orkiestracji i historią zadań, gdy incydent jest wciąż aktywny. Zapisz obiekty, których dotyczy problem, zaobserwowane symptomy oraz identyfikatory zapytań (query IDs), które zmieniły produkcję.
Zasada operacyjna: Traktuj przechowywanie (retention) jako kontrolę na poziomie obiektu, a obietnicę obejmującą całą platformę.
Zastosuj ostrożną sekwencję odzyskiwania:
Zatrzymaj zapis: Wstrzymaj nieudane zadanie, potok (pipeline) lub wdrożenie.
Sprawdź przed przywróceniem: Porównaj wiersze historyczne i bieżące, klucze, zachowanie wartości null oraz sumy biznesowe.
Odzyskaj w izolacji: Utwórz klon lub osobną tabelę, dopóki mechanizm awarii pozostaje niepewny.
Zweryfikuj zamiennik: Przetestuj zależności i uprawnienia przed wdrożeniem na produkcję.
Zespoły budujące szersze praktyki niezawodności mogą połączyć ten przepływ pracy z inżynierią niezawodności baz danych. Dane historyczne wspierają wówczas Observability i przegląd audytowy, a nie tylko awaryjne odzyskiwanie. Retencja powinna być weryfikowana wraz z własnością, pochodzeniem danych (lineage), monitorowaniem i celami odzyskiwania.
Rozwój Snowflake przyniósł również bardziej zróżnicowane cykle życia obiektów. W miarę rozbudowy wdrożeń zespoły przejmują trwałe, przejściowe i tymczasowe zestawy danych o różnym zachowaniu podczas odzyskiwania. Praktyczne pytanie nie brzmi, czy Snowflake oferuje 90 dni. Brzmi: które obiekty zachowują dowody wystarczająco długo, aby odzyskać dane i wyjaśnić awarię produkcyjną.
Querying Past States with Time Travel
Time Travel działa najlepiej, gdy inżynier rozdziela trzy zadania: sprawdzenie wcześniejszego stanu, zidentyfikowanie dokładnej granicy zmiany i utworzenie wyizolowanej kopii. Składnia wspiera każde z tych podejść, ale wybór wpływa na to, jak dokładnie można odtworzyć incydent.
Używanie znaczników czasu dla znanego okna incydentu
Jeśli monitorowanie wykaże, że niszczycielskie ładowanie rozpoczęło się o określonej godzinie, wykonaj zapytanie do tabeli w stanie, w jakim istniała przed tym zdarzeniem:
AT jest przydatne, gdy oś czasu incydentu pochodzi z logów orkiestracji, rekordów wdrożeń lub historii zapytań. Pyta Snowflake o stan obiektu w określonym punkcie, co czyni go odpowiednim do porównania znanej dobrej wersji z bieżącą tabelą.
Możesz również sklonować ten stan historyczny:
Klon daje zespołowi roboczą przestrzeń do dochodzenia bez nadpisywania źródła. Przed oparciem się na wyniku sprawdź, czy żądany znacznik czasu mieści się w bieżącym oknie przechowywania obiektu.
Używanie przesunięć (offsets) do dochodzeń względnych
Gdy incydent wydarzył się niedawno, ale dokładny znacznik czasu jest mniej ważny, OFFSET pozwala cofnąć się o określoną liczbę sekund:
Jest to wygodne podczas aktywnego incydentu, ponieważ wyraża względny punkt w czasie. Jest mniej odpowiednie dla formalnego zapisu audytowego, chyba że zarejestrujesz również czas wykonania i ustalony znacznik czasu, ponieważ „godzina temu” może stać się niejednoznaczna po fakcie.
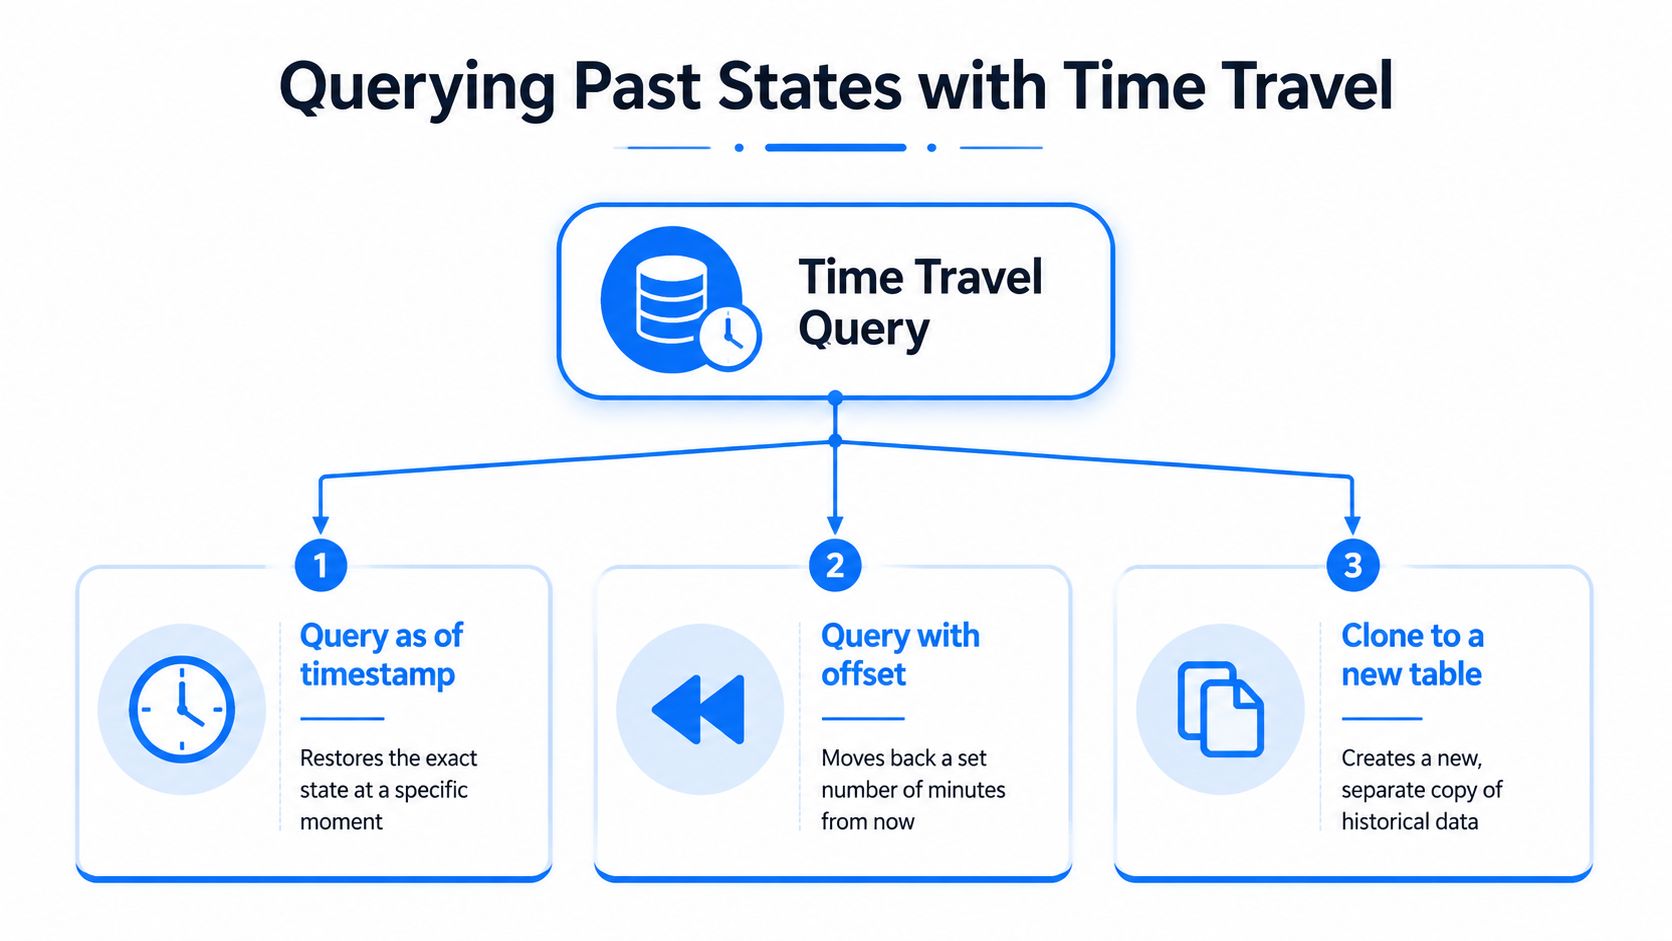
Używanie granic transakcji, gdy zmiana jest identyfikowalna
Jeśli historia zapytań lub narzędzia wdrożeniowe dostarczają identyfikator transakcji, BEFORE pozwala sprawdzić stan tabeli przed tą transakcją:
Dokładny identyfikator musi być dostępny w rekordach operacyjnych. Nie zgaduj go. Zapytanie oparte na znaczniku czasu jest zazwyczaj bezpieczniejsze, gdy zespół dysponuje jedynie przybliżonym czasem incydentu.
Walidacja przechowywania powinna nastąpić przed SQL odzyskiwania, a nie po nieudanym zapytaniu:
Sprawdź zwrócony retention_time, a następnie potwierdź edycję tabeli i typ obiektu. Snowflake dokumentuje standardowy 1-dniowy okres przechowywania i konfigurowalne przechowywanie od 0 do 90 dni dla trwałych baz danych, schematów i tabel w odpowiednich edycjach, jak opisano w wytycznych dotyczących dostępności danych.
Time Travel nie jest również konwencjonalnym archiwum kopii zapasowych. Zachowuje historyczne stany zdatne do odpytywania przez określony czas, ale nie spełnia automatycznie wymagań dotyczących długoterminowego przechowywania, niezmiennych kopii czy odzyskiwania na niezależnym koncie. Używaj go do szybkiego badania operacyjnego i przywracania do punktu w czasie, a następnie oceń, czy potrzebna jest inna warstwa ochrony.
Zrozumienie limitów przechowywania i typów obiektów
Okres 90 dni dotyczy możliwości platformy, a nie każdego obiektu na koncie. Obiekty trwałe mogą mieć konfigurowalny okres Time Travel od 0 do 90 dni, podczas gdy obiekty tymczasowe i przejściowe są ograniczone do 0 lub 1 dnia, zgodnie z dokumentacją Snowflake dotyczącą kosztów przechowywania i retencji. Tabela stagingowa, którą Twój potok utworzył na nowo podczas wdrożenia, może nie mieć takiej samej ochrony jak tabela produkcyjna, którą zasila.
Przechowywanie danych historycznych Snowflake według typu obiektu
Typ obiektu | Time Travel (Standard) | Time Travel (Enterprise+) | Fail-safe |
|---|---|---|---|
Trwała baza danych, schemat lub tabela | Domyślnie 1 dzień | Od 0 do 90 dni | 7 dni po Time Travel dla obiektów trwałych |
Tabela przejściowa (transient) | 0 lub 1 dzień | 0 lub 1 dzień | Niedostępne |
Tabela tymczasowa (temporary) | 0 or 1 dzień | 0 or 1 dzień | Niedostępne |
Tabela odzwierciedla udokumentowany model retencji. Fail-safe nie jest rozszerzeniem Time Travel, które może być odpytywane przez użytkownika. Po wygaśnięciu danych historycznych obiekty trwałe mogą wejść w 7-dniowy okres Fail-safe, ale dane te są przeznaczone do wsparcia odzyskiwania, a nie do zwykłej analizy za pomocą SELECT. Traktowanie Fail-safe jako warstwy zapytań audytowych buduje fałszywe poczucie bezpieczeństwa podczas incydentu.
Audyt ustawień przed wystąpieniem awarii
Zacznij od samego obiektu:
Sprawdź retention_time, rodzaj obiektu oraz edycję, która zarządza kontem. Następnie sklasyfikuj tabele według roli. Trwałe tabele biznesowe zazwyczaj zasługują na inną politykę niż jednorazowe tabele wejściowe, ale to rozróżnienie musi być wyraźne i udokumentowane.
Przechowywanie danych wiąże się z kompromisem kosztowym. Dłuższa retencja oznacza, że Snowflake utrzymuje więcej danych historycznych, więc zespoły powinny oszacować wpływ dla tabel o wysokiej częstotliwości zmian zamiast włączać maksymalną retencję wszędzie. Udokumentowane w Snowflake okna utrzymania danych historycznych wynoszą od 7 do 97 dni dla obiektów trwałych w edycji Enterprise, w porównaniu do 0 do 1 dnia dla obiektów przejściowych, co sprawia, że klasyfikacja obiektów ma kluczowe znaczenie dla planowania kosztów i projektowania odzyskiwania danych.
Zasada praktyczna: Polityka retencji powinna odpowiadać na trzy pytania: co musi być odzyskiwalne, co musi podlegać audytowi, a co można odtworzyć z autorytatywnego źródła.
Wymogi regulacyjne nakładają kolejne ograniczenia. Firma może potrzebować zachować dowody przez okres, który nie pokrywa się z Time Travel, lub może wymagać udokumentowanego harmonogramu usuwania zamiast bezterminowego przechowywania. W pracy nad taką polityką pomocne mogą być wskazówki dotyczące harmonogramu retencji RODO, oferujące przydatny kontekst dopasowania retencji do celu, wymogów prawnych i kontrolowanej utylizacji.
Zespoły projektujące długowieczne zestawy danych powinny również oddzielić archiwizację od odzyskiwania po incydentach. Wskazówki dotyczące opanowania archiwizacji danych są istotne, ponieważ archiwum powinno być celowe, kontrolowane i łatwe do przeszukiwania. Time Travel chroni zmieniający się obiekt przez ograniczone okno. Nie zastępuje katalogu archiwalnego ani właściciela odpowiedzialnego za retencję.
Odzyskiwanie usuniętych obiektów za pomocą klonowania i UNDROP
Usunięta tabela stwarza inny problem z odzyskiwaniem niż błędna aktualizacja. Sam obiekt może zniknąć z aktywnej przestrzeni nazw, więc inżynier musi zdecydować, czy przywrócić oryginalny obiekt, czy utworzyć niezależną kopię do zbadania.
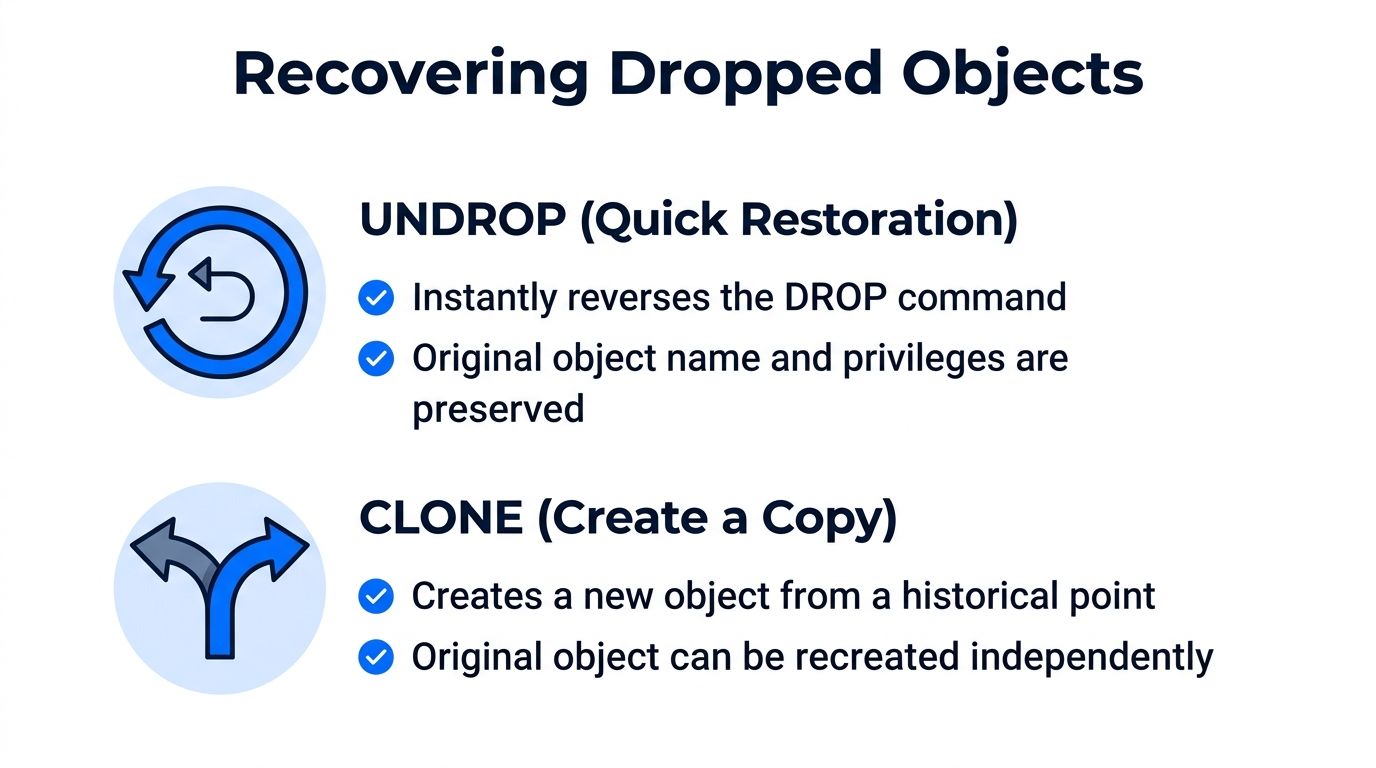
UNDROP to bezpośrednia droga, gdy obiekt został usunięty w dostępnym okresie odzyskiwania:
W przypadku usuniętego schematu lub bazy danych użyj odpowiedniego polecenia na poziomie obiektu:
To polecenie jest atrakcyjne podczas awarii, ponieważ cofa usunięcie zamiast wymagać przepływu pracy związanego z przenoszeniem danych. Mimo to przywrócenia nie należy traktować jako dowodu na to, że obiekt jest poprawny. Przed ponownym podłączeniem konsumentów sprawdź istnienie obiektu, uprawnienia (grants), zależności oraz oczekiwany schemat aplikacji.
Klonuj najpierw, gdy przyczyna awarii jest niejasna
Klonowanie jest bezpieczniejsze, gdy zespół musi sprawdzić wersję historyczną bez zmiany ścieżki odzyskiwania produkcji:
Takie podejście chroni źródło, podczas gdy inżynierowie porównują rekordy, testują transformacje i identyfikują instrukcję, która spowodowała uszkodzenie. Wspiera również kontrolowany proces wdrożenia produkcyjnego: zweryfikuj klon, udokumentuj dowody, a następnie zdecyduj, czy zastąpić, czy naprawić obiekt produkcyjny.
Nazwy obiektów mogą komplikować UNDROP. Jeśli nowy obiekt przyjął już oryginalną nazwę, operacja odzyskiwania może wymagać uprzedniej zmiany nazwy lub usunięcia konfliktowego obiektu. Nie improwizuj tego kroku na produkcji. Zapisz metadane bieżącego obiektu, zachowaj obiekt będący w konflikcie, jeśli może zawierać dowody, i tam, gdzie to możliwe, korzystaj z wyznaczonego schematu odzyskiwania.
Walidacja przed wdrożeniem produkcyjnym (promotion)
Lista kontrolna odzyskiwania powinna obejmować:
Potwierdzenie granicy awarii: Ustal, czy usunięcie, aktualizacja lub zastąpienie dotyczyło jednej tabeli, schematu czy bazy danych.
Sprawdzenie uprawnień do retencji: Zweryfikuj, czy stan historyczny obiektu jest nadal dostępny i zdatny do odpytywania.
Utworzenie izolowanej kopii: Wybierz klon, gdy badanie lub porównanie jest nadal potrzebne.
Porównanie krytycznych wartości: Sprawdź klucze, wyjątki na poziomie wierszy, agregaty i oczekiwania procesów downstream.
Przegląd uprawnień: Potwierdź, że własność i uprawnienia (grants) pasują do zamierzonego modelu dostępu.
Świadome wdrożenie: Zmieniaj odbiorców (consumers) dopiero po pomyślnej walidacji odzyskanego obiektu.
Architektura mikropartycji Snowflake oznacza, że klon nie jest ręcznie składaną kopią zapasową. Stany historyczne pozostają powiązane z zachowaniem retencji i przechowywania platformy, więc plan odzyskiwania nadal potrzebuje niezależnej strategii dla danych, które muszą przetrwać poza tym cyklem życia.
Zespoły formalizujące te procedury mogą odwołać się do najlepszych praktyk dotyczących hurtowni danych jako szerszego punktu odniesienia. Praktycznym celem jest powtarzalność. O 2 w nocy inżynier powinien postępować zgodnie ze znaną ścieżką decyzyjną, zamiast szukać po omacku nieudokumentowanych założeń dotyczących nazw obiektów i retencji.
Wykorzystanie danych historycznych do Observability i audytów
Historyczny stan tabeli odpowiada na pytanie: „Co ten obiekt wtedy zawierał?”. Observability zadaje szersze pytanie: „Jak dane zachowywały się w czasie i kiedy to zachowanie stało się nienormalne?”. Te pytania współgrają ze sobą, ale nie są tożsame.
Użyteczne dochodzenie rozpoczyna się od zaobserwowanego symptomu. Spada metryka, ładowanie dociera z opóźnieniem, kolumna zmienia typ lub suma biznesowa wykracza poza normę. Time Travel pozwala zbadać leżącą u podstaw tabelę w odpowiednim punkcie, podczas gdy zapis z systemu observability może pokazać, czy zmiana była odosobniona, powtarzająca się, czy stanowiła część większego problemu z potokiem danych.
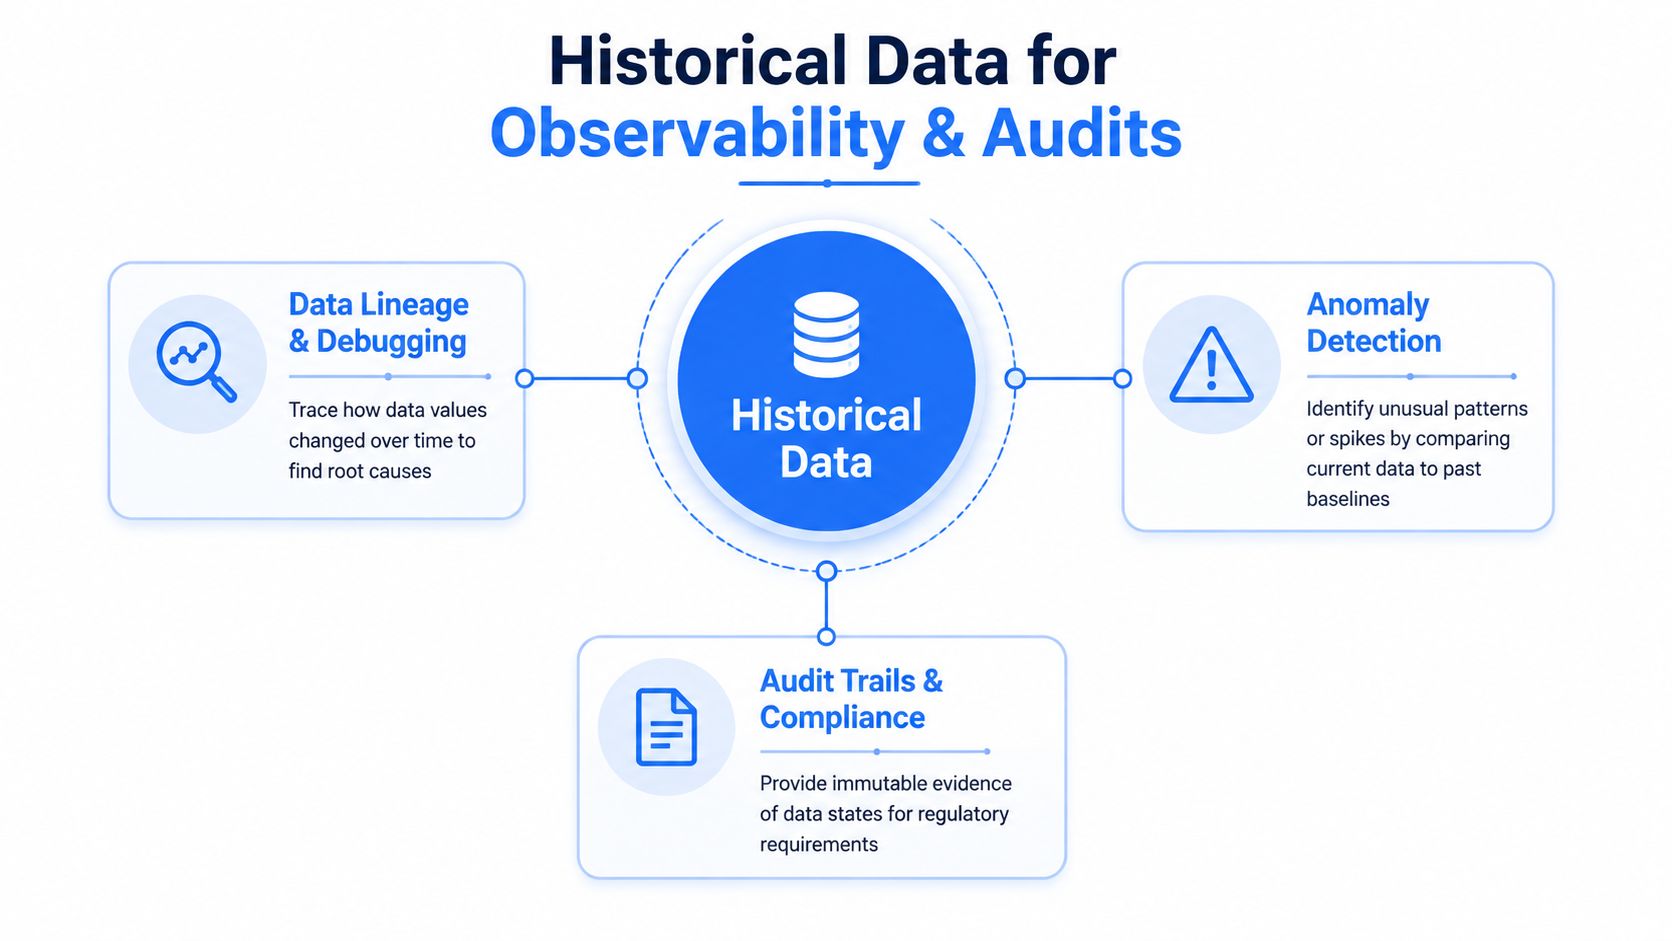
Łączenie dowodów punktowych w czasie z ciągłymi sygnałami
Przepływ pracy jest prosty:
Wykrywanie (Detect): Monitor sygnalizuje nienormalny wolumen, Timeliness, schemat lub zachowanie biznesowe.
Lokalizacja (Locate): Inżynierowie identyfikują tabelę, zadanie, instrukcję oraz przybliżone okno zmian, których dotyczy problem.
Porównanie (Compare): Zapytanie Time Travel zestawia stan bieżący ze stanem historycznym.
Wyjaśnienie (Explain): Pochodzenie danych (lineage) i logi potoku łączą zmianę danych z działaniem na wcześniejszym etapie (upstream).
Zachowanie (Preserve): Zespół zapisuje kontekst incydentu i wyniki walidacji w rekordzie przyjaznym dla audytu.
Snowflake udostępnia informacje o klastrowaniu poprzez CLUSTERING_INFORMATION, w tym average_overlaps, average_depth oraz partition_depth_histogram. Metryki te mogą pomóc inżynierom ustalić, czy słabe usuwanie niepotrzebnych partycji (pruning) przyczynia się do wolnej analizy historycznej, ale ponowne klastrowanie niesie za sobą koszty. Prawidłowy przepływ pracy porównuje partycje przeskanowane z partycjami ogółem, tworzy punkt odniesienia dla czasu wykonania reprezentatywnego zapytania i weryfikuje zużycie kredytów w AUTOMATIC_CLUSTERING_HISTORY przed zachowaniem klucza klastrowania.
Historia zapytań ma również własne granice retencji. Widok QUERY_HISTORY w schemacie Account Usage przechowuje rekordy przez 1 rok, czyli 365 dni, podczas gdy odpowiadające mu widoki Information Schema i funkcje tabelaryczne mają krótsze okresy przechowywania – od 7 dni do 6 miesięcy, co zostało podsumowane w tym przeglądzie Time Travel i historii zapytań Snowflake. Ta różnica ma znaczenie podczas audytów. Tabela może zachować wiersze historyczne, podczas gdy dowody operacyjne wyjaśniające zmianę uległy już przedawnieniu.
Platforma taka jak data observability może uzupełniać Time Travel poprzez zachowywanie historii metryk, uczenie się oczekiwanego zachowania, śledzenie punktualności (Timeliness), walidację rekordów i wykrywanie zmian schematu. Architektura powinna przechowywać dowody w środowisku klienta i odróżniać surowe stany historyczne od pochodnych sygnałów monitorowania. Taki podział daje audytorom zarówno kontekst danych bazowych, jak i stojącą za nimi historię operacyjną.
Kiedy używać Time Travel, a kiedy zewnętrznych kopii zapasowych
Time Travel to właściwe narzędzie do szybkiego, lokalnego odzyskiwania danych po niedawnych błędach. Zazwyczaj jest to jednak kiepski zamiennik dla długoterminowej polityki kopii zapasowych, zwłaszcza gdy firma potrzebuje historii wykraczającej poza skonfigurowane okno, niezależnego odzyskiwania danych lub dowodów, których użytkownicy nie mogą zmienić poprzez normalne operacje na hurtowni danych.
Czynnik decyzyjny | Time Travel | Zewnętrzna kopia zapasowa |
|---|---|---|
Główny cel | Operacyjne odzyskiwanie i analiza | Odzyskiwanie po awarii (DR) i długoterminowe przechowywanie |
Cel odzyskiwania | Stan tabeli, schematu lub bazy danych | Osobno utrzymywana kopia lub szersze środowisko |
Precyzja historyczna | Stan w punkcie czasowym (point-in-time) w ramach retencji | Zależy od harmonogramu migawek (snapshots) lub eksportu |
Szybkość operacyjna | Szybka dla uprawnionych obiektów | Może wymagać przywracania, transferu i prac walidacyjnych |
Główne ograniczenie | Retencja, typ obiektu i zależność od platformy | Narzut związany z przechowywaniem, orkiestracją, testowaniem i zarządzaniem |
Używaj Time Travel, gdy incydent jest świeży, obiekt, którego dotyczy problem, kwalifikuje się do tej funkcji, a zakres odzyskiwania jest wąski. Klon często wystarcza do przeprowadzenia dochodzenia, podczas gdy UNDROP nadaje się do ewidentnego przypadkowego usunięcia, które wymaga szybkiego przywrócenia.
Wybierz inną warstwę ochrony, gdy wymagania wykraczają poza model retencji Snowflake. Obejmuje to długoterminową retencję regulacyjną, niezmienne dowody, odzyskiwanie między środowiskami lub ochronę przed błędami operacyjnymi na poziomie całego konta. Obiekty trwałe mogą otrzymać 7 dni Fail-safe po wygaśnięciu Time Travel, ale obiekty przejściowe i tymczasowe nie otrzymują tej ochrony, a Fail-safe nie jest dostępny do odpytywania przez użytkowników. Plan odzyskiwania musi uwzględniać te granice, zamiast traktować je jako równoważne z kopią zewnętrzną.
Podejmowanie decyzji w oparciu o wymagania biznesowe
Zadaj właścicielowi każdego krytycznego zestawu danych następujące pytania:
Jak daleko wstecz musi sięgać możliwość odzyskania danych?
Czy kopia musi być kontrolowana niezależnie?
Czy biznes może tolerować rekonstrukcję z systemów źródłowych?
Czy audytorzy muszą bezpośrednio kontrolować rekordy historyczne?
Jaka szybkość odzyskiwania jest wymagana dla procesów roboczych skierowanych do klienta?
Natywna replikacja, zarządzany eksport oraz narzędzia do tworzenia kopii zapasowych firm trzecich mogą uzupełniać różne luki. Właściwy projekt może łączyć krótkoterminowe okno Time Travel do natychmiastowych napraw z osobno zarządzanym archiwum do dłuższego przechowywania. Koszt to nie tylko przechowywanie. Obejmuje on testy operacyjne, kontrolę dostępu, katalogowanie oraz czas wymagany do udowodnienia, że kopia odzyskiwania działa.
Zespoły dopracowujące szerszy plan ciągłości działania mogą zapoznać się z tym praktycznym przewodnikiem po DR dla nowoczesnych zespołów. W kwestiach projektowych po stronie Snowflake, najlepsze praktyki dotyczące dostępności danych pomagają ująć dostępność jako dyscyplinę operacyjną, a nie pojedyncze polecenie odzyskiwania danych.
digna pomaga zespołom zajmującym się danymi monitorować zachowanie danych w Snowflake poprzez wykrywanie anomalii, monitorowanie terminowości (Timeliness), walidację rekordów, śledzenie schematów i analizę historyczną, przy jednoczesnym zachowaniu wykonywania operacji w środowisku klienta. Odwiedź digna, aby połączyć planowanie retencji i odzyskiwania z ciągłym observability przed kolejnym incydentem na produkcji.
Najczęściej zadawane pytania
Jak długo Snowflake przechowuje dane historyczne?
Krócej, niż zakłada większość zespołów. Standardowy okres Time Travel to 1 dzień, a trwałe bazy, schematy i tabele można skonfigurować od 0 do 90 dni. Okno 90 dni jest konfigurowalnym maksimum, a nie czymś, co każda tabela ma automatycznie.
Dlaczego tabela tymczasowa psuje odtworzenie?
Bo retencja jest kontrolą na poziomie obiektu, a nie obietnicą całej platformy. Trwała tabela produkcyjna może wciąż przechowywać potrzebny stan, podczas gdy zasilająca ją tymczasowa tabela stagingowa już utraciła użyteczną historię.
Co zebrać przed jakimkolwiek odtworzeniem?
Oś czasu incydentu. Odpytaj SNOWFLAKE.ACCOUNT_USAGE.QUERY_HISTORY dla danego okna, filtrując po query_start_time i czytając query_id, user_name, query_type, query_text oraz execution_status. Ten widok ma opóźnienie, więc połącz go z logami orkiestracji i historią zadań.
Jaka jest bezpieczna kolejność odtwarzania?
Najpierw zatrzymaj zapisującego: wstrzymaj wadliwe zadanie, potok albo wdrożenie, zanim cokolwiek przywrócisz. Odtwarzanie, gdy zadanie powodujące szkodę wciąż działa, tworzy drugi incydent na pierwszym.
Co Fail-safe dodaje do Time Travel?
Ostateczność, a nie drugi, odpytywalny poziom retencji. Time Travel jest oknem, które zespół kontroluje i wykorzystuje bezpośrednio, więc plan odtworzenia oparty na Fail-safe wyszedł już poza kontrole możliwe do przetestowania z wyprzedzeniem.