Otwarty format tabeli: Iceberg, Delta i Hudi w porównaniu
|
8
min. czyt.

Najczęściej powtarzana rada dotycząca otwartego formatu tabeli mówi, by wybrać taki, który chroni przed uzależnieniem od dostawcy. Ta rada jest niepełna. Przenośność plików ma znaczenie, ale głębsza zmiana polega na tym, że znaczenie tabeli, historia transakcji, intencja schematu i metadane do planowania zapytań przenoszą się do wspólnej warstwy nad obiektami w chmurze.
To przesunięcie zamienia katalog pełen plików Parquet lub ORC w tabelę, którą wiele silników może odkryć, odczytać, zaktualizować i rozwijać. Tworzy też nową odpowiedzialność: metadanymi trzeba zarządzać. Iceberg, Delta Lake i Hudi mogą sprawić, że pamięć masowa zachowuje się bardziej jak baza danych, ale nie rozstrzygają, czy spóźniony snapshot łamie SLA, czy nowa kolumna psuje model niżej w łańcuchu ani czy poprawnie wyglądający rekord zawiera nietypowy wzorzec biznesowy.
Ten przewodnik zaczyna się od modelu pojęciowego, porównuje trzy główne formaty, a następnie śledzi metadane aż do eksploatacji produkcyjnej. Pytanie główne jest proste: która warstwa kontroli utrzymuje wiarygodność otwartej tabeli po udanym commicie?
Spis treści
Dlaczego otwarte formaty tabel zmieniają reguły gry w lakehouse
Otwarty format tabeli to nie tylko wspólny sposób czytania Parquet bez zależności od dostawcy. Umieszcza semantykę tabeli w metadanych, które mogą leżeć obok danych w pamięci obiektowej. Ta semantyka obejmuje atomowe commity, wersjonowane snapshoty, ewolucję schematu, informacje o partycjach i statystyki na poziomie plików.
Bez tej warstwy pamięć obiektowa daje w gruncie rzeczy pliki i foldery. Silnik zapytań może wywnioskować tabelę z katalogu, ale struktura katalogów nie odpowiada wiarygodnie na podstawowe pytania: które pliki należą do bieżącej wersji, który zapis się zakończył, który schemat obowiązywał wczoraj i które pliki można bezpiecznie pominąć przy danym filtrze.
Otwarte formaty tabel odpowiadają na te pytania za pomocą wspólnych metadanych. Apache Hudi powstał w Uberze w 2016 roku, Databricks wprowadził Delta Lake w latach 2017–2018 i udostępnił go jako otwarte oprogramowanie w 2019, a Apache Iceberg narodził się w Netflixie w 2018 i trafił do Apache Software Foundation w 2019. Te odrębne wysiłki zbiegły się wokół tego samego problemu: sprawić, by data lake zachowywał się bardziej jak baza danych, bez wyprowadzania danych z pamięci obiektowej (historyczny przegląd otwartych formatów tabel).
Od katalogów do pełnoprawnych tabel
Praktycznym wynikiem jest tabela obsługująca odczyty wsadowe, zapisy strumieniowe, aktualizacje i usunięcia na tej samej pamięci masowej. Silniki nie muszą traktować każdego pliku jako osobnego źródła prawdy. Mogą rozstrzygnąć spójny snapshot, sprawdzić metadane i zaplanować pracę na właściwym podzbiorze plików.
To zmienia projekt na kilka sposobów:
Równoległe zapisy stają się możliwe do opanowania: commit może powieść się lub nie powieść jako kompletna zmiana metadanych, bez ujawniania częściowego stanu tabeli.
Wiele silników może współpracować: Spark, Trino, Flink, hurtownie i inni czytelnicy mogą korzystać z kontraktu metadanych tabeli zamiast opierać się wyłącznie na ścieżkach fizycznych.
Potoki stają się mniej zależne od silnika: zespoły mogą oddzielić semantykę przechowywania od silnika obliczeniowego wykonującego transformację.
Tabele stają się obiektami katalogu: własność, odnajdywalność, dostęp i pochodzenie danych można organizować wokół tabeli, a nie folderu.
Tabela Delta zawiera na przykład pliki danych oraz dziennik transakcji. Regularne punkty kontrolne kompaktują ten dziennik, dzięki czemu silniki rozpoznają aktywny snapshot i właściwe partycje bez wyliczania każdego obiektu, nawet przy bardzo dużej skali (techniczny opis projektu transakcyjnego Delta Lake).
Zasada architektoniczna: otwarty format tabeli daje trwały opis stanu tabeli. Nie daje automatycznie trwałej kontroli nad tym, co ten stan oznacza dla biznesu.
To rozróżnienie ma znaczenie przy projektowaniu lakehouse. Użyteczny model jakości danych w lakehouse musi znajdować się nad commitami pamięci masowej i łączyć zmianę strukturalną z własnością, walidacją, świeżością i wpływem na odbiorców.
Podstawowe elementy wyjaśnione bez żargonu
Pomyśl o pamięci obiektowej jak o dużej sortowni. Na podłodze stoją skrzynie z surowymi plikami Parquet lub ORC. Skrzynie są trwałe, ale sama podłoga nie mówi urzędnikowi, które skrzynie należą do dzisiejszej przesyłki ani czy nowo przybyła skrzynia jest zgodna z uzgodnionym formatem koperty.
Otwarty format tabeli dodaje rejestry urzędnika. Każdy rejestr opisuje bieżący stan tabeli i pomaga silnikowi zapytań znaleźć właściwe skrzynie bez otwierania wszystkich.
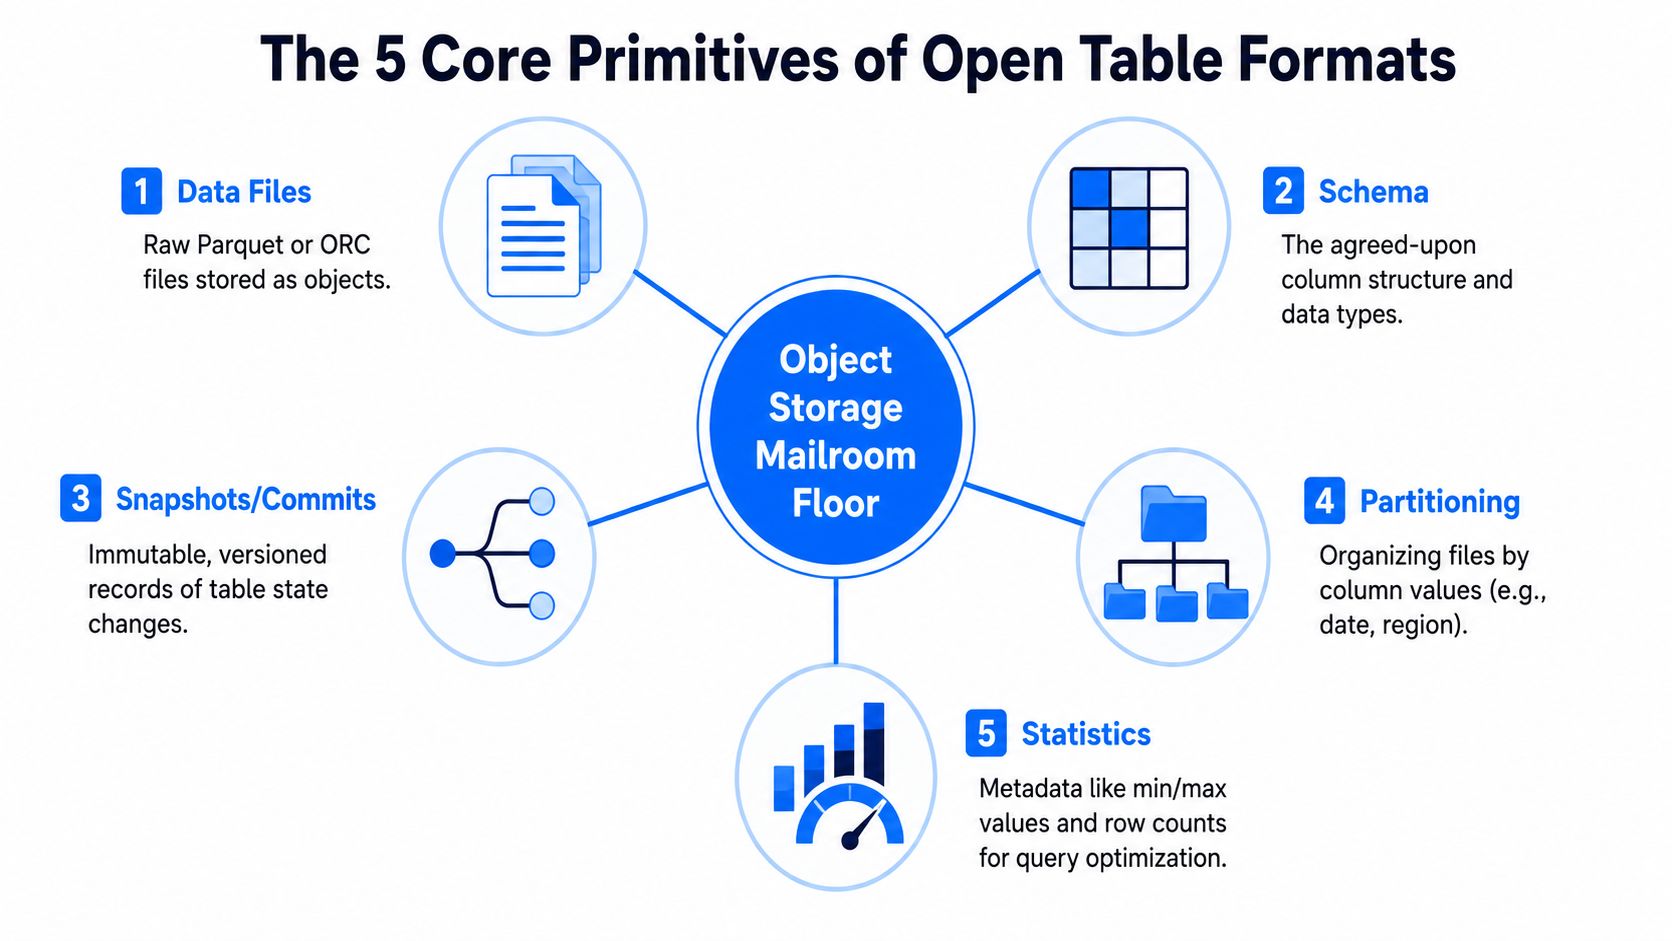
Pięć rejestrów, których potrzebuje urzędnik
Pliki danych to skrzynie na podłodze sortowni. Zawierają rzeczywiste wiersze, zwykle w formatach kolumnowych, takich jak Parquet czy ORC. Rola Parquet w przechowywaniu analitycznym to coś innego niż zarządzanie tabelami. Parquet składuje dane wydajnie, a otwarty format tabeli wyjaśnia, jak te pliki tworzą rozwijającą się tabelę.
Schemat to regulamin kształtu koperty. Definiuje nazwy kolumn, typy danych i oczekiwania strukturalne. Ewolucja schematu pozwala tabeli zmieniać się w czasie bez natychmiastowego przepisywania każdego historycznego pliku, ale dopuszczalna zmiana wciąż wymaga nadzoru.
Manifesty to szczegółowe spisy. Wpis manifestu może podawać ścieżkę pliku danych, jego wartości partycji i statystyki kolumn. W Icebergu pliki metadanych definiują tabelę, listy manifestów definiują snapshoty, a pliki manifestów wyliczają pliki danych ze statystykami do przycinania (porównanie architektoniczne dotyczące Iceberga).
Snapshoty to migawki rejestrów. Czytelnik może odpytać tabelę w takim stanie, w jakim istniała przy wcześniejszym snapshocie, i otrzymać spójną odpowiedź nawet wtedy, gdy napływają nowe pliki. Iceberg używa niezmiennych plików metadanych i historii snapshotów, przy czym każdy commit tworzy nową wersję metadanych (specyfikacja Iceberga).
Transakcje ACID to reguły commitowania urzędnika. Aktualizacja metadanych staje się widoczna jako kompletna operacja albo w ogóle nie wchodzi do bieżącego stanu tabeli. Chroni to czytelników przed zobaczeniem połowy zapisu i daje zapisującym sposób na koordynowanie zmian.
Dlaczego partycjonowanie i statystyki wpływają na wydajność
Partycjonowanie to układ regałów. Jeśli wiersze są pogrupowane według wartości często pojawiającej się w filtrach, silnik może pominąć całe regały. Statystyki dają wskazówki bardziej szczegółowe, na przykład wartość minimalną i maksymalną kolumny w pliku, dzięki czemu planista omija pliki, których zakresy nie pasują do zapytania.
Dlatego wydajność zależy od planowania opartego na metadanych, a nie tylko od surowej szybkości plików. Dobrze zorganizowana tabela pozwala silnikowi ograniczyć operacje wejścia-wyjścia przed skanowaniem danych. Źle zorganizowana tabela może pozostać technicznie poprawna, a mimo to wymuszać szerokie skany.
Ewolucja schematu zasługuje na taką samą ostrożność. Dodanie kolumny może być zgodne z istniejącymi czytelnikami, ale usunięcie jej lub zmiana typu może dotknąć pulpitów, modeli i kontraktów danych. Format zapisuje stan strukturalny. Twoja platforma wciąż musi zdecydować, czy proponowana zmiana jest do przyjęcia.
Jak powstały Iceberg, Delta Lake i Hudi
Iceberg, Delta Lake i Hudi wyrosły w osobnych zespołach, które napotkały tę samą lukę architektoniczną: pliki w pamięci obiektowej nie są tabelami. Każdy projekt dodał metadane i zachowanie commitów, priorytetyzując inne obciążenia i środowiska eksploatacyjne. Ich historia jest więc historią nadzoru nad metadanymi, a nie układu plików.
Apache Hudi powstał w Uberze w 2016 roku, gdy zespoły potrzebowały, by pamięć data lake obsługiwała przetwarzanie przyrostowe i dane zmienne. Jego projekt opiera się na upsertach, usunięciach, indeksowaniu na poziomie rekordów i osi czasu commitów. Te decyzje pasują do potoków wielokrotnie nakładających zmiany z systemów operacyjnych.
Databricks wprowadził Delta Lake w latach 2017–2018 i udostępnił go jako otwarte oprogramowanie w 2019. Delta przechowuje historię transakcji w dzienniku obok plików danych. Sekwencyjne wpisy JSON lub Parquet w _delta_log rejestrują operacje i pozwalają silnikom odtworzyć stan tabeli oraz odpytać wcześniejsze wersje. To porównanie architektoniczne Iceberga, Delta Lake i Hudi daje zwięzły ogląd ich konstrukcji.
Netflix stworzył Iceberga w 2018 roku i przekazał go Apache Software Foundation w 2019. Iceberg skupił się na niezmiennych metadanych, izolacji snapshotów, ukrytym partycjonowaniu i neutralnym wobec silnika dostępie do tabel. Jego struktura metadanych oddziela definicje tabel, odwołania do snapshotów i manifesty na poziomie plików oraz wspiera ewolucję partycji i przycinanie zapytań. Nasz przegląd otwartego formatu tabeli Apache Iceberg daje więcej kontekstu.
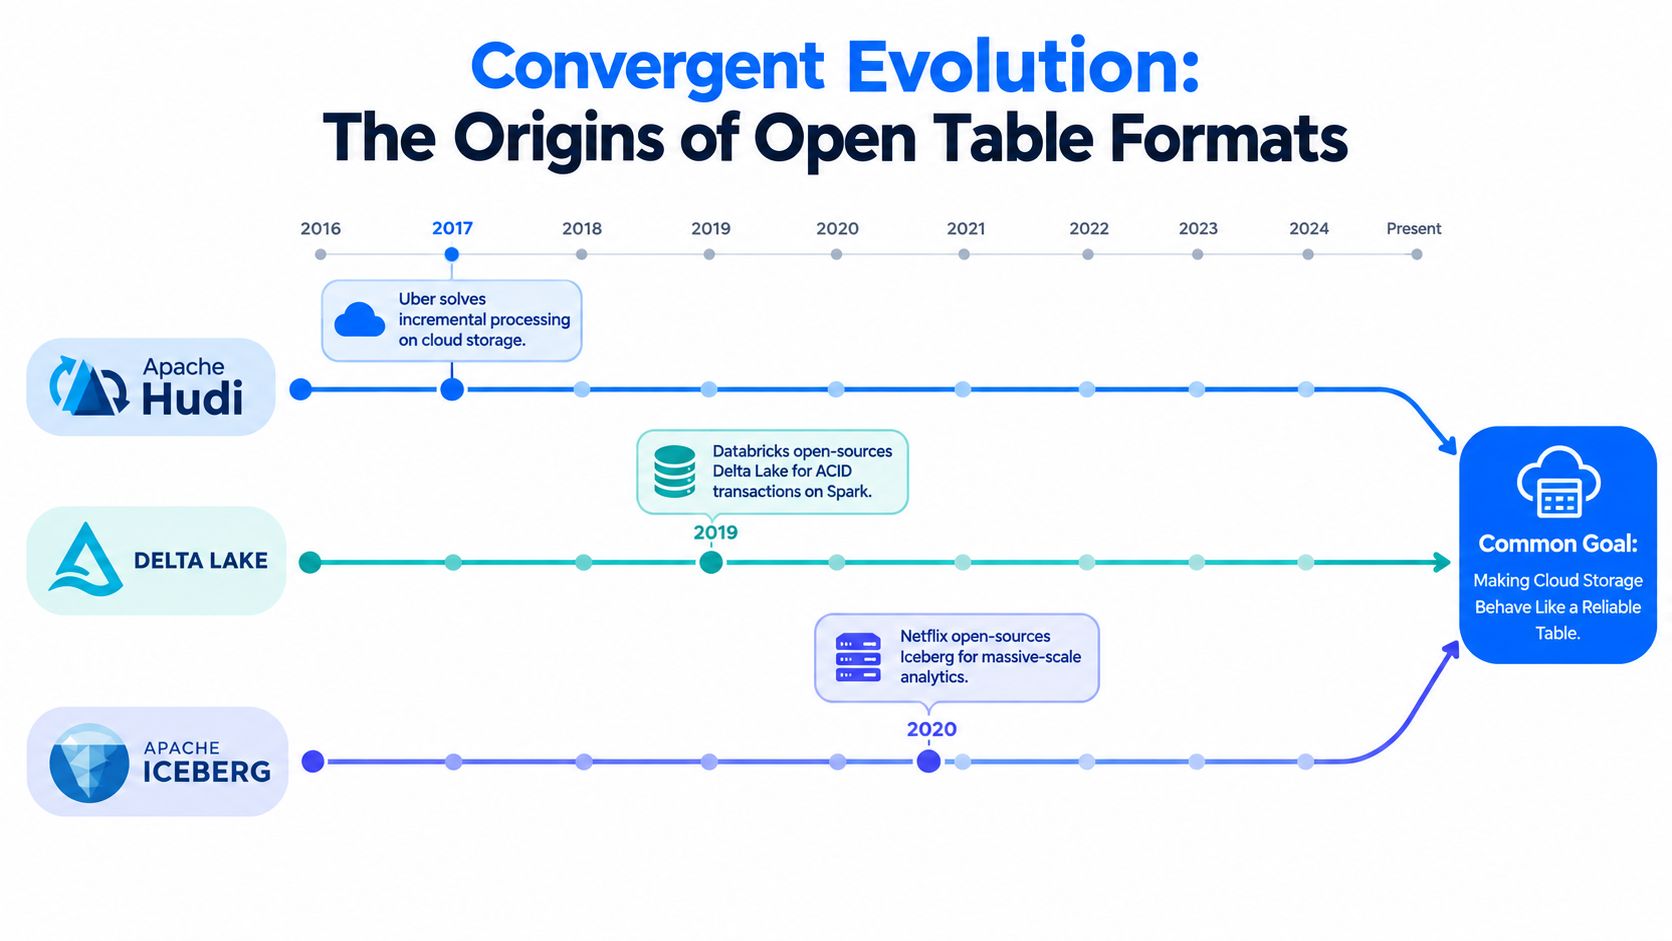
Te formaty zbiegły się, bo podchodzą do tego samego fundamentu za pomocą różnych modeli metadanych. Decyzja dotyczy tego, jak obciążenia zapisują dane, które silniki muszą ze sobą współpracować, jak katalogi koordynują dostęp i który zespół odpowiada za utrzymanie tabel.
Ta historia wyjaśnia też pozostającą lukę operacyjną. Mocne strony Hudi na poziomie rekordów, podejście Delty oparte na dzienniku transakcji i model Iceberga oparty na manifestach dostarczają użytecznych elementów tabelarycznych. Żaden z nich sam nie definiuje pochodzenia danych w skali przedsiębiorstwa, definicji biznesowych, polityk dostępu, reakcji na anomalie ani zatwierdzania zmian. Warstwa obserwowalności działająca wewnątrz bazy danych, taka jak digna, może powiązać te kontrole ze zmianami schematu, Timeliness i nietypowym zachowaniem.
Porównanie Iceberga, Delta Lake i Hudi obok siebie
Architektki platform powinny porównywać formaty według kształtu obciążenia i zestawu silników, a nie według obietnic pojedynczych funkcji. Wszystkie trzy potrafią zapewnić transakcyjne zachowanie tabeli, obsługę schematu, historię wersji i planowanie zapytań oparte na metadanych. Ich różnice widać wyraźniej w tym, jak reprezentują stan i optymalizują zapisy.
Wymiar | Apache Iceberg | Delta Lake | Apache Hudi |
|---|---|---|---|
Model metadanych | Niezmienne pliki metadanych, listy manifestów, manifesty i historia snapshotów | Płaski dziennik transakcji w | Commity oparte na osi czasu, z metadanymi i strukturami indeksów dla zmian rekordów |
Styl partycjonowania | Ukryte partycjonowanie i transformacje partycji, przy czym ewolucja partycji jest traktowana jako zmiana metadanych | Kolumny partycji oraz układ i funkcje optymalizacji charakterystyczne dla ekosystemu | Kolumny partycji, indeksy na poziomie rekordów i organizacja wspierana przez silnik dla obciążeń zmiennych |
Ewolucja schematu | Jawne metadane schematu i partycji, z ewolucją, która nie wiąże zapytań z fizycznymi kolumnami partycji | Metadane schematu i transakcji zarządzane przez protokół Delta oraz otaczające kontrole platformy | Schemat i oś czasu commitów obsługują zmiany w potokach ingestii i intensywnych aktualizacji |
Gwarancje współbieżności | Commity oparte na snapshotach i izolacja poprzez niezmienne wersje metadanych | Commity poprzez dziennik transakcji i optymistyczna koordynacja wokół stanu tabeli | Commity osi czasu, zaprojektowane dla wstawień, aktualizacji i usunięć |
Dopasowanie do ekosystemu | Mocna opcja dla środowisk z wieloma różnymi silnikami i architektur zorientowanych na katalog | Naturalne dopasowanie do platform skupionych na Databricks i Spark, z szerszą interoperacyjnością zależną od wsparcia protokołu | Mocna opcja dla ingestii bogatej w upserty, przetwarzania przyrostowego i obciążeń korzystających z indeksowania na poziomie rekordów |
Apache Iceberg
Iceberg bywa atrakcyjny, gdy wiele silników musi współdzielić tabele, a fizyczne kolumny partycji nie powinny przenikać do logiki zapytań. Ukryte partycjonowanie pozwala formatowi zarządzać transformacjami, podczas gdy zapytania odwołują się do kolumn logicznych. Jego specyfikacja wspiera też ewolucję partycji jako zmianę wyłącznie metadanych, która nie przepisuje natychmiast istniejących plików danych (dokumentacja Iceberga).
Kompromisem jest utrzymanie metadanych. Pliki manifestów i struktury snapshotów dostarczają bogatych informacji do planowania, ale małe lub często zmieniane tabele mogą gromadzić metadane wymagające świadomego utrzymania. Iceberg pasuje dobrze, gdy interoperacyjność, ewolucja partycji i nadzór zorientowany na snapshoty ważą więcej niż prostota stosu jednego dostawcy.
Delta Lake
Dziennik transakcji Delty jest łatwy do ogarnięcia dla zespołów, które już eksploatują Spark i Databricks. Dziennik rejestruje działania na tabeli, a punkty kontrolne czynią odtwarzanie stanu wydajniejszym w dużej skali. Ta integracja może skrócić drogę od istniejących potoków Spark do transakcyjnych tabel lakehouse.
Uczciwym ograniczeniem jest sprzężenie. Delta działa w szerszym ekosystemie, ale najbardziej płynne doświadczenie często zależy od protokołów, środowisk uruchomieniowych, katalogów i praktyk optymalizacyjnych Databricks. Platforma, która oczekuje, że niezależne silniki będą zapisywać i nadzorować te same tabele, powinna zweryfikować te ścieżki, zamiast wnioskować o zgodności z układu plików.
Apache Hudi
Hudi błyszczy w potokach przechwytywania zmian i w tabelach zmiennych. Jego podejście do indeksowania na poziomie rekordów potrafi kierować aktualizacje i usunięcia do właściwych grup plików, ograniczając potrzebę szerokiego wyszukiwania docelowych rekordów. Ta mocna strona wiąże się z większą liczbą pojęć operacyjnych typowych dla formatu, w tym z indeksowaniem, kompaktowaniem i osiami czasu commitów.
Wybierz Hudi, gdy zachowanie upsert jest kluczowe dla obciążenia, a zespół jest gotów eksploatować jego model zapisu i utrzymania. Wybierz Deltę, gdy środkiem ciężkości są Spark i Databricks. Wybierz Iceberga, gdy neutralność wobec silników, koordynacja katalogów i zmieniające się strategie partycjonowania są głównymi wymaganiami.
Test decyzyjny: wypisz silniki, które muszą czytać i zapisywać tę samą tabelę, a następnie mutacje, kontrole nadzoru i zachowania wycofania, których te silniki potrzebują. Format pasujący do tego przecięcia liczy się bardziej niż ogólna obietnica przenośności.
Gdzie otwarte formaty tabel przestają rozwiązywać problem
Otwarty format tabeli może powiedzieć, że commit się powiódł. Nie powie, czy zatwierdzone rekordy spełniają regułę biznesową.
To ograniczenie jest zamierzone. Warstwa formatu zarządza strukturą i stanem tabeli, a nie znaczeniem każdego rekordu ani oczekiwaniami dotyczącymi poziomu usług przy dostawie. Nie waliduje automatycznie, że transakcja ma dozwolony status, nie zgłasza spóźnionego snapshotu, nie wykrywa nieoczekiwanej zmiany rozkładu i nie uzgadnia zmiany schematu z każdym kontraktem niżej w łańcuchu.
Luka w nadzorze ponad tabelą
Ewolucja schematu pokazuje problem wyraźnie. Format tabeli może dopuścić zmianę addytywną bez psucia istniejących zapytań, ale zespół produkcyjny wciąż musi zapytać, kto ją zatwierdził, którzy odbiorcy zależą od dotkniętej kolumny, czy rozszerzenie typu zmienia zachowanie modelu i czy istnieje ślad audytowy.
Objaśnienie Databricks z 2026 roku podkreśla, że lekkie zmiany schematu mogą zachęcać do bezpośrednich modyfikacji na produkcji bez wystarczających testów, podczas gdy katalogi zyskują na znaczeniu dla wiarygodnych snapshotów i kontroli dostępu (dyskusja Databricks o otwartych formatach tabel). Niezależne raporty z 2026 roku również opisują rozdźwięk między strukturą na poziomie tabeli a pochodzeniem danych, glosariuszami, klasyfikacją i zarządzaniem politykami między silnikami w skali katalogu (analiza nowoczesnej architektury danych).
Zespoły często wypełniają tę lukę niepowiązanymi narzędziami:
Przepływy katalogowe: odnajdywalność zasobów i własność żyją w jednym systemie.
Zadania walidacyjne: kontrole biznesowe wykonują się w notatnikach lub zadaniach orkiestracji.
Monitory świeżości: alerty o napływie opierają się na harmonogramach i metadanych potoków.
Reagowanie na incydenty: analitycy i inżynierowie używają osobnych pulpitów, by badać skutki.
Ta fragmentacja utrudnia prześledzenie incydentu metadanych. W manifeście Iceberga pojawia się nowa kolumna, model niżej w łańcuchu wciąż działa, pulpit się zmienia i żaden pojedynczy widok nie łączy zdarzenia strukturalnego z powstającym ryzykiem biznesowym.
Nadzór może przesunąć się wyżej, nie zniknąć
Otwarte formaty zmniejszają uzależnienie na poziomie pamięci masowej, ale organizacje wciąż mogą je tworzyć ponad plikami, poprzez katalogi, systemy kontroli dostępu, konwencje pochodzenia danych i praktyki operacyjne. Wyzwanie rośnie w finansach, ochronie zdrowia, telekomunikacji i sektorze publicznym, gdzie zespoły potrzebują spójnych kontroli w wielu silnikach i dowodów przy istotnych zmianach.
Warstwa kontroli musi więc obserwować więcej niż stan plików. Powinna łączyć schemat, Timeliness, poprawność rekordów, anomalie, własność i zależności odbiorców, pozostawiając dane tam, gdzie organizacja już nimi zarządza.
Podejście do monitorowania data lake powinno zaczynać się na granicy tabeli, a potem śledzić metadane i zachowanie danych na zewnątrz, aż do potoków, odbiorców i kontroli biznesowych.
Jak digna zamyka lukę operacyjną
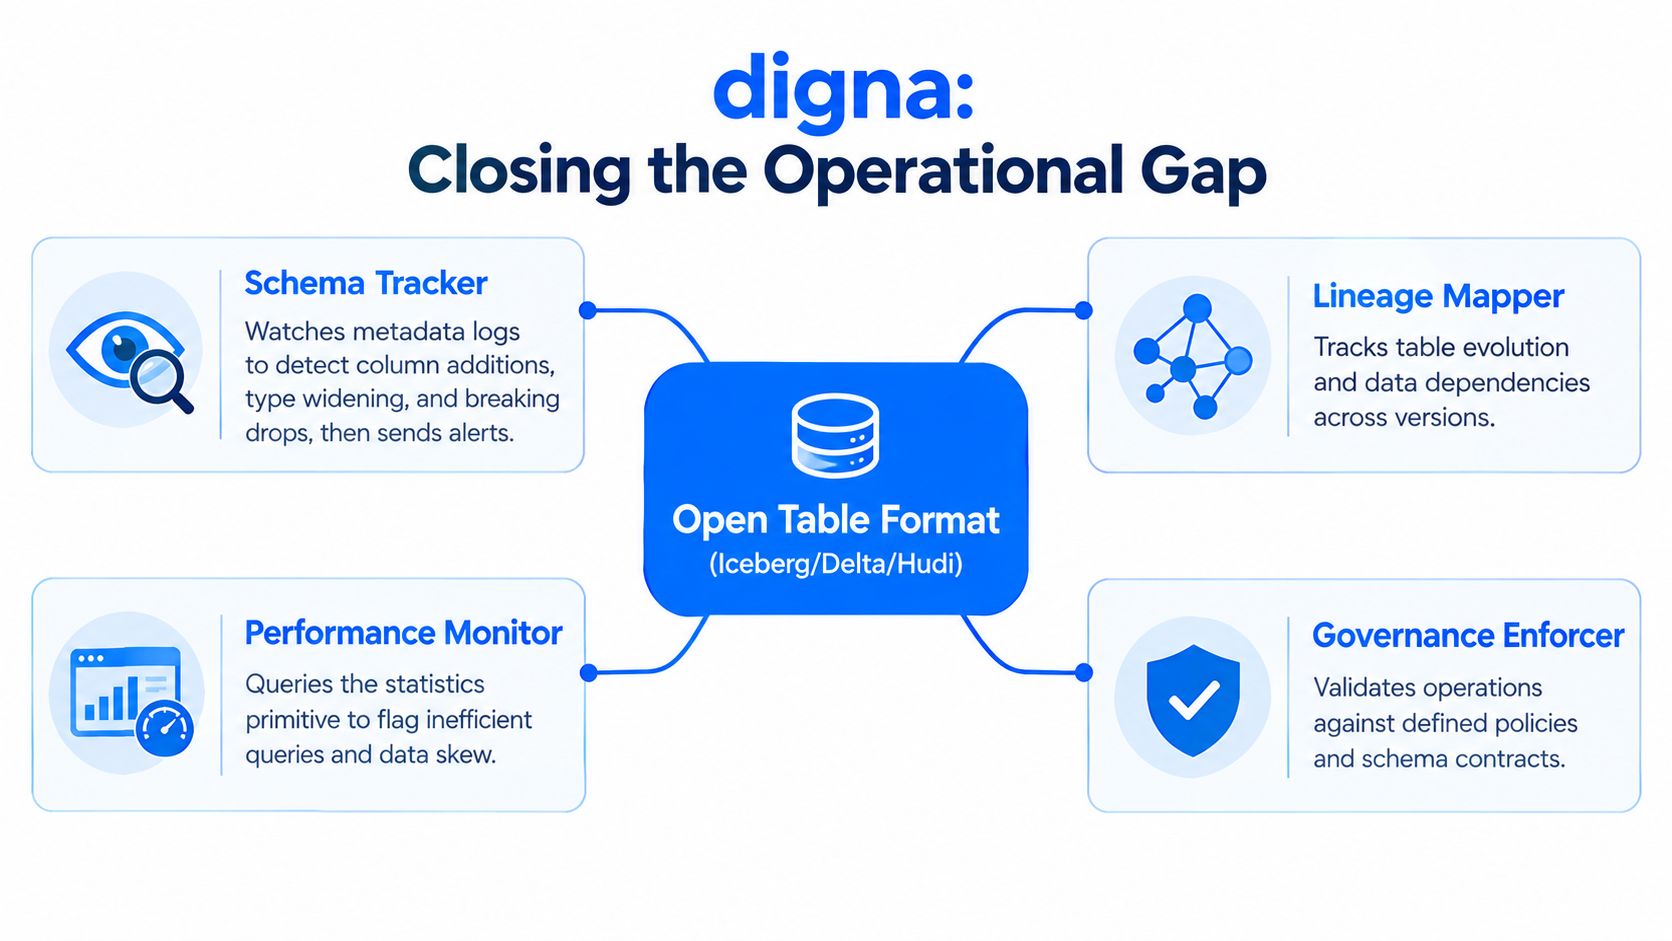
digna może działać nad Icebergiem, Delta Lake i Hudi jako warstwa obserwowalności wewnątrz bazy danych. Użyteczny model myślowy to nie kolejny format tabeli. To zestaw kontroli operacyjnych, który zamienia metadane tabeli i zachowanie snapshotów w sygnały dla inżynierów, opiekunów danych i zespołów nadzoru.
Zacznij od zmiany strukturalnej
Schema Tracker obserwuje metadane strukturalne i wykrywa dodane kolumny, usunięte kolumny i zmiany typów danych. Dla otwartej tabeli oznacza to powiązanie zmian w plikach metadanych Iceberga, wpisach dziennika transakcji Delty lub informacjach o commitach Hudi z osobami odpowiedzialnymi i odbiorcami zależnymi od tabeli.
Zdarzenie schematu nie powinno automatycznie stawać się incydentem. Ważne pytanie brzmi, czy zmiana jest zgodna z kontraktami tabeli. Nowy atrybut dopuszczający wartości puste może być akceptowalny, podczas gdy usunięty identyfikator lub niezgodna zmiana typu może wymagać zatwierdzenia i testów po stronie odbiorców.
Dodaj zachowanie dostaw i rekordów
Timeliness porównuje faktyczny napływ snapshotów z oczekiwanymi wzorcami dostaw i oczekiwaniami dotyczącymi poziomu usług. Potrafi zgłaszać spóźnione partycje, brakujące ładowania i dostawy przedwczesne, co pomaga zespołom odróżnić udany commit od udanej dostawy produktu danych.
Data Anomalies profiluje nowe snapshoty, by ujawnić nietypowe zmiany wolumenu, zachowanie wartości pustych i przesunięcia rozkładu. Uzupełnia to statystyki na poziomie plików. Metadane mogą pomóc silnikowi zapytań w przycinaniu, ale obserwowalność pyta, czy świeżo zatwierdzone dane wyglądają normalnie w swoim kontekście biznesowym.
Data Validation stosuje reguły na poziomie rekordów i kontrakty schematu. Te kontrole mogą wymuszać warunki takie jak poprawne relacje, dozwolone wartości czy wymogi audytowe, zanim odbiorcy uznają snapshot za gotowy.
Powiąż incydenty z kondycją platformy
Data Platform Observability zbiera kondycję potoków, pochodzenie danych, świeżość, użycie i zachowanie platformy w jednym widoku operacyjnym. Gdy tabela Iceberga po stronie źródłowej zmienia schemat, zespół może prześledzić to zdarzenie do dotkniętych pulpitów lub modeli, zamiast osobno przeszukiwać dzienniki pamięci masowej, historię orkiestracji i alerty BI.
Model wykonania digny wewnątrz bazy danych utrzymuje obliczanie metryk i analizę w bazach danych klienta. Model wdrożenia obsługuje środowiska chmury prywatnej i lokalne, co może mieć znaczenie, gdy danych podlegających regulacjom nie wolno kopiować do zewnętrznej usługi monitorującej.
Granica architektoniczna pozostaje jasna. Iceberg, Delta lub Hudi jest właścicielem stanu tabeli i metadanych. digna monitoruje, czy ten stan jest strukturalnie bezpieczny, terminowy, poprawny i zgodny z oczekiwaniami.
Praktyczna droga do wdrożenia i migracji
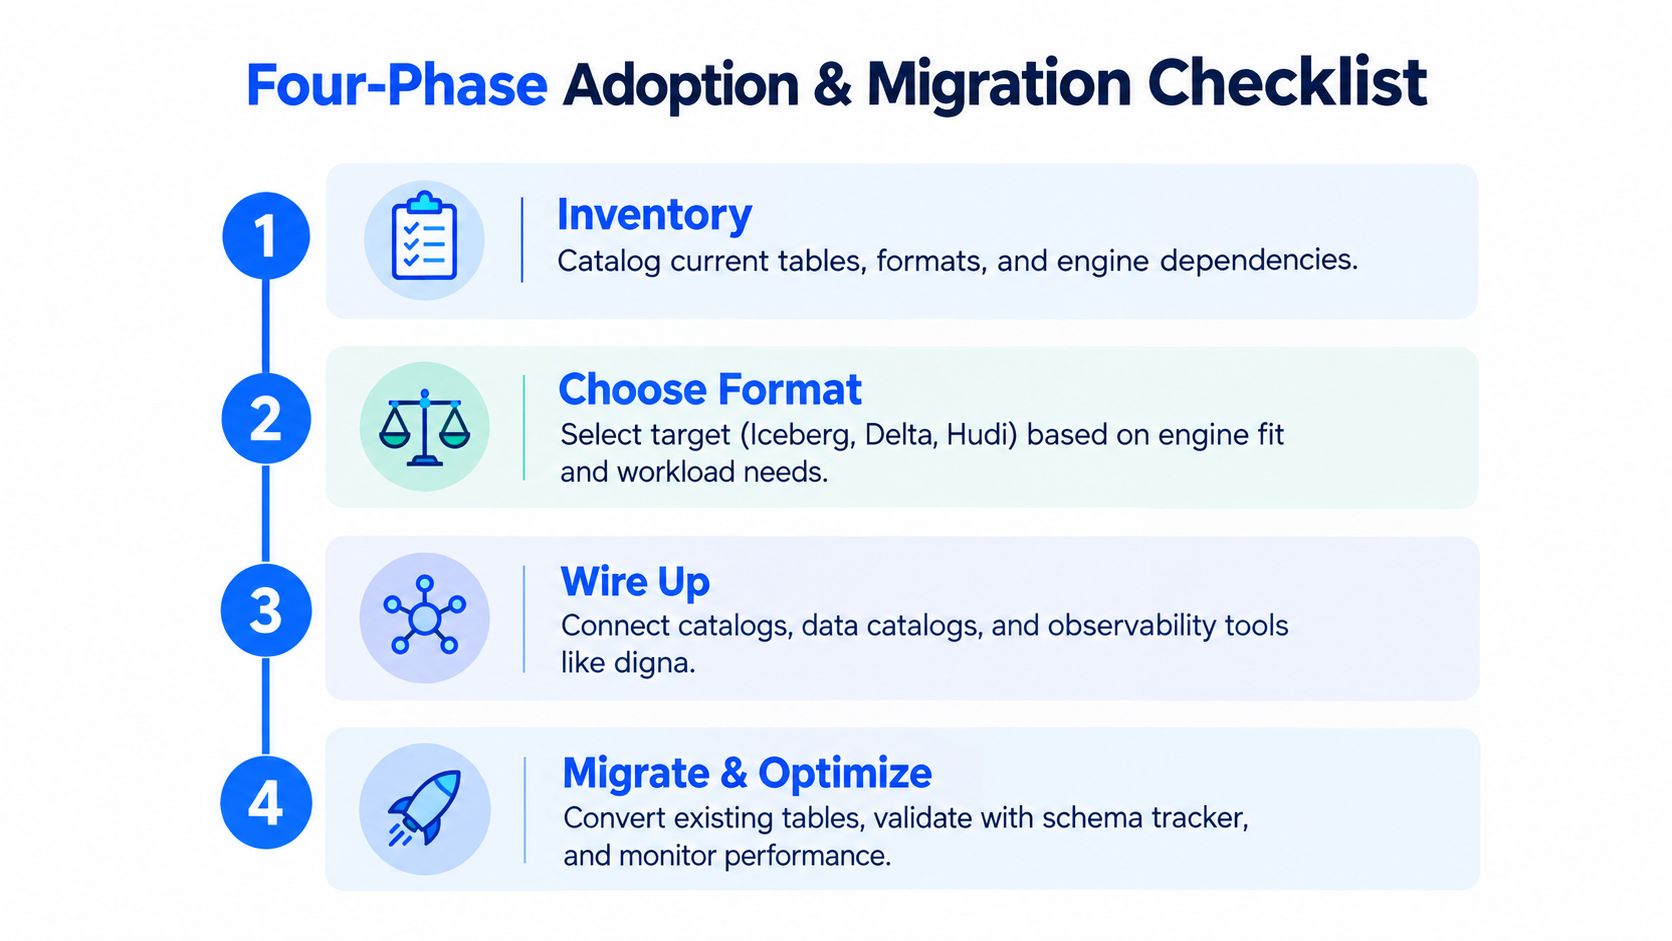
Migracja udaje się najlepiej jako kontrolowana sekwencja, a nie masowa konwersja. Traktuj każdą tabelę jak produkt z formatem przechowywania, tożsamością katalogową, zestawem odbiorców i oczekiwaniami operacyjnymi.
Faza pierwsza: inwentaryzacja środowiska
Wypisz obecne tabele, formaty plików, wzorce zapisu, schematy partycjonowania, zależności od silników i odbiorców końcowych. Ustal, które tabele przyjmują wyłącznie dopisywane dane, które potrzebują aktualizacji lub usunięć i które czyta więcej niż jeden silnik.
Ta inwentaryzacja ujawnia rzeczywiste kryteria decyzyjne. Tabela używana tylko przez Spark ma inną ścieżkę migracji niż taka, którą zapisuje Flink, odpytuje Trino, a konsumuje hurtownia.
Faza druga: wybór celu
Wybierz Iceberga, Delta Lake lub Hudi według dopasowania do silników, wzorców mutacji, potrzeb partycjonowania, zachowania katalogu i zdolności operacyjnych zespołu. Zespoły finansowe mogą priorytetowo traktować spójność transakcyjną i egzekwowanie schematu. Potoki handlowe mogą preferować ukryte partycjonowanie i upserty ze strumieniowego CDC. Platformy analityki SaaS mogą mocniej ważyć odczyty z wielu silników.
Format to tylko jedna decyzja. Ustal, który katalog definiuje tożsamość tabeli, jak silniki ją znajdują, kto zatwierdza zmiany schematu i jak działa wycofanie.
Faza trzecia: podłącz kontrole przed przełączeniem
Połącz katalog, przepływy walidacji, dowody własności i obserwowalność, zanim przeniesiesz ruch produkcyjny. Uruchom równoległe odczyty ze starej tabeli i z docelowej tabeli Iceberg, Delta lub Hudi. Porównaj schemat i wyniki na poziomie wierszy przy pomocy Data Validation, a następnie ustaw progi świeżości i zachowania anomalii.
Ramy planowania migracji danych powinny obejmować kryteria wycofania, czas trwania odczytów równoległych, akceptację odbiorców i przechowywanie dowodów. Nie czekaj na pierwszy zepsuty pulpit, by odkryć, że nikt nie odpowiada za nową tabelę.
Faza czwarta: migruj tabela po tabeli
Przekonwertuj jedną ograniczoną tabelę, zweryfikuj odczyty i zapisy, obserwuj przyrost metadanych i zachowanie zapytań. Utrzymuj starą ścieżkę dostępną aż do osiągnięcia parzystości i progów operacyjnych, a potem przenoś odbiorców etapami.
Wybór formatu ma znaczenie, ale dyscyplina w metadanych znaczy więcej. Dobrze nadzorowana tabela Hudi może przewyższyć źle utrzymane wdrożenie Iceberga dla swojego obciążenia, tak jak starannie eksploatowane środowisko Delta może źle pasować do organizacji potrzebującej niezależnych silników i katalogów.
Wybierz format pasujący do swojego obciążenia, ale zaprojektuj jednocześnie warstwę nadzoru. To właśnie zamienia otwartą pamięć masową w wiarygodną tabelę lakehouse.
digna monitoruje zmiany schematu, terminowość snapshotów, poprawność rekordów i nietypowe zachowanie danych we własnym środowisku klienta, dając zespołom warstwę operacyjną nad Icebergiem, Delta Lake i Hudi. Odwiedź digna, by ocenić, jak jej modułowe możliwości obserwowalności i walidacji mogą wesprzeć migrację do otwartych tabel.
Tam, gdzie kończy się format, zaczynają się kontrole biznesowe — Business Monitoring pilnuje, czy liczby generowane przez tabelę wciąż zachowują się zgodnie z oczekiwaniami.
Najczęściej zadawane pytania
Czy unikanie uzależnienia od dostawcy to główny powód stosowania otwartego formatu tabeli?
Ten powód jest niepełny. Przenośność plików ma znaczenie, ale większa zmiana polega na tym, że znaczenie tabeli — historia transakcji, intencja schematu i metadane do planowania zapytań — opuszcza pojedynczy silnik i trafia do plików, które każdy może odczytać. Uzależnienie to objaw; prawdziwą zmianą jest to, gdzie mieszka definicja tabeli.
Jakie elementy dzielą Iceberg, Delta Lake i Hudi?
Wszystkie trzy prowadzą niezmienny dziennik commitów, manifest opisujący, które pliki należą do której wersji, statystyki per plik do przycinania i zapis schematu rozwijający się niezależnie od plików danych. Różnice dotyczą tego, jak każdy z nich zapisuje i kompaktuje tę strukturę, a nie leżącej u podstaw koncepcji.
Czym te trzy formaty różnią się w praktyce?
Iceberg ma najszersze wsparcie silników i najbardziej neutralną wobec nich konstrukcję. Delta Lake wchodzi najgłębiej w środowiska Spark i Databricks. Hudi optymalizuje częste upserty i konsumpcję przyrostową. Uczciwe porównanie dotyczy wzorca zapisu, pod który każdy z nich powstał, a nie tego, który wymienia więcej funkcji.
Gdzie otwarte formaty tabel przestają rozwiązywać problem?
Na granicy między strukturą a znaczeniem. Format może zagwarantować, że każdy silnik czyta te same zatwierdzone wiersze w tym samym schemacie; nie powie, że te wiersze są kompletne, że dotarły na czas ani że zawierają sensowne wartości. Ta luka to miejsce dla monitorowania jakości.
Jak wygląda realistyczna droga wdrożenia?
Wybierz tabelę o jasnej własności i znanym wzorcu zapytań, przekonwertuj ją, gdy oryginał wciąż działa, i porównaj wyniki przez pełny cykl biznesowy, zanim przeniesiesz odbiorców. Przypisz utrzymanie — kompaktowanie, wygasanie snapshotów, aktualizacje katalogu — przed końcem pilotażu, inaczej nie będzie zadaniem nikogo.



