Otwarty format tabeli Iceberg wyjaśniony prosto
|
8
min. czyt.

Twój pulpit mówi, że wczorajszy przychód spadł, ale problem jest mniej oczywisty. Jeden silnik przeczytał katalog, zanim nowy wsad został w pełni zatwierdzony, drugi inaczej zinterpretował partycję, a trzeci wciąż widzi starszy schemat. Pliki istnieją, a mimo to tabela nie potrafi dać jednej wiarygodnej odpowiedzi.
To właśnie problem, który adresuje otwarty format tabeli Iceberg. Dokłada ustrukturyzowaną warstwę metadanych i transakcji nad danymi trzymanymi w otwartych plikach, zostawiając zespołom swobodę korzystania z silników takich jak Spark, Flink, Trino czy Hive. Ważna decyzja w 2026 roku nie brzmi jednak tylko, czy Iceberg jest dobrym formatem tabeli. Brzmi: który katalog kontroluje metadane, polityki i ścieżkę dostępu w tych silnikach.
Spis treści
Wprowadzenie do nowoczesnych formatów tabel i dlaczego mają znaczenie
Gwarancje transakcyjne, ewolucja schematu i strategie partycjonowania
Integracje ekosystemu, wzorce migracji i przykładowe przepływy
Dobre praktyki, strojenie wydajności i diagnostyka na produkcji
Wprowadzenie do nowoczesnych formatów tabel i dlaczego mają znaczenie
Tradycyjne jezioro danych często zaczyna się od zadania wczytującego, które zapisuje pliki Parquet do magazynu obiektowego, metastore'u rejestrującego lokalizację tabeli i silnika zapytań odkrywającego pliki przez przeglądanie folderów. Dla danych tylko dopisywanych może to działać, ale presja operacyjna przychodzi szybko.
Producent może zapisać do niewłaściwego katalogu z datą. Zadanie naprawcze może zmienić pliki w trakcie działania zapytania pulpitu. Analityk może odczytać mieszankę starych i nowych plików. Jeśli zmieni się układ partycji tabeli, każdy producent i odbiorca może musieć zrozumieć tę zmianę ręcznie. Jezioro zachowuje się wtedy mniej jak baza danych, a bardziej jak wspólny folder z nieudokumentowanymi regułami.
Otwarte formaty tabel poprawiają ten układ, kładąc abstrakcję tabeli nad plikami. Śledzą schematy, migawki, metadane na poziomie plików i zatwierdzenia, dzięki czemu silniki zapytań rozumieją, które pliki należą do spójnej wersji tabeli. Dane zostają w otwartych formatach składowania, ale użytkownicy zyskują zachowanie znane z baz danych.
Dla klientów digny i podobnych zespołów korporacyjnych niezawodność znaczy więcej niż udane zapytania. Tabela raportowa musi dotrzeć na czas, zachować oczekiwaną strukturę, przejść walidacje biznesowe i udostępnić dość historii, by zbadać incydent. Iceberg pomaga położyć transakcyjny i strukturalny fundament tabeli. Obserwowalność wciąż musi działać wokół tego fundamentu, sprawdzając, czy dane dotarły, czy wartości nie zmieniły się nieoczekiwanie i czy odbiorcy niżej pozostają zgodni. Zespoły badające szersze pojęcie mogą wykorzystać ten przegląd otwartych formatów tabel jako dodatkowy kontekst.
Reguła praktyczna: traktuj otwarty format tabeli jako warstwę niezawodności dla plików, a nie jako kompletną platformę nadzoru.
Apache Iceberg powstał w Netflix w 2017 roku, by zaradzić problemom skalowalności i spójności w tabelach w stylu Hive. Netflix przekazał go Apache Software Foundation w listopadzie 2018, a projekt uzyskał status najwyższego poziomu w Apache w maju 2020. Specyfikacja rozwijała się dalej przez stabilne wydanie 1.0.0 w październiku 2022 i 1.6.1 w sierpniu 2024, zgodnie z historią projektu Apache Iceberg.
Ten przewodnik zaczyna od podstawowego modelu tabeli, a potem przechodzi przez architekturę metadanych Iceberga, zachowanie transakcyjne, porównania formatów, wzorce migracji i eksploatację produkcyjną. Na końcu skupia się na nadzorze, bo specyfikacja pliku to tylko jeden element korporacyjnej platformy danych.
Czym jest otwarty format tabeli i jak działa
Pomyśl o surowym jeziorze danych jak o magazynie pełnym opisanych kartonów. Pliki Parquet to kartony, foldery to zgrubne strefy składowania, a silnik zapytań to pracownik szukający kartonów, które mogą zawierać odpowiedź. Bez wiarygodnego inwentarza pracownik może szukać za długo, przeoczyć istotne pliki albo połączyć kartony z niezgodnych dostaw.
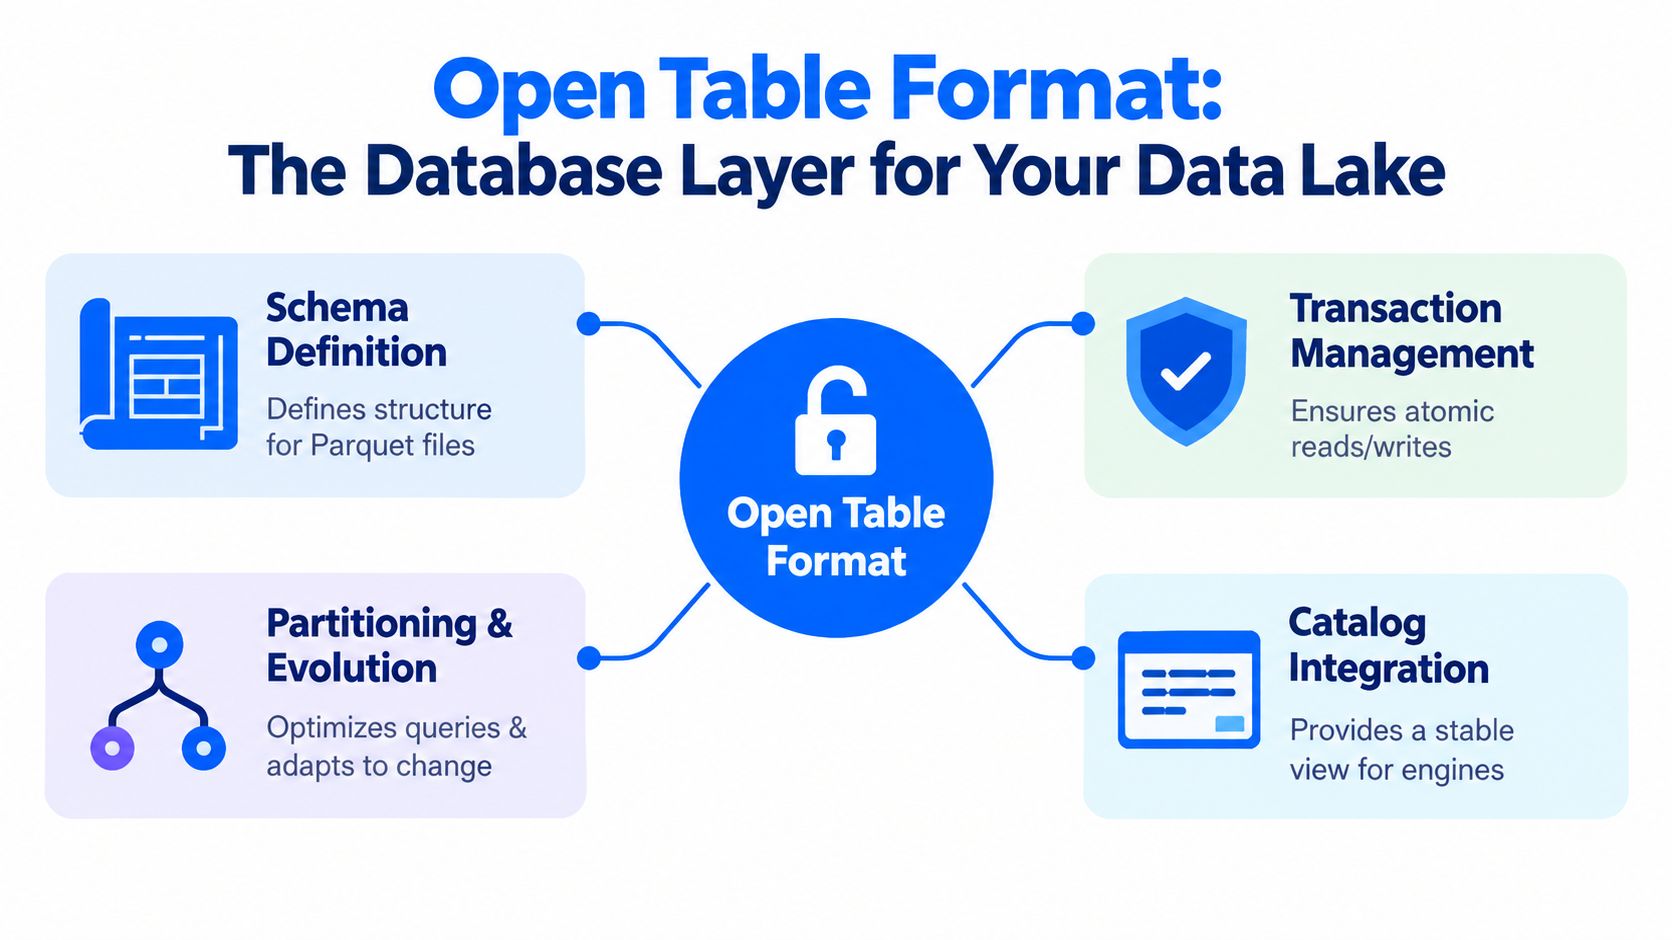
Otwarty format tabeli dokłada ten inwentarz i zestaw reguł. Zwykle obejmuje trzy powiązane warstwy:
Pliki danych trzymają właściwe rekordy, zwykle w formatach kolumnowych jak Parquet.
Metadane tabeli opisują schematy, migawki, pliki, statystyki i informacje o partycjach.
Katalog daje silnikom stabilny sposób odnajdywania bieżących metadanych tabeli i stosowania polityk dostępu.
Tę trzecią warstwę łatwo zlekceważyć. Format definiuje, jak reprezentowany jest stan tabeli, a katalog definiuje, jak silniki ten stan odnajdują. Zadanie Sparka, potok Flinka i zapytanie Trino mogą pracować na tej samej tabeli tylko wtedy, gdy potrafią ją rozwiązać przez zgodny katalog i zinterpretować odpowiednią wersję formatu.
Od plików do zarządzanej tabeli
Załóżmy, że potok odbiera rekordy sprzedaży. Zapisuje pliki danych Parquet do magazynu obiektowego, ale nie wrzuca ich do folderu z datą w nadziei, że każdy czytający zrozumie układ. Iceberg rejestruje pliki w manifestach, wiąże je z migawką tabeli i publikuje nowy stan metadanych przez katalog.
Czytający najpierw odkrywa bieżący stan tabeli. Potem używa metadanych do zaplanowania skanu, wybierając tylko pliki, które mogą zawierać pasujące rekordy. To co innego niż kazać silnikowi wylistować każdy obiekt i obejrzeć każdy plik.
Słowo otwarty oznacza więcej niż otwarty kod. Otwarty format tabeli ma dostarczyć udokumentowaną specyfikację, którą może wdrożyć wiele silników. Specyfikacja Iceberga rozwinęła się przez formalne wersje. Dokumentacja Apache podaje, że wersje 1, 2 i 3 są kompletne i przyjęte przez społeczność, podczas gdy wersja 4 pozostaje w aktywnym rozwoju. Dokumentacja wskazuje też 1.11.0 jako najnowszą wersję dokumentacji w 2026 roku, co odzwierciedla dalsze inwestycje w specyfikację i dokumentację Iceberga.
Otwartość zmniejsza zależność od jednego silnika zapytań, ale nie usuwa automatycznie zachowań specyficznych dla dostawcy. Czytający i zapisujący wciąż potrzebują zgodnego wsparcia funkcji, a katalog może stosować własne polityki, poświadczenia albo reguły nadzoru. To rozróżnienie staje się kluczowe, gdy kilka silników dzieli tabele produkcyjne.
Wewnątrz architektury otwartego formatu tabeli Iceberg
Architekturę Iceberga najłatwiej zrozumieć, idąc od katalogu w dół. Katalog wskazuje bieżący plik metadanych. Te metadane wskazują aktywną migawkę i łączą tabelę z jedną lub wieloma listami manifestów. Listy manifestów wskazują pliki manifestów, a manifesty opisują pliki danych dostępne dla migawki.

Śledząc odczyt tabeli
Uproszczony odczyt wygląda tak:
Silnik pyta katalog o bieżącą lokalizację metadanych tabeli.
Plik metadanych wskazuje bieżącą migawkę.
Migawka odwołuje się do listy manifestów.
Lista manifestów wskazuje pliki manifestów.
Silnik ocenia wpisy manifestów i czyta kwalifikujące się pliki danych.
Same dane pozostają w plikach takich jak Parquet. Dla czytających, którzy chcą osobnego omówienia formatu składowania pod spodem, ten przewodnik po Parquet daje przydatne tło. Wkładem Iceberga jest organizacja na poziomie tabeli wokół tych plików.
Manifesty przechowują wartości partycji dla plików danych. Gdy zapytanie zawiera predykat, silnik może porównać go z krotkami partycji i odrzucić pliki, które nie mogą pasować. To przycinanie sterowane metadanymi. Silnik wkłada mniej wysiłku w otwieranie nieistotnych plików, a planowanie nie zależy od ręcznej interpretacji nazw katalogów.
Iceberg wspiera też ukryte partycjonowanie. Producent może zapisać znacznik czasu, podczas gdy tabela wewnętrznie stosuje transformację partycji, na przykład wydobycie daty albo skrócenie wartości. Producenci i odbiorcy nie muszą wprost zarządzać osobną kolumną partycji, co ogranicza błędy wynikające z niespójnych wyrażeń partycji.
Dlaczego migawki mają znaczenie
Każdy zapis tworzy nową migawkę. Czytający rozwiązuje jedną migawkę i planuje wobec tego spójnego stanu, zamiast oglądać tabelę w trakcie dodawania lub usuwania plików. Ten projekt wspiera izolację migawkową oraz serializowalne, atomowe zmiany tabeli, więc czytający nie widzą częściowych ani niezatwierdzonych zapisów.
Model migawek umożliwia też podróż w czasie. Analityczka badająca rozbieżność na pulpicie może odpytać wcześniejszy stan tabeli, o ile odpowiednie migawki i pliki są nadal dostępne. Czyni to badanie historii precyzyjniejszym niż opieranie się na skopiowanych wyciągach albo ręcznie zachowanych folderach.
Dokumentacja wydajności Apache Iceberg zauważa, że architektura metadanych pozwala czytać nawet tabele wielopetabajtowe z pojedynczego węzła, bez potrzeby rozproszonego silnika SQL tylko do przesiewania metadanych. Ta sama dokumentacja przywołuje przypadki z dziesięciokrotną poprawą wydajności, jak opisano w dokumentacji wydajności Iceberga. Praktyczna lekcja brzmi, że projekt metadanych może wpływać na koszt planowania tak samo, jak układ plików wpływa na koszt skanowania.
Gwarancje transakcyjne, ewolucja schematu i strategie partycjonowania
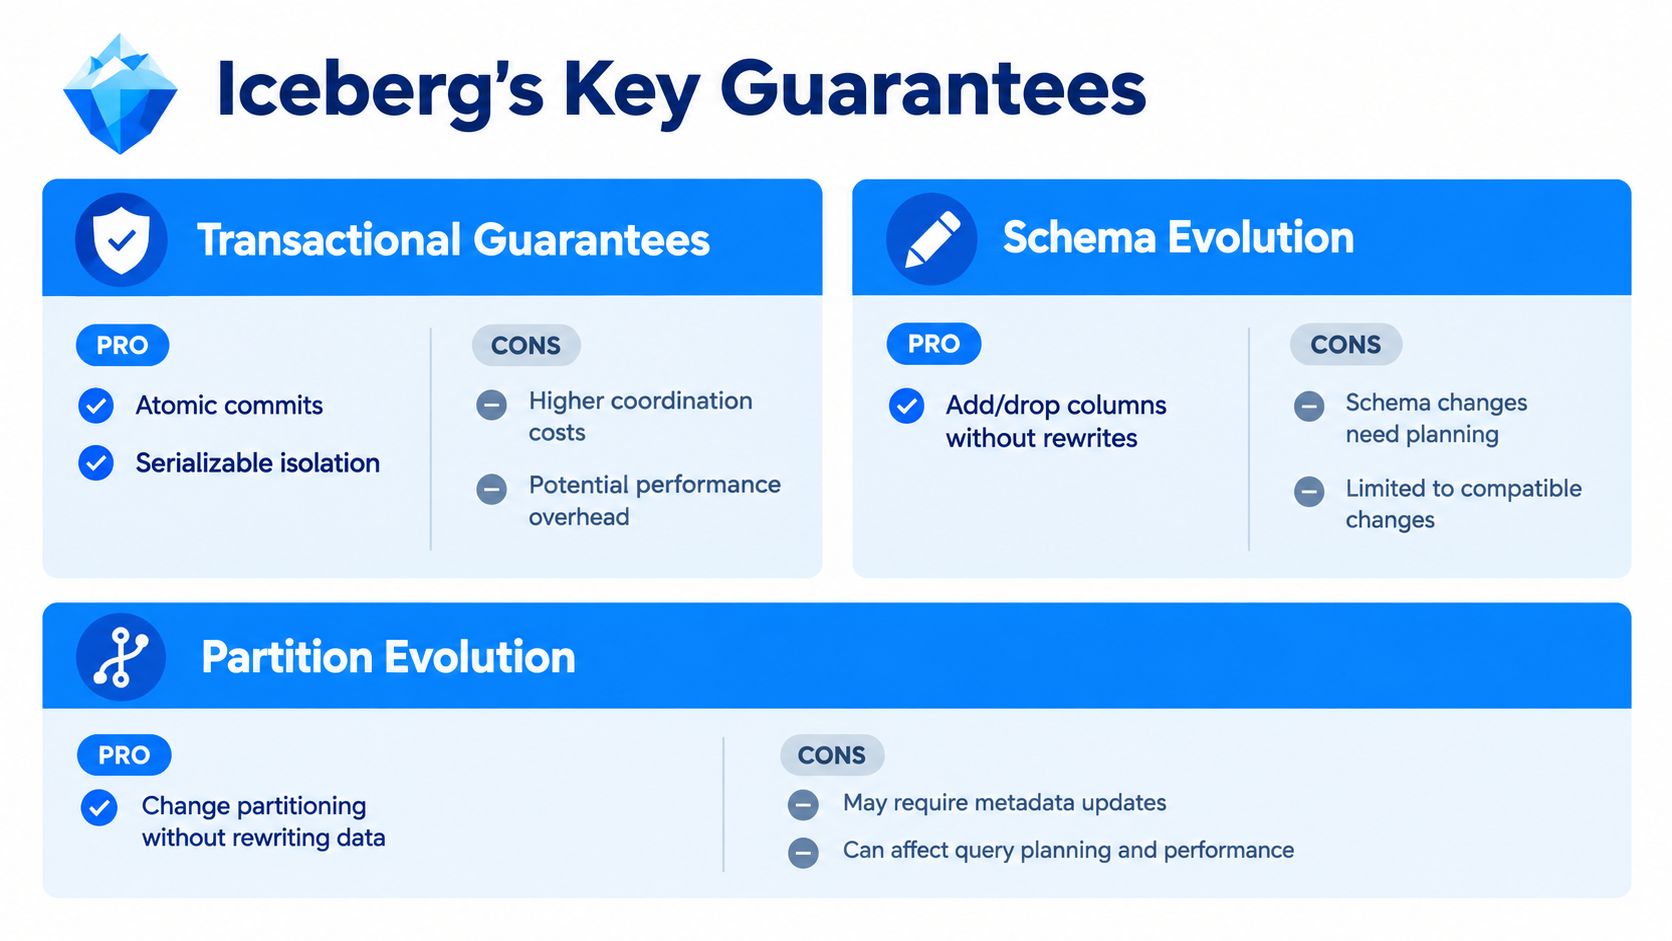
Wartość Iceberga widać wyraźniej, gdy tabela zmienia się, a ludzie i potoki dalej z niej korzystają. Zapisujący nie publikuje półgotowego stanu tabeli. Przygotowuje nową migawkę i zatwierdza ten stan atomowo. Czytający wciąż widzą poprzednią zatwierdzoną migawkę, dopóki nowa nie stanie się widoczna.
Daje to zespołom izolację migawkową i serializowalne zmiany tabeli. Współbieżni zapisujący wciąż potrzebują strategii konfliktów, a nieudane zatwierdzenie może wymagać logiki ponowień, ale czytający nie połączą przypadkiem niekompletnego zapisu ze starszym stanem tabeli.
Zmiany bez przepisywania danych
Iceberg wspiera operacje ewolucji schematu, takie jak dodawanie, usuwanie, zmiana nazw i kolejności kolumn, bez przepisywania istniejących plików danych. Metadane śledzą schemat logiczny, więc zmiana nazwy kolumny nie musi oznaczać fizycznego przepisania każdego historycznego pliku.
Ta możliwość nie znosi potrzeby dyscypliny. Przemianowane pole wciąż może zmylić narzędzia niżej, które identyfikują kolumny po nazwie, a usunięte pole może wpłynąć na raporty albo modele. Kontrole zgodności schematu i powiadomienia odbiorców pozostają ważne, zwłaszcza gdy różne silniki wspierają funkcje formatu na różnym poziomie. System śledzenia schematu, jak digna Schema Tracker, może stanąć obok tabeli i wychwycić zmiany strukturalne, zanim przerodzą się w incydenty niżej.
Ewolucja partycji działa na podobnej zasadzie. Iceberg traktuje zmianę specyfikacji partycji jako operację na metadanych. Stare pliki zostają w dotychczasowym układzie, a nowe korzystają z zaktualizowanej specyfikacji. Zespoły mogą dostosować partycjonowanie do nowych wzorców dostępu bez przepisywania całej historycznej tabeli ani wyłączania jej z użycia.
Świadomy wybór ukrytego partycjonowania
Ukryte partycjonowanie przydaje się, gdy zespoły chcą fizycznej organizacji bez odsłaniania mechaniki partycji każdemu producentowi. Pole ze znacznikiem czasu może wspierać przycinanie po dacie bez wymagania, by każde zadanie wczytujące poprawnie wypełniało odpowiadającą kolumnę partycji.
Jest kompromis. Po ewolucji partycji tabela może zawierać pliki zapisane pod różnymi specyfikacjami. Iceberg potrafi planować przez tę historię, ale operatorzy wciąż muszą obserwować, czy stary i nowy układ nie dają nierównego zachowania skanów. Zmiany partycji powinny podążać za obserwowanymi wzorcami zapytań, a nie zastępować zrozumienia dostępu do obciążenia.
Usuwanie na poziomie wiersza
Format Iceberg v2 wspiera usuwanie na poziomie wiersza przez osobne pliki usunięć zamiast przepisywania całych plików danych. Usunięcia pozycyjne identyfikują wiersz po ścieżce pliku i pozycji. Usunięcia równościowe identyfikują wiersze po dopasowaniu wartości kolumn, co może wspierać przepływy aktualizacji i usuwania z mniejszą amplifikacją zapisu, jak opisuje to wyjaśnienie usuwania na poziomie wiersza w Iceberg.
Pliki usunięć wnoszą kwestie konserwacyjne. Zapytania mogą musieć scalić dane bazowe z informacją o usunięciach, a operacje kompaktowania lub przepisania mogą później skonsolidować układ. Format zmniejsza natychmiastowy ciężar przepisywania, ale nie znosi zarządzania cyklem życia.
Porównanie Iceberg, Delta Lake i Hudi dla Twojego lakehouse
Iceberg, Delta Lake i Hudi adresują lukę między niezarządzanymi plikami danych a zachowaniem tabeli znanym z baz danych. Właściwy wybór zależy od obciążenia, silników, strategii katalogu i usług operacyjnych, które Twój zespół jest gotów prowadzić.
Kryteria | Apache Iceberg | Delta Lake | Apache Hudi |
|---|---|---|---|
Główne dopasowanie | Analityczne tabele dla wielu silników i otwarta interoperacyjność | Mocne dopasowanie do ekosystemu Databricks | Obciążenia lakehouse bogate w aktualizacje i strumieniowanie |
Model metadanych | Architektura migawki, listy manifestów i manifestu | Projekt skupiony wokół logu transakcji | Projekt oparty na osi czasu i usługach tabelowych |
Ewolucja schematu | Wspiera zmiany takie jak dodanie, usunięcie, zmiana nazwy i kolejności | Wspiera ewolucję schematu, a zachowanie zależy od środowiska i wsparcia funkcji | Wspiera szerokie możliwości ewolucji schematu |
Strategia partycji | Ukryte partycjonowanie i ewolucja partycji wyłącznie na metadanych | Zarządzanie partycjami zależy od konfiguracji tabeli i platformy | Używa partycjonowania oraz klastrowania i usług tabelowych |
Zmiany wierszy | Pliki usunięć v2, pozycyjne i równościowe | Aktualizacje i usunięcia przez operacje Delta | Mocne wsparcie upsertów, usunięć i przepływów przyrostowych |
Wybór silnika | Zaprojektowany pod szeroką interoperacyjność silników | Szczególnie naturalny we wdrożeniach Databricks | Mocna integracja ze Sparkiem i strumieniowaniem, z szerszym wsparciem ekosystemu |
Kwestia katalogu | Katalog jest kluczowy dla odnajdywania i nadzoru | Katalog i usługi platformy mocno wpływają na otwartość | Katalog bywa mniej kluczowy dla podstawowej pracy tabeli, ale nadzór wciąż potrzebuje usług wokół |
Te opisy są wskazówką architektoniczną, nie uniwersalnym benchmarkiem. Szybkość zapytań zależy od rozmiarów plików, rozkładu danych, kolejności sortowania, kompaktowania, wersji silników, kształtu obciążenia i implementacji katalogu. Zespół platformowy powinien przetestować reprezentatywne odczyty i zapisy, zamiast wybierać wyłącznie po haczykach funkcji.
Dopasuj format do modelu operacyjnego
Wybierz Iceberg, gdy kilka silników musi dzielić tabele, a zespół ceni szeroko wyspecyfikowaną warstwę tabeli z ukrytym partycjonowaniem i niezależną ewolucją. Wybierz Delta Lake, gdy głęboka integracja z Databricks, natywne usługi platformy i jednolity model operacyjny dostawcy ważą więcej niż potrzeba neutralności katalogu.
Hudi zasługuje na rozważenie, gdy projekt napędzają częste aktualizacje, przechwytywanie zmian, przetwarzanie przyrostowe albo wczytywanie strumieniowe. Jego podejście obejmuje możliwości silnika składowania i zarządzania tabelami, które mogą kształtować sposób, w jaki platforma radzi sobie z indeksowaniem, kompaktowaniem i wczytywaniem.
Ważniejsze pytanie leży często poza specyfikacją pliku. Zespół nadzoru potrzebuje jednego miejsca do zarządzania przestrzeniami nazw, własnością, klasyfikacją, uprawnieniami i historią audytu. Iceberg dostarcza transakcje tabel i metadane, ale sam z siebie nie daje kompletnego systemu polityk między silnikami. Zespoły oceniające Iceberg obok obciążeń Databricks mogą też przejrzeć kwestie jakości danych w Databricks, zwłaszcza tam, gdzie spotykają się kontrole platformy i procesy niezawodności.
Integracje ekosystemu, wzorce migracji i przykładowe przepływy
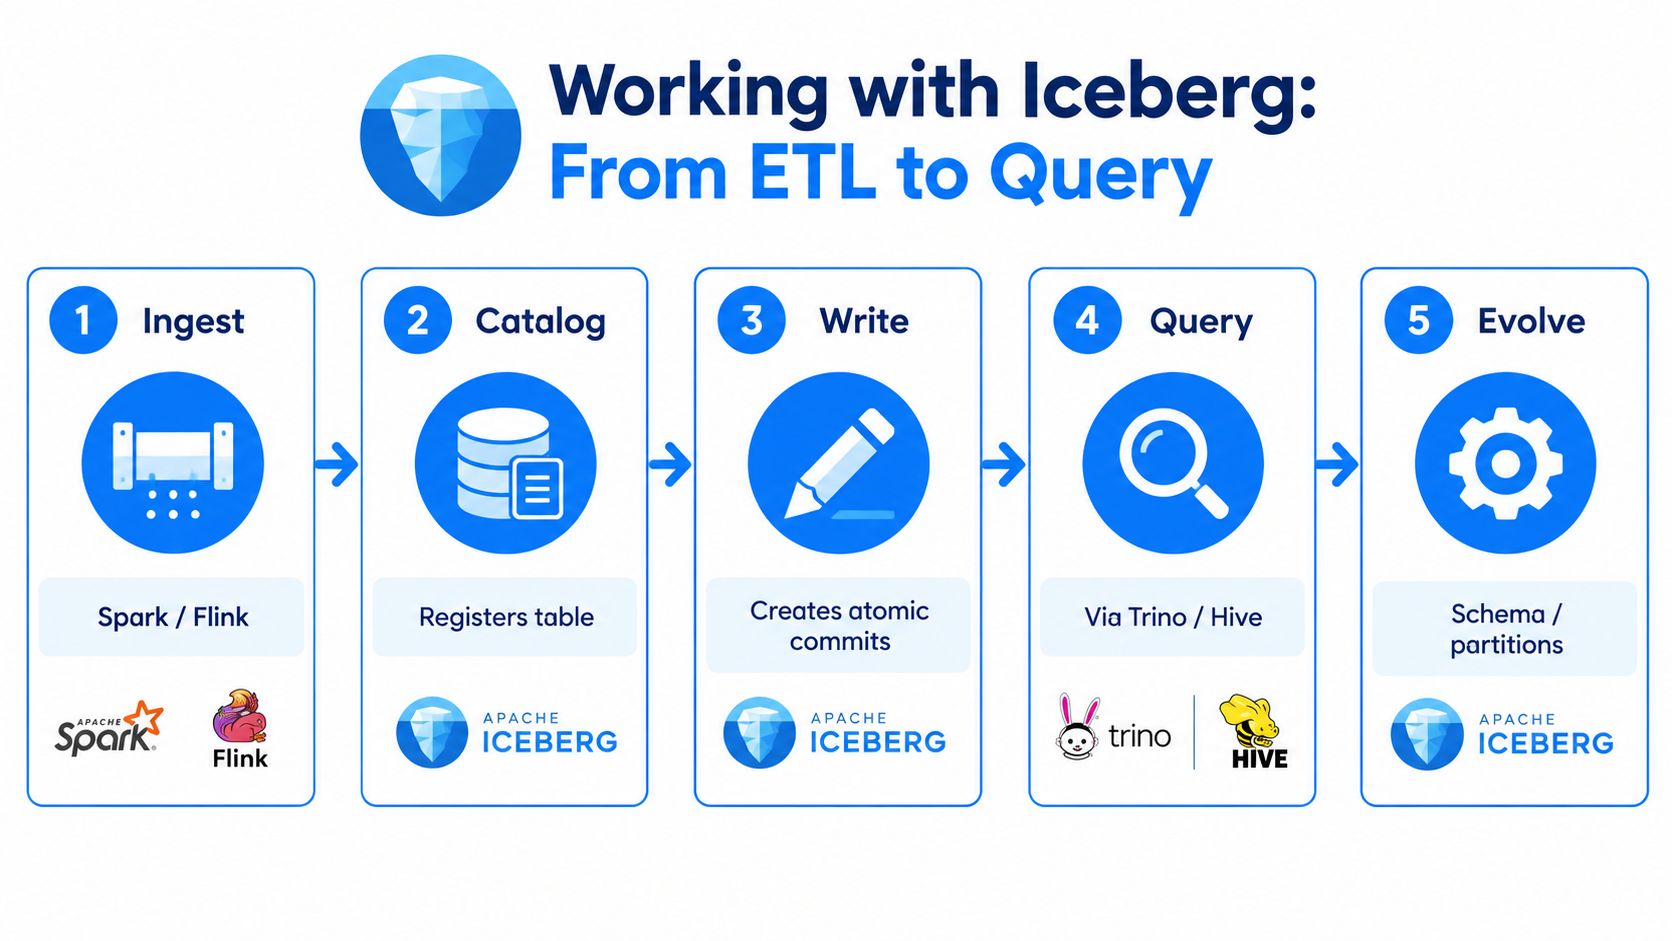
Iceberg wpina się w lakehouse przez dwa interfejsy: składowanie i katalog. Spark albo Flink mogą produkować dane, Trino albo Hive je odpytywać, a magazyn obiektowy trzymać pliki. Katalog wiąże te działania z jedną tożsamością tabeli i udostępnia metadane potrzebne każdemu zgodnemu silnikowi.
Reprezentatywny przepływ wygląda tak:
Wczytanie: Spark albo Flink odbiera rekordy wsadowe lub strumieniowe.
Katalog: tabela zostaje zarejestrowana przez katalog taki jak Hive Metastore, AWS Glue Catalog albo katalog REST Iceberga.
Zapis: silnik tworzy pliki danych i publikuje atomową migawkę.
Zapytanie: Trino, Hive, Spark albo inny zgodny silnik rozwiązuje tabelę przez katalog.
Ewolucja: osoba odpowiedzialna zmienia schemat albo specyfikację partycji wraz z rozwojem obciążenia.
Dokładna składnia różni się między silnikami, ale pojęcia pozostają stałe. Przepływ SQL mógłby utworzyć tabelę z jawnym schematem, wstawić rekordy, zmienić kolumnę i odpytać wcześniejszą migawkę. Zadanie Sparka mogłoby użyć interfejsu DataFrameWriterV2 Iceberga, a Flink swojego sinka Iceberga i konfiguracji katalogu.
Migracja bez utraty kontroli
Migracja z Hive do Iceberga może pójść różnymi ścieżkami. Zespoły mogą przekonwertować istniejące dane i zarejestrować je przez metadane Iceberga albo przepisać pliki, by poprawić układ, ujednolicić schematy i usunąć stare założenia partycji. Konwersja metadanych może ograniczyć zakłócenia, a przepisanie daje okazję do optymalizacji plików danych. Wybór zależy od stanu istniejącej tabeli i tolerancji na pracę migracyjną.
Migracja z Delty do Iceberga wymaga tej samej staranności, z dodatkową uwagą na historię transakcji, niewspierane funkcje, usunięcia, kolumny generowane i zależności niżej. Plan migracji powinien zinwentaryzować czytających i zapisujących przed zmianą właściciela tabeli. Przewodnik po planowaniu migracji danych może pomóc uporządkować zależności, walidację i decyzje wdrożeniowe.
Obserwowalność wokół tabeli
Migawki Iceberga mówią, jaki stan tabeli został zatwierdzony. Nie mówią, czy źródło dostarczyło oczekiwane rekordy, czy wartości biznesowe są wiarygodne ani czy kluczowa metryka pulpitu wyszła poza swoje normalne zachowanie. Te kontrole należą do otaczającego systemu niezawodności.
Zespół może na przykład walidować reguły rekordów po zatwierdzeniu migawki, śledzić czas przybycia każdego oczekiwanego ładowania, porównywać bieżące metryki z zachowaniem historycznym i zgłaszać zmiany schematu, zanim polegną modele BI. Kontrole mogą działać na tabeli w miejscu, bez kopiowania danych do osobnego magazynu monitorującego.
Dobre praktyki, strojenie wydajności i diagnostyka na produkcji
Produkcyjna eksploatacja Iceberga obraca się wokół utrzymania w zdrowiu metadanych, plików, migawek i polityk naraz. Tabela może pozostać poprawna transakcyjnie, a jednocześnie stać się droga w odpytywaniu, bo zawiera zbyt wiele małych plików, nieaktualne migawki albo nakładające się układy z kilku specyfikacji partycji.
Zacznij od zarządzania plikami. Obserwuj powstawanie małych plików, kompaktuj pliki zgodne i wybieraj ustawienia zapisu dające praktyczne rozmiary dla silników obsługujących tabelę. Kompaktowanie powinno iść za dowodami z obciążenia. Tabela używana do częstych odczytów przyrostowych może wymagać innego rytmu konserwacji niż tabela obsługująca sporadyczne skany analityczne.
Metadane zasługują na własny monitoring. Śledź przyrost manifestów, opóźnienie planowania, narastanie migawek i wzorce nieudanych zatwierdzeń. Wygaszaj migawki zgodnie z wymaganiami odtwarzania i audytu, a osierocone pliki sprzątaj dopiero po potwierdzeniu, że żadna aktywna migawka ani proces zewnętrzny już od nich nie zależy.
Reguła operacyjna: konserwacja to nie sprzątanie. To część projektu zapytań i odtwarzania tabeli.
Diagnostyka staje się bardziej systematyczna, gdy objawy przypiszesz do warstw:
Wolne planowanie: sprawdź liczbę manifestów, przyrost metadanych i czas odpowiedzi katalogu, zanim obwinisz silnik zapytań.
Wolne skany: sprawdź skuteczność przycinania, rozmiary plików, rozkład danych i czy ewoluowane specyfikacje partycji tworzą nierówne układy.
Brakujące rekordy: porównaj oczekiwane okno wczytania z zatwierdzoną migawką i osobno zweryfikuj dostawę źródłową.
Awarie schematu: ustal zapisującego, który zmienił schemat, a potem sprawdź zgodność czytników i założenia niżej.
Konflikty zatwierdzeń: przejrzyj współbieżnych zapisujących, zachowanie ponowień i zadania konserwacyjne rywalizujące o tę samą tabelę.
Nieoczekiwany przyrost magazynu: zbadaj zachowane migawki, pliki usunięć, nieudane zapisy i osierocone pliki danych.
Aktualizacje formatu wymagają planu wdrożenia. Zmiany wersji Iceberga są opcjonalne tabela po tabeli, więc starsze tabele mogą współistnieć z nowszymi. Ankieta ekosystemu Apache Iceberg z 2025 roku podała, że 78,6 % respondentów używa Iceberga wyłącznie spośród otwartych formatów tabel, a niezależne badanie korporacyjne wskazało 58 % używających Iceberga do analityki krytycznej dla biznesu, 95 % używających go lub planujących użyć do AI/ML oraz 79 % przenoszących lub planujących przenieść pozostałe dane do Iceberga w ciągu 12 miesięcy. Liczby pochodzą z podsumowania ankiety State of the Apache Iceberg Ecosystem 2025 i sygnalizują rozpęd, a nie dowód, że każda organizacja rozwiązała pracę z mieszanymi wersjami.
Kolejną kwestią planistyczną jest Iceberg v3, z możliwościami takimi jak lineage wierszy, wektory usunięć i nowe typy logiczne. Testuj czytających i zapisujących razem, zdefiniuj bramki zgodności i zaktualizuj reprezentatywne tabele przed szerokim wdrożeniem. Format może być otwarty, a mimo to krajobraz potrafi zgromadzić ukryty dług niezawodności, jeśli katalogi, silniki i polityki nadzoru rozwijają się w różnym tempie.
Katalog należy wybierać z równą starannością. Iceberg daje zachowanie ACID, ewolucję schematu i podróż w czasie, a lineage, klasyfikacja, kontrola dostępu i jednolite ślady audytu zależą od katalogu i stosu nadzoru. Databricks ogłosił Managed Iceberg, Iceberg v3 i Foreign Iceberg jako ogólnie dostępne w Unity Catalog 28 maja 2026, a Snowflake wbudował Polaris w Horizon Catalog dla interoperacyjności REST Iceberga, jak opisują materiały specyfikacji Apache Iceberg. Te ruchy ekosystemu wzmacniają kluczową decyzję: otwartość między silnikami zależy nie tylko od plików tabeli, ale też od tego, kto kontroluje dostęp do metadanych i egzekwowanie polityk.
digna działa wewnątrz Twojego środowiska i łączy śledzenie schematu, monitorowanie Timeliness, walidację w bazie danych, wykrywanie anomalii i obserwowalność platformy wokół krytycznych tabel i potoków. Odwiedź dignę, by zobaczyć, jak Twój zespół może monitorować analitykę opartą na Iceberg bez przenoszenia danych produkcyjnych.
Większość produkcyjnych incydentów z Icebergiem okazuje się problemami z wartościami przebranymi za metadane, więc zaplanuj zarządzanie jakością danych równolegle z migracją.
Najczęściej zadawane pytania
Jaki problem rozwiązuje Iceberg?
Powstrzymuje różne silniki przed niezgodą co do zawartości tabeli. Bez formatu tabeli jeden silnik może przeczytać katalog, zanim wsad zostanie w pełni zatwierdzony, drugi inaczej zinterpretować partycję, a trzeci wciąż widzieć starszy schemat, choć każdy zaangażowany plik jest całkowicie poprawny.
Jak zbudowana jest tabela Iceberg?
Iceberg prowadzi łańcuch metadanych: wpis katalogu wskazuje plik metadanych opisujący bieżącą migawkę, ta migawka wskazuje listę manifestów, a manifesty wyliczają pliki danych wraz ze statystykami. Każde zatwierdzenie zapisuje nowe metadane zamiast zmieniać stare, co czyni wycofanie tanim.
Czy Iceberg wspiera współbieżnych zapisujących?
Tak, przez optymistyczną współbieżność. Każdy zapisujący przygotowuje swoje zmiany, a potem próbuje podmienić wskaźnik metadanych tabeli; jeśli wcześniej wylądowało inne zatwierdzenie, ponawia próbę wobec nowego stanu. Sprzeczne zapisy do tych samych plików zawodzą głośno, zamiast po cichu nadpisywać się nawzajem.
Które silniki działają z Icebergiem?
Iceberg czytają między innymi Spark, Trino, Flink, Dremio, Snowflake i BigQuery, choć pokrycie funkcji bywa różne: część silników czyta, ale nie zapisuje, a nowsze możliwości pojawiają się nierównomiernie. Potwierdź, że konkretne potrzebne operacje są wspierane przez każdy silnik w Twoim stosie, a nie tylko przez ten, na którym testujesz.
Co zwykle psuje się z Icebergiem na produkcji?
Małe pliki i niewygaszone migawki, w tej kolejności. Strumieniowanie albo częste zapisy wsadowe tworzą wiele małych plików danych i długi łańcuch metadanych, co spowalnia planowanie, dopóki kompaktowanie i wygaszanie migawek nie działają regularnie. Żadne z nich nie psuje poprawności, więc objaw pojawia się jako pełzający wzrost opóźnienia zapytań.



