10 kroków migracji danych zgodnych z najlepszymi praktykami na rok 2026
|
6
min. czyt.

Prawdopodobnie jesteś w samym środku etapu, który każdy bagatelizuje. Platforma docelowa jest gotowa, interesariusze żądają dat, a ktoś ciągle powtarza, że migracja to „tylko transfer”. Tymczasem Ty już wiesz, że rzeczywiste ryzyko nie jest abstrakcyjne. Nieudane wdrożenie (cutover) może pozostawić zduplikowanych klientów w systemie bilingowym, puste pola w raportach regulacyjnych oraz uszkodzone pulpity nawigacyjne, czego nikt nie zauważy, dopóki kadra zarządzająca nie zapyta, dlaczego zniknęły wczorajsze dane.
Ta presja jest uzasadniona. Projekty migracji danych kończą się niepowodzeniem w przewidywalny sposób, gdy zespoły spieszą się, pomijając jakość danych, mapowanie zależności, testowanie i monitorowanie po wdrożeniu. Według dyskusji DataQualityPro na temat jakości danych podczas migracji, 84% projektów migracji danych przekracza przydzielony czas lub budżet. Monte Carlo powołuje się również na badanie Experian w swojej liście kontrolnej ryzyk migracji danych, według którego 64% analizowanych projektów migracji przekroczyło budżet, a tylko 46% zostało dostarczonych na czas. Liczby te pokrywają się z tym, co doświadczone zespoły widzą w praktyce. Migracje kończą się niepowodzeniem na długo przed rozpoczęciem ostatecznego kopiowania.
Nowoczesny plan migracji danych oparty na najlepszych praktykach traktuje Observability jako część realizacji, a nie jako warstwę porządkującą po uruchomieniu produkcyjnym. Oznacza to walidację rekordów przed ich zapisaniem, śledzenie zmian schematu na bieżąco, kontrolowanie terminu dostarczania danych oraz wykrywanie anomalii, zanim dowiedzą się o nich użytkownicy biznesowi. digna naturalnie wpisuje się w ten model operacyjny, ponieważ łączy wykrywanie anomalii, monitorowanie terminowości, walidację i śledzenie schematów w środowisku klienta.
Poniższe 10 kroków zostało opracowanych z myślą o zespołach technicznych, które potrzebują planu migracji możliwego do wdrożenia.
Spis treści
2. Zdefiniowanie jasnych kryteriów jakości danych i reguł walidacji
4. Monitorowanie Timeliness danych i wzorców ich napływu podczas migracji
5. Przeprowadzenie testów równoległego działania i uzgadniania danych
6. Wprowadzenie zarządzania zmianami w schematach i dokumentacji
7. Wdrożenie wykrywania anomalii w danych i nauki zachowań bazowych
8. Ustanowienie ram ładu danych, odpowiedzialności i komunikacji
9. Zaplanowanie monitorowania po migracji i ciągłej obserwowalności danych
10. Udokumentowanie wniosków i budowa szablonów migracyjnych wielokrotnego użytku
1. Przeprowadzenie kompleksowego audytu i oceny danych
Najszybszym sposobem na sabotaż migracji jest rozpoczęcie mapowania pól przed zrozumieniem danych źródłowych. Najlepsze praktyki migracji danych nakazują rozpoczęcie od pełnego audytu struktury, jakości, łańcuchów zależności i reguł biznesowych. Musisz wiedzieć, gdzie znajdują się duplikaty, które pola mają zbyt wiele nałożonych znaczeń, które tabele zasilają raporty docelowe, a które „opcjonalne” kolumny są w rzeczywistości obowiązkowe.
Zespół ds. usług finansowych może odkryć zduplikowane rekordy kont, które wymagają deterministycznej deduplifikacji, zanim historie klientów będą mogły zostać czysto połączone. Organizacja opieki zdrowotnej często napotyka brak obowiązkowych pól klinicznych w starszych rekordach, co oznacza, że reguły ETL muszą uzupełniać, odrzucać lub poddawać kwarantannie rekordy przed ostatecznym wdrożeniem. Migracje w telekomunikacji regularnie ujawniają rozbieżności w lokalnych schematach, gdzie ten sam atrybut klienta używa różnych typów danych w różnych systemach.
Sprofiluj źródło przed przystąpieniem do mapowania
Automated profiling to jedyny praktyczny sposób na wykonanie tego działania na dużą skalę. digna Data Validation, Schema Tracker i Data Analytics pomagają zespołom ustalić poziom bazowy wartości pustych (null), rozkładów, zmian kardynalności i niezgodności strukturalnych przed sfinalizowaniem logiki migracji.
Profiluj pola na poziomie kolumn: Sprawdź wzorce wartości pustych, wskaźniki duplikacji, niezgodności typów i wartości odstające przed zatwierdzeniem jakiejkolwiek logiki transformacji.
Zmapuj rzeczywiste zależności: Sklasyfikuj podrzędne pulpity nawigacyjne, funkcje uczenia maszynowego, eksporty i raporty regulacyjne powiązane z każdym obiektem źródłowym.
Wyraźnie dokumentuj wyjątki: Jeśli identyfikator pacjenta może być pusty w jednym starszym procesie, ale nie w innym, ten wyjątek powinien znaleźć się w specyfikacji migracji, a nie w pamięci pracownika.
Określ priorytety dla obszarów krytycznych: Twórz mapy ciepła najbardziej zanieczyszczonych obszarów, aby zespół naprawiał w pierwszej kolejności dane o wysokim ryzyku.
Praktyczna zasada: Najpierw audyt, potem transformacja. Jeśli zespół nie potrafi jasno opisać stanu obecnego, nie będzie w stanie bezpiecznie przeprowadzić migracji.
2. Zdefiniowanie jasnych kryteriów jakości danych i reguł walidacji
Zespoły często deklarują dbałość o jakość, po czym przy wdrożeniu okazuje się, że nikt nie uzgodnił, co oznacza pojęcie „prawidłowe”. Można tego uniknąć. Migracja wymaga jasnych kryteriów akceptacji pod kątem kompletności, zgodności, logiki biznesowej i możliwości audytu przed rozpoczęciem pierwszej fali produkcyjnej.
Ma to jeszcze większe znaczenie w środowiskach regulowanych. W badaniach źródłowych Olahht zakłada szeroki dostęp dostawców, jednak wiele zespołów finansowych i medycznych nie dopuszcza takiego modelu. Zweryfikowane badania wskazują również, że 62% projektów migracji kończy się niepowodzeniem z powodu ukrytych problemów z jakością danych, niewykrytych przez same sumy kontrolne po migracji, co podsumowano w dyskusji Olahht na temat planowania migracji danych medycznych. Dlatego reguły na poziomie rekordów są ważniejsze niż sama walidacja sum kontrolnych.
Napisz reguły, które zablokują błędne dane
Instytucja finansowa może wymagać, aby atrybuty KYC były obecne i spójne przed przeniesieniem rekordów kont. System opieki zdrowotnej może wymusić prawidłowe kodowanie diagnoz i poddać kwarantannie historyczne mapowania, które nie odpowiadają obecnym standardom. Operator telekomunikacyjny może walidować formaty numerów komórkowych i kompatybilność planów taryfowych przed zapisaniem danych w systemie docelowym.
Podejście oferowane przez digna w zakresie najlepszych praktyk walidacji danych podczas migracji idealnie się tu sprawdza, ponieważ wspiera weryfikację na poziomie rekordów bezpośrednio w bazie danych bez przekazywania danych produkcyjnych zewnętrznemu dostawcy.
Rozdziel reguły blokujące od ostrzegawczych: Brak identyfikatorów podmiotów prawnych może zablokować całą falę migracji. Kosmetyczne problemy z formatowaniem mogą generować jedynie ostrzeżenia do późniejszego wyczyszczenia.
Powiąż każdą regułę z logiką biznesową: „Email musi być podany” to słaba reguła. „Proces powiadomień nie zadziała bez adresu email” ma znaczenie operacyjne.
Kontroluj wersje zestawu reguł: Zespoły zmieniają progi weryfikacji podczas testów. Dbaj o to, aby te zmiany były widoczne i przypisane do osób.
Waliduj wewnątrz środowiska klienta: To często jedyny możliwy do wdrożenia schemat, gdy prywatność, lokalizacja przechowywania danych lub wymogi audytowe ograniczają możliwość ujawnienia danych.
3. Wdrożenie podejścia przyrostowego i etapowego
Wdrożenie w piątek. Najpierw przenoszone są rekordy klientów, potem bilingi, a w poniedziałek rano dział wsparcia widzi konta, których finanse nie mogą zafakturować. Ten scenariusz awarii jest powszechny przy metodzie „big-bang”, ponieważ jedno wydanie skupia każdą zależność, każdą transformację i każdą decyzję o wycofaniu zmian w jedno wydarzenie.
Podejście etapowe zmniejsza to ryzyko, dzieląc je na kontrolowane fale. Podział powinien przebiegać wzdłuż granic operacyjnych, które zespoły potrafią zweryfikować i obsłużyć – mogą to być regiony, jednostki biznesowe, aplikacje lub domeny danych. Globalny bank może migrować dane główne klientów kraj po kraju, dzięki czemu lokalne pola regulacyjne, zgody i raporty niższego szczebla zostaną sprawdzone przed rozpoczęciem kolejnej fali. Sieć placówek medycznych może przenosić po jednej grupie szpitali naraz, aby wychwycić problemy z mapowaniem terminologii w kontrolowanym środowisku. Operator telekomunikacyjny może oddzielić telefonię komórkową, szerokopasmowy internet i telewizję, aby każdy zespół mógł przetestować własną logikę usług bez dziedziczenia błędów od innych.
Chodzi nie tylko o mniejszy zasięg potencjalnej awarii. Każda fala dostarcza projektowi nowych dowodów.
Zaprojektuj etapy tak, aby ułatwiały decyzje, a nie tylko generowały postęp
Zespoły czerpią najwięcej korzyści z etapowej migracji, gdy każda fala ma jasny cel. Fala pilotażowa powinna odpowiedzieć na konkretne pytania: Czy reguły transformacji sprawdzają się w nietypowych, skrajnych przypadkach? Czy zespół potrafi uzgodnić liczbę wierszy między źródłem a celem na odpowiednim poziomie szczegółowości? Jak długo trwa wycofanie zmian pod obciążeniem? Jeśli dana faza nie odpowiada na te pytania, stanowi jedynie częściowe wdrożenie, a nie rzeczywiste ograniczenie ryzyka.
Praktyczny plan etapowy zazwyczaj zawiera:
Pilotaż o niskim ryzyku z realistyczną złożonością: Wybierz dane na tyle istotne, aby ujawnić realne problemy, ale nie na tyle krytyczne dla biznesu, aby pojedynczy błąd zablokował cały program.
Jasne kryteria wejścia (entry criteria): Zatwierdzone ekstrakty źródłowe, zamrożone mapowania dla danej fali, aktywne reguły walidacji oraz dostępność właścicieli biznesowych do podpisania odbioru.
Jasne kryteria wyjścia (exit criteria): Zakończone uzgadnianie danych, osiągnięcie dopuszczalnych progów błędów, akceptowalna wydajność systemu docelowego i brak konieczności wycofania procedury.
Procedury operacyjne (runbooks) ze sprawdzonymi ścieżkami wycofania: Udokumentuj, kto podejmuje decyzję o kontynuacji lub przerwaniu prac („go / no-go”), co podlega cofnięciu i ile czasu zajmuje przywrócenie systemu.
Observability na poziomie danej fali: Śledź błędy walidacji, czas ładowania, wskaźniki anomalii i świeżość danych po każdym przeniesieniu.
digna dodaje mierzalną kontrolę, a nie kolejny prosty wykres na ekranie. Podczas migracji etapowej zespoły mogą jej użyć do określenia bazowej liczby wierszy, wzorców świeżości, poziomu wartości null oraz rozkładu pól dla każdej domeny, a następnie porównać kolejną falę z tym poziomem odniesienia. Pomaga to wychwycić problemy, które umykają standardowej kontroli liczby wierszy, takie jak załadowanie regionu na czas, ale przy nagłym spadku uzupełnienia pól podatkowych, lub dostarczenie danych pacjentów ze szpitala, gdzie poprawne klinicznie kody skoncentrowały się na niewłaściwym oddziale.
Praca etapowa poprawia również styl działania zespołu. Zmusza właścicieli produktów, inżynierów platform i zespoły danych do podejmowania decyzji o wdrożeniach na podstawie obserwowanych wyników, a nie pod presją kalendarza. Po dwóch lub trzech falach wzorce stają się widoczne. Niektóre mapowania zawodzą za każdym razem. Niektóre systemy źródłowe zawsze spóźniają się z dostarczeniem danych. Niektóre domeny wymagają dłuższego czasu na uzgadnianie. Te wnioski łatwiej przekuć w czyn, gdy plan migracji pozwala na zatrzymanie się, naprawę i powtórzenie procesu.
4. Monitorowanie terminowości danych i wzorców ich napływu podczas migracji
Większość planów migracji sprawdza, czy dane dotarły. Mniej z nich weryfikuje, czy dotarły wtedy, gdy oczekują ich systemy docelowe. Ta ślepa plama prowadzi do nieaktualnych pulpitów nawigacyjnych, opóźnionych raportów i stopniowego przesuwania się okien przetwarzania wsadowego bez wiedzy zespołu, dopóki użytkownicy nie stracą zaufania.
Weryfikowane badania bezpośrednio wskazują na tę lukę. Zwracają uwagę, że dotychczasowe opracowania skupiają się na dokładności transferu, ignorując często weryfikację terminowości, i przytaczają dyskusję inżynierów danych na Reddicie dotyczącą błędów migracji i niezgodności systemów docelowych przy omawianiu problemów po wdrożeniu. Pokrywa się to z doświadczeniami zespołów migracyjnych. Zadanie może zakończyć się pomyślnie, a i tak zaburzyć proces podejmowania decyzji, jeśli dane dotrą za późno.
Opóźnione dane niszczą zaufanie szybciej niż brakujące wiersze
Zespół usług finansowych może zauważyć, że salda na koniec dnia docierają dopiero po uruchomieniu zadań raportujących. Organizacja medyczna może odnotować, że wyniki badań laboratoryjnych ładują się niespójnie po migracji, przez co lekarze nie mają kompletnego obrazu sytuacji. Sektor handlu detalicznego może zaobserwować, że dane o stanach magazynowych nie spełniają wymogów świeżości w punktach sprzedaży.
digna Timeliness przydaje się w tym miejscu, ponieważ uczy się wzorców napływu i oczekiwanych okien dostarczania, zamiast opierać się wyłącznie na sztywno zakodowanych harmonogramach.
Terminowość danych to wskaźnik sukcesu migracji, a nie udogodnienie po przejściu na produkcję.
Funkcjonalna konfiguracja zazwyczaj obejmuje:
Poziomy odniesienia podczas działania równoległego: Mierz stare i nowe wzorce napływu obok siebie przed pełnym wdrożeniem.
Zróżnicowane oczekiwania: Koniec miesiąca, weekendy czy okresy sezonowe często charakteryzują się inną charakterystyką napływu.
Poziomy ważności: Niewielkie opóźnienie może wymagać analizy, ale pominięcie krytycznego źródła powinno natychmiast powiadomić właściciela procesu.
Wspólne pulpity nawigacyjne: Biznesowi interesariusze powinni widzieć ten sam widok terminowości co inżynierowie podczas aktywnych okien migracji.
5. Przeprowadzenie testów równoległego działania i uzgadniania danych
Wdrożenia kończą się niepowodzeniem, gdy zespoły porównują jedynie ogólne podsumowania i zakładają, że szczegóły są w porządku. Testowanie równoległego działania rozwiązuje ten problem, utrzymując system źródłowy i docelowy aktywne na tyle długo, aby porównać wyniki w rzeczywistych warunkach operacyjnych. Jest to jeden z najbardziej niezawodnych mechanizmów kontrolnych w każdym poprawnym planie migracji danych.
Problemy, które przeszły testy jednostkowe, zazwyczaj wychodzą na jaw na tym etapie. Zespół ubezpieczeniowy może odkryć polisy zmigrowane bez części historii roszczeń. Firma produkcyjna może zauważyć sumy faktur, które zgadzają się globalnie, ale przypisują koszty niepoprawnie na poziomie poszczególnych pozycji. Platforma handlowa może wykazać zgodną liczbę pozycji, ujawniając jednocześnie subtelne różnice w logice wyceny.
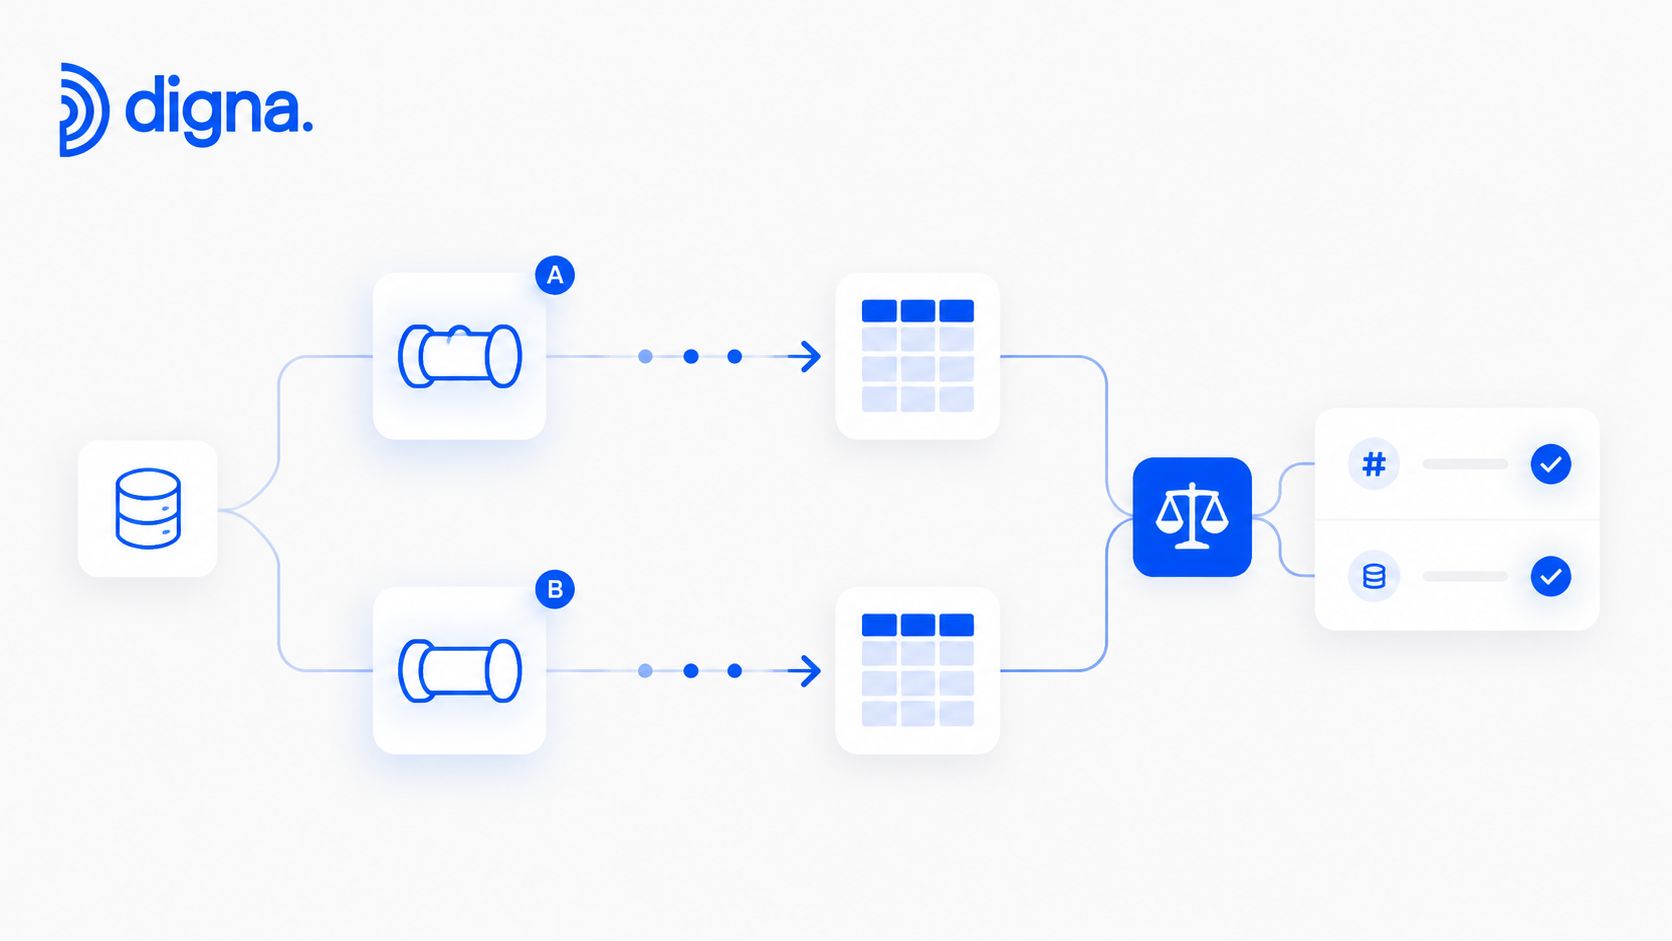
Uzgodnij zachowanie, a nie tylko liczbę wierszy
Najlepsze plany uzgadniania (reconciliation) porównują wiele warstw jednocześnie. Liczba wierszy ma znaczenie, ale to dopiero początek, a nie koniec. Wartości zagregowane, sumy kontrolne, spójność relacji (join integrity) i reguły na poziomie pojedynczych rekordów powinny stanowić część pakietu uzgadniającego.
Automatyzuj każdy powtarzalny test: Ręczna wyrywkowa kontrola ma swoją wartość, ale oskryptowane uzgadnianie stale wychwytuje odchylenia.
Należy traktować priorytetowo obiekty krytyczne dla biznesu: Uzgadniaj klientów, salda, polisy, transakcje, pacjentów czy faktury przed danymi słownikowymi o mniejszym znaczeniu.
Uruchamiaj testy na wielu etapach: Porównaj dane przed wdrożeniem, w trakcie wdrożenia oraz po uruchomieniu ruchu produkcyjnego.
Badaj rozbieżności o niskim wolumenie: Małe niezgodności często ujawniają błędną logikę biznesową, a nie niegroźny szum informacyjny.
Moduł digna Data Anomalies dodaje tutaj kolejną warstwę. Potrafi wskazać nieoczekiwane wzorce w wynikach uzgadniania, które przechodzą proste testy progowe, co jest przydatne, gdy problem ma charakter dystrybucyjny, a nie zerojedynkowy.
6. Wprowadzenie zarządzania zmianami w schematach i dokumentacji
Zespoły zazwyczaj dokumentują planowane mapowanie. Często jednak nie śledzą zmian, które zachodzą w samym oknie migracyjnym. To właśnie tam rodzą się późniejsze awarie w systemach docelowych. Zmiana nazwy kolumny, rozszerzenie typu danych, usunięcie wartości domyślnej lub zmiana typu wyliczeniowego (enum) mogą uszkodzić transformacje, raporty, potoki danych i interfejsy API, nie zgłaszając oczywistego błędu migracji.
Dokumentacja schematu musi mieć charakter aktywny, a nie statyczny. Zespół medyczny może odkryć niezmapowane pola demograficzne przed wdrożeniem i zapobiec cichej utracie kontekstu klinicznego. Sprzedawca detaliczny może wychwycić zmianę struktury pola discount_type w trakcie migracji i zaktualizować walidację, zanim zepsuje się powiązana logika cenowa. Instytucja finansowa może wykorzystać przegląd mapowania schematów, aby udowodnić, że każde wymagane pole KYC trafiło do właściwej struktury docelowej.
Traktuj mapowania jako artefakty produkcyjne
Rynek usług migracyjnych stale rośnie i staje się coraz bardziej skomplikowany. Prognozuje się, że globalny rynek migracji danych wzrośnie z 14,67 mld USD w 2026 r. do 48,33 mld USD do roku 2035, jak podaje raport DataM Intelligence dotyczący rynku migracji danych. Taka skala to kolejny powód, by traktować kontrolę schematów jak dyscyplinę inżynieryjną, a nie tylko formalność projektową.
Twórz porównawcze specyfikacje mapowania: Uwzględnij typ źródłowy, typ docelowy, regułę transformacji, dopuszczalność braku danych (nullability) oraz zatwierdzenie właściciela.
Śledź każdą zmianę strukturalną: digna Schema Tracker pozwala automatycznie flagować dodane lub usunięte kolumny oraz modyfikacje typów danych.
Wymagaj zatwierdzeń w oknie migracyjnym: Zmiany awaryjne nadal wymagają wskazania osób odpowiedzialnych i udokumentowania uzasadnienia.
Informuj odbiorców danych z wyprzedzeniem: Właściciele raportów, zespoły ML i integracji potrzebują powiadomienia, zanim pola zmienią swoją strukturę.
Jeśli Twój zespół intensywnie pracuje w ekosystemach Snowflake, katalog najlepszych firm doradczych Snowflake może pomóc, gdy potrzebujesz zewnętrznego wsparcia wdrożeniowego przy pracach migracyjnych specyficznych dla tej platformy.
7. Wdrożenie wykrywania anomalii w danych i nauki zachowań bazowych
Sztywno zakodowane reguły progowe wychwytują oczywiste błędy. Omijają jednak zjawiska nietypowe. Dlatego wykrywanie anomalii powinno być stałym elementem prac migracyjnych, zwłaszcza gdy rozkłady danych po przeniesieniu ulegają subtelnym zmianom.
Migracja może zachować każdy wiersz, a jednocześnie zniekształcić sygnał biznesowy. Logika przeliczania walut może zmienić wartości transakcji. Sposób łączenia tabel może zaburzyć kalkulację odejść klientów (churn). Historyczne uzupełnianie wsteczne (backfill) może na tyle zmienić wzorce sezonowe, że wprowadzi w błąd modele uczenia maszynowego i raporty.
Poznaj normę przed wdrożeniem produkcyjnym
Najbardziej efektywne wykrywanie anomalii zaczyna się jeszcze przed migracją. digna Data Anomalies uczy się bazowego zachowania systemu w czasie, a następnie wskazuje zmiany wymagające uwagi, eliminując potrzebę ręcznego tworzenia każdej reguły przez zespół.
Praktyczny wzorzec выглядит tak:
Najpierw ustal poziom bazowy źródła: Rozpocznij naukę normalnych rozkładów, poziomu wartości null i wolumenów przed pierwszą falą migracji.
Kontynuuj podczas pracy równoległej: Pozwala to zespołowi porównać zachowanie starego i nowego systemu w tych samych warunkach operacyjnych.
Segmentuj tam, gdzie zachowania się różnią: Poziomy odniesienia specyficzne dla regionu, produktu czy kanału dają dokładniejsze sygnały niż jedna globalna średnia.
Powiąż anomalie ze zmianami w potokach: Najbardziej przydatne alerty wiążą się bezpośrednio z wdrożeniami kodu, zmianami mapowania lub przesunięciem okna przetwarzania wsadowego.
Przegląd narzędzi jakości migracji danych opartych na AI od digna jest tutaj istotny, ponieważ pokazuje, jak nauka wzorców bazowych i automatyczna detekcja odciążają zespoły inżynieryjne z prac manualnych.
Jeśli metryka nadal wygląda na „prawidłową”, ale zachowuje się inaczej niż zwykle, zbadaj sprawę, zanim użytkownicy zbudują na jej podstawie raporty.
8. Ustanowienie ram ładu danych, odpowiedzialności i komunikacji
Programy migracji nie zatrzymują się wyłącznie z powodów technicznych. Blokują się, ponieważ nikt nie wie, kto może zatwierdzić zmianę reguły, kto odpowiada za nieudaną falę lub kto podejmuje decyzję o cofnięciu wdrożenia w sytuacji kryzysowej. Rozwiązaniem jest governance.
Sprawdzony schemat operacyjny jest prosty. Każda domena zyskuje przypisanego właściciela. Każda reguła jakości ma uzasadnienie biznesowe. Każdy incydent ma określoną ścieżkę eskalacji. Bank może powołać komitet sterujący z udziałem przedstawicieli finansów, zgodności (compliance), ryzyka i IT, wspólnie przeglądających pulpity jakości digna. Organizacja medyczna może połączyć rzecznika danych klinicznych z opiekunem technicznym dla każdego departamentu, aby znaczenie biznesowe i wdrożenie techniczne szły w parze. Sieć handlowa może przypisać właścicieli domen do danych o klientach, zapasach i cenach z pełnym prawem decyzyjnym przy zatwierdzaniu wdrożenia.
Uprawnienia decyzyjne mają większe znaczenie niż spotkania o statusie projektu
Struktura ładu danych powinna odpowiedzieć na poniższe pytania przed rozpoczęciem prac:
Kto zatwierdza wdrożenie (cutover): Jedna osoba lub komitet, z jasno określonymi kryteriami sukcesu.
Kto zatwierdza działania naprawcze: Zespół musi mieć uprawnienia do nakładania kwarantanny, poprawiania lub odraczania błędnych rekordów.
Kto odpowiada za wycofanie zmian (rollback): Ta decyzja nie może czekać na zebranie się zarządu w trybie doraźnym.
Kto zatwierdza zmiany w schemacie: Odbiorcy danych na dalszych etapach muszą mieć formalną możliwość wpływu na te decyzje.
Rekomendacje branżowe podsumowane w zweryfikowanych źródłach kładą również nacisk na punkty decyzyjne Go/No-Go oraz rejestry zmian z wersjonowaniem przypisane do konkretnych właścicieli w artykule opublikowanym przez Streamkap na temat najlepszych praktyk migracji. Ma to bezpośrednie przełożenie na realne projekty. Jasna struktura własności skraca czas reakcji na incydenty i zmniejsza opóźnienia organizacyjne.
Dla zespołów, które potrzebują lokalnych narzędzi pomocniczych dbających o prywatność przy przygotowaniu migracji i obsłudze plików, aplikacja desktopowa do lokalnej konwersji plików może wspierać powiązane procesy bez przenoszenia wrażliwych treści do niezarządzanych środowisk chmurowych.
9. Zaplanowanie monitorowania po migracji i ciągłej obserwowalności danych
Migracja nie odnosi sukcesu dlatego, że noc wdrożenia przebiegła spokojnie. Sukces ma miejsce wtedy, gdy dane pozostają kompletne, terminowe, stabilne strukturalnie i wiarygodne po tym, jak wzrośnie intensywność ich produkcyjnego wykorzystania. W tym krytycznym momencie wiele projektów traci kontrolę.
Jednym z najbardziej pomijanych tematów w publikacjach o migracjach jest to, co dzieje się kilka tygodni później. Pulpity nawigacyjne psują się przy pierwszym nietypowym wzorcu zasilania danymi. Funkcje modeli ML tracą stabilność, gdy pole zmienia swoje znaczenie. Analitycy tracą zaufanie do danych, ponieważ raporty docierają z opóźnieniem, a nie dlatego, że brakuje wierszy. Dlatego post-migration observability powinno być zaprojektowane jeszcze przed uruchomieniem produkcyjnym, a nie dopiero po wpłynięciu zgłoszeń serwisowych.
Prawdziwy test zaczyna się po wejściu na produkcję
Skuteczny plan po migracji zawiera metryki jakości, alerty o terminowości, monitorowanie zmian schematu (schema drift), poziomy odniesienia dla anomalii oraz jasną własność celów SLO dla poszczególnych domen. digna doskonale pasuje do tego modelu, łącząc Data Anomalies, Timeliness, Data Validation, Schema Tracker oraz analizę historyczną na jednej platformie działającej w środowisku kontrolowanym przez klienta.
Weźmy pod uwagę kilka powszechnych scenariuszy po wdrożeniu:
Usługi finansowe: Wspólny pulpit nawigacyjny prezentuje błędy walidacji, zmiany schematu i spóźnione dane o pozycjach w jednym miejscu, eliminując ręczną weryfikację każdego ranka.
Opieka zdrowotna: Informatyka medyczna monitoruje kompletność i świeżość rekordów pacjentów, aby personel medyczny nie napotykał braków podczas codziennej pracy.
Telekomunikacja: Właściciele systemów bilingowych wspólnie obserwują jakość danych i czas ładowania, ponieważ dokładne dane dostarczone zbyt późno nadal negatywnie wpływają na fakturowanie.
Najbardziej efektywne zespoły definiują widoki dostosowane do ról. Inżynierowie potrzebują szczegółów błędnych testów i kontekstu technicznego incydentów. Analitycy wymagają wiedzy o świeżości i dostępności pól. Kadra kierownicza oczekuje zwięzłego podsumowania stanu operacyjnego, a nie surowych dzienników zdarzeń.
10. Udokumentowanie wniosków i budowa szablonów migracyjnych wielokrotnego użytku
Każda migracja uczy zespół czegoś kosztownego. Jeśli ten wniosek pozostanie na kanale czatu lub w pamięci jednego inżyniera, przy kolejnej migracji organizacja zapłaci za tę lekcję ponownie. Dojrzałym krokiem jest przekształcenie wiedzy z realizacji w aktywa wielokrotnego użytku.
Mowa o procedurach operacyjnych, szablonach mapowania, bibliotekach reguł, procedurach wycofywania zmian, katalogach wyjątków i notatkach dotyczących rozwiązywania problemów. Firma technologiczna może przekształcić migrację hurtowni danych w standardowy zestaw dokumentów dla kolejnego przeniesienia platformy. Instytucja finansowa może zachować bibliotekę reguł walidacji dla pól podlegających regulacjom. System opieki zdrowotnej może ujednolicić wzorce mapowania schematów dla danych klinicznych w integracjach regionalnych.
Przekształć jedną migrację w powtarzalny system
Podsumowania projektów (retrospektywy) działają najlepiej, gdy są szczegółowe i dotykają trudnych kwestii. Zapytaj, gdzie zespół musiał zgadywać. Dowiedz się, które testy powinny powstać wcześniej. Sprawdź, które ścieżki akceptacji spowolniły reakcję. Zapisz zarówno sukcesy, jak i porażki.
Przeprowadź retrospektywę, póki szczegóły są świeże: Nie czekaj, aż wszyscy zaangażują się w kolejny projekt.
Zachowaj konkretne artefakty: Zapisz ostateczny runbook, specyfikację mapowania, zapytania uzgadniające i definicje walidacji.
Twórz szablony wielokrotnego użytku: Wspólne reguły domenowe i wzorce schematów nie powinny być tworzone od zera za każdym razem.
Stwórz bazę wiedzy z odpowiedziami (FAQ): Przyszłe zespoły napotkają te same wyzwania związane z obsługą wartości null, kolejnością przetwarzania i zależnościami.
Sens stosowania najlepszych praktyk migracji danych to nie tylko przetrwanie jednego wdrożenia. To budowa całego systemu organizacji pracy, dzięki któremu kolejny proces będzie znacznie bezpieczniejszy.
Porównanie 10 najlepszych praktyk migracji danych
Praktyka | 🔄 Złożoność wdrożenia | ⚡ Wymagania zasobowe | 📊 Oczekiwane rezultaty | ⭐ Główne zalety i idealne zastosowanie | 💡 Wskazówki |
|---|---|---|---|---|---|
Przeprowadzenie kompleksowego audytu i oceny danych | Wysoka, szerokie profilowanie i analiza zależności między zespołami | Średnia–Wysoka, narzędzia do profilowania, inżynierowie danych, eksperci domenowi, czas | Jasny inwentarz danych, zidentyfikowane anomalie, specyfikacje migracyjne | Zapobiega rozprzestrzenianiu się problemów z jakością; idealne dla dużych, przestarzałych lub nieudokumentowanych systemów | Używaj automatycznego profilowania, angażuj interesariuszy na wczesnym etapie, twórz mapy ciepła jakości danych |
Define Clear Data Quality Criteria and Validation Rules | Średnia–Wysoka, wymaga uzgodnień domenowych i zaprojektowania reguł | Średnia, eksperci domenowi, ramy walidacji, dane testowe | Obiektywne kryteria akceptacji; mniej odrzuceń po wdrożeniu | Zapewnia zgodność z przepisami (Compliance) i spójne egzekwowanie zasad; idealne dla branż regulowanych | Zacznij od kluczowych reguł, podziel na blokady i ostrzeżenia, dokumentuj uzasadnienie biznesowe |
Wdrożenie podejścia przyrostowego i etapowego | Średnia, planowanie kolejnych fal i zależności | Średnia, równoległe zespoły, planowanie rollbacku, monitoring | Mniejszy obszar potencjalnego błędu, ciągłe ulepszanie procesów | Ogranicza ryzyko przy migracjach na dużą skalę; idealne dla wdrożeń wieloregionowych lub wieloproduktowych | Priorytetyzuj według krytyczności, przeprowadzaj pilotaże, ustalaj jasne kryteria wejścia/wyjścia oraz procedury runbook |
Monitorowanie terminowości danych i wzorców ich napływu podczas migracji | Niska–Średnia, określenie poziomu bazowego i konfiguracja alertów | Niska–Średnia, narzędzia observability, czas na naukę zachowań bazowych | Wykrywa opóźnienia w ładowaniu, wspiera śledzenie umów SLA i analizę przyczyn źródłowych | Zapobiega nieaktualności pulpitów nawigacyjnych; idealne, gdy umowy SLA dla systemów docelowych mają kluczowe znaczenie | Ucz się zachowań bazowych podczas pracy równoległej, segmentuj według wzorców (dzień/tydzień/miesiąc), ustawiaj poziomy eskalacji |
Execute Parallel Run and Reconciliation Testing | Wysoka, jednoczesne operacje i skomplikowana logika uzgadniania | Wysoka, moc obliczeniowa do porównań, automatyczne skrypty, wsparcie operacyjne | Obiektywna walidacja kompletności i spójności przed wdrożeniem produkcyjnym | Dostarcza twardych dowodów audytowych; idealne dla systemów transakcyjnych i finansowych | Automatyzuj proces reconciliation, ustawiaj progi tolerancji błędów, uruchamiaj kontrole przed, w trakcie i po wdrożeniu |
Establish Schema Change Management and Documentation | Średnia, mapowanie, wersjonowanie i analiza wpływu zmian | Średnia, nakład pracy na dokumentację, narzędzia do śledzenia schematów | Rzadsze awarie w potokach danych i czytelniejsza historia zmian | Wykrywa zmiany strukturalne; idealne przy migracjach hurtowni danych i ewoluujących modelach danych | Utrzymuj porównawcze mapowania pól, używaj narzędzi schema tracker, wymagaj akceptacji dla zmian |
Implement Data Anomaly Detection and Baseline Learning | Średnia, wymaga okresu stabilizacji i dostrojenia | Średnia, narzędzia klasy AI/ML, dane historyczne, monitoring | Wykrywa subtelne pogorszenie jakości i rodzące się trendy wykraczające poza statyczne reguły | Przydatne w złożonych wzorcach; idealne dla zmiennych rozkładów i dużych zbiorów danych | Rozpocznij naukę profilu bazowego 4–6 tygodni wcześniej, segmentuj partycje, wiąż alerty ze zdarzeniami w potokach |
Ustanowienie ram ładu danych, odpowiedzialności i komunikacji | Średnia, zdefiniowanie macierzy RACI i regularnych spotkań | Niska–Średnia, spotkania, role nadzorcze, wsparcie kadry zarządzającej | Jasna odpowiedzialność, szybsze decyzje, audytowalne zatwierdzenia | Zapobiega niejasnościom między zespołami; idealne dla wielofunkcyjnych projektów korporacyjnych | Zdefiniuj uprawnienia decyzyjne, ustal cotygodniowe statusy podczas migracji, prezentuj metryki na spotkaniach komitetu sterującego |
Plan for Post-Migration Monitoring and Ongoing Data Observability | Średnia, ujednolicone pulpity nawigacyjne i strategia alertów | Średnia–Wysoka, platforma observability, system alertowy, dyżury inżynierskie | Wczesne wykrywanie zmian, krótszy czas rozwiązania problemów, stałe dotrzymywanie umów SLA | Zapewnia długoterminowe zdrowie danych; idealne, gdy wymagana jest ciągła niezawodność | Zdefiniuj cele SLO, twórz pulpity dopasowane do ról użytkowników, dostrajaj alerty, aby unikać zmęczenia powiadomieniami |
Document Lessons Learned and Build Reusable Migration Frameworks | Niska–Średnia, ustrukturyzowane retrospektywy i szablony | Niska, czas na podsumowania, dokumentację, bazę wiedzy | Szybsze przyszłe migracje, mniej powtarzających się błędów, budowanie wiedzy instytucjonalnej | Mnoży wartość zrealizowanych migracji; idealne dla organizacji powtarzających podobne projekty | Przeprowadzaj retrospektywy 1–2 tygodnie po migracji, spisuj sukcesy i porażki, twórz powtarzalne playbooki |
Twoja migracja to dopiero początek
Udana migracja nie kończy się z chwilą załadowania ostatniego zbioru danych na docelową platformę. Zmienia ona model operacyjny wokół Twoich danych. Jeśli Twój zespół zrobił to dobrze, nie tylko skopiowałeś rekordy z jednego miejsca w drugie. Wyjaśniłeś strukturę własności, uporządkowałeś ukryty dług jakościowy, ujawniłeś ukryte założenia dotyczące schematów i zbudowałeś monitoring, który zapewnia wiarygodność nowej platformy w rzeczywistych warunkach produkcyjnych.
To rozróżnienie ma kluczowe znaczenie, ponieważ najbardziej dotkliwe problemy migracyjne często ujawniają się dopiero wtedy, gdy zespół projektowy uważa pracę za zakończoną. Spóźnione zasilenia generują nieaktualne raporty. Niezauważone zmiany schematu psują relacje łączące tabele i potoki danych. Luki w regułach biznesowych omijają weryfikację liczby wierszy i wychodzą na jaw później w dziale finansów, obsługi klienta czy procesach zgodności (compliance). Zespoły, które walidują dane wyłącznie w noc wdrożenia, zazwyczaj spędzają kolejne tygodnie na gaszeniu pożarów, których można było uniknąć.
Najlepsze programy migracyjne traktują Observability jako stałą część dostarczania wartości. Walidują rekordy zarówno przed, jak i po transferze. Porównują zachowanie źródła i celu podczas działania równoległego. Monitorują wzorce napływu danych, a nie tylko techniczne statusy wykonania zadań. Stale śledzą zmiany w schematach i badają anomalie w odniesieniu do wyuczonego poziomu odniesienia. Jest to praktyczne przejście od jednorazowego podejścia projektowego do myślenia w kategoriach ciągłej niezawodności.
Takie podejście ułatwia również skalowanie działań w miarę wzrostu potrzeb migracyjnych. Środowiska korporacyjne nie stają się prostsze. Platformy danych zasilają jednocześnie analitykę, aplikacje operacyjne, systemy uczenia maszynowego i zewnętrzne raportowanie. Migracja, która kończy się sukcesem technicznym, ale osłabia zaufanie do tych powiązanych zastosowań, nadal stanowi porażkę biznesową. Skuteczny monitoring uzupełnia tę lukę, dając inżynierom i interesariuszom wspólny pogląd na kondycję danych po przenosinach.
W przypadku zespołów z sektorów regulowanych model operacyjny jest równie ważny jak same narzędzia. Wiele organizacji nie może pozwolić zewnętrznym dostawcom na bezpośredni dostęp do produkcyjnych zbiorów danych, co sprawia, że walidacja wewnątrz bazy danych i wdrożenie kontrolowane przez klienta to kluczowe decyzje architektoniczne, a nie zwykłe szczegóły techniczne. Uruchamianie weryfikacji w miejscu, w którym dane już się znajdują, ogranicza ich niepotrzebny ruch i pomaga zespołom zachować poufność, lokalizację i granice audytu, przy jednoczesnym zachowaniu pełnej widoczności procesu.
digna to jedno z rozwiązań doskonale pasujących do tego modelu. Jej platforma łączy wykrywanie anomalii, monitorowanie terminowości, walidację na poziomie pojedynczych rekordów, śledzenie zmian schematu oraz analizę historyczną w ramach jednego systemu działającego w środowisku kontrolowanym przez klienta – bez konieczności udostępniania danych produkcyjnych na zewnątrz. To połączenie jest bardzo pomocne, gdy zespoły ds. migracji poszukują spójnej warstwy operacyjnej, zamiast łączyć ze sobą odrębne narzędzia do kontroli jakości i obserwowalności (observability).
Wniosek praktyczny jest prosty. Nie mierz sukcesu migracji wyłącznie tym, czy dane zostały przeniesione. Zmierz, czy pozostały one kompletne, terminowe, poprawne, stabilne strukturalnie i wiarygodne po wznowieniu ich biznesowego użytkowania. Jeśli Twój plan uwzględnia te cele, nie musisz mieć nadziei, że migracja się udała – działasz w oparciu o twarde dowody.
Jeśli planujesz migrację i chcesz zyskać większą kontrolę nad walidacją, terminowością, zmianami schematów i wykrywaniem anomalii bez narażania danych produkcyjnych, warto rozważyć rozwiązanie digna.



