Monitorowanie potoków danych: Metryki i inteligentne alertowanie
|
5
min. czyt.

Możesz mieć trzy zielone pulpity nawigacyjne i nadal budzić się z uszkodzonym pakietem raportów zarządczych, brakującym zasilaniem finansowym lub raportem BI, któremu nikt nie ufa. To irytująca prawda o monitorowaniu rurociągów danych. Zadaniem nie jest wpatrywanie się w kolejne wykresy, ale wiedza – odpowiednio wcześnie – czy dane są opóźnione, zniekształcone, dryfują, czy też mogą zakłócić coś w dalszej części procesu.
W Europie ta presja jest silniejsza, ponieważ monitorowanie nie jest tylko technicznym nawykiem. Hiszpański plan Cyfrowa Hiszpania 2025, uruchomiony z budżetem 2,5 miliarda euro, postawił dane i interoperacyjność w centrum infrastruktury publicznej, a unijny akt ws. zarządzania danymi (EU Data Governance Act) dodał kolejną warstwę oczekiwań dotyczących zaufania i dostępu do przepływów danych między organizacjami, co oznacza, że kontrole rurociągów danych znajdują się teraz wewnątrz szerszej historii związanej z governance, a nie poza nią. Polityczne tło staje się tutaj niemożliwe do zignorowania, zwłaszcza gdy terminowość, spójność schematów i identyfikowalność są wymaganiami biznesowymi w równym stopniu, co inżynieryjnymi.
Poza nocnymi pożarami o 3 rano
O 3 rano pierwszą wskazówką jest zazwyczaj wiadomość od kogoś, kogo nie obchodzi status Twoich procesów DAG. Finanse chcą liczb. Operacje chcą odpowiedzi. Pulpit nawigacyjny jest uszkodzony, rurociąg zgłasza sukces, a logi są rozproszone w trzech narzędziach, z których każde twierdzi, że wykonało swoje zadanie. To ten rodzaj nocy, który zamienia porządnego inżyniera w stałego ratownika ds. incydentów.
Rozwiązaniem nie jest „więcej alertów”. To przejście od reaktywnego monitorowania do Observability. Praktycznym celem jest dostrzeżenie awarii, zanim odczuje ją osoba w biznesie, co oznacza śledzenie end-to-end takich aspektów jak Data Timeliness, zmiany schematów i luki w dostarczaniu danych. W regulowanych europejskich środowiskach ta zmiana ma jeszcze większe znaczenie, ponieważ pytanie brzmi nie tylko „czy zadanie się uruchomiło?”, ale „czy odpowiednie dane dotarły w odpowiednim kształcie tam, gdzie powinny?”
Praktyczna zasada: jeśli alert mówi Ci tylko, że infrastruktura obliczeniowa jest sprawna, nie monitorujesz rurociągu, tylko serwer.
Oto dlaczego ten problem przeniósł się z higieny operacyjnej do obszaru governance. Przydatnym punktem wyjścia jest szeroka lista kontrolna niezawodności, a jeśli potrzebujesz punktu odniesienia do myślenia o ryzyku w rurociągach danych, warto mieć pod ręką tę listę kontrolną niezawodności danych dla zespołów zajmujących się danymi podczas projektowania własnych reguł monitorowania.
Co tak naprawdę monitorować w rurociągach danych
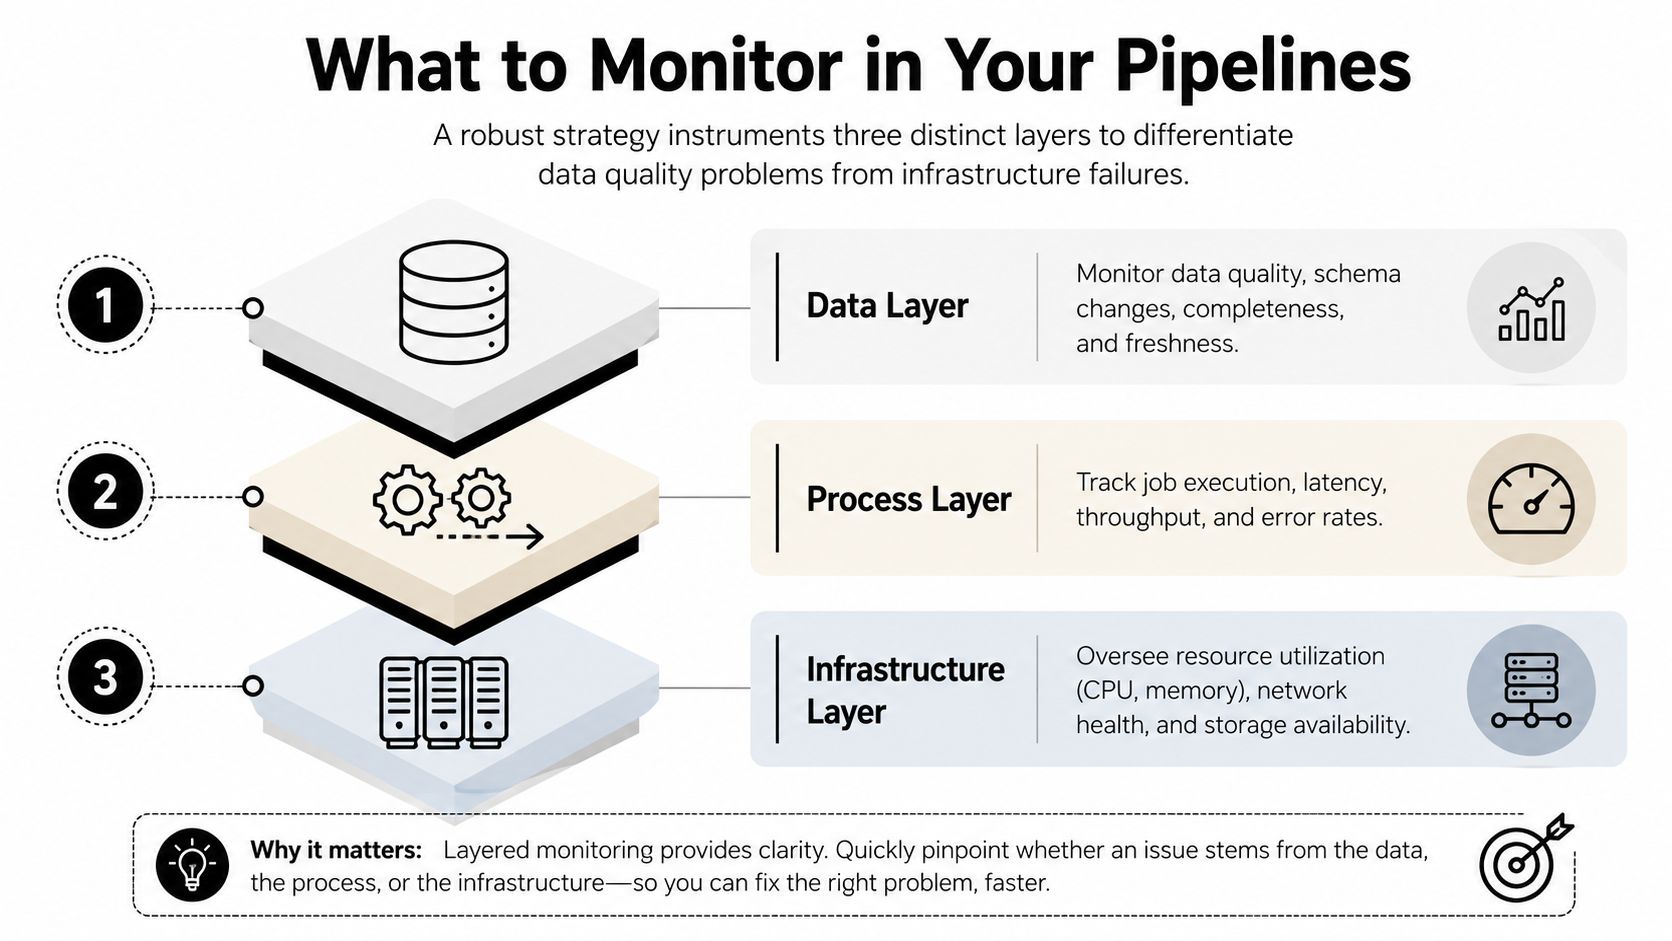
Rurociąg danych najłatwiej debugować, gdy każdy sygnał należy do jasnej warstwy. Jeśli wymieszasz jakość danych, wykonywanie zadań i kondycję klastra w jednym worku, spędzisz połowę życia, pytając, czy problem leży w źródle, transformacji, czy na platformie. Czystszym posunięciem jest monitorowanie trzech warstw jednocześnie, a następnie decydowanie o tym, co uległo awarii, bez konieczności prowadzenia rygorystycznego śledztwa.
Warstwa danych
Ciche uszkodzenia zwykle zaczynają się w tym punkcie.
Znaczniki czasu świeżości mówią, czy dane dotarły z opóźnieniem, co ma znaczenie, gdy raportowanie i dalsze umowy SLA są wrażliwe na czas.
Liczba rekordów wychwytuje spadki i duplikacje, ale silniejszym sygnałem jest trend w czasie, a nie pojedynczy próg.
Dryf schematu ujawnia dodane, usunięte lub przeklasyfikowane pola, zanim modele BI i transformacje zaczną działać niepoprawnie.
Wskaźniki wartości null i anomalie w dystrybucji ujawniają uszkodzenia, które na poziomie wykonywania zadania wciąż wyglądają na „zakończone sukcesem”.
Oczekiwany czas dostarczenia w porównaniu z rzeczywistym nadejściem jest szczególnie przydatny w przypadku zasileń realizowanych według harmonogramu, ponieważ pozwala wykryć opóźnienia, zanim ludzie zobaczą nieaktualny pulpit nawigacyjny.
Warstwa procesowa
Często ujawniają się tu problemy z orkiestracją.
Czas trwania uruchomienia pomaga dostrzec pełzające spowolnienia, zanim zadania zaczną się na siebie nakładać.
Opóźnienie między etapami pokazuje, czy jedno zadanie blokuje drugie, co często jest pierwszym sygnałem problemów z zależnościami.
Wskaźniki błędów w podziale na zadania pozwalają odróżnić niestabilną transformację od awarii źródła danych.
Unikalne identyfikatory uruchomień umożliwiają śledzenie jednego wykonania w logach, alertach i pod kątem wpływu na dalsze etapy.
Czas od ostatniego udanego uruchomienia to jedna z najszybszych metod weryfikacji, gdy zespół zaczyna pytać, dlaczego tabela nie została zaktualizowana.
Warstwa infrastruktury
Ta warstwa ma znaczenie, ale nie powinna być jedyną.
Procesor i pamięć pomagają wychwycić przeciążenie zasobów, zanim zadania całkowicie zakończą się niepowodzeniem.
Wejście/wyjście dysku i dostępność pamięci masowej mają znaczenie, gdy ładowanie danych zwalnia z powodów, które wyglądają na problemy z samymi danymi.
Stan sieci może wyjaśnić, dlaczego pobieranie danych zostało wstrzymane, mimo że kod nie uległ zmianie.
Sygnały o awariach na poziomie platformy są przydatne jako zabezpieczenie, ale nie wychwycą poprawnie wyglądającego zadania, które zapisało błędne dane.
Jeśli potrzebujesz punktu odniesienia dla rodzajów kontroli jakości danych, które należą do pierwszej warstwy, te metryki jakości danych są dobrym sposobem na przełożenie abstrakcyjnej „jakości” na rzeczywiste sygnały observability. A jeśli normalizujesz nieregularne źródła danych domenowych, ta sama zasada obowiązuje niezależnie od tego, czy zajmujesz się finansami, czy normalizujesz dane e-sportowe dla CS2 – struktura danych ma większe znaczenie niż etykieta systemu źródłowego.
Wybór stosu narzędzi do Observability
Decyzja typu „zbudować samodzielnie czy kupić gotowe” szybko staje się skomplikowana, gdy w grę wkracza prywatność danych. Własny stos zbudowany na bazie logów orkiestracji, zapytań do magazynu danych i niestandardowych reguł alertów może działać, ale oznacza więcej kodu do utrzymania, więcej konfiguracji do dostrajania i więcej miejsc, w których sama warstwa monitorowania może ulec awarii. Jest to do zaakceptowania dla małego zespołu z prostymi przepływami. Staje się jednak uciążliwe w finansach, opiece zdrowotnej, sektorze publicznym i wszędzie tam, gdzie lokalizacja przechowywania danych (data residency) ma kluczowe znaczenie.
Większym problemem jest architektura. Wiele starszych narzędzi do monitorowania nadal wymaga wypychania metadanych, ekstraktów lub próbek do środowiska dostawcy. To rozwiązanie sprawdza się, dopóki zestaw danych nie jest wrażliwy, regulowany lub po prostu nie powinien opuszczać granic kontrolowanych przez klienta. Dla europejskich przedsiębiorstw jest to niewłaściwe podejście domyślne. Monitorowanie powinno odbywać się tam, gdzie znajdują się dane.

Observability wewnątrz bazy danych zmienia postać rzeczy. Platformy takie jak digna automatycznie obliczają metryki danych bezpośrednio w bazie, uczą się wartości bazowych, analizują trendy i monitorują harmonogramy w środowisku klienta. System wykrywania anomalii oblicza metryki takie jak Sum, Min i liczby wartości dla każdej kolumny, co oznacza, że bada zachowanie danych bez konieczności ich przesyłania. Model wdrożenia jest udokumentowany tutaj, a praktyczna korzyść jest prosta: warstwa monitorowania może dopasować się do granic przechowywania danych, zamiast z nimi walczyć.
Jeśli Twój plan monitorowania zależy od wysyłania danych produkcyjnych w inne miejsce, oznacza to, że właśnie stworzyłeś problem z obszaru Compliance, którego próbowałeś uniknąć.
Istnieje również korzyść związana z Data Governance, która często umyka w dyskusjach o narzędziach. Wykonywanie operacji wewnątrz bazy danych zmniejsza tarcia operacyjne, zachowuje możliwość audytu i ułatwia utrzymanie warstwy kontrolnej blisko warstwy danych. Dla europejskich przedsiębiorstw jest to znacznie lepsze rozwiązanie niż warstwa widoczności, która w efekcie staje się kolejnym rurociągiem do eksportu danych.
Wyposażanie rurociągów w narzędzia dla pełnej widoczności

Rurociąg danych staje się możliwy do monitorowania tylko wtedy, gdy emituje odpowiednie metadane. Airflow, dbt, Spark i podobne narzędzia nie wskażą w magiczny sposób przyczyny źródłowej, jeśli Twoje zadania nie rejestrują wystarczającego kontekstu, aby połączyć kropki. Najczystszym wzorcem jest zapewnienie identyfikowalności każdego uruchomienia od samego początku, a następnie dołączanie metryk jakości w momencie zapisu danych.
Praktyczny godzinowy przepływ danych o sprzedaży
Weźmy pod uwagę godzinowe ładowanie danych o sprzedaży w e-commerce. Źródło rejestruje zamówienia, Twoja transformacja je wzbogaca, a tabela w magazynie danych zasila raportowanie. Pierwszą rzeczą, którą należy dodać, jest unikalny identyfikator uruchomienia, który towarzyszy zadaniu od momentu pobrania danych przez transformację aż po załadowanie. Bez tego każdy incydent zamienia się w archeologię logów.
Następnie rejestruj ustrukturyzowane zdarzenia na początku i na końcu każdego zadania. Przechwytuj migawkę źródła, tabelę docelową, liczbę wierszy na wejściu, liczbę wierszy na wyjściu oraz wszelkie zaobserwowane po drodze zmiany schematu. Jeśli pulpit nawigacyjny nagle pokazuje mniejszą sprzedaż, chcesz wiedzieć, czy pobranie danych było niepełne, czy transformacja odrzuciła wiersze, czy też ładowanie nigdy się nie zakończyło.
Co należy emitować za każdym razem
Identyfikator uruchomienia w celu zapewnienia identyfikowalności w różnych systemach.
Znaczniki czasu etapów, aby móc zmierzyć, gdzie stracono czas.
Liczba rekordów przed transformacją i po niej, aby wychwycić ciche utraty danych.
Metadane schematu, aby nowe kolumny lub zmiany typów nie przeszły niezauważone.
Wyniki walidacji dla istotnych reguł biznesowych, takich jak zduplikowane identyfikatory zamówień czy brakujące klucze klientów.
Najlepszym nawykiem wdrożeniowym jest spójność. Jeśli każdy rurociąg emituje nieco inny format metadanych, odpytywanie systemów alertów i pulpitów nawigacyjnych staje się trudniejsze niż praca z samymi danymi. Ustandaryzuj schemat zdarzeń na wczesnym etapie, a potem dbaj o to, by pozostał prosty. Proste metadane to dobre metadane.
Zachowanie historyczne również ma znaczenie. Wskazówki dotyczące monitorowania od firmy Astera bezpośrednio wskazują problem ze statycznymi kontrolami – generują one szum i pomijają stopniowe zmiany – dlatego podczas wyposażania rurociągu w narzędzia pomiarowe korzystaj z historycznych linii bazowych, a nie tylko ze stałych progów. Podejście typu code-first do wprowadzania observability do zadań związanych z danymi jest przydatne, jeśli chcesz wbudować to rozwiązania na etapie rozwoju oprogramowania, zamiast dodawać je później.
Konfigurowanie inteligentnych alertów i pulpitów nawigacyjnych
Statyczne progi łatwo ustawić i łatwo tego żałować. „Wyślij alert, jeśli liczba wierszy spadnie poniżej X” brzmi dobrze, dopóki nie zmieni się specyfika biznesu, nie wejdzie sezonowość lub gdy źródło naturalnie cichnie w weekendy. Wtedy kanał alertów zapełnia się śmieciami, wszyscy go wyciszają, a ten jeden prawdziwy incydent zostaje zignorowany, ponieważ zespół nauczył się nie ufać generowanemu szumowi.
Lepszym modelem jest alertowanie oparte na linii bazowej. Oznacza to obserwowanie kształtu danych w czasie, a następnie flagowanie odchyleń od normalnego zachowania, a nie tylko sytuacji, gdy przypadkowa liczba przekroczy granicę. Różnica w codziennej pracy operacyjnej jest ogromna. Codzienne zasilanie z mniejszym wolumenem weekendowym nie powinno nikogo niepokoić. Nagłe opóźnienie w świeżości regulowanego zbioru danych prawdopodobnie powinno.

W takich sytuacjach swoje zadanie doskonale spełnia wykrywanie anomalii oparte na sztucznej inteligencji. digna automatycznie uczy się normalnego zachowania zbioru danych i flaguje odchylenia bez konieczności ręcznego utrzymywania reguł, zachowując jednocześnie historyczny kontekst observability wokół każdego alertu. Podejście do automatyzacji zostało opisane tutaj, a jego wartość nie polega na tym, że jest nowoczesne, ale na tym, że ogranicza bezużyteczne alerty, z powodu których zespoły przestają zwracać na nie uwagę.
Użyteczny pulpit nawigacyjny to krótki pulpit. Powinien na pierwszy rzut oka pokazywać status SLA, świeżość, dryf i bieżące incydenty, a następnie pozwalać na przejście do uszkodzonej tabeli lub zadania bez przeszukiwania pięciu różnych kart. Jeśli pulpit nawigacyjny wymaga ustnego wyjaśnienia za każdym razem, gdy ktoś go otwiera, oznacza to, że jest już zbyt skomplikowany.
Zasada: pulpity nawigacyjne służą do oceny sytuacji i ustalania priorytetów, a nie na pokaz.
Dla europejskich zespołów istnieje tutaj dodatkowa zaleta. Inteligentniejsze alertowanie pomaga zachować selektywność, co ma znaczenie, gdy rosną zarówno koszty chmury, jak i narzuty związane z governance. Potrzebujesz monitorowania, które udowadnia swoją wartość poprzez ujawnianie anomalii wymagających działania, a nie poprzez zalewanie zespołu kosztownymi i pewnymi informacjami o nieistotnych rzeczach.
Od alertu do rozwiązania: proces rozwiązywania problemów
Alert powinien rozpoczynać diagnozę, a nie panikę. Pierwszym pytaniem jest zawsze zakres wpływu (blast radius), ponieważ jedno uszkodzone zasilanie może popsuć jeden raport lub dotknąć dziesięciu odbiorców końcowych. Drugim pytaniem jest to, czy błąd powstał w źródle, transformacji, czy na ścieżce dostarczania. Jeśli pominiesz te pytania, zaczniesz debugować w kółko.
Najszybszy proces rozpoczyna się od samego kontekstu alertu. Dobra platforma nie wyświetli tylko komunikatu „wykryto anomalię” – pokaże, jak długo utrzymuje się trend danej metryki, czy ten wzorzec pojawił się już wcześniej oraz czy problem jest odosobniony, czy jest częścią szerszego wzorca w zbiorze danych. Dokładnie taki rodzaj kontekstu zapewnia model alertów digna, co skraca drogę od symptomu do prawdopodobnej przyczyny.
Prosta kolejność działania
Najpierw sprawdź kontekst alertu. Potwierdź, czy problem to nagła awaria, czy powolny dryf.
Śledź identyfikator uruchomienia. Użyj go, aby przejść przez rurociąg w centralnych logach, zdarzeniach zadań i dalszych zależnościach.
Sprawdź powiązania (lineage) i odbiorców. Dowiedz się, które pulpity nawigacyjne, modele lub raporty zależą od dotkniętej problemem tabeli.
Przejrzyj ostatnie zmiany w kodzie lub konfiguracji. Wiele awarii wynika z niewinnie wyglądającej zmiany harmonogramu lub aktualizacji schematu.
Porównaj z poprzednimi incydentami. Powtarzające się wzorce zazwyczaj wskazują na niestabilne źródło lub błędne założenie.
Ta sekwencja zamienia rozwiązywanie problemów w powtarzalny proces. Pomaga również zespołom uniknąć klasycznego błędu traktowania każdego incydentu jako jednorazowego zdarzenia. Jeśli ta sama klasa awarii ciągle powraca, problemem zazwyczaj nie jest alert, lecz brak rzeczywistego modelu zależności.
Najlepsi operatorzy pamiętają o jednej zasadzie: każdy alert ma swoją historię, nawet jeśli ta historia jest skomplikowana. Skorzystaj z niej. Następnie użyj identyfikatora uruchomienia, kontekstu bazowego i widoku wpływu na dalsze etapy, aby zdecydować, czy masz do czynienia z problemem z danymi, z orkiestracją, czy z wadą projektową rurociągu, którą należy naprawić u źródła.
Jeśli projektujesz na nowo swój system monitorowania dla regulowanego środowiska europejskiego, zacznij od granic, a nie od alertów. Zmapuj, co musi pozostać w środowisku klienta, zdefiniuj metryki, które mają znaczenie dla każdego zbioru danych, a następnie przetestuj warstwę monitorowania wewnątrz bazy danych na jednym działającym rurociągu, zanim wdrożysz ją szerzej. Praktycznym kolejnym krokiem jest ocena platformy digna pod kątem własnych wymagań dotyczących przechowywania danych, terminowości i dryfu schematów, a następnie użycie rzeczywistego przepływu produkcyjnego, aby sprawdzić, czy ujawnia ona problemy, zanim zrobią to użytkownicy.
Kontrolę oczekiwanego i rzeczywistego czasu dostarczenia, opisaną w warstwie danych, realizuje digna Timeliness, monitorujący, kiedy dane powinny dotrzeć, i sygnalizujący opóźnione lub brakujące ładowania.
Najczęściej zadawane pytania
Co należy monitorować w pipeline danych?
Monitoruj trzy warstwy oddzielnie. Warstwa danych obejmuje znaczniki świeżości, liczbę rekordów, dryf schematu, odsetek wartości null oraz oczekiwany i rzeczywisty czas dostarczenia; warstwa procesów obejmuje czas wykonania, opóźnienia między etapami, wskaźniki błędów zadań i identyfikatory uruchomień; warstwa infrastruktury obejmuje CPU, pamięć, operacje dyskowe i stan sieci.
Dlaczego unikalny identyfikator uruchomienia jest ważny w monitorowaniu pipeline'ów?
Unikalny identyfikator uruchomienia pozwala śledzić jedno wykonanie od pobrania danych, przez transformację, po załadowanie, w logach, alertach i skutkach downstream. W przykładzie z artykułu dotyczącym godzinowego feedu sprzedaży e-commerce dodaje się go jako pierwszy, bo bez niego każdy incydent zamienia się w archeologię logów.
Jakie metadane powinno emitować każde uruchomienie pipeline'u?
Każde uruchomienie powinno emitować identyfikator, znaczniki czasu etapów, liczbę rekordów przed i po transformacji, metadane schematu oraz wyniki walidacji reguł biznesowych, np. zduplikowanych identyfikatorów zamówień lub brakujących kluczy klientów. Artykuł zaleca też wczesną standaryzację schematu zdarzeń, aby alerty i dashboardy były łatwe do odpytywania.
Dlaczego statyczne progi źle sprawdzają się w alertach pipeline'ów?
Statyczne reguły typu „alarmuj, gdy liczba wierszy spadnie poniżej X” zawodzą przy sezonowości lub gdy źródło milknie w weekendy; kanał zapełnia się szumem, a zespoły go wyciszają. Alertowanie oparte na liniach bazowych sygnalizuje odchylenia od wyuczonego normalnego zachowania i wychwytuje stopniowy dryf.
Jak diagnozować alert w pipeline danych?
Zacznij od kontekstu alertu, aby ustalić, czy to nagła awaria, czy powolny dryf. Następnie prześledź identyfikator uruchomienia w logach, sprawdź lineage i odbiorców downstream, przejrzyj ostatnie zmiany kodu lub konfiguracji i porównaj z wcześniejszymi incydentami, ponieważ powtarzające się wzorce zwykle wskazują na niestabilne źródło.



