Kontrola integralności referencyjnej: konfiguracja krok po kroku
|
6
min. czyt.

Klucz obcy, który wskazuje donikąd, nie zgłasza błędu. Wiersz się ładuje, najbliższy INNER JOIN go odrzuca, a raport pokazuje zero tam, gdzie powinno być 82. Kontrola integralności referencyjnej to reguła walidacji danych, która potwierdza, że każda wartość w kolumnie podrzędnej (lub w zestawie kolumn) istnieje w tabeli nadrzędnej, do której się odwołuje, i zgłasza wiersze, które tego warunku nie spełniają.
Większość platform analitycznych nie wykona jej za Ciebie. Snowflake traktuje klucze obce w standardowych tabelach jako opcjonalne i niewymuszane, a BigQuery wprost stwierdza, że to Ty odpowiadasz za ich utrzymanie. Redshift i Databricks zachowują się tak samo. Kontrola musi więc działać gdzie indziej.
Ten poradnik pokazuje, jak w praktyce sprawdzać integralność referencyjną: najpierw decyzje, które trzeba podjąć (relacje, kolumny, wartości NULL, progi, moment uruchomienia), a potem konfiguracja w digna: kilka pól, zero SQL. Jeśli wolisz zacząć od samego pojęcia, przeczytaj nasz przewodnik po integralności referencyjnej i rekordach osieroconych.
Najważniejsze wnioski
Najpierw sprawdzaj relacje, na których złączeniach opierają się Twoje raporty: tabele faktów z wymiarami oraz rekordy podrzędne z nadrzędnymi, uszeregowane według tego, co się psuje, gdy zawiodą.
Używaj dokładnie tych kolumn złączenia po obu stronach. Klucz złożony jest sprawdzany jako kombinacja, a obie listy kolumn muszą mieć tę samą długość i kolejność.
Klucz obcy o wartości NULL nie powoduje niepowodzenia kontroli integralności referencyjnej. Jeśli odwołanie jest obowiązkowe, dodaj osobną regułę NOT NULL.
Dla danych finansowych i klinicznych stosuj zerową tolerancję, a dla dużych tabel ze znanym „ogonem” spóźnionych odwołań – próg względny.
W digna kontrola to reguła typu Referential Integrity: wybierasz kolumny, wskazujesz, gdzie muszą istnieć, ustawiasz dwa progi i zapisujesz. Reguła działa w Twojej bazie danych przy każdej inspekcji.
Spis treści
Czym jest kontrola integralności referencyjnej?
Które relacje sprawdzić w pierwszej kolejności?
Jak dobrać kolumny i klucze złożone?
Co powinien oznaczać klucz obcy o wartości NULL?
Jakiego progu powinna używać kontrola integralności referencyjnej?
Kiedy uruchamiać kontrolę integralności referencyjnej?
Jak skonfigurować kontrolę integralności referencyjnej w digna?
Jak wygląda odpowiednik w SQL?
Jak odczytać nieudaną kontrolę integralności referencyjnej?
Od czego zacząć?
Czym jest kontrola integralności referencyjnej?
Kontrola integralności referencyjnej bierze kolumnę (lub zestaw kolumn) tabeli podrzędnej i potwierdza, że każda wypełniona wartość istnieje również w tabeli nadrzędnej, do której się odwołuje. Wiersze, które znajdują rekord nadrzędny, przechodzą kontrolę. Wiersze, które go nie znajdują, są sierotami i jej nie przechodzą. Wynikiem jest liczba wierszy poprawnych, liczba błędnych oraz – jeśli o to poprosisz – same błędne wiersze. Spotkasz się też z nazwami „kontrola klucza obcego” lub „walidacja integralności referencyjnej”.
Ograniczenie klucza obcego działa w momencie zapisu i odrzuca operację INSERT. Kontrola działa po załadowaniu danych i mówi, jaka część załadowanych danych wskazuje donikąd. Tam, gdzie zadeklarowane klucze mają wyłącznie charakter informacyjny, kontrola jest jedynym zabezpieczeniem, jakie faktycznie masz.
Podejście | Kiedy działa | Co dzieje się z sierotą | Działa tam, gdzie klucze obce nie są wymuszane | Co otrzymujesz |
|---|---|---|---|---|
Ograniczenie klucza obcego | Przy INSERT lub UPDATE | Odrzucona; ładowanie kończy się błędem | Nie, deklaracja jest tylko wskazówką | Komunikat o błędzie |
Doraźne zapytanie SQL | Gdy ktoś pamięta, żeby je uruchomić | Nic, dopóki ktoś nie zajrzy | Tak | Zbiór wyników w czyimś kliencie SQL |
Kontrola integralności referencyjnej w digna | Przy każdej inspekcji, według harmonogramu lub na żądanie | Załadowana, policzona i wylistowana | Tak, także między połączeniami bazodanowymi | Liczby poprawnych/błędnych wierszy, status względem Twojego progu, błędne wiersze |
Które relacje sprawdzić w pierwszej kolejności?
Najpierw sprawdź relacje, na których faktycznie opierają się złączenia w Twoich raportach i zadaniach na dalszych etapach: tabele faktów z ich wymiarami oraz rekordy podrzędne z ich rekordami nadrzędnymi. Zerwane powiązanie w tym miejscu zmienia liczby, które ludzie czytają i podpisują. Relacja, o którą nikt nie odpytuje, może poczekać.
Szybka inwentaryzacja daje Ci uszeregowaną listę:
Wypisz złączenia fakt–wymiar. Księgowania z kontami, roszczenia z pacjentami, rekordy połączeń z abonentami, podania leków z kartoteką produktów.
Wypisz złączenia podrzędny–nadrzędny. Pozycje zamówień z zamówieniami, diagnozy z pobytami, zabezpieczenia z kredytami.
Oznacz te, które zasilają raporty, rozliczenia lub sprawozdania regulacyjne. INNER JOIN w takich zapytaniach odrzuca sieroty bez śladu.
Oznacz te, które są ładowane przez różne zadania lub systemy. Rekord podrzędny, który dotrze przed swoim rekordem nadrzędnym, jest sierotą.
Zacznij od pierwszych pięciu–dziesięciu. Resztę dodaj, gdy ktoś przejmie odpowiedzialność za wyniki.
Jeśli chcesz oszacować skalę problemu, zanim cokolwiek skonfigurujesz, zapytania z artykułu o wyszukiwaniu rekordów osieroconych w SQL dadzą Ci jednorazową liczbę dla każdej relacji.
Jak dobrać kolumny i klucze złożone?
Używaj dokładnie tych kolumn, których używa złączenie, po obu stronach i w tej samej kolejności. Jeśli rekord nadrzędny jest identyfikowany przez dwie kolumny, sprawdzaj je razem jako klucz złożony. Sprawdzanie każdej kolumny osobno przepuszcza kombinacje, które nigdzie w tabeli nadrzędnej nie występują.
Dobrym przykładem są kody oddziałów. Jeśli każdy szpital w grupie ma oddział o nazwie ICU-1, wiersz ze szpitalem 2 i ICU-1 przejdzie jednokolumnową kontrolę na ward_code, o ile szpital 1 ma taki oddział. Wyłapie go dopiero para (hospital_id, ward_code). digna sprawdza kombinację, gdy wybierzesz kilka kolumn, i odrzuca listy kolumn o różnej długości, zamiast sprawdzać słabszy warunek.
Najpierw ustal jeszcze dwie rzeczy:
Wskazuj klucz rekordu nadrzędnego, a nie etykietę. Sprawdzaj
product_codewzględemproduct_codew kartotece, a nie względem nazwy produktu, którą ktoś może edytować.Zadbaj o porównywalność obu stron. Kod zapisany po jednej stronie jako tekst z zerami wiodącymi, a po drugiej jako liczba, daje sieroty, które nie są prawdziwe. Znormalizuj go w widoku i sprawdzaj widok: w digna źródłem danych może być tabela, widok lub własne zapytanie SQL.
Co powinien oznaczać klucz obcy o wartości NULL?
Z góry zdecyduj, czy klucz obcy o wartości NULL jest dozwolony. Kontrola integralności referencyjnej pyta, czy wartość istnieje w tabeli nadrzędnej, a NULL nie ma wartości do wyszukania, dlatego digna pomija wartości NULL w tej kontroli. Jeśli odwołanie jest obowiązkowe, dodaj osobną regułę NOT NULL, aby brakująca wartość i wartość wisząca w próżni pojawiały się jako różne ustalenia.
Niektóre odwołania są w naturalny sposób opcjonalne: lekarz kierujący, kod promocyjny, konto nadrzędne klienta najwyższego poziomu. Inne nigdy takie nie są: każde księgowanie ma konto, każda podana dawka ma produkt. Rozdzielenie ich sprawia, że sposób naprawy jest oczywisty: brakujące odwołanie wraca do systemu, który je rejestruje, a wiszące – do zespołu danych głównych lub do kolejności ładowania.
Co chcesz wyłapać | Typ reguły w digna | Przykład |
|---|---|---|
Wartość jest, ale nie ma jej w tabeli nadrzędnej | Referential Integrity |
|
Brak wartości tam, gdzie jest wymagana | Rule |
|
Klucz występuje w tabeli nadrzędnej więcej niż raz | Uniqueness |
|
Trzeci wiersz też ma znaczenie: zduplikowany klucz nadrzędny nie tworzy sierot, ale podwaja każdy wiersz, który się z nim łączy.
Jakiego progu powinna używać kontrola integralności referencyjnej?
Dla danych finansowych i klinicznych stosuj zerową tolerancję – tam jedna sierota to jedna błędna liczba w sprawozdaniu albo jedna dawka brakująca w dokumentacji pacjenta. Próg względny stosuj dla bardzo dużych tabel, w których mały, znany „ogon” spóźnionych odwołań jest normalny i uwagi wymaga dopiero skok ponad ten poziom.
digna daje każdej regule Threshold Mode (tryb progu). Absolute (bezwzględny) porównuje liczbę błędnych rekordów. Relative (względny) porównuje stosunek błędnych rekordów do ocenianych, wyrażony jako ułamek, więc 0.01 oznacza jeden procent. Każdy tryb ma dwa poziomy: powyżej Info threshold status to Uncertain, powyżej Warn threshold – Failed, w pozostałych przypadkach – Passed. Oba domyślnie wynoszą zero, więc nowa reguła kończy się niepowodzeniem już przy jednym złym rekordzie, dopóki nie zdecydujesz inaczej.
Sytuacja | Threshold Mode | Info | Warn | Efekt |
|---|---|---|---|---|
Księgowania do kont, dawki do kartoteki produktów | Absolute | 0 | 0 | Jedna sierota oznacza niepowodzenie przebiegu |
Te same dane, ale pojedynczy zabłąkany rekord ma najpierw dać sygnał, zanim spowoduje niepowodzenie | Absolute | 0 | 1 | Jedna sierota daje Uncertain, dwie lub więcej – Failed |
Rekordy zdarzeń lub połączeń ze znanymi spóźnionymi wymiarami | Relative | 0.001 | 0.01 | Powyżej 0,1% Uncertain, powyżej 1% Failed |
Zacznij restrykcyjnie i luzuj tylko z powodu, który potrafisz zapisać.
Kiedy uruchamiać kontrolę integralności referencyjnej?
Uruchamiaj ją po każdym załadowaniu tabeli podrzędnej, a także po załadowaniach tabeli nadrzędnej, bo sieroty pojawiają się zawsze, gdy obie docierają w złej kolejności. W digna reguła działa przy każdej inspekcji swojego źródła danych, według harmonogramu lub na żądanie, więc dopasuj inspekcję do ładowania, a nie do kalendarza raportowego.
Kontrola na koniec miesiąca znajduje sieroty z całego miesiąca naraz, gdy raport jest już na wczoraj. Kontrola po każdym ładowaniu znajduje sieroty z jednego dnia, gdy osoba, która ładowała dane, wciąż pamięta, co się zmieniło. Koszt to jedno złączenie na przebieg, wykonywane w źródłowej bazie danych, bez kopiowania czegokolwiek na zewnątrz. Gdy kontrola zawiedzie, powiadom zespół, który jest właścicielem danych.
Jak skonfigurować kontrolę integralności referencyjnej w digna?
W digna kontrola integralności referencyjnej to reguła digna Data Validation typu Referential Integrity. Wybierasz kolumny w swoim źródle danych, wskazujesz źródło danych i kolumny, w których muszą istnieć, ustawiasz dwa progi i zapisujesz. Nie trzeba pisać SQL, a konfiguracja zajmuje mniej niż minutę.
Przejdź do Configuration, wybierz źródło danych (tutaj
hospital_medication_administrations), otwórz zakładkę Data Validation i kliknij Add Rule. Otworzy się okno Add Data Validation Rule.Wpisz Name (nazwę) i Description (opis):
hc_product_in_master, „Każdy podany produkt istnieje w kartotece produktów apteki”.Ustaw Type na Referential Integrity. Pozostałe opcje to Rule i Uniqueness.
W sekcji Attributes wybierz kolumnę w tym źródle danych:
product_code.W sekcji must exist in wybierz Data Source (
hospital_medications) i jego Attributes (product_code). Dla klucza złożonego wybierz kilka kolumn po obu stronach w tej samej kolejności.Wybierz Threshold Mode i ustaw Info threshold oraz Warn threshold. W przykładzie użyto Absolute, Info 0, Warn 1.
Zapisz. Od teraz reguła działa przy każdej inspekcji tego źródła danych.

Kompletna reguła: typ, atrybuty, źródło danych, w którym muszą istnieć, i dwa progi. Dane demonstracyjne z Danubia Kliniken, fikcyjnej austriackiej grupy szpitali.
Przy Info 0 i Warn 1 już jedna sierota zmienia status na Uncertain, a każda kolejna – na Failed. Zostaw Warn na 0, jeśli pojedyncza sierota ma oznaczać niepowodzenie przebiegu. Tabela nadrzędna nie musi też leżeć obok podrzędnej: od Release 2026.01 druga strona może być tabelą lub widokiem w innym schemacie albo w innym połączeniu bazodanowym w tym samym projekcie – opisujemy to w artykule o integralności referencyjnej między bazami danych. Film Integralność referencyjna w digna: konfiguracja w niecałą minutę (2:26) pokazuje te same kroki.
Gdy takich reguł masz wiele, trzymaj je jako kod: Release 2026.06 dodał Python SDK (pip install digna-sdk) oraz import i eksport reguł walidacji między środowiskami.
Jak wygląda odpowiednik w SQL?
Pod spodem kontrola integralności referencyjnej to LEFT JOIN wierszy podrzędnych z unikalnymi kluczami nadrzędnymi, który zlicza wiersze bez dopasowania i ignoruje klucze NULL. digna generuje i uruchamia to zapytanie w Twojej bazie danych. Napisana ręcznie dla powyższego przykładu logika wygląda tak:
To ilustracja logiki, a nie dosłowne zapytanie, które wysyła digna. Dla klucza złożonego warunek złączenia ma jedną równość na każdą parę kolumn. Samo zapytanie to łatwa część. Prawdziwa praca to wszystko wokół niego: uruchamianie po każdym ładowaniu, porównywanie z progiem, przechowywanie historii, dostarczanie wierszy właściwym osobom. Dokumentacja digna opisuje, jak każdy rodzaj reguły zamienia się w SQL.
Jak odczytać nieudaną kontrolę integralności referencyjnej?
Odczytuj niepowodzenie w trzech krokach: status mówi, że próg został przekroczony, liczby mówią, jak duża jest luka, a błędne rekordy mówią, dlaczego. Sieroty z jednym wspólnym kluczem zwykle oznaczają brakujące dane główne. Sieroty rozrzucone po wielu kluczach zwykle wskazują na nieudane ładowanie tabeli nadrzędnej lub niezgodność formatu klucza.
Wróćmy do przykładu Danubia Kliniken. 2026-04-22 na oddziałach zarejestrowano 82 podania nowego produktu, zanim produkt trafił do kartoteki produktów apteki. Reguła hc_product_in_master zakończyła się niepowodzeniem: kontrolę przeszło 4 244 z 4 326 wierszy.
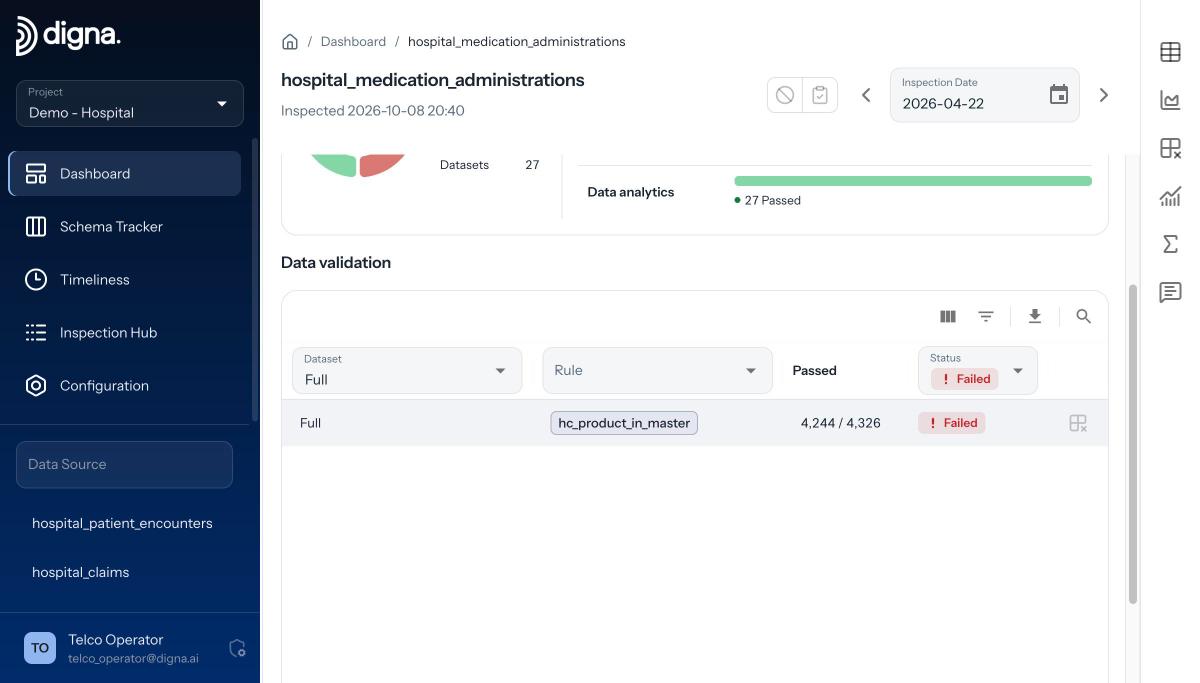
Wynik na dashboardzie: 4 244 z 4 326 poprawnych, status Failed.
Aby zobaczyć dlaczego, otwórz widok Invalid Records, ustaw filtr na Failed, wybierz kontrolę, a digna wylistuje każdy błędny wiersz. Tutaj wszystkie 82 mają ten sam product_code, 3858646 (Coavira 2.5 mg). To nie 82 błędy wprowadzania, tylko jeden produkt brakujący w kartotece. Każdy raport, który łączył dawki z produktami, pokazywał 0 dawek tego leku, podczas gdy pielęgniarki podały ich 82.

Invalid Records: każda błędna dawka ze szpitalem, oddziałem, kodem produktu i nazwą leku.
Typowe wzorce:
Jeden klucz, wiele wierszy: rekord nadrzędny jeszcze nie istnieje. Dodaj go do danych głównych i uruchom inspekcję ponownie.
Wiele kluczy, jedno ładowanie: ładowanie tabeli nadrzędnej się nie powiodło lub było opóźnione. Popraw kolejność ładowania.
Klucze, które wyglądają prawie dobrze: zera wiodące, wielkość liter lub białe znaki różnią się między systemami. Znormalizuj je w widoku.
Stare klucze: rekordy nadrzędne zostały usunięte lub zarchiwizowane, a rekordy podrzędne wciąż się do nich odwołują.
Błędne wiersze można wyeksportować, więc zespół odpowiedzialny dostaje rekordy, a nie tylko liczbę.
Od czego zacząć?
Wybierz jedną relację, której sieroty zaszkodziłyby najbardziej, gdyby w tym miesiącu trafiły do raportu, i ustaw na niej kontrolę po najbliższym ładowaniu. Każda kontrola to kilka pól, działa w Twojej bazie danych, a Twoje dane nigdy nie opuszczają Twojej infrastruktury. Jeśli chcesz zobaczyć to na własnych tabelach, umów się na demo z zespołem digna.
Najczęściej zadawane pytania
Jak sprawdzić integralność referencyjną w SQL?
Złącz tabelę podrzędną przez LEFT JOIN z unikalnymi wartościami klucza tabeli nadrzędnej i policz wiersze, w których strona nadrzędna ma wartość NULL, pomijając wiersze, których własny klucz obcy to NULL. Te wiersze to sieroty. Zamiast je liczyć, wybierz je, aby dostać rekordy do naprawy; harmonogram, progi i historię musisz zbudować samodzielnie.
Czy kontrola integralności referencyjnej kończy się niepowodzeniem przy kluczach obcych NULL?
Nie. W digna kontrole integralności referencyjnej pomijają wartości NULL, ponieważ dla NULL nie ma czego szukać w tabeli nadrzędnej. Gdy odwołanie jest obowiązkowe, dodaj osobną regułę typu Rule, np. product_code IS NOT NULL, aby brakująca wartość i osierocona wartość pojawiały się jako różne ustalenia.
Czy kontrola integralności referencyjnej może używać klucza złożonego?
Tak. Wybierz kilka atrybutów w źródle danych i tyle samo w tabeli nadrzędnej, w tej samej kolejności, a digna sprawdzi kombinację. Listy kolumn o różnej długości są odrzucane, ponieważ porównanie klucza dwukolumnowego z jedną kolumną przepuściłoby wiersze, które pełny klucz by wyłapał.
Jakiego progu powinna używać kontrola integralności referencyjnej?
Dla danych finansowych i klinicznych używaj trybu Absolute z zerową tolerancją, aby pojedyncza sierota oznaczała niepowodzenie przebiegu. Bardzo duże tabele ze znanym „ogonem” spóźnionych odwołań lepiej obsłuży próg Relative; w digna jest to ułamek, więc 0.01 oznacza jeden procent ocenianych wierszy.
Ile trwa skonfigurowanie kontroli integralności referencyjnej w digna?
Mniej niż minutę. Otwórz źródło danych w Configuration, przejdź do zakładki Data Validation, kliknij Add Rule, ustaw Type na Referential Integrity, wybierz atrybuty i źródło danych, w którym muszą istnieć, ustaw dwa progi i zapisz. digna generuje SQL i uruchamia go w Twojej bazie danych.



