Integralność referencyjna między bazami danych: jak ją sprawdzić
|
6
min. czyt.

Twoje zamówienia leżą w hurtowni danych. Klienci, na których wskazują, są w CRM, na innym serwerze, utrzymywanym przez inny zespół. Integralność referencyjna między bazami danych oznacza, że każdy klucz w jednym systemie, na przykład numer klienta w zamówieniu, odpowiada istniejącemu rekordowi w tabeli głównej innego systemu. Klucz obcy tego nie zagwarantuje, bo zadeklarowany klucz obcy z reguły działa tylko w obrębie jednej bazy danych. Gdy więc przychodzi zamówienie z numerem klienta, którego CRM nigdy nie nadał, nic nie zgłasza błędu. Wiersz się ładuje, złączenie (join) go gubi, a jakiś raport po cichu pokazuje złe liczby.
To najtrudniejszy wariant integralności referencyjnej. W obrębie jednej bazy możesz przynajmniej zadeklarować ograniczenie; na granicy bazy danych, serwera czy systemu nie ma czego deklarować. Ogólną koncepcję opisujemy w naszym głównym artykule Czy Twoje dane wciąż odnajdują swoich rodziców? Zrozumienie integralności referencyjnej. Ten artykuł dotyczy integralności referencyjnej między systemami: gdzie się psuje, ile kosztują typowe obejścia, dlaczego formaty kluczy wywołują fałszywe alarmy i jak sprawdzić ją w digna bez kopiowania danych głównych gdziekolwiek.
Najważniejsze wnioski
Klucz obcy między bazami danych z reguły nie jest możliwy: zadeklarowane ograniczenie odwołuje się do tabel w tej samej bazie, więc odwołania między systemami z założenia nie są chronione.
Typowe obejścia (zapytania federacyjne, kopiowane tabele referencyjne, wyszukiwanie kluczy w ETL, eksporty do uzgadniania) oznaczają dodatkowy przepływ danych, dodatkowe potoki albo ręczną pracę.
Różnice w formacie kluczy, takie jak wiodące zera, wielkość liter, dopełnianie spacjami czy typy danych, tworzą fałszywe rekordy osierocone. Zanim zaczniesz porównywać, ustal kanoniczną postać klucza.
Od Release 2026.01 digna Data Validation sprawdza integralność referencyjną między tabelami, widokami, schematami i różnymi połączeniami bazodanowymi w tym samym projekcie, walidując dane tam, gdzie się znajdują.
Konfiguracja to kilka pól: kolumny kluczy, źródło danych, w którym muszą istnieć, i dwa progi. Bez pisania SQL.
Spis treści
Dlaczego klucz obcy nie chroni odwołania między bazami danych?
Gdzie psują się odwołania między systemami?
Kartoteka klientów w CRM, transakcje w hurtowni
Kartoteka produktów w ERP, zamówienia w systemie zamówień
Kartoteka pacjentów i pobyty kliniczne
System core banking i hurtownia raportowa
Jak zespoły zwykle walidują odwołania między systemami?
Dlaczego niezgodne formaty kluczy tworzą fałszywe rekordy osierocone?
Jak sprawdzić integralność referencyjną między bazami danych w digna?
Które odwołania między systemami sprawdzić najpierw?
Następny krok
Dlaczego klucz obcy nie chroni odwołania między bazami danych?
Klucz obcy nie chroni odwołania między bazami danych, ponieważ jest ograniczeniem, które silnik wymusza na własnych tabelach, sprawdzając wiersz nadrzędny w tej samej bazie przy każdym INSERT, UPDATE i DELETE. Zadeklarowany klucz obcy z reguły nie może wskazywać na tabelę w innej bazie, na innym serwerze ani w innym produkcie, więc nie ma względem czego sprawdzać.
Niektóre silniki pozwalają odpytywać inne bazy, ale odpytywanie to nie ograniczenie. Wymuszane ograniczenie między systemami wymagałoby, by zdalny system był dostępny i spójny przy każdym zapisie, a osobne systemy istnieją właśnie po to, żeby jeden działał dalej, gdy drugi jest wyłączony, migrowany albo przeładowywany.
Po stronie hurtowni jest jeszcze gorzej. Wiele platform analitycznych przyjmuje deklaracje kluczy obcych, nie wymuszając ich nawet w obrębie jednej bazy: Snowflake opisuje je jako opcjonalne i niewymuszane na standardowych tabelach, a BigQuery wprost podaje, że ich nie wymusza. Do tego systemy zmieniają się niezależnie: zespół CRM scala zduplikowanych klientów, ERP wycofuje produkt. Każda taka zmiana jest poprawna we własnym systemie, a mimo to może zostawić gdzie indziej rekordy wskazujące na klucze, które już nie istnieją.
Gdzie psują się odwołania między systemami?
Odwołania między systemami psują się wszędzie tam, gdzie jeden system jest właścicielem danych głównych, a inny rejestruje aktywność: tabela transakcji odwołuje się do klienta, produktu, pacjenta lub konta utrzymywanego gdzie indziej, przez inny zespół, we własnym cyklu wydań i według własnych zasad scalania i wycofywania kluczy. Cztery sytuacje powtarzają się bez przerwy.
Kartoteka klientów w CRM, transakcje w hurtowni
Dział sprzedaży utrzymuje klientów w CRM; zamówienia trafiają do hurtowni co noc. Gdy dwa rekordy w CRM zostają scalone, jeden identyfikator znika. Zamówienia w hurtowni nadal go mają, a przychód per klient, segment czy region po cichu traci wiersze.
Kartoteka produktów w ERP, zamówienia w systemie zamówień
Nowy produkt trafia do sprzedaży, zanim rekord główny w ERP zostanie zwolniony, albo wycofany produkt zostaje usunięty, choć otwarte zamówienia wciąż się do niego odwołują. Pozycje zamówień bez pasującego produktu znikają z raportów marży i stanów magazynowych.
Kartoteka pacjentów i pobyty kliniczne
Szpitale przechowują tożsamość pacjenta w kartotece pacjentów, często w głównym indeksie pacjentów (MPI), a przyjęcia, zlecenia badań laboratoryjnych i podania leków rejestrują w systemach klinicznych. Gdy zduplikowani pacjenci zostają scaleni, pobyty wciąż odwołujące się do wycofanego identyfikatora tracą swojego pacjenta, co wpływa na rozliczenia i raportowanie kliniczne.
System core banking i hurtownia raportowa
Konta i klienci są w systemie core banking. Raportowanie zarządcze i regulacyjne działa na osobnej hurtowni zasilanej z kilku systemów źródłowych. Księgowanie odwołujące się do konta, którego brakuje w wymiarze kont hurtowni raportowej, albo wypada z sum, albo ląduje w koszyku „unknown”. Ten przypadek omawiamy szerzej w artykule o integralności referencyjnej w danych bankowych.
Jak zespoły zwykle walidują odwołania między systemami?
Zespoły zwykle walidują odwołania między systemami na jeden z czterech sposobów: odpytują zdalną tabelę przez linked server, database link lub zapytanie federacyjne; kopiują tabelę referencyjną do systemu docelowego; wyszukują klucze w trakcie ETL; albo eksportują klucze z obu stron i okresowo je uzgadniają. Każdy z tych sposobów działa i każdy ma swój koszt.
Sama kontrola to zawsze ten sam anti-join. Gdyby obie tabele były dostępne z jednego silnika, wyglądałaby tak:
Obejścia różnią się tym, jak udostępniają crm.customers systemowi, w którym leży sales_orders:
Podejście | Jak działa | Ile kosztuje |
|---|---|---|
Linked servers, database links, zapytania federacyjne | Jeden silnik odpytuje zdalną tabelę bezpośrednio i wykonuje złączenie | Oba systemy muszą działać w chwili zapytania; duże złączenia przez sieć są wolne i obciążają źródło; dane uwierzytelniające do zdalnego systemu są przechowywane w bazie; często blokowane między strefami sieciowymi |
Kopiowanie tabeli referencyjnej do hurtowni | Potok replikuje tabelę główną obok transakcji | Dodatkowy potok do zbudowania i utrzymania; kontrola jest tak aktualna jak ostatnia kopia; kolejna kopia danych głównych, często osobowych, rodzi pytania o ochronę danych i ich lokalizację (data residency) |
Wyszukiwanie kluczy w ETL | Zadanie ładujące sprawdza każdy klucz i odrzuca lub oznacza niedopasowane wiersze | Obejmuje tylko dane płynące przez ten potok; sprawdza raz, przy ładowaniu, więc późniejsze usunięcia i scalenia w danych głównych przechodzą niezauważone; tabele odrzutów rosną i nikt ich nie czyta |
Okresowe eksporty do uzgadniania | Listy kluczy z obu systemów są eksportowane do plików i porównywane | Ręcznie i rzadko; wyniki przychodzą tygodnie po błędzie; pliki z kluczami krążą mailem lub po dyskach współdzielonych |
Żadne z tych podejść nie jest błędne, ale wszystkie mają wspólny problem: albo dane się przemieszczają, albo ktoś musi pamiętać, żeby coś uruchomić. Potrzebujesz zaplanowanej kontroli, która odczytuje każdą stronę tam, gdzie leży, i mówi zespołowi będącemu właścicielem danych, które rekordy są osierocone.
Dlaczego niezgodne formaty kluczy tworzą fałszywe rekordy osierocone?
Niezgodne formaty kluczy tworzą fałszywe rekordy osierocone, bo dwa systemy mogą przechowywać ten sam klucz biznesowy w różnej postaci: w jednym jako tekst, w drugim jako liczbę, z wiodącymi zerami lub bez, inną wielkością liter albo z końcowymi spacjami. Porównanie bajt po bajcie zgłasza wtedy brak rekordu nadrzędnego, który w rzeczywistości istnieje.
To najczęstszy powód, dla którego pierwsza kontrola między systemami zgłasza tysiące błędów:
Niezgodność | System A | System B |
|---|---|---|
Wiodące zera |
|
|
Wielkość liter |
|
|
Dopełnienie i białe znaki |
|
|
Rzutowanie typów |
|
|
Prefiksy systemowe |
|
|
Napraw to w trzech krokach:
Ustal kanoniczną postać klucza, na przykład przycięty ciąg wielkimi literami, dopełniony do dziesięciu cyfr.
Znormalizuj jedną lub obie strony do tej postaci w widoku lub instrukcji SQL, blisko źródła.
Sprawdź, czy znormalizowany klucz główny nadal jest unikalny. Obcięcie zer lub ujednolicenie wielkości liter może złączyć dwa różne klucze w jeden, co ukryłoby prawdziwe rekordy osierocone.
Zapytanie normalizujące wygląda tak (nazwy funkcji nieco różnią się między bazami danych):
Nie normalizuj prawdziwych różnic. Jeśli prefiks mówi, który system źródłowy nadał klucz, klucz złożony z systemu źródłowego i numeru jest bezpieczniejszy niż obcięcie prefiksu.
Jak sprawdzić integralność referencyjną między bazami danych w digna?
W digna kontrola integralności referencyjnej między bazami danych to reguła Data Validation typu Referential Integrity, której strona „must exist in” wskazuje źródło danych na innym połączeniu bazodanowym w tym samym projekcie. Od Release 2026.01 waliduje ona dane tam, gdzie się znajdują, bez replikowania którejkolwiek tabeli do drugiego systemu.
Umożliwiają to dwie zmiany w wydaniu 2026.01. Kontrole integralności referencyjnej działają między tabelami i widokami, między schematami i między różnymi połączeniami bazodanowymi w jednym projekcie. Ponadto źródło danych jest warstwą logiczną opartą na tabeli, widoku lub własnej instrukcji SQL, co daje Ci miejsce na obsługę formatów kluczy: źródło danych oparte na własnym SQL może przyciąć, rzutować lub dopełnić klucz przed porównaniem, podobnie jak powyższe zapytanie. Przetestuj tę normalizację na prawdziwych danych, zanim zaczniesz na niej polegać. Połączenia bazodanowe są globalne, więc połączenie z CRM skonfigurowane raz może być używane przez każdy projekt.
Samą regułę konfigurujesz w jednym oknie dialogowym:
Przejdź do Configuration, wybierz źródło danych z wierszami odwołującymi się, otwórz zakładkę Data Validation i kliknij Add Rule. Otworzy się okno Add Data Validation Rule (dodaj regułę walidacji danych).
Wpisz Name (nazwa) i Description (opis), który mówi, co musi być spełnione, na przykład „Każde zamówienie odwołuje się do klienta w kartotece CRM”.
Ustaw Type na Referential Integrity.
W sekcji Attributes wybierz kolumnę lub kolumny klucza w tym źródle danych.
W sekcji must exist in (musi istnieć w) wybierz docelowe Data Source, które może leżeć na innym połączeniu, oraz jego odpowiadające Attributes. Dla klucza złożonego wybierz kolumny po obu stronach w tej samej kolejności.
Wybierz Threshold Mode (tryb progu: Absolute lub Relative) i ustaw Info threshold oraz Warn threshold.
Zapisz. Reguła uruchamia się przy każdej inspekcji źródła danych, zaplanowanej lub na żądanie.

Reguła integralności referencyjnej w digna: product_code musi istnieć w źródle danych hospital_medications.
Zrzuty ekranu pochodzą z naszego projektu demonstracyjnego, w którym oba źródła danych leżą na tym samym połączeniu. Okno wygląda tak samo, gdy docelowe źródło danych jest na innym połączeniu: wybierasz je w „must exist in” jak każde inne źródło danych. Demo używa fikcyjnych danych Danubia Kliniken, zmyślonej austriackiej grupy szpitali.
Reguła hc_product_in_master mówi, że każdy podany produkt musi istnieć w kartotece produktów apteki szpitalnej. 2026-04-22 oddziały zarejestrowały 82 podania leku „Coavira 2.5 mg” (kod produktu 3858646), zanim produkt został dodany do kartoteki. Każdy raport łączący dawki z produktami pokazywał zero dawek nowego produktu, choć pielęgniarki podały ich 82.
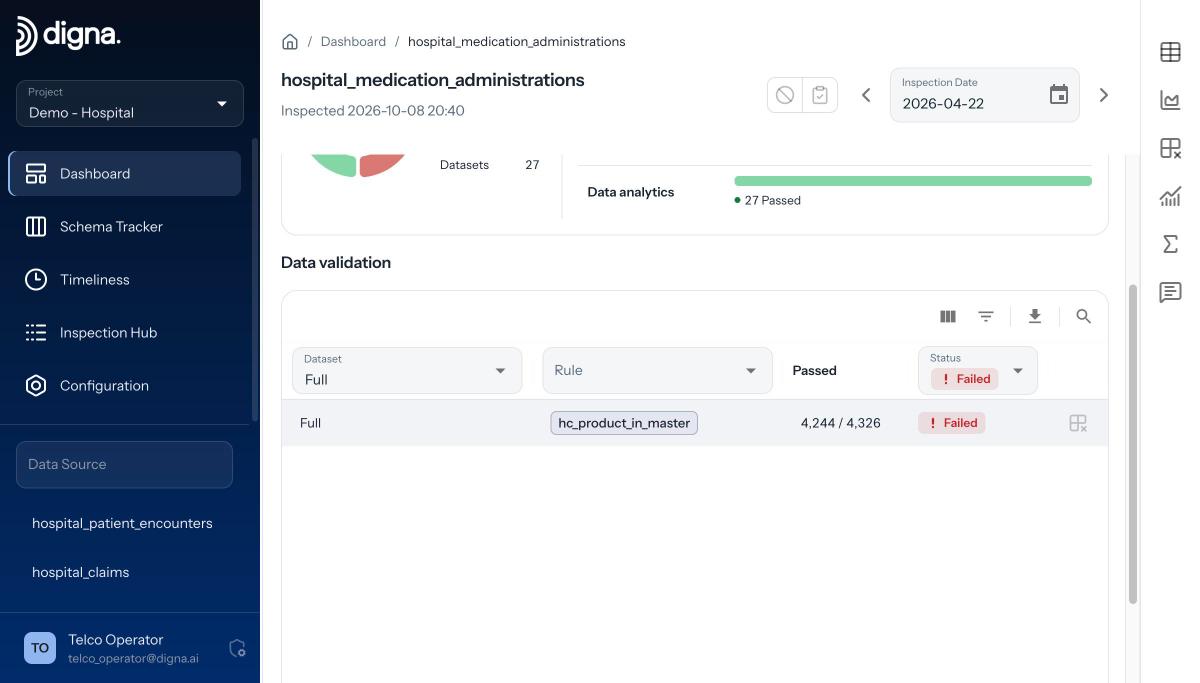
Wynik z 2026-04-22: 4244 z 4326 wierszy przeszło, 82 nie przeszły, status Failed.
digna raportuje liczbę rekordów, które przeszły i nie przeszły kontroli dla każdej reguły, i zwraca same błędne rekordy: to samo zapytanie z zanegowanym warunkiem. W widoku Invalid Records filtrujesz po Passed, Uncertain lub Failed, wybierasz kontrolę i widzisz wiersze, tutaj ze szpitalem, oddziałem, kodem produktu i nazwą leku. Możesz je wyeksportować i powiadomić zespół, który jest właścicielem danych.
Przy kontrolach między systemami ważnych jest kilka zachowań:
Progi domyślnie wynoszą zero, więc nowa reguła kończy się błędem przy pojedynczym rekordzie osieroconym. Jeśli wiadomo, że dane główne opóźniają się względem transakcji o kilka godzin, podnieś Info threshold, żeby niewielka liczba dawała status Uncertain zamiast Failed, albo użyj trybu Relative.
Klucze NULL są pomijane. Brakujący numer klienta nie powoduje niepowodzenia kontroli referencyjnej. Jeśli klucz jest obowiązkowy, dodaj osobną regułę typu Rule, na przykład
customer_no IS NOT NULL.Listy kolumn muszą mieć tę samą długość. Niezgodność jest odrzucana, zamiast po cichu sprawdzać słabszy warunek.
Kontrole działają wewnątrz baz źródłowych. digna wysyła SQL i otrzymuje liczby, a na Twoje życzenie także błędne wiersze. Twoje dane nigdy nie opuszczają Twojej infrastruktury.
Pełny opis krok po kroku z każdym polem znajdziesz w artykule o tym, jak skonfigurować kontrolę integralności referencyjnej. Typy reguł, progi i widoki wyników opisuje strona digna Data Validation oraz dokumentacja.
Które odwołania między systemami sprawdzić najpierw?
Najpierw sprawdź odwołania między systemami, które zasilają raporty, na podstawie których ludzie podejmują decyzje, oraz te, których dane główne są regularnie scalane, przenumerowywane lub wycofywane, bo tam rekord osierocony od razu zamienia się w błędną liczbę. Zacznij od kilku reguł i rozszerzaj zakres, gdy uporasz się z fałszywymi rekordami osieroconymi wynikającymi z formatów kluczy.
Praktyczna kolejność walidacji danych głównych między systemami:
Transakcje względem kartoteki klientów, kont lub pacjentów, bo scalenia i zamknięcia zdarzają się tam cały czas.
Pozycje zamówień i ruchy magazynowe względem kartoteki produktów, bo nowe produkty często są sprzedawane, zanim rekord główny jest kompletny.
Kody referencyjne (kraj, waluta, centrum kosztów) względem systemu, który jest właścicielem listy kodów.
Połącz każdą regułę referencyjną z regułą Uniqueness na kluczu głównym: kontrola odwołań względem danych głównych z duplikatami kluczy może przejść, a dane i tak będą błędne.
Następny krok
Klucze obce kończą się na granicy bazy danych, a wiele istotnych danych tę granicę przekracza. Do walidacji odwołań między systemami nie potrzebujesz kolejnego potoku: jedna reguła Referential Integrity na relację, działająca tam, gdzie leżą dane, po każdej inspekcji pokazuje, które rekordy straciły swój rekord nadrzędny. Jeśli chcesz zobaczyć to na własnym środowisku, umów demo z zespołem digna.
Najczęściej zadawane pytania
Czy można utworzyć klucz obcy między bazami danych?
Z reguły nie. Zadeklarowany klucz obcy odwołuje się do tabeli w tej samej bazie danych, bo silnik sprawdza go przy każdym INSERT, UPDATE i DELETE. Między bazami, serwerami czy produktami nie ma czego deklarować, więc odwołania między systemami trzeba walidować zaplanowaną kontrolą, taką jak anti-join lub reguła integralności referencyjnej.
Jak sprawdzić integralność referencyjną między dwiema różnymi bazami danych?
Uruchom anti-join, który zwraca klucze z tabeli odwołującej się bez dopasowania w tabeli głównej. Zespoły zwykle udostępniają obie tabele przez zapytania federacyjne, kopiowane tabele referencyjne, wyszukiwanie kluczy w ETL lub eksporty do uzgadniania. W digna reguła Referential Integrity może wskazywać źródło danych na innym połączeniu, bez replikowania danych.
Dlaczego kontrola między systemami zgłasza rekordy osierocone, których rodzic istnieje?
Zwykle różnią się formaty kluczy. Jeden system przechowuje '0004711' jako tekst, drugi 4711 jako liczbę całkowitą, a wielkość liter, końcowe spacje czy prefiksy systemowe dają te same fałszywe rekordy osierocone. Ustal kanoniczną postać, znormalizuj klucz w widoku lub instrukcji SQL i sprawdź, czy znormalizowany klucz główny nadal jest unikalny.
Czy digna kopiuje tabelę główną, żeby porównać klucze między połączeniami?
Nie. Od Release 2026.01 digna sprawdza integralność referencyjną między tabelami, widokami, schematami i połączeniami bazodanowymi w jednym projekcie bez replikowania danych. Kontrole działają wewnątrz Twoich baz danych: digna wysyła SQL i otrzymuje liczby, a na Twoje życzenie także błędne wiersze. Twoje dane nigdy nie opuszczają Twojej infrastruktury.
Czy klucze obce o wartości NULL powodują niepowodzenie kontroli integralności referencyjnej w digna?
Nie. Reguły Referential Integrity pomijają wartości NULL, więc wiersz z pustym numerem klienta nie jest liczony jako rekord osierocony. Gdy klucz jest obowiązkowy, dodaj osobną regułę typu Rule z warunkiem takim jak customer_no IS NOT NULL, aby brakujące klucze i niedopasowane klucze były raportowane jako dwa odrębne problemy.



