Format pliku Parquet wyjaśniony: praktyczny przewodnik 2026
|
10
min. czyt.

Prawdopodobnie już masz do czynienia z Parquet, nawet jeśli nie Ty go wybrałeś. Eksport z hurtowni ląduje w S3, Twoje zadanie Spark czyta tabelę jeziora opartą na plikach Parquet albo Athena wciąż skanuje zbiory, które ktoś powyżej przez ostatni rok spartycjonował na trzy różne sposoby. Przez większość dni wydaje się to wystarczająco szybkie i wystarczająco niewidoczne, by nikt nie zadawał pytań.
Potem coś się psuje. Zapytanie, które kiedyś śmigało, zaczyna się wlec. Nowy zapisujący wdraża funkcję, którą jeden silnik potrafi przeczytać, a inny nie. Jedno przemianowane pole zamienia się w tydzień wartości pustych niżej. To moment, w którym format pliku Parquet przestaje być rozszerzeniem, a staje się sprawą operacyjną.
Spis treści
Jak Parquet osiąga szybkość: predicate pushdown i przycinanie kolumn
Partycjonowanie, rozmiar plików i dobre praktyki składowania
Dlaczego Parquet stał się domyślnym formatem kolumnowym
Typowy wzorzec analityczny wygląda tak: zespół przechowuje szeroką tabelę sprzedaży z wieloma atrybutami, ale większość zapytań pulpitu dotyka tylko garstki kolumn. W eksporcie wierszowym, jak CSV, silnik i tak musi przeżuć każdy wiersz jako tekst. W Parquet silnik może skupić się na kolumnach, których potrzebuje zapytanie. Ta różnica sprawia, że ludzie wciąż wybierają go do składowania analitycznego.
Parquet nie pojawił się przypadkiem. Zaczął jako otwartoźródłowa współpraca Twittera i Cloudery, z pierwszym wydaniem 13 marca 2013 roku, Parquet 1.0 w lipcu 2013, a do 27 kwietnia 2015 roku stał się projektem najwyższego poziomu Apache Software Foundation, według dokumentacji formatu pliku Apache Parquet. Własny opis Apache pozostaje najczystszy: Parquet to otwartoźródłowy, kolumnowy format pliku danych do wydajnego składowania i pobierania.
Dlaczego składowanie kolumnowe zmieniło domyślny wybór
Mówiąc prosto, Parquet przechowuje wartości kolumnami zamiast wierszami. Wszystkie wartości order_total leżą razem. Wszystkie wartości country leżą razem. Daje to silnikom zapytań dwie przewagi:
Selektywny odczyt: mogą pominąć kolumny, do których Twój SQL nigdy się nie odwołuje.
Lepsze upakowanie: podobne wartości dobrze się kompresują, bo format może zastosować kodowania przed kompresją.
To połączenie dobrze pasuje do nowoczesnych silników analitycznych i formatów tabel lakehouse. Jeśli przed pogłębieniem tematu chcesz krótszego wprowadzenia, digna ma użyteczny przegląd Parquet.
Reguła praktyczna: jeśli Twoje obciążenie to głównie skany, agregacje i filtry na dużych zbiorach danych, Parquet zwykle pasuje do wzorca dostępu lepiej niż formaty tekstowe.
Dlaczego rozprzestrzenił się tak szeroko
Parquet stał się tkanką łączną między potokami Spark, eksportami z hurtowni, jeziorami danych w magazynie obiektowym i formatami tabel takimi jak Iceberg, Delta Lake i Hudi. Zespoły cenią go, bo jest otwarty, typowany i szeroko wspierany. Lubią też, że oddziela fizyczne składowanie od wyboru silnika zapytań. Plik zapisany w jednej części stosu często da się przeczytać gdzie indziej.
To „często” ma znaczenie. Przenośność jest realna, ale nie jest automatyczna, gdy do produkcji wchodzą nowsze funkcje i mieszane wersje silników.
Silnik | Natywne wsparcie Parquet | Typowy wzorzec |
|---|---|---|
Spark | Tak | Transformacja wsadowa i tabele lakehouse |
BigQuery | Tak | Tabele zewnętrzne i wymiana plików |
Redshift Spectrum | Tak | Odpytywanie danych w magazynie obiektowym |
DuckDB | Tak | Analityka lokalna i zapytania ad hoc |
Athena | Tak | Bezserwerowe skany po partycjonowanych danych jeziora |
Wewnątrz pliku Parquet: row groups, column chunks i pages
Plik Parquet nabiera sensu, gdy wyobrazisz sobie typowe zapytanie hurtowni. Analityczka prosi o trzy kolumny z pięćdziesięciu, z filtrem na zeszły tydzień. To, czy zapytanie wyda się szybkie czy ociężałe, zależy w dużej mierze od tego, jak Parquet układa bajty wewnątrz pliku, a nie tylko od czytającego silnika SQL.
Zacznij od row group
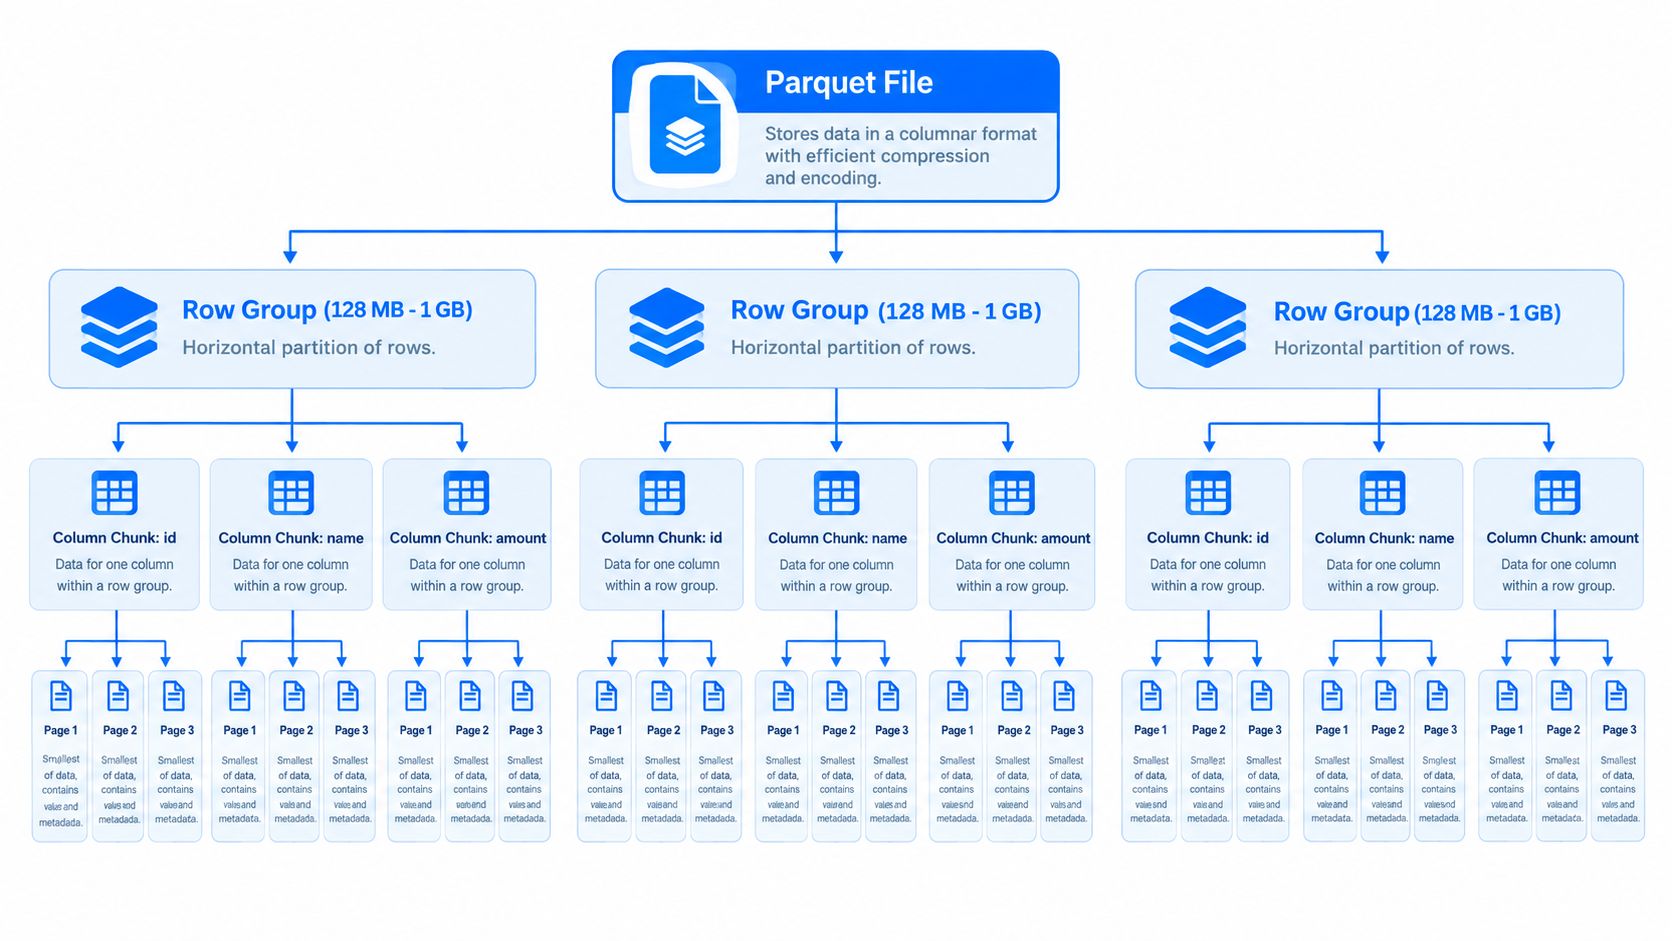
Plik Parquet dzieli się na row groups. Każda row group to poziomy wycinek tabeli, więc zawiera ten sam zestaw kolumn dla podzbioru wierszy.
Rozmiar row group kształtuje zachowanie odczytu bardziej, niż wiele zespołów się spodziewa. Wcześniejsze zalecenia Apache Parquet radzą duże row groups, bo większe grupy zwykle tworzą większe column chunks i sprzyjają sekwencyjnym operacjom wejścia-wyjścia. Na produkcji może to pomóc obciążeniom opartym na skanach. Tworzy też kompromis. Bardzo duże row groups zmniejszają narzut metadanych, ale mogą uczynić selektywne odczyty mniej zwinnymi, bo silnik wciąż planuje na poziomie row group.
Wewnątrz każdej row group Parquet przechowuje dokładnie jeden column chunk na kolumnę schematu, a każdy chunk jest ciągły w pliku, jak zdefiniowano w repozytorium parquet-format. Ten układ w dużej mierze tłumaczy, dlaczego działa przycinanie kolumn. Jeśli zapytanie potrzebuje order_total i order_date, silnik może zignorować bajty dla customer_notes, device_model i całej reszty.
Potem przybliż column chunk i page
Column chunk przechowuje wartości jednej kolumny dla jednej row group. Ten chunk dzieli się następnie na pages, mniejsze jednostki, które Parquet koduje i kompresuje.
Pages mają znaczenie, bo to tam decyzje o składowaniu stają się konkretne. Metadane strony zapisują, jakiego kodowania i jakiej kompresji użyto. Jeśli istnieje strona słownikowa, musi pojawić się jako pierwsza w column chunk, a na jeden column chunk może przypadać co najwyżej jedna strona słownikowa, według dokumentacji Apache Parquet o column chunks.
Praktyczny model myślowy to:
Plik zawiera jeden fizyczny obiekt Parquet.
Row groups dzielą wiersze na duże bloki.
Column chunks przechowują jedną kolumnę dla jednej row group.
Pages przechowują zakodowane i skompresowane wycinki tego chunku.
Pomaga tu analogia do arkusza kalkulacyjnego. Row groups są jak pasma wierszy w poprzek arkusza. Column chunks to pionowe paski dla każdego pola wewnątrz jednego pasma. Pages to mniejsze paczki w każdym pasku, które czytający może dekodować kawałek po kawałku.
Dlaczego stopka decyduje o planowaniu odczytu
Stopka to miejsce, w którym Parquet trzyma mapę. Przechowuje schemat oraz metadane mówiące czytającemu, gdzie leżą row groups i column chunks. Zanim silnik zapytań podejmie rozsądne decyzje o tym, co czytać, zwykle potrzebuje tej stopki.
Ten projekt jest znakomity przy planowaniu analitycznym. Słabszy jest przy dostępie punktowym.
Jeśli Twoje obciążenie brzmi „przeskanuj miesiąc zdarzeń i zagreguj”, planowanie od stopki pomaga silnikowi oszczędzić pracę. Jeśli brzmi „pobierz jeden rekord po ID”, czytający i tak musi znaleźć i sparsować stopkę, zanim zlokalizuje właściwy obszar pliku. Dokumentacja Parquet w Apache Arrow zauważa też, że dane Parquet są dekodowane blokami, a nie obsługiwane wprost na poziomie bajtów, co jest jednym z powodów, dla których pobieranie pojedynczego wiersza źle pasuje do formatu.
To jedna z produkcyjnych luk, które podstawowe objaśnienia Parquet pomijają. Zespoły często słyszą „kolumnowy znaczy szybki”, a potem stosują Parquet do każdego wzorca dostępu. Dla analityki wsadowej to się broni. Dla wyszukiwań sterowanych żądaniami, sond walidacyjnych CDC czy operacyjnego debugowania, gdy inżynier chce jeden wiersz natychmiast, często się łamie.
Stopka odgrywa też rolę w późniejszych problemach z interoperacyjnością. Różne silniki mogą zgadzać się, że plik istnieje, a mimo to różnić się co do nowszych funkcji metadanych, page indexes czy statystyk opcjonalnych. Gdy tak się dzieje, objawem rzadko jest dramatyczne uszkodzenie. Zwykle jest ciszej. Filtry przestają przycinać tak dobrze, jak oczekiwano, jeden silnik czyta więcej bajtów niż inny, albo opóźnienie zapytań dryfuje w górę wiele miesięcy po aktualizacji zapisującego.
Dla analityki planowanie od stopki jest siłą. Dla zapytań punktowych jest narzutem.
Dlatego Parquet działa najlepiej, gdy traktujesz go jako analityczny format pliku, obserwujesz, jak Twoje silniki korzystają z jego metadanych, i badasz sprawę, gdy „przeskanowane bajty” albo współczynnik przycinania row groups nagle się pogarszają.
Opcje kodowania i kompresji, które naprawdę mają znaczenie
Zespoły często mieszają kodowanie i kompresję, ale rozwiązują one różne problemy. Kodowanie przebudowuje wartości wewnątrz strony. Kompresja zmniejsza potem zakodowany strumień bajtów. W Parquet te warstwy się nakładają.
Kodowania najpierw zmieniają kształt danych
Parquet obsługuje kodowania na poziomie strony, w tym PLAIN, RLE, DELTA_BINARY_PACKED, RLE_DICTIONARY i BYTE_STREAM_SPLIT, oraz kodeki kompresji takie jak SNAPPY, GZIP, BROTLI, ZSTD i LZ4_RAW, jak podsumowuje referencja formatu Parquet.
Na produkcji liczy się kształt danych:
Ścieżki słownikowe pomagają, gdy wartości się powtarzają, jak w polach statusu, kodach krajów czy kategoriach produktów.
RLE działa dobrze, gdy powtarzające się wartości występują seriami, zwłaszcza po posortowaniu.
Kodowania typu delta przydają się, gdy wartości zmieniają się przyrostowo, jak rosnące identyfikatory czy znaczniki czasu.
Byte stream split może pomóc niektórym obciążeniom numerycznym, ale zgodność między narzędziami bywa opóźniona.
Empiryczna ocena formatów kolumnowych wykazała, że agresywne kodowanie słownikowe Parquet często dawało mocną kompresję przy rozsądnej wydajności dekodowania w wielu typach danych, a jego ścieżka bit-packing plus RLE zwykle dekodowała szybciej niż bardziej złożone podejścia wieloalgorytmowe, według artykułu oceniającego formaty kolumnowe.
Kompresja powinna odpowiadać Twojemu celowi operacyjnemu
Użytecznym sposobem wyboru kodeka jest zdecydowanie, co optymalizujesz:
Szybkie odczyty i szeroka zgodność: użyj Snappy.
Ciaśniejsze składowanie przy wyważonym kompromisie: użyj ZSTD tam, gdzie Twój stos silników obsługuje go bez trudu.
Maksymalne ściśnięcie przy wolniejszym odczycie i zapisie: użyj GZIP dla zbiorów zimnych lub mało interaktywnych.
W skrócie: wybierz kodowanie pod wzorzec wartości w kolumnie, a potem kompresję pod kompromis między pamięcią a CPU.
Kształt danych | Kodowanie | Kompresja | Dlaczego działa |
|---|---|---|---|
Powtarzające się łańcuchy w logach | Dictionary lub RLE_DICTIONARY | SNAPPY | Powtarzające się wartości dobrze się pakują, a Snappy utrzymuje niski narzut dekodowania |
Posortowane flagi statusu lub kody regionów | RLE | ZSTD | Długie serie kompresują się wydajnie, a ZSTD zwykle równoważy współczynnik i koszt odczytu |
Rosnące identyfikatory lub uporządkowane znaczniki czasu | DELTA_BINARY_PACKED | GZIP lub ZSTD | Drobne zmiany kodują się zwięźle, zanim zadziała kodek |
Mieszane kolumny wymiarów o niskiej kardynalności | Dictionary | SNAPPY lub ZSTD | Podobne wartości korzystają na wyszukiwaniu słownikowym i pozostają przenośne |
Cechy analityczne bogate w liczby zmiennoprzecinkowe | BYTE_STREAM_SPLIT tam, gdzie jest wspierany | ZSTD | Może poprawić układ liczbowy, ale najpierw sprawdź wsparcie czytnika |
Ostrożność dotyczy przenośności. Specyfikacja może dopuszczać kodowanie, którego Twój czytnik niżej nie wdraża w pełni.
Jak Parquet osiąga szybkość: predicate pushdown i przycinanie kolumn
Szybkość Parquet bierze się z nieczytania danych, których nie potrzebujesz. Brzmi oczywiście, ale rozkłada się na trzy odrębne mechanizmy o różnych trybach awarii.
Przycinanie kolumn wykonuje pierwsze cięcie
Jeśli Twoja tabela faktów ma wiele kolumn, a SQL dotyka tylko kilku, silnik może przeczytać wyłącznie te column chunks. To najbardziej widoczna wygrana w systemach analitycznych. To także powód, dla którego zespoły zagłębiające się w optymalizację zapytań SQL często odkrywają, że format pliku i układ tabeli znaczą tyle samo co treść zapytania.
W praktyce zapytanie takie jak:
nie potrzebuje pól atrybucji marketingowej, notatek wysyłkowych ani dziesiątek nieużywanych wymiarów. Dzięki Parquet planista często może całkowicie ominąć te bajty.
Pomijanie row groups to moment, w którym decyzje o układzie się zwracają
Pliki Parquet przechowują metadane, które pomagają czytającym zdecydować, czy row group warto skanować. Gdy filtr mówi region = 'EMEA', a statystyki row group pokazują wyłącznie wartości spoza tego zakresu, silnik może ją pominąć.
Kolejność sortowania ma znaczenie. Jeśli zapisujesz wiersze w losowej kolejności, statystyki minimum i maksimum tracą selektywność. Jeśli grupujesz powiązane wartości razem, te statystyki stają się znacznie użyteczniejsze.
Zachowanie na poziomie strony pomaga, ale tylko gdy dane współpracują
Pages to najmniejsze praktyczne jednostki wewnątrz column chunk. Czytający mogą uniknąć dekodowania części chunku, jeśli pozwalają na to metadane i logika filtrowania. Strony kodowane słownikowo mogą też potanieć predykaty równości, bo powtarzające się wartości zostały już znormalizowane do odwołań słownikowych.
Mimo to te optymalizacje słabną, gdy:
Kolumny z dowolnym tekstem nie kompresują się ani nie przycinają czysto
Pola o wysokiej kardynalności rozrzucają wartości po wielu grupach
Zapytania punktowe potrzebują maleńkiej odpowiedzi z dużego pliku
Nieposortowane zapisy rozmazują wartości filtra po całym zbiorze
Wzorzec zapytania | Odczytane kolumny | Przeskanowane row groups | Odczytane bajty | Czas wykonania |
|---|---|---|---|---|
Pełny skan tabeli | Wiele | Większość lub wszystkie | Wysokie | Najwolniejszy |
Agregacja z przycinaniem kolumn | Niewiele | Większość lub wszystkie | Niższe | Szybszy |
Zapytanie analityczne z filtrem predykatu | Niewiele | Tylko wybrane grupy | Najniższe z trzech | Najszybszy, gdy statystyki są selektywne |
Pułapką jest zakładanie, że Parquet jest „szybki” w każdym sensie. Jest szybki w zaplanowanym, sekwencyjnym odczycie analitycznym. Nie jest zbudowany jak indeksowany magazyn serwujący.
Parquet wobec ORC, Avro, CSV i JSON
Wybór Parquet staje się łatwiejszy, gdy porównasz go z formatami, o których zespoły zwykle dyskutują.
Dwa formaty analityczne, jeden wierszowy i dwa wymiany
Parquet i ORC celują w skany analityczne. Są kolumnowe, skompresowane i zaprojektowane dla danych typowanych. W szerokiej praktyce Parquet zwykle wygrywa szerokością ekosystemu wśród silników i narzędzi lakehouse. ORC wciąż ma sens w części środowisk zorientowanych na Hive.
Avro to inne zwierzę. Jest wierszowe i lepiej nadaje się do zapisu rekord po rekordzie, wymiany zdarzeń i potoków bogatych w schemat, gdzie zachowanie struktury wiersza liczy się bardziej niż efektywność skanowania.
CSV i JSON są łatwiejsze dla ludzi i narzędzi ogólnego przeznaczenia, ale przerzucają pracę parsowania i typowania na czas odczytu. Zwykle czyni je to kiepskim długoterminowym wyborem dla dużych zbiorów analitycznych.
Używaj Parquet, gdy spodziewasz się powtarzalnych skanów i selektywnych odczytów kolumn. Używaj Avro, gdy rekordy wędrują przez systemy strumieniowe. Zostaw CSV i JSON do wymiany, diagnostyki lub prostych przekazań.
Prawdziwą decyzją jest dopasowanie do obciążenia
Wiele zespołów pyta: „Który format jest najszybszy?”. Lepsze pytanie brzmi: „Szybki do czego?”.
Analityka wsadowa: Parquet zwykle pasuje najlepiej.
Stos analityczny mocno oparty na Hive: ORC może zasługiwać na uwagę.
Rekordy strumieniowe i transport zdarzeń: Avro jest często czystsze.
Inspekcja ad hoc i szeroka zgodność narzędzi: CSV wciąż wygrywa.
Wymiana zagnieżdżonych ładunków API: JSON pozostaje powszechny mimo kosztu.
Format | Układ | Efektywność kompresji | Szybkość skanowania | Ewolucja schematu | Najlepsze dopasowanie |
|---|---|---|---|---|---|
Parquet | Kolumnowy | Mocna | Mocna dla analityki | Dobra, z zastrzeżeniami między czytnikami | Jeziora danych, BI, analityka wsadowa |
ORC | Kolumnowy | Mocna | Mocna dla analityki | Dobra | Środowiska analityczne zorientowane na Hive |
Avro | Wierszowy | Umiarkowana | Lepszy do dostępu wierszowego niż do skanów kolumnowych | Mocna dla rekordów | Streaming, ładunki komunikatów, wymiana |
CSV | Tekst wierszowy | Słaba | Słaba przy dużych odczytach analitycznych | Brak wbudowanej | Ręczna inspekcja, proste eksporty |
JSON | Tekst półstrukturalny | Od słabej do umiarkowanej | Słaba przy dużych skanach | Elastyczna, ale luźno egzekwowana | Ładunki API, zagnieżdżona wymiana |
Partycjonowanie, rozmiar plików i dobre praktyki składowania
Typowa produkcyjna historia brzmi tak: zespół wybrał Parquet, czasy zapytań wyglądały dobrze przez pierwszy miesiąc, a potem jezioro wypełniło się maleńkimi plikami, nierównymi partycjami i tabelami, które jeden silnik skanował szybko, podczas gdy inny walczył z narzutem planowania. Format zrobił swoje. Układ nie.
Wybieraj kolumny partycji, po których ludzie faktycznie filtrują
Partycjonowanie działa jak zgrubny spis treści. Pomaga czytającym pominąć całe foldery, zanim w ogóle otworzą stopki Parquet. To potężne, ale tylko gdy klucz partycji pasuje do rzeczywistych wzorców zapytań.
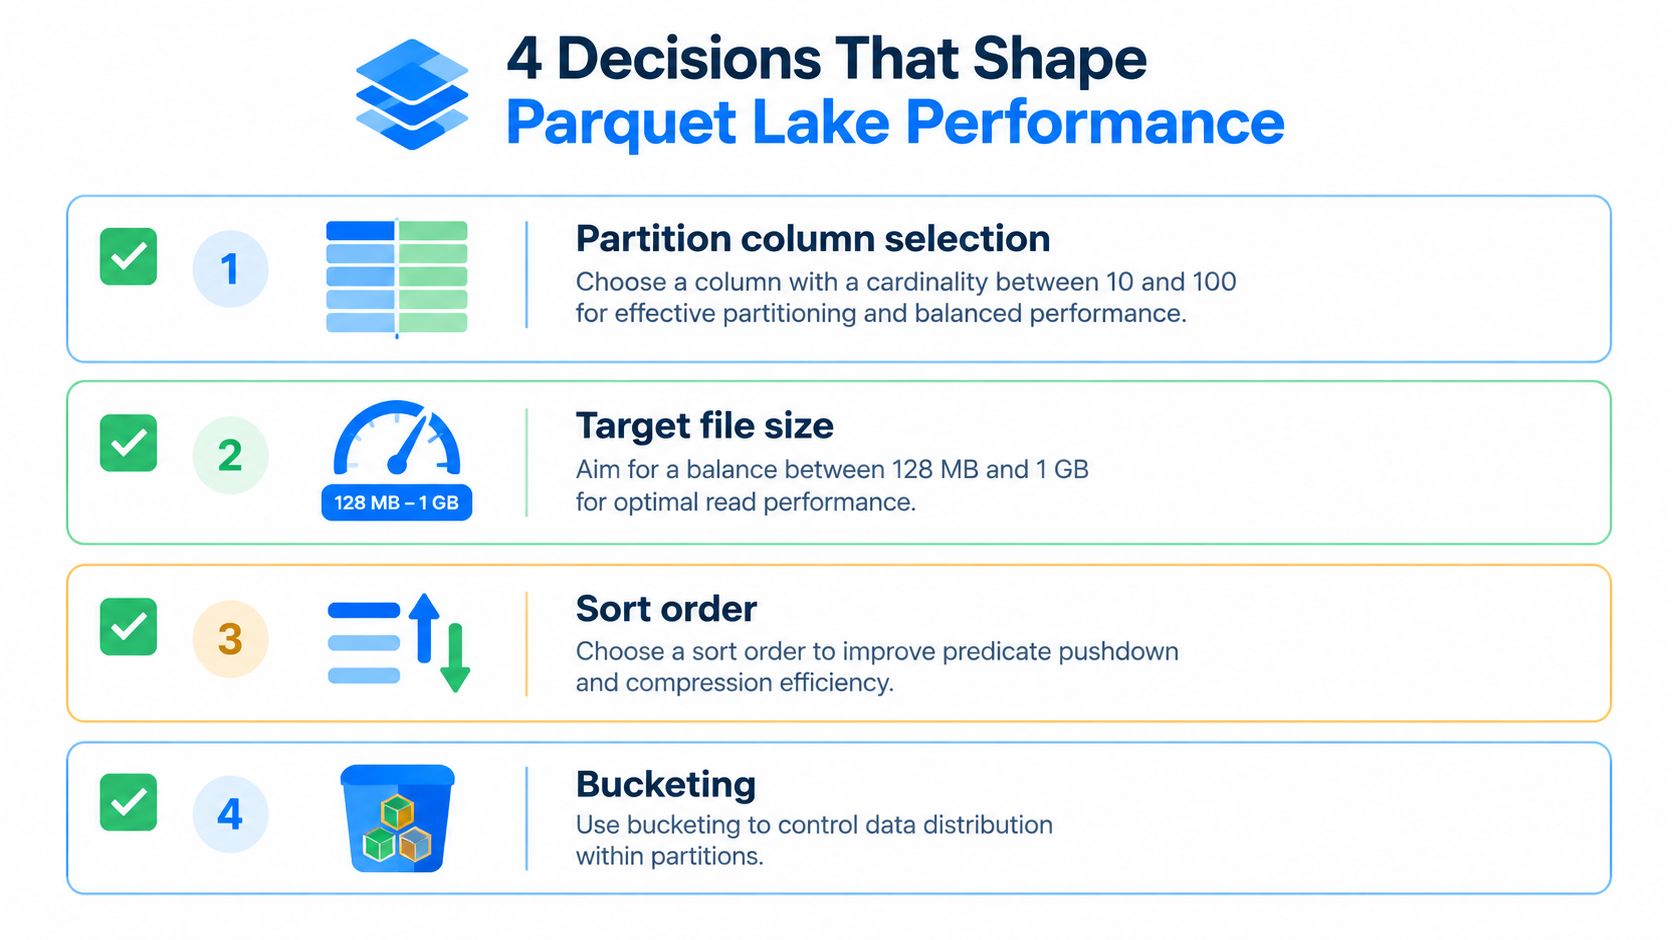
Data to zwykły punkt wyjścia, bo raportowanie i uzupełnianie danych często tną według dnia, tygodnia lub miesiąca. Region, środowisko, poziom najemcy albo jednostka biznesowa też mogą pasować, jeśli te pola często pojawiają się w klauzulach WHERE. Zły klucz ma zwykle jeden z dwóch problemów. Albo jest zbyt szeroki, by wiele przyciąć, albo tak wysokokardynalny, że eksploduje niezliczonymi małymi katalogami i plikami. Partycjonowanie po identyfikatorze użytkownika to klasyczny błąd.
Kompromis waży więcej, niż przyznaje wiele przewodników. Dobre partycjonowanie przyspiesza szerokie odczyty analityczne. Niewiele daje przy zapytaniach punktowych, bo Parquet wciąż potrzebuje metadanych stopki, zanim znajdzie właściwą row group. Jeśli Twoje obciążenie obejmuje częste pobrania pojedynczych rekordów, żaden schemat partycjonowania nie zamieni Parquet w magazyn klucz-wartość.
Dla zespołów budujących zapisujące zadania wsadowe i kompaktowanie te wskazówki o orkiestracji ETL w Pythonie są praktycznym towarzyszem, bo partycjonowanie broni się tylko wtedy, gdy harmonogram, logika ponowień i wyjścia zapisującego pozostają spójne w czasie.
Rozmiar pliku decyduje, czy magazyn obiektowy działa zwinnie czy niezgrabnie
Rozmiar plików to miejsce, w którym wiele jezior traci formę. Bardzo małe pliki zwiększają narzut listowania, odczyty metadanych i czas planowania. Bardzo duże mogą obniżyć równoległość i podnieść koszt ponowień. Optimum zależy od silnika, sieci i ścieżki zapisu, ale celem są stabilne, przyjazne skanom pliki, a nie rozmiar, który przypadkiem wypadł z wcześniejszych mikro-wsadów.
Rozmiar row group też się liczy. Większe row groups często poprawiają odczyty sekwencyjne i kompresję, ale czynią selektywne odczyty mniej precyzyjnymi, jeśli Twoja kolejność sortowania jest kiepska. Dlatego rozmiar pliku i kolejność sortowania należy wybierać razem, a nie jako osobne pokrętła.
Magazyn obiektowy dokłada kolejną warstwę zachowań. Jezioro danych na magazynie zgodnym z S3 nie zachowuje się jak lokalny dysk z tanimi operacjami katalogowymi. Koszty widać w wywołaniach listowania, opóźnieniu otwarcia i rozproszeniu małych plików. To wprowadzenie do tego, jak S3 zachowuje się jako system plików, jest użyteczną referencją dla tego modelu myślowego.
Obserwuj na produkcji kilka sygnałów: średni rozmiar pliku na tabelę, liczbę plików na partycję, zaległość kompaktowania oraz czas planowania wobec czasu skanowania. Jeśli czas planowania rośnie, a wolumen danych stoi w miejscu, układ plików jest zwykle pierwszym miejscem do sprawdzenia.
Sortowanie i bucketing pomagają, ale tylko we właściwych miejscach
Sortowanie to jeden z najbardziej wartościowych nawyków dla zapisujących Parquet. Gdy podobne wartości lądują razem, statystyki row group stają się bardziej selektywne, kompresja się poprawia, a silniki mogą z większą pewnością pomijać więcej danych. Jeśli analitycy często filtrują po event_date, customer_region albo innym selektywnym polu, sortowanie po nim potrafi uczynić metadane stopki znacznie użyteczniejszymi.
Bucketing rozwiązuje inny problem. Potrafi uczynić rozkład wewnątrz partycji bardziej przewidywalnym, co pomaga niektórym potokom bogatym w złączenia. Dokłada też narzutu operacyjnego i nie jest równie dobrze wspierany we wszystkich silnikach, więc traktuj go jako wybór zależny od obciążenia, a nie jako domyślny.
Praktyczna lista kontrolna:
Partycjonuj pod typowe filtry: zacznij od pól, które konsekwentnie pojawiają się w predykatach zapytań.
Trzymaj liczbę plików w ryzach: kompaktuj po zapisach strumieniowych lub mocno zrównoleglonych.
Sortuj wewnątrz partycji: lepsza kolejność sprawia, że statystykom row group warto ufać.
Śledź dryf układu w czasie: rosnąca liczba małych plików i wolniejsze planowanie to wczesne ostrzeżenia.
Stosuj bucketing wybiórczo: używaj go tam, gdzie zachowanie złączeń uzasadnia koszt utrzymania.
Ewolucja schematu, interoperacyjność i ciche pułapki
Reputacja Parquet w zakresie przenośności jest zasłużona tylko do pewnego stopnia. Niewygodna realia produkcji są takie, że specyfikacja porusza się szybciej niż wiele stosów czytników.
Otwarty format nie oznacza jednolitego wsparcia
Materiały Apache o stanie implementacji pokazują wsparcie pofragmentowane według silnika i roku wydania, przy czym część nowszych możliwości nie została jeszcze szeroko wdrożona, a niektóre funkcje są wspierane tylko częściowo, według strony o stanie implementacji Parquet. Wskazówki o wersjach ostrzegają też, że część funkcji jest zgodna w przód, a część nie.
Oznacza to, że starszy czytnik może wciąż otworzyć plik, ale stracić metadane, pominąć usprawnienia wydajności albo polec na niewspieranych kodowaniach. Niedawne prace, jak adaptacyjne bezstratne kodowanie zmiennoprzecinkowe i nowe typy logiczne, poszerzają przepaść między tym, co format potrafi wyrazić, a tym, co każdy silnik w Twoim stosie potrafi niezawodnie skonsumować.
Pułapka zwykle ujawnia się miesiące po wdrożeniu
Groźne awarie nie zawsze są głośne. Czasem jeden silnik czyta pole zgodnie z oczekiwaniem, drugi zwraca wartości puste, a trzeci schodzi na wolniejszą ścieżkę dekodowania. Nie wychwycisz tego w szybkim teście, jeśli wszyscy walidują tylko silnikiem zapisującym.
Kilka wzorców awarii powtarza się regularnie:
Niezgodności typów logicznych: znaczniki czasu, liczby dziesiętne i typy zagnieżdżone mogą być prezentowane różnie przez różne czytniki.
Luki zgodności kodowań: nowsze kodowania potrafią zaskoczyć starsze silniki.
Zachowanie awaryjne słownika: różni zapisujący zmieniają strategię odmiennie, co wpływa na rozmiar pliku i szybkość skanowania.
Opóźnienie odczytu stopki: nawet drobne odczyty wciąż płacą omówiony wcześniej koszt dostępu do metadanych.
Jeśli Twój zespół prowadzi potoki mocno oparte na Databricks i konsumentów w wielu silnikach, dedykowane podejście do jakości danych w Databricks staje się istotne, bo dryf typów i niezgodność czytników pojawiają się najpierw jako incydenty jakościowe, a nie błędy parsera.
Funkcja | Spark 3.5 | Trino 470 | DuckDB 1.2 | Athena |
|---|---|---|---|---|
Podstawowy odczyt Parquet | Szeroko wspierany | Szeroko wspierany | Szeroko wspierany | Szeroko wspierany |
Nowsze kodowania | Sprawdzać per wydanie | Sprawdzać per wydanie | Sprawdzać per wydanie | Sprawdzać per wydanie |
Zagnieżdżone typy logiczne | Zwykle wykonalne, testować uważnie | Testować uważnie | Testować uważnie | Testować uważnie |
Zachowanie metadanych | Zależnie od przepływu | Zależnie od przepływu | Zależnie od przepływu | Zależnie od przepływu |
Nie pytaj tylko „Czy ten silnik potrafi czytać Parquet?”. Pytaj „Czy dokładnie ta wersja czytnika bezpiecznie przeczyta pliki z dokładnie tej konfiguracji zapisującego?”.
Dryf schematu, Timeliness i obserwowalność potoków Parquet
Stopka Parquet to nie tylko metadane dla czytnika. W dojrzałej platformie staje się powierzchnią obserwowalności.

Dryf schematu zwykle najpierw zapowiada się w metadanych
Gdy zapisujący dodaje kolumnę, zmienia typ, usuwa pole albo zmienia zachowanie sortowania, zmiany te pojawiają się w metadanych pliku, zanim pulpity niżej ujawnią pełen zasięg skutków. To czyni inspekcję stopki użyteczną do wczesnego wykrywania.
Typowe sygnały dryfu to:
Nieoczekiwane pola dopuszczające wartości puste: pojawia się nowa kolumna, ale konsumenci nie wypełniają jej konsekwentnie.
Poszerzenie typu: pola całkowitoliczbowe stają się szerszymi typami numerycznymi, a logika niżej zmienia zachowanie.
Usunięte lub przemianowane pola: czytniki mogą wciąż działać, ale logika biznesowa zaczyna czytać coraz bardziej puste wyniki.
Niezgodność partycji: nazewnictwo katalogów i schemat pliku przestają opowiadać tę samą historię.
Timeliness i semantyka plików są ze sobą powiązane
Potoki Parquet tworzą też własne problemy ze świeżością. Tabela może wyglądać na obecną w magazynie, podczas gdy część plików jest wciąż niekompletna, opóźniona albo zapisana z niespójnymi metadanymi. Zapisujące strumieniowo mogą zostawić częściowe wyniki, które zmylą konsumentów, jeśli Twoja platforma za wcześnie oznaczy zbiór jako „gotowy”.
Dlatego inżynierowie monitorują coś więcej niż czas przybycia. Sprawdzają też liczbę plików, czas modyfikacji, spójność schematu między partycjami oraz metadane zapisującego, takie jak created_by i informacje o sortowaniu.
Jednym ze sposobów operacjonalizacji tego jest monitorowanie jeziora danych, które obserwuje razem sygnały na poziomie pliku i zbioru, zamiast traktować magazyn jak czarną skrzynkę. W tym kontekście digna pasuje jako opcja dla zespołów, które chcą monitorować we własnym środowisku zmiany schematu, Timeliness, anomalie i walidację w potokach jeziora i hurtowni.
Co obserwować na produkcji
Gdybym wdrażał nową inżynierkę analityki do jeziora mocno opartego na Parquet, powiedziałbym jej, by zaczęła od czterech kontroli:
Różnice stopek między dziennymi ładowaniami: wychwyć wcześnie ciche zmiany schematu.
Przyrost małych plików na partycję: ból zapytań często zaczyna się tutaj.
Macierz zgodności czytnika i zapisującego: prowadź jawną listę per wersja silnika.
Timeliness powiązana z pełną gotowością zbioru: nie alarmuj wyłącznie o brakujących folderach.
Najbardziej użyteczne metadane Parquet nie są po to, by plik był elegancki. Są po to, by pomóc Ci wykryć kłopoty, zanim użytkownicy zapytają, czemu pulpit wygląda źle.
Parquet działa dobrze, gdy Twoje obciążenie pasuje do jego projektu, ale wymaga zdyscyplinowanego monitorowania, gdy w grę wchodzi wiele silników, zapisujących i konsumentów niżej. digna pomaga zespołom śledzić zmiany schematu, Timeliness, walidację i zachowanie danych wewnątrz własnego środowiska, czyli dokładnie tam, gdzie problemy potoków Parquet ujawniają się najpierw. Jeśli Twój lakehouse działa na Parquet, a incydenty zaczynają się od cichego dryfu zamiast głośnych awarii, warto się przyjrzeć.
Metadane stopki wcześnie uwidaczniają dryf schematu, ale ktoś musi go pilnować — to zadanie warstwy zarządzania jakością danych nad jeziorem.
Najczęściej zadawane pytania
Dlaczego Parquet stał się domyślnym formatem kolumnowym?
Parquet stał się tkanką łączną między potokami Spark, eksportami z hurtowni, jeziorami w magazynie obiektowym i formatami tabel takimi jak Iceberg, Delta Lake i Hudi. Zespoły przyjęły go, bo jest otwarty, typowany i szeroko wspierany oraz dlatego, że oddziela fizyczne składowanie od wyboru silnika — plik zapisany jednym narzędziem pozostaje czytelny dla innego.
Jakie kodowania i kodeki kompresji obsługuje Parquet?
Parquet obsługuje kodowania na poziomie strony, w tym PLAIN, RLE, DELTA_BINARY_PACKED, RLE_DICTIONARY i BYTE_STREAM_SPLIT, oraz kodeki takie jak SNAPPY, GZIP, BROTLI, ZSTD i LZ4_RAW. Kodowanie przebudowuje wartości wewnątrz strony; kompresja zmniejsza potem zakodowany strumień bajtów. Wybierz kodek według tego, co optymalizujesz — szybkość odczytu, koszt składowania albo przepustowość zapisu.
Czym jest predicate pushdown w Parquet?
Predicate pushdown pozwala czytającemu pominąć dane na podstawie metadanych, zanim cokolwiek zdekoduje. Statystyki row group zapisują zakres obecnych wartości, więc filtr na region = 'EMEA' może odrzucić row groups, których statystyki dowodzą braku dopasowania. Działa razem z przycinaniem kolumn, które najpierw usuwa nieużywane kolumny.
Jak należy partycjonować i wymiarować pliki Parquet?
Partycjonuj po kolumnach, po których ludzie faktycznie filtrują — partycjonowanie działa jak zgrubny spis treści, pozwalając czytającym pominąć całe foldery przed otwarciem jakiejkolwiek stopki. Co do rozmiaru, bardzo małe pliki zwiększają narzut listowania i planowania, a bardzo duże obniżają równoległość i podnoszą koszt ponowień. Sortowanie po selektywnym polu wyostrza statystyki row group.
Czy ewolucja schematu Parquet jest bezpieczna między silnikami?
Tylko do pewnego stopnia. Materiały Apache o stanie implementacji pokazują wsparcie pofragmentowane według silnika i roku wydania, przy czym część nowszych funkcji jest wdrożona tylko częściowo. Groźne awarie to te ciche: jeden silnik czyta pole poprawnie, podczas gdy inny zwraca wartości puste. Walidowanie wyłącznie silnikiem zapisującym ukrywa to przez miesiące.



