Przewodnik po architekturze i niezawodności potoków danych ETL
|
7
min. czyt.

Analiza porównawcza z 2026 roku wykazała, że 97% wyższych liderów ds. danych i technologii twierdzi, że awarie potoków spowolniły inicjatywy analityczne lub AI, przy średniej miesięcznej ekspozycji biznesowej wynoszącej około 3 miliony dolarów (raport StorageNewsletter na temat tej analizy porównawczej). To zmienia sposób, w jaki oceniam potok danych ETL. Pytanie nie brzmi, czy zadanie zostało ukończone. Chodzi o to, czy potok dostarczył wiarygodne dane na czas, wraz z wystarczającymi dowodami, aby wyjaśnić, co się stało, gdy coś uległo zmianie.
Potok ETL jest często traktowany jak zwykła instalacja przesyłowa. W przedsiębiorstwie zachowuje się on bardziej jak usługa produkcyjna. Ma swoje zależności, oczekiwania dotyczące poziomu usług, tryby awarii, procedury odzyskiwania oraz odbiorców, którzy na podstawie jego wyników mogą podejmować decyzje finansowe, operacyjne lub regulacyjne. Praca nad niezawodnością nie jest więc poboczną konserwacją. To część produktu danych.
Spis treści
Dlaczego potoki ETL wciąż mają znaczenie w 2026 roku
Koszt biznesowy incydentu w potoku rzadko pojawia się w harmonogramie (schedulerze). Nieudane zadanie może wyglądać jak jeden czerwony status, ale konsekwencje mogą obejmować nieaktualne pulpity nawigacyjne, opóźnione uzgodnienia, zakłócone szkolenie modeli, ręczne dochodzenia oraz decyzje podejmowane na podstawie niepełnych informacji. Cytowane powyżej badanie porównawcze wykazało, że awarie potoków już teraz spowalniają programy analityczne i AI w zespołach kadry kierowniczej wyższego szczebla, co sprawia, że Observability staje się priorytetem biznesowym, a nie tylko funkcją pulpitu nawigacyjnego.
Obraz zawiera twierdzenia, które nie są częścią zweryfikowanych danych dostępnych dla tego artykułu, w tym rzekomy koszt awarii i wartości procentowe w otaczających go bąbelkach statystycznych. Dane te nie powinny być używane jako dowód. Zweryfikowane badanie porównawcze wspiera inny, wciąż pilny wniosek: awarie potoków generują średnio około 3 miliony dolarów miesięcznej ekspozycji biznesowej dla organizacji reprezentowanych w raporcie (StorageNewsletter).
ETL pozostaje fundamentem
ETL stał się kluczowym wzorcem danych w przedsiębiorstwach we wczesnych latach 90., gdy hurtownie danych weszły do głównego nurtu analityki. W tamtej erze pojawiły się dedykowane produkty integracyjne, w tym Prism Solutions założone w 1988 roku, Informatica założona w 1993 roku oraz DataStage w tym samym okresie. Do 1995 roku założono Data Warehousing Institute, co odzwierciedlało, jak szybko przepływ danych oparty na hurtowniach stał się odrębną kategorią oprogramowania dla przedsiębiorstw (historyczny przegląd hurtowni danych).
Ten wzorzec utrzymuje się, ponieważ wiele organizacji nadal wymaga, aby przekształcenia były kontrolowane, powtarzalne i audytowalne, zanim dane trafią do systemów antywirusowych. Środowiska finansowe, medyczne, telekomunikacyjne i sektora publicznego często nie mogą traktować surowych danych źródłowych jako natychmiast godnych zaufania. Potrzebują zdefiniowanych mapowań, dowodów walidacji, logiki uzgadniania, kontroli dostępu i powtarzalnych przebiegów.
ELT i streaming rozszerzyły przestrzeń projektową, ale nie wyeliminowały ETL. Nowoczesna platforma może wykorzystywać przechwytywanie zmian danych (CDC) dla jednego źródła, wsadowy proces ETL dla regulowanej księgi głównej, ELT dla eksploracyjnych modeli hurtowni oraz streaming dla zdarzeń wrażliwych na czas. Rozsądna architektura to taka, która odpowiada ryzyku danych, wymaganiom dotyczącym opóźnień, lokalizacji obliczeń, zobowiązaniom z zakresu governance oraz możliwościom odzyskiwania.
W celu uzyskania szczegółów wdrożeniowych zespoły mogą korzystać z najlepszych praktyk dotyczących potoków danych digna wraz z ich istniejącymi standardami orkiestracji i governance. Praktyczny cel jest prosty: sprawić, by zachowanie potoku było widoczne w kategoriach biznesowych, zanim pominięte ładowanie stanie się incydentem analitycznym.
Zrozumienie kluczowych komponentów architektury ETL
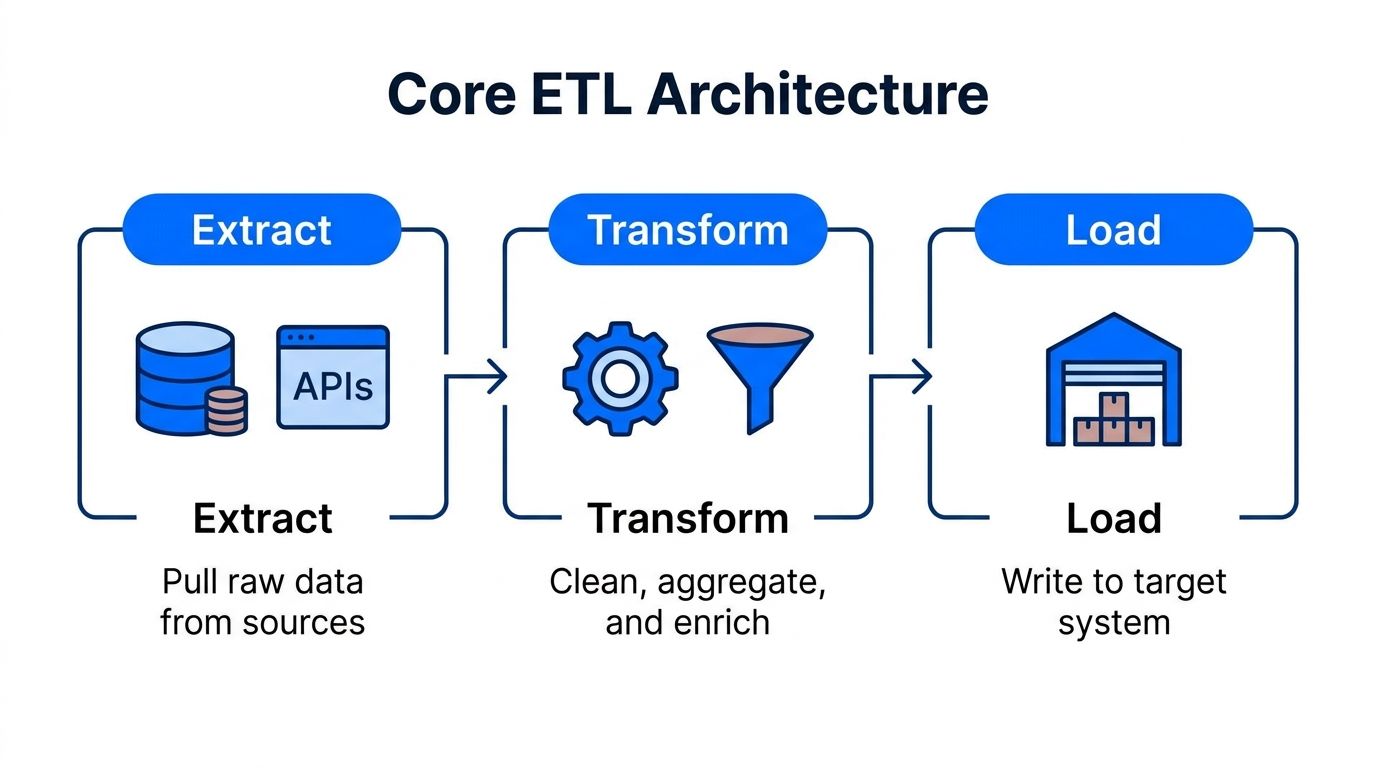
Potok danych ETL składa się z trzech definiujących ruchów: wyodrębniania (extract), transformacji (transform) i ładowania (load). W produkcji etapy te zazwyczaj znajdują się wewnątrz większej struktury kontrolnej, która obsługuje obszary przejściowe (staging), punkty kontrolne, zależności, ponowne próby, walidację i dowody operacyjne.
Wyodrębnianie (Extract) na granicy źródła
Wyodrębnianie pobiera dane z operacyjnych baz danych, interfejsów API, plików, aplikacji SaaS lub innych systemów. Trudność polega nie tylko na samym połączeniu się z każdym źródłem. Chodzi o zachowanie wystarczającego kontekstu, aby wiedzieć, co zostało wyodrębnione, kiedy to nastąpiło, która wersja źródłowa została użyta i czy źródło zwróciło kompletną odpowiedź.
Odporny mechanizm wyodrębniania ostrożnie obsługuje granice przyrostowe. Rejestruje on punkt kontrolny, taki jak ostatni zaakceptowany znacznik aktualizacji, i unika przesuwania tego punktu kontrolnego, dopóki zapis w dół potoku nie zakończy się sukcesem. Jeśli przebieg zatrzyma się w połowie, potok może wznowić lub powtórzyć działanie od znanej pozycji, zamiast zgadywać, co zostało przetworzone.
Obszar przejściowy (staging area) stanowi kolejną użyteczną granicę. Surowe wyodrębnione dane mogą być przechowywane przed transformacją, umożliwiając inżynierom inspekcję zachowania źródła, powtarzanie transformacji i oddzielanie problemów z dostępnością źródła od błędów transformacji.
Transformowanie (Transform) w zaufaną postać
Transformacja to etap, w którym potok ujednolica formaty, stosuje reguły biznesowe, usuwa bezużyteczne rekordy, uzgadnia jednostki i tworzy struktury analityczne. Identyfikator klienta może wymagać normalizacji w różnych systemach. Znaczniki czasu mogą wymagać wspólnej interpretacji. Rekordy transakcji mogą wymagać obsługi duplikatów i kontroli referencyjnej, zanim będą mogły wspierać raportowanie.
Zachowaj modułowość logiki transformacji. Pojedynczy monolityczny skrypt utrudnia wyizolowanie uszkodzonego mapowania lub zidentyfikowanie, która reguła zmieniła dane wyjściowe. Komponenty kontrolowane wersjami, jawne wejścia i wyjścia oraz funkcje testowalne sprawiają, że przegląd i wycofywanie zmian są bardziej praktyczne.
Ładowanie (Load) pod kontrolą
Ładowanie zapisuje zweryfikowane wyniki do hurtowni, jeziora danych, magazynu operacyjnego lub innego celu. Niezawodny program ładujący odróżnia zakończony zapis od zapisu ukończonego częściowo. W miarę możliwości korzysta z zachowań idempotentnych, rejestruje wiersze zaakceptowane i odrzucone oraz sprawia, że ostateczny krok publikacji jest jawny.
Orkiestracja powinna koordynować zależności, a nie uruchamiać zadania wyłącznie według harmonogramu. Dla zespołów projektujących stronę źródłową tej architektury, wskazówki digna dotyczące potoków pozyskiwania danych stanowią przydatny punkt odniesienia. Kluczową zasadą projektową jest traktowanie każdego etapu jako obserwowalnego kontraktu, a nie nieprzejrzystego przekazania zadań.
Wybór między podejściem ETL a ELT
ETL i ELT różnią się głównie tym, gdzie odbywa się transformacja. ETL przekształca dane przed załadowaniem ich do celu. ELT najpierw ładuje surowe dane, a następnie wykorzystuje docelową hurtownię lub lakehouse do ich transformacji.
Żadne z podejść nie jest uniwersalnie lepsze. ETL może być lepszym wyborem, gdy wrażliwe lub nieprawidłowe rekordy muszą zostać przefiltrowane przed wejściem do wspólnego magazynu analitycznego, gdy cel ma ograniczone zasoby obliczeniowe lub gdy wymagana jest kontrolowana reprezentacja przed załadowaniem w celu zapewnienia zgodności (compliance). ELT może być bardziej elastyczny, gdy zespoły muszą zachować surową historię, iterować na modelach i korzystać ze skalowalnych mocy obliczeniowych hurtowni do transformacji.
Decyzja zależy również od odzyskiwania po awarii. ETL może zmniejszyć ilość nieodpowiednich danych trafiających do celu, ale błąd transformacji może wymusić ponowne przetwarzanie upstream. ELT zachowuje surowe dane do późniejszego modelowania, ale przenosi większą odpowiedzialność na governance hurtowni, kontrolę dostępu, testowanie i zarządzanie obliczeniami.
Przydatna macierz decyzyjna wygląda następująco:
Czynnik | Wybierz ETL, gdy | Wybierz ELT, gdy |
|---|---|---|
Compliance | Wrażliwe dane muszą zostać przekształcone lub ograniczone przed załadowaniem | Surowe dane mogą być przechowywane przy zastosowaniu silnej kontroli dostępu |
Jakość danych | Walidacja przed załadowaniem musi blokować nieodpowiednie rekordy | Testy w hurtowni mogą zarządzać modelami po pozyskaniu danych (ingestion) |
Lokalizacja obliczeń | Przetwarzanie zewnętrzne jest dostępne lub cel ma ograniczone moce obliczeniowe | Hurtownia lub lakehouse zapewnia odpowiednią wydajność transformacji |
Ponowne przetwarzanie | Kontrakt przed załadowaniem jest stabilny i ściśle kontrolowany | Zespoły muszą wracać do surowych danych przy zmieniającej się logice biznesowej |
Governance | Wymagany jest uporządkowany cel przed szerokim udostępnieniem | Strefy surowe i modelowane mogą być odseparowane i zarządzane |
Umiejętności zespołu | Inżynierowie są najsilniejsi w narzędziach integracyjnych i transformacjach proceduralnych | Analitycy i inżynierowie swobodnie czują się w modelowaniu hurtowni opartym na SQL |
Architektura | Dominują starsze bazy danych lub regulowane przepływy pracy wsadowej | Kluczowe znaczenie mają pamięć masowa natywna dla chmury i elastyczne przetwarzanie w hurtowni |
Model operacyjny | Organizacja ceni rygorystyczne bramki wydań (Release) przed publikacją | Organizacja potrzebuje szybkiego eksperymentowania ze śledzonymi modelami |
Hybrydowe projekty są popularne nie bez powodu. Zespół może używać ETL do tokenizacji wrażliwych pól i egzekwowania kontraktów na poziomie źródła, a następnie używać ELT do dalszego modelowania wymiarowego. Taki układ pozwala zachować kontrolę na granicy systemu bez poświęcania elastyczności analitycznej.
Skorzystaj z wyjaśnienia digna dotyczącego pozyskiwania danych, aby sprecyzować granicę pozyskiwania przed wyborem wzorca transformacji. Najważniejszą decyzją nie jest sama etykieta. Chodzi o to, czy architektura czyni ryzyko danych, koszty, pochodzenie (lineage) i odzyskiwanie widocznymi dla osób odpowiedzialnych za wynik.
Typowe awarie potoków i obciążenia związane z konserwacją
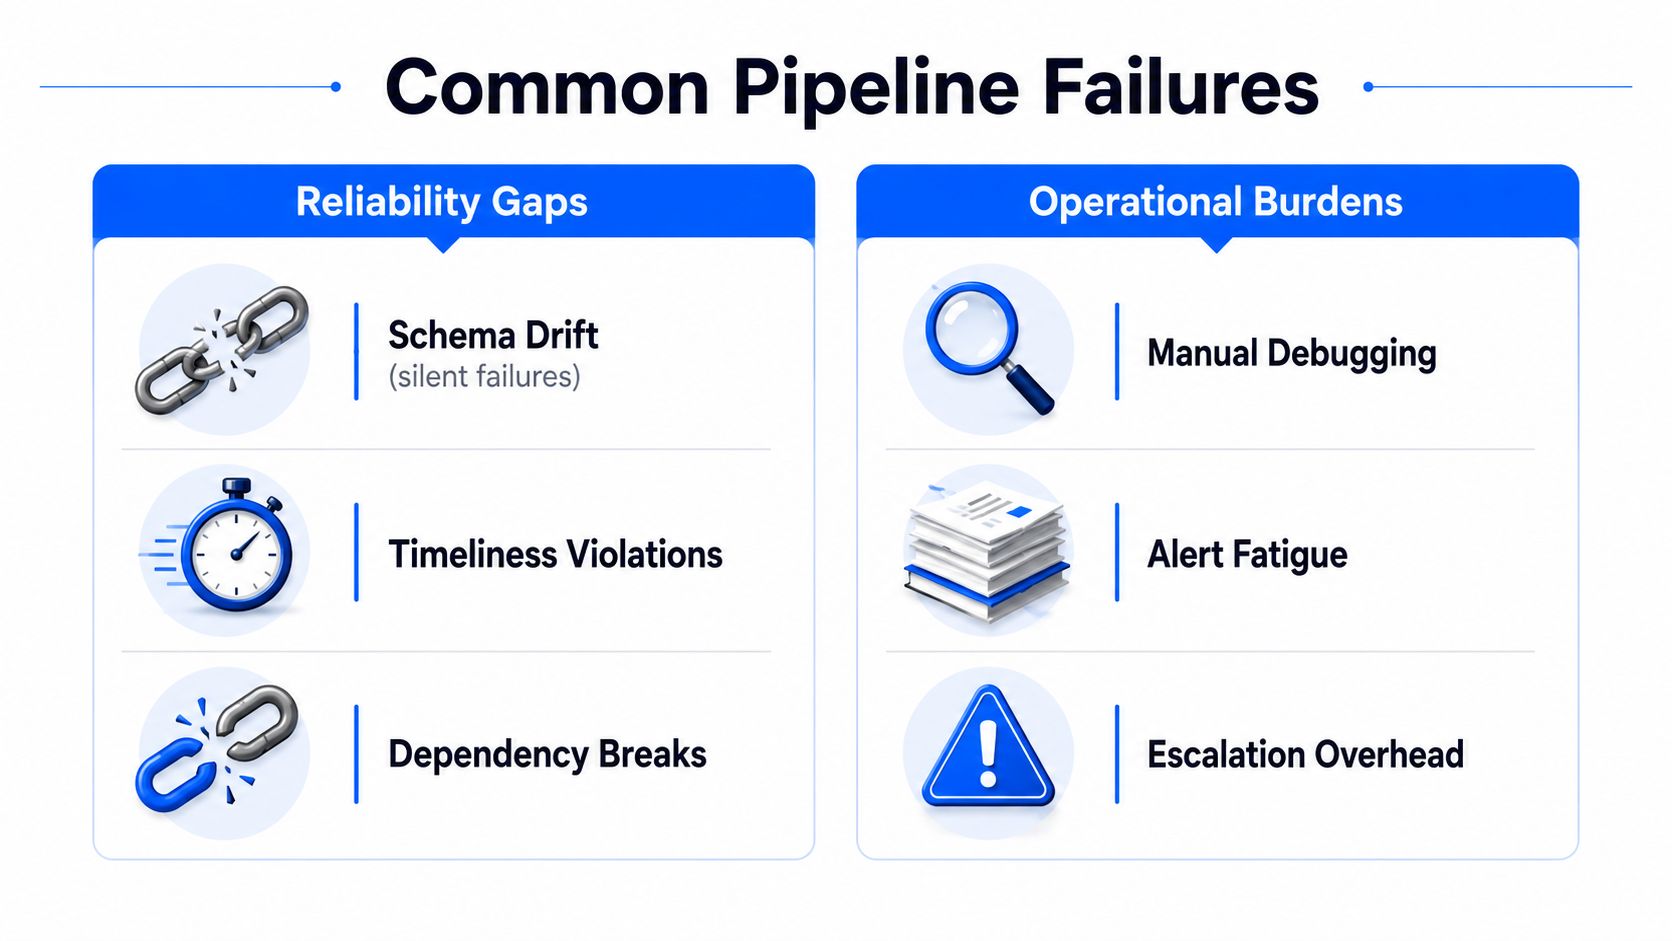
Zielony status harmonogramu ukrywa znacznie więcej, niż ujawnia na temat poprawności potoku. Zadanie ETL może zakończyć się po pobraniu niekompletnego pliku, zaakceptowaniu zmienionego typu kolumny, załadowaniu nieaktualnych rekordów lub wyprodukowaniu technicznie poprawnego wyniku, który błędnie przedstawia przychody, zapasy lub aktywność klientów.
Niekontrolowana zmiana schematu (schema drift) to częste źródło cichych awarii. Załóżmy, że źródło zmienia typ customer_id z liczby całkowitej na ciąg znaków lub zmienia nazwę order_status, podczas gdy wyodrębnianie nadal zgłasza sukces. Transformacja może odrzucić każdy wiersz, niepoprawnie przekonwertować wartości lub opublikować dane wyjściowe, których znaczenie uległo zmianie. Porównuj przychodzące metadane z wersjonowaną linią bazową przy każdym uruchomieniu, klasyfikuj zmiany i poddawaj kwarantannie niezgodności przed pełnym załadowaniem. Wskazówki dotyczące incydentów związanych ze schema drift dostarczają przydatnego kontekstu do obsługi tych zdarzeń.
What conventional monitoring misses
Zliczanie nieudanych zadań pozwala wykryć jawne błędy wykonania, podczas gdy wiarygodne operacje wymagają szerszych sygnałów:
Przepustowość: Porównaj oczekiwany przepływ z rzeczywistymi przetworzonymi wierszami lub bajtami.
Świeżość: Potwierdź, że najnowsze rekordy dotarły w uzgodnionym oknie serwisowym.
Dostępność: Śledź, czy potok i jego zależności są zdatne do użytku, gdy konsumenci ich potrzebują.
Czas odzyskiwania: Mierz, jak długo zespołom zajmuje przywrócenie wiarygodnego dostarczania.
Zachowanie błędów: Obserwuj odrzucone wiersze, ponowne próby, wzrost liczby wiadomości niesklasyfikowanych (dead-letter) i powtarzające się częściowe awarie.
Kontrole terminowości (Timeliness) powinny łączyć znaczniki czasu źródła, takie jak created_at lub updated_at, z sygnałami testowymi (heartbeats) i porównaniami harmonogramu z dostępnością. Kontrole te mogą ujawnić opóźnione pozyskiwanie danych, zanim raport w dół potoku widocznie ulegnie awarii (wskazówki dotyczące monitorowania terminowości).
Konserwacja jako ograniczenie ekonomiczne
Starsze potoki i te budowane własnymi siłami psują się częściej niż w pełni zarządzane systemy ELT, a inżynierowie danych mogą spędzać nawet 53% swojego czasu na konserwacji potoków, według badania z końca 2025 roku omówionego w raporcie TechTarget. Zarządzane systemy ELT nie eliminują pracy nad niezawodnością. Zespoły nadal potrzebują kontraktów, własności, procedur odzyskiwania i testów. Wybór operacyjny powinien uwzględniać nakład pracy, przestoje i koszty badania błędnych wyników.
Observability zmienia te kalkulacje, gdy łączy symptomy z wpływem i prawdopodobną przyczyną. Przewodnik Captapi po odpornych systemach oferuje szersze omówienie testowania odporności i zachowania w przypadku awarii. Alerty powinny identyfikować affected zestawy danych, pilność i kolejne działanie, zamiast tworzyć kolejną kolejkę niewyjaśnionego szumu.
Szczegółowa dyskusja na temat wczesnego wykrywania znajduje się w analizie digna dotyczącej tego, dlaczego potoki danych zawodzą w produkcji. Praktycznym celem jest krótsza ścieżka od zmiany źródła do bezpiecznej decyzji operacyjnej, co zmienia widoczność potoku z narzutu konserwacyjnego w atut dla niezawodnego dostarczania danych.
Budowanie niezawodności dzięki kontroli jakości
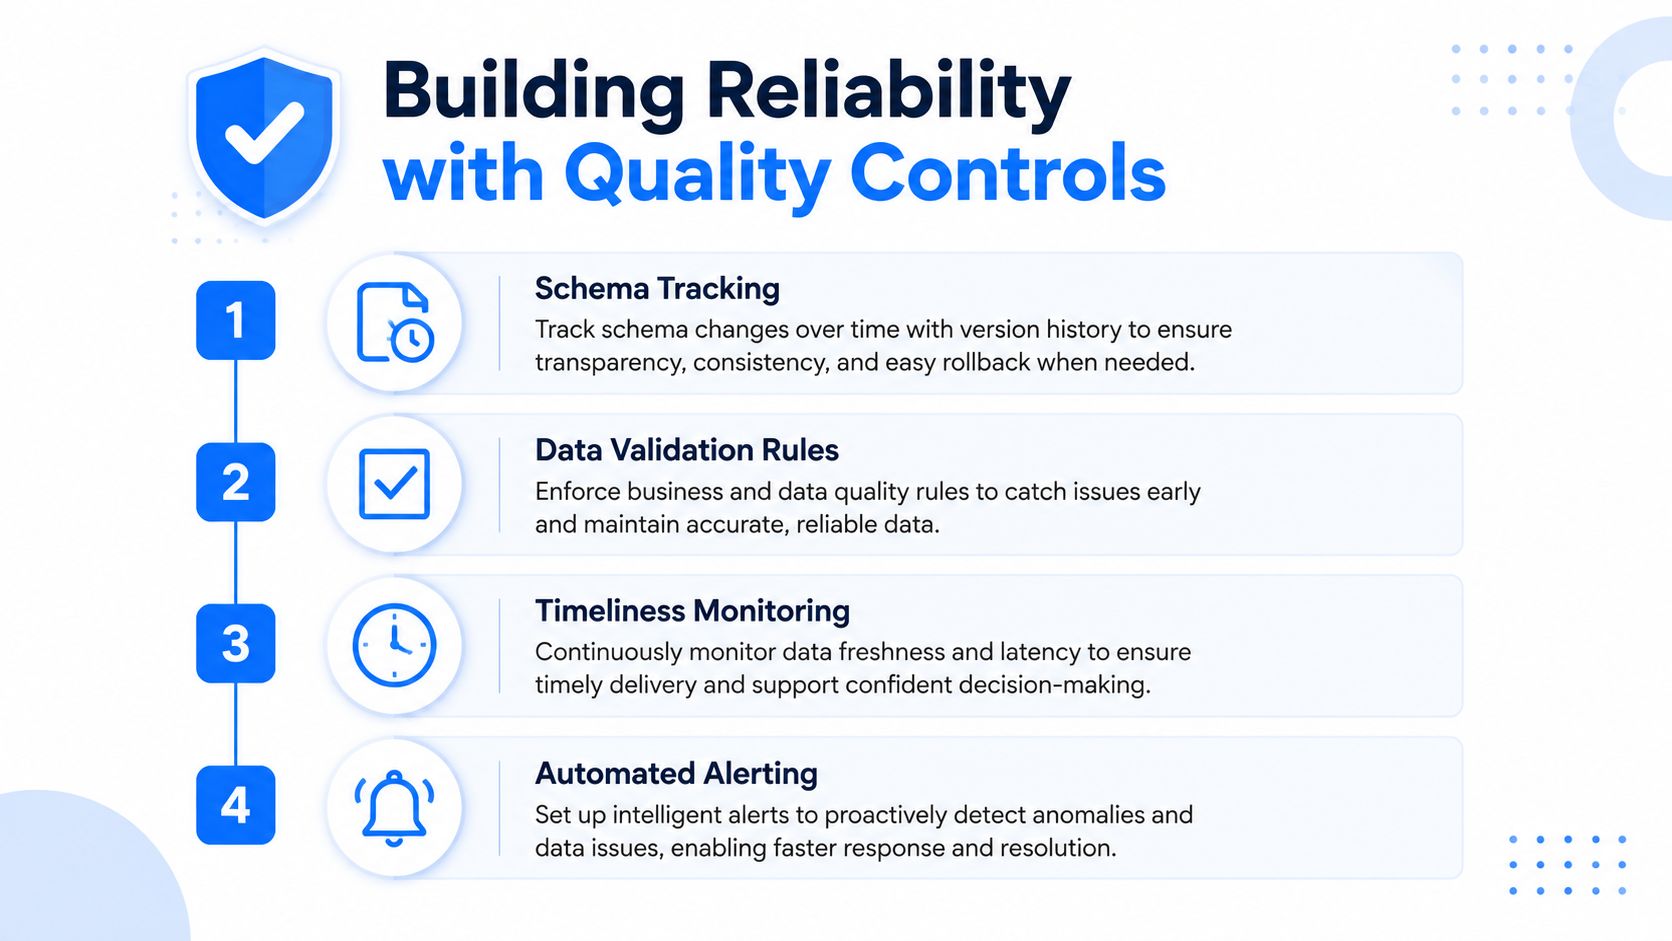
Niezawodność zależy od kontroli rozmieszczonych w całym potoku. Śledzenie schematu wychwytuje zmiany strukturalne, walidacja (Data Validation) testuje znaczenie danych, monitorowanie terminowości (Timeliness) identyfikuje problemy z dostarczaniem, a metryki operacyjne ujawniają pogarszającą się jakość wykonywania, nawet gdy zadania wciąż się kończą. Razem te kontrole ograniczają ukryte koszty awarii, w tym ponowne przetwarzanie, ręczne dochodzenia, opóźnione decyzje i utratę zaufania do danych wyjściowych.
Zacznij od pozyskiwania danych (ingestion)
Obsługuj zmiany schematu (schema drift) na granicy źródła, zanim zmieniona struktura dotrze do transformacji i odbiorców w dół potoku. Ustal wersjonowaną linię bazową dla każdego ważnego źródła, porównuj przychodzące metadane przy każdym uruchomieniu i klasyfikuj zmiany według ryzyka.
Kompatybilne dodanie pola może wymagać przeglądu bez powodowania przestoju. Usunięte pole, niekompatybilna zmiana typu lub zmiana nazwy klucza biznesowego powinny zazwyczaj zatrzymać lub poddać kwarantannie dany przepływ, dopóki właściciel nie certyfikuje go ponownie. Przebiegi testowe (canary runs) i rejestry schematów pozwalają zespołom testować kompatybilność przed opublikowaniem pełnego ładunku.
Walidacja rekordów i relacji
Reguły biznesowe przekształcają oczekiwania dotyczące jakości w decyzje, które systemy mogą przetestować. Kontrole w przedsiębiorstwie mogą obejmować przedziały wariancji liczby wierszy wynoszące ±30%, limit pustych wartości (null-rate) e-maili wynoszący mniej niż 5% oraz regułę integralności referencyjnej wymagającą, aby każdy order.customer_id istniał w tabeli klientów (przykłady kontroli jakości ETL).
Te progi nie są uniwersalnymi wartościami domyślnymi. Są to jawne kontrakty, które właściciele danych powinni zatwierdzać, dokumentować i przeglądać, gdy zmienia się zachowanie źródła. Walidacja na poziomie rekordu tworzy również dowód audytowy, pokazując, która reguła zawiodła i których rekordów to dotyczyło. Prace naukowe nad weryfikacją reguł biznesowych pod kątem jakości danych wspierają ocenę jakości na podstawie sformułowanych reguł. Wskazówki dotyczące wdrożenia znajdują się w analizie digna na temat reguł walidacji danych i ciągłej jakości danych.
Monitorowanie dostarczania i odzyskiwania
Potok może pomyślnie przejść każdy test zawartości i nadal nie dotrzymać biznesowego terminu. Zdefiniuj oczekiwania dotyczące świeżości na podstawie znaczników czasu źródła, oczekiwanych wzorców przybycia i wymagań usług odbiorców. Alertuj o brakującym, opóźnionym lub przedwczesnym dostarczeniu, gdy te zdarzenia wskazują na problem upstream lub z harmonogramem.
Śledź wiersze wejściowe, wyjściowe, odrzucone wiersze, czas trwania, liczbę błędów i świeżość dla każdego etapu. Eksperci zalecają dążenie do wskaźnika błędów poniżej 0,1%, traktowanie wskaźników powyżej 5% jako sygnału awarii systemowej, utrzymywanie 99,9% dostępności i przywracanie usług w czasie poniżej 30 minut (wskazówki dotyczące benchmarkingu ETL).
Zasada operacyjna: Alert powinien identyfikować zestaw danych, naruszony kontrakt, prawdopodobną zależność, właściciela biznesowego oraz kolejne bezpieczne działanie.
Te kontrole tworzą jedną pętlę operacyjną. Wykrywanie bez kwarantanny pozwala na rozprzestrzenianie się złych danych. Walidacja bez terminowości (Timeliness) pozostawia konsumentów z nieaktualnymi wynikami. Metryki bez przypisanej własności produkują wykresy, ale nie prowadzą do odzyskania sprawności. Observability łączy każdy sygnał ze spriorytetyzowaną reakcją, redukując nakład pracy konserwacyjnej i czyniąc niezawodne dostarczanie danych zarządzaną zdolnością operacyjną.
Jak Data Observability transformuje operacje
Tradycyjny monitoring pyta, czy zadanie zostało uruchomione. Data Observability pyta, czy dane zachowały się zgodnie z oczekiwaniami, czy konsumenci otrzymali je na czas i jaka zmiana wyjaśnia to odchylenie.
Rozważmy potok usług finansowych, który otrzymuje dane transakcyjne z kilku systemów operacyjnych. Zespół źródłowy dodaje pole i zmienia typ bez koordynacji z zespołem platformy danych. Scheduler może zgłosić sukces dla etapu wyodrębniania, podczas gdy model downstream odrzuca wartości lub zmienia swoją agregację bez powiadomienia. Śledzenie schematu może zidentyfikować zmianę strukturalną przy pozyskiwaniu danych, poddać kwarantannie dany przepływ i dostarczyć inżynierom dowodów, zanim cykl raportowania stanie się zależny od tych danych wyjściowych.
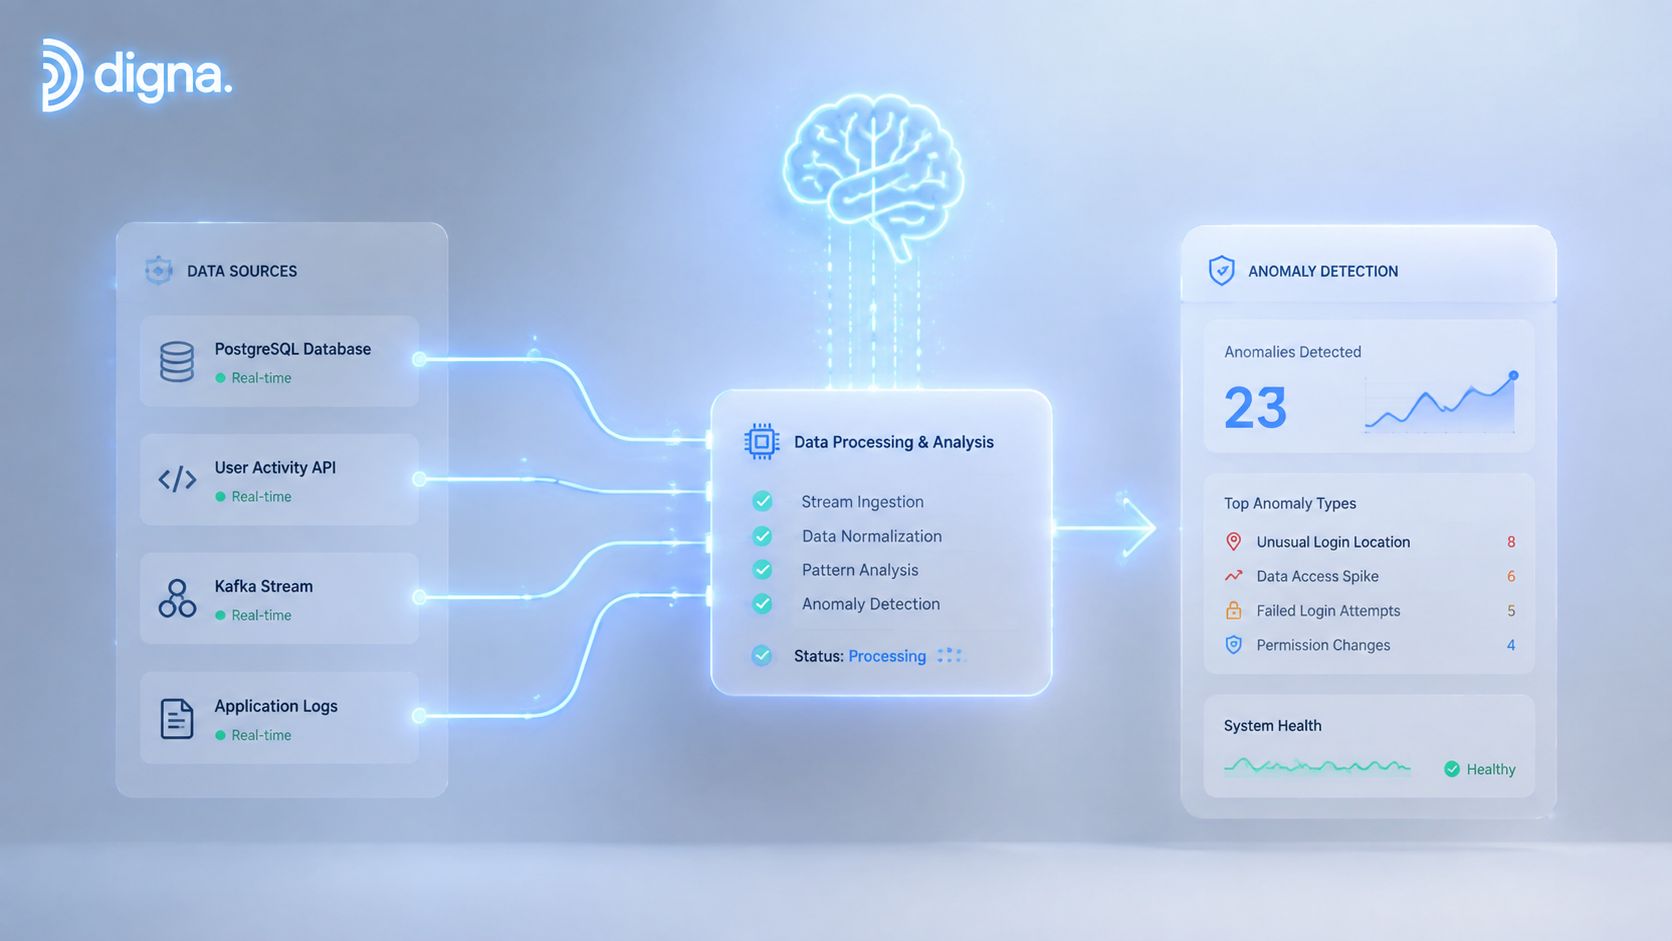
Potoki w branży opieki zdrowotnej generują inną presję. Zestaw danych może dotrzeć ze znanym schematem, ale z nietypowym wzorcem kompletności, bez istotnej części oczekiwanych rekordów. Wykrywanie anomalii w oparciu o linię bazową może oznaczyć tę zmianę zachowania, podczas gdy kontrole walidacyjne mogą przetestować wymagane relacje i reguły biznesowe. Monitorowanie terminowości (Timeliness) pozwala odróżnić opóźniony strumień danych od strumienia, który dotarł zgodnie z harmonogramem, ale zawiera anomalną zawartość.
Zespoły telekomunikacyjne często zarządzają dużym wolumenem danych operacyjnych i klientów w heterogenicznych systemach. Użyteczna warstwa observability powinna łączyć zachowanie platformy z zachowaniem danych, aby inżynierowie mogli odróżnić problem z obciążeniem, awarię źródła, zmianę schematu i błąd jakości. Dla zespołów, które wdrażają zarówno platformy danych, jak i praktyki inżynierii niezawodności systemów, zasoby dotyczące monitorowania infrastruktury dla inżynierów SRE zapewniają odpowiedni kontekst do myślenia o sygnałach, zależnościach i reagowaniu na incydenty.
digna może służyć jako jedna z opcji w tej kategorii. Działa w środowisku klienta, przeprowadza kontrole wewnątrz bazy danych, monitoruje anomalie, terminowość (Timeliness), reguły walidacji (Data Validation), zmiany schematu oraz metryki platformy, a także wspiera wdrażanie w chmurze prywatnej lub lokalnie (on-premises). Jej modułowa struktura pozwala zespołowi zacząć od jednej funkcji monitorowania i rozszerzać ją na kluczowe tabele i potoki, podczas gdy wspólny interfejs daje inżynierom, analitykom i interesariuszom jednolity widok incydentów i trendów.
Strategiczna zmiana jest mierzalna w przepływie pracy, nawet gdy same dane pozostają na swoim miejscu. Inżynierowie spędzają mniej czasu na udowadnianiu, że wystąpiła awaria, a więcej na decydowaniu, czy zablokować, powtórzyć, naprawić czy też skomunikować wpływ danej sytuacji.
Wdrażanie Observability w Twoim środowisku
Zacznij od zestawów danych, które mają jasne konsekwencje biznesowe. Mapuj ich źródła, właścicieli, odbiorców downstream, oczekiwane zachowanie przy dostarczaniu, kluczowe pola i zależności odzyskiwania. Nie zaczynaj od instrumentowania każdej tabeli. Wąski początkowy zakres daje jaśniejsze poczucie odpowiedzialności i ujawnia luki w kontraktach.
Następnie ustal linię bazową dla każdego wybranego zbioru danych. Uchwyć normalny wolumen, zachowanie przy dostarczaniu, postać schematu, wzorce wartości pustych (null) oraz wyniki walidacji. Skonfiguruj alerty dla odchyleń wymagających działania i skieruj je do zespołu, który może zmienić źródło, potok lub cel. Alert, który nie trafia do nikogo zdolnego do naprawy błędu, jest jedynie dokumentacją awarii.
Dodawaj kontrole bez zastępowania istniejącego schedulera. Airflow, dbt, Informatica, Talend i Spark mogą nadal zarządzać transformacjami, podczas gdy warstwa observability ocenia zachowanie wokół nich. Zacznij w trybie monitorowania, jeśli blokowanie ładowania wiązałoby się z niepotrzebnym ryzykiem, a następnie promuj testy o wysokiej pewności do kwarantanny lub bramek wydań (Release).
Współpraca przy obsłudze incydentów
Zdefiniuj rekord incydentu, który zawiera naruszone oczekiwanie, dane, których dotyczy problem, czas pierwszego wykrycia, bieżący status, właściciela, środki naprawcze i działania następcze. Analizuj powtarzające się awarie pod kątem wpływu na biznes, a nie liczby alertów. Opóźniony zestaw danych o niskim wpływie może mieć niższy priorytet niż subtelna zmiana schematu w strumieniu regulacyjnym, nawet jeśli ta druga nie wygenerowała błędu w schedulerze.
Mierz, czy ta praktyka skraca czas wykrywania, nakład pracy przy dochodzeniu, powtarzalność, dostarczanie nieaktualnych danych i odrzucanie danych. Powiąż oceny z wynikami biznesowymi, takimi jak wiarygodne raportowanie i bezpieczniejsze dane wejściowe dla AI. Observability staje się aktywem strategicznym, gdy liderzy widzą, które inwestycje w niezawodność chronią proces decyzyjny, a które zmiany w potokach generują nowe ryzyka.
digna zapewnia wewnątrzśrodowiskowe Data Observability dla potoków ETL, w tym wykrywanie anomalii, śledzenie schematów, monitorowanie terminowości (Timeliness), walidację na poziomie rekordów (Data Validation) oraz metryki platformy. Odwiedź digna, aby ocenić, jak jej modułowy model wdrażania może pomóc Twojemu zespołowi wcześniej wykrywać ryzyka w potokach i przekształcić dbanie o niezawodność w odpowiedzialną praktykę operacyjną.
Najczęściej zadawane pytania
Ile naprawdę kosztuje awaria potoku?
Benchmark z 2026 r. wykazał, że 97 % wyższych menedżerów ds. danych i technologii mówi, iż awarie potoków spowolniły inicjatywy analityczne lub AI, przy średniej miesięcznej ekspozycji biznesowej rzędu 3 mln dolarów. Koszt rzadko pojawia się w harmonogramie zadań i dlatego pozostaje poza budżetem.
Dlaczego ETL wciąż się liczy obok ELT i streamingu?
Bo wiele organizacji nadal potrzebuje, by transformacje były kontrolowane, odtwarzalne i audytowalne, zanim dane dotrą do systemów analitycznych. ELT i streaming poszerzyły przestrzeń projektową, nie usuwając tego wymagania.
Kiedy ETL stał się standardowym wzorcem?
Na początku lat dziewięćdziesiątych, gdy hurtownie danych weszły do głównego nurtu analityki. W tym okresie powstały dedykowane produkty integracyjne, w tym Prism Solutions założona w 1988 r., Informatica założona w 1993 r. oraz DataStage z tego samego czasu.
Jakie ruchy definiują potok ETL?
Trzy: wyodrębnienie na krawędzi źródła, przekształcenie według uzgodnionej logiki i załadowanie do celu. Nazwanie ich osobno ma znaczenie, bo każdy ma własne tryby awarii i przez każdy wchodzi inny rodzaj usterki.
Co monitorować poza statusem zadania?
Dane, które zadanie wytworzyło. Harmonogram raportuje zakończenie, a ekspozycja biznesowa bierze się z wyniku, który się zakończył i był błędny, więc praca nad niezawodnością należy do warstwy danych, a nie tylko do warstwy orkiestracji.