Jakość danych ETL: Praktyczny przewodnik po niezawodnych potokach danych
|
6
min. czyt.

Twój potok zazielenił się o 2:14 w nocy. Przed śniadaniem finanse wpatrują się w linie przychodów, które nie mają sensu, analitycy pytają, czy magazyn jest uszkodzony, a Twoje narzędzie do orkiestracji nadal upiera się, że wszystko się udało. Ta luka między kondycją zadań a kondycją danych to miejsce, w którym jakość danych ETL zwykle zawodzi w praktyce.
Trudną częścią nie jest uruchamianie testów. Jest nią projektowanie mechanizmów kontrolnych, które zauważają zmianę zachowania danych, a nie tylko błąd zadania. Potoki ETL mogą kończyć się na czas, osiągać oczekiwaną liczbę wierszy, a mimo to przesyłać dalej uszkodzone, nieaktualne lub strukturalnie niezgodne dane. Dlatego jakość musi być mierzona na samych danych, a nie na flagach sukcesu przypisanych do zadania.
Spis treści
Pięć wymiarów jakości, które musi monitorować każdy potok ETL
Walidacja oparta na regułach a wykrywanie anomalii oparte na sztucznej inteligencji
Mechanika walidacji na poziomie rekordów, która wychwytuje błędy
Monitorowanie terminowości (Timeliness) i oczekiwane okna dostarczania
Dryft schematu i jak go wykryć przed awarią systemów odbiorczych
Typowe błędne przekonania i praktyczna lista kontrolna jakości
Kiedy zielone potoki generują uszkodzone dane
Zielone uruchomienie może wyglądać dobrze aż do momentu, gdy ktoś otworzy pulpit nawigacyjny i zobaczy liczby, które nie odpowiadają rzeczywistości. Warstwa ETL może zakończyć się pomyślnie, podczas gdy system źródłowy zmieni pole dziesiętne, plik dotrze w połowie pusty lub wymuszenie typu zmieni poprawne wartości w coś, co nadal się ładuje, ale nie oznacza już tego, co kiedyś. Zanim finanse, operacje lub BI zauważą problem, incydent w potoku jest już przeszłością, a czyszczenie przeniosło się do systemów odbiorczych.
Historyczne badania nad ETL jasno wskazują, skąd biorą się te awarie. Badanie wdrożeń ETL wykazało, że zadania ETL kończące się niepowodzeniem w trakcie pracy, blokowanie systemów podczas wykonywania oraz brak danych w systemie docelowym z powodu błędnej transformacji kluczy głównych należały do najczęstszych problemów, a te same procesy powodowały problemy z dokładnością, terminowością (timeliness), wiarygodnością i spójnością reprezentacji (Badanie awarii jakości danych ETL). Wniosek jest prosty. Sam potok może wprowadzić błąd, nawet jeśli system źródłowy wyglądał poprawnie.
Dlaczego status wykonania nie wystarczy
Narzędzia do orkiestracji w większości raportują, czy zadanie zostało uruchomione, a nie czy dane zachowały się poprawnie. Zadanie może zakończyć się zgodnie z harmonogramem i nadal dostarczać częściowe ładunki, pominąć partycję lub wymusić zmianę wartości podczas transformacji. Dlatego mechanizmy kontrolne powinny znajdować się w warstwie danych, a nie tylko w warstwie przepływu pracy.
Zasada praktyczna: traktuj każde udane uruchomienie ETL jako niezweryfikowane, dopóki dane nie przejdą testów świeżości, schematu i rekordów.
Koszt popełnienia tego błędu nie jest abstrakcyjny. Gartner szacuje, że niska jakość danych kosztuje organizacje średnio 12,9 miliona dolarów rocznie, a podsumowania branżowe wskazują, że złe dane mogą powodować od 15% do 25% strat w przychodach w niektórych firmach, dlatego wczesne kontrole jakości ETL są tak ważne (Koszty niskiej jakości danych). Eppler i Helfert opisali również 23 odrębne typy kosztów powiązanych z danymi niskiej jakości, w tym konserwację, nadmierną pracę, ponowne wprowadzanie danych, utratę przychodów, utratę klientów i poprawki. Zidentyfikowali również 10 kategorii kosztów zapewnienia jakości danych, takich jak inspekcja, zapobieganie defektom, naprawa, szkolenia i doskonalenie procesów. Mówiąc wprost, rachunek pojawia się niezależnie od tego, czy inwestujesz w jakość, czy nie.
Co zwykle psuje się jako pierwsze
Awarie, które bolą najbardziej, to te ciche. Plik dociera z opóźnieniem, ale nadal się ładuje. System źródłowy dodaje kolumnę, a Twój parser ją ignoruje. Pole numeryczne staje się tekstem, a magazyn akceptuje je po wymuszeniu typu. Żaden z tych problemów nie musi zatrzymać zadania, ale wszystkie skażą dane.
Właściwą odpowiedzią jest warstwowy monitoring, a nie nadzieja. Potrzebujesz sygnałów behawioralnych, które informują, kiedy potok produkuje dane, które nie pasują już do oczekiwanego kształtu, czasu lub rozkładu. Oznacza to wyjście poza samą weryfikację wykonania i spojrzenie na właściwości samych rekordów.
Pięć wymiarów jakości, które musi monitorować każdy potok ETL
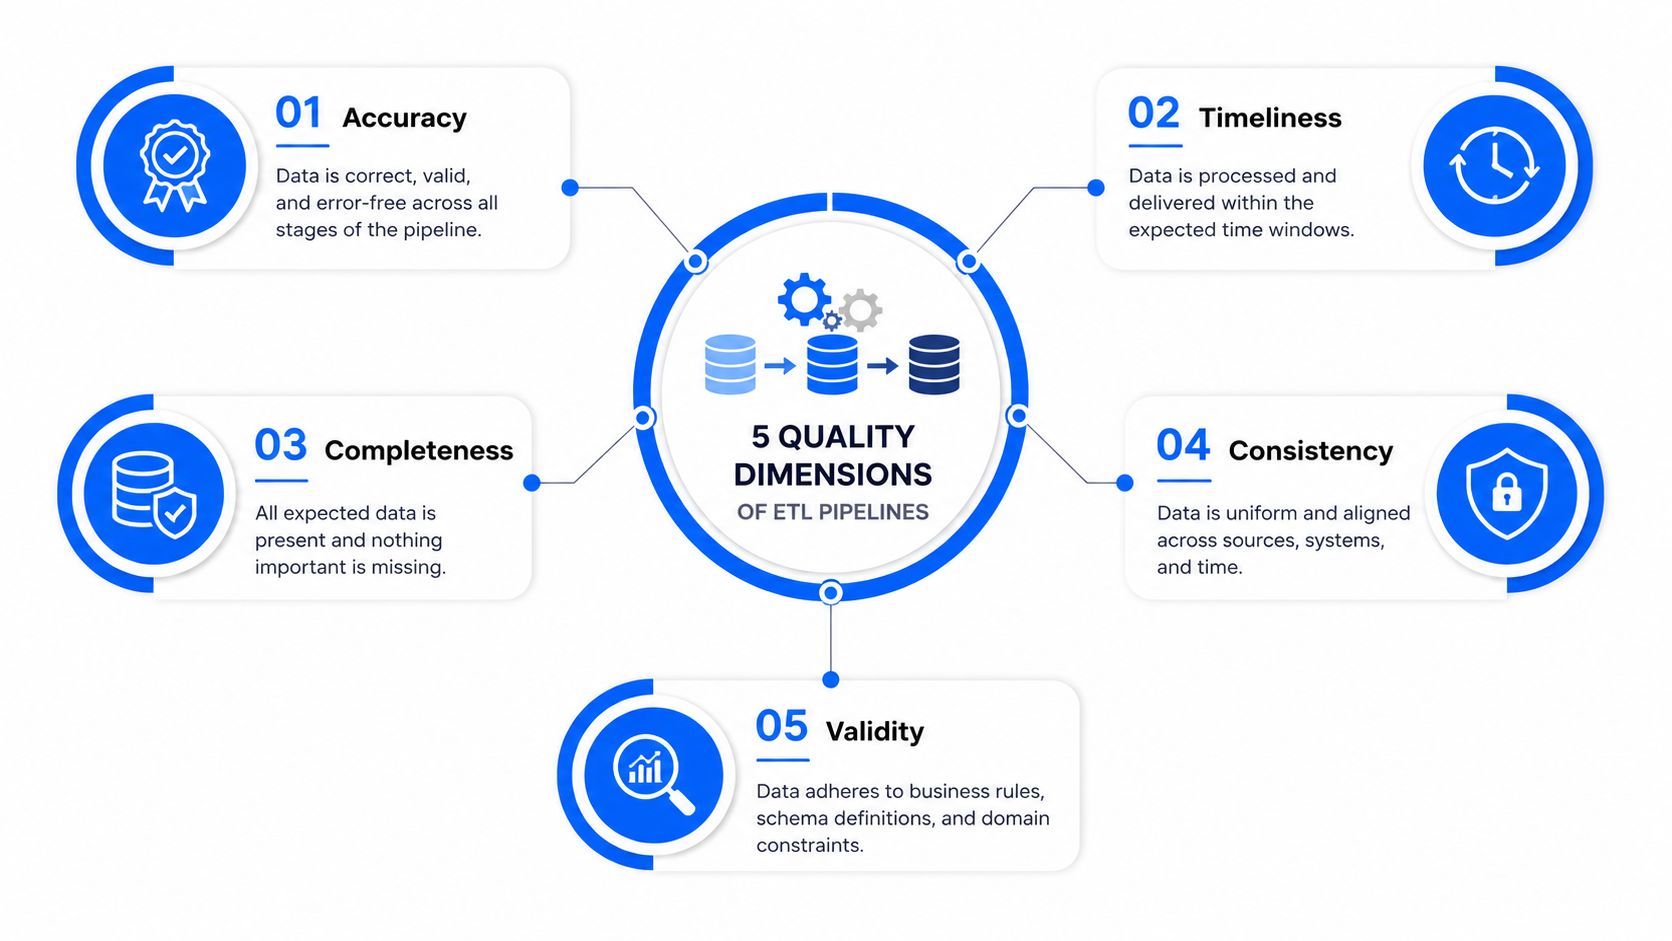
Jakość ETL działa najlepiej, gdy przestaniesz traktować ją jak pojedynczy wynik. Współczesne badania nad observability definiują problem wokół świeżości, schematu, wolumenu, dystrybucji i pochodzenia danych (lineage), a ten podział przekłada się bezpośrednio na starsze akademickie wymiary, takie jak dokładność, kompletność, spójność, timeliness, ważność i unikalność (Współczesne filary observability, akademicki przegląd wymiarów jakości ETL). Każdy z nich wychwytuje inny tryb awarii i żaden nie zastępuje pozostałych.
Świeżość informuje, czy dociera najnowszy poprawny rekord. Schemat wychwytuje dryft strukturalny, w tym nowe kolumny, usunięte pola i zmiany typów. Wolumen sygnalizuje nagłe spadki lub skoki sugerujące obcięcie danych lub duplikację. Dystrybucja ujawnia bardziej subtelne zmiany, takie jak zmiany wskaźnika wartości pustych (null) lub przesunięte zakresy wartości. Pochodzenie danych (lineage) pozwala powiązać problem ze źródłem i krokiem transformacji, który go wprowadził.
Dlaczego pięć filarów musi ze sobą współpracować
Jeśli będziesz obserwować tylko schemat, przegapisz nieaktualne, ale strukturalnie poprawne dane. Jeśli będziesz obserwować tylko wolumen, wadliwy ładunek może przejść pomyślnie, ponieważ liczba wierszy wygląda normalnie. Jeśli będziesz monitorować tylko świeżość, nadal możesz wysłać strukturalnie błędny plik dokładnie na czas. Dlatego są to sygnały behawioralne, a nie wymienne pola wyboru.
Dobrym źródłem informacji dla zespołów budujących dyscyplinę w tym zakresie są Standardy jakości danych szkoleniowych, zwłaszcza jeśli próbujesz dostosować analityków, inżynierów i właścicieli ładu danych (governance) do tych samych oczekiwań. Nie chodzi o to, by nakładać więcej barier. Chodzi o to, aby właściwy tryb awarii stał się widoczny, zanim magazyn danych stanie się jedynym miejscem, w którym ktokolwiek go zauważy.
Zespołom, które chcą bardziej formalnego podziału filarów, udostępniam prosty wewnętrzny odnośnik w Wymiary jakości danych digna. Tego rodzaju wspólne słownictwo ma znaczenie, gdy różne zespoły używają tych samych słów do oznaczania różnych rzeczy.
Co faktycznie wychwytuje każdy wymiar
Świeżość wychwytuje brakujące lub opóźnione dostawy, zanim pulpity nawigacyjne stracą aktualność.
Schemat wychwytuje niezapowiedziane zmiany struktury, które psują pracę odbiorców lub niszczą mapowania.
Wolumen wychwytuje obcięcia danych, duplikację i częściowe ładowanie.
Dystrybucja wychwytuje zmiany wskaźników wartości pustych (null), zakresów wartości i kardynalności, które reguły wiersz po wierszu często pomijają.
Pochodzenie (Lineage) pomaga prześledzić awarię wstecz do systemu źródłowego, zadania lub kroku transformacji.
Magazyn danych wygląda na zdrowy tylko wtedy, gdy sprawdzasz odpowiednią warstwę.
Najsilniejsze wdrożenia observability nie opierają się na jednym wymiarze wykonującym całą pracę. Używają każdego wymiaru jako innego obiektywu dla tego samego potoku, dzięki czemu problem można wykryć tam, gdzie się zaczął, a nie po tym, jak wpłynął na raportowanie w systemach odbiorczych.
Walidacja oparta na regułach a wykrywanie anomalii oparte na sztucznej inteligencji
Walidacja oparta na regułach jest nadal niezbędna, ale obejmuje tylko to, czego już się spodziewasz. Jeśli pole przychodu nie może być ujemne, jeśli kod kraju musi należeć do zdefiniowanego zbioru lub jeśli klucz obcy musi istnieć przed załadowaniem wiersza faktów, reguła powinna to wymusić. To twarda kontrola, a twarda kontrola jest dobra.
Problem polega na tym, że reguły są ślepe na zachowania, które się zmieniają bez naruszania twardych ograniczeń. Źródło może zacząć wysyłać rekordy z opóźnieniem, pole może stać się bardziej zaszumione, złączenie może utracić pasujące klucze lub dystrybucja może zmienić się na tyle, by uszkodzić analitykę, przechodząc jednocześnie pomyślnie przez każdą statyczną kontrolę. W tym miejscu swoje miejsce znajduje wykrywanie anomalii. Aby uzyskać szerszy przegląd tego wzorca, warto przeczytać Przewodnik po wykrywaniu anomalii w ETL wraz z Podejście do wykrywania anomalii digna.
Praktyczny kompromis jest prosty. Reguły są precyzyjne i łatwe do wyjaśnienia. Wykrywanie anomalii obejmuje szerszy obszar, ale wymaga punktu odniesienia i może generować szum, jeśli nie dostroisz dokładnie odpowiedzialności i alertów. Z mojego doświadczenia wynika, że zespoły wpadają w kłopoty, gdy traktują wykrywanie anomalii jako substytut deterministycznych kontroli. Tak nie jest.
Gdzie każde podejście wygrywa
Wymiar | Walidacja oparta na regułach | Wykrywanie anomalii oparte na AI |
|---|---|---|
Koszt konfiguracji | Niższy w przypadku znanych ograniczeń | Wyższy, ponieważ wymaga historycznego punktu odniesienia zachowań |
Zakres | Wąski, ale dokładny | Szerszy, wychwytuje dryft i nietypowe wzorce |
Obciążenie konserwacją | Rośnie wraz z nagromadzaniem się reguł | Rośnie, gdy punkty odniesienia, właściciele i dostrajanie nie są zarządzane |
Czas do uzyskania informacji | Natychmiastowy w przypadku zdefiniowanych awarii | Szybki po wyuczeniu wzorców, ale nie zawsze natychmiastowy od pierwszego dnia |
Ślepe plamy | Nieznane niewiadome i dryft zachowań | Twarde niezmienniki biznesowe i jawne wymagania polityki |
Jak układać je warstwowo bez tworzenia chaosu alertów
Zacznij od reguł dla niezmienników, których nigdy nie chciałbyś łagodzić. Następnie nałóż wykrywanie anomalii dla metryk, które mają tendencję do dryfowania, takich jak wolumen, wskaźniki wartości pustych i korelacje pól. Jeśli rekord nie przejdzie którejś z warstw, skieruj go do kwarantanny lub kolejki przeglądu, zamiast pozwalać mu przejść dalej.
Takie podejście sprawia również, że Twoje kontrole są zrozumiałe. Inżynierowie mogą debugować niespełnione ograniczenie. Analitycy mogą zrozumieć, dlaczego zmienił się punkt odniesienia. Zespoły ds. governance otrzymują rejestr tego, co zostało zablokowane i dlaczego. Dobrze zaprojektowany system przypomina mniej ścianę podatnych na uszkodzenia kontroli, a bardziej skalibrowany zestaw barier ochronnych.
Mechanika walidacji na poziomie rekordów, która wychwytuje błędy
Kontrole na poziomie rekordów działają tylko wtedy, gdy przekładają się na wpływ biznesowy, a nie tylko na status zaliczenia lub niezaliczenia. Brakujące pole dopuszczające wartość pustą w zbiorze danych o niskim ryzyku to nie to samo, co brakujący klucz w tabeli faktów dotyczących przychodów. Kontrola musi odzwierciedlać tę różnicę, inaczej staje się albo zbyt rygorystyczna, by przetrwać, albo zbyt luźna, by mieć znaczenie.
Kliniczne analizy ETL pokazują, jak szybko jakość może ulec pogorszeniu, gdy definicje są rozmyte. W jednym z badań szpitalnych wskaźniki błędów ręcznego wyodrębniania i zautomatyzowanego eksportu różniły się w zależności od tego, czy wykluczono niejednoznaczne pola, co prowadzi do prostego wniosku: automatyzacja nie gwarantuje jakości, a jasność definicji danych istotnie wpływa na wskaźnik błędów.
Używaj progów, a nie tylko liczby wierszy
Wskaźnik niepowodzeń na poziomie 0,1% przy ładowaniu 50 milionów wierszy to inny problem operacyjny niż ten sam wskaźnik przy partii 1000 wierszy. Pierwszy przypadek może ukrywać dziesiątki tysięcy złych wierszy. Drugi może być małą, ale krytyczną próbką, w której liczy się nawet jeden błąd.
Dlatego poziomy ważności mają znaczenie. Ostrzeżenie, kwarantanna i zatrzymanie dają potokowi przestrzeń do reakcji bez stawania się jednocześnie kruchym i zbyt pobłażliwym.
Mechanika walidacji powinna pozostać konkretna. Artykuł o walidacji ETL z 2021 r. zaleca poprawną liczbę kolumn, typy danych i ograniczenia kolumn, a także obecność i kolejność kolumn dla plików płaskich, wraz z ograniczeniami klucza głównego, klucza obcego i indeksu unikalnego (artykuł o mechanice walidacji). To pozostaje kręgosłupem niezawodnej walidacji na poziomie rekordów.
Kontrole, które opłacają się w praktyce
Wykrywanie wartości pustych (null): Profiluj kolumny i ustawiaj akceptowalne zakresy gęstości, szczególnie dla obowiązkowych pól biznesowych.
Wymuszanie kluczy: Odrzucaj zduplikowane klucze główne i osierocone klucze obce, zanim skażą złączenia w dalszych krokach.
Walidacja domenowa: Używaj kontrolowanych wartości dla pól takich jak kody krajów ISO i inne ograniczone typy wyliczeniowe.
Progi biznesowe: Wyrażaj pasma tolerancji przychodów, limity zwrotów lub progi anulowania jako procenty przychodzących wierszy.
Późno docierające fakty: Waliduj pod kątem okien datowania ważności, aby zdarzenia trafiały do właściwego przedziału czasowego.
Wolę poddawać kwarantannie niejednoznaczne wiersze, niż pozwalać im modyfikować zaufany zbiór danych. Kwarantanna daje producentom danych szansę na naprawienie źródła lub mapowania bez zamieniania magazynu danych w śmietnik.
Zasada operacyjna: jeśli zespół nie potrafi wyjaśnić, dlaczego zignorowanie błędnego wiersza jest bezpieczne, nie jest ono bezpieczne.
Jedna praktyczna uwaga. Nie pisz reguł dla każdego skrajnego przypadku. Zacznij od pól, które napędzają finanse, zgodność (compliance), procesy robocze klientów i szkolenie modeli. To tam defekty jakościowe najszybciej stają się kosztowne.
Typ kontroli | Co wykrywa | Wskazówki dotyczące progów | Zalecane działanie |
|---|---|---|---|
Kontrole wartości pustych | Brakujące wymagane wartości | Ustalane na podstawie krytyczności pola i rozmiaru zbioru danych | Ostrzeżenie dla pól o niskim ryzyku, kwarantanna dla pól krytycznych |
Ograniczenia kluczy | Duplikaty i uszkodzone relacje | Zero tolerancji dla kluczy identyfikacyjnych | Zatrzymanie lub kwarantanna |
Reguły domenowe | Niepoprawne kody i wartości spoza zbioru | Używaj skończonych list dozwolonych wartości | Odrzucenie lub skierowanie do naprawy |
Kontrole zakresów | Wartości odstające i niemożliwe | Zdefiniuj granice specyficzne dla biznesu | Ostrzeżenie przy miękkich limitach, kwarantanna przy twardych |
Datowanie ważności | Późne lub błędnie datowane zdarzenia | Waliduj pod kątem oczekiwanych okien | Kwarantanna i w razie potrzeby ponowne przetworzenie |
Dla zespołów, które chcą szerszego zestawu kontroli, Reguły walidacji danych i przewodnik ciągłej jakości digna stanowią przydatne uzupełnienie tych kontroli na poziomie rekordów.
Monitorowanie terminowości (Timeliness) i oczekiwane okna dostarczania
Potok może mieć status zielony, a mimo to dostarczać nieaktualne dane. To właśnie niszczy poranne pulpity nawigacyjne, a nie alert o nieudanym zadaniu. Terminowość (Timeliness) musi być traktowana jako umowa SLA, z oczekiwanym oknem dostarczania powiązanym z momentem, w którym biznes korzysta ze zbioru danych.
Kontrola ta jest prosta w teorii i bezlitosna w praktyce. Porównaj oczekiwany czas przybycia z rzeczywistym czasem przybycia, a następnie oznacz przebieg jako wczesny, opóźniony, brakujący lub częściowy. Kanał sprzedaży, który musi dotrzeć przed porannym przeglądem przychodów o 8:00 rano, ma wąskie okno, podczas gdy popołudniowy kanał raportowania może tolerować dłuższe opóźnienie. Jako punkt odniesienia przyjmij biznesowy moment odcięcia, a nie harmonogram w narzędziu orkiestracji.
Najczystszym sposobem na ustawienie tego okna jest nauka na podstawie wcześniejszych wzorców przebiegów, kadencji zatwierdzania danych źródłowych i czasu konsumpcji. Jeśli zespół sprawdza pulpity nawigacyjne na początku dnia, dziesięciominutowe opóźnienie może mieć znaczenie. Jeśli dane są używane dopiero po obiedzie, to samo opóźnienie może być szumem. Przewodnik po metrykach Timeliness (timeliness) digna zapewnia przydatne ramy do ustawiania tych okien i spójnego ich mierzenia.
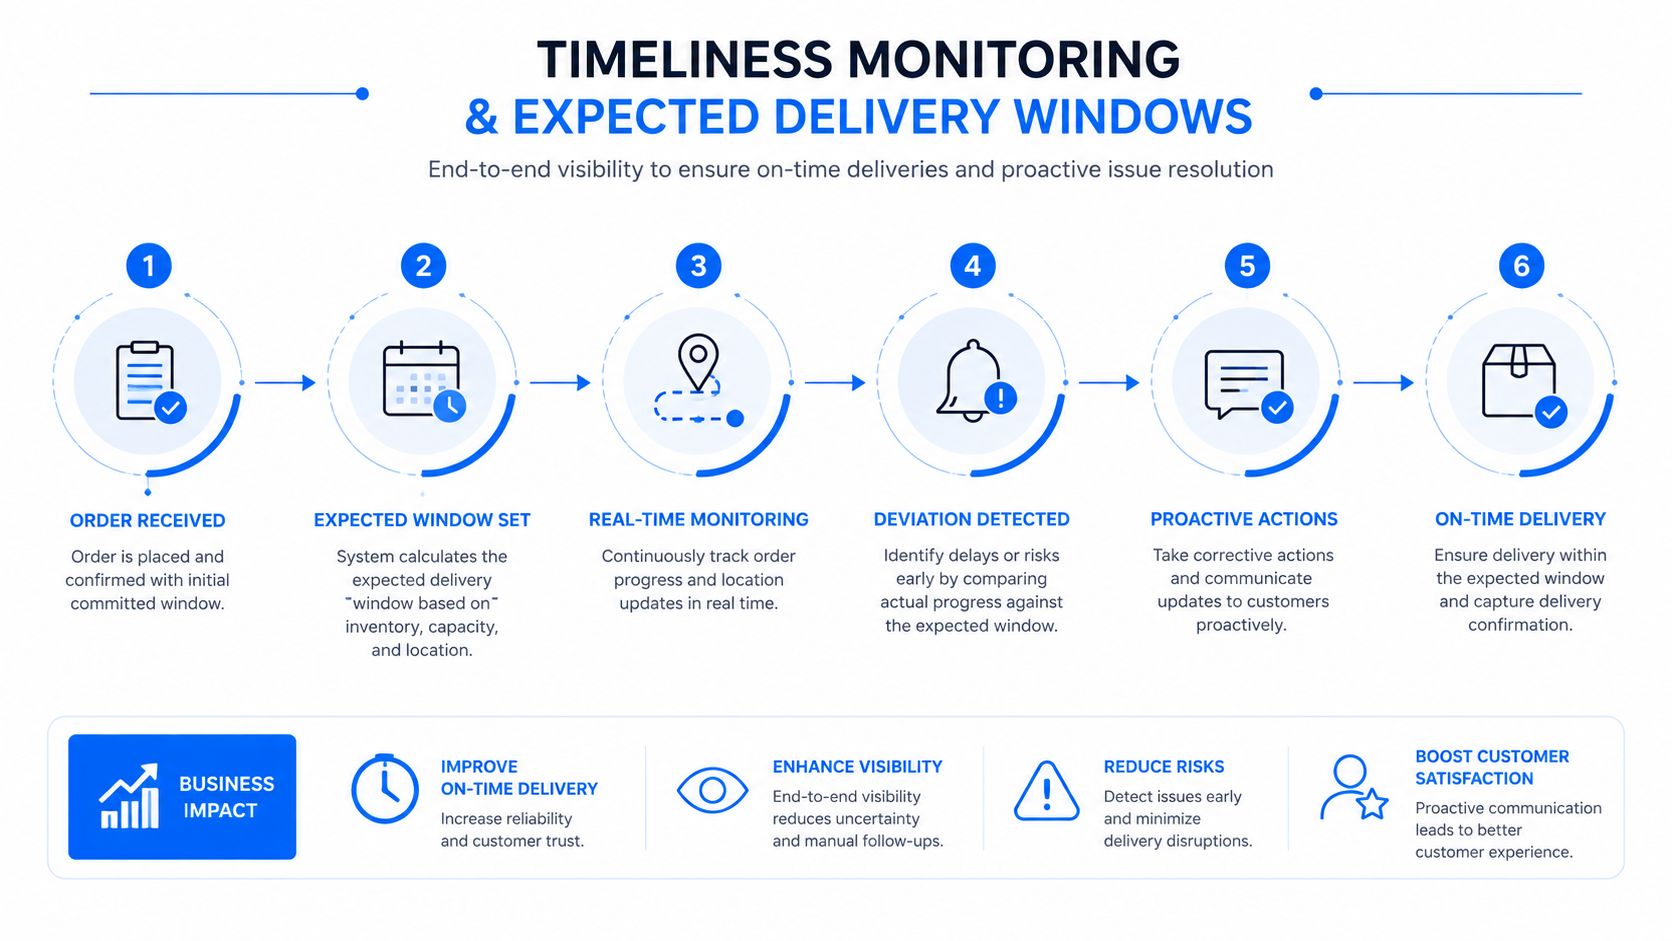
Monitoruj coś więcej niż tylko ostateczny znacznik czasu. Testy tętna (heartbeat) pokazują, czy źródło nadal generuje dane. Znaczniki poziomu wody (watermarks) pokazują, jak daleko posunął się potok. Przyrostowe znaczniki ukończenia pokazują, czy dotarły wszystkie partycje, w czym często kryją się częściowe załadunki.
Polityka alertów powinna odzwierciedlać rodzaj awarii, a nie tylko fakt wystąpienia opóźnienia.
Wczesne przybycia: Zazwyczaj nieszkodliwe, ale przydatne, gdy wskazują na zmianę harmonogramu w systemach nadawczych.
Opóźnione przybycia: Wyślij alert, gdy opóźnienie przekroczy okno biznesowe zbioru danych.
Brakujące ładunki: Eskaluj szybko, jeśli danych brakuje przed znanym terminem konsumpcji.
Częściowe ładunki: Traktuj jako wysokie ryzyko, gdy oczekiwane grupy plików lub partycje są niekompletne.
Użyteczne jest rozróżnienie między rutynowym poślizgiem a opóźnieniem, które zakłóci spotkanie zarządu lub pracę klienta. Ta decyzja należy do polityki monitorowania, a nie do czyjejś głowy o 7:50 rano. Kontrola terminowości (timeliness) działa wtedy, gdy daje zespołowi czas na reakcję i gdy wychwytuje cichą nieaktualność, zanim ktokolwiek zaufa liczbom.
Dryft schematu i jak go wykryć przed awarią systemów odbiorczych
Dryft schematu jest cichy, ponieważ potok często działa dalej, podczas gdy systemy odbiorcze psują się wokół niego. Systemy źródłowe zmieniają kształt bez ostrzeżenia, a ładowanie nadal wygląda na pomyślne, dopóki pulpit nawigacyjny, model lub zadanie podrzędne nie zacznie zgłaszać błędów z powodu brakujących lub przekształconych pól. Dlatego wykrywanie dryftu schematu powinno znajdować się w tej samej warstwie kontrolnej, co walidacja i monitorowanie terminowości (timeliness), a nie w kolejce do późniejszego sprzątania. Praktyczna definicja dryftu to niezapowiedziana lub stopniowa zmiana struktury źródłowej w czasie w stosunku do schematu potoku, dlatego wymaga aktywnego monitorowania, a nie jednorazowego zatwierdzenia (definicja dryftu schematu).
Użytecznym sposobem myślenia o dryfcie jest jego podział na typy. Dryft addytywny wprowadza nowe kolumny. Dryft subtraktywny usuwa pola, których oczekują odbiorcy. Dryft mutacyjny zmienia typ, precyzję lub dopuszczalność wartości pustych. Są to różne tryby awarii, więc wymagają różnych reakcji. Zmiana, która jest bezpieczna dla wprowadzania danych (ingestion), może nadal popsuć semantic layer w systemach odbiorczych lub zestaw funkcji modelu.
Wyjaśnienie dryftu schematu jasno przedstawia problem operacyjny. Jeśli struktura się zmienia i nikt tego nie zauważa aż do momentu konsumpcji, koszt pojawia się później w postaci błędnych złączeń, nieudanych rzutowań typów lub cichej utraty danych.
Wykrywaj dryft na granicy
Kontrole kontraktów powinny być uruchamiane, gdy dane przekraczają granicę ingestion. Wersjonowane rejestry schematów pomagają, gdy systemy źródłowe ewoluują celowo. Zadania diff, które porównują migawki DDL, wychwytują zmiany, które umknęły podczas przeglądu kodu. Kontrole wnioskowania mogą flagować nieoczekiwane kolumny, nawet jeśli producent nigdy ich nie zapowiedział.
Mechanika ma znaczenie. Walidacja względem zadeklarowanej struktury powinna obejmować obecność kolumn, typ, ograniczenia i kolejność dla plików płaskich, a także kontrole klucza głównego, klucza obcego i unikalności tam, gdzie te reguły mają zastosowanie. Te kontrole nie są spektakularne, ale zapobiegają wielu problemom, zanim rozprzestrzenią się na tabele i raporty w systemach odbiorczych.
Reaguj bez zamieniania każdej zmiany w awarię
Typ dryftu | Przykładowa zmiana | Metoda wykrywania | Zalecana reakcja |
|---|---|---|---|
Addytywny | Nowe pole dodane do ładunku | Diff schematu, wnioskowanie, kontrola kontraktu | Zezwól na dodanie pola dopuszczającego null, a następnie zaktualizuj modele odbiorcze |
Subtraktywny | Usunięto istniejącą kolumnę | Walidacja graniczna, diff migawki | Zablokuj lub skieruj do warstwy kompatybilności |
Mutacyjny | Zmiany typu lub precyzji | Walidacja typu, porównanie z rejestrem | Kwarantanna, dokładne mapowanie i wersjonowanie kontraktu |
Polityka bezwzględnego zatrzymywania (strict-fail) brzmi bezpiecznie, dopóki nie generuje więcej incydentów, niż zapobiega. Widziałem zespoły odrzucające nieszkodliwe zmiany addytywne, a następnie spędzające kolejny sprint na ręcznym odblokowywaniu odbiorców. Zazwyczaj lepiej sprawdza się ewolucja wstecznie kompatybilna. Dodawanie pól dopuszczających wartości puste, przejścia typu dual-write i powtarzalne ładowanie w systemach odbiorczych są bezpieczniejsze niż udawanie, że schematy nigdy się nie zmieniają.
Projektuj z myślą o dryfcie, a kontrole pozostaną użyteczne na dłużej. Załóż, że schemat jest stały, a kolejne wydanie systemu źródłowego szybko udowodni, że jest inaczej.
Budowanie warstwowego stosu jakości ETL w praktyce
Zielony przebieg ETL może nadal dostarczyć złe dane. Zwykle dzieje się tak dlatego, że jedna kontrola robi zbyt wiele, podczas gdy rzeczywista awaria ma miejsce o jedną warstwę dalej. Praktyczny stos jakości rozdziela te zadania. Kontrole na poziomie wierszy są uruchamiane inline podczas ekstrakcji lub transformacji. Wykrywanie anomalii na poziomie agregacji działa na granicach ładowania. Kontrole świeżości i lineage są uruchamiane po zatwierdzeniu (commit), gdy można potwierdzić, że zbiór danych dotarł, i prześledzić, jak się przemieszczał.
Ten podział ma znaczenie w praktyce. Reguły statyczne dobrze radzą sobie z wykrywaniem znanych błędnych wzorców. Monitorowanie behawioralne wychwytuje dryft, opóźnienia i subtelne zmiany, które omijają stałe reguły.
Jak zwykle dojrzewa stos
Pierwsza wersja powinna być lekka. Zacznij od nieblokujących sond na każdym przejściu etapu, aby zespół mógł zobaczyć, co się zmieniło, zanim zdecyduje, czy zatrzymać ładowanie. W miarę poprawy sygnału promuj kontrole wychwytujące rzeczywiste defekty do roli barier orkiestracji. Resztę pozostaw jako alerty lub ścieżki kwarantanny.
Częstym błędem jest traktowanie każdego problemu jako wyzwania polegającego na pisaniu reguł. Zespoły kończą z kruchą logiką, która blokuje nieszkodliwe zmiany, a omija istotny dryft. Lepszym wzorcem jest kontrola warstwowa, w której profilowanie dystrybucji, alerty o oknach przybycia i kontrakty schematów świadome lineage pokrywają różne obszary ryzyka. Dokładne narzędzia mogą się różnić. Zasada projektowania pozostaje ta sama.
Jeden przypadek branżowy jasno pokazuje ten kompromis. Wdrożenie opisane w materiałach ITSV zastąpiło tysiące statycznych reguł walidacji profilowaniem, alertami o terminowości (timeliness) i kontraktami schematów, co zmniejszyło szum alertów i pozwoliło wcześniej wykryć dryft wpływającej na przychody. Ten wynik to mniej kwestia konkretnego stosu technologii, a bardziej dopasowania. Twarde bariery powinny obsługiwać awarie, które psują odbiorców. Wszystko inne powinno informować operatorów bez zamieniania rutynowych zmian w przestój.
Kto za co odpowiada w stosie
Inżynierowie danych (Data engineers): Odpowiadają za granice potoku, kontrakty schematów i trasowanie awarii.
Inżynierowie analityczni (Analytics engineers): Odpowiadają za oczekiwania skierowane do modeli, kontrole dystrybucji i walidację semantyczną.
Zespoły ds. governance: Odpowiadają za standardy, politykę ważności i ścieżki eskalacji.
Właściciele biznesowi: Odpowiadają za znaczenie alertu, szczególnie gdy wiersz jest technicznie poprawny, ale komercyjnie błędny.
Buduj stos kontrolny w taki sam sposób, w jaki budujesz potok – z jasną odpowiedzialnością, testami i ścieżkami wycofywania zmian.
digna pasuje do tego modelu, ponieważ działa w środowisku klienta i łączy wykrywanie anomalii, monitorowanie terminowości (timeliness), walidację na poziomie rekordów, śledzenie schematów i metryki platformy. Nie chodzi o markę dostawcy. Chodzi o to, aby kontrole pozostawały blisko danych, a model operacyjny znajdował się wewnątrz środowiska, w którym działa potok.
Traktuj stos jakości jako produkt, a nie jednorazowy projekt. Profiluj każdy zbiór danych, przypisuj każdy tryb awarii do jednego właściciela, kieruj alerty do zespołu, który może podjąć działania, i wycofuj kontrole, gdy inna warstwa pokryje tę samą lukę w czystszy sposób. Jakość utrzymuje się wtedy, gdy stos jest zarządzany z dyscypliną, a nie wtedy, gdy liczba reguł stale rośnie.
Typowe błędne przekonania i praktyczna lista kontrolna jakości
Pierwszym błędnym przekonaniem jest to, że więcej reguł automatycznie oznacza lepszą jakość. W rzeczywistości nagromadzenie statycznych kontroli zazwyczaj prowadzi do zmęczenia alertami, podatnych na błędy potoków i długiego ogona reguł, którym nikt nie ufa. Drugim błędnym przekonaniem jest to, że zielony potok oznacza wiarygodne dane. Tak nie jest, ponieważ zadanie może zakończyć się sukcesem, podczas gdy ładunek jest nieaktualny, przesunięty lub strukturalnie błędny. Trzecim jest to, że dryft schematu to jednorazowy problem migracji. To nieprawda, to proces ciągły.
Te błędy znikają, gdy oddzielisz zadania poszczególnych kontroli. Reguły mierzą to, co oczekiwane. Anomalie wychwytują to, co nieoczekiwane. Wykrywanie dryftu obserwuje strukturę w miarę jej zmian w czasie. Jeśli zespół wymiesza te zadania, rezultatem będzie hałaśliwy monitoring i powolna reakcja na incydenty.
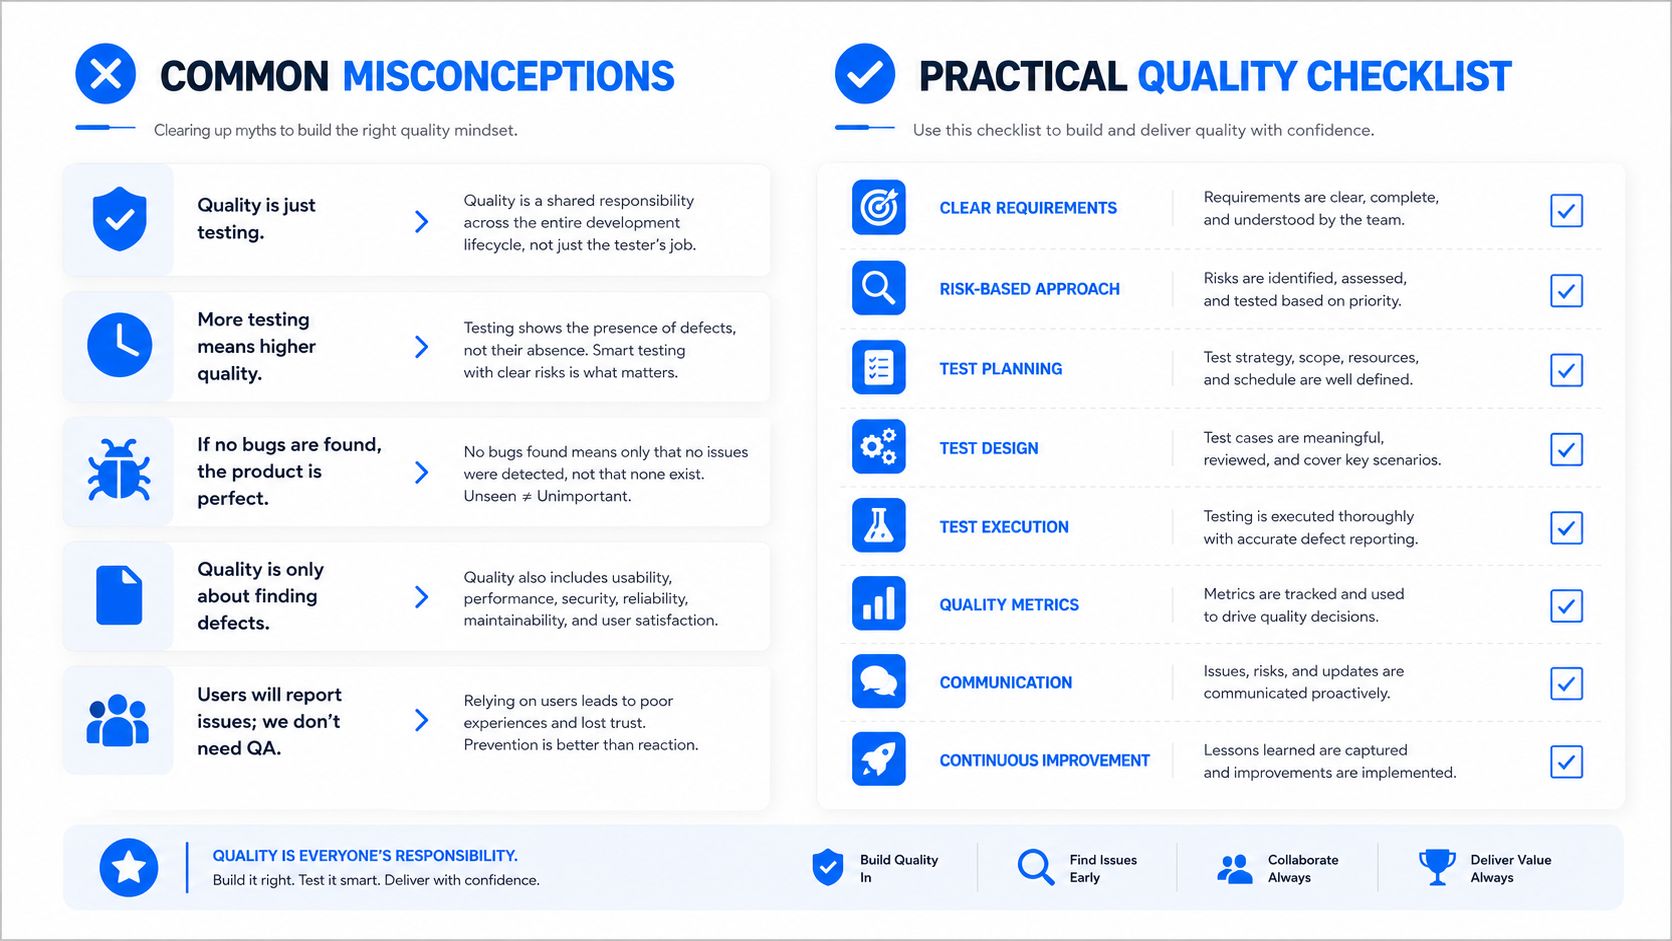
Lista kontrolna, którą możesz zastosować w tym tygodniu
Najpierw sprofiluj źródło: Poznaj kształty pól, wzorce wartości pustych i dystrybucje przed napisaniem reguł.
Zastąp statyczne progi kroczącymi punktami odniesienia: Używaj zaobserwowanego zachowania, gdy zbiór danych charakteryzuje się naturalną zmiennością.
Alertuj o braku, a nie tylko o obecności: Brakujące dane są często pierwszym znakiem uszkodzonego ładowania.
Wersjonuj każdy schemat: Traktuj zmiany strukturalne jako zdarzenie zarządzane, a nie niespodziankę.
Przypisz ludzkiego właściciela do każdego alertu: Alerty bez przypisanego właściciela stają się szumem w tle.
Najbardziej trwałe programy nie dążą do idealnych reguł. Budują observability, określają jasną odpowiedzialność i pozwalają modelowi kontroli ewoluować wraz z potokiem. Na tym polega różnica między systemem, który wygląda czysto, a takim, który pozostaje niezawodny, gdy zmienia się zachowanie źródła.
Jeśli wzmacniasz jakość danych ETL w magazynach danych, jeziorach danych i potokach strumieniowych, zacznij od kontroli, które obserwują zachowanie danych, a nie tylko status zadań. digna pomaga zespołom monitorować anomalie, dryft schematu, terminowość (timeliness) i walidację w ich własnym środowisku, dzięki czemu kontrole pozostają blisko danych, a odpowiedzialność jest jasna. Odwiedź digna, aby zobaczyć, jak to podejście pasuje do Twojego stosu.
Najczęściej zadawane pytania
Dlaczego zielone potoki ETL i tak produkują zepsute dane?
Bo narzędzia orkiestracji raportują głównie to, czy zadanie się wykonało, a nie czy dane zachowały się poprawnie. Praktyczna zasada brzmi: traktuj każdy udany przebieg ETL jako niezweryfikowany, dopóki dane nie przejdą kontroli świeżości, schematu i poziomu rekordu.
Jakie wymiary powinien monitorować każdy potok ETL?
Pięć, bo pojedyncza ocena ukrywa awarię. Świeżość mówi, czy dociera najnowszy poprawny rekord, a pozostałe obejmują wolumen, schemat, rozkład i poprawność na poziomie rekordu. Każdy wychwytuje inną klasę awarii i dopiero rozdzielne ich traktowanie czyni sygnał użytecznym.
Które awarie ETL bolą najbardziej?
Te ciche. Potok, który się wywraca, sam się zgłasza i zostaje naprawiony; przebieg, który kończy się powodzeniem, po cichu gubiąc partycję, wymuszając typ albo dopuszczając nieprawidłowe rekordy, dociera aż do pulpitu, zanim ktokolwiek zada pytanie.
Ile kosztuje słaba jakość danych w ETL?
Gartner szacuje koszt słabej jakości danych na średnio 12,9 mln USD na organizację rocznie, a podsumowania branżowe wskazują, że złe dane potrafią powodować 15–25 % utraty przychodów w części firm. Wczesne kontrole mają znaczenie, bo koszt rośnie z każdym kolejnym krokiem w dół łańcucha.
Czy odpowiedzią jest więcej testów?
Odpowiedzią jest warstwowy monitoring, a nie nadzieja ani dłuższy zestaw testów. Kontrole deterministyczne wychwytują naruszenia znanych reguł, kontrole statystyczne zachowania, których reguły nie opisują, a śledzenie schematu zmiany strukturalne, i żadna warstwa nie zastępuje dwóch pozostałych.



