Czym jest otwarty format tabeli
|
9
min. czyt.

Jest wtorek rano. Zadanie Sparka pobrało plik Parquet, gdy inny proces wciąż go zapisywał. Model dbt niżej w łańcuchu czyta niekompletną partię, przy ponowieniu łączy ją jeszcze raz i podwaja część sumy przychodów. Zespół nie znajduje problemu w logach potoku. Znajduje go finanse, w raporcie.
To rodzaj awarii, przez którą surowy data lake przypomina mniej bazę danych, a bardziej współdzielony folder o znakomitej przepustowości. Pliki mogą być trwałe, tanie i otwarte, ale lake wciąż potrzebuje wiarygodnego sposobu określenia, które pliki należą do tabeli, którą wersję powinni widzieć czytelnicy i jak zapisujący bezpiecznie publikują zmiany. To właśnie rola otwartego formatu tabeli.
Spis treści
Problem, który rozwiązuje otwarty format tabeli
Surowy data lake zwykle przechowuje pliki w pamięci obiektowej, często w formatach takich jak Parquet, ORC czy Avro. System pamięci wie, że pliki istnieją, ale nie wie automatycznie, że dany zbiór plików tworzy jedną logiczną tabelę, że nowa partia jest kompletna ani że czytelnik powinien zobaczyć albo stary, albo nowy stan, nigdy mieszankę obu.
Konwencje katalogów próbują wypełnić tę lukę. Zespoły tworzą foldery dla dat, regionów, najemców czy przebiegów ingestii, a potem proszą silniki przetwarzania, by wywiodły strukturę tabeli ze ścieżek i zawartości plików. To podejście działa, dopóki nie pojawią się jednocześnie wielu zapisujących, ponowienia, aktualizacje, usunięcia, zmiany schematu i równolegli czytelnicy.
Reguła praktyczna: folder z plikami to pamięć masowa. Tabela potrzebuje kontraktu na tożsamość, stan i zmianę.
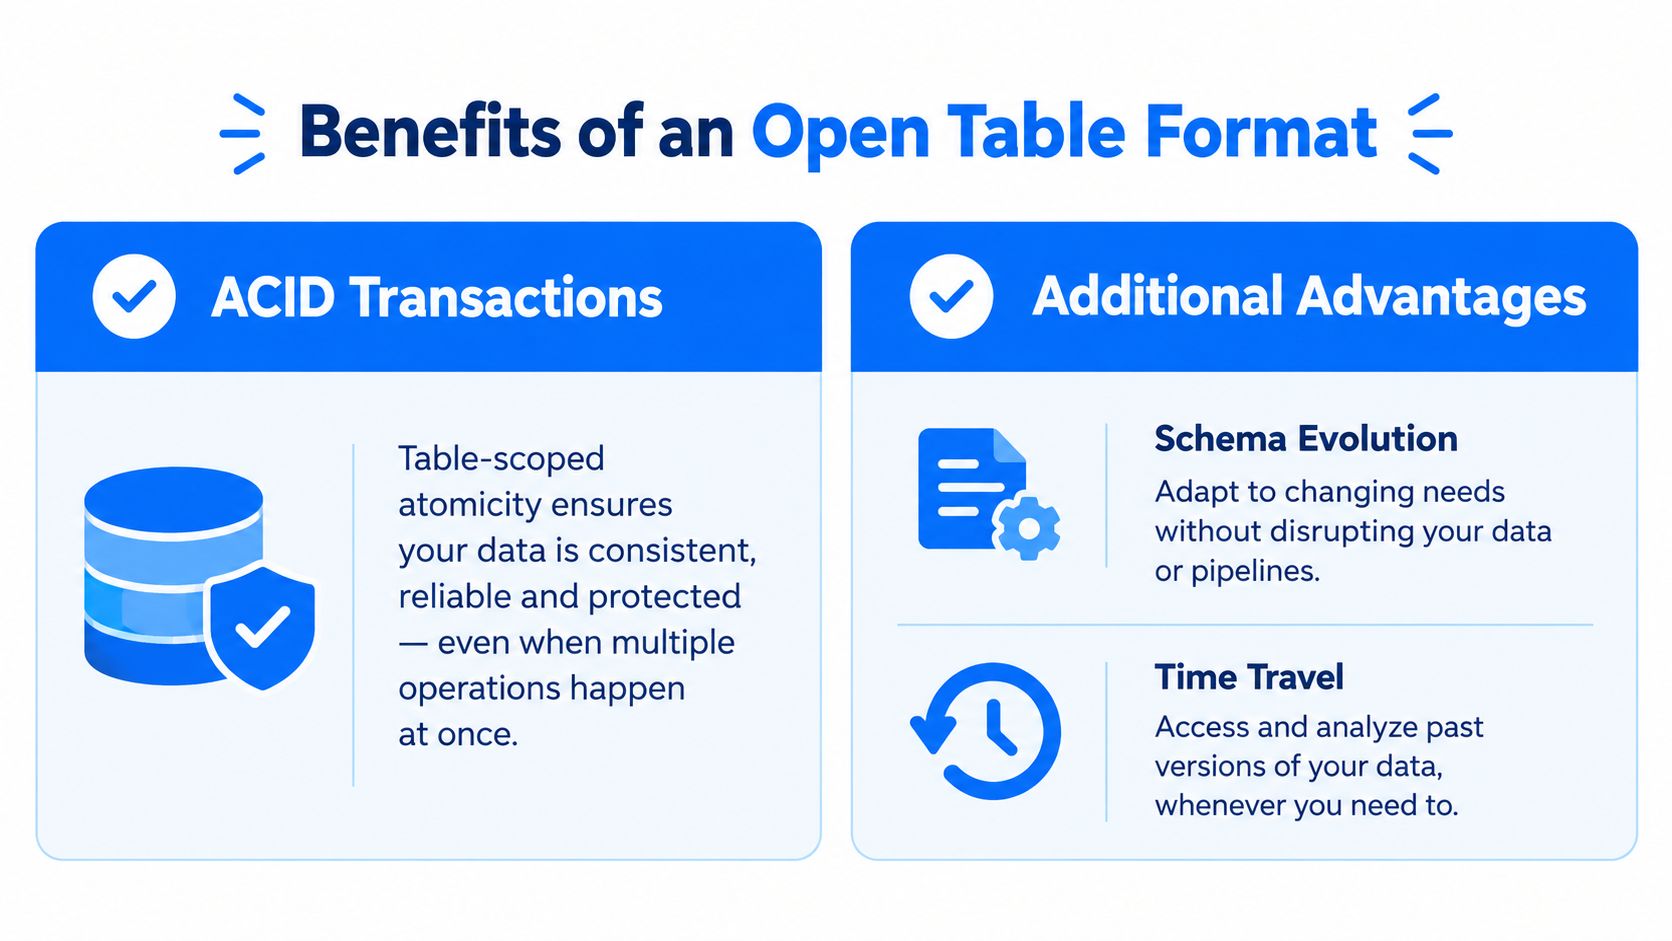
Otwarty format tabeli to warstwa specyfikacji i metadanych leżąca nad surowymi plikami danych i pod silnikami zapytań lub przetwarzania. Opisuje te pliki jako wersjonowaną, transakcyjną tabelę, wraz ze schematem, regułami partycjonowania, aktywnymi plikami i zatwierdzonymi snapshotami. Dane pozostają w otwartej pamięci, a metadane tabeli dostarczają koordynacji, której brakuje surowym katalogom. Przegląd otwartych formatów tabel autorstwa Databricks opisuje tę warstwę jako mechanizm, który dodaje plikom w pamięci obiektowej możliwości takie jak transakcje ACID, ewolucja schematu, podróż w czasie oraz aktualizacje i usunięcia na poziomie wierszy.
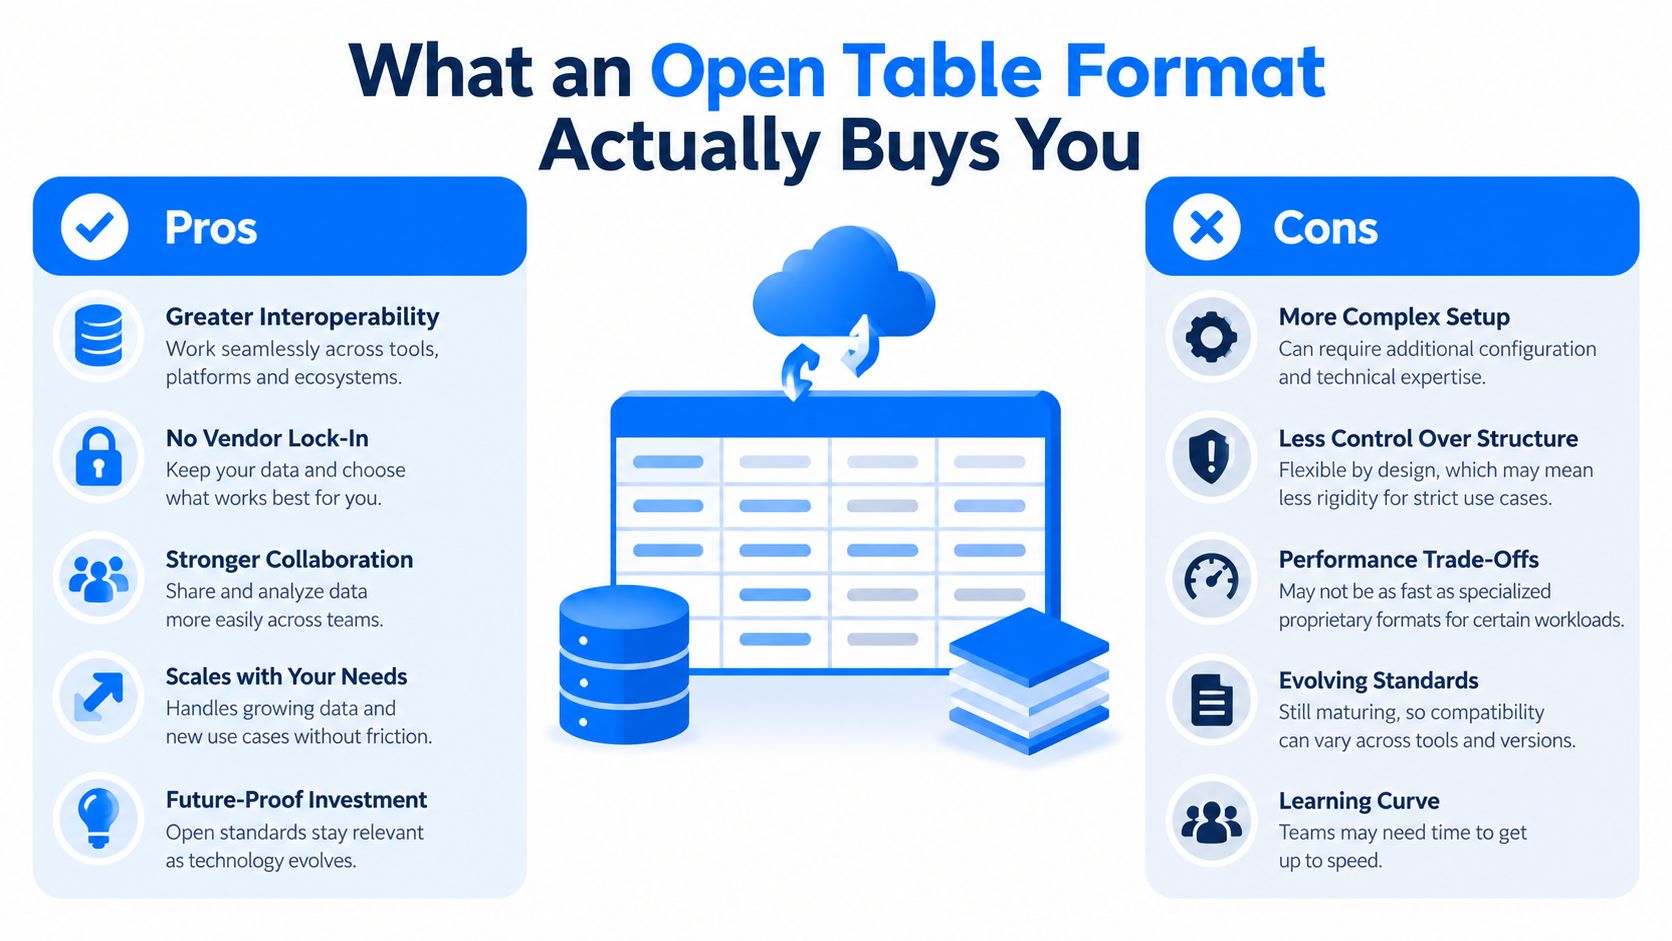
Format oddziela też logiczną tabelę od prywatnych założeń przechowywania pojedynczego silnika. Zgodni klienci mogą pozwolić, by Spark, Trino, Flink, Snowflake, BigQuery i DuckDB pracowały na tej samej tabeli źródłowej, choć dokładny zakres wsparcia funkcji zależy od silnika, konektora, katalogu i wersji formatu. Ta neutralność wobec silników jest tu kluczowa. Zespół platformowy może użyć Sparka do transformacji, Trino do interaktywnego SQL, Flinka do strumieni i jeszcze innego silnika do BI, nie tworząc osobnej fizycznej kopii dla każdego obciążenia.
Dlatego otwarty format tabeli należy do szerszej architektury platformy danych. Nie zastępuje platformy. Dostarcza wiarygodnego stanu tabeli, który reszta platformy może odnaleźć, odpytać, monitorować i nadzorować.
Historycznie otwarte formaty tabel wyrosły z ograniczeń zarządzania tabelami w stylu Hive, opartego na katalogach. Apache Hudi powstał w Uberze w 2016 roku, Apache Iceberg narodził się w Netflixie około 2017 roku, a Delta Lake wprowadził Databricks w 2017 roku i udostępnił jako otwarte oprogramowanie w 2019. Te kamienie milowe wyznaczyły zwrot ku zarządzaniu metadanymi na poziomie plików, zachowaniu ACID, ewolucji schematu i bezpieczniejszym aktualizacjom w chmurowej pamięci obiektowej. Historia otwartych formatów tabel stawia te projekty w centrum ewolucji lakehouse.
Jak otwarty format tabeli działa pod maską
Otwarty format tabeli łatwiej zrozumieć, gdy rozłożysz tabelę na warstwy. Wyobraź sobie zamrażarkę pełną kostek lodu.
Pliki danych to kostki lodu. Zawierają rzeczywiste rekordy, zwykle w formacie kolumnowym takim jak Parquet. Tabela może zawierać wiele plików, a te pliki mogą być rozproszone po pamięci obiektowej.
Partycjonowanie to foremka. Grupuje pliki według układu, który może wspomóc planowanie zapytań, na przykład według daty albo innego przekształcenia kolumny. Ważna różnica polega na tym, że nowoczesny format tabeli może zarządzać tym układem jako metadanymi tabeli, zamiast zmuszać każdego użytkownika do rozumienia fizycznej struktury katalogów.
Pliki manifestów to spisy inwentarzowe. Każdy manifest zapisuje, które pliki danych należą do konkretnej części tabeli, i zawiera informacje pomagające silnikowi zdecydować, które pliki może pominąć. Zapytanie o wąski zakres dat nie musi sprawdzać każdej kostki w zamrażarce, jeśli inwentarz wskazuje właściwą foremkę.
Warstwa metadanych to segregator. Śledzi schemat tabeli, specyfikację partycji, bieżący snapshot i odwołania do list manifestów. Snapshot to jeden spójny obraz całego segregatora, a nie tylko znacznik czasu doczepiony do przypadkowego folderu.
Model Apache Iceberg dobrze ilustruje to warstwowe podejście. Organizuje tabele przez niezmienne snapshoty i pliki manifestów. Każdy commit tworzy nowy obraz z danego momentu, zachowując wcześniejsze wersje na potrzeby podróży w czasie i wycofania, a JSON metadanych, listy manifestów i pliki manifestów tworzą powszechnie opisywaną hierarchię. Ta ściągawka z metadanych Apache Iceberg omawia te elementy.
Publikowanie nowego stanu tabeli
Zapisujący zwykle nie nadpisuje opublikowanego snapshotu w miejscu. Przygotowuje nowe lub zastępcze pliki, tworzy zaktualizowane metadane i manifesty, a następnie commituje nowy stan tabeli przez katalog lub protokół tabeli. Końcowy krok publikacji zmienia bieżące odwołanie do metadanych tabeli atomowo.
Czytelnicy, którzy zaczęli przed commitem, dalej korzystają z wcześniejszego snapshotu. Ci, którzy zaczęli po nim, używają nowego. Ten rozdział zapobiega temu, by zapytanie zobaczyło połowę partii, bo pliki pojawiły się w pamięci obiektowej w różnych chwilach.
Katalog koordynuje tożsamość i odnajdywanie tabel. Może korzystać z interfejsu REST, usługi w stylu Hive albo innej implementacji katalogu. Katalog odpowiada na pytania, gdzie leżą metadane tabeli i która wersja metadanych jest bieżąca. To punkt kontrolny, który powstrzymuje każdy silnik przed wymyślaniem własnej interpretacji tabeli.
Listy manifestów wspierają przycinanie na etapie planowania, a metadane przechowują schemat i specyfikację partycji. Ukryte partycjonowanie idzie krok dalej, pozwalając odpytywać kolumny logiczne bez pisania filtrów wobec fizycznych nazw folderów. Oznacza to, że tabela może rozwijać strategię partycjonowania, nie zmuszając każdej analityczki do przepisywania SQL wokół ścieżek pamięci masowej.
Wybór układu zapisu
Copy-on-write i merge-on-read to różne kompromisy.
Przy copy-on-write aktualizacja przepisuje dotknięte pliki danych. Odczyty pozostają prostsze, bo najnowszy stan tabeli jest już zmaterializowany w plikach kolumnowych, ale częste aktualizacje mogą tworzyć więcej pracy zapisu.
Przy merge-on-read nowe zmiany mogą być przechowywane osobno i scalane z plikami bazowymi podczas odczytu lub późniejszego kompaktowania. Zapisy pozostają bardziej responsywne przy obciążeniach z licznymi aktualizacjami lub strumieniowych, ale czytelnicy i procesy utrzymaniowe biorą na siebie więcej odpowiedzialności.
Jeśli wciąż oswajasz się z plikami źródłowymi, to wyjaśnienie Parquet daje kontekst niższego poziomu. Parquet przechowuje rekordy. Otwarty format tabeli wyjaśnia, jak te rekordy uczestniczą w nadzorowanej, wersjonowanej tabeli.
Co otwarty format tabeli naprawdę ci daje
Korzyści łatwiej ocenić jako macierz. Każda zdolność rozwiązuje określony tryb awarii, ale żadna nie gwarantuje, że biznesowe znaczenie danych jest poprawne.
Zdolność | Co umożliwia | Gdzie się kończy |
|---|---|---|
Transakcje ACID | Czytelnicy widzą zatwierdzony stan tabeli, a zapisujący publikują zmiany atomowo w zakresie tabeli. | Nie czynią atomową transakcji obejmującej kilka tabel. |
Podróż w czasie | Zespoły mogą odpytać lub przywrócić wcześniejszy snapshot, gdy bieżący stan budzi wątpliwości. | Retencja, sprzątanie i wsparcie katalogu decydują, jak długo te snapshoty pozostają dostępne. |
Ewolucja schematu | Zespoły mogą dodawać, przemianowywać, przestawiać lub usuwać kolumny zgodnie z regułami zgodności formatu i silnika. | Nie rozstrzyga, czy zmiana biznesowa jest bezpieczna dla modeli niżej w łańcuchu. |
Wydajność oparta na metadanych | Silniki mogą pomijać partycje i całe pliki, korzystając z metadanych, statystyk i informacji o układzie. | Słabe partycjonowanie, małe pliki i nieodpowiedni porządek sortowania nadal mogą dawać kosztowne zapytania. |
Transakcje ACID są fundamentem. Bez nich zespoły często polegają na wzorcu „przemianuj i módl się”. Zadanie zapisuje do katalogu tymczasowego i liczy, że końcowe przemianowanie uchroni czytelników przed zobaczeniem niepełnego wyniku. To podejście kruszeje, gdy zaczynają się przeplatać ponowienia, wielu zapisujących, zachowanie pamięci obiektowej i niezależne silniki zapytań.
Podróż w czasie zmienia reagowanie na incydenty. Jeśli potok wprowadzi złe wartości, analityczka może porównać bieżącą tabelę z wcześniejszym snapshotem, powtórzyć zapytanie wobec poprzedniego stanu albo przywrócić wersję uznaną za dobrą, o ile odpowiednie metadane i pliki nie zostały usunięte przez procedury retencji. Historia tabeli staje się artefaktem operacyjnym, a nie niewidzialnym ciągiem mutacji plików.
Ewolucja schematu dotyczy innego problemu. Systemy źródłowe się zmieniają. Producent dodaje pole, zmienia nazwę kolumny albo kolejność pól. Format tabeli może zapisać zgodne zmiany strukturalne, nie wymagając natychmiastowego przepisania każdego historycznego pliku. To zmniejsza tarcie migracji, ale zespół wciąż potrzebuje kontraktu o tym, jak odbiorcy niżej w łańcuchu interpretują tę zmianę.
Poprawa wydajności bierze się z przeniesienia pracy z czasu skanowania do czasu planowania. Silnik może użyć metadanych partycji, statystyk kolumn na poziomie plików i porządku sortowania, by uniknąć czytania nieistotnych plików. Wynik zależy od tego, jak tabela jest zapisywana i utrzymywana. Metadane mogą zawęzić poszukiwania, ale nie uratują układu, który tworzy nadmierną rotację plików albo słabą lokalność danych.
Granica ma znaczenie:
Tabela może być poprawna transakcyjnie i błędna znaczeniowo.
Atomowy commit może zachować kompletną partię zawierającą błędne przychody, zdublowanych klientów albo nieprawidłowy kod statusu. Otwarte formaty tabel zapewniają spójność strukturalną i stan historyczny. Walidacja danych, pochodzenie, własność i monitorowanie biznesowe nadal wymagają osobnego projektu.
Iceberg, Delta Lake i Hudi w porównaniu
Apache Iceberg, Delta Lake i Apache Hudi to trzy dominujące wybory wśród otwartych formatów tabel. Łączy je szeroki cel wniesienia niezawodnego zachowania tabeli do pamięci obiektowej, ale ich modele metadanych i priorytety obciążeń się różnią.
Cecha | Apache Iceberg | Delta Lake | Apache Hudi |
|---|---|---|---|
Model metadanych | Niezmienne snapshoty odwołują się do list manifestów i plików manifestów, które wyliczają pliki danych tabeli. | Sekwencyjny dziennik transakcji w | Oś czasu i system metadanych wspierają commity tabeli, indeksowanie na poziomie rekordów i przetwarzanie przyrostowe. |
Tryby zapisu | Zwykle używa zastępowania plików przy aktualizacjach, z funkcjami wersjonowania tabeli wynikającymi z możliwości formatu. | Zwykle używa zastępowania plików koordynowanego dziennikiem transakcji i wzorców optymistycznej współbieżności. | Wspiera Copy On Write i Merge On Read. |
Gwarancje transakcyjne | Zachowanie ACID zorganizowane jest wokół zatwierdzonych snapshotów tabeli. | Atomowe commity, izolacja snapshotów i powtarzalna historia biorą się z dziennika transakcji. | Commity transakcyjne wspierają upserty i usunięcia, a zachowanie kształtuje wybrany tryb zapisu. |
Strategia partycjonowania | Ukryte partycjonowanie i ewolucja partycji pomagają oddzielić zapytania logiczne od układu fizycznego. | Układy tabel partycjonowanych koordynuje protokół transakcji Delta i integracje z silnikami. | Partycjonowanie współpracuje z indeksowaniem na poziomie rekordów i usługami tabelarycznymi zaprojektowanymi dla danych zmiennych. |
Najlepiej dopasowane obciążenia | Analityka wielosilnikowa, tabele wsadowe i środowiska, w których liczy się przenośność metadanych. | Obciążenia ściśle zintegrowane z natywnymi narzędziami Delty i operacjami lakehouse skupionymi na Sparku. | Przetwarzanie przyrostowe, CDC, upserty, usunięcia i potoki zorientowane strumieniowo. |
Siłą Iceberga jest architektura snapshotów i manifestów. Silnik może planować na metadanych, nie wyliczając każdego pliku w pamięci obiektowej, a ukryte partycjonowanie pozwala administratorom tabel zmieniać organizację fizyczną bez odsłaniania każdego szczegółu układu użytkownikom SQL.
Delta Lake używa dziennika transakcji przechowywanego w katalogu _delta_log/. Operacje pojawiają się jako kolejno numerowane pliki JSON lub Parquet, a ten dziennik wspiera atomowe commity, izolację snapshotów i powtarzalną historię tabeli. To porównanie Delta Lake, Iceberga i Hudi wyjaśnia rolę dziennika w projekcie Delty.
Hudi zbudowano wokół indeksowania na poziomie rekordów i wspiera Copy On Write oraz Merge On Read, co pasuje do potoków obsługujących częste upserty i usunięcia. Wskazówki AWS dotyczące otwartych formatów tabel opisują te tryby zapisu i skupienie Hudi na przetwarzaniu przyrostowym oraz strumieniowym CDC.
Dla wsadowego obciążenia ETL wszystkie trzy mogą się sprawdzić. Dla BI praktyczne pytanie brzmi, które silniki zapytań potrafią odczytać tabelę z funkcjami potrzebnymi twoim zapytaniom, w tym przycinaniem, odczytami snapshotów i zachowaniem schematu. Dla strumieniowego CDC wzmocnienie zapisu, indeksowanie, semantyka scalania i kompaktowanie mogą znaczyć więcej niż prosta lista funkcji.
Wsparcie ekosystemu wciąż się zmienia w obrębie Sparka, Trino, Flinka, Snowflake, BigQuery i innych silników. To sprawia, że testy zgodności są cenniejsze niż założenie, że logo na stronie wsparcia gwarantuje wszędzie identyczne zachowanie. Zespoły powinny sprawdzić zapisy, równoległe commity, zmiany schematu, usunięcia, podróż w czasie i odtwarzanie po awarii na swoich rzeczywistych silnikach i katalogach. Podejście do jakości danych w Databricks też trzeba oceniać razem z wyborem formatu, bo protokół zapisu tabeli nie zastąpi kontroli danych, które ona zawiera.
Praktyczny wybór to nie „który format wygrywa?”. To która semantyka zapisu, model katalogu, proces utrzymania i integracje silników pasują do potoku, który eksploatujesz.
Jak otwarte formaty tabel wpisują się w nowoczesne platformy danych
Lakehouse ma zwykle cztery warstwy funkcjonalne. Pamięć obiektowa trzyma pliki. Otwarty format tabeli zarządza metadanymi i zatwierdzonym stanem. Silniki przetwarzania i zapytań czytają lub zapisują przez zgodnych klientów. Systemy nadzoru i obserwowalności badają, co się wydarzyło i czy powstałe dane nadają się do użycia.
Typowy przepływ zaczyna się, gdy rekordy lądują w S3 lub ADLS. Zapisujący tworzy lub aktualizuje tabelę, publikuje metadane i rejestruje tabelę w katalogu. Spark może przekształcić dane, Flink przetworzyć strumień, Trino obsłużyć zapytania interaktywne, a Snowflake, BigQuery czy Athena dać dodatkowe ścieżki konsumpcji, gdy ich integracje wspierają protokół i funkcje tabeli.
Ten rozdział udostępnia jeden logiczny zbiór danych wielu obciążeniom. Analityka może odpytać tabelę, potok uczenia maszynowego wyprowadzić cechy, a odbiorca strumieniowy przetwarzać świeże zmiany, bez zmuszania każdego zespołu do utrzymywania osobnej kopii. Kompromis polega na tym, że każdy klient musi zgodzić się co do semantyki tabeli, dostępu do katalogu, wspieranych funkcji i zachowania autoryzacji.
Dlatego format lepiej rozumieć jako część warstwy sterowania lakehouse, a nie zwykły wybór formatu pliku. Warstwa sterowania odsłania sygnały, które liczą się w zwykłym dniu z incydentem:
Wzorce commitów: wykrywaj zatrzymanych zapisujących, nietypową częstotliwość commitów lub powtarzające się niepowodzenia.
Świeżość metadanych: wskazuj tabele, których stan katalogu lub aktualizacje metadanych zostają w tyle za oczekiwaną dostawą.
Dryf partycji: znajduj zmiany organizacji fizycznej, które zmieniają zachowanie zapytań.
Zdarzenia schematu: śledź kolumny dodane, usunięte lub zmienione, zanim odbiorcy niżej w łańcuchu zawiodą.
Zachowanie snapshotów: wiąż incydenty jakości danych z dokładnym zatwierdzonym stanem tabeli, który skonsumowali czytelnicy.
Platforma taka jak digna może stanąć obok tej warstwy, monitorując świeżość metadanych, zdarzenia zmian schematu, terminowość, wyniki walidacji, anomalie i sygnały platformy we własnym środowisku klienta. To podejście traktuje historię tabeli jako źródło sygnałów operacyjnych, trzymając odpowiedzialność za jakość danych osobno od protokołu tabeli.
To rozróżnienie jest przydatne. Format mówi ci, który stan tabeli został zatwierdzony. Obserwowalność mówi, czy ten stan dotarł na czas, trzyma się oczekiwanych wzorców, spełnia reguły biznesowe i pozostaje bezpieczny do dalszego użycia. Więcej kontekstu o tej relacji znajdziesz w tekście o tym, jak utrzymać jakość danych w lakehouse.
Granice i kompromisy, które pomija większość artykułów
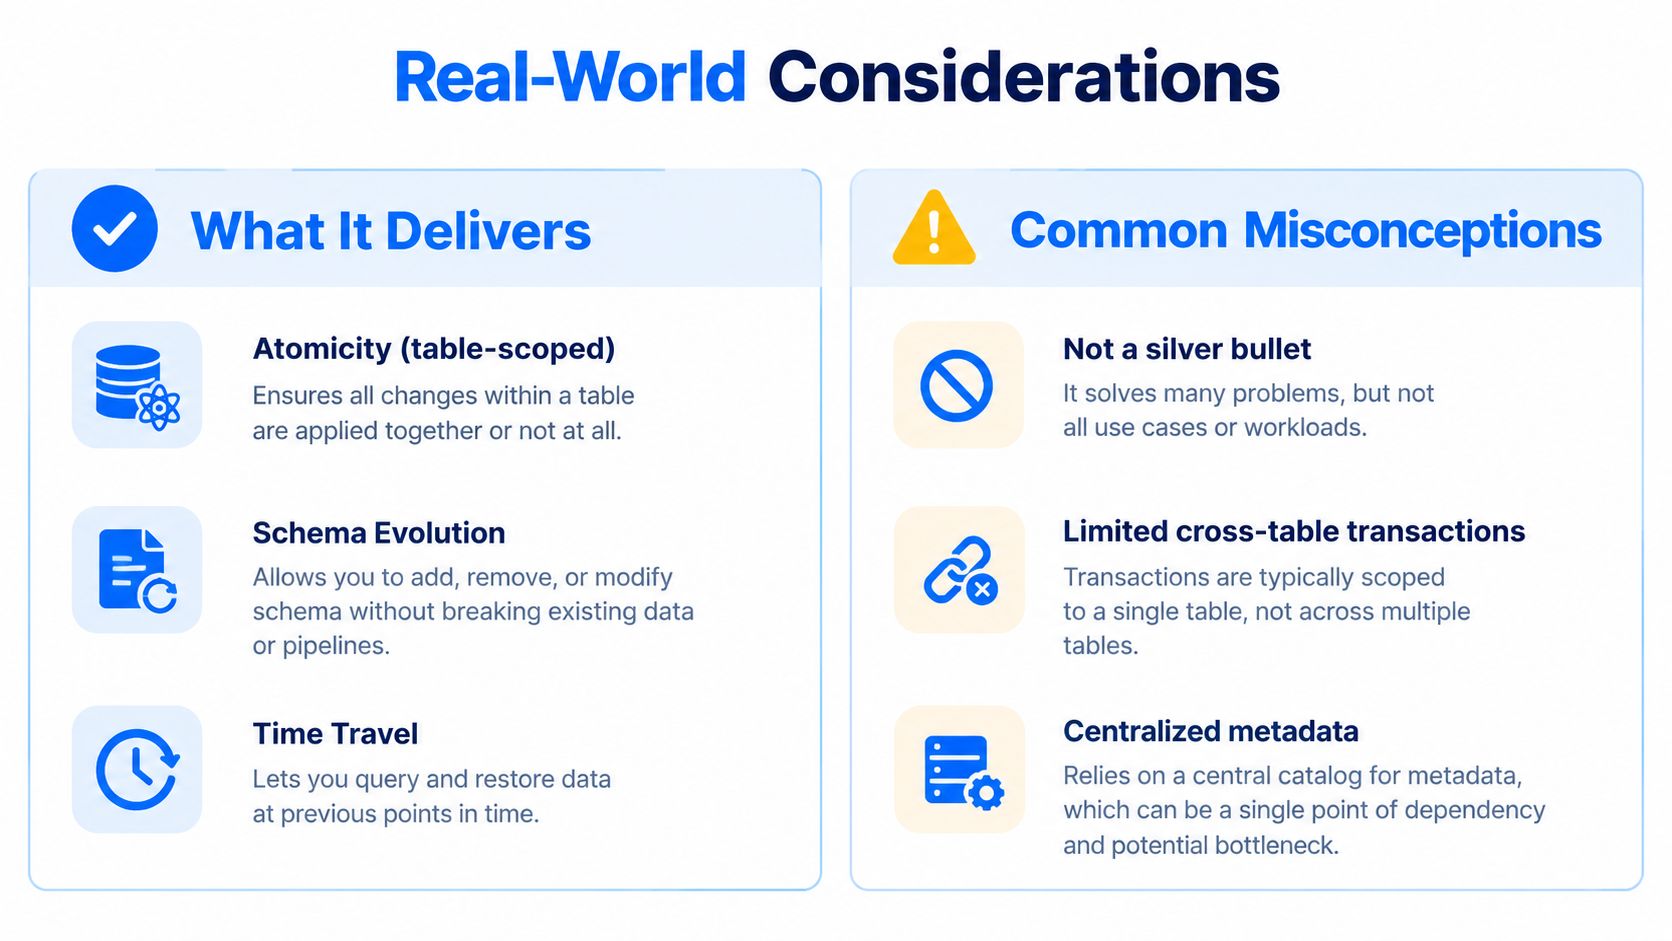
Otwarty format tabeli zamyka lukę atomowości dla tabeli. Nie zamienia jeziora na pamięci obiektowej w w pełni skoordynowaną relacyjną bazę danych.
Pierwszą granicą jest zakres transakcji. W ogólnym modelu gwarancje ACID pozostają ograniczone do tabeli. Jeśli potok aktualizuje tabelę sprzedaży i tabelę zapasów, każda z nich może commitować bezpiecznie, a mimo to cała operacja biznesowa stanie się między nimi niespójna. Transakcja obejmująca wiele tabel potrzebuje koordynatora albo funkcji platformy zaprojektowanej do tego celu.
Drugą granicą jest jakość znaczeniowa. Tabela może zawierać każdy oczekiwany plik, poprawny schemat i czysty snapshot, a mimo to trzymać błędne wartości. Otwarty format tabeli nie dowie się, że zwrot jest większy niż zamówienie, że identyfikator klienta łamie regułę biznesową albo że przychody nagle odzwierciedlają złą walutę.
Praca operacyjna nie znika
Utrzymanie tabel nadal wymaga uwagi inżynierskiej.
Kompaktowanie: układy merge-on-read i obciążenia z licznymi aktualizacjami mogą wymagać kompaktowania, by czytelnicy nie uzgadniali w kółko wielu plików zmian.
Rozmiar plików: nadmiar małych plików podnosi koszt planowania i skanowania, nawet gdy metadane pozwalają przycinać.
Strojenie partycji: schemat partycji, który pasował do wczorajszych wzorców dostępu, może dawać słabą wydajność po zmianach obciążenia lub rozkładu danych.
Retencja: podróż w czasie zależy od zachowania metadanych i plików danych wymaganych przez starsze snapshoty. Polityki sprzątania muszą godzić potrzeby odtwarzania z zarządzaniem pamięcią.
Współbieżność: wielu zapisujących może wejść w konflikt. Potok musi obsłużyć ponowienia, nieudane commity i idempotencję, zamiast zakładać, że każdy zapis się powiedzie.
Nadzór również żyje poza samym formatem tabeli. Katalogi takie jak Unity Catalog, Glue, Polaris i Nessie mogą zarządzać odnajdywaniem, uprawnieniami, integracjami pochodzenia danych i koordynacją, ale każdy niesie odpowiedzialność za konfigurację, dostępność, zgodność i aktualizacje. Różnice między dostawcami wokół specyfikacji katalogów, interfejsów REST i ukrytego partycjonowania mogą utrudniać przenośność, nawet gdy dwa systemy deklarują wsparcie dla tego samego formatu źródłowego.
Granica operacyjna: format chroni stan tabeli. Twoja platforma wciąż odpowiada za jakość, pochodzenie danych, politykę dostępu, reagowanie na incydenty i projekt obciążeń.
Te ograniczenia nie są powodem, by odrzucać otwarte formaty tabel. To granice, które trzeba udokumentować przed produkcją. Projekt obejmujący eksploatację katalogu, zadania utrzymaniowe, kontrole jakości, monitorowanie i procedury wycofania zachowa się zupełnie inaczej niż taki, który traktuje format jako proste zastępstwo hurtowni.
Wybór i wdrożenie otwartego formatu tabeli
Wybieraj format pod obciążenie, a nie pod hasło reklamowe dostawcy. Zacznij od silników, które muszą czytać i zapisywać tabelę, a potem przetestuj wzorce zapisu, integrację z katalogiem, zachowanie przy awarii, ścieżkę utrzymania i sygnały jakości, które liczą się na produkcji.
Kryterium | Co oceniać | Dlaczego to ważne |
|---|---|---|
Zgodność silników | Przetestuj Sparka, Trino, Flinka, narzędzia BI i wszystkie integracje z hurtowniami chmurowymi, których faktycznie używasz. | Nominalna integracja może nie wspierać każdej funkcji tabeli ani każdej operacji zapisu. |
Współbieżność zapisu | Zasymuluj równoległe dopisania, aktualizacje, usunięcia, ponowienia i nieudane commity. | Obsługa konfliktów decyduje, czy potoki odtwarzają się czysto, czy wymagają ręcznej interwencji. |
Potrzeby CDC i zmian | Porównaj upserty, usunięcia, odczyty przyrostowe oraz zachowanie Copy On Write i Merge On Read. | Obciążenia strumieniowe i zmienne stawiają różne wymagania pamięci masowej i odczytom. |
Integracja z katalogiem | Oceń dostęp REST lub w stylu Hive, odnajdywanie, uprawnienia, pochodzenie danych i dostępność katalogu. | Warstwa sterowania decyduje, jak silniki identyfikują i koordynują stan tabeli. |
Narzędzia utrzymaniowe | Przetestuj kompaktowanie, sprzątanie plików, ewolucję partycji, statystyki i retencję snapshotów. | Format łatwy w zapisie, lecz trudny w utrzymaniu, staje się ciężarem operacyjnym. |
Obserwowalność i jakość | Połącz zdarzenia commitów, zmiany schematu, terminowość, walidację i metryki biznesowe z procesami incydentów. | Sama spójność strukturalna nie dowodzi, że dane nadają się do użycia. |
Praktyczna migracja może zmieścić się w planie 90-dniowym, bez udawania, że zmiana formatu to pojedyncze wdrożenie.
Pilotaż
Wybierz reprezentatywne tabele, w tym tabelę z przewagą dopisań, tabelę ze zmianami schematu i obciążenie z aktualizacjami lub usunięciami. Zmierz zachowanie zapytań, konflikty commitów, przyrost metadanych, kroki odtwarzania i wysiłek potrzebny do walidacji rekordów.
Walidacja podwójnym zapisem
Zapisuj te same logiczne dane wejściowe starą i nową ścieżką tabeli. Porównaj liczbę wierszy, klucze, zachowanie wartości pustych, agregaty, zdarzenia schematu, czasy dostaw i zawartość snapshotów. Trzymaj porównanie przy biznesowych kryteriach akceptacji, a nie tylko przy tym, czy oba systemy wytworzyły pliki.
Przełączenie
Przenoś po jednym obciążeniu odbiorczym naraz. Określ odpowiedzialność za katalog, zadania utrzymaniowe, nieudane commity, decyzje o wycofaniu i alerty. Utrzymuj starą ścieżkę dostępną, dopóki nowa nie wykaże stabilnych odczytów, zapisów, odtwarzania i monitorowania w normalnych warunkach pracy.
Wycofanie z użycia
Usuwaj zbędnych zapisujących i ścieżki pamięci masowej dopiero po udokumentowaniu wymogów retencji, audytu, pochodzenia danych i wycofania. Zarchiwizuj dowody potrzebne, by wyjaśnić, kiedy nastąpiło przełączenie i który snapshot tabeli stał się wiążący.
Typowe błędy wdrożeniowe są przewidywalne: niedocenianie eksploatacji katalogu, pomijanie testów ewolucji partycji, traktowanie formatu jako zamiennika hurtowni, ignorowanie konfliktów równoległych zapisujących i zaniedbanie planu wycofania. Najsilniejszy proces wyboru włącza obserwowalność już od pilotażu, by zespoły widziały nie tylko, czy commit się powiódł, ale też czy powstałe dane dotarły na czas i pozostały poprawne dla odbiorców.
Przy szerszych decyzjach architektonicznych wskazówki dotyczące korporacyjnej platformy danych mogą pomóc umiejscowić formaty tabel obok nadzoru, jakości i odpowiedzialności operacyjnej.
digna pomaga przedsiębiorstwom monitorować jakość danych, terminowość, zmiany schematu, anomalie i zachowanie platformy we własnej infrastrukturze, co czyni ją praktycznym towarzyszem warstwy sterowania metadanymi i snapshotami otwartego formatu tabeli. Odwiedź digna, by ocenić, jak te sygnały mogą wesprzeć bezpieczniejszą eksploatację lakehouse.
Atomowy commit gwarantuje, że czytelnik nigdy nie zobaczy połowy partii; nie gwarantuje, że partia była poprawna, a to pozostaje problemem zarządzania jakością danych.
Najczęściej zadawane pytania
Czym jest otwarty format tabeli?
Warstwą specyfikacji i metadanych leżącą nad surowymi plikami danych i pod silnikami zapytań lub przetwarzania. Dostarcza tego, czego folder nie potrafi: kontraktu na tożsamość, stan i zmianę.
Dlaczego folder z plikami nie jest tabelą?
Bo folder to pamięć masowa. Surowy data lake trzyma pliki w pamięci obiektowej w formatach takich jak Parquet, ORC czy Avro, a konwencje katalogów próbują wypełnić lukę — i to właśnie sprawia, że jezioro przypomina mniej bazę danych, a bardziej współdzielony folder o znakomitej przepustowości.
Kiedy pojawiły się te formaty?
Wyrosły z ograniczeń zarządzania tabelami w stylu Hive, opartego na katalogach. Apache Hudi powstał w Uberze w 2016 roku, Apache Iceberg narodził się w Netflixie około 2017 roku, a Delta Lake wprowadził Databricks w 2017 roku i udostępnił jako otwarte oprogramowanie w 2019.
Co rozdziela format?
Logiczną tabelę od prywatnych założeń przechowywania pojedynczego silnika. To rozdzielenie pozwala wielu silnikom czytać tę samą tabelę, bez narzucania przez każdy z nich własnej interpretacji tego, które pliki się liczą.
Jakie kompromisy pomija większość artykułów?
Te operacyjne. Przyjęcie formatu dokłada metadane do zarządzania, decyzje o retencji do podjęcia i zachowania silników do uzgodnienia, więc koszt nie jest zerowy, nawet gdy specyfikacja jest otwarta, a migracja wygląda mechanicznie.



